
Leerpad
Ik maakte kennis met videogeneratiemodellen toen OpenAI de eerste iteratie van Sora lanceerde. Vanaf dat moment kwam ik veel topmodellen voor videogeneratie tegen. Dat inspireerde me om een lijst samen te stellen van de beste beschikbare modellen. De rangschikking is gebaseerd op mijn persoonlijke ervaring, de leaderboard voor videogeneratie van Artificial Analysis en algemene gebruikersfeedback.
Videogeneratie lijkt op beeldgeneratie, maar met een extra beperking: tijd. Elk frame moet consistent blijven met eerdere frames, waarbij karakteridentiteit, belichting, camerabeweging en scene‑indeling behouden blijven om temporele samenhang te waarborgen.
Moderne systemen gaan verder dan text-to-video: je kunt een enkele afbeelding in je eigen stijl animeren, shots aan elkaar rijgen tot langere sequenties en zelfs gesynchroniseerde audio (muziek, SFX, dialoog) uit prompts genereren, waardoor end-to-end filmische clips ontstaan.
In deze blog verkennen we enkele van de hoogst beoordeelde videogeneratiemodellen die de werelden van marketing, cinema, reclame en contentcreatie transformeren en nieuwe creatieve mogelijkheden openen in allerlei sectoren.
Afbeelding door de auteur | Canva + Google Nano Banana
Wat zijn videogeneratiemodellen?
Videogeneratiemodellen zijn AI-systemen die bewegende beelden creëren op basis van invoer zoals tekst, afbeeldingen of bestaande video’s. Ze bouwen voort op text-to-image‑methoden door het element tijd toe te voegen. Naast realisme en het opvolgen van prompts moeten deze modellen ook zorgen voor vloeiende beweging, continuïteit van onderwerpen en coherentie van frame tot frame.
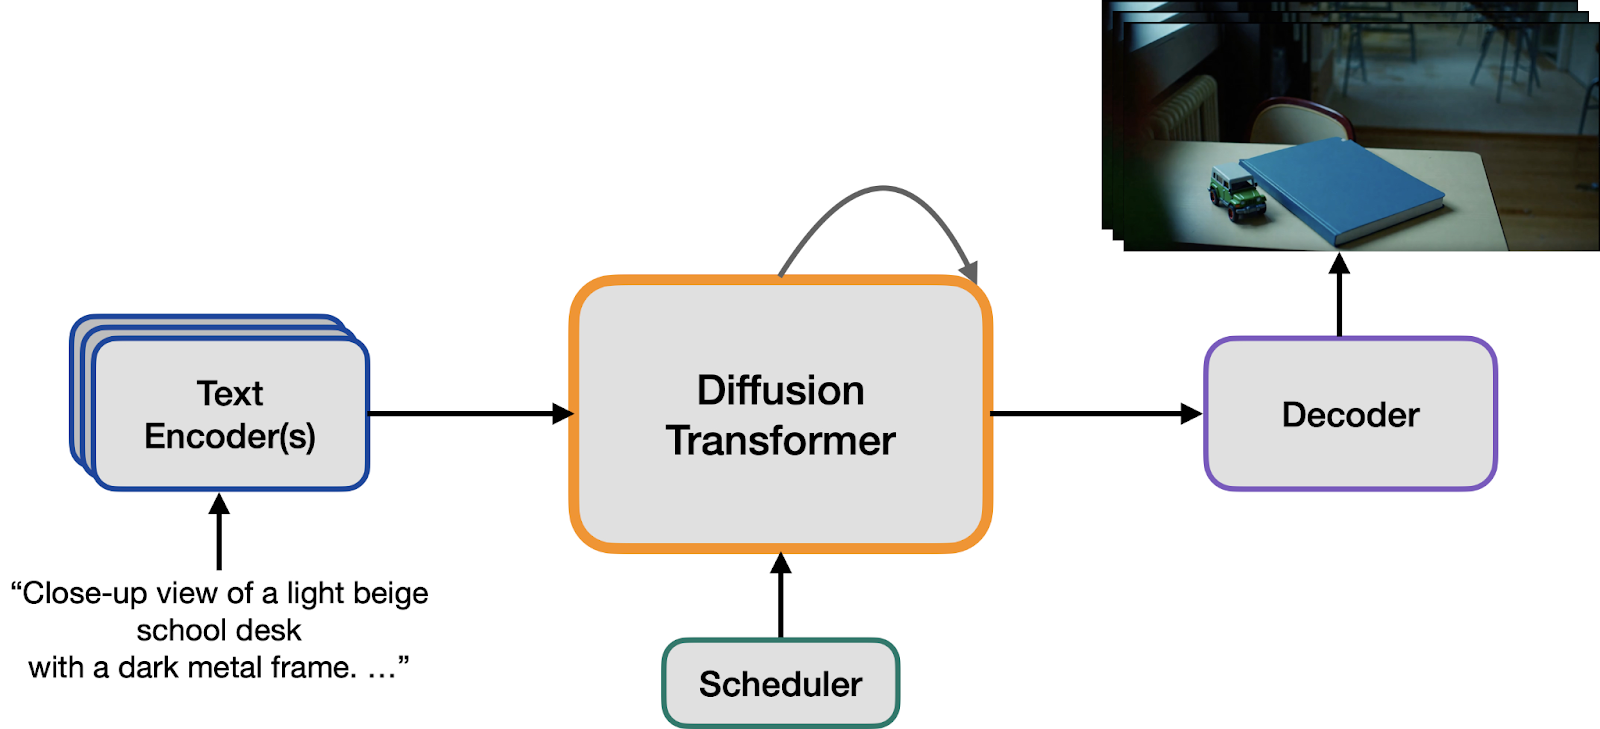
Afbeelding van State of open video generation models in Diffusers
Een videogeneratiemodel werkt door een tekstprompt om te zetten in een gestructureerde representatie met een tekstencoder, vervolgens te starten vanuit willekeurige ruis en dit stap voor stap te verfijnen via een denoising‑netwerk. Een scheduler stuurt dit proces aan, terwijl encoders en decoders schakelen tussen pixelruimte en een gecomprimeerde latente ruimte voor efficiëntie. In tegenstelling tot beeldmodellen verwerken videomodellen 3D‑tokens die zowel ruimtelijke details als temporele beweging vastleggen. Omdat decoderen veel geheugen vereist, gebruiken veel pipelines frame‑voor‑frame‑decodering om de generatie efficiënter te maken.
1. Veo 3
Veo 3 is Google’s state‑of‑the‑art videogeneratiemodel dat hoogwaardige clips van 8 seconden op 720p of 1080p (16:9) produceert met native, altijd‑aan audio op 24fps. Beschikbaar via de Gemini API blinkt het uit in dialooggedreven scènes, filmisch realisme en creatieve animatie, waarbij het geciteerde dialogen, expliciete geluidseffecten en omgevingsgeluiden rechtstreeks uit je prompt vastlegt.
Veo 3 vertaalt tekstprompts naar filmische shots met coherente belichting, scherptediepte en filmische kleur, terwijl de temporele consistentie van frame tot frame behouden blijft. Het rendert native gesynchroniseerde dialogen, SFX en ambience, wat lip‑bewuste spraak, scène‑passende akoestiek en timing‑nauwkeurige cues mogelijk maakt die het realisme verhogen.
2. Sora 2
Sora 2 is een veelzijdig text‑to‑video‑systeem dat nu gesynchroniseerde audio naast visuals genereert, inclusief dialogen, omgevingsgeluiden en geluidseffecten, allemaal in één keer. Deze vooruitgang overbrugt een belangrijke kloof in eerdere workflows en maakt meer samenhangende storytelling over meerdere shots mogelijk.
Naast audio richt het model zich op het creëren van realistischere scènes, met verbeterde fysieke plausibiliteit (zoals gewicht, balans, objectpermanentie en oorzaak‑gevolgrelaties) en een betere continuïteit over meerdere shots (zodat personages, belichting en de algemene wereldtoestand consistent blijven). Het biedt ook flexibele stijloptes, geschikt voor fotorealistische, filmische en geanimeerde esthetiek.
Bovendien introduceert Sora 2 een geavanceerde mogelijkheid om falen te simuleren, zoals mislukte sprongen of uitglijders, wat waardevol is voor previsualisatie en veiligheid gerelateerde concepten.
3. PixVerse V5
PixVerse V5 is een grote upgrade ten opzichte van V4.5, met snellere text‑to‑video en image‑to‑video generatie en scherpere, filmische visuals. Het levert vloeiende, expressieve beweging, stabiele stijl en kleur, en sterke prompt‑nauwkeurigheid zodat jouw regie helder op het scherm terechtkomt.
PixVerse V5 focust op realisme via drie pijlers: beweging, consistentie en detail. Soepelere camerabewegingen en natuurlijke, gewichtsvolle animaties verminderen de stijfheid uit eerdere versies, terwijl temporele consistentie stijl, kleur en onderwerpen coherent houdt over frames voor een samenhangende, filmachtige flow. Het resultaat is scherpe, filmische beeldvorming die veel makers omschrijven als “filmwaardig”, met betrouwbaar opvolgen van prompts voor stijl, toon en onderwerp.
4. Kling 2.5 Turbo
Kling 2.5 Turbo is de nieuwste upgrade in Kling’s AI‑videogeneratiesuite, gebouwd voor next‑level snelheid en creatieve vrijheid. Het verbetert zowel text‑to‑video als image‑to‑video met sterkere prompt‑nauwkeurigheid, geavanceerde cameracontrole en fysica‑bewust realisme, zodat jouw regie met minder iteraties en vertraging naar filmische resultaten wordt vertaald.
Kling 2.5 Turbo richt zich op esthetiek op filmniveau, met scherpere frames, uitgebalanceerde belichting en rijke kleurdiepte, waardoor scènes vanaf het begin een doordachte, filmische kwaliteit krijgen. De verbeterde prompt‑nauwkeurigheid en cameracontrole vertalen gedetailleerde scripts nauwkeurig naar precieze visuals, met soepele pans, zooms en overgangen die professioneel aanvoelen.
Realisme wordt versterkt door fysica‑bewuste beweging, met elementen als zwaartekracht en impacts naast vloeiende, vloeistofachtige bewegingen. Dit wordt aangevuld met levensechtere gezichtsuitdrukkingen, waardoor actie en spel geloofwaardig overkomen op het scherm.
5. Hailuo 02
De MiniMax Hailuo 02 is een videogeneratiemodel van de volgende generatie, ontworpen voor native 1080p‑output. Het beschikt over state‑of‑the‑art instructie‑opvolging en uitzonderlijke vaardigheden in fysica. Aangedreven door een nieuwe architectuur, Noise‑Aware Compute Redistribution (NCR), behaalt het ongeveer 2,5 keer de efficiëntie bij vergelijkbare parameterschalen.
Deze vooruitgang maakt een model mogelijk dat drie keer zo groot is en getraind op vier keer zoveel data als zijn voorganger, terwijl de kosten voor makers ongewijzigd blijven. Het resultaat is een sneller, capabeler systeem dat complexe prompts nauwkeurig interpreteert en beweging met hoge fideliteit genereert
De Hailuo 02 blinkt uit in het creëren van scènes die realistische fysica en precieze controle vereisen. Zo kan het choreografie op turnniveau aan, waarbij lichaamsbewegingen, gewichtsverdeling en timing allemaal authentiek moeten aanvoelen. De vergrote trainingsschaal en NCR‑efficiëntie resulteren in helderdere frames, stabiele temporele consistentie en hoge nauwkeurigheid in het volgen van prompts, zodat ingewikkelde instructies met minimale drift op het scherm worden uitgevoerd.
6. Seedance 1.0
Seedance 1.0 is ByteDance’s nieuwste hoogwaardige videogeneratiemodel, ontworpen om vloeiende en stabiele beweging te creëren met native multi‑shot storytelling. Het verwerkt zowel text‑to‑video (T2V) als image‑to‑video (I2V) effectief.
Dit model heeft een groot dynamisch bereik, wat zorgt voor vloeiende, grootschalige bewegingen met behoud van stabiliteit en fysieke realiteit. Het kan alles vastleggen, van subtiele expressies tot zeer actieve scènes.
Naast de bewegingsmogelijkheden ondersteunt Seedance 1.0 het maken van narratieve video’s met meerdere shots, waarbij consistentie in het hoofdonderwerp, de stijl en de algehele sfeer behouden blijft tijdens overgang tussen shots en veranderingen in ruimte en tijd. Die consistentie is essentieel voor samenhangende storytelling en efficiënte productie‑workflows.
Seedance 1.0 biedt ook diverse stilistische expressie en nauwkeurige controle. Het kan interacties tussen meerdere agents, complexe actiescènes en dynamische camerabewegingen aan, terwijl het gedetailleerde prompts nauwkeurig volgt. Zo wordt tekst trouw vertaald naar filmische video. Bovendien ondersteunt het hoge‑definitie outputs, waaronder 1080p, met vloeiende beweging en sterke visuele details die bijdragen aan een gepolijste, filmachtige uitstraling in zowel T2V‑ als I2V‑taken.
7. Wan2.2
Wan-AI/Wan2.2 is een open‑source en geavanceerd grootschalig generatief videomodel. Voortbouwend op Wan 2.1 beschikt het over een Mixture‑of‑Experts (MoE) diffusion‑architectuur die gespecialiseerde experts efficiënt routeert over denoising‑timesteps, waardoor de capaciteit wordt vergroot zonder de rekeneisen te verhogen.
Het mooiste is dat het volledig open is: het Wan‑AI‑team heeft code en gewichten vrijgegeven voor praktisch gebruik, waaronder een 5B hybride TI2V‑model met een high‑compression VAE (16×16×4) dat 720p op 24fps ondersteunt voor zowel text‑to‑video als image‑to‑video taken op consumenten‑GPU’s (bijv. de 4090). Er zijn ook A14B T2V/I2V‑modellen beschikbaar voor 480p‑ en 720p‑outputs.
Wan2.2 creëert video’s met filmische controle en complexe, geloofwaardige beweging. Het MoE‑ontwerp wijst een high‑noise expert toe voor de vroege globale layout en een low‑noise expert voor de gedetailleerde late stadia. Deze combinatie levert schone composities, scherpe texturen en stabiele temporele coherentie op die realistisch ogen op het scherm. De gecureerde esthetische labels maken precieze en gecontroleerde visuele stijlen mogelijk, waaronder belichting, kleurcorrectie en kadrering.
8. Mochi 1
genmo/mochi-1 is een geavanceerd, open‑source videogeneratiemodel dat in eerste evaluaties hoge‑fideliteitsbeweging en sterk opvolgen van prompts laat zien, waardoor de kloof tussen gesloten en open systemen aanzienlijk wordt verkleind.
Mochi 1 blinkt uit in het omzetten van natuurlijke taalprompts naar coherente, filmische beweging, waarbij de intentie van de gebruiker effectief wordt vastgelegd. De resulterende video’s zijn gepolijst, doordacht en trouw aan de gegeven beschrijvingen. Door de kwaliteitskloof met toonaangevende gesloten modellen te verkleinen en tegelijk volledig open en onder de Apache‑licentie te blijven, stelt Mochi 1 onderzoekers, makers en ontwikkelaars in staat om te experimenteren, te fine‑tunen en geavanceerde text‑to‑video‑technologie in echte projecten te integreren zonder zware beperkingen of kostenbarrières.
9. LTX-Video
LTX-Video is Lightricks’ met diffusie getrainde (DiT) videogeneratiesysteem, bekend om het leveren van hoogwaardige video’s in realtime. Het produceert 30 frames per seconde (FPS) op een resolutie van 1216×704, sneller dan afspeelsnelheid. Getraind op een grote en diverse videodataset richt LTX‑Video zich op het omzetten van afbeeldingen naar video met optionele conditionering via afbeeldingen en korte clips.
Het biedt verschillende modellen om kwaliteit en kosten in balans te brengen: een model met 13 miljard parameters voor de hoogste fideliteit, gedistilleerde en FP8‑varianten voor lager VRAM‑gebruik en snellere verwerking, en een optie met 2 miljard parameters voor lichte deployments. Het resultaat is een praktisch, maker‑vriendelijk systeem dat snelheid combineert met realistische, hoge‑resolutie visuals.
LTX‑Video transformeert stilstaande beelden in vloeiende, coherente beweging op 30 FPS, met scherpe texturen, stabiele onderwerpen en geloofwaardige cameradynamiek, waardoor de resultaten aanvoelen als doelbewust gefilmd in plaats van gesynthetiseerd. De DiT‑architectuur en uitgebreide training dragen bij aan temporele consistentie en gevarieerde, levensechte content, terwijl gedetailleerde prompts in het Engels je precieze stilistische controle geven.
10. Marey
Marey is het fundamentele AI‑videomodel van Moonvalley, specifiek ontworpen om te voldoen aan de standaarden van cinematografie van wereldklasse. Het is afgestemd op filmmakers die precisie in elk frame eisen, met nadruk op controle, consistentie en fideliteit. Zo wordt jouw creatieve visie trouw gerealiseerd van concept tot final cut. Van look‑ontwikkeling tot montage integreert Marey naadloos in professionele workflows en levert het hoogwaardige beelden die nauwkeurige inspectie doorstaan.
Marey zet gedetailleerde aanwijzingen om in precieze, productieklare sequenties, met stabiele onderwerpen, consistente belichting en vloeiende beweging voor een filmische kwaliteit. Door de nadruk op controle op frameniveau en temporele consistentie helpt het de toon, stijl en timing over verschillende shots te behouden. Zo kunnen makers vol vertrouwen trailers, scènes en campagnes produceren.
Conclusie
Videogeneratiemodellen ontwikkelen zich razendsnel, en makers in reclame, e‑commerce, marketing, cinema, YouTube en korte verhalen zetten ze nu al in. De voordelen zijn aanzienlijk: snellere iteratie, filmische kwaliteit en nieuwe creatieve mogelijkheden die voorheen buiten bereik lagen. Maar het realisme dat deze systemen bereiken brengt ook echte risico’s met zich mee, zoals misleidende advertenties, productoplichtingen en hyper‑overtuigende deepfakes van publieke figuren.
Terwijl we deze tools omarmen, is het essentieel om innovatie te koppelen aan verantwoordelijkheid. Dat betekent transparant zijn over het gebruik van AI, bronnen verifiëren en je houden aan duidelijke ethische en juridische richtlijnen.
In deze blog hebben we tien toonaangevende videomodellen verkend die tekst en afbeeldingen omzetten in zeer realistische beelden, met YouTube‑demo’s om de sterke punten van elk model te tonen. Ik heb ook open‑source opties uitgelicht die je lokaal kunt draaien, uitstekend voor leren, experimenteren en het fine‑tunen van resultaten die passen bij jouw merk of verhaal.
Als gecertificeerd data scientist haal ik met passie het maximale uit de nieuwste technologie om innovatieve machinelearning-toepassingen te bouwen. Met een sterke achtergrond in spraakherkenning, data-analyse en -rapportage, MLOps, conversationele AI en NLP heb ik mijn vaardigheden aangescherpt in het ontwikkelen van intelligente systemen die echt impact maken. Naast mijn technische expertise ben ik ook een sterke communicator met een talent om complexe concepten terug te brengen tot heldere, beknopte taal. Daardoor ben ik uitgegroeid tot een veelgelezen blogger over data science, waar ik mijn inzichten en ervaringen deel met een groeiende community van data-professionals. Op dit moment richt ik me op contentcreatie en redactie, waarbij ik met large language models werk aan krachtige en aansprekende content die zowel bedrijven als individuen helpt het beste uit hun data te halen.


