
Programma
Ho scoperto i modelli di generazione video quando OpenAI ha lanciato la prima iterazione di Sora. Da quel momento ho iniziato a incontrare molti modelli di generazione video di fascia alta. Questo mi ha spinto a compilare un elenco dei migliori modelli disponibili. Le classifiche si basano sulla mia esperienza personale, sulla classifica di Artificial Analysis per la generazione video e sul feedback complessivo degli utenti.
La generazione video è simile alla generazione di immagini, ma con un vincolo in più: il tempo. Ogni fotogramma deve rimanere coerente con i precedenti, preservando identità dei personaggi, illuminazione, movimento di camera e impianto scenico, per mantenere la coerenza temporale.
I sistemi moderni vanno oltre il text-to-video: puoi animare una singola immagine nel tuo stile, montare in sequenza più inquadrature e persino generare audio sincronizzato (musica, SFX, dialoghi) a partire dai prompt, producendo clip cinematografiche end‑to‑end.
In questo blog esploreremo alcuni dei modelli di generazione video più apprezzati che stanno trasformando i mondi del marketing, del cinema, della pubblicità e della content creation, aprendo nuove possibilità creative in vari settori.
Immagine dell’autore | Canva + Google Nano Banana
Cosa sono i modelli di generazione video?
I modelli di generazione video sono sistemi di IA che creano immagini in movimento a partire da input come testo, immagini o video esistenti. Si basano sui metodi di text-to-image incorporando l’elemento del tempo. Oltre a garantire realismo e aderenza ai prompt, questi modelli devono mantenere un movimento fluido, la continuità dei soggetti e la coerenza tra i fotogrammi.
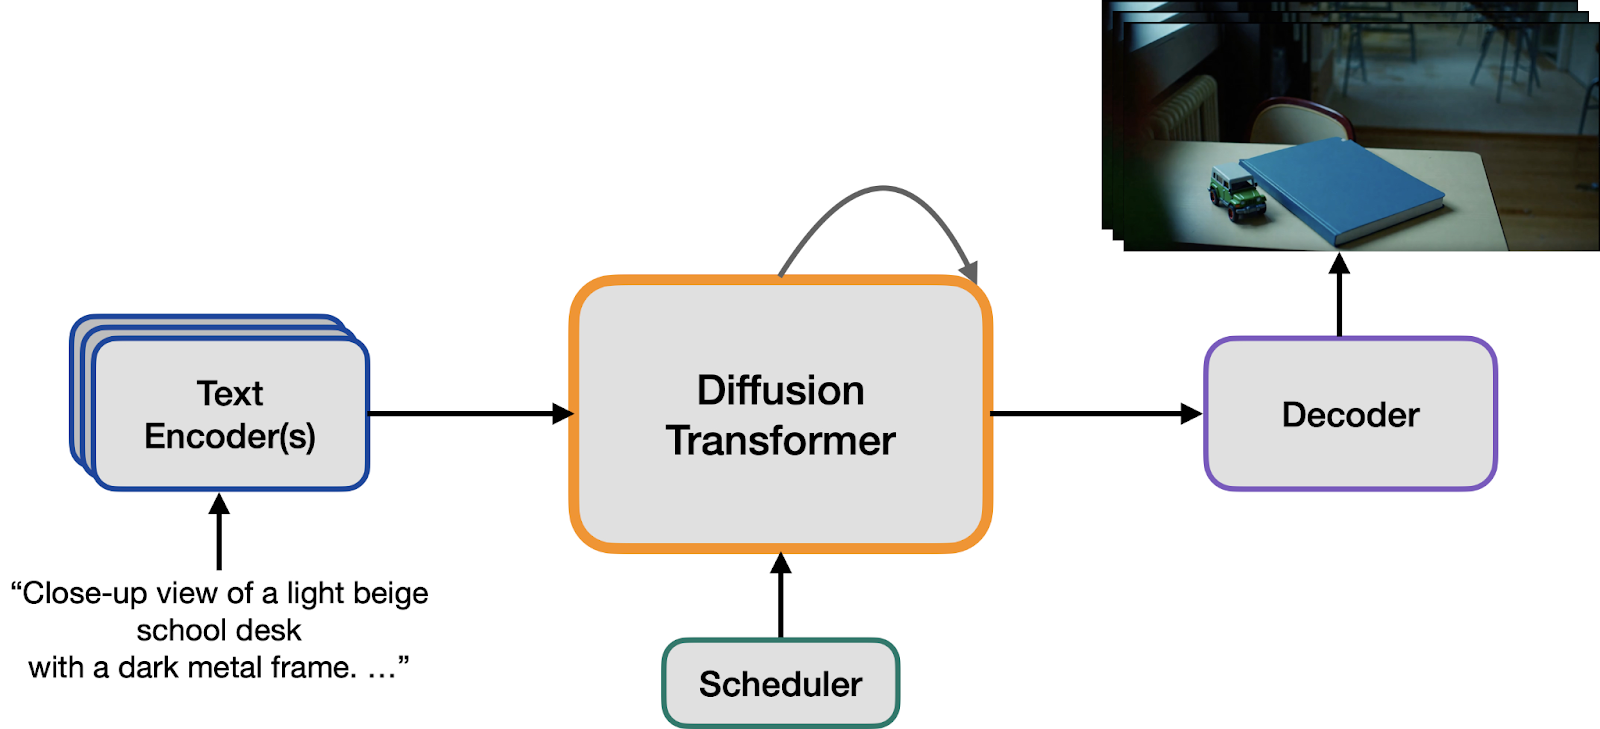
Immagine da State of open video generation models in Diffusers
Un modello di generazione video funziona trasformando un prompt testuale in una rappresentazione strutturata tramite un encoder di testo, quindi partendo da rumore casuale e raffinando il risultato passo dopo passo con una rete di denoising. Un scheduler guida questo processo, mentre encoder e decoder passano dallo spazio dei pixel a uno spazio latente compresso per efficienza. A differenza dei modelli di immagine, i modelli video elaborano token 3D che catturano sia il dettaglio spaziale sia il movimento temporale. Poiché il decoding richiede molta memoria, molte pipeline usano il decoding fotogramma per fotogramma per rendere la generazione più efficiente.
1. Veo 3
Veo 3 è il modello di generazione video all’avanguardia di Google, in grado di produrre clip ad alta fedeltà di 8 secondi a 720p o 1080p (16:9) con audio nativo sempre attivo a 24 fps. Disponibile tramite la Gemini API, eccelle in scene guidate dai dialoghi, realismo cinematografico e animazione creativa, catturando dialoghi tra virgolette, effetti sonori espliciti e paesaggi sonori ambientali direttamente dal tuo prompt.
Veo 3 traduce i prompt testuali in inquadrature cinematografiche con illuminazione coerente, profondità di campo e colorimetria filmica, mantenendo la consistenza temporale tra i fotogrammi. Esegue nativamente dialoghi, SFX e ambience sincronizzati, consentendo parlato con labiale allineato, acustica aderente alla scena e segnali temporali accurati che aumentano il realismo.
2. Sora 2
Sora 2 è un sistema text-to-video versatile che ora genera audio sincronizzato insieme ai visual, inclusi dialoghi, suoni ambientali ed effetti sonori, il tutto in un’unica passata. Questo progresso colma un divario significativo nei flussi di lavoro precedenti e permette uno storytelling più coeso su più inquadrature.
Oltre all’audio, il modello punta a creare scene più realistiche, migliorando la plausibilità fisica (come peso, equilibrio, permanenza degli oggetti e relazioni causa‑effetto) e potenziando la continuità su più inquadrature (garantendo coerenza di personaggi, illuminazione e stato generale del mondo). Offre anche opzioni di stile flessibili, accogliendo estetiche fotorealistiche, cinematografiche e animate.
Inoltre, Sora 2 introduce una sofisticata capacità di simulare fallimenti, come salti mancati o scivolate, utile per pre-visualizzazione e concetti legati alla sicurezza.
3. PixVerse V5
PixVerse V5 è un importante upgrade rispetto alla V4.5, che abbina generazione text‑to‑video e image‑to‑video più veloci a visual più nitidi e cinematografici. Offre movimento fluido ed espressivo, stile e colore stabili e forte aderenza ai prompt, così le tue indicazioni si traducono sullo schermo in modo pulito.
PixVerse V5 punta al realismo attraverso tre pilastri: movimento, coerenza e dettaglio. I movimenti di camera più fluidi e le animazioni naturali, con senso del peso, riducono la rigidità vista nelle versioni precedenti, mentre la coerenza temporale mantiene stile, colore e soggetti allineati tra i fotogrammi per un flusso coeso e cinematografico. Il risultato sono immagini nitide e cinematografiche che molti creator definiscono “da film”, con affidabile rispetto del prompt per stile, tono e soggetto.
4. Kling 2.5 Turbo
Kling 2.5 Turbo è il nuovo upgrade della suite di generazione video IA di Kling, pensato per velocità e libertà creativa di livello superiore. Migliora sia il text‑to‑video sia l’image‑to‑video con maggiore aderenza ai prompt, controllo avanzato della camera e realismo sensibile alla fisica, così le tue indicazioni si traducono in risultati cinematografici con meno iterazioni e meno latenza.
Kling 2.5 Turbo punta a un’estetica da cinema, con fotogrammi più nitidi, illuminazione bilanciata e ricca profondità cromatica, che dona fin da subito alle scene un carattere intenzionale e cinematografico. La migliore aderenza ai prompt e il controllo della camera traducono accuratamente sceneggiature dettagliate in visual precisi, eseguendo con fluidità pan, zoom e transizioni in modo professionale.
Il realismo è potenziato da un movimento consapevole della fisica, che incorpora elementi come gravità e impatti insieme a movimenti di tipo fluido. Il tutto è completato da espressioni dei personaggi più credibili, che rendono azioni e interpretazioni convincenti sullo schermo.
5. Hailuo 02
Il MiniMax Hailuo 02 è un modello di generazione video di nuova generazione progettato per output nativi a 1080p. Offre instruction following all’avanguardia e un’eccezionale padronanza della fisica. Grazie a una nuova architettura chiamata Noise‑Aware Compute Redistribution (NCR), raggiunge circa 2,5 volte l’efficienza a parità di scala dei parametri.
Questo progresso consente un modello tre volte più grande e addestrato su quattro volte più dati rispetto al predecessore, mantenendo invariati i costi per i creator. Il risultato è un sistema più veloce e capace, che interpreta con precisione prompt complessi e genera movimenti ad alta fedeltà
Hailuo 02 eccelle nella creazione di scene che richiedono fisica realistica e controllo preciso. Per esempio, può gestire coreografie a livello ginnico in cui movimenti del corpo, distribuzione del peso e tempistica devono risultare autentici. La maggiore scala di training e l’efficienza NCR si traducono in fotogrammi più chiari, stabile coerenza temporale e alta accuratezza nel seguire i prompt, assicurando che istruzioni complesse vengano eseguite sullo schermo con deriva minima.
6. Seedance 1.0
Seedance 1.0 è l’ultimo modello di generazione video di alta qualità di ByteDance, progettato per creare movimento fluido e stabile integrando nativamente il racconto multi‑shot. Gestisce in modo efficace sia i flussi di lavoro text‑to‑video (T2V) sia image‑to‑video (I2V).
Questo modello offre un’ampia gamma dinamica, consentendo movimenti ampi e fluidi mantenendo stabilità e realismo fisico. Riesce a catturare tutto, dalle espressioni sottili alle scene altamente dinamiche.
Oltre alle capacità di movimento, Seedance 1.0 supporta la creazione di video narrativi multi‑shot, garantendo coerenza nel soggetto principale, nello stile e nell’atmosfera complessiva durante le transizioni di inquadratura e i cambi di spazio e tempo. Questa coerenza è essenziale per uno storytelling coeso e flussi di produzione efficienti.
Seedance 1.0 offre anche ampia espressività stilistica e controllo preciso. Può gestire interazioni multi‑agente, sequenze d’azione complesse e movimenti di camera dinamici seguendo fedelmente prompt dettagliati. Ciò consente una traduzione accurata del testo in video cinematografico. Inoltre, supporta output in alta definizione, inclusi i 1080p, garantendo movimento fluido e forte dettaglio visivo che contribuiscono a un aspetto curato e filmico sia nei compiti T2V sia I2V.
7. Wan2.2
Wan-AI/Wan2.2 è un avanzato modello generativo video open‑source e su larga scala. Basato su Wan 2.1, adotta un’architettura di diffusione Mixture‑of‑Experts (MoE) che instrada in modo efficiente esperti specializzati lungo gli step di denoising, consentendo di espandere la capacità senza aumentare le richieste computazionali.
La parte migliore è che è completamente aperto: il team Wan‑AI ha rilasciato codice e pesi per l’uso pratico, incluso un modello ibrido TI2V da 5B con un VAE ad alta compressione (16×16×4) che supporta 720p a 24 fps per attività sia text‑to‑video sia image‑to‑video su GPU consumer (ad es. la 4090). Sono disponibili anche modelli A14B T2V/I2V per output a 480p e 720p.
Wan2.2 crea video con controllo cinematografico e movimenti complessi e credibili. Il design MoE assegna un esperto ad alto rumore per l’impianto globale iniziale e un esperto a basso rumore per le fasi finali di dettaglio. Questa combinazione produce composizioni pulite, texture nitide e stabile coerenza temporale che risultano realistiche sullo schermo. Le etichette estetiche curate consentono stili visivi precisi e controllati, che comprendono illuminazione, color grading e inquadratura.
8. Mochi 1
genmo/mochi-1 è un avanzato modello di generazione video open‑source che, nelle valutazioni iniziali, mostra movimento ad alta fedeltà e forte aderenza ai prompt, riducendo sensibilmente il divario tra sistemi chiusi e aperti.
Mochi 1 eccelle nel convertire prompt in linguaggio naturale in movimento coerente e cinematografico, catturando efficacemente l’intento dell’utente. I video risultanti sono curati, intenzionali e fedeli alle descrizioni fornite. Colmando il divario qualitativo con i principali modelli chiusi pur restando completamente aperto e con licenza Apache, Mochi 1 consente a ricercatori, creator e sviluppatori di sperimentare, fare fine‑tuning e integrare tecnologie text‑to‑video all’avanguardia in progetti reali senza pesanti vincoli o barriere di costo.
9. LTX-Video
LTX-Video è il sistema di generazione video addestrato con diffusione (DiT) di Lightricks, noto per offrire video di alta qualità in tempo reale. Produce 30 fotogrammi al secondo (FPS) a una risoluzione di 1216×704, più veloce della velocità di riproduzione. Addestrato su un ampio e vario dataset di video, LTX‑Video si concentra sulla conversione di immagini in video con condizionamento opzionale tramite immagini e clip brevi.
Offre una varietà di modelli per bilanciare qualità e costo: un modello da 13 miliardi di parametri per la massima fedeltà, varianti distillate e FP8 per minore uso di VRAM ed elaborazione più rapida, e un’opzione da 2 miliardi di parametri per deploy leggeri. Il risultato è un sistema pratico e adatto ai creator che combina velocità con visual realistici e ad alta risoluzione.
LTX‑Video trasforma immagini statiche in un movimento fluido e coerente a 30 FPS, con texture nitide, soggetti stabili e dinamiche di camera credibili, facendo percepire i risultati come intenzionalmente filmati e non sintetizzati. La sua architettura DiT e l’ampio training contribuiscono alla coerenza temporale e a contenuti vari e realistici, mentre prompt dettagliati in inglese ti offrono un controllo stilistico preciso.
10. Marey
Marey è il modello video IA di base di Moonvalley, progettato specificamente per soddisfare gli standard della cinematografia di livello mondiale. È pensato per i filmmaker che richiedono precisione in ogni fotogramma, con enfasi su controllo, coerenza e fedeltà. Questo assicura che la tua visione creativa venga realizzata fedelmente dal concept al final cut. Dallo sviluppo del look al montaggio, Marey si integra senza soluzione di continuità nei flussi di lavoro professionali e offre immagini di alta qualità che resistono a un esame ravvicinato.
Marey trasforma indicazioni dettagliate in sequenze precise e pronte per la produzione, garantendo soggetti stabili, illuminazione coerente e movimento fluido per una qualità cinematografica. Enfatizzando il controllo a livello di fotogramma e la coerenza temporale, aiuta a mantenere tono, stile e ritmo tra le diverse inquadrature. Questo consente ai creator di produrre con sicurezza trailer, scene e campagne.
Conclusione
I modelli di generazione video stanno progredendo rapidamente e creator in pubblicità, e‑commerce, marketing, cinema, YouTube e storytelling short‑form li stanno già utilizzando. I vantaggi sono notevoli: iterazioni più veloci, qualità cinematografica e nuove possibilità creative un tempo fuori portata. Tuttavia, il realismo che questi sistemi raggiungono comporta anche rischi concreti, come pubblicità fuorvianti, truffe su prodotti e deepfake estremamente convincenti di figure pubbliche.
Mentre abbracciamo questi strumenti, è essenziale affiancare l’innovazione alla responsabilità. Significa essere trasparenti sull’uso dell’IA, verificare le fonti e rispettare linee guida etiche e legali chiare.
In questo blog abbiamo esplorato dieci modelli video leader che convertono testo e immagini in riprese altamente realistiche, accompagnati da demo su YouTube per mostrare i punti di forza di ciascun modello. Ho anche evidenziato opzioni open‑source che puoi eseguire in locale, eccellenti per apprendimento, sperimentazione e fine‑tuning dei risultati in base al tuo brand o alla tua storia.
In quanto data scientist certificato, sono appassionato di sfruttare tecnologie all’avanguardia per creare applicazioni di machine learning innovative. Con una solida esperienza in riconoscimento vocale, analisi e reportistica dei dati, MLOps, AI conversazionale e NLP, ho affinato le mie competenze nello sviluppo di sistemi intelligenti in grado di avere un impatto concreto. Oltre alla mia expertise tecnica, sono anche un comunicatore efficace, con il talento di rendere chiari e sintetici concetti complessi. Di conseguenza, sono diventato un blogger molto seguito in ambito data science, condividendo idee ed esperienze con una community in crescita di professionisti dei dati. Attualmente mi concentro sulla creazione e sull’editing di contenuti, lavorando con large language model per sviluppare contenuti potenti e coinvolgenti che possano aiutare aziende e singoli a valorizzare al meglio i propri dati.



