Curso
Introducción a Python
4 h
7M
Con el Análisis Exploratorio de Datos (EDA) y el modelo base ya listos, puedes ponerte manos a la obra con tu primer modelo real de machine learning.
Nota: este tutorial se basa en una sesión de Facebook Live de código en directo; puedes volver a verla aquí:
Antes de empezar, importa todas las librerías necesarias:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data, que combine los sets de entrenamiento y prueba. Esto te permite preprocesar un poco y asegurarte de que cualquier operación que hagas sobre el entrenamiento también se aplique al test.# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
data con el método info().data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Hay 2 variables numéricas con valores ausentes.
¿Cuáles son?
Exacto: faltan valores en las columnas 'Age' y 'Fare'. En el resultado de .info() ves que faltan 263 valores en la primera, ya que solo hay 1046 valores no nulos de un total de 1309 entradas. Lo ideal sería que las 1309 tuvieran valores no nulos, pero no es el caso.
Por suerte, en Fare solo falta uno. Fíjate también en que 'Cabin' y 'Embarked' tienen valores ausentes y también habrá que tratarlos en algún momento.
Por ahora nos centraremos en arreglar las numéricas: vamos a imputar o rellenar los valores que faltan en 'Age' y 'Fare' usando la mediana de esas variables donde la conocemos.
Nota: en este caso usamos la mediana porque es perfecta para lidiar con valores atípicos. Es decir, la mediana es útil cuando la distribución está sesgada. Otras formas de imputación serían la media (suma de puntos dividida por el número de puntos) o la moda (el valor más frecuente).
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Ya tiene mucha mejor pinta, ¿verdad?
Además, en el tutorial anterior y el notebook, seleccionaste varias variables que parecían útiles para predecir 'Survived' según tu EDA. Entre ellas estaban 'Fare', pero también 'Age' y 'Sex'.
Como quieres trabajar con números, vas a convertir 'male' y 'female' en valores numéricos. La mayoría de modelos de machine learning requieren variables de entrada numéricas. Para ello puedes usar la función pandas .get_dummies():
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies() crea una nueva columna para cada opción de 'Sex'. Así, genera una columna para female, llamada 'Sex_female', y otra para 'Sex_male', que codifican si esa fila es hombre o mujer.
Como añadiste el argumento drop_first en la línea anterior, se eliminó 'Sex_female' porque, en esencia, 'Sex_female' y 'Sex_male' contienen la misma información.
En resumen, has creado una columna 'Sex_male' que vale 1 si la fila corresponde a un hombre y 0 si corresponde a una mujer.
.get_dummies() será uno de tus mejores aliados para preparar datos en machine learning.
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] de tu DataFrame para construir tu primer modelo:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info() para comprobar data:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
Ahora todas las entradas son no nulas. ¡Buen trabajo!
Hasta aquí, ya tienes los datos listos para construir tu primer modelo de machine learning. ¡Así que por fin vamos a crearlo!
Si quieres profundizar en pandas, echa un vistazo a nuestro itinerario de Data Manipulation with Python.
¿Qué es un clasificador de árbol de decisión? Es un árbol que te permite clasificar observaciones (las variables objetivo) a partir de variables predictoras.
Por ejemplo, en el árbol de abajo, el nodo raíz te obliga a tomar una primera decisión con la pregunta: "¿Fue 'Sex_male' menor que 0.5?" En otras palabras, ¿la observación era una mujer? Si la respuesta es True, bajas por la izquierda y obtienes 'Survived'. Si es False, bajas por la derecha y obtienes 'Dead'.
De momento no te preocupes por la información adicional de los nodos (gini, samples, value). Ya volveremos sobre ello.
'Male' conduzca a predecir 'Dead'.Nota: en realidad es el coeficiente gini el que se usa para tomar estas decisiones. No profundizaremos en ello ahora.
data, divide de nuevo en entrenamiento y prueba:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn, que requiere arrays en lugar de DataFrames, así que transfórmalos:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 y ajústalo a tus datos. Nota: llamamos clf al modelo por "Classifier".# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
Las variables predictoras X son el primer argumento que pasas a .fit(), y la variable objetivo y es el segundo.
La salida te resume el clasificador que acabas de construir: por ejemplo, confirma que la profundidad máxima es 3.
'Survived' y guarda ahí las predicciones. Exporta las columnas 'PassengerId' y 'Survived' de df_test a un .csv y súbelo a Kaggle.# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
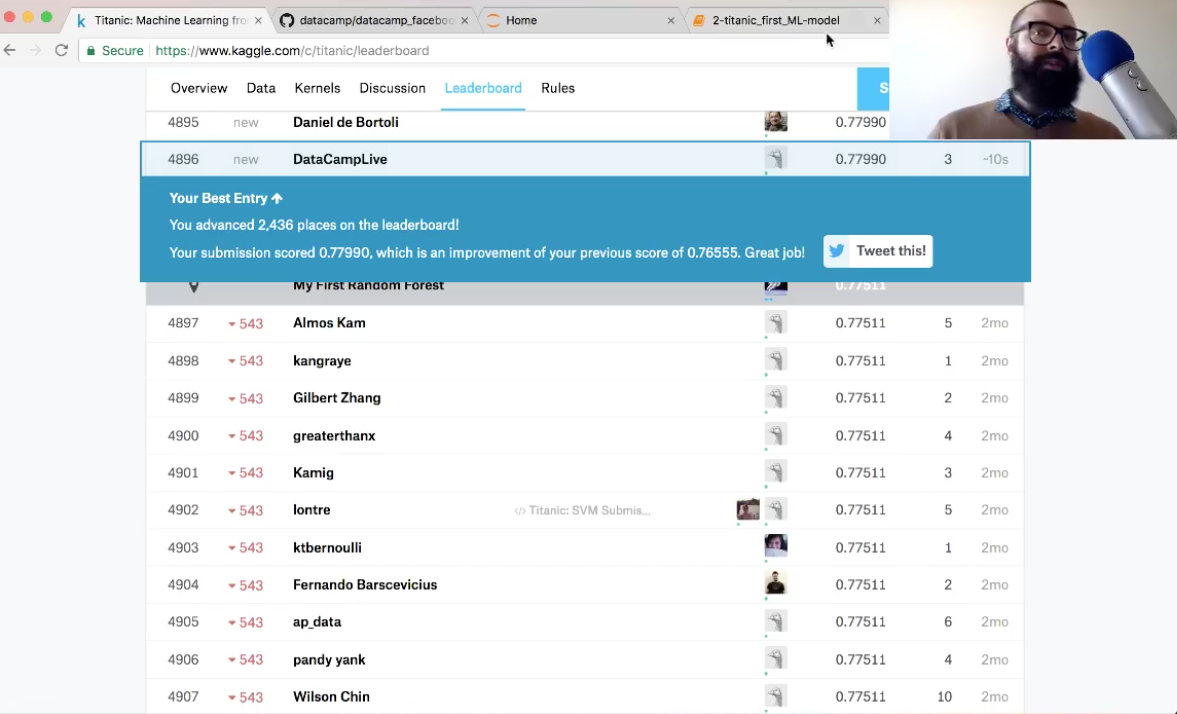
La precisión es del 78%. ¡Has subido más de 2000 puestos!
Enhorabuena: has dejado tus datos listos para construir tu primer modelo de machine learning. Y además, ya lo has construido: un clasificador de árbol de decisión.
Ahora vamos a ver qué es ese argumento max_depth, por qué lo elegiste y a explorar train_test_split.
Para saber más sobre scikit-learn, echa un vistazo a nuestro curso Supervised Learning with scikit-learn.
El clasificador que acabas de construir tenía max_depth=3 y se ve así:
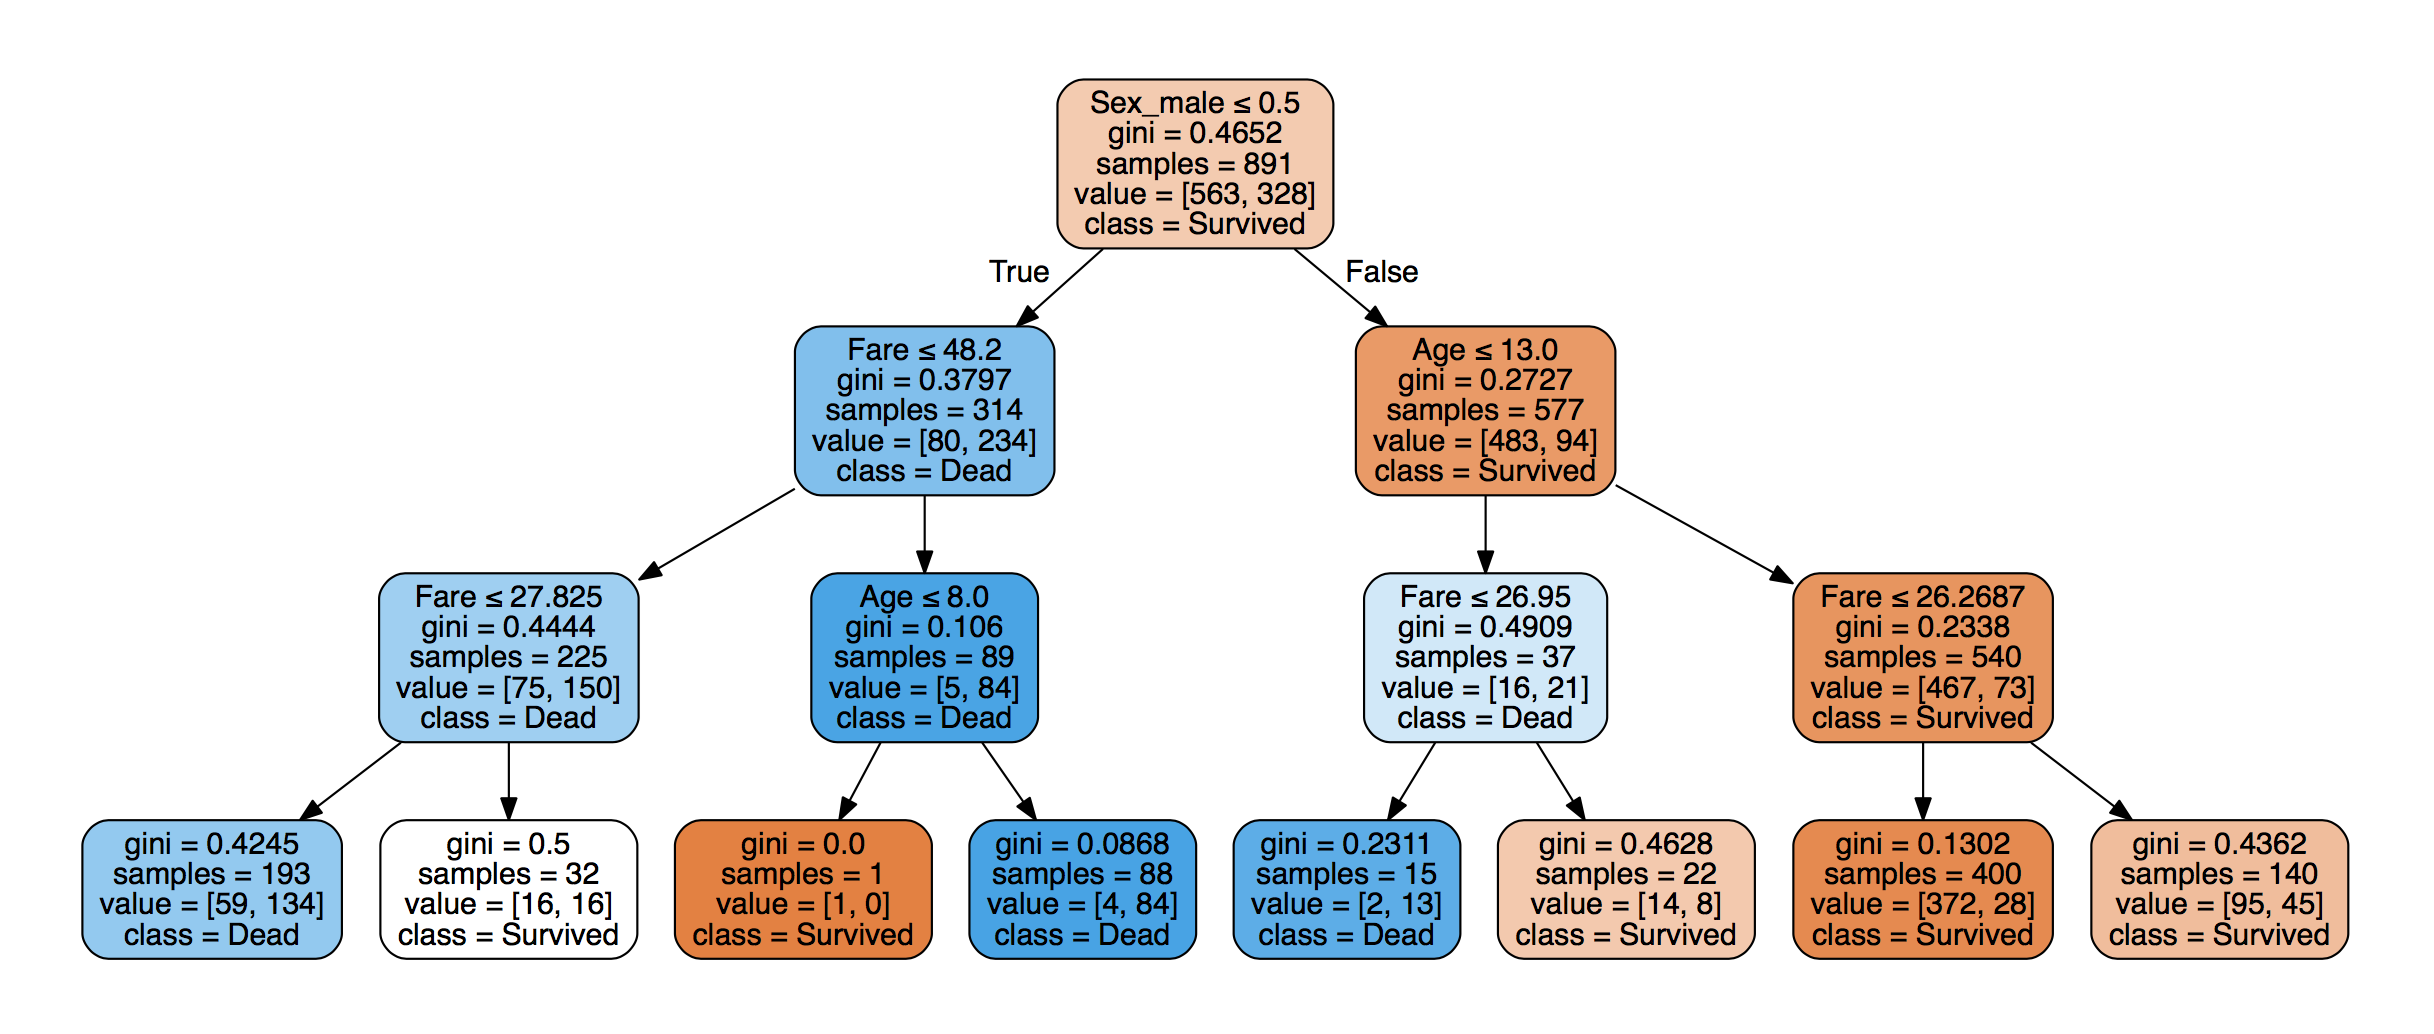
La distancia máxima entre la primera decisión y la última es 3; de ahí max_depth=3.
Nota: puedes usar graphviz para generar figuras como esta. Consulta la documentación de scikit-learn aquí para más detalles.
Al construir este modelo, en esencia estás creando una frontera de decisión en el espacio de variables, por ejemplo (imagen de aquí):
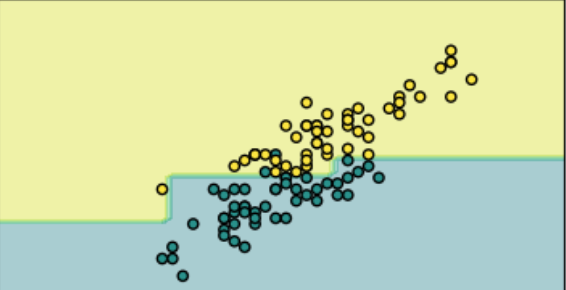
max_depth=3?La profundidad del árbol es un hiperparámetro, es decir, algo que decides antes de ajustar el modelo. Si eliges un max_depth mayor, obtendrás una frontera de decisión más compleja.
Si tu frontera es demasiado compleja, puedes sobreajustar: el modelo describirá también el ruido.
Si tu max_depth es demasiado pequeño, puedes infraajustar: el modelo no captará suficiente señal.
¿Cómo saber si estás sobreajustando o infraajustando?
Nota: esto es el conocido compromiso sesgo-varianza; no entraremos en detalle ahora.
Una forma es reservar un conjunto de prueba a partir de tus datos de entrenamiento. Ajustas el modelo en el entrenamiento, predices sobre el test y evalúas cómo rinde en ese test.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
max_depth del 1 al 9 y representa la precisión en entrenamiento y prueba:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
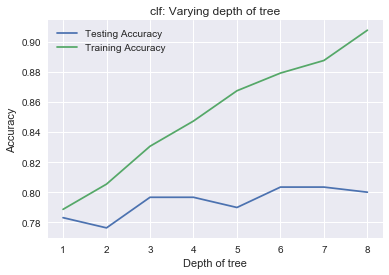
A medida que aumentas max_depth, te ajustas cada vez mejor a los datos de entrenamiento, porque tomas decisiones que describen esos datos. La precisión en entrenamiento sube y sube, pero ves que no ocurre lo mismo en el test: estás sobreajustando.
Por eso elegiste max_depth=3.
En este tutorial has dejado tus datos listos para construir tu primer modelo de machine learning. Después, has creado también tu primer modelo: un clasificador de árbol de decisión. Por último, has visto train_test_split y cómo ayuda a elegir los hiperparámetros del modelo.
En el próximo tutorial, que aparecerá en la Comunidad de DataCamp el 10 de enero de 2018, aprenderás a crear nuevas características y a construir nuevos modelos.
Mientras tanto, si quieres seguir explorando scikit-learn, echa un vistazo al curso de DataCamp Supervised Learning with scikit-learn.
Cursos de machine learning
Curso
Curso
Tutorial
Avinash Navlani
12 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Kevin Babitz
8 min
Tutorial
Moez Ali
14 min
Tutorial
Avinash Navlani
15 min
Tutorial