Curso
Creación de aplicaciones de IA con Pinecone
3 h
11.6K
En esencia, una base de datos vectorial es un sistema diseñado específicamente para almacenar y recuperar datos en forma de vectores. En este contexto, un vector es un conjunto ordenado de valores numéricos que puede representar desde coordenadas espaciales hasta atributos de características, como ocurre en machine learning y ciencia de datos, donde los vectores suelen representar las características de los objetos. La base de datos vectorial puede almacenar y recuperar estos vectores de características de forma eficiente.
Imagen de Gary Alway
Un embedding vectorial es el proceso de representar objetos, como palabras, frases o entidades, como vectores en un espacio continuo. Esta técnica se usa habitualmente para convertir datos de alta dimensionalidad y categóricos en vectores continuos de menor dimensión, que los algoritmos de machine learning pueden aprovechar con mayor eficacia. Los embeddings vectoriales son especialmente populares en procesamiento del lenguaje natural (NLP), donde se emplean para representar palabras o expresiones.
La idea principal detrás de los embeddings es capturar las relaciones semánticas entre objetos. En el caso de los word embeddings, por ejemplo, las palabras con significados similares se representan con vectores más cercanos entre sí en el espacio vectorial. Esto permite que los modelos de machine learning comprendan mejor las relaciones contextuales y semánticas entre palabras.
Partiendo del concepto de embeddings, los Large Language Models (LLMs) aprovechan estas representaciones numéricas para abordar tareas complejas de comprensión y generación de lenguaje.
Como ejemplo concreto, la arquitectura subyacente del modelo de chat GPT utiliza vectores. El modelo procesa entradas, como texto, convirtiéndolas en vectores numéricos.
Estos vectores capturan la información semántica y contextual de la entrada, lo que permite al modelo entender y generar respuestas coherentes y relevantes. La arquitectura Transformer, sobre la que se construye GPT-3.5, utiliza mecanismos de self-attention para ponderar la importancia de diferentes palabras en una secuencia, mejorando aún más la capacidad del modelo para captar relaciones y contexto.
Self-attention hace referencia a la capacidad del modelo para asignar distintos grados de importancia a las palabras dentro de la secuencia de entrada.
En resumen, el modelo GPT-3.5 opera sobre representaciones vectorizadas del lenguaje para realizar diversas tareas de comprensión y generación. Este enfoque basado en vectores es una de las claves de su éxito en un amplio abanico de aplicaciones relacionadas con el lenguaje.
PG Vector es una búsqueda de similitud vectorial de código abierto para Postgres. Vamos al grano y creemos una base de datos con Docker. Crea un archivo llamado docker-compose.yml y, en la línea de comandos, ejecuta: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
El siguiente paso es crear una tabla; en este ejemplo, vamos a catalogar recursos de aprendizaje de DataCamp: cursos, blogs, tutoriales, pódcasts, chuletas, code alongs y certificaciones.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
La columna embedding se generará a partir de un objeto JSON en forma de cadena que representa los atributos del recurso { name, content, slug, type }. Para crear este embedding vectorial, usaremos un modelo de embedding.
Uno de los modelos disponibles en AWS Bedrock es amazon.titan-embed-text-v1. La configuración de Bedrock no se trata en este artículo; es solo un ejemplo entre muchos modelos de embedding capaces de lograr resultados similares. El objetivo principal es tomar una entrada de texto, usar un modelo de embedding para generar embeddings vectoriales y almacenarlos en la columna embedding.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]Al poder almacenar datos junto con sus embeddings vectoriales, desbloqueamos todo el potencial de las bases de datos vectoriales: podemos interactuar con la base de datos en lenguaje natural y recuperar resultados con sentido sin esfuerzo.
Formula cualquier pregunta que quieras «hacerle a tus datos» y aplica el mismo embedding a ese texto. La consulta SQL sería así:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Esta consulta emplea una búsqueda por similitud coseno. El parámetro $1 representa el embedding del texto de tu pregunta, mientras que el parámetro $2 actúa como umbral de similitud y conviene ajustarlo mediante pruebas. Su valor óptimo depende del tamaño de tu dataset y del nivel de relevancia que busques, lo que determina la granularidad de la información recuperada.
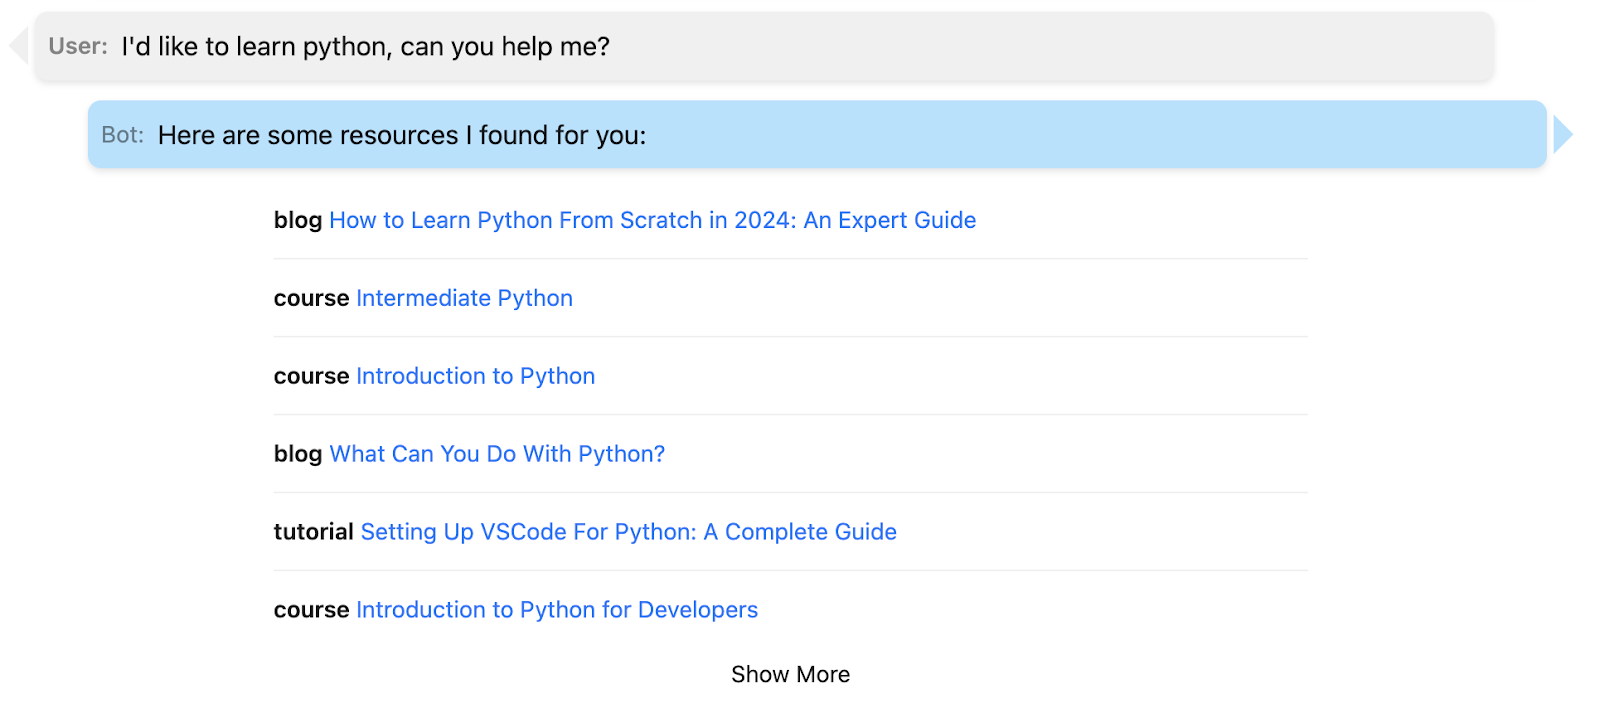
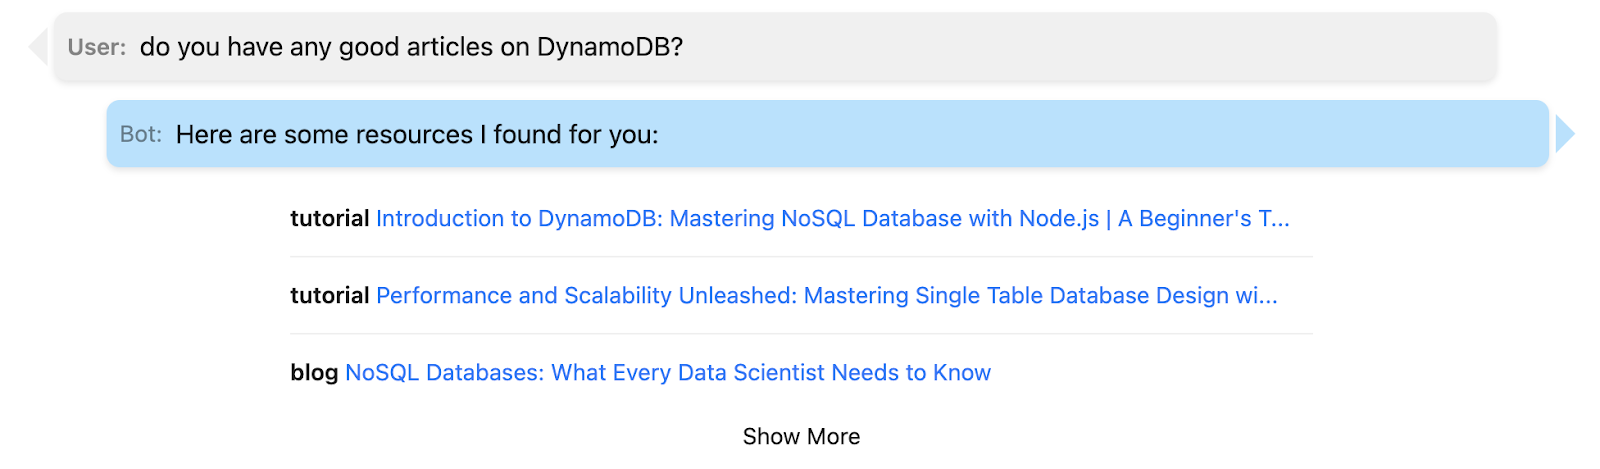
Con todo esto en marcha, crear una interfaz de chat es bastante directo. Los detalles de implementación quedan fuera del alcance de este artículo, pero aquí tienes algunos ejemplos usando mi dataset de DataCamp, que incluye más de 600 registros:
En este artículo hemos explorado el potente mundo de las bases de datos vectoriales, aprovechando PG Vector para mejorar nuestras capacidades de almacenamiento y recuperación. Si te animas a profundizar en los embeddings vectoriales, todavía hay mucho por descubrir. Para saber más sobre PG Vector, consulta su readme, que entra en detalle e incluye enlaces a clientes para tu lenguaje de programación favorito.
Una evolución natural tras entender los embeddings es la Retrieval Augmented Generation (RAG). Consiste en inyectar datos contextuales en los LLMs. Al hacerlo, RAG aporta al modelo conocimiento externo a sus datos de entrenamiento, permitiendo respuestas más informadas y relevantes al contexto.
También encontrarás una variedad de recursos de DataCamp que cubren otros aspectos de las bases de datos vectoriales, entre ellos:
¡Feliz programación y que tus proyectos basados en vectores sean tan reveladores como gratificantes!
¡Sigue hoy con tu viaje vectorial!
Curso
Curso
Curso
blog
Moez Ali
14 min
blog
Kurtis Pykes
11 min
blog
Zoumana Keita
14 min
Tutorial
Moez Ali
10 min
Tutorial
Avinash Navlani
15 min
Tutorial
Joanne Xiong
11 min