Curso
Conceptos de MLOps
2 h
45.3K
¿Alguna vez has revisado un proyecto de machine learning y te has preguntado por qué tomaste ciertas decisiones o incluso qué hace exactamente el código? Por ejemplo, por qué elegiste ese subconjunto de variables, con qué versión de los datos entrenaste el modelo final o cómo afectaron distintos conjuntos de hiperparámetros al rendimiento. ¡Suena a que necesitas incorporar buenas prácticas de experimentación en tus proyectos de machine learning!
La experimentación en machine learning es el proceso de diseñar, construir, registrar y evaluar una canalización de ML para identificar el modelo que alcanza el rendimiento deseado según una o varias métricas (por ejemplo, F1, RMSE, etc.). Es un paso clave tanto antes del despliegue como en el reentrenamiento. Como cualquier experimento, debería estar diseñado para:
Si tienes estos objetivos en mente, te asegurarás de poder encontrar con facilidad lo que necesites —como los hiperparámetros de un modelo o una versión de un conjunto de datos— y compartir información como el rendimiento del modelo y el código fuente.
Por suerte, aquí es donde entra Weights & Biases.
Weights & Biases es una plataforma y librería de Python para que los ingenieros de machine learning ejecuten experimentos, registren artefactos, automaticen el ajuste de hiperparámetros y evalúen el rendimiento. En este tutorial verás la funcionalidad básica con una canalización de ML donde registramos los elementos clave y luego los analizamos en un panel.
# Install Python library
!pip install wandb
Para iniciar sesión, primero tendrás que crear una cuenta.
Una vez creada, visita la página de autorización para obtener tu clave de API y poder iniciar sesión. Guárdala y no la compartas con nadie.
Para iniciar sesión, abre un nuevo terminal y escribe wandb login o añade una celda al cuaderno y ejecuta !wandb login.
Se te pedirá que introduzcas tu clave de API; pégala para iniciar sesión correctamente. Tus credenciales se almacenarán localmente en ~/.netrc a partir de entonces.
wandb loginWeights & Biases incluye varios componentes: Experiments, Artifacts, Sweeps y Models. Empecemos por el núcleo del flujo de trabajo: crear y ejecutar experimentos.
# Import required modules
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import wandb
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
En Weights & Biases, un Experiment también se conoce como proyecto. Para crear uno nuevo, llama a la función wand.init() y pasa el nombre como cadena al argumento project. Puedes asignarlo a una variable llamada run para registrar en ella archivos, modelos y métricas importantes.
Opcionalmente, puedes indicar una cadena en el argumento job_type para distinguir fácilmente pasos como EDA, ingeniería de características o ajuste de hiperparámetros. Además, puedes registrar el código ejecutado estableciendo save_code en True.
# Initialize a run
run = wandb.init(project="predicting_london_temperature",
                 job_type="Baseline modeling",
save_code=True)Puedes registrar cualquier información importante —conjuntos de datos, variables o archivos— como Artifact. Primero crea una variable con wandb.Artifact(), indicando nombre y tipo. Después regístrala con wandb.log_artifact(). Empecemos registrando el conjunto de datos original.
original_data = "london_weather.csv"
# Create an Artifact
data_artifact = wandb.Artifact(name="original_dataset",
                               type="data",
                               description="London weather dataset")
# Add the file to the Artifact
data_artifact.add_file(original_data)
# Log the Artifact as part of the run
run.log_artifact(data_artifact)El análisis exploratorio de datos (EDA) es un paso esencial en el flujo de trabajo de ML: te ayuda a comprobar que los datos tienen los tipos adecuados y están libres de valores ausentes y atípicos. También es una oportunidad para examinar distribuciones y relaciones entre variables.
La ventaja de usar Weights & Biases es que podemos ir registrando los datos según los preprocesamos, junto con las visualizaciones generadas.
# Read in the data
london = pd.read_csv(original_data)

# Previewing the first five rows
london.head()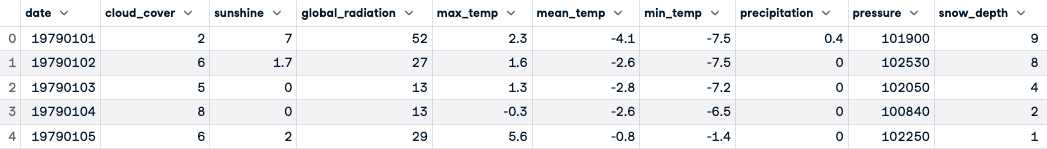
# Visualize distributions
plt.figure(figsize=(12,8))
london.hist()
plt.tight_layout()
plt.show()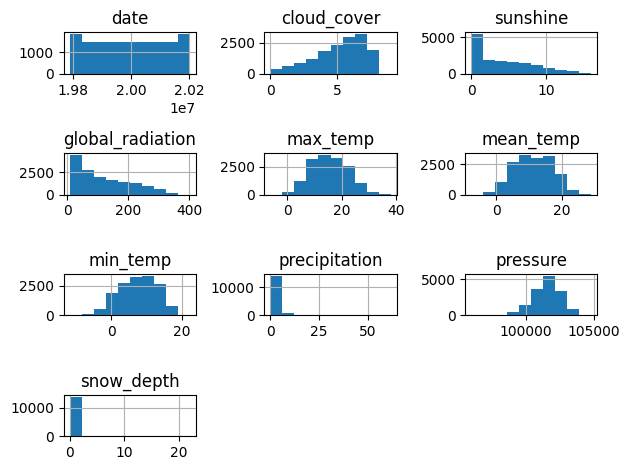
# View data types and non-null counts
london.info()


<class 'pandas.core.frame.DataFrame'>
RangeIndex: 15341 entries, 0 to 15340
Data columns (total 10 columns):
 #   Column            Non-Null Count  Dtype
---  ------            --------------  -----
 0   date              15341 non-null  int64
 1   cloud_cover       15322 non-null  float64
 2   sunshine          15341 non-null  float64
 3   global_radiation  15322 non-null  float64
 4   max_temp          15335 non-null  float64
 5   mean_temp         15305 non-null  float64
 6   min_temp          15339 non-null  float64
 7   precipitation     15335 non-null  float64
 8   pressure          15337 non-null  float64
 9   snow_depth        13900 non-null  float64
dtypes: float64(9), int64(1)
memory usage: 1.2 MB


# Convert date to datetime
london["date"] = pd.to_datetime(london["date"], format="%Y%m%d")

# Add a month column
london["month"] = london["date"].dt.month

# Drop missing values
london.dropna(inplace=True)
Ahora que los datos están limpios, puedes registrarlos como Artifact con wand.Artifact().
# Save and log the new version of the data
london.to_csv("london_weather_preprocessed.csv", index=False)
preprocessed_data = "london_weather_preprocessed.csv"
# Create an Artifact
preprocessed_data_artifact = wandb.Artifact(name="london_weather_preprocessed",
                               type="data",
                               description="London weather dataset - preprocessed")
# Add the file to the Artifact
preprocessed_data_artifact.add_file(preprocessed_data)
# Log the Artifact as part of the run
run.log_artifact(preprocessed_data_artifact)


<wandb.sdk.artifacts.local_artifact.Artifact at 0x15bfe6710>El siguiente paso es identificar posibles variables para el modelado evitando la multicolinealidad. Para ello, primero genera un mapa de calor de correlaciones y luego usa Ridge Regression para cuantificar la importancia de las variables al predecir "mean_temperature".
# Correlation heatmap
sns.heatmap(london.corr(), annot=True, center=True)
plt.show()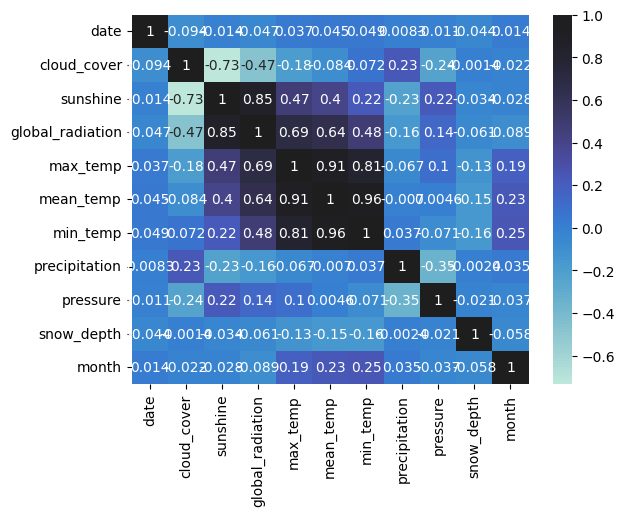
¡Puedes registrar esta figura con wandb.Image()!
# Log the heatmap
wandb.log({"correlation_heatmap": wandb.Image(plt)})


# Split the data
X = london.drop(columns=["mean_temp", "min_temp", "max_temp", "date"])
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

# Build a Ridge regression model
ridge = Ridge(alpha=0.1)
ridge.fit(X_train, y_train)
y_pred = ridge.predict(X_test)

# Visualize feature importance using the coefficients
fig = plt.figure()
sns.barplot(x=X_train.columns, y=ridge.coef_)
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("feature_selection.png")
plt.show()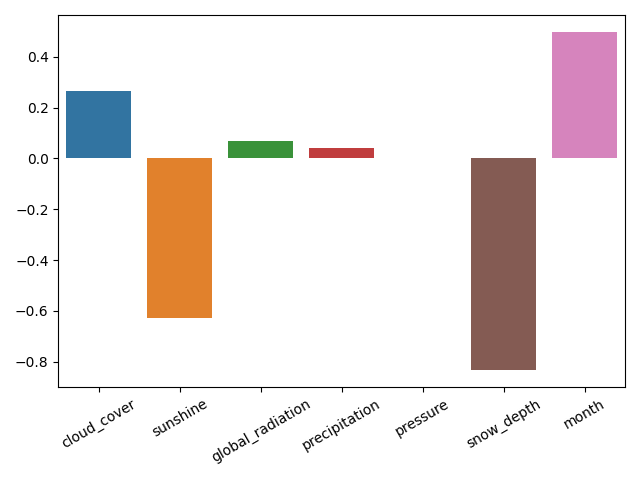
Guardemos el modelo y la gráfica de importancia de variables con pickle.dump() y wandb.log().
import pickle
pickle.dump(ridge, open("feature_selection_model.pkl", "wb"))
feature_selection_model = wandb.Artifact("feature_selection_model", type="model")
feature_selection_model.add_file("feature_selection_model.pkl")
run.log_artifact(feature_selection_model)
wandb.log({"feature_selection_plot": wandb.Image(fig)})


<Figure size 640x480 with 0 Axes>¡Llegaste hasta aquí! Toca entrenar tu modelo base usando las variables importantes identificadas (aquellas con coeficiente de Ridge mayor que cero). También registrarás los nuevos datos de entrenamiento y prueba.
X = london[["cloud_cover", "global_radiation", "precipitation", "month"]]
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

def log_data(X_train, y_train, X_test, y_test):
    # Log the training and test data
    training_features = wandb.Artifact(name="X_train",
                               type="data",
                               description="Training features")
    X_train.to_csv("X_train.csv", index=False)
    training_features.add_file("X_train.csv")
    run.log_artifact(training_features)

    training_labels = wandb.Artifact(name="y_train",
                               type="data",
                               description="Training labels")
    y_train.to_csv("y_train.csv", index=False)

    training_labels.add_file("y_train.csv")
    run.log_artifact(training_labels)

    test_features = wandb.Artifact(name="X_test",
                               type="data",
                               description="Test features")
    X_test.to_csv("X_test.csv", index=False)
    test_features.add_file("X_test.csv")
    run.log_artifact(test_features)

    test_labels = wandb.Artifact(name="y_test",
                               type="data",
                               description="Test labels")
    y_test.to_csv("y_test.csv", index=False)
    test_labels.add_file("y_test.csv")
    run.log_artifact(test_labels)

log_data(X_train, y_train, X_test, y_test)
Vamos a entrenar y evaluar un modelo de regresión con árboles de decisión, usando el error cuadrático medio raíz (RMSE) y R cuadrado como métricas de rendimiento.
# Fit and evaluate the model
dt_reg = DecisionTreeRegressor(random_state=42)
dt_reg.fit(X_train, y_train)
y_pred = dt_reg.predict(X_test)
rmse = mean_squared_error(y_test, y_pred, squared=False)
r_squared = r2_score(y_test, y_pred)
print(rmse, r_squared)


3.8627385194713346 0.5399282872125385

# Save and log the model and metrics
pickle.dump(dt_reg, open("baseline_decision_tree.pkl", "wb"))
baseline_model = wandb.Artifact("baseline_decision_tree", type="model")
baseline_model.add_file("baseline_decision_tree.pkl")
run.log_artifact(baseline_model)
wandb.log({"rmse": rmse, "r_squared": r_squared})
Puedes profundizar en el rendimiento del modelo visualizando los residuales. Weights & Biases incluye una función en su módulo de sklearn para generarlos.
# Plot training residuals
wandb.log({"baseline_residuals_plot": wandb.sklearn.plot_residuals(dt_reg, X_train, y_train)})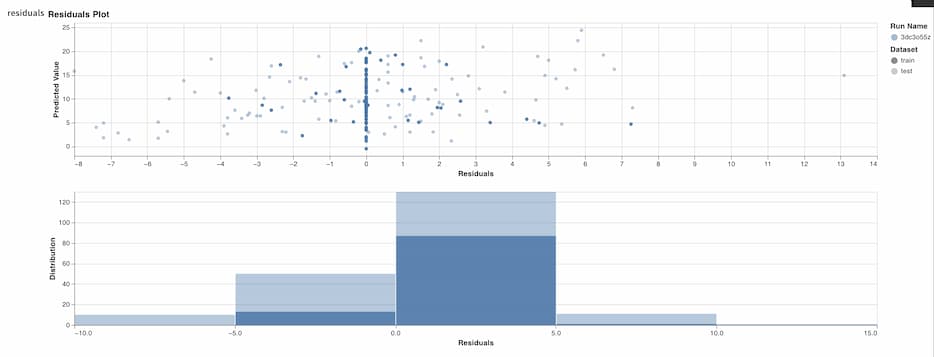
El entrenamiento y la evaluación han terminado, así que cerremos la ejecución actual.
# Finish run
wandb.finish()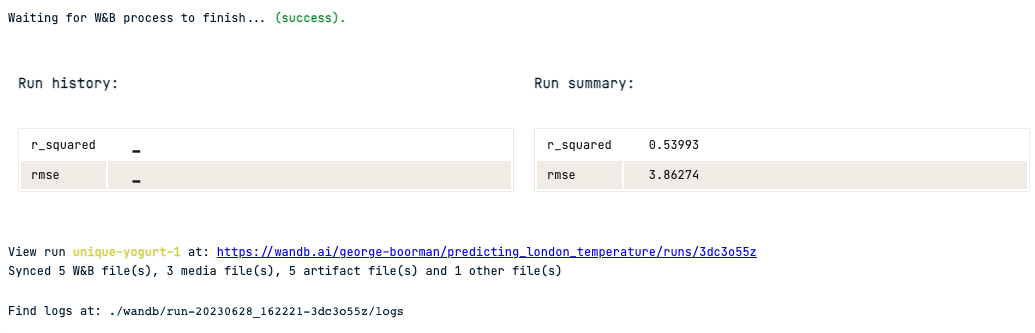
Ahora que has creado y registrado un modelo base con sus métricas de rendimiento asociadas, veamos cómo puedes ajustar hiperparámetros y versionar tus modelos con Weights & Biases y scikit-learn.
Usaremos GridSearchCV para buscar el mejor modelo en un espacio de hiperparámetros, tomando el RMSE como referencia.
# Initialize a new run
run_v2 = wandb.init(project="predicting_london_temperature",
                 job_type="Hyperparameter tuning",
                 save_code=True)

# Split the data and create a KFold object
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# Create the hyperparameter space
params = {"max_depth":[2, 5, 8, 12, 20],
          "min_samples_split": [2, 5, 8, 12, 20],
          "max_features": [1, 2, 3, 4],
          "random_state": [42]
          }

# Create a GridSearchCV object
dt_reg = DecisionTreeRegressor()
dt_reg_cv = GridSearchCV(dt_reg,
                         params,
                         cv=kf,
                         scoring="neg_root_mean_squared_error")

# Fit the data
dt_reg_cv.fit(X_train, y_train)

# Evaluate and log performance
## GridSearchCV uses negative RMSE
## so you can convert it to positive
print(f"Best RMSE: {-1 * dt_reg_cv.best_score_})")
print(f"Best model: {dt_reg_cv.best_estimator_}")

# Save and log the model, metrics, and parameters
pickle.dump(dt_reg_cv, open("tuned_decision_tree.pkl", "wb"))
tuned_decision_tree = wandb.Artifact("tuned_decision_tree", type="model")
tuned_decision_tree.add_file("tuned_decision_tree.pkl")
run_v2.log_artifact(tuned_decision_tree)
wandb.log({"rmse": -1 * dt_reg_cv.best_score_})
wandb.finish()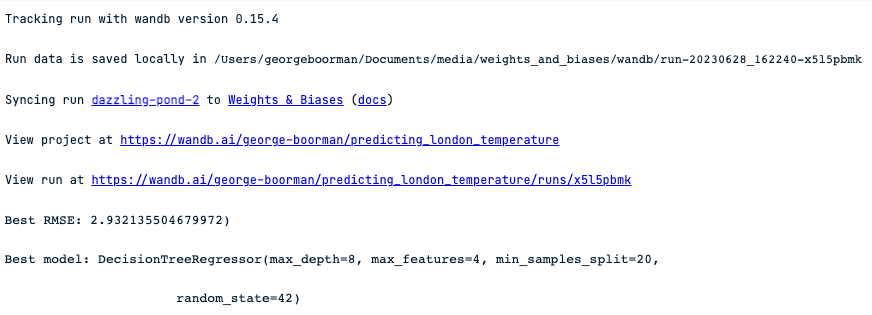
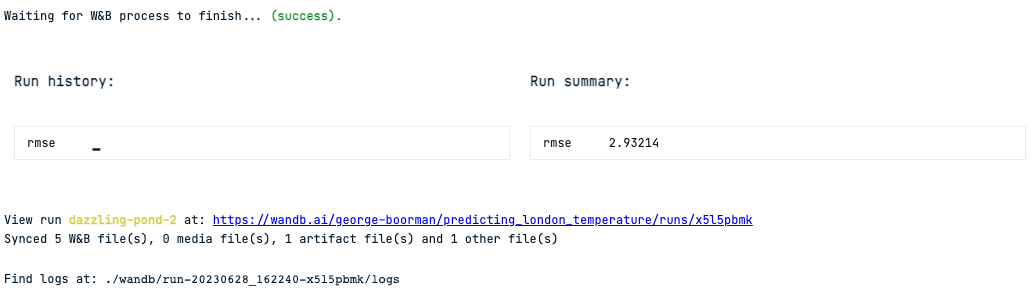
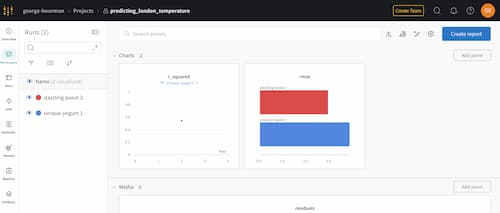
Para revisar ejecuciones y artefactos, ve a www.wandb.ai/<your-profile-name>/projects y selecciona el proyecto que has creado.
Dentro verás cada ejecución que hayas creado, junto con los medios asociados, como gráficas, por ejemplo:
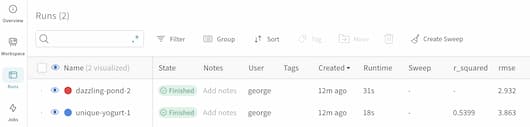
Al hacer clic en el icono Runs, podrás ver todas tus ejecuciones e información clave, incluidas las métricas registradas como RMSE y R cuadrado.
Weights & Biases ofrece mucha más funcionalidad que puedes explorar, como usar artefactos existentes en nuevas ejecuciones, una herramienta de línea de comandos y Prompts para desarrollar LLMs.
Para afianzar tus conocimientos sobre la experimentación en ML y las técnicas más amplias de MLOps, te pueden interesar:
¡Aprende los temas mencionados en este tutorial!
Curso
Curso
Curso
blog
Abid Ali Awan
15 min
blog
Zoumana Keita
14 min
blog
Abid Ali Awan
10 min
Tutorial
Joanne Xiong
11 min
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
12 min