Curso
Conceitos de MLOps
2 h
45.4K
Já olhou para trás em um projeto de machine learning e se perguntou por que tomou certas decisões — ou até o que o código realmente faz? Por exemplo, por que você escolheu este subconjunto de variáveis, em qual versão dos dados treinou o modelo final, ou como diferentes conjuntos de hiperparâmetros afetaram o desempenho? Se identificou? Então está na hora de adotar boas práticas de experimentação nos seus projetos de machine learning!
Experimentação em machine learning é o processo de projetar, construir, registrar e avaliar um pipeline de machine learning para identificar o modelo que atinge o desempenho desejado segundo uma ou mais métricas, como F1-score, RMSE etc. É uma etapa crucial no desenvolvimento de modelos, tanto antes da produção quanto em ciclos de retreinamento. Como qualquer experimento, ela deve ser pensada para:
Com esses objetivos em mente, você garante que encontra rápido o que precisa — como os hiperparâmetros de um modelo ou a versão de um dataset — e consegue compartilhar informações como desempenho do modelo e código-fonte.
É aqui que entra o Weights & Biases!
Weights & Biases é uma plataforma e biblioteca Python para engenheiros de machine learning executarem experimentos, registrarem artefatos, automatizarem o ajuste de hiperparâmetros e avaliarem performance. Este tutorial apresenta as funcionalidades essenciais mostrando um pipeline de machine learning em que os elementos-chave são registrados e depois analisados em um dashboard!
# Install Python library
!pip install wandb
Para fazer login, você precisa criar uma conta.
Depois, acesse a página de autorização para obter sua chave de API e usá-la no login. Guarde essa chave e não compartilhe com ninguém!
Para fazer login, abra um novo Terminal e digite wandb login ou adicione uma nova célula no notebook e execute !wandb login.
Você vai informar a chave de API (copiar e colar) para concluir o login. Suas credenciais ficam salvas localmente em ~/.netrc.
wandb loginO Weights & Biases tem vários componentes, incluindo Experiments, Artifacts, Sweeps e Models. Vamos começar pelo coração do fluxo: criar e executar experimentos.
# Import required modules
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import wandb
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
No Weights & Biases, um Experiment também é chamado de projeto. Para criar um novo projeto, chamamos a função wand.init(), passando o nome como string no argumento project. Você pode atribuir o retorno a uma variável chamada run para registrar arquivos importantes, modelos e métricas nesse run.
Opcionalmente, você também pode informar uma string no argumento job_type para diferenciar etapas como EDA, engenharia de atributos ou ajuste de hiperparâmetros. Além disso, o código executado pode ser registrado definindo save_code como True.
# Initialize a run
run = wandb.init(project="predicting_london_temperature",
                 job_type="Baseline modeling",
save_code=True)Você pode registrar qualquer informação importante — como datasets, variáveis ou arquivos — como um Artifact. Para isso, crie primeiro um objeto com wandb.Artifact(), informando nome e tipo. Depois, registre com a função run.log_artifact(). Vamos começar registrando o dataset original.
original_data = "london_weather.csv"
# Create an Artifact
data_artifact = wandb.Artifact(name="original_dataset",
                               type="data",
                               description="London weather dataset")
# Add the file to the Artifact
data_artifact.add_file(original_data)
# Log the Artifact as part of the run
run.log_artifact(data_artifact)A análise exploratória de dados (EDA) é uma etapa fundamental no fluxo de machine learning. Ela ajuda a validar tipos de dados, identificar ausências e outliers, além de explorar distribuições e relações entre variáveis.
Com o Weights & Biases, você ainda ganha o benefício de registrar os dados conforme faz o pré-processamento, junto com quaisquer visualizações geradas.
# Read in the data
london = pd.read_csv(original_data)

# Previewing the first five rows
london.head()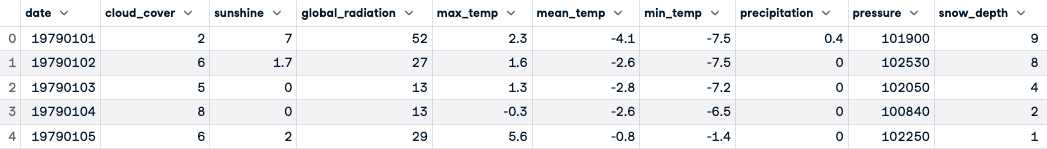
# Visualize distributions
plt.figure(figsize=(12,8))
london.hist()
plt.tight_layout()
plt.show()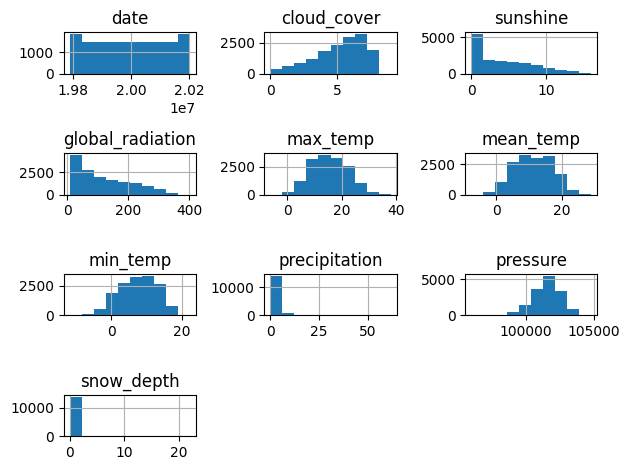
# View data types and non-null counts
london.info()


<class 'pandas.core.frame.DataFrame'>
RangeIndex: 15341 entries, 0 to 15340
Data columns (total 10 columns):
 #   Column            Non-Null Count  Dtype
---  ------            --------------  -----
 0   date              15341 non-null  int64
 1   cloud_cover       15322 non-null  float64
 2   sunshine          15341 non-null  float64
 3   global_radiation  15322 non-null  float64
 4   max_temp          15335 non-null  float64
 5   mean_temp         15305 non-null  float64
 6   min_temp          15339 non-null  float64
 7   precipitation     15335 non-null  float64
 8   pressure          15337 non-null  float64
 9   snow_depth        13900 non-null  float64
dtypes: float64(9), int64(1)
memory usage: 1.2 MB


# Convert date to datetime
london["date"] = pd.to_datetime(london["date"], format="%Y%m%d")

# Add a month column
london["month"] = london["date"].dt.month

# Drop missing values
london.dropna(inplace=True)
Agora que os dados foram limpos, você pode registrá-los como um Artifact usando wand.Artifact().
# Save and log the new version of the data
london.to_csv("london_weather_preprocessed.csv", index=False)
preprocessed_data = "london_weather_preprocessed.csv"
# Create an Artifact
preprocessed_data_artifact = wandb.Artifact(name="london_weather_preprocessed",
                               type="data",
                               description="London weather dataset - preprocessed")
# Add the file to the Artifact
preprocessed_data_artifact.add_file(preprocessed_data)
# Log the Artifact as part of the run
run.log_artifact(preprocessed_data_artifact)


<wandb.sdk.artifacts.local_artifact.Artifact at 0x15bfe6710>A próxima etapa é identificar variáveis preditoras para o modelo, evitando multicolinearidade. Para isso, primeiro gere um mapa de calor de correlações e depois use Ridge Regression para quantificar a importância das variáveis na predição de "mean_temperature".
# Correlation heatmap
sns.heatmap(london.corr(), annot=True, center=True)
plt.show()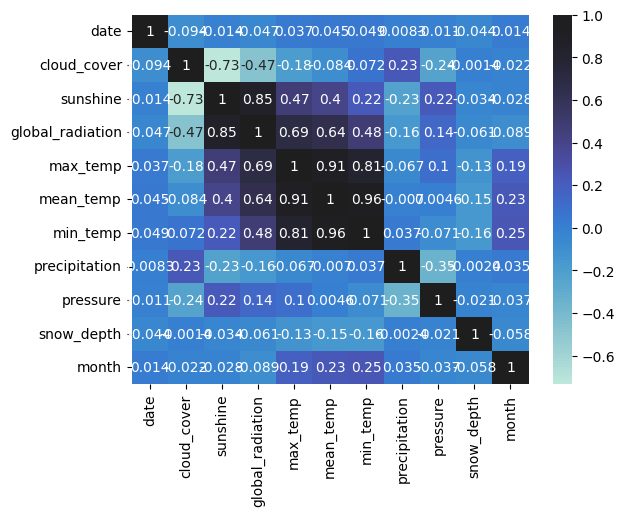
Você pode registrar esse gráfico usando wandb.Image()!
# Log the heatmap
wandb.log({"correlation_heatmap": wandb.Image(plt)})


# Split the data
X = london.drop(columns=["mean_temp", "min_temp", "max_temp", "date"])
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

# Build a Ridge regression model
ridge = Ridge(alpha=0.1)
ridge.fit(X_train, y_train)
y_pred = ridge.predict(X_test)

# Visualize feature importance using the coefficients
fig = plt.figure()
sns.barplot(x=X_train.columns, y=ridge.coef_)
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("feature_selection.png")
plt.show()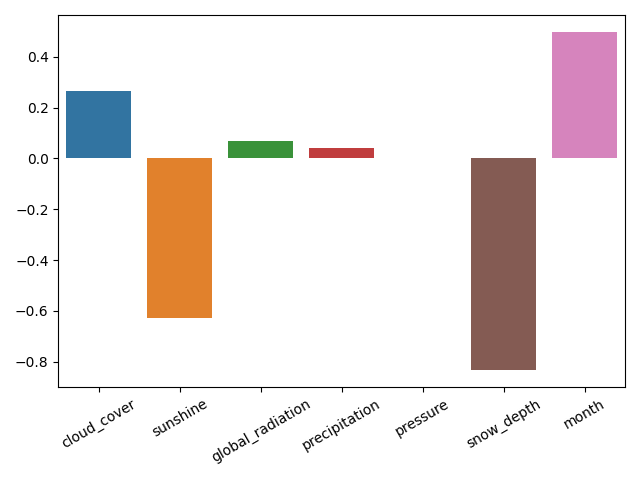
Vamos salvar o modelo e o gráfico de importância das variáveis usando pickle.dump() e wandb.log().
import pickle
pickle.dump(ridge, open("feature_selection_model.pkl", "wb"))
feature_selection_model = wandb.Artifact("feature_selection_model", type="model")
feature_selection_model.add_file("feature_selection_model.pkl")
run.log_artifact(feature_selection_model)
wandb.log({"feature_selection_plot": wandb.Image(fig)})


<Figure size 640x480 with 0 Axes>Bora lá! Hora de treinar seu modelo baseline usando as variáveis identificadas como importantes — aquelas com coeficiente maior que zero no Ridge. Você também vai registrar os novos conjuntos de treino e teste.
X = london[["cloud_cover", "global_radiation", "precipitation", "month"]]
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

def log_data(X_train, y_train, X_test, y_test):
    # Log the training and test data
    training_features = wandb.Artifact(name="X_train",
                               type="data",
                               description="Training features")
    X_train.to_csv("X_train.csv", index=False)
    training_features.add_file("X_train.csv")
    run.log_artifact(training_features)

    training_labels = wandb.Artifact(name="y_train",
                               type="data",
                               description="Training labels")
    y_train.to_csv("y_train.csv", index=False)

    training_labels.add_file("y_train.csv")
    run.log_artifact(training_labels)

    test_features = wandb.Artifact(name="X_test",
                               type="data",
                               description="Test features")
    X_test.to_csv("X_test.csv", index=False)
    test_features.add_file("X_test.csv")
    run.log_artifact(test_features)

    test_labels = wandb.Artifact(name="y_test",
                               type="data",
                               description="Test labels")
    y_test.to_csv("y_test.csv", index=False)
    test_labels.add_file("y_test.csv")
    run.log_artifact(test_labels)

log_data(X_train, y_train, X_test, y_test)
Vamos treinar e avaliar um modelo de árvore de decisão para regressão, usando o erro quadrático médio raiz (RMSE) e o R-quadrado como métricas.
# Fit and evaluate the model
dt_reg = DecisionTreeRegressor(random_state=42)
dt_reg.fit(X_train, y_train)
y_pred = dt_reg.predict(X_test)
rmse = mean_squared_error(y_test, y_pred, squared=False)
r_squared = r2_score(y_test, y_pred)
print(rmse, r_squared)


3.8627385194713346 0.5399282872125385

# Save and log the model and metrics
pickle.dump(dt_reg, open("baseline_decision_tree.pkl", "wb"))
baseline_model = wandb.Artifact("baseline_decision_tree", type="model")
baseline_model.add_file("baseline_decision_tree.pkl")
run.log_artifact(baseline_model)
wandb.log({"rmse": rmse, "r_squared": r_squared})
Você pode aprofundar a análise do desempenho visualizando os resíduos do modelo. O Weights & Biases tem uma função no módulo sklearn para gerar isso!
# Plot training residuals
wandb.log({"baseline_residuals_plot": wandb.sklearn.plot_residuals(dt_reg, X_train, y_train)})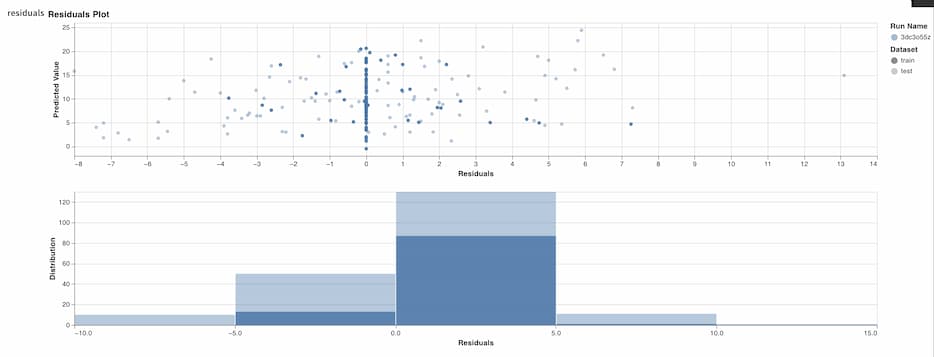
Treinamento e avaliação concluídos. Vamos encerrar o run atual.
# Finish run
wandb.finish()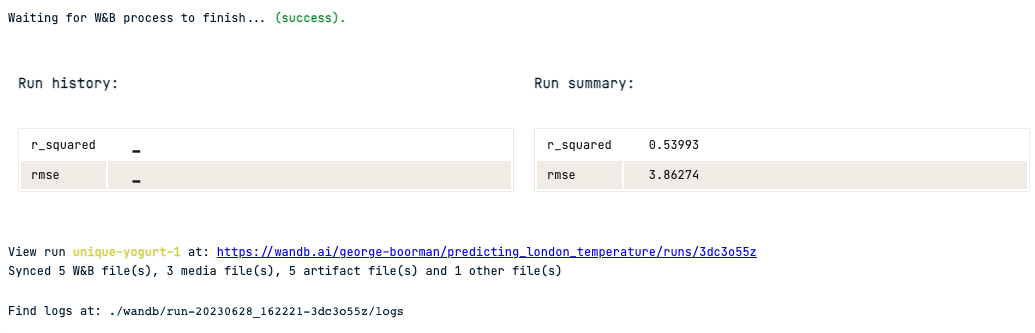
Agora que você criou e registrou um modelo baseline com suas métricas de desempenho, vamos ver como ajustar hiperparâmetros e versionar modelos usando Weights & Biases e scikit-learn.
Usaremos GridSearchCV para buscar o melhor modelo em um espaço de hiperparâmetros, com base no RMSE.
# Initialize a new run
run_v2 = wandb.init(project="predicting_london_temperature",
                 job_type="Hyperparameter tuning",
                 save_code=True)

# Split the data and create a KFold object
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# Create the hyperparameter space
params = {"max_depth":[2, 5, 8, 12, 20],
          "min_samples_split": [2, 5, 8, 12, 20],
          "max_features": [1, 2, 3, 4],
          "random_state": [42]
          }

# Create a GridSearchCV object
dt_reg = DecisionTreeRegressor()
dt_reg_cv = GridSearchCV(dt_reg,
                         params,
                         cv=kf,
                         scoring="neg_root_mean_squared_error")

# Fit the data
dt_reg_cv.fit(X_train, y_train)

# Evaluate and log performance
## GridSearchCV uses negative RMSE
## so you can convert it to positive
print(f"Best RMSE: {-1 * dt_reg_cv.best_score_})")
print(f"Best model: {dt_reg_cv.best_estimator_}")

# Save and log the model, metrics, and parameters
pickle.dump(dt_reg_cv, open("tuned_decision_tree.pkl", "wb"))
tuned_decision_tree = wandb.Artifact("tuned_decision_tree", type="model")
tuned_decision_tree.add_file("tuned_decision_tree.pkl")
run_v2.log_artifact(tuned_decision_tree)
wandb.log({"rmse": -1 * dt_reg_cv.best_score_})
wandb.finish()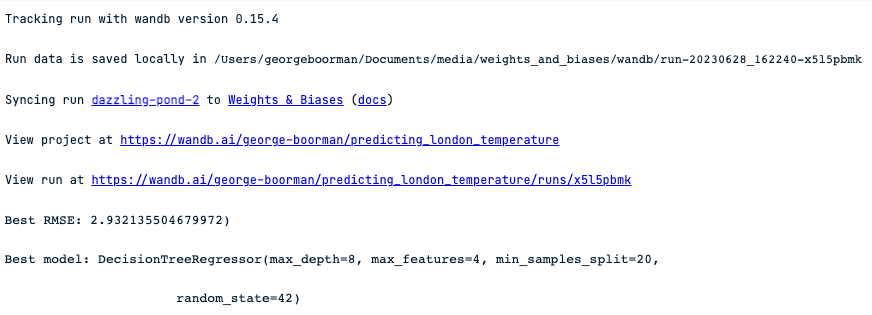
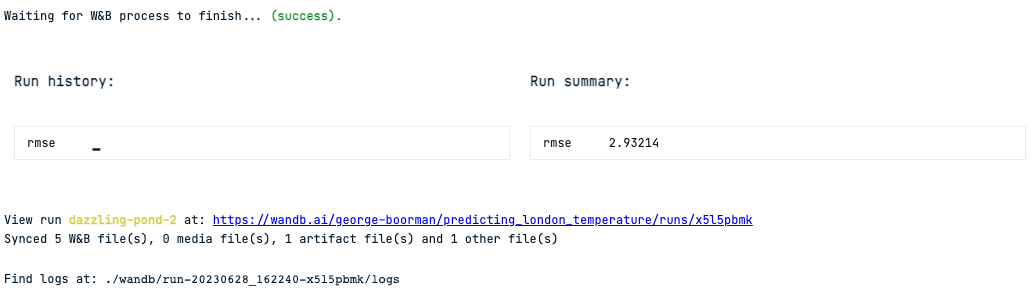
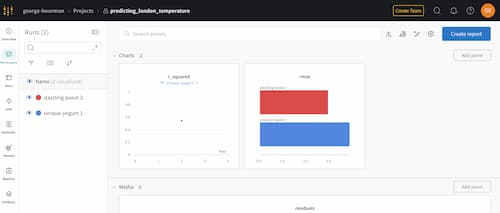
Para explorar runs e artefatos, acesse www.wandb.ai/<your-profile-name>/projects e selecione o projeto que você criou.
Lá dentro, você verá cada run criado e as mídias associadas, como gráficos, assim:
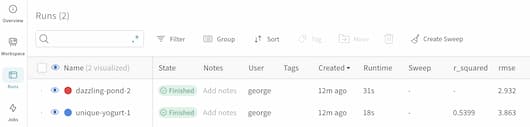
Clicando no ícone Runs, você confere todos os runs e informações-chave, incluindo métricas registradas como RMSE e R-quadrado.
O Weights & Biases tem muito mais recursos para você explorar, como usar artefatos existentes em novos runs, a ferramenta de linha de comando e Prompts para desenvolvimento de LLMs!
Para reforçar seu conhecimento sobre experimentação em machine learning e técnicas mais amplas de MLOps, vale conferir:
Aprenda os tópicos citados neste tutorial!
Curso
Curso
Curso
blog
Abid Ali Awan
7 min
Tutorial
Zoumana Keita
14 min
Tutorial
Amberle McKee
15 min
Tutorial
Sejal Jaiswal
15 min
Tutorial
Moez Ali
11 min
Tutorial
Abid Ali Awan
12 min