Cours
Concepts MLOps
2 h
45.4K
Vous est-il déjà arrivé de revenir sur un projet de machine learning en vous demandant pourquoi vous avez pris certaines décisions, ou même ce que fait réellement le code ? Par exemple, pourquoi avoir choisi ce sous-ensemble de variables, sur quelle version des données avez-vous entraîné le modèle final, ou comment différents jeux d’hyperparamètres ont-ils influé sur les performances ? Il est temps d’intégrer les bonnes pratiques d’expérimentation à vos projets de machine learning !
L’expérimentation en machine learning consiste à concevoir, construire, consigner et évaluer un pipeline de machine learning afin d’identifier le modèle qui atteint le niveau de performance visé selon un ou plusieurs indicateurs (par exemple F1-score, RMSE, etc.). C’est une étape clé du développement de modèles, en amont de la mise en production comme pour le réentraînement. Comme toute expérimentation, elle doit être conçue pour :
En gardant ces objectifs en tête, vous vous assurez de pouvoir retrouver facilement ce dont vous avez besoin (hyperparamètres d’un modèle, version d’un jeu de données, etc.) et de partager les informations utiles (performances du modèle, code source, etc.).
Heureusement, c’est précisément là que Weights & Biases entre en jeu !
Weights & Biases est une plateforme et une bibliothèque Python destinée aux ingénieurs en machine learning pour exécuter des expériences, consigner des artefacts, automatiser l’optimisation d’hyperparamètres et évaluer les performances. Ce tutoriel présente les fonctionnalités essentielles en montrant un pipeline de machine learning dont les éléments clés sont consignés puis analysés dans un tableau de bord !
# Install Python library
!pip install wandb
Pour vous connecter, vous devez d’abord créer un compte.
Une fois le compte créé, rendez-vous sur la page d’autorisation pour récupérer votre clé d’API, qui vous servira à vous connecter. Conservez-la précieusement et ne la partagez avec personne.
Pour vous connecter, ouvrez un nouveau terminal et saisissez wandb login, ou ajoutez une cellule à votre notebook et exécutez !wandb login.
Vous serez invité à fournir votre clé d’API, que vous pourrez coller pour finaliser la connexion. Vos identifiants seront ensuite stockés localement dans ~/.netrc.
wandb loginWeights & Biases comprend plusieurs composants, notamment Experiments, Artifacts, Sweeps et Models. Commençons par le cœur du flux de travail : créer et exécuter des expériences.
# Import required modules
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import wandb
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
Dans Weights & Biases, une Experiment est aussi appelée projet. Pour créer un nouveau projet, on appelle la fonction wand.init() et on transmet le nom du projet via l’argument project. Vous pouvez l’assigner à une variable nommée run afin d’y consigner les fichiers, modèles et métriques importants.
En option, vous pouvez aussi fournir une chaîne à l’argument job_type pour distinguer facilement les étapes (EDA, ingénierie des variables, optimisation d’hyperparamètres, etc.). De plus, le code exécuté peut être enregistré en définissant save_code à True.
# Initialize a run
run = wandb.init(project="predicting_london_temperature",
                 job_type="Baseline modeling",
save_code=True)Vous pouvez consigner toute information importante (jeux de données, variables, fichiers, etc.) sous forme d’Artifact. Pour cela, créez d’abord une variable avec wandb.Artifact() en précisant le nom et le type. Puis consignez-la avec wandb.log_artifact(). Commençons par enregistrer le jeu de données d’origine.
original_data = "london_weather.csv"
# Create an Artifact
data_artifact = wandb.Artifact(name="original_dataset",
                               type="data",
                               description="London weather dataset")
# Add the file to the Artifact
data_artifact.add_file(original_data)
# Log the Artifact as part of the run
run.log_artifact(data_artifact)L’analyse exploratoire des données (EDA) est une étape essentielle du workflow de machine learning. Elle permet de vérifier les types, de traiter les valeurs manquantes et les valeurs aberrantes, et d’examiner les distributions et relations entre variables.
Avec Weights & Biases, vous pouvez en prime consigner les données au fil du prétraitement, ainsi que les visualisations produites.
# Read in the data
london = pd.read_csv(original_data)

# Previewing the first five rows
london.head()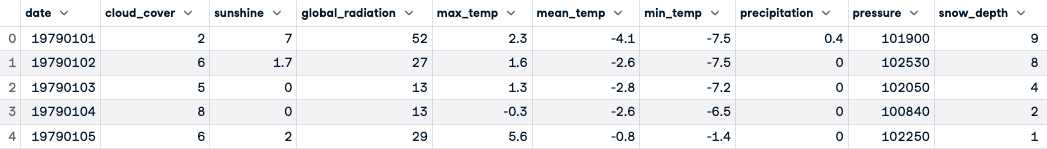
# Visualize distributions
plt.figure(figsize=(12,8))
london.hist()
plt.tight_layout()
plt.show()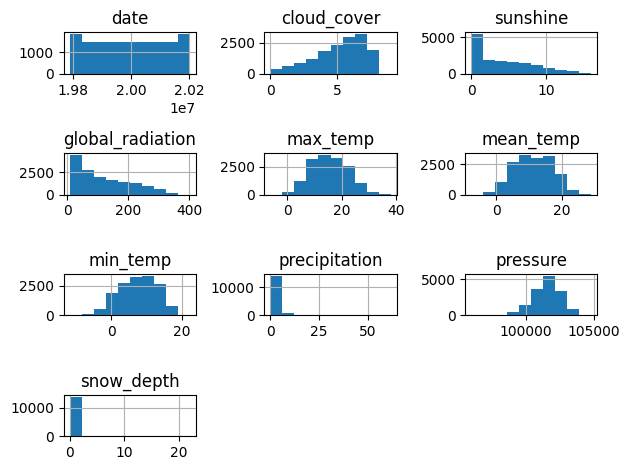
# View data types and non-null counts
london.info()


<class 'pandas.core.frame.DataFrame'>
RangeIndex: 15341 entries, 0 to 15340
Data columns (total 10 columns):
 #   Column            Non-Null Count  Dtype
---  ------            --------------  -----
 0   date              15341 non-null  int64
 1   cloud_cover       15322 non-null  float64
 2   sunshine          15341 non-null  float64
 3   global_radiation  15322 non-null  float64
 4   max_temp          15335 non-null  float64
 5   mean_temp         15305 non-null  float64
 6   min_temp          15339 non-null  float64
 7   precipitation     15335 non-null  float64
 8   pressure          15337 non-null  float64
 9   snow_depth        13900 non-null  float64
dtypes: float64(9), int64(1)
memory usage: 1.2 MB


# Convert date to datetime
london["date"] = pd.to_datetime(london["date"], format="%Y%m%d")

# Add a month column
london["month"] = london["date"].dt.month

# Drop missing values
london.dropna(inplace=True)
Maintenant que les données sont nettoyées, vous pouvez les consigner comme Artifact avec wand.Artifact().
# Save and log the new version of the data
london.to_csv("london_weather_preprocessed.csv", index=False)
preprocessed_data = "london_weather_preprocessed.csv"
# Create an Artifact
preprocessed_data_artifact = wandb.Artifact(name="london_weather_preprocessed",
                               type="data",
                               description="London weather dataset - preprocessed")
# Add the file to the Artifact
preprocessed_data_artifact.add_file(preprocessed_data)
# Log the Artifact as part of the run
run.log_artifact(preprocessed_data_artifact)


<wandb.sdk.artifacts.local_artifact.Artifact at 0x15bfe6710>L’étape suivante consiste à identifier des variables pertinentes pour la modélisation tout en évitant la multicolinéarité. Pour cela, vous pouvez d’abord produire une carte de corrélation, puis utiliser la régression Ridge pour quantifier l’importance des variables dans la prédiction de « mean_temperature ».
# Correlation heatmap
sns.heatmap(london.corr(), annot=True, center=True)
plt.show()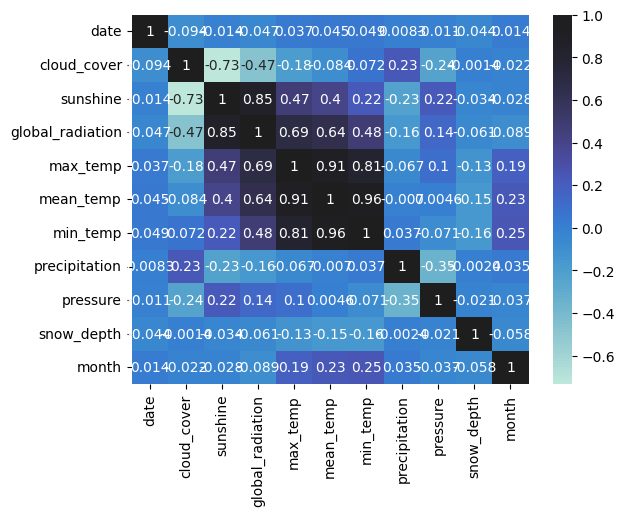
Vous pouvez consigner ce graphique avec wandb.Image() !
# Log the heatmap
wandb.log({"correlation_heatmap": wandb.Image(plt)})


# Split the data
X = london.drop(columns=["mean_temp", "min_temp", "max_temp", "date"])
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

# Build a Ridge regression model
ridge = Ridge(alpha=0.1)
ridge.fit(X_train, y_train)
y_pred = ridge.predict(X_test)

# Visualize feature importance using the coefficients
fig = plt.figure()
sns.barplot(x=X_train.columns, y=ridge.coef_)
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("feature_selection.png")
plt.show()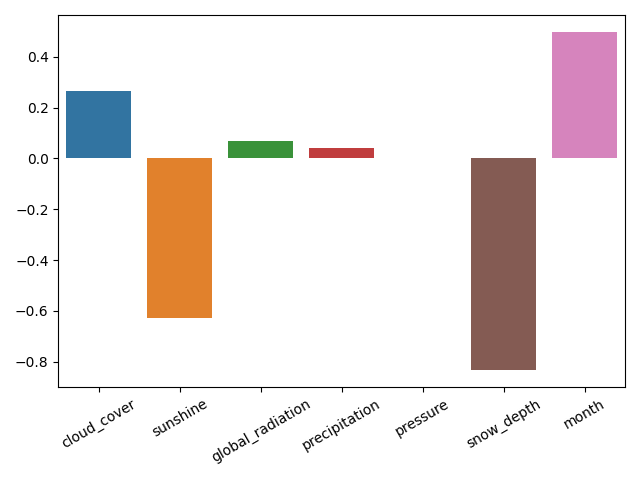
Enregistrons le modèle et le graphique d’importance des variables avec pickle.dump() et wandb.log().
import pickle
pickle.dump(ridge, open("feature_selection_model.pkl", "wb"))
feature_selection_model = wandb.Artifact("feature_selection_model", type="model")
feature_selection_model.add_file("feature_selection_model.pkl")
run.log_artifact(feature_selection_model)
wandb.log({"feature_selection_plot": wandb.Image(fig)})


<Figure size 640x480 with 0 Axes>Vous y êtes ! Il est temps d’entraîner votre modèle de base à partir des variables jugées importantes, c’est‑à‑dire celles dont le coefficient du modèle Ridge est supérieur à zéro. Vous consignerez également les nouveaux jeux d’entraînement et de test.
X = london[["cloud_cover", "global_radiation", "precipitation", "month"]]
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

def log_data(X_train, y_train, X_test, y_test):
    # Log the training and test data
    training_features = wandb.Artifact(name="X_train",
                               type="data",
                               description="Training features")
    X_train.to_csv("X_train.csv", index=False)
    training_features.add_file("X_train.csv")
    run.log_artifact(training_features)

    training_labels = wandb.Artifact(name="y_train",
                               type="data",
                               description="Training labels")
    y_train.to_csv("y_train.csv", index=False)

    training_labels.add_file("y_train.csv")
    run.log_artifact(training_labels)

    test_features = wandb.Artifact(name="X_test",
                               type="data",
                               description="Test features")
    X_test.to_csv("X_test.csv", index=False)
    test_features.add_file("X_test.csv")
    run.log_artifact(test_features)

    test_labels = wandb.Artifact(name="y_test",
                               type="data",
                               description="Test labels")
    y_test.to_csv("y_test.csv", index=False)
    test_labels.add_file("y_test.csv")
    run.log_artifact(test_labels)

log_data(X_train, y_train, X_test, y_test)
Entraînons et évaluons un modèle de régression par arbre de décision, en utilisant la racine de l’erreur quadratique moyenne (RMSE) et le R² comme métriques.
# Fit and evaluate the model
dt_reg = DecisionTreeRegressor(random_state=42)
dt_reg.fit(X_train, y_train)
y_pred = dt_reg.predict(X_test)
rmse = mean_squared_error(y_test, y_pred, squared=False)
r_squared = r2_score(y_test, y_pred)
print(rmse, r_squared)


3.8627385194713346 0.5399282872125385

# Save and log the model and metrics
pickle.dump(dt_reg, open("baseline_decision_tree.pkl", "wb"))
baseline_model = wandb.Artifact("baseline_decision_tree", type="model")
baseline_model.add_file("baseline_decision_tree.pkl")
run.log_artifact(baseline_model)
wandb.log({"rmse": rmse, "r_squared": r_squared})
Vous pouvez aller plus loin dans l’analyse des performances en visualisant les résidus du modèle. Weights & Biases propose une fonction dans son module sklearn pour cela !
# Plot training residuals
wandb.log({"baseline_residuals_plot": wandb.sklearn.plot_residuals(dt_reg, X_train, y_train)})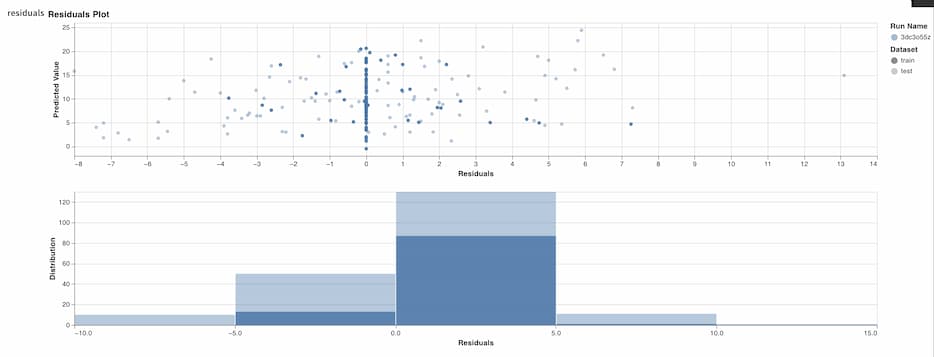
L’entraînement et l’évaluation sont terminés ; clôturons l’exécution en cours.
# Finish run
wandb.finish()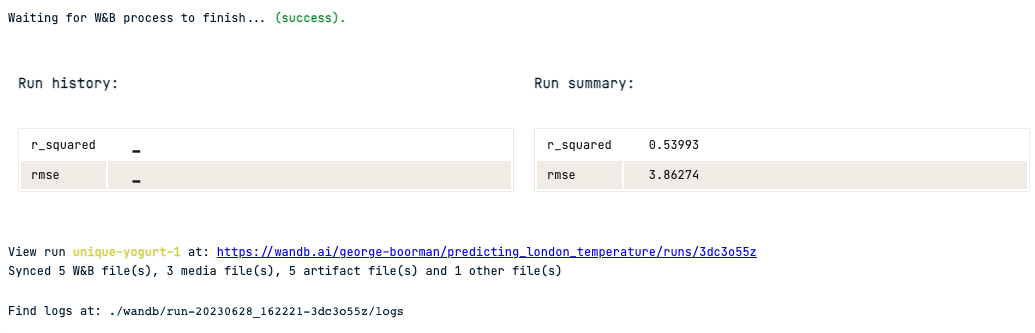
Vous avez maintenant créé et consigné un modèle de base avec ses métriques de performance. Voyons comment régler les hyperparamètres et versionner vos modèles avec Weights & Biases et scikit-learn.
Nous utiliserons GridSearchCV pour rechercher, sur un espace d’hyperparamètres, le meilleur modèle selon la RMSE.
# Initialize a new run
run_v2 = wandb.init(project="predicting_london_temperature",
                 job_type="Hyperparameter tuning",
                 save_code=True)

# Split the data and create a KFold object
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# Create the hyperparameter space
params = {"max_depth":[2, 5, 8, 12, 20],
          "min_samples_split": [2, 5, 8, 12, 20],
          "max_features": [1, 2, 3, 4],
          "random_state": [42]
          }

# Create a GridSearchCV object
dt_reg = DecisionTreeRegressor()
dt_reg_cv = GridSearchCV(dt_reg,
                         params,
                         cv=kf,
                         scoring="neg_root_mean_squared_error")

# Fit the data
dt_reg_cv.fit(X_train, y_train)

# Evaluate and log performance
## GridSearchCV uses negative RMSE
## so you can convert it to positive
print(f"Best RMSE: {-1 * dt_reg_cv.best_score_})")
print(f"Best model: {dt_reg_cv.best_estimator_}")

# Save and log the model, metrics, and parameters
pickle.dump(dt_reg_cv, open("tuned_decision_tree.pkl", "wb"))
tuned_decision_tree = wandb.Artifact("tuned_decision_tree", type="model")
tuned_decision_tree.add_file("tuned_decision_tree.pkl")
run_v2.log_artifact(tuned_decision_tree)
wandb.log({"rmse": -1 * dt_reg_cv.best_score_})
wandb.finish()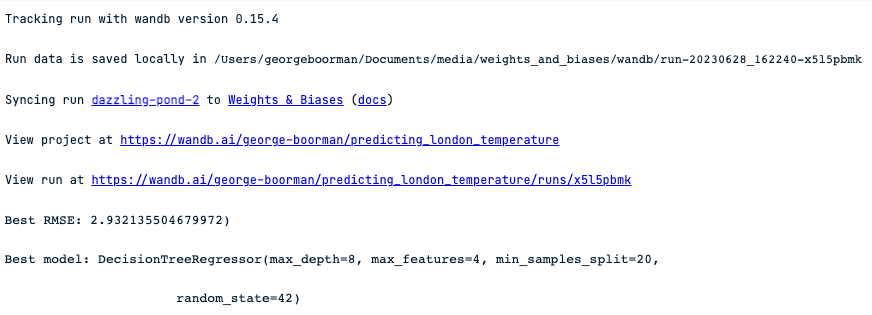
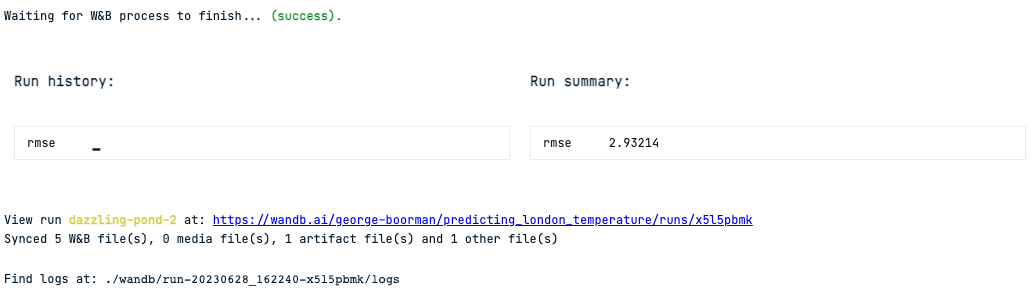
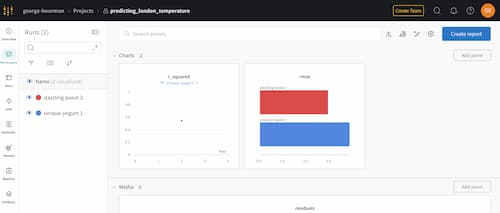
Pour examiner vos exécutions et artefacts, rendez-vous sur www.wandb.ai/<your-profile-name>/projects puis sélectionnez le projet que vous avez créé.
Une fois dedans, vous verrez chaque exécution que vous avez lancée, ainsi que les médias associés (graphiques, etc.), comme ici :
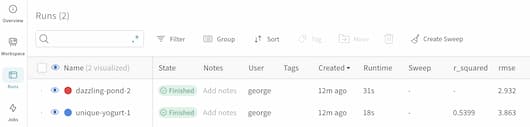
En cliquant sur l’icône Runs, vous pouvez consulter toutes vos exécutions et les informations clés, dont les métriques consignées comme la RMSE et le R².
Weights & Biases offre bien d’autres fonctionnalités à explorer, comme la réutilisation d’artefacts existants dans de nouvelles exécutions, un outil en ligne de commande et des Prompts pour le développement de LLM !
Pour consolider vos connaissances sur l’expérimentation en machine learning et, plus largement, sur les techniques de MLOps, vous pouvez consulter :
Approfondissez les notions abordées dans ce tutoriel !
Cours
Cours
Cours