programa
Fundamentos de la IA
10 h
Si sigues de cerca el mundo de la tecnología, habrás oído hablar de los ‘Large Language Models (LLMs)’. Los LLM son hoy el término de moda y su peso en el ámbito de la inteligencia artificial (IA) crece día a día. Impulsan la revolución de la IA generativa al aprender a procesar el lenguaje humano, como hacen ChatGPT y Bard.
Los LLM se han convertido en protagonistas del mercado actual gracias a su capacidad para reflejar conversaciones humanas mediante sistemas avanzados de procesamiento del lenguaje natural (NLP). Como es natural, todo tiene límites, y los asistentes con IA también presentan desafíos propios.
El más destacado es el posible sesgo en los LLM, arraigado en los datos con los que se entrenan.
Vayamos un paso atrás. ¿Qué son los LLM?
Los LLM son sistemas de IA como ChatGPT, diseñados para modelar y procesar el lenguaje humano. Son algoritmos de IA que emplean técnicas de deep learning para resumir, generar y predecir contenido nuevo. Se llaman “large” porque el modelo requiere millones o incluso miles de millones de parámetros y se entrena con un corpus ‘enorme’ de texto.
LLM y NLP van de la mano: aspiran a comprender profundamente el lenguaje humano y sus patrones, y a aprender conocimiento a partir de grandes conjuntos de datos.
Si estás empezando en el mundo de los LLM, te recomendamos este artículo para ponerte al día:
What is an LLM? A Guide on Large Language Models and How They Work. O realiza nuestro Large Language Models (LLMs) Concepts Course, perfecto para aprender sobre LLM.
Los LLM se emplean ampliamente en distintos tipos de aplicaciones de IA. Su popularidad crece a diario y las empresas exploran formas de integrarlos en sus sistemas y herramientas para mejorar la productividad del flujo de trabajo.
Algunos casos de uso de los LLM:
Los LLM utilizan modelos Transformer, una arquitectura de deep learning que aprende el contexto y lo comprende mediante el análisis secuencial de datos.
La tokenización consiste en descomponer el texto de entrada en unidades más pequeñas llamadas tokens para que el modelo las procese y analice mediante operaciones matemáticas que descubren las relaciones entre los distintos tokens. El proceso matemático adopta un enfoque probabilístico para predecir la siguiente secuencia de palabras durante la fase de entrenamiento del modelo.
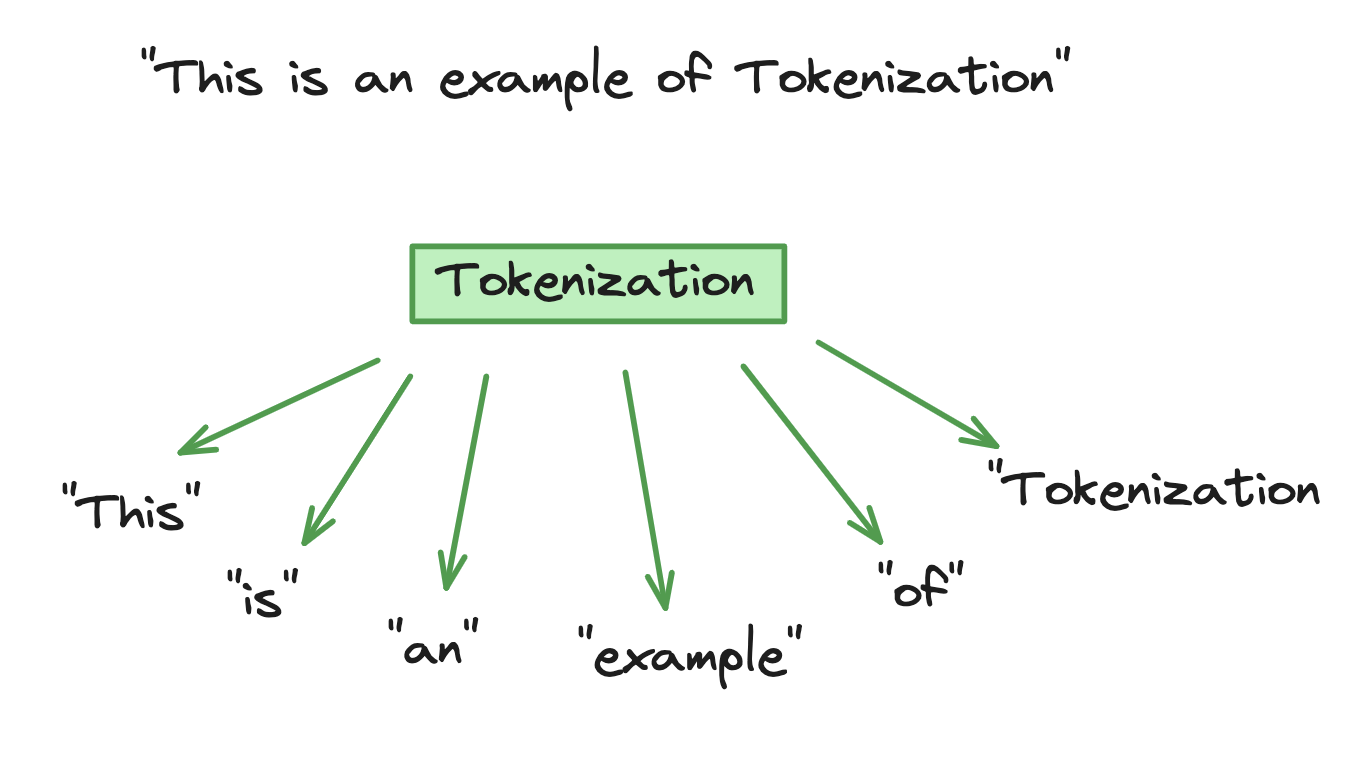
Ejemplo de tokenización
La fase de entrenamiento consiste en alimentar al modelo con conjuntos masivos de texto para ayudarle a comprender diversos contextos, matices y estilos lingüísticos. Así, los LLM construyen una base de conocimiento con la que pueden imitar de forma efectiva el lenguaje humano.
La versatilidad y comprensión del lenguaje que poseen los LLM es una muestra de su capacidad avanzada. Al entrenarse con amplios datasets de distintos géneros y estilos, desde documentos legales hasta narrativas de ficción, los LLM ganan la capacidad de adaptarse a múltiples escenarios y contextos.
Pero su versatilidad va más allá de predecir texto. Ser capaces de abordar tareas en distintos idiomas, contextos y con diferentes formatos de salida se traduce en aplicaciones adaptativas, como la atención al cliente. Esto es posible gracias al entrenamiento con grandes conjuntos de datos específicos y a procesos de ajuste fino, que mejoran su eficacia en campos diversos.
Ahora bien, no olvidemos el gran desafío de los LLM: el sesgo.
Como sabemos, los LLM se entrenan con textos procedentes de numerosas fuentes. Cuando esos datos se introducen en el modelo, este los toma como su base de conocimiento e interpreta que son veraces. Sin embargo, los datos pueden estar impregnados de sesgos y desinformación, lo que lleva a que las salidas del LLM reflejen esos sesgos.
Una herramienta destinada a mejorar la productividad y ayudar en tareas cotidianas también plantea cuestiones éticas. Puedes aprender más sobre la ética de la IA en nuestro curso.
Cuantos más datos, mejor. Si los datos de entrenamiento de un LLM contienen muestras no representativas o sesgos, el modelo inevitablemente los heredará y aprenderá. Ejemplos de sesgos en LLM incluyen género, raza y cultura.
Por ejemplo, un LLM puede mostrar sesgo de género si la mayoría de sus datos reflejan que las mujeres trabajan sobre todo como limpiadoras o enfermeras, y los hombres como ingenieros o CEOs. El LLM hereda estereotipos sociales por los datos con los que se entrenó. Otro ejemplo es el sesgo racial, donde los LLM pueden reflejar estereotipos sobre ciertos grupos étnicos, o el sesgo cultural por sobrerrepresentación para encajar en el estereotipo.
Los dos orígenes principales de los sesgos en los LLM son:
Aunque los LLM son muy versátiles, este desafío muestra que el modelo es menos eficaz con contenidos multiculturales. La preocupación surge cuando se usan LLM en procesos de toma de decisiones, lo que plantea inquietudes éticas.
Los impactos del sesgo en LLM afectan tanto a quienes usan el modelo como a la sociedad en general.
Como hemos visto, existen diversos estereotipos, como los culturales o de género. Los sesgos en los datos de entrenamiento de los LLM perpetúan estos estereotipos dañinos, manteniendo a la sociedad en un ciclo de prejuicios y frenando el progreso.
Si los LLM siguen ingiriendo datos sesgados, continuarán alimentando la división cultural y la desigualdad de género.
La discriminación es el trato prejuicioso hacia diferentes categorías de personas en función de su sexo, etnia, edad o discapacidad. Los datos de entrenamiento pueden estar muy infrarrepresentados, sin reflejar fielmente a distintos grupos.
Las salidas de un LLM con respuestas sesgadas que mantienen la discriminación racial, de género o edad perjudican el día a día de personas de comunidades marginadas, desde procesos de selección y contratación hasta oportunidades educativas. Esto conlleva falta de diversidad e inclusión en las salidas de los LLM, y eleva las preocupaciones éticas cuando esas salidas se usan para tomar decisiones.
Si preocupa que los datos de entrenamiento de los LLM contengan muestras no representativas o sesgos, también surge la duda de si la información es correcta. La difusión de información errónea o desinformación a través de LLM puede tener consecuencias.
Por ejemplo, en sanidad, usar LLM con información sesgada puede derivar en decisiones peligrosas. Otro caso es que un LLM contenga sesgos políticos y difunda ese enfoque, generando desinformación política.
Las preocupaciones éticas sobre los LLM no son el único motivo por el que parte de la sociedad no acoge bien la implantación de sistemas de IA en la vida diaria. Muchas personas temen su impacto, por ejemplo, en la pérdida de empleo o la estabilidad económica.
Ya existe una falta de confianza en los sistemas de IA. Por tanto, el sesgo que produzcan los LLM puede erosionar por completo cualquier confianza que la sociedad tenga en ellos. Para que la tecnología LLM sea aceptada con seguridad, la sociedad debe confiar en ella.
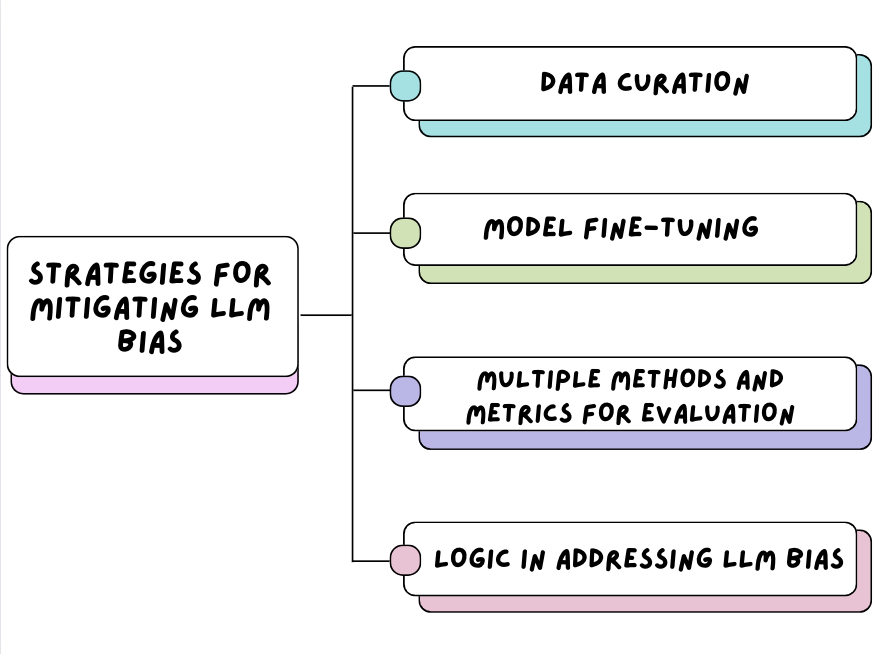
Estrategias para mitigar el sesgo en LLM
Empecemos por el principio: los datos. Las empresas deben asumir una gran responsabilidad sobre el tipo de datos que introducen en los modelos.
Hay que garantizar que los datos de entrenamiento de los LLM se han curado a partir de un abanico diverso de fuentes. Conjuntos de texto procedentes de distintas demografías, idiomas y culturas equilibran la representación del lenguaje humano. Así se evitan muestras no representativas y se orienta el ajuste fino del modelo, reduciendo el impacto del sesgo cuando la comunidad en general lo utiliza.
Una vez recopiladas y cargadas en el modelo múltiples fuentes de datos, las organizaciones pueden seguir mejorando la precisión y reduciendo sesgos mediante el ajuste fino. Existen varios enfoques, como:
Puedes conocer más sobre el ajuste fino con nuestro tutorial de Fine-Tuning LLaMA 2, con una guía paso a paso para adaptar un modelo preentrenado.
Para desarrollar sistemas de IA que puedan integrarse con seguridad en la sociedad actual, las organizaciones necesitan varios métodos y métricas en su proceso de evaluación. Antes de abrir LLM a la comunidad, hay que aplicar métodos y métricas adecuados para capturar las distintas dimensiones del sesgo en sus salidas.
Entre los métodos están la evaluación humana, la evaluación automática o la híbrida. Todos se emplean para detectar, estimar o filtrar sesgos en LLM. Entre las métricas, precisión, sentimiento, equidad y más. Estas métricas aportan feedback sobre el sesgo en las salidas y ayudan a mejorar continuamente lo detectado.
Si quieres aprender más sobre evaluaciones para mejorar la calidad de los LLM, echa un vistazo a nuestro code-along sobre Evaluating LLM Responses.
Un estudio del Computer Science and Artificial Intelligence Laboratory (CSAIL) del MIT ha logrado avances significativos al integrar razonamiento lógico en LLM: Large language models are biased. Can logic help save them?
La importancia de un pensamiento lógico y estructurado en los LLM permite que procesen y generen salidas aplicando razonamiento y pensamiento crítico, ofreciendo respuestas más precisas fundamentadas.
El proceso consiste en construir un modelo de lenguaje neutral, donde las relaciones entre tokens se consideran ‘neutrales’ al no existir una lógica que establezca relación entre ellos. CSAIL entrenó este enfoque en un modelo de lenguaje y comprobó que el modelo resultante era menos sesgado sin necesidad de más datos ni entrenamiento adicional de algoritmos.
Los modelos de lenguaje conscientes de la lógica podrán evitar la generación de estereotipos dañinos.
Google Research sigue mejorando su LLM BERT ampliando los datos de entrenamiento para que sean más inclusivos y diversos. El uso de grandes conjuntos de texto no anotado en la fase de preentrenamiento permite ajustar posteriormente el modelo para tareas específicas. El objetivo es un LLM menos sesgado y con salidas más sólidas. Google Research afirma que este método ha reducido las salidas estereotipadas y mejora continuamente el rendimiento en la comprensión de distintos dialectos y contextos culturales.
El equipo de Google Research ha creado varias herramientas llamadas ‘Fairness Indicators’ para detectar sesgos en modelos de machine learning y aplicar procesos de mitigación. Estos indicadores usan métricas como falsos positivos y falsos negativos para evaluar el rendimiento e identificar brechas que podrían quedar ocultas con métricas generales.
OpenAI ha asegurado a la comunidad que la seguridad, la privacidad y la ética están en el centro de sus objetivos. Sus medidas de mitigación en el preentrenamiento para DALL-E 2 incluyeron filtrar imágenes violentas y sexuales del conjunto de entrenamiento, eliminar imágenes visualmente similares entre sí y enseñar al modelo a compensar los efectos de ese filtrado.
Lograr un objetivo sin sacrificar otro a veces es complicado. Esto aplica cuando buscamos equilibrar la reducción del sesgo en LLM con mantener o incluso mejorar el rendimiento del modelo. Desbiasar modelos es clave para lograr equidad; sin embargo, no debe comprometerse su precisión ni su desempeño.
Hay que aplicar un enfoque estratégico para asegurar que las medidas de mitigación —como la curación de datos, el ajuste fino y el uso de múltiples métodos— no afecten a la capacidad del modelo para comprender y generar lenguaje. Es necesario mejorar, sí, pero el rendimiento no debe ser la moneda de cambio.
Se trata de probar y aprender, monitorizar y ajustar, desbiasar y mejorar.
En este artículo hemos visto:
El sesgo en LLM es un desafío complejo y con muchas aristas que debe priorizarse para que la sociedad confíe más en esta tecnología y acepte su integración en tareas cotidianas. Las organizaciones han de comprender el impacto negativo y duradero de los estereotipos en las personas y la sociedad, y usar ese entendimiento para trazar un camino de mitigación del sesgo en LLM mediante curación de datos, ajuste fino y modelado lógico.
Para aprender más sobre LLM, echa un vistazo a nuestro curso Large Language Models Concepts, que explica cómo estas potentes herramientas están transformando el panorama de la IA.
¡Empieza hoy tu viaje en IA!
programa
Curso
Curso