Kurs
MLOps-Konzepte
2 Std.
45.3K
Hast du schon einmal auf ein Machine-Learning-Projekt zurückgeblickt und dich gefragt, warum du bestimmte Entscheidungen getroffen hast – oder was der Code eigentlich genau macht? Zum Beispiel: Warum hast du dieses Feature-Subset gewählt, mit welcher Datenversion hast du das finale Modell trainiert, oder wie haben unterschiedliche Hyperparameter-Sets die Performance beeinflusst? Klingt so, als solltest du Best Practices für Experimente in deine ML-Projekte aufnehmen!
Machine-Learning-Experimentieren bedeutet, eine ML-Pipeline zu entwerfen, aufzubauen, zu protokollieren und auszuwerten, um das Modell zu identifizieren, das im Hinblick auf eine gegebene Metrik oder mehrere Metriken (z. B. F1-Score, RMSE usw.) die gewünschte Leistung erreicht. Es ist ein entscheidender Schritt bei der Entwicklung von ML-Modellen – vor dem Deployment und als Teil des Retrainings. Wie jedes gute Experiment sollte es so gestaltet sein, dass es:
Mit diesen Zielen im Blick findest du schnell, was du brauchst – etwa die Hyperparameter eines Modells oder eine Version eines Datasets – und kannst Informationen wie Modellleistung und Quellcode einfach teilen.
Genau hier kommt Weights & Biases ins Spiel!
Weights & Biases ist eine Plattform und Python-Bibliothek, mit der ML-Teams Experimente ausführen, Artefakte protokollieren, Hyperparameter-Tuning automatisieren und Performance auswerten. Dieses Tutorial führt dich in die Kernfunktionen ein, indem wir eine ML-Pipeline aufsetzen, ihre Schlüsselelemente loggen und anschließend im Dashboard untersuchen!
# Install Python library
!pip install wandb
Für den Login musst du dich zunächst für ein Konto registrieren.
Anschließend rufst du die Authorize-Seite auf, um deinen API-Schlüssel zu erhalten, mit dem du dich einloggen kannst. Notiere ihn dir, aber teile ihn mit niemandem!
Zum Einloggen öffnest du entweder ein neues Terminal und gibst wandb login ein oder fügst deinem Notebook eine neue Zelle hinzu und führst !wandb login aus.
Du wirst aufgefordert, deinen API-Schlüssel einzugeben. Kopiere ihn einfach hinein, um dich erfolgreich anzumelden. Deine Zugangsdaten werden lokal in ~/.netrc gespeichert.
wandb loginWeights & Biases bietet mehrere Bausteine, darunter Experiments, Artifacts, Sweeps und Models. Starten wir mit dem Kern des Workflows – dem Erstellen und Ausführen von Experimenten.
# Import required modules
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import wandb
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
In Weights & Biases wird ein Experiment auch als Projekt bezeichnet. Ein neues Projekt legst du mit der Funktion wand.init() an, indem du den Projektnamen als String an das Keyword-Argument project übergibst. Weisen wir das Ergebnis einer Variablen namens run zu, damit wir wichtige Dateien, Modelle und Metriken diesem Run zuordnen können.
Optional kannst du über das Keyword-Argument job_type einen String übergeben, um Schritte wie EDA, Feature Engineering oder Hyperparameter-Tuning leichter zu unterscheiden. Außerdem kannst du den ausgeführten Code loggen, indem du save_code auf True setzt.
# Initialize a run
run = wandb.init(project="predicting_london_temperature",
                 job_type="Baseline modeling",
save_code=True)Du kannst alle wichtigen Informationen – etwa Datasets, Variablen oder Dateien – als Artifact protokollieren. Erstelle dazu zunächst mit wandb.Artifact() ein Objekt und gib Name und Typ an. Logge es dann mit der Funktion run.log_artifact(). Beginnen wir mit dem ursprünglichen Dataset.
original_data = "london_weather.csv"
# Create an Artifact
data_artifact = wandb.Artifact(name="original_dataset",
                               type="data",
                               description="London weather dataset")
# Add the file to the Artifact
data_artifact.add_file(original_data)
# Log the Artifact as part of the run
run.log_artifact(data_artifact)
Explorative Datenanalyse (EDA) ist ein zentraler Schritt im ML-Workflow. Sie hilft dir zu prüfen, ob Datentypen passen und ob fehlende Werte oder Ausreißer vorliegen. Zudem kannst du Verteilungen und Zusammenhänge zwischen Features untersuchen.
Der Zusatznutzen von Weights & Biases: Wir können Daten während des Preprocessings loggen – inklusive aller erzeugten Visualisierungen.
# Read in the data
london = pd.read_csv(original_data)

# Previewing the first five rows
london.head()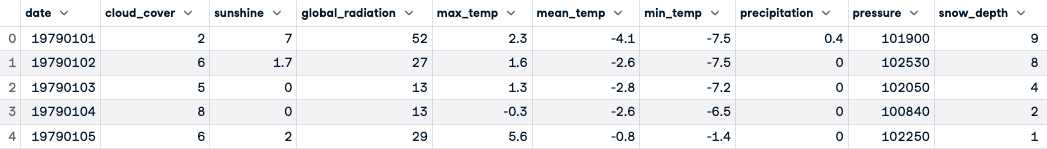
# Visualize distributions
plt.figure(figsize=(12,8))
london.hist()
plt.tight_layout()
plt.show()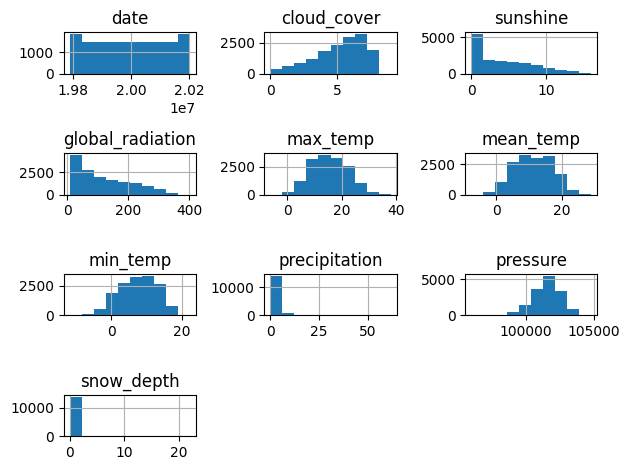
# View data types and non-null counts
london.info()


<class 'pandas.core.frame.DataFrame'>
RangeIndex: 15341 entries, 0 to 15340
Data columns (total 10 columns):
 #   Column            Non-Null Count  Dtype
---  ------            --------------  -----
 0   date              15341 non-null  int64
 1   cloud_cover       15322 non-null  float64
 2   sunshine          15341 non-null  float64
 3   global_radiation  15322 non-null  float64
 4   max_temp          15335 non-null  float64
 5   mean_temp         15305 non-null  float64
 6   min_temp          15339 non-null  float64
 7   precipitation     15335 non-null  float64
 8   pressure          15337 non-null  float64
 9   snow_depth        13900 non-null  float64
dtypes: float64(9), int64(1)
memory usage: 1.2 MB


# Convert date to datetime
london["date"] = pd.to_datetime(london["date"], format="%Y%m%d")

# Add a month column
london["month"] = london["date"].dt.month

# Drop missing values
london.dropna(inplace=True)
Jetzt sind die Daten bereinigt und du kannst sie mit wand.Artifact() als Artifact loggen.
# Save and log the new version of the data
london.to_csv("london_weather_preprocessed.csv", index=False)
preprocessed_data = "london_weather_preprocessed.csv"
# Create an Artifact
preprocessed_data_artifact = wandb.Artifact(name="london_weather_preprocessed",
                               type="data",
                               description="London weather dataset - preprocessed")
# Add the file to the Artifact
preprocessed_data_artifact.add_file(preprocessed_data)
# Log the Artifact as part of the run
run.log_artifact(preprocessed_data_artifact)


<wandb.sdk.artifacts.local_artifact.Artifact at 0x15bfe6710>Als Nächstes identifizieren wir geeignete Features fürs Modeling und vermeiden Multikollinearität. Dazu erzeugen wir zunächst eine Korrelations-Heatmap und nutzen dann Ridge Regression, um die Feature-Wichtigkeit für die Vorhersage von "mean_temperature" zu quantifizieren.
# Correlation heatmap
sns.heatmap(london.corr(), annot=True, center=True)
plt.show()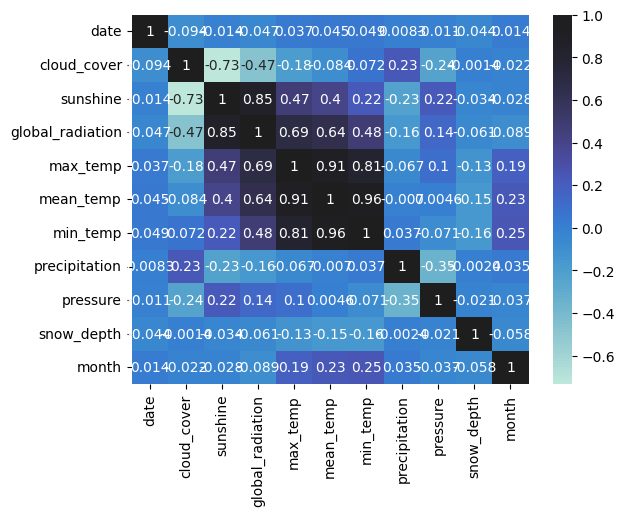
Diesen Plot kannst du mit wandb.Image() loggen!
# Log the heatmap
wandb.log({"correlation_heatmap": wandb.Image(plt)})


# Split the data
X = london.drop(columns=["mean_temp", "min_temp", "max_temp", "date"])
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

# Build a Ridge regression model
ridge = Ridge(alpha=0.1)
ridge.fit(X_train, y_train)
y_pred = ridge.predict(X_test)

# Visualize feature importance using the coefficients
fig = plt.figure()
sns.barplot(x=X_train.columns, y=ridge.coef_)
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("feature_selection.png")
plt.show()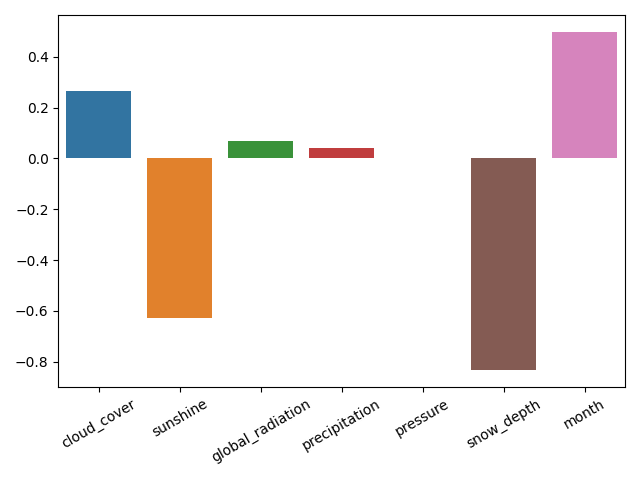
Speichern wir das Modell und den Plot zur Feature-Wichtigkeit mit pickle.dump() und wandb.log().
import pickle
pickle.dump(ridge, open("feature_selection_model.pkl", "wb"))
feature_selection_model = wandb.Artifact("feature_selection_model", type="model")
feature_selection_model.add_file("feature_selection_model.pkl")
run.log_artifact(feature_selection_model)
wandb.log({"feature_selection_plot": wandb.Image(fig)})


<Figure size 640x480 with 0 Axes>Geschafft! Jetzt trainieren wir ein Baseline-Modell mit den identifizierten wichtigen Features, also jenen mit einem Ridge-Koeffizienten größer null. Außerdem loggen wir die neuen Trainings- und Testdaten.
X = london[["cloud_cover", "global_radiation", "precipitation", "month"]]
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

def log_data(X_train, y_train, X_test, y_test):
    # Log the training and test data
    training_features = wandb.Artifact(name="X_train",
                               type="data",
                               description="Training features")
    X_train.to_csv("X_train.csv", index=False)
    training_features.add_file("X_train.csv")
    run.log_artifact(training_features)

    training_labels = wandb.Artifact(name="y_train",
                               type="data",
                               description="Training labels")
    y_train.to_csv("y_train.csv", index=False)

    training_labels.add_file("y_train.csv")
    run.log_artifact(training_labels)

    test_features = wandb.Artifact(name="X_test",
                               type="data",
                               description="Test features")
    X_test.to_csv("X_test.csv", index=False)
    test_features.add_file("X_test.csv")
    run.log_artifact(test_features)

    test_labels = wandb.Artifact(name="y_test",
                               type="data",
                               description="Test labels")
    y_test.to_csv("y_test.csv", index=False)
    test_labels.add_file("y_test.csv")
    run.log_artifact(test_labels)

log_data(X_train, y_train, X_test, y_test)
Trainieren und bewerten wir ein Decision-Tree-Regressionsmodell und nutzen Root Mean Squared Error (RMSE) und R-Squared als Leistungsmetriken.
# Fit and evaluate the model
dt_reg = DecisionTreeRegressor(random_state=42)
dt_reg.fit(X_train, y_train)
y_pred = dt_reg.predict(X_test)
rmse = mean_squared_error(y_test, y_pred, squared=False)
r_squared = r2_score(y_test, y_pred)
print(rmse, r_squared)


3.8627385194713346 0.5399282872125385

# Save and log the model and metrics
pickle.dump(dt_reg, open("baseline_decision_tree.pkl", "wb"))
baseline_model = wandb.Artifact("baseline_decision_tree", type="model")
baseline_model.add_file("baseline_decision_tree.pkl")
run.log_artifact(baseline_model)
wandb.log({"rmse": rmse, "r_squared": r_squared})
Du kannst die Modellleistung weiter untersuchen, indem du die Residuen des Modells visualisierst. Weights & Biases bietet dafür eine Funktion im sklearn-Modul!
# Plot training residuals
wandb.log({"baseline_residuals_plot": wandb.sklearn.plot_residuals(dt_reg, X_train, y_train)})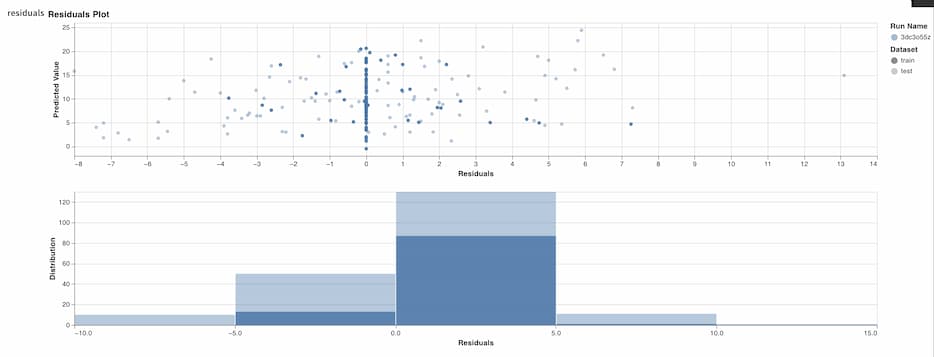
Training und Evaluation sind abgeschlossen, also beenden wir den aktuellen Run.
# Finish run
wandb.finish()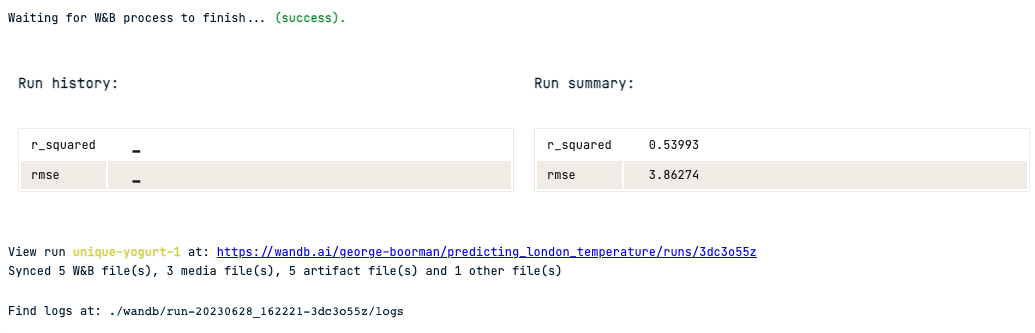
Nachdem du ein Baseline-Modell mit zugehörigen Leistungsmetriken erstellt und geloggt hast, schauen wir uns an, wie du Hyperparameter-Tuning durchführst und deine Modelle mit Weights & Biases und scikit-learn versionierst.
Wir verwenden GridSearchCV, um anhand des RMSE das beste Modell über einen Hyperparameterraum zu finden.
# Initialize a new run
run_v2 = wandb.init(project="predicting_london_temperature",
                 job_type="Hyperparameter tuning",
                 save_code=True)

# Split the data and create a KFold object
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# Create the hyperparameter space
params = {"max_depth":[2, 5, 8, 12, 20],
          "min_samples_split": [2, 5, 8, 12, 20],
          "max_features": [1, 2, 3, 4],
          "random_state": [42]
          }

# Create a GridSearchCV object
dt_reg = DecisionTreeRegressor()
dt_reg_cv = GridSearchCV(dt_reg,
                         params,
                         cv=kf,
                         scoring="neg_root_mean_squared_error")

# Fit the data
dt_reg_cv.fit(X_train, y_train)

# Evaluate and log performance
## GridSearchCV uses negative RMSE
## so you can convert it to positive
print(f"Best RMSE: {-1 * dt_reg_cv.best_score_})")
print(f"Best model: {dt_reg_cv.best_estimator_}")

# Save and log the model, metrics, and parameters
pickle.dump(dt_reg_cv, open("tuned_decision_tree.pkl", "wb"))
tuned_decision_tree = wandb.Artifact("tuned_decision_tree", type="model")
tuned_decision_tree.add_file("tuned_decision_tree.pkl")
run_v2.log_artifact(tuned_decision_tree)
wandb.log({"rmse": -1 * dt_reg_cv.best_score_})
wandb.finish()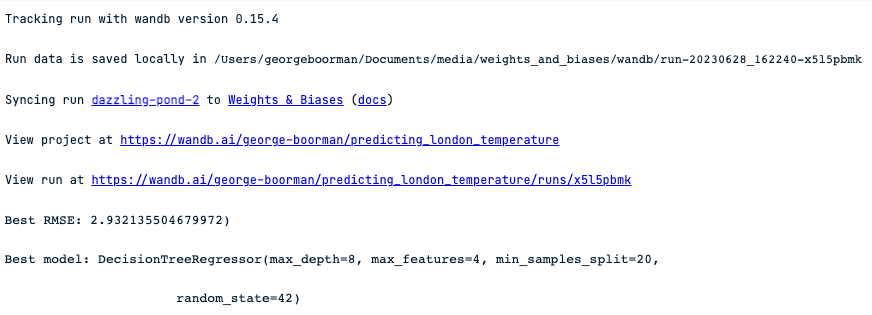
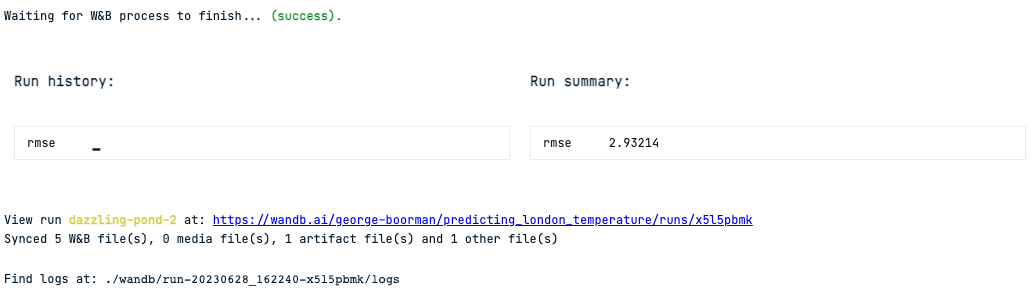
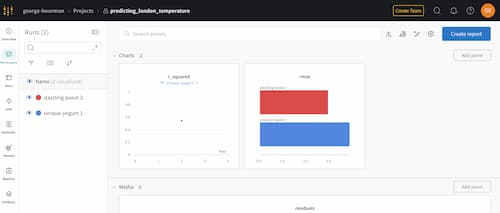
Um Runs und Artefakte zu untersuchen, geh auf www.wandb.ai/<your-profile-name>/projects und wähle dein erstelltes Projekt aus.
Dort siehst du jeden deiner Runs inklusive Medien wie Plots – so wie hier:
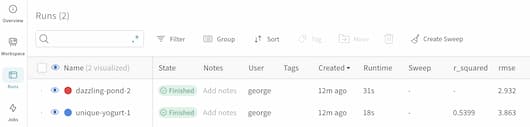
Über das Runs-Symbol erhältst du die Übersicht aller Runs und wichtiger Informationen, darunter geloggte Metriken wie RMSE und R-Squared.
Weights & Biases bietet noch viel mehr Funktionen, die du entdecken kannst, zum Beispiel das Verwenden bestehender Artefakte in neuen Runs, ein Command-Line-Interface und Prompts für die Entwicklung von LLMs!
Um dein Wissen zu ML-Experimenten und den weiterführenden Methoden aus MLOps zu vertiefen, schau dir gern Folgendes an:
Lerne die in diesem Tutorial erwähnten Themen!
Kurs
Kurs
Kurs