
कोर्स
Python परिचय
4 घंटा
7.1M
Python विभिन्न प्रकार के संख्यात्मक मानों को संभालने के लिए कई न्यूमेरिक डेटा टाइप्स प्रदान करती है।
पूर्णांक, धनात्मक या ऋणात्मक, जिनमें भिन्नात्मक घटक नहीं होता।
ये मूलभूत संख्यात्मक मान होते हैं जो गणना या डिस्क्रीट माप का प्रतिनिधित्व करते हैं।
फ्लोटिंग-पॉइंट संख्याओं के विपरीत, इंटीजर सटीक होते हैं और इनमें अनुमान शामिल नहीं होता, इसलिए जहां परिशुद्धता महत्वपूर्ण हो—जैसे इंडेक्सिंग या वस्तुओं की गिनती—वहां ये आदर्श हैं।
age = 25दशमलव बिंदु वाली या घातांक रूप में लिखी संख्याएँ।
ये मान अक्सर भिन्नात्मक परिशुद्धता वाले परिदृश्यों में उपयोग किए जाते हैं, जैसे वित्तीय गणनाएँ, वैज्ञानिक माप, और ग्राफ़िक्स प्रोग्रामिंग।
फ्लोटिंग-पॉइंट संख्याएँ घातांकीय संकेतन का उपयोग करके अत्यंत बड़े या छोटे मानों का भी प्रतिनिधित्व कर सकती हैं, जिससे वे विभिन्न संख्यात्मक अनुप्रयोगों के लिए बहुमुखी बनती हैं।
price = 19.99ऐसी संख्याएँ जिनमें वास्तविक और काल्पनिक दोनों भाग होते हैं। कॉम्प्लेक्स संख्याएँ विद्युत अभियांत्रिकी, भौतिकी, और सिग्नल प्रोसेसिंग जैसे क्षेत्रों में उपयोगी हैं, जहाँ काल्पनिक संख्याओं से संबंधित ऑपरेशन आम हैं।
Python कॉम्प्लेक्स संख्याओं को a + bj के रूप में दर्शाती है, जहाँ a वास्तविक भाग है, और b काल्पनिक भाग है। यह बिल्ट-इन समर्थन उन गणनाओं को सरल बनाता है जो अन्य भाषाओं में बाहरी लाइब्रेरी या कस्टम इम्प्लीमेंटेशन की मांग कर सकती हैं।
z = 2 + 3jसंख्याओं से आगे बढ़ते हुए, Python ऑर्डर में व्यवस्थित तत्वों के संग्रह को संग्रहीत करने के लिए सीक्वेंस डेटा टाइप्स भी प्रदान करती है।
एकल या डबल कोट्स में बंद वर्णों का क्रमबद्ध अनुक्रम। स्ट्रिंग्स Python के सबसे बहुमुखी डेटा टाइप्स में से एक हैं, जो आपको टेक्स्ट-आधारित डेटा को संग्रहीत और संसाधित करने देती हैं।
ये आम तौर पर यूज़र इनपुट संभालने, संदेश बनाने, या बड़े टेक्स्ट डेटासेट प्रोसेस करने जैसे कार्यों में उपयोग होती हैं।
Python कई बिल्ट-इन मेथड्स देती है, जैसे .lower(), .upper(), .replace(), और .split(), जो स्ट्रिंग्स के साथ काम करना बहुत प्रभावी बनाती हैं।
greeting = "Welcome to Python!"लिस्ट्स क्रमबद्ध, परिवर्तनीय (mutable) आइटम्स के संग्रह हैं, जिनमें विभिन्न डेटा टाइप्स के तत्व हो सकते हैं।
यह लचीलापन लिस्ट्स को Python में सबसे सामान्यत: उपयोग किए जाने वाले डेटा टाइप्स में से एक बनाता है, जो सरल स्टोरेज से लेकर जटिल डेटा मैनिपुलेशन तक के कार्यों के लिए उपयुक्त हैं।
लिस्ट्स डायनेमिक रिसाइजिंग की अनुमति देती हैं और स्लाइसिंग, जोड़ने (append), और हटाने जैसे विभिन्न ऑपरेशन सपोर्ट करती हैं, जिससे वे क्रमबद्ध और बदलने योग्य डेटा वाले परिदृश्यों के लिए पसंदीदा संरचना बनती हैं।
fruits = ["apple", "banana", "cherry"]क्रमबद्ध, अपरिवर्तनीय (immutable) आइटम्स का संग्रह। ट्यूपल्स का उपयोग अक्सर उन स्थिर संग्रहों को संग्रहीत करने के लिए किया जाता है जहाँ अपरिवर्तनीयता महत्वपूर्ण होती है, जैसे भौगोलिक निर्देशांक, RGB कलर कोड्स, या डेटाबेस रिकॉर्ड्स।
लिस्ट्स के विपरीत, ट्यूपल्स बनाए जाने के बाद संशोधित नहीं किए जा सकते, जिससे वे उन स्थितियों में तेज़ और अधिक सुरक्षित होते हैं जहाँ डेटा अखंडता महत्वपूर्ण है।
dimensions = (1920, 1080)जहाँ सीक्वेंस क्रमबद्ध संग्रहों को संग्रहीत करते हैं, वहीं Python मैपिंग डेटा टाइप्स भी प्रदान करती है जो कुंजियों (keys) को मानों (values) से जोड़ते हैं। सबसे अधिक उपयोग होने वाला मैपिंग टाइप डिक्शनरी है।
यूनिक और अपरिवर्तनीय कुंजियों वाले की-वैल्यू पेयर्स का संग्रह।
डिक्शनरीज़ अत्यंत बहुमुखी हैं और आपको संख्यात्मक इंडेक्स पर निर्भर होने की बजाय अर्थपूर्ण कुंजियों का उपयोग करके डेटा को कुशलतापूर्वक व्यवस्थित और पुनः प्राप्त करने देती हैं। यह उन्हें संरचित डेटा, जैसे JSON ऑब्जेक्ट्स या कॉन्फ़िगरेशन सेटिंग्स, का प्रतिनिधित्व करने में विशेष रूप से उपयोगी बनाती है।
Python डिक्शनरीज़ में की-वैल्यू पेयर्स जोड़ने, अपडेट करने या हटाने जैसे विभिन्न ऑपरेशन सपोर्ट होते हैं, जो उन्हें कई प्रोग्रामिंग परिदृश्यों में आवश्यक टूल बनाते हैं।
person = {"name": "Alice", "age": 30}सीक्वेंस और मैपिंग के अतिरिक्त, Python सेट डेटा टाइप्स प्रदान करती है, जो बिना किसी विशिष्ट क्रम के अद्वितीय तत्वों के संग्रह को संग्रहीत करती हैं।
अक्रमबद्ध (unordered) अद्वितीय तत्वों का संग्रह। सेट्स तब विशेष रूप से उपयोगी होते हैं जब आपको यह सुनिश्चित करना हो कि आपके डेटा में डुप्लीकेट न हों, जैसे मेंबरशिप परीक्षण या किसी लिस्ट से डुप्लीकेट हटाना।
ये यूनियन, इंटरसेक्शन, और डिफरेंस जैसे गणितीय ऑपरेशन सपोर्ट करते हैं, जो उन्हें डेटा के सेट्स से संबंधित समस्याएँ हल करने के लिए शक्तिशाली टूल बनाते हैं।
unique_numbers = {1, 2, 3, 4, 5}सेट का अपरिवर्तनीय संस्करण, यानी एक बार बनाए जाने के बाद इसके तत्व बदले नहीं जा सकते।
फ्रोजन सेट्स उन स्थितियों में उपयोगी होते हैं जहाँ आपको अद्वितीय आइटम्स का हैशेबल संग्रह चाहिए, जैसे किसी डिक्शनरी में कुंजी के रूप में सेट का उपयोग करना या ऐसे डेटा की अखंडता सुनिश्चित करना जिसे बदलना नहीं चाहिए।
ये नियमित सेट्स के सभी गुण रखते हैं, जैसे यूनियन और इंटरसेक्शन जैसे गणितीय ऑपरेशन सपोर्ट करना, लेकिन अपरिवर्तनीयता का अतिरिक्त लाभ भी देते हैं।
immutable_set = frozenset([1, 2, 3])इसके बारे में और जानने के लिए, Python Sets और सेट थ्योरी पर उत्कृष्ट ट्यूटोरियल देखें।
कई प्रोग्रामिंग परिदृश्यों में, हमें सत्य मानों का प्रतिनिधित्व करने का एक तरीका चाहिए। Python बूलियन डेटा टाइप प्रदान करती है, जो निर्णय-निर्धारण और नियंत्रण प्रवाह में भूमिका निभाती है।
तार्किक मान, या तो True या False। ये मान अक्सर निर्णय लेने की प्रक्रियाओं में उपयोग होते हैं, जैसे कंडीशनल स्टेटमेंट्स और लूप्स।
बूलियन प्रोग्रामिंग में कंट्रोल फ्लो के लिए मौलिक हैं, जिससे आप ऐसी कोड लिख सकते हैं जो शर्तों के आधार पर गतिशील रूप से प्रतिक्रिया करता है।
Python में, बूलियन मान तुलनाओं से भी उत्पन्न हो सकते हैं (उदा., 5 > 3 का मान True होता है) या लॉजिकल ऑपरेशनों से (उदा., True and False का मान False होता है)।
is_active = Trueन्यूमेरिक, सीक्वेंस, मैपिंग, सेट, और बूलियन टाइप्स के अलावा, Python एक विशेष डेटा टाइप भी शामिल करती है जो मान की अनुपस्थिति को दर्शाता है।
किसी मान की अनुपस्थिति या null मान का प्रतिनिधित्व करता है।
None टाइप का उपयोग अक्सर प्लेसहोल्डर, अनइनिशियलाइज़्ड वैरिएबल्स, या उन फ़ंक्शन्स के डिफ़ॉल्ट रिटर्न वैल्यू के रूप में किया जाता है जो स्पष्ट रूप से कुछ वापस नहीं करते।
यह विशेष रूप से उन मामलों में उपयोगी है जहाँ कोई ऑपरेशन परिणाम न दे सकता हो, या जब किसी वैरिएबल को बिना प्रारंभिक मान के परिभाषित करना हो।
result = Noneमौलिक बिल्ट-इन टाइप्स से आगे बढ़कर, Python कुछ विशेष उपयोग मामलों को संभालने के लिए एडवांस्ड डेटा टाइप्स भी प्रदान करती है। आइए सबसे सामान्य टाइप्स पर नज़र डालें।
बाइट ऑब्जेक्ट्स विशेष रूप से बाइनरी डेटा—जैसे फाइलें, मल्टीमीडिया, और नेटवर्क पैकेट्स—को संभालने के लिए डिज़ाइन किए गए हैं। ये डेटा टाइप्स तब विशेष रूप से उपयोगी होते हैं जब आप गैर-टेक्स्टुअल डेटा के साथ काम कर रहे हों।
bytes टाइप अपरिवर्तनीय है, जो इसे केवल-पढ़ने (read-only) वाले ऑपरेशनों के लिए उपयुक्त बनाता है, जबकि bytearray उन परिदृश्यों के लिए एक परिवर्तनीय विकल्प प्रदान करता है जहाँ संशोधन की आवश्यकता होती है। memory view टाइप किसी ऑब्जेक्ट के इंटरनल डेटा बफ़र तक बिना कॉपी किए पहुँचने की सुविधा देता है, जिससे मेमोरी-इंटेंसिव एप्लिकेशनों में प्रदर्शन बेहतर होता है।
data = b"hello"  # Immutable bytes object
mutable_data = bytearray(b"hello")  # Mutable bytearray object
view = memoryview(mutable_data) # Memoryview of the bytearrayNumPy एरेज़ संख्यात्मक गणनाओं के लिए अत्यंत कुशल, बहु-आयामी एरेज़ हैं।
Python लिस्ट्स के विपरीत, NumPy एरेज़ बेहतर प्रदर्शन देते हैं और गणितीय ऑपरेशनों के लिए अनुकूलित होते हैं। वे वैज्ञानिक कंप्यूटिंग में आधारशिला हैं, जैसे रैखिक बीजगणित, फूरियर ट्रांसफॉर्म, और सांख्यिकीय विश्लेषण के कार्यों को शक्ति देते हैं।
ये ब्रॉडकास्टिंग को सपोर्ट करते हैं, जो अलग-अलग आकार के एरेज़ पर ऑपरेशनों की अनुमति देता है, जिससे उनकी बहुमुखी प्रतिभा और बढ़ती है।
import numpy as np

# Creating a 1D array
data = np.array([1, 2, 3, 4])

# Creating a 2D array
data_2d = np.array([[1, 2], [3, 4]])

# Performing element-wise operations
squared = data ** 2
यदि आप NumPy के बारे में अधिक सीखना चाहते हैं, तो इस मुफ़्त शुरुआती-स्तर के Introduction to NumPy कोर्स में साइन अप करें।
Pandas DataFrames सारणीबद्ध (tabular) डेटा संरचनाएँ हैं जो शक्तिशाली डेटा मैनिपुलेशन और विश्लेषण टूल्स प्रदान करती हैं। नामित पंक्तियों और स्तंभों के साथ, वे संरचित डेटा को संभालना सहज और कुशल बनाती हैं।
DataFrames डेटा साइंस वर्कफ़्लोज़ के लिए अभिन्न हैं, जो बड़े डेटासेट्स को फ़िल्टर करने, समूहित करने, मर्ज करने, और एग्रीगेट करने जैसे कार्यों को सक्षम बनाती हैं। इसके अतिरिक्त, वे अन्य लाइब्रेरीज़ के साथ सहजता से इंटीग्रेट होती हैं, जिससे pandas आधुनिक डेटा विश्लेषण के लिए अपरिहार्य हो जाता है।
import pandas as pd

# Creating a simple DataFrame
data = pd.DataFrame({"Name": ["Alice", "Bob"], "Age": [25, 30]})

# Filtering rows based on a condition
adults = data[data["Age"] > 18]

# Adding a new column
data["IsAdult"] = data["Age"] > 18

# show data
data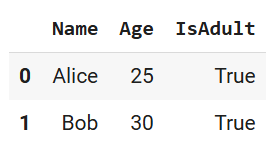
नोटबुक में प्रदर्शित Pandas DataFrame
pandas चीट शीट देखें, जिसमें कोड सैंपल शामिल हैं और जो pandas के साथ डेटा रैंगलिंग के लिए एक झटपट संदर्भ है।
यदि आप Pandas DataFrames का उपयोग करके उन्नत डेटा मैनिपुलेशन के बारे में अधिक सीखना चाहते हैं, तो मुफ़्त Data Manipulation with pandas कोर्स में साइन अप करें।
टाइप रूपांतरण का अर्थ है किसी मान को एक डेटा टाइप से दूसरे में बदलने की प्रक्रिया। प्रोग्रामिंग में, यह अक्सर आवश्यक होता है ताकि ऑपरेशन सही ढंग से किए जा सकें और डेटा को इच्छित तरीके से संसाधित किया जा सके।
Python का टाइप रूपांतरण प्रबंधन अत्यंत लचीला है, जो स्वचालित (इम्प्लिसिट) और मैनुअल (एक्स्प्लिसिट) दोनों तरीकों की पेशकश करता है।
जब किसी अभिव्यक्ति में छोटा या कम परिशुद्ध डेटा टाइप किसी बड़े या अधिक परिशुद्ध टाइप के साथ संयोजित होता है, तो Python अपने-आप एक डेटा टाइप को दूसरे में बदल देती है।
उदाहरण के लिए, int और float को मिलाने पर परिणाम float होता है, ताकि गणनाओं के दौरान कोई परिशुद्धता न खोए।
result = 5 + 3.5
print(result)
>>> 8.5 # This is a floatएक्स्प्लिसिट टाइप रूपांतरण, या टाइप कास्टिंग, आपको बिल्ट-इन फ़ंक्शन्स जैसे int(), float(), str(), आदि का उपयोग करके, किसी मान को एक डेटा टाइप से दूसरे में मैनुअली बदलने की अनुमति देता है।
यह तब उपयोगी होता है जब इम्प्लिसिट रूपांतरण नहीं होता, या जब स्ट्रिंग्स जैसे डेटा टाइप्स के साथ काम करना हो जिन्हें संख्यात्मक ऑपरेशनों के लिए स्पष्ट रूप से बदलना पड़ता है।
num = int("10")  # Converts string to integer
price = float("19.99")  # Converts string to float
text = str(123)  # Converts integer to string
Python के डेटा टाइप्स को समझना पहला कदम है—उन्हें प्रभावी ढंग से उपयोग करना साफ़, कुशल, और मेंटेन करने योग्य कोड लिखने की कुंजी है। डेटा टाइप्स के साथ काम करते समय ध्यान में रखने के लिए यहाँ कुछ सर्वोत्तम अभ्यास दिए गए हैं।
ऐसे टाइप्स चुनें जो आपके कार्य के अनुरूप हों। उदाहरण के लिए, जब आपको अद्वितीय तत्वों को बनाए रखना हो तो set का उपयोग करें, क्रमबद्ध डेटा संग्रहों के लिए list और अपरिवर्तनीय अनुक्रमों के लिए tuple।
डेटा टाइप्स के बारे में सोची-समझी पसंद आपका कोड कुशल बनाती है और उसे पढ़ना व मेंटेन करना आसान करती है।
यह सुनिश्चित करना कि इनपुट डेटा अपेक्षित टाइप का है, रनटाइम त्रुटियों को रोक सकता है और कोड की विश्वसनीयता में सुधार कर सकता है।
Python का isinstance() फ़ंक्शन टाइप्स को वैलिडेट करने का एक सीधा तरीका है। यह अभ्यास विशेष रूप से उन एप्लिकेशनों में महत्वपूर्ण है जहाँ इनपुट्स डाइनैमिक रूप से प्राप्त होते हैं, जैसे यूज़र फॉर्म या APIs से।
if not isinstance(age, int):
raise ValueError("Age must be an integer")NumPy और pandas जैसी Python लाइब्रेरीज़ उन्नत डेटा मैनिपुलेशन और कंप्यूटेशन के लिए अनिवार्य हैं।
जैसा कि हमने देखा, NumPy संख्यात्मक ऑपरेशनों के लिए तेज़, बहु-आयामी एरेज़ प्रदान करता है, जबकि pandas संरचित डेटा को कुशलतापूर्वक संभालने और रूपांतरित करने में उत्कृष्ट है। इन लाइब्रेरीज़ का लाभ उठाने से आपके कोड की जटिलता में उल्लेखनीय कमी आ सकती है और उसके प्रदर्शन में सुधार हो सकता है।
Python डेटा टाइप्स को समझना कुशल प्रोग्रामिंग और डेटा मैनिपुलेशन की पहली सीढ़ी है। डेटा टाइप्स Python की बहुमुखी प्रतिभा की नींव बनाते हैं, जो आपको विभिन्न प्रकार के डेटा को परिशुद्धता और सहजता से संभालने में सक्षम बनाते हैं।
Python के बिल्ट-इन टाइप्स की इन बुनियादियों को सीखकर और NumPy व pandas जैसी एडवांस्ड लाइब्रेरीज़ का अन्वेषण करके, आप एक प्रो Python उपयोगकर्ता बनने और डेटा साइंस, डेटा एनालिटिक्स, वित्तीय विश्लेषण, आर्टिफिशियल इंटेलिजेंस, और अधिक में वास्तविक दुनिया की समस्याएँ सुलझाने की राह पर हैं!
यदि आप अपना ज्ञान गहरा करना चाहते हैं, तो Introduction to Python for Developers कोर्स देखें, जो आवश्यक Python अवधारणाओं को हैंड्स-ऑन तरीके से कवर करता है। एक संरचित लर्निंग पाथ के लिए, जो आपकी Python स्किल्स को जड़ से बनाता है, Python Data Fundamentals ट्रैक पर विचार करें।
इन कोर्सेज़ के साथ Python के बारे में और जानें!
कोर्स
कोर्स
कोर्स