

इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएं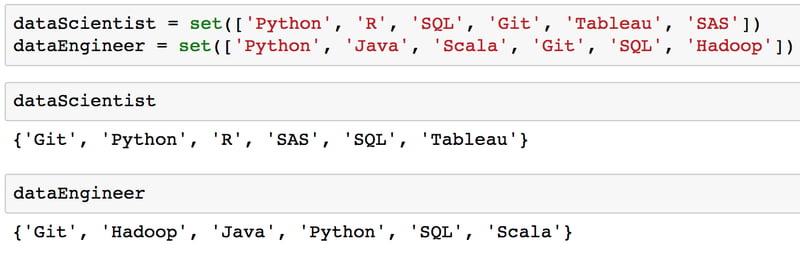
ऊपर दिए गए dataScientist और dataEngineer वेरिएबल्स के आउटपुट को देखें, तो ध्यान दें कि सेट में मान उसी क्रम में नहीं हैं जिस क्रम में जोड़े गए थे। ऐसा इसलिए है क्योंकि सेट्स अनऑर्डर्ड होते हैं।
मानों वाले सेट्स को कर्ली ब्रेसेज़ का उपयोग करके भी इनिशियलाइज़ किया जा सकता है।
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
dataEngineer = {'Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'}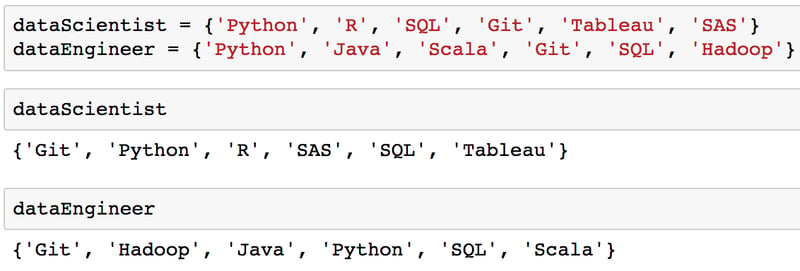
ध्यान रखें कि कर्ली ब्रेसेज़ का उपयोग केवल मानों वाले सेट को इनिशियलाइज़ करने के लिए किया जा सकता है। नीचे दी गई छवि दिखाती है कि बिना मानों के कर्ली ब्रेसेज़ का उपयोग करना, सेट नहीं बल्कि डिक्शनरी को इनिशियलाइज़ करने के तरीकों में से एक है।
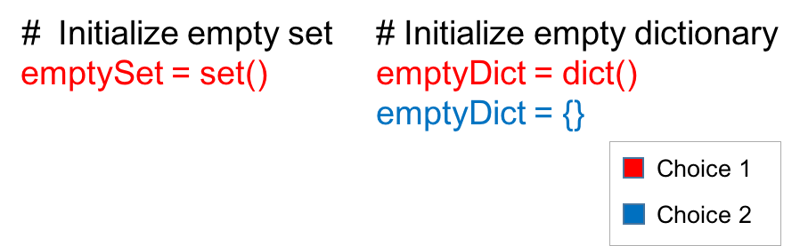
Python सेट्स में मान जोड़ें और हटाएँ
किसी सेट में मान जोड़ने या हटाने के लिए, सबसे पहले आपको एक सेट इनिशियलाइज़ करना होगा।
# Initialize set with values
graphicDesigner = {'InDesign', 'Photoshop', 'Acrobat', 'Premiere', 'Bridge'}Python सेट में मान जोड़ें
आप add मेथड का उपयोग करके किसी सेट में एक मान जोड़ सकते हैं।
graphicDesigner.add('Illustrator')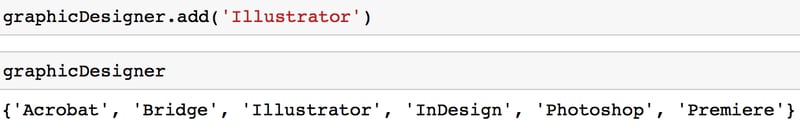
यह ध्यान देना महत्वपूर्ण है कि आप सेट में केवल ऐसा मान जोड़ सकते हैं जो इम्यूटेबल हो (जैसे स्ट्रिंग या ट्यूपल)। उदाहरण के लिए, यदि आप किसी लिस्ट को सेट में जोड़ने की कोशिश करते हैं, तो आपको TypeError मिलेगा।
graphicDesigner.add(['Powerpoint', 'Blender'])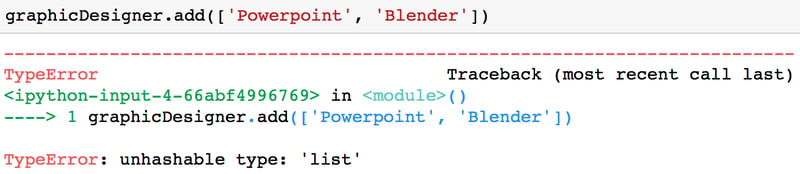
Python में सेट से मान हटाएँ
किसी सेट से मान हटाने के कुछ तरीके हैं।
विकल्प 1: आप remove मेथड का उपयोग करके सेट से कोई मान हटा सकते हैं।
graphicDesigner.remove('Illustrator')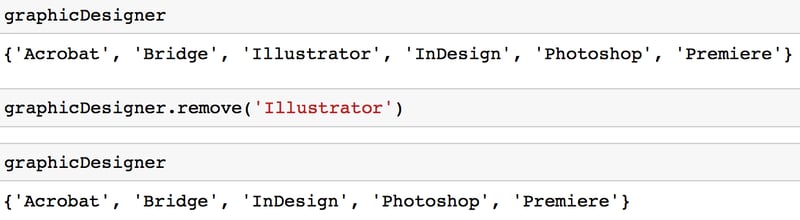
इस मेथड की कमी यह है कि यदि आप ऐसा मान हटाने की कोशिश करते हैं जो आपके सेट में नहीं है, तो आपको KeyError मिलेगा।
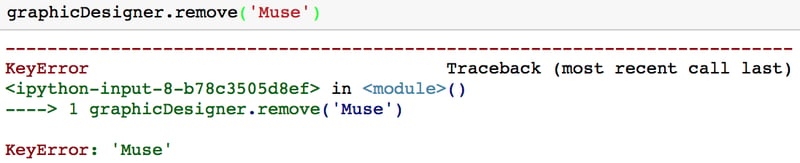
विकल्प 2: आप discard मेथड का उपयोग करके सेट से कोई मान हटा सकते हैं।
graphicDesigner.discard('Premiere')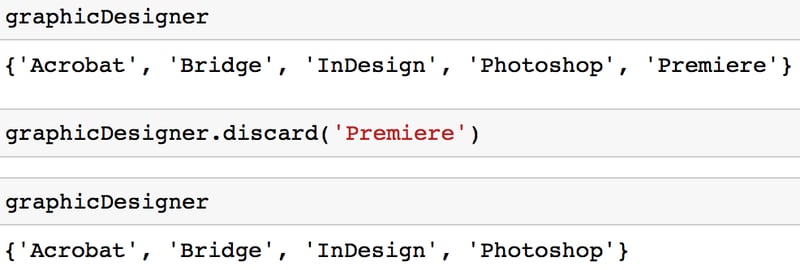
इस तरीके का remove मेथड पर लाभ यह है कि यदि आप कोई ऐसा मान हटाने की कोशिश करते हैं जो सेट का हिस्सा नहीं है, तो आपको KeyError नहीं मिलेगा। यदि आप डिक्शनरीज़ से परिचित हैं, तो आप पाएँगे कि यह डिक्शनरी के get मेथड जैसा काम करता है।
विकल्प 3: आप pop मेथड का उपयोग करके किसी सेट से एक मनमाना मान हटाकर वापस भी प्राप्त कर सकते हैं।
graphicDesigner.pop()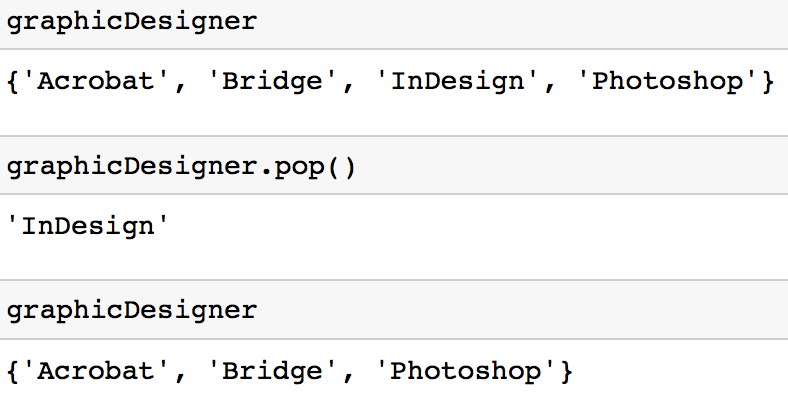
यह ध्यान देने योग्य है कि यदि सेट खाली है तो यह मेथड KeyError उठाता है।
Python सेट से सभी मान हटाएँ
आप clear मेथड का उपयोग करके किसी सेट से सभी मान हटा सकते हैं।
graphicDesigner.clear()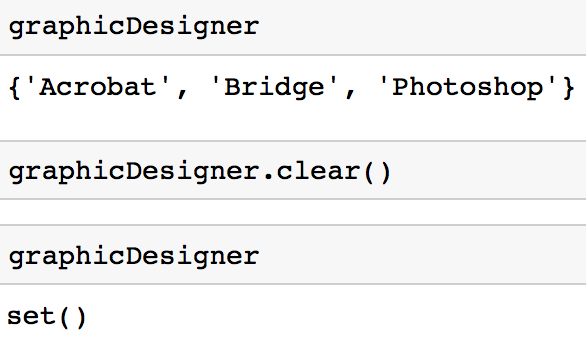
Python सेट मान अपडेट करें
update मेथड किसी सेट में किसी अन्य सेट के एलिमेंट्स जोड़ता है। यह एक तर्क लेता है जो सेट, लिस्ट, ट्यूपल या डिक्शनरी हो सकता है। .update() मेथड अन्य डेटा टाइप्स को स्वतः सेट में बदलकर उस सेट में जोड़ देता है।
उदाहरण में, हमने तीन सेट इनिशियलाइज़ किए हैं और update फ़ंक्शन का उपयोग करके set2 के एलिमेंट्स set1 में और फिर set3 के एलिमेंट्स set1 में जोड़े हैं।
# Initialize 3 sets
set1 = set([7, 10, 11, 13])
set2 = set([11, 8, 9, 12, 14, 15])
set3 = {'d', 'f', 'h'}
# Update set1 with set2
set1.update(set2)
print(set1)
# Update set1 with set3
set1.update(set3)
print(set1)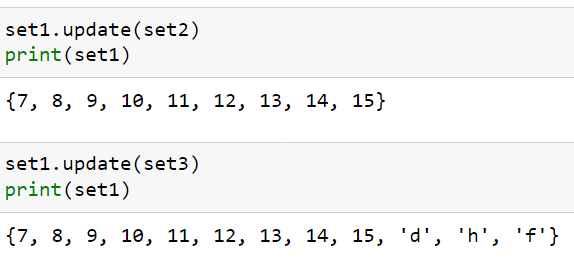
Python सेट पर इटरेट करें
कई मानक Python डेटा टाइप्स की तरह, किसी सेट पर भी इटरेट करना संभव है।
# Initialize a set
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
for skill in dataScientist:
print(skill)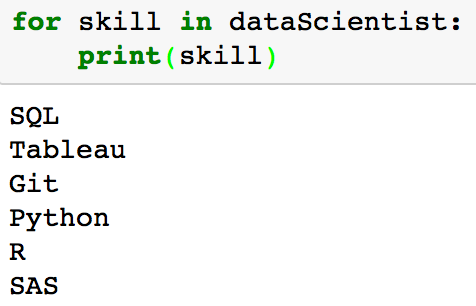
dataScientist के प्रत्येक मान को प्रिंट करने के आउटपुट को देखें, तो ध्यान दें कि सेट में प्रिंट हुए मान उसी क्रम में नहीं हैं जिसमें वे जोड़े गए थे। ऐसा इसलिए है क्योंकि सेट्स अनऑर्डर्ड होते हैं।
Python सेट को क्रमबद्ध मानों में बदलें
इस ट्यूटोरियल में ज़ोर दिया गया है कि सेट्स अनऑर्डर्ड होते हैं। यदि आपको अपने सेट के मानों को ऑर्डर्ड रूप में चाहिए, तो आप sorted फ़ंक्शन का उपयोग कर सकते हैं, जो एक ऑर्डर्ड लिस्ट देता है।
type(sorted(dataScientist))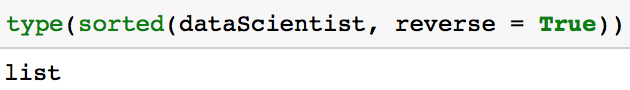
नीचे दिया गया कोड सेट dataScientist के मानों को वर्णानुक्रम में अवरोही क्रम (इस मामले में Z-A) में आउटपुट करता है।
sorted(dataScientist, reverse = True)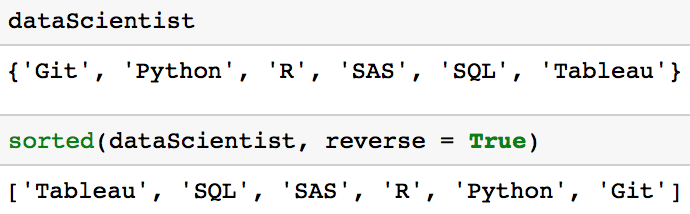
Python में लिस्ट से डुप्लिकेट हटाएँ
इस खंड का कुछ हिस्सा पहले 18 Most Common Python List Questions ट्यूटोरियल में देखा गया था, लेकिन यह बताना महत्वपूर्ण है कि लिस्ट से डुप्लिकेट्स हटाने का सबसे तेज़ तरीका सेट्स हैं। इसे दिखाने के लिए, आइए दो तरीकों के बीच के परफॉर्मेंस अंतर का अध्ययन करें।
तरीका 1: लिस्ट से डुप्लिकेट्स हटाने के लिए सेट का उपयोग करें।
print(list(set([1, 2, 3, 1, 7])))तरीका 2: लिस्ट से डुप्लिकेट्स हटाने के लिए लिस्ट कॉम्प्रिहेंशन का उपयोग करें (यदि आप लिस्ट कॉम्प्रिहेंशंस पर दोहराव चाहते हैं, तो यह ट्यूटोरियल देखें)।
def remove_duplicates(original):
unique = []
[unique.append(n) for n in original if n not in unique]
return(unique)
print(remove_duplicates([1, 2, 3, 1, 7]))परफॉर्मेंस अंतर को timeit लाइब्रेरी का उपयोग करके मापा जा सकता है, जो आपको अपने Python कोड का समय निकालने देती है। नीचे दिया गया कोड प्रत्येक तरीके के कोड को 10000 बार चलाता है और सेकंड में कुल समय आउटपुट करता है।
import timeit
# Approach 1: Execution time
print(timeit.timeit('list(set([1, 2, 3, 1, 7]))', number=10000))
# Approach 2: Execution time
print(timeit.timeit('remove_duplicates([1, 2, 3, 1, 7])', globals=globals(), number=10000))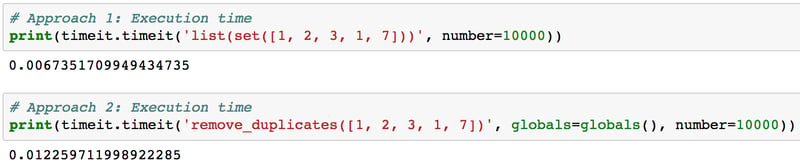
इन दो तरीकों की तुलना करने पर पता चलता है कि डुप्लिकेट हटाने के लिए सेट्स का उपयोग अधिक कुशल है। भले ही समय में अंतर छोटा लगे, बहुत बड़ी लिस्ट होने पर यह आपके लिए काफी समय बचा सकता है।
Python सेट ऑपरेशंस
Python में सेट्स का एक सामान्य उपयोग मानक गणितीय ऑपरेशंस जैसे union, intersection, difference और symmetric difference की गणना करना है। नीचे दी गई छवि में दो सेट A और B पर कुछ मानक गणितीय ऑपरेशंस दिखाए गए हैं। प्रत्येक वेन आरेख का लाल भाग दिए गए सेट ऑपरेशन का परिणामी सेट है।
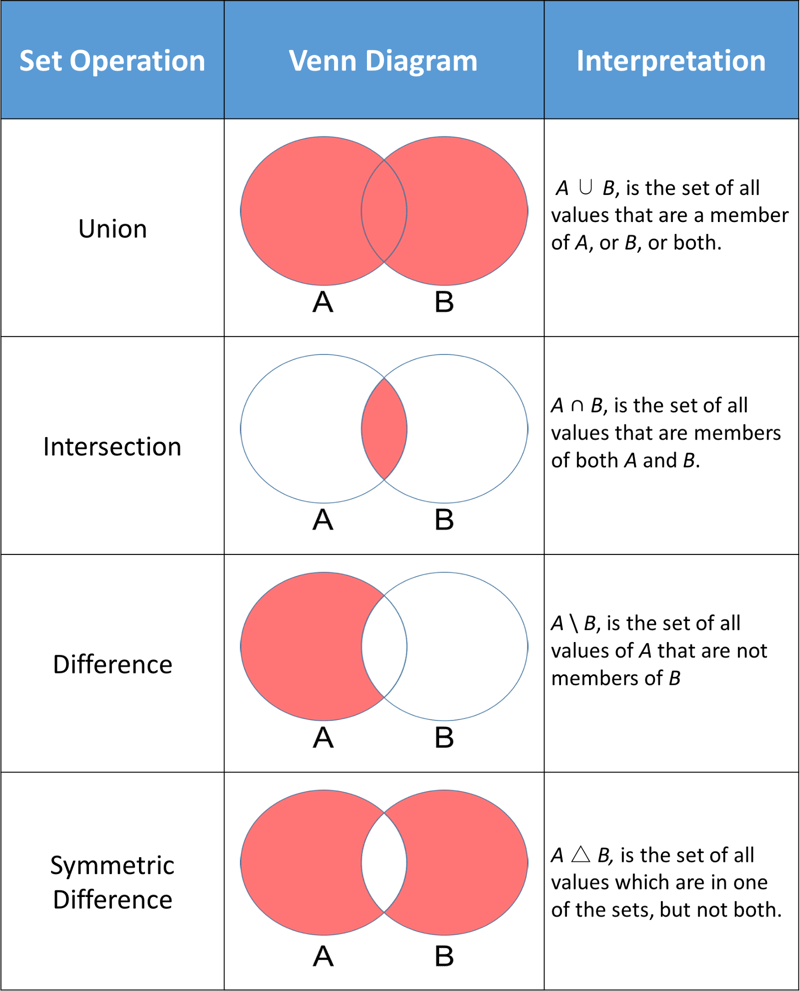
Python सेट्स में ऐसे मेथड्स होते हैं जो आपको ये गणितीय ऑपरेशंस करने देते हैं, साथ ही ऐसे ऑपरेटर्स भी होते हैं जो समान परिणाम देते हैं।
इन मेथड्स का पता लगाने से पहले, आइए दो सेट dataScientist और dataEngineer को इनिशियलाइज़ करके शुरू करें।
dataScientist = set(['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'])
dataEngineer = set(['Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'])union
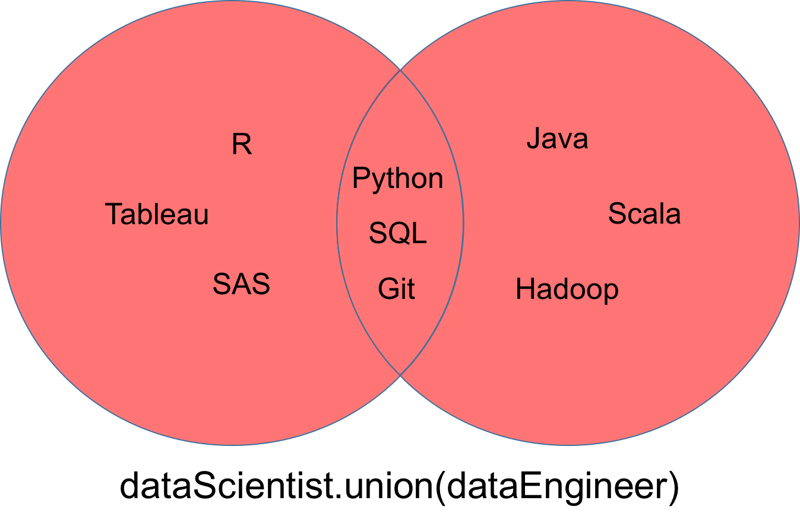
union, जिसे dataScientist ∪ dataEngineer द्वारा सूचित किया जाता है, वह सेट है जिसमें वे सभी मान हैं जो dataScientist के मान हैं, या dataEngineer के मान हैं, या दोनों के हैं। आप union मेथड का उपयोग करके दो सेट्स में सभी युनिक मान निकाल सकते हैं।
# set built-in function union
dataScientist.union(dataEngineer)
# Equivalent Result
dataScientist | dataEngineer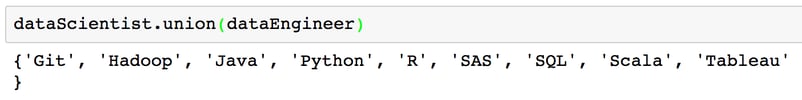
union से लौटा सेट नीचे दिए गए वेन आरेख के लाल भाग के रूप में प्रदर्शित किया जा सकता है।
intersection
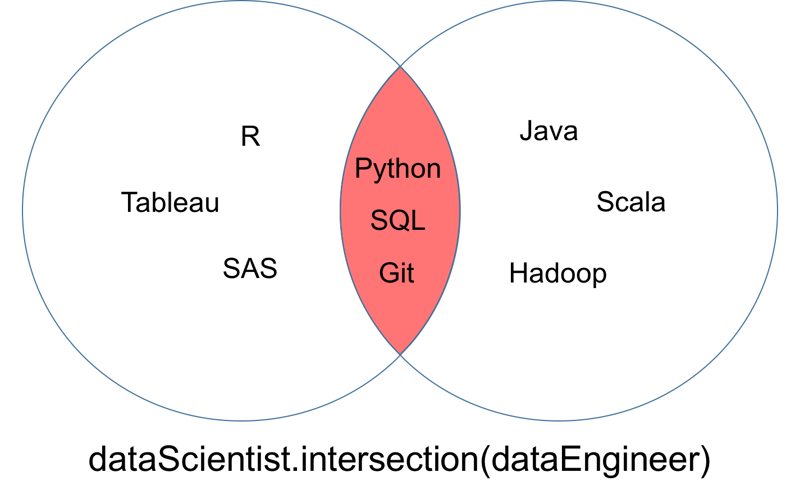
दो सेट dataScientist और dataEngineer का intersection, जिसे dataScientist ∩ dataEngineer द्वारा सूचित किया जाता है, वह सेट है जिसमें वे सभी मान हैं जो दोनों, dataScientist और dataEngineer, के मान हैं।
# Intersection operation
dataScientist.intersection(dataEngineer)
# Equivalent Result
dataScientist & dataEngineer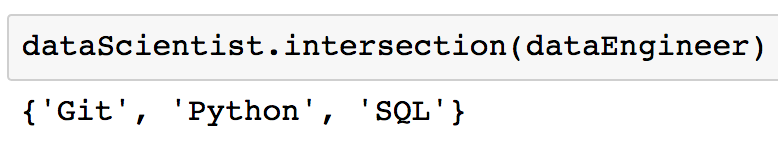
intersection से लौटा सेट नीचे दिए गए वेन आरेख के लाल भाग के रूप में प्रदर्शित किया जा सकता है।
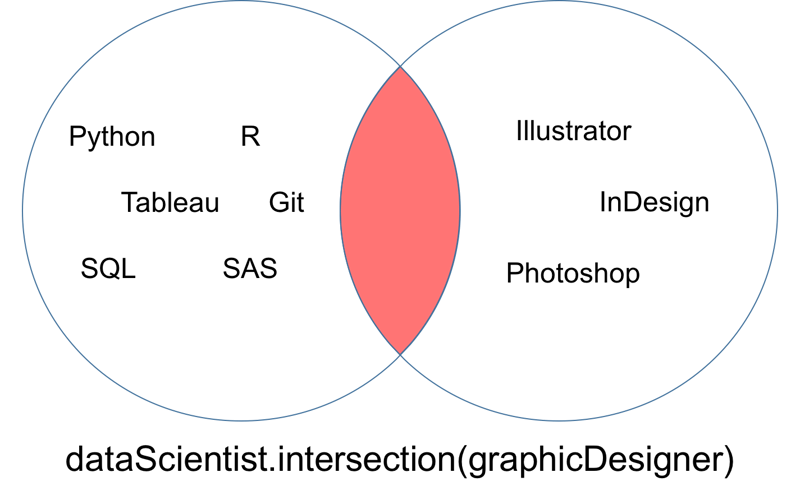
आपको ऐसा केस मिल सकता है जहाँ आप यह सुनिश्चित करना चाहें कि दो सेट्स में कोई भी मान कॉमन न हो। दूसरे शब्दों में, आप ऐसे दो सेट चाहते हैं जिनका intersection खाली हो। ऐसे दो सेट्स को disjoint सेट्स कहा जाता है। आप isdisjoint मेथड का उपयोग करके disjoint सेट्स का परीक्षण कर सकते हैं।
# Initialize a set
graphicDesigner = {'Illustrator', 'InDesign', 'Photoshop'}
# These sets have elements in common so it would return False
dataScientist.isdisjoint(dataEngineer)
# These sets have no elements in common so it would return True
dataScientist.isdisjoint(graphicDesigner)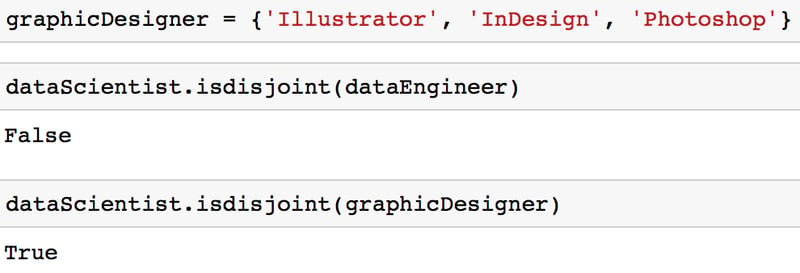
नीचे दिए गए वेन आरेख में दिखाए गए intersection में आप देख सकते हैं कि disjoint सेट्स dataScientist और graphicDesigner के बीच कोई कॉमन मान नहीं है।
Difference
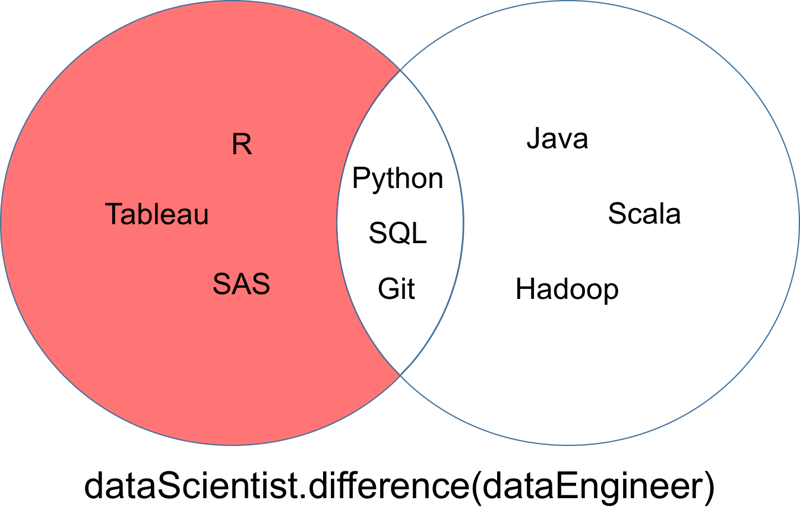
दो सेट dataScientist और dataEngineer का difference, जिसे dataScientist \ dataEngineer द्वारा सूचित किया जाता है, वह सेट है जिसमें dataScientist के वे सभी मान हैं जो dataEngineer के मान नहीं हैं।
# Difference Operation
dataScientist.difference(dataEngineer)
# Equivalent Result
dataScientist - dataEngineer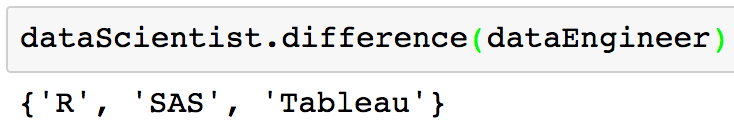
difference से लौटा सेट नीचे दिए गए वेन आरेख के लाल भाग के रूप में प्रदर्शित किया जा सकता है।
Symmetric Difference
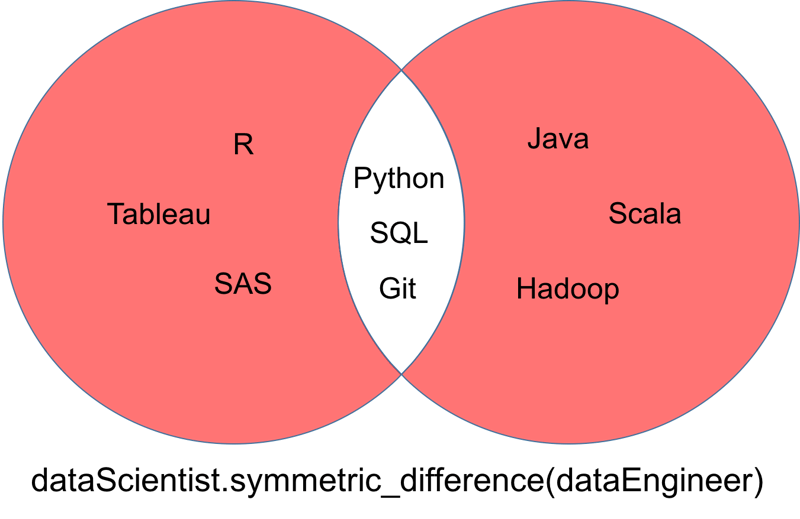
दो सेट dataScientist और dataEngineer का symmetric difference, जिसे dataScientist △ dataEngineer द्वारा सूचित किया जाता है, वह सेट है जिसमें वे सभी मान हैं जो ठीक एक सेट के मान हैं, लेकिन दोनों के नहीं।
# Symmetric Difference Operation
dataScientist.symmetric_difference(dataEngineer)
# Equivalent Result
dataScientist ^ dataEngineer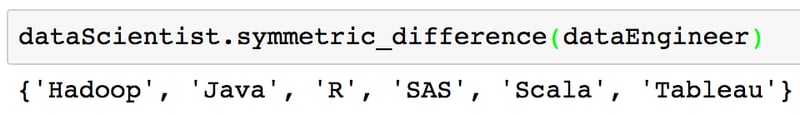
symmetric difference से लौटा सेट नीचे दिए गए वेन आरेख के लाल भाग के रूप में प्रदर्शित किया जा सकता है।
Set Comprehension
आपने पहले लिस्ट कॉम्प्रिहेंशंस, डिक्शनरी कॉम्प्रिहेंशंस और जेनरेटर कॉम्प्रिहेंशंस के बारे में सीखा होगा। Python में सेट कॉम्प्रिहेंशंस भी होते हैं। सेट कॉम्प्रिहेंशंस बहुत समान होते हैं। Python में सेट कॉम्प्रिहेंशंस इस प्रकार बनाए जा सकते हैं:
{skill for skill in ['SQL', 'SQL', 'PYTHON', 'PYTHON']}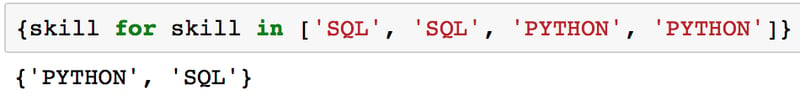
ऊपर का आउटपुट 2 मानों का सेट है क्योंकि सेट्स में एक ही एलिमेंट की कई आवृत्तियाँ नहीं हो सकतीं।
सेट कॉम्प्रिहेंशंस का उपयोग करने के पीछे विचार यह है कि आप कोड में उसी तरह लिख और तर्क कर सकें जैसे आप गणित हाथ से करते हैं।
{skill for skill in ['GIT', 'PYTHON', 'SQL'] if skill not in {'GIT', 'PYTHON', 'JAVA'}}ऊपर दिया गया कोड उस सेट difference के समान है जिसके बारे में आपने पहले सीखा था। यह बस थोड़ा अलग दिखता है।
Membership Tests
Membership टेस्ट यह जाँचते हैं कि कोई विशेष एलिमेंट किसी अनुक्रम, जैसे स्ट्रिंग, लिस्ट, ट्यूपल या सेट, में मौजूद है या नहीं। Python में सेट्स का उपयोग करने के मुख्य लाभों में से एक यह है कि वे membership टेस्ट के लिए अत्यधिक अनुकूलित होते हैं। उदाहरण के लिए, सेट्स लिस्ट्स की तुलना में membership टेस्ट कहीं अधिक कुशलता से करते हैं। यदि आपका कंप्यूटर साइंस बैकग्राउंड है, तो ऐसा इसलिए है क्योंकि सेट्स में membership टेस्ट की औसत समय जटिलता O(1) होती है जबकि लिस्ट्स के लिए O(n)।
नीचे दिया गया कोड एक लिस्ट का उपयोग करके membership टेस्ट दिखाता है।
# Initialize a list
possibleList = ['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala']
# Membership test
'Python' in possibleList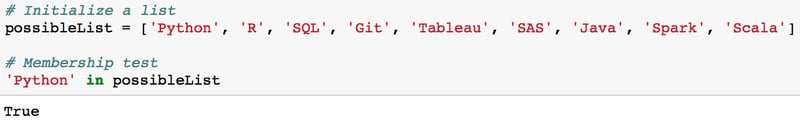
सेट्स के लिए भी कुछ ऐसा ही किया जा सकता है। बस सेट्स अधिक कुशल होते हैं।
# Initialize a set
possibleSet = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala'}
# Membership test
'Python' in possibleSet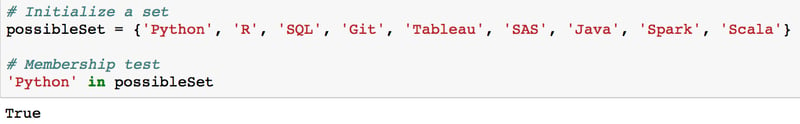
क्योंकि possibleSet एक सेट है और मान 'Python' possibleSet का एक मान है, इसे 'Python' ∈ possibleSet के रूप में व्यक्त किया जा सकता है।
यदि आपके पास कोई ऐसा मान होता जो सेट का हिस्सा नहीं है, जैसे 'Fortran', तो इसे 'Fortran' ∉ possibleSet के रूप में लिखा जाएगा।
Subset
Membership को समझने का एक व्यावहारिक अनुप्रयोग subsets हैं।
पहले दो सेट इनिशियलाइज़ करते हैं।
possibleSkills = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
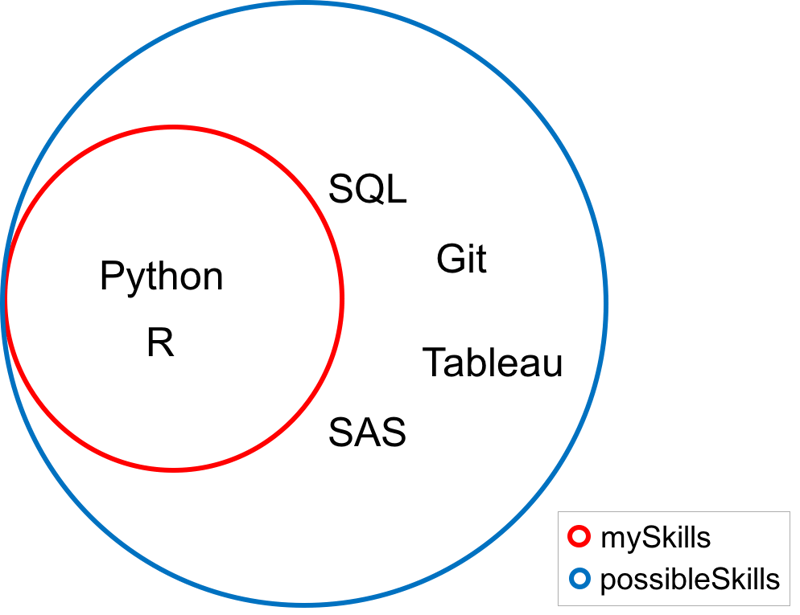
mySkills = {'Python', 'R'}यदि सेट mySkills का हर मान सेट possibleSkills का भी मान है, तो mySkills को possibleSkills का subset कहा जाता है, जिसे गणितीय रूप से mySkills ⊆ possibleSkills लिखा जाता है।
आप issubset मेथड का उपयोग करके जाँच सकते हैं कि एक सेट दूसरे का subset है या नहीं।
mySkills.issubset(possibleSkills)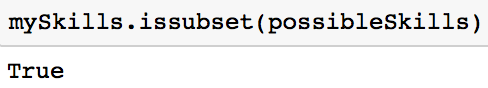
क्योंकि इस मामले में मेथड True लौटाता है, यह एक subset है। नीचे दिए गए वेन आरेख में ध्यान दें कि सेट mySkills का हर मान सेट possibleSkills का भी मान है।
Frozensets
आपने नेस्टेड लिस्ट्स और ट्यूपल्स देखे होंगे।
# Nested Lists and Tuples
nestedLists = [['the', 12], ['to', 11], ['of', 9], ['and', 7], ['that', 6]]
nestedTuples = (('the', 12), ('to', 11), ('of', 9), ('and', 7), ('that', 6))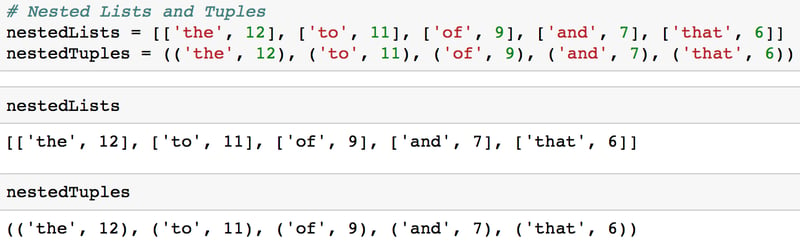
नेस्टेड सेट्स की समस्या यह है कि आप सामान्य रूप से नेस्टेड Python सेट्स नहीं बना सकते, क्योंकि सेट्स में परिवर्तनशील मान (mutable values), जिनमें सेट्स भी शामिल हैं, नहीं हो सकते।
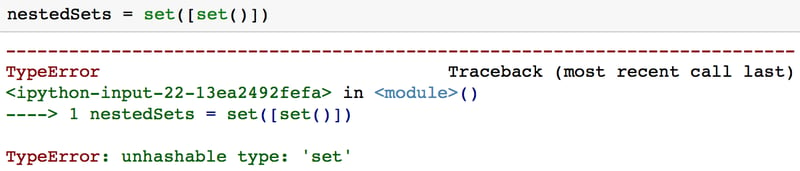
यह वह स्थिति है जहाँ आप frozenset का उपयोग करना चाह सकते हैं। frozenset सेट के समान ही होता है, सिवाय इसके कि frozenset अपरिवर्तनीय (immutable) होता है।
आप frozenset() का उपयोग करके frozenset बनाते हैं।
# Initialize a frozenset
immutableSet = frozenset()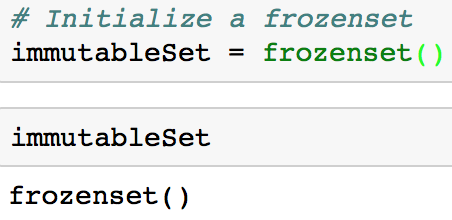
यदि आप नीचे दिए गए कोड जैसा frozenset उपयोग करते हैं, तो आप नेस्टेड सेट बना सकते हैं।
nestedSets = set([frozenset()])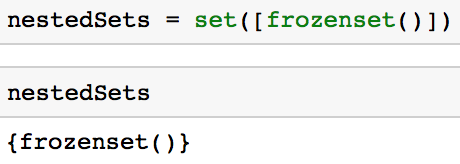
ध्यान रखना महत्वपूर्ण है कि frozenset की एक बड़ी कमी यह है कि चूँकि वे अपरिवर्तनीय हैं, इसलिए आप मानों को जोड़ या हटा नहीं सकते।
निष्कर्ष
Python सेट्स किसी कलेक्शन (जैसे लिस्ट) से डुप्लिकेट मानों को कुशलता से हटाने और यूनियन व इंटरसेक्शन जैसी सामान्य गणितीय क्रियाएँ करने के लिए अत्यंत उपयोगी हैं। लोगों को अक्सर जो चुनौतियाँ आती हैं, वे यह हैं कि विभिन्न डेटा प्रकारों का उपयोग कब करें। उदाहरण के लिए, यदि आपको यकीन नहीं है कि डिक्शनरी बनाम सेट का उपयोग करना कब फायदेमंद है, तो मैं आपको DataCamp के डेली प्रैक्टिस मोड को देखने के लिए प्रोत्साहित करता/करती हूँ। यदि ट्यूटोरियल पर आपके कोई प्रश्न या विचार हैं, तो नीचे टिप्पणियों में या Twitter के माध्यम से बेझिझक संपर्क करें।
Python Sets बनाम Lists और Tuples
लिस्ट्स और ट्यूपल्स मानों को क्रमबद्ध रूप में संग्रहीत करने वाले मानक Python डेटा टाइप्स हैं। सेट्स भी एक मानक Python डेटा टाइप हैं जो मानों को संग्रहीत करते हैं। मुख्य अंतर यह है कि सेट्स, लिस्ट्स या ट्यूपल्स के विपरीत, एक ही तत्व की एक से अधिक आवृत्तियाँ नहीं रख सकते और इनमें मान अव्यवस्थित होते हैं।
Python Set के लाभ
क्योंकि सेट्स में एक ही तत्व की एक से अधिक आवृत्तियाँ नहीं हो सकतीं, इसलिए वे किसी लिस्ट या ट्यूपल से डुप्लिकेट मानों को कुशलतापूर्वक हटाने और यूनियन व इंटरसेक्शन जैसी सामान्य गणितीय क्रियाएँ करने में अत्यंत उपयोगी होते हैं।
यदि आप अपने Python कौशल को निखारना चाहते हैं, या आप अभी शुरुआती हैं, तो DataCamp पर हमारे Python Programmer करियर ट्रैक को अवश्य देखें।
तो चलिए, शुरू करते हैं।
Python में Set कैसे बनाएँ
सेट्स असंगठित, परिवर्तनशील संग्रह हैं जिनमें भिन्न (यूनिक) अपरिवर्तनीय मान होते हैं।
आप set() का उपयोग करके एक खाली सेट प्रारंभ कर सकते हैं।
किसी सेट को मानों के साथ प्रारंभ करने के लिए, आप set() में एक लिस्ट पास कर सकते हैं।