डेटा साइंस को 21वीं सदी की 'सबसे आकर्षक नौकरी' कहा गया है, और यह केवल अतिशयोक्ति नहीं है। यूएस ब्यूरो ऑफ लेबर स्टैटिस्टिक्स का अनुमान है कि 2023 से 2033 के बीच डेटा वैज्ञानिक भूमिकाएँ 36% बढ़ेंगी, जो इस क्षेत्र के बढ़ते महत्व का स्पष्ट प्रमाण है।
लेकिन वास्तव में डेटा साइंस है क्या, और यह इतना महत्वपूर्ण क्यों है? यह लेख आपको डेटा साइंस की दुनिया में ले जाएगा—डेटा साइंस लाइफसाइकल से लेकर विभिन्न उद्योगों में इसके अनुप्रयोगों तक, डेटा साइंस में प्रवेश करने के लिए आवश्यक कौशलों तक, और भी बहुत कुछ। हम बताएंगे कि आज यह उद्योग इतना गतिशील क्यों है और कैसे डेटा साइंस ने प्रमुखता हासिल की है।
डेटा साइंस क्या है?
डेटा साइंस एक बहुविषयक क्षेत्र है जो संरचित और असंरचित डेटा से ज्ञान और अंतर्दृष्टि निकालने के लिए वैज्ञानिक तरीकों, प्रक्रियाओं, एल्गोरिदम और प्रणालियों का उपयोग करता है। सरल शब्दों में, डेटा साइंस का मतलब है डेटा को प्राप्त करना, उसे संसाधित करना, और विश्लेषण करके विभिन्न उद्देश्यों के लिए अंतर्दृष्टि पाना।
डेटा साइंस लाइफसाइकल
डेटा साइंस लाइफसाइकल उन चरणों को संदर्भित करता है जिनसे एक डेटा साइंस प्रोजेक्ट आमतौर पर गुजरता है—प्रारंभिक परिकल्पना और डेटा संग्रह से लेकर परिणामों और अंतर्दृष्टियों के संप्रेषण तक।
हालाँकि हर डेटा साइंस प्रोजेक्ट अपने आप में अनोखा होता है—समस्या, लागू उद्योग, और शामिल डेटा पर निर्भर—अधिकांश प्रोजेक्ट्स एक समान लाइफसाइकल का अनुसरण करते हैं।
यह लाइफसाइकल जटिल डेटा को संभालने, सटीक निष्कर्ष निकालने, और डेटा-आधारित निर्णय लेने के लिए एक संरचित दृष्टिकोण प्रदान करता है।
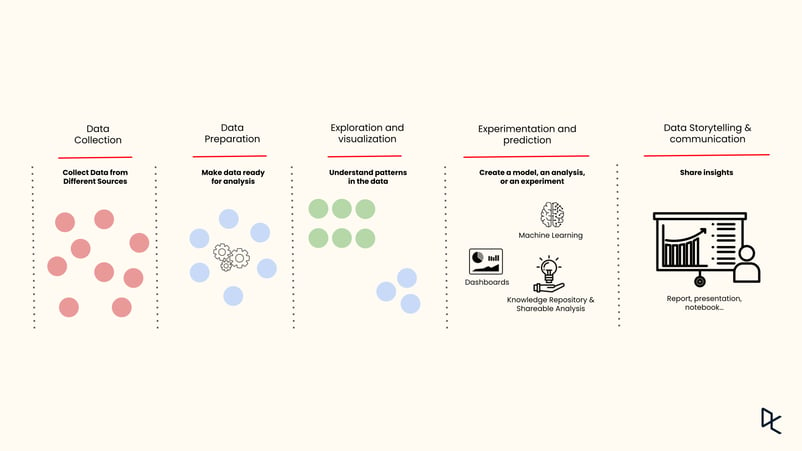
डेटा साइंस लाइफसाइकल
यहाँ डेटा साइंस लाइफसाइकल की पाँच मुख्य अवस्थाएँ दी गई हैं:
डेटा संग्रह और भंडारण
इस प्रारंभिक चरण में विभिन्न स्रोतों से डेटा एकत्र किया जाता है, जैसे डेटाबेस, Excel फाइलें, टेक्स्ट फाइलें, APIs, वेब स्क्रैपिंग, या रियल-टाइम डेटा स्ट्रीम्स। एकत्र किए गए डेटा का प्रकार और मात्रा मुख्यतः उस समस्या पर निर्भर करता है जिसे आप संबोधित कर रहे हैं।
एकत्रण के बाद, इस डेटा को आगे की प्रोसेसिंग के लिए उपयुक्त स्वरूप में संग्रहीत किया जाता है। डेटा का सुरक्षित और कुशल भंडारण महत्वपूर्ण है ताकि शीघ्र पुनर्प्राप्ति और प्रोसेसिंग संभव हो सके।
डेटा तैयारी
अक्सर सबसे समय लेने वाला चरण माना जाने वाला डेटा तैयारी, कच्चे डेटा को विश्लेषण के लिए उपयुक्त रूप में बदलने और साफ करने से जुड़ा है। इसमें मिसिंग या असंगत डेटा को संभालना, डुप्लीकेट्स हटाना, नॉर्मलाइज़ेशन, और डेटा टाइप रूपांतरण शामिल हैं। उद्देश्य एक साफ-सुथरा, उच्च-गुणवत्ता वाला डेटासेट बनाना है जो सटीक और विश्वसनीय विश्लेषणात्मक परिणाम दे सके।
अन्वेषण और विज़ुअलाइज़ेशन
इस चरण में, डेटा वैज्ञानिक तैयार किए गए डेटा का अन्वेषण करते हैं ताकि उसके पैटर्न, विशेषताओं, और संभावित विसंगतियों को समझ सकें। सांख्यिकीय विश्लेषण और डेटा विज़ुअलाइज़ेशन जैसी तकनीकें डेटा की मुख्य विशेषताओं का सार प्रस्तुत करती हैं, अक्सर दृश्य तरीकों से।
चार्ट्स और ग्राफ़ जैसी विज़ुअलाइज़ेशन टूल्स डेटा को अधिक समझने योग्य बनाते हैं, जिससे हितधारक ट्रेंड्स और पैटर्न्स को बेहतर ढंग से समझ सकें।
प्रयोग और पूर्वानुमान
डेटा वैज्ञानिक इस चरण में मशीन लर्निंग एल्गोरिदम और सांख्यिकीय मॉडलों का उपयोग करके पैटर्न की पहचान करते हैं, पूर्वानुमान लगाते हैं, या अंतर्दृष्टियाँ खोजते हैं। लक्ष्य प्रोजेक्ट के उद्देश्यों के अनुरूप डेटा से सार्थक निष्कर्ष निकालना है—चाहे भविष्य के परिणामों का पूर्वानुमान हो, डेटा का वर्गीकरण हो, या छिपे पैटर्न्स का पता लगाना।
डेटा स्टोरीटेलिंग और संचार
अंतिम चरण डेटा विश्लेषण से प्राप्त परिणामों की व्याख्या और उनका संप्रेषण करने से जुड़ा है। केवल अंतर्दृष्टि होना पर्याप्त नहीं है; आपको उन्हें स्पष्ट, संक्षिप्त भाषा और प्रभावशाली विज़ुअल्स के माध्यम से प्रभावी ढंग से संप्रेषित करना चाहिए। लक्ष्य यह है कि गैर-तकनीकी हितधारकों तक निष्कर्ष इस तरह पहुँचें कि वे निर्णय लेने या रणनीतिक पहलों को प्रभावित कर सकें।
इस लाइफसाइकल को समझना और लागू करना डेटा साइंस प्रोजेक्ट्स के लिए अधिक व्यवस्थित और सफल दृष्टिकोण को संभव बनाता है। अब देखते हैं कि डेटा साइंस इतना महत्वपूर्ण क्यों है।
डेटा साइंस महत्वपूर्ण क्यों है?
डेटा साइंस एक क्रांतिकारी क्षेत्र के रूप में उभरा है जो डेटा से अंतर्दृष्टियाँ उत्पन्न करने और व्यवसायों को बदलने में महत्वपूर्ण भूमिका निभाता है। यह कहना अतिशयोक्ति नहीं होगी कि डेटा साइंस आधुनिक उद्योगों की रीढ़ है। लेकिन इसे इतना महत्व क्यों मिला है?
- डेटा की मात्रा। सबसे पहले, डिजिटल तकनीकों के उदय ने डेटा में विस्फोट कर दिया है। हर ऑनलाइन लेन-देन, सोशल मीडिया इंटरैक्शन, और डिजिटल प्रक्रिया डेटा उत्पन्न करती है। हालाँकि, यह डेटा तभी मूल्यवान है जब हम इससे सार्थक अंतर्दृष्टियाँ निकाल सकें—और यहीं डेटा साइंस काम आता है।
- मूल्य सृजन। दूसरा, डेटा साइंस केवल डेटा का विश्लेषण भर नहीं है; यह उस डेटा की व्याख्या कर उसे सूचित व्यावसायिक निर्णयों, भविष्य के रुझानों के पूर्वानुमान, ग्राहक व्यवहार की समझ, और परिचालन दक्षता बढ़ाने में उपयोग करने के बारे में है। डेटा-आधारित निर्णय लेने की यही क्षमता संगठनों के लिए डेटा साइंस को अनिवार्य बनाती है।
- कैरियर विकल्प। अंत में, डेटा साइंस आकर्षक करियर अवसर प्रदान करता है। डेटा के साथ काम कर सकने वाले पेशेवरों की बढ़ती मांग के साथ, डेटा साइंस की नौकरियाँ उद्योग में सबसे अधिक वेतन वाली नौकरियों में से हैं। Glassdoor के अनुसार, संयुक्त राज्य अमेरिका में एक डेटा वैज्ञानिक का औसत बेस वेतन $116,000 है, जो इसे एक लाभकारी कैरियर विकल्प बनाता है।
डेटा साइंस का उपयोग किसके लिए होता है?
डेटा साइंस का उपयोग अनेक अनुप्रयोगों में होता है—ग्राहक व्यवहार का पूर्वानुमान लगाने से लेकर व्यावसायिक प्रक्रियाओं का अनुकूलन करने तक। डेटा साइंस का दायरा व्यापक है और यह विभिन्न प्रकार के एनालिटिक्स को समेटता है।
- डिस्क्रिप्टिव एनालिटिक्स। पिछले डेटा का विश्लेषण कर वर्तमान स्थिति और रुझानों की पहचान करता है। उदाहरण के लिए, एक रिटेल स्टोर पिछली तिमाही की बिक्री का विश्लेषण कर सकता है या सर्वाधिक बिकने वाले उत्पादों की पहचान कर सकता है।
- डायग्नोस्टिक एनालिटिक्स। यह समझने के लिए डेटा का अन्वेषण करता है कि कुछ घटनाएँ क्यों हुईं, पैटर्न और विसंगतियाँ पहचानता है। यदि किसी कंपनी की बिक्री घटती है, तो यह पता लगाएगा कि क्या इसका कारण खराब उत्पाद गुणवत्ता, बढ़ती प्रतिस्पर्धा, या अन्य कारक थे।
- प्रेडिक्टिव एनालिटिक्स। सांख्यिकीय मॉडलों का उपयोग करके पिछले डेटा के आधार पर भविष्य के परिणामों का पूर्वानुमान लगाता है—वित्त, स्वास्थ्य सेवा, और मार्केटिंग में व्यापक रूप से प्रयुक्त। एक क्रेडिट कार्ड कंपनी ग्राहक डिफ़ॉल्ट जोखिम का पूर्वानुमान लगाने के लिए इसका उपयोग कर सकती है।
- प्रेस्क्रिप्टिव एनालिटिक्स। अन्य प्रकार के एनालिटिक्स के परिणामों के आधार पर भविष्य की समस्याओं को कम करने या आशाजनक रुझानों का लाभ उठाने के लिए कार्रवाइयों का सुझाव देता है। उदाहरण के लिए, एक नेविगेशन ऐप वर्तमान ट्रैफ़िक के आधार पर सबसे तेज़ मार्ग बताता है।
डिस्क्रिप्टिव से डायग्नोस्टिक से प्रेडिक्टिव से प्रेस्क्रिप्टिव एनालिटिक्स तक बढ़ती परिष्कृतता कंपनियों को निर्णय-निर्धारण और रणनीतिक योजना के लिए मूल्यवान अंतर्दृष्टियाँ प्रदान कर सकती है। आप एनालिटिक्स के चार प्रकार पर एक अलग लेख में अधिक पढ़ सकते हैं।
डेटा साइंस के लाभ क्या हैं?
डेटा साइंस किसी भी ऐसे व्यवसाय में मूल्य जोड़ सकता है जो अपने डेटा का उपयोग करता है। आँकड़ों से लेकर पूर्वानुमानों तक, प्रभावी डेटा-आधारित प्रथाएँ किसी कंपनी को सफलता की तेज़ राह पर ला सकती हैं। यहाँ कुछ तरीके हैं जिनसे डेटा साइंस का उपयोग होता है:
व्यावसायिक प्रक्रियाओं का अनुकूलन
डेटा साइंस लॉजिस्टिक्स और सप्लाई चेन से लेकर एचआर और आगे तक विभिन्न विभागों में कंपनी के संचालन में उल्लेखनीय सुधार कर सकता है। यह संसाधन आवंटन, प्रदर्शन मूल्यांकन, और प्रक्रिया स्वचालन में मदद कर सकता है। उदाहरण के लिए, एक लॉजिस्टिक्स कंपनी मार्गों का अनुकूलन, डिलीवरी समय कम करने, ईंधन लागत बचाने, और ग्राहक संतुष्टि बढ़ाने के लिए डेटा साइंस का उपयोग कर सकती है।
नई अंतर्दृष्टियों का पता लगाना
डेटा साइंस ऐसे छिपे पैटर्न और अंतर्दृष्टियाँ उजागर कर सकता है जो पहली नज़र में स्पष्ट नहीं होते। ये अंतर्दृष्टियाँ कंपनियों को प्रतिस्पर्धात्मक बढ़त दे सकती हैं और उन्हें अपने व्यवसाय को बेहतर समझने में मदद कर सकती हैं। उदाहरण के लिए, कोई कंपनी ग्राहक डेटा का उपयोग करके रुझान और पसंद की पहचान कर सकती है, जिससे वे अपने उत्पादों या सेवाओं को उसी अनुरूप ढाल सकें।
नवोन्मेषी उत्पाद और समाधान बनाना
कंपनियाँ ग्राहक की आवश्यकताओं और पसंद के आधार पर नए उत्पाद या सेवाएँ विकसित करने और नवाचार करने के लिए डेटा साइंस का उपयोग कर सकती हैं। यह व्यवसायों को बाज़ार रुझानों का पूर्वानुमान लगाने और प्रतिस्पर्धा से आगे रहने में भी सक्षम बनाता है। उदाहरण के लिए, Netflix जैसी स्ट्रीमिंग सेवाएँ दर्शकों की पसंद समझने और व्यक्तिगत सिफारिशें बनाने के लिए डेटा साइंस का उपयोग करती हैं, जिससे उपयोगकर्ता अनुभव बेहतर होता है।
कौन-से उद्योग डेटा साइंस का उपयोग करते हैं?
डेटा साइंस के प्रभाव सभी उद्योगों में फैले हुए हैं, जिससे संगठनों के संचालन और निर्णय लेने के तरीके बुनियादी तौर पर बदल रहे हैं। जबकि हर उद्योग डेटा साइंस लागू करने से लाभान्वित हो सकता है, यह विशेष रूप से डेटा-समृद्ध क्षेत्रों में प्रभावशाली है।
आइए देखें कि डेटा साइंस इन प्रमुख उद्योगों में कैसे क्रांति ला रहा है:
वित्त में डेटा साइंस के अनुप्रयोग
वित्त क्षेत्र ने डेटा साइंस की शक्ति को तेजी से अपनाया है। फ्रॉड डिटेक्शन और एल्गोरिथमिक ट्रेडिंग से लेकर पोर्टफोलियो प्रबंधन और जोखिम आकलन तक, डेटा साइंस ने जटिल वित्तीय कार्यों को अधिक कुशल और सटीक बना दिया है। उदाहरण के लिए, क्रेडिट कार्ड कंपनियाँ धोखाधड़ी वाले लेनदेन का पता लगाने और रोकने के लिए डेटा साइंस तकनीकों का उपयोग करती हैं, जिससे हर साल अरबों डॉलर की बचत होती है।
Python में वित्त के मूल सिद्धांत और हमारी स्किल ट्रैक के साथ डेटा-आधारित वित्तीय निर्णय लेने के बारे में और जानें।
हेल्थकेयर में डेटा साइंस के अनुप्रयोग
हेल्थकेयर एक और उद्योग है जहाँ डेटा साइंस का गहरा प्रभाव है। अनुप्रयोगों में रोग प्रकोपों का पूर्वानुमान लगाने और रोगी देखभाल की गुणवत्ता में सुधार करने से लेकर अस्पताल प्रबंधन और दवा खोज को बेहतर बनाना शामिल है। प्रेडिक्टिव मॉडल डॉक्टरों को बीमारियों का शुरुआती निदान करने में मदद करते हैं, और उपचार योजनाएँ रोगी की विशिष्ट आवश्यकताओं के अनुरूप अनुकूलित की जा सकती हैं, जिससे बेहतर परिणाम मिलते हैं।
आप DataFramed पॉडकास्ट के एक एपिसोड में डेटा साइंस कैसे हेल्थकेयर को बदल रहा है के बारे में और जान सकते हैं।
मार्केटिंग में डेटा साइंस के अनुप्रयोग
मार्केटिंग वह क्षेत्र है जो डेटा साइंस के आगमन से उल्लेखनीय रूप से बदल गया है। यहाँ के अनुप्रयोग विविध हैं—ग्राहक विभाजन और लक्षित विज्ञापन से लेकर बिक्री पूर्वानुमान और सेंटिमेंट एनालिसिस तक। डेटा साइंस मार्केटर्स को उपभोक्ता व्यवहार को अभूतपूर्व विवरण में समझने देता है, जिससे वे अधिक प्रभावी अभियानों का निर्माण कर सकें। प्रेडिक्टिव एनालिटिक्स संभावित बाज़ार रुझानों की पहचान में भी मदद कर सकता है, जिससे प्रतिस्पर्धात्मक बढ़त मिलती है। पर्सनलाइज़ेशन एल्गोरिदम व्यक्तिगत ग्राहकों के लिए उत्पाद सिफारिशें तैयार कर सकते हैं, जिससे बिक्री और ग्राहक संतुष्टि बढ़ती है।
हमारे पास मार्केटिंग में डेटा साइंस का उपयोग करने के पाँच तरीके पर एक अलग ब्लॉग पोस्ट है, जो उद्योग में प्रयुक्त कुछ तरीकों का अन्वेषण करता है। आप हमारी Marketing Analytics with Python स्किल ट्रैक में भी अधिक सीख सकते हैं।
प्रौद्योगिकी में डेटा साइंस के अनुप्रयोग
टेक कंपनियाँ शायद डेटा साइंस की सबसे बड़ी लाभार्थी हैं। रिकमेंडेशन इंजन को शक्ति देने से लेकर इमेज और स्पीच रिकॉग्निशन को बेहतर बनाने तक, डेटा साइंस के अनुप्रयोग विविध हैं। उदाहरण के लिए, राइड-हेलिंग प्लेटफ़ॉर्म चालक और सवारों को जोड़ने और दिन के समय के अनुसार ड्राइवर सप्लाई को अनुकूलित करने के लिए डेटा साइंस पर निर्भर करते हैं।
डेटा साइंस अन्य डेटा-संबंधित क्षेत्रों से कैसे भिन्न है?
हालाँकि डेटा साइंस कई ऐसे क्षेत्रों से ओवरलैप करता है जो डेटा के साथ काम करते हैं, यह सिद्धांतों, टूल्स, और तकनीकों के एक अद्वितीय मिश्रण के साथ आता है, जो डेटा से सार्थक पैटर्न निकालने के लिए डिज़ाइन किया गया है।
डेटा साइंस और संबंधित क्षेत्रों के बीच अंतर करना परिदृश्य को बेहतर समझने और सही करियर पथ तय करने में मदद कर सकता है। आइए इन अंतरों को स्पष्ट करें।
डेटा साइंस बनाम डेटा एनालिटिक्स
डेटा साइंस और डेटा एनालिटिक्स दोनों डेटा से मूल्य निकालने में महत्वपूर्ण भूमिका निभाते हैं, लेकिन उनका फोकस अलग होता है। डेटा साइंस एक व्यापक क्षेत्र है जो मशीन लर्निंग और प्रेडिक्टिव एनालिटिक्स सहित तरीकों का उपयोग कर डेटा से अंतर्दृष्टियाँ निकालता है। इसके विपरीत, डेटा एनालिटिक्स विशिष्ट प्रश्नों के उत्तर देने के लिए मौजूदा डेटासेट्स को प्रोसेस करने और उन पर सांख्यिकीय विश्लेषण करने पर केंद्रित है।
डेटा साइंस बनाम बिज़नेस एनालिटिक्स
बिज़नेस एनालिटिक्स भी डेटा विश्लेषण से संबंधित है, लेकिन यह रणनीतिक व्यावसायिक निर्णयों के लिए डेटा का लाभ उठाने पर अधिक केंद्रित होता है। यह आमतौर पर डेटा साइंस की तुलना में कम तकनीकी और अधिक व्यवसाय-केंद्रित होता है। डेटा साइंस, भले ही वह व्यावसायिक रणनीतियों को सूचित कर सकता है, अक्सर प्रोग्रामिंग और मशीन लर्निंग जैसे तकनीकी पहलुओं में गहराई तक जाता है।
डेटा साइंस बनाम डेटा इंजीनियरिंग
डेटा इंजीनियरिंग डेटा संग्रह, भंडारण, और प्रोसेसिंग के लिए इन्फ्रास्ट्रक्चर का निर्माण और रखरखाव करने पर केंद्रित है, ताकि डेटा साफ़ और सुलभ रहे। दूसरी ओर, डेटा साइंस इसी डेटा का विश्लेषण कर सांख्यिकीय और मशीन लर्निंग मॉडलों से मूल्यवान अंतर्दृष्टियाँ निकालता है, जो व्यावसायिक निर्णयों को प्रभावित करती हैं। सार रूप में, डेटा इंजीनियर्स डेटा की 'सड़कें' बनाते हैं, जबकि डेटा साइंटिस्ट्स उन पर 'ड्राइव' कर सार्थक अंतर्दृष्टियाँ निकालते हैं। दोनों भूमिकाएँ डेटा-चालित संगठन में महत्वपूर्ण हैं।
डेटा साइंस बनाम मशीन लर्निंग
मशीन लर्निंग डेटा साइंस का एक उप-समुच्चय है, जो ऐसे एल्गोरिदम बनाने और लागू करने पर केंद्रित है जो मशीनों को डेटा से सीखने और निर्णय लेने में सक्षम बनाते हैं। जबकि डेटा साइंस व्यापक है और डेटा से सार्थक जानकारी निकालने के लिए मशीन लर्निंग सहित कई तकनीकों को समेटता है।
डेटा साइंस बनाम सांख्यिकी
सांख्यिकी, जो डेटा संग्रह, विश्लेषण, व्याख्या, और संगठन से संबंधित एक गणितीय विधा है, डेटा साइंस का एक प्रमुख घटक है। हालाँकि, डेटा साइंस डेटा से अंतर्दृष्टियाँ निकालने के लिए सांख्यिकी को अन्य तरीकों के साथ एकीकृत करता है, जिससे यह अधिक बहुविषयक क्षेत्र बन जाता है।
|
उद्योग
|
फोकस
|
तकनीकी जोर
|
|
डेटा साइंस
|
एनालिटिक्स के 4 स्तरों में डेटा से मूल्य संचालित करना
|
प्रोग्रामिंग, ML, सांख्यिकी
|
|
डेटा एनालिटिक्स
|
मौजूदा डेटासेट्स पर सांख्यिकीय विश्लेषण करना
|
सांख्यिकीय विश्लेषण
|
|
बिज़नेस एनालिटिक्स
|
रणनीतिक व्यावसायिक निर्णयों के लिए डेटा का लाभ उठाना
|
व्यावसायिक रणनीतियाँ, डेटा विश्लेषण
|
|
डेटा इंजीनियरिंग
|
डेटा इन्फ्रास्ट्रक्चर बनाना और बनाए रखना
|
डेटा संग्रह, भंडारण, प्रोसेसिंग
|
|
मशीन लर्निंग
|
मशीन लर्निंग के लिए एल्गोरिदम बनाना और लागू करना
|
एल्गोरिदम विकास, मॉडल इम्प्लीमेंटेशन
|
|
सांख्यिकी
|
डेटा का संग्रह, विश्लेषण, व्याख्या, और संगठन
|
सांख्यिकीय विश्लेषण, गणितीय सिद्धांत
|
इन अंतरों को समझने के बाद, अब हम उन प्रमुख अवधारणाओं पर आते हैं जिन्हें हर डेटा वैज्ञानिक को सीखना चाहिए।
मुख्य डेटा साइंस अवधारणाएँ
एक सफल डेटा वैज्ञानिक को केवल तकनीकी कौशल ही नहीं, बल्कि उन आधारभूत अवधारणाओं की समझ भी चाहिए जो इस क्षेत्र की नींव हैं। यहाँ कुछ प्रमुख अवधारणाएँ हैं:
सांख्यिकी और प्रायिकता
ये डेटा साइंस की आधारशिला हैं। सांख्यिकी डेटा से सार्थक अंतर्दृष्टि निकालने में काम आती है, जबकि प्रायिकता उपलब्ध डेटा के आधार पर भविष्य की घटनाओं का पूर्वानुमान लगाने देती है। डिस्ट्रीब्यूशंस, सांख्यिकीय परीक्षण, और प्रायिकता सिद्धांतों की समझ किसी भी डेटा वैज्ञानिक के लिए आवश्यक है।
शुरू करने के लिए संसाधन
प्रोग्रामिंग
प्रोग्रामिंग वह साधन है जिससे डेटा वैज्ञानिक डेटा के साथ काम करते हैं। Python और R भाषाएँ विशेष रूप से लोकप्रिय हैं—उनकी सरलता और शक्तिशाली डेटा हैंडलिंग लाइब्रेरीज़ के कारण। इन भाषाओं से परिचय डेटा को साफ़ करने, प्रोसेस करने, और प्रभावी ढंग से विश्लेषित करने में सहायक होता है।
शुरू करने के लिए संसाधन
डेटा विज़ुअलाइज़ेशन
डेटा विज़ुअलाइज़ेशन जटिल डेटा को दृश्य और आसानी से समझ आने वाले स्वरूप में प्रस्तुत करने की कला है। यह निष्कर्षों का संप्रेषण करने में मदद करता है और जटिल डेटासेट्स को समझना आसान बनाता है। Tableau, Matplotlib, और Seaborn जैसे टूल आमतौर पर प्रयुक्त होते हैं।
शुरू करने के लिए संसाधन
मशीन लर्निंग
मशीन लर्निंग, जो आर्टिफिशियल इंटेलिजेंस का उप-समुच्चय है, में ऐसे मॉडलों को डेटा पर प्रशिक्षित करना शामिल है जो बिना स्पष्ट रूप से प्रोग्राम किए पूर्वानुमान या निर्णय लेते हैं। यह आधुनिक डेटा साइंस अनुप्रयोगों—रिकमेंडेशन सिस्टम से लेकर प्रेडिक्टिव एनालिटिक्स तक—के केंद्र में है।
शुरू करने के लिए संसाधन
डेटा इंजीनियरिंग
डेटा इंजीनियरिंग डेटा को एकत्र करने, संग्रहीत करने, और प्रोसेस करने के लिए प्रणालियों के डिज़ाइन और निर्माण से संबंधित है। इसी आधार पर डेटा विश्लेषण और मशीन लर्निंग मॉडल बनाए जाते हैं।
शुरू करने के लिए संसाधन
मुख्य डेटा साइंस टूल्स
डेटा वैज्ञानिकों को अपने कार्य प्रभावी ढंग से करने के लिए टूल्स के एक सेट की आवश्यकता होती है। ये टूल्स प्रोग्रामिंग भाषाओं से लेकर डेटा विज़ुअलाइज़ेशन सॉफ़्टवेयर तक हो सकते हैं। यहाँ कुछ आवश्यक डेटा साइंस टूल्स हैं।
प्रोग्रामिंग भाषाएँ
डेटा साइंस के क्षेत्र में, प्रोग्रामिंग भाषाएँ ही कार्य करने के औज़ार हैं। ये कंप्यूटर को विशिष्ट कार्य—जैसे डेटा मैनिपुलेशन, सांख्यिकीय विश्लेषण, और मशीन लर्निंग—करने के निर्देश देने का ढांचा प्रदान करती हैं। यहाँ कुछ प्रमुख भाषाएँ हैं जिन्हें हर डेटा वैज्ञानिक को सीखने पर विचार करना चाहिए:
- Python. अपनी सरलता और pandas तथा NumPy जैसी शक्तिशाली लाइब्रेरीज़ के लिए प्रसिद्ध।
- R. सांख्यिकीय विश्लेषण और विज़ुअलाइज़ेशन के लिए उत्तम।
- Julia. उच्च प्रदर्शन और गति के लिए जानी जाती है—न्यूमेरिकल और वैज्ञानिक कंप्यूटिंग के लिए आदर्श।
शुरू करने के लिए संसाधन
बिज़नेस इंटेलिजेंस टूल्स
बिज़नेस इंटेलिजेंस (BI) टूल्स ऐसे सॉफ़्टवेयर अनुप्रयोग हैं जिनका उपयोग किसी संगठन के कच्चे डेटा का विश्लेषण करने के लिए किया जाता है। ये विज़ुअलाइज़ेशन, रिपोर्टिंग, और डेटा अंतर्दृष्टियों को साझा करने में मदद करते हैं, जिससे कंपनियाँ डेटा-आधारित निर्णय ले सकें। डेटा साइंस के लिए कुछ आवश्यक BI टूल्स इस प्रकार हैं:
- Tableau. इंटरैक्टिव डेटा विज़ुअलाइज़ेशन बनाने के लिए।
- Power BI. Microsoft का बिज़नेस एनालिटिक्स टूल्स का सूट।
- QlikView. ETL, डेटा स्टोरेज, और विज़ुअलाइज़ेशन को संयोजित करता है।
शुरू करने के लिए संसाधन
मशीन लर्निंग लाइब्रेरीज़
मशीन लर्निंग लाइब्रेरीज़ पूर्व-लिखित कोड का संग्रह होती हैं जिन्हें डेटा वैज्ञानिक समय बचाने के लिए उपयोग कर सकते हैं। ये पूर्व-पैकेज्ड एल्गोरिदम और लर्निंग रूटीन प्रदान करती हैं जिन्हें प्रोग्राम्स में एकीकृत किया जा सकता है। यहाँ कुछ प्रमुख लाइब्रेरीज़ हैं जो मशीन लर्निंग कार्यों को सरल बनाती हैं:
- Scikit-learn. वर्गीकरण, प्रतिगमन, क्लस्टरिंग आदि के लिए विभिन्न एल्गोरिदम प्रदान करता है।
- TensorFlow. Google द्वारा न्यूरल नेटवर्क बनाने के लिए विकसित।
- PyTorch. अपने डायनेमिक कंप्यूटेशन ग्राफ़ के लिए प्रसिद्ध।
aResources to get you started
डेटाबेस मैनेजमेंट सिस्टम्स
डेटाबेस मैनेजमेंट सिस्टम्स (DBMS) ऐसे सॉफ़्टवेयर अनुप्रयोग हैं जो उपयोगकर्ता, अन्य अनुप्रयोगों, और डेटाबेस के साथ इंटरैक्ट कर डेटा कैप्चर और विश्लेषित करते हैं। DBMS डेटा को बनाने, पुनः प्राप्त करने, अपडेट करने, और प्रबंधित करने का एक व्यवस्थित तरीका प्रदान करता है। डेटा साइंस में प्रयुक्त कुछ लोकप्रिय DBMS इस प्रकार हैं:
- MySQL. एक ओपन-सोर्स रिलेशनल डेटाबेस सिस्टम।
- PostgreSQL. मल्टी-वर्ज़न कंकरेन्सी कंट्रोल जैसी उन्नत सुविधाएँ प्रदान करता है।
- MongoDB. एक लोकप्रिय NoSQL डेटाबेस।
शुरू करने के लिए संसाधन
शीर्ष डेटा साइंस नौकरियाँ
डेटा साइंस एक विशाल क्षेत्र है जिसमें कई विशेषज्ञ भूमिकाएँ हैं—प्रत्येक की अपनी विशिष्ट ज़िम्मेदारियाँ, कौशल आवश्यकताएँ, और वेतन अपेक्षाएँ हैं। यहाँ डेटा साइंस के क्षेत्र में सबसे अधिक माँग वाली कुछ जॉब टाइटल्स दी गई हैं:
डेटा एनालिस्ट
डेटा एनालिस्ट किसी संगठन के डेटा की व्याख्या करने में महत्वपूर्ण भूमिका निभाते हैं। वे गणितीय और सांख्यिकीय विश्लेषण में विशेषज्ञ होते हैं, जिससे वे जटिल डेटासेट्स को क्रियान्वयन योग्य अंतर्दृष्टियों में बदलते हैं जो व्यावसायिक निर्णयों को संचालित करती हैं। डेटा विज़ुअलाइज़ेशन टूल्स का उपयोग करके वे अपने निष्कर्ष तकनीकी और गैर-तकनीकी दोनों हितधारकों तक प्रभावी ढंग से पहुँचाते हैं।
डेटा एनालिस्ट डेटा में गहराई तक जाकर रिपोर्ट और विज़ुअलाइज़ेशन प्रदान करते हैं जो छिपी अंतर्दृष्टियों को उजागर करते हैं। वे उन्नत एल्गोरिदम विकसित करने में शामिल न भी हों, फिर भी वे डेटा को समझने के लिए कई टूल्स का उपयोग करते हैं। उनकी ज़िम्मेदारियों में SQL क्वेरीज़, डेटा क्लीनिंग, और डेटा मैनेजमेंट भी शामिल हो सकते हैं। डेटा एनालिस्ट कैसे बनें पर एक अलग लेख में अधिक पढ़ें।
मुख्य कौशल:
- SQL, Python, या R में दक्षता
- सांख्यिकीय विश्लेषण की मजबूत समझ
- आकर्षक डेटा विज़ुअलाइज़ेशन और रिपोर्ट बनाने की क्षमता
- डेटा क्लीनिंग और मैनेजमेंट में प्रवीण
- प्रभावी संचार कौशल
आवश्यक टूल्स:
- डेटाबेस क्वेरी के लिए SQL
- डेटा मैनिपुलेशन के लिए Python या R जैसी भाषाएँ
- Tableau या PowerBI जैसे डेटा विज़ुअलाइज़ेशन टूल्स
- MS Excel या Google Sheets जैसे स्प्रेडशीट टूल्स
- SPSS या SAS जैसे सांख्यिकीय सॉफ़्टवेयर
डेटा साइंटिस्ट
डेटा साइंटिस्ट किसी संगठन के डेटा में गहराई तक जाकर सार्थक अंतर्दृष्टियाँ निकालते और संप्रेषित करते हैं। वे मशीन लर्निंग वर्कफ़्लोज़ और उन्हें वास्तविक व्यावसायिक अनुप्रयोगों में लागू करने की समझ रखते हैं। डेटा साइंटिस्ट मुख्यतः कोडिंग टूल्स के साथ काम करते हैं, गहन विश्लेषण करते हैं, और अक्सर बिग डेटा टूल्स का उपयोग करते हैं।
डेटा साइंटिस्ट डेटा जगत के जासूसों की तरह होते हैं। वे समृद्ध डेटा स्रोतों को ढूँढ़ने और उनकी व्याख्या करने, बड़े डेटासेट्स को संभालने, और डेटा पॉइंट्स को मिलाकर रुझान पहचानने के लिए ज़िम्मेदार होते हैं। विश्लेषणात्मक, सांख्यिकीय, और प्रोग्रामिंग कौशल का लाभ लेकर वे व्यापक डेटासेट्स को एकत्रित, विश्लेषित, और व्याख्यायित करते हैं। ये अंतर्दृष्टियाँ जटिल व्यावसायिक समस्याओं के डेटा-आधारित समाधान विकसित करने में सहायक होती हैं—अक्सर मशीन लर्निंग एल्गोरिदम बनाकर जो नई अंतर्दृष्टियाँ उत्पन्न करें, प्रक्रियाओं को स्वचालित करें, या ग्राहकों को बेहतर मूल्य दें।
हमारे पास डेटा साइंटिस्ट कैसे बनें पर एक संपूर्ण गाइड है, जो इस भूमिका में शुरुआत करने के लिए आवश्यक प्रमुख चरणों को बताता है।
मुख्य कौशल:
- Python, R, और SQL पर मजबूत पकड़
- मशीन लर्निंग और एआई अवधारणाओं की समझ
- सांख्यिकीय विश्लेषण, परिमाणात्मक एनालिटिक्स, और प्रेडिक्टिव मॉडलिंग में दक्षता
- डेटा का प्रभावी विज़ुअलाइज़ेशन और रिपोर्टिंग करने की क्षमता
- उत्कृष्ट संचार और प्रस्तुति कौशल
आवश्यक टूल्स:
- Pandas और NumPy जैसे डेटा विश्लेषण टूल्स
- Scikit-learn जैसी मशीन लर्निंग लाइब्रेरीज़
- Matplotlib और Tableau जैसे डेटा विज़ुअलाइज़ेशन टूल्स
- Airflow और Spark जैसे बिग डेटा फ़्रेमवर्क
- Git और Bash जैसे कमांड लाइन टूल्स
डेटा इंजीनियर
डेटा इंजीनियर्स डेटा साइंस जगत के वास्तुकार हैं। वे डेटा इन्फ्रास्ट्रक्चर को डिज़ाइन, निर्मित, और प्रबंधित करते हैं, जिससे डेटा साइंटिस्ट्स डेटा का कुशल विश्लेषण कर सकें। डेटा इंजीनियर्स डेटा संग्रह, भंडारण, और प्रोसेसिंग पर ध्यान केंद्रित करते हैं और ऐसे डेटा पाइपलाइन्स बनाते हैं जो विश्लेषणात्मक प्रक्रिया को सुव्यवस्थित करें।
डेटा इंजीनियर्स अक्सर सूचना निष्कर्षण के लिए एल्गोरिदम डिज़ाइन करते हैं और डेटाबेस सिस्टम्स बनाते हैं। वे डेटा आर्किटेक्चर, डेटाबेस, और प्रोसेसिंग सिस्टम्स का प्रबंधन कर सर्वोत्तम प्रदर्शन सुनिश्चित करते हैं। इस भूमिका के लिए प्रोग्रामिंग भाषाओं की व्यापक समझ और रिलेशनल व नॉन-रिलेशनल डेटाबेसेज़ का अनुभव आवश्यक है। डेटा इंजीनियर बनने पर अलग पोस्ट में अधिक पढ़ें।
मुख्य कौशल:
- SQL और डेटाबेस डिज़ाइन में विशेषज्ञता
- Python या Java जैसी भाषाओं में प्रवीणता
- Hadoop या Spark जैसी बिग डेटा तकनीकों का ज्ञान
- डेटा मॉडलिंग और डेटा वेयरहाउसिंग सिद्धांतों की समझ
- मजबूत समस्या-समाधान और संचार कौशल
टूल्स:
- डेटाबेस प्रबंधन के लिए SQL
- डेटा पाइपलाइन्स बनाने के लिए प्रोग्रामिंग भाषाएँ (जैसे Python, Java)
- Hadoop और Spark जैसे बिग डेटा प्लेटफ़ॉर्म
- Informatica या Talend जैसे ETL (Extract, Transform, Load) टूल्स
- MongoDB या Cassandra जैसे NoSQL डेटाबेस
मशीन लर्निंग इंजीनियर
मशीन लर्निंग इंजीनियर्स एआई जगत के वास्तुकार हैं। वे ऐसे मशीन लर्निंग सिस्टम्स का डिज़ाइन और इम्प्लीमेंटेशन करते हैं जो संगठनात्मक डेटा का उपयोग कर पूर्वानुमान लगाते हैं। उनकी ज़िम्मेदारियों में कस्टमर चर्न का पूर्वानुमान, लाइफ़टाइम वैल्यू का आकलन जैसे चुनौतियों का समाधान और मॉडलों को संगठन में परिनियोजित करना शामिल है। मशीन लर्निंग इंजीनियर्स मुख्यतः कोडिंग-आधारित टूल्स के साथ काम करते हैं।
अलग लेख में हमारा पूर्ण गाइड देखें—मशीन लर्निंग इंजीनियर कैसे बनें।
मुख्य कौशल:
- Python, Java, और Scala की गहरी समझ
- Scikit-learn, Keras, या PyTorch जैसे मशीन लर्निंग फ़्रेमवर्क का ज्ञान
- डेटा स्ट्रक्चर्स, डेटा मॉडलिंग, और सॉफ़्टवेयर आर्किटेक्चर की समझ
- रैखिक बीजगणित, कलन, और सांख्यिकी सहित उन्नत गणितीय कौशल
- मजबूत टीमवर्क और उत्कृष्ट समस्या-समाधान क्षमता
टूल्स:
- मशीन लर्निंग लाइब्रेरीज़ और एल्गोरिदम (जैसे Scikit-learn, TensorFlow)
- Pandas और NumPy जैसी डेटा साइंस लाइब्रेरीज़
- AWS या Google Cloud Platform जैसे क्लाउड प्लेटफ़ॉर्म
- Git जैसे वर्शन कंट्रोल सिस्टम्स
एआई रिसर्च साइंटिस्ट
एआई रिसर्च साइंटिस्ट्स कृत्रिम बुद्धिमत्ता को आगे बढ़ाने के लिए एल्गोरिदम और मॉडलों का निर्माण और सुधार करते हैं। वे भाषा समझ, इमेज पहचान, या अनुभव से सीखने जैसी जटिल चुनौतियों को हल करते हैं। उनका कार्य अकादमिक शोध और व्यावहारिक अनुप्रयोगों के बीच पुल बनाता है, जो एआई में नवाचार को आगे बढ़ाता है।
उदाहरण के लिए, वे अधिक स्मार्ट चैटबॉट्स विकसित कर सकते हैं, सेल्फ-ड्राइविंग कार सिस्टम्स में सुधार कर सकते हैं, या हेल्थकेयर के लिए एआई मॉडल डिज़ाइन कर सकते हैं। इस भूमिका में तकनीकी विशेषज्ञता के साथ रचनात्मक समस्या-समाधान भी आवश्यक है।
मुख्य कौशल:
- मशीन लर्निंग और एआई तकनीकों का मजबूत ज्ञान
- न्यूरल नेटवर्क्स, नेचुरल लैंग्वेज प्रोसेसिंग, या कंप्यूटर विज़न का अनुभव
- Python और TensorFlow या PyTorch जैसे टूल्स में प्रवीणता
- रैखिक बीजगणित और प्रायिकता जैसे क्षेत्रों में ठोस गणितीय कौशल
- सैद्धांतिक विचारों को वास्तविक समाधानों में बदलने की क्षमता
आवश्यक टूल्स:
- डीप लर्निंग फ़्रेमवर्क (जैसे TensorFlow, PyTorch)
- AWS या Google Cloud जैसे क्लाउड प्लेटफ़ॉर्म
- Git जैसे वर्शन कंट्रोल टूल्स
- Jupyter Notebooks जैसे रिसर्च टूल्स
- GPUs जैसी उच्च-प्रदर्शन हार्डवेयर
एआई रिसर्च साइंटिस्ट्स एआई के भविष्य को आकार देने में अहम भूमिका निभाते हैं—ऐसी तकनीकें बनाकर जो अधिक स्मार्ट अनुप्रयोगों को शक्ति दें, स्वचालन को बढ़ाएँ, और वास्तविक दुनिया की समस्याएँ सुलझाएँ।
|
भूमिका
|
ज़िम्मेदारियाँ
|
मुख्य कौशल
|
आवश्यक टूल्स
|
|
डेटा एनालिस्ट
|
व्यावसायिक समस्याओं के समाधान हेतु डेटा से अंतर्दृष्टियाँ निकालना और रिपोर्ट करना
|
SQL, Python, या R
|
SQL, Python या R, डेटा विज़ुअलाइज़ेशन टूल्स (जैसे Tableau, PowerBI), सांख्यिकीय सॉफ़्टवेयर (जैसे SPSS, SAS), स्प्रेडशीट टूल्स
|
|
डेटा साइंटिस्ट
|
सार्थक अंतर्दृष्टियाँ निकालना, मशीन लर्निंग से डेटा-आधारित समाधान विकसित करना, निष्कर्षों का संप्रेषण
|
Python, R, SQL, मशीन लर्निंग और एआई अवधारणाएँ, सांख्यिकीय विश्लेषण, डेटा विज़ुअलाइज़ेशन, संचार और प्रस्तुति कौशल
|
Pandas, NumPy, Scikit-learn, Matplotlib, Tableau, Airflow, Spark, Git, Bash
|
|
डेटा इंजीनियर
|
डेटा इन्फ्रास्ट्रक्चर का डिज़ाइन, निर्माण और प्रबंधन, डेटा पाइपलाइन्स बनाना, सर्वोत्तम प्रदर्शन सुनिश्चित करना
|
SQL, Python, Java, डेटाबेस डिज़ाइन, बिग डेटा तकनीकें, डेटा मॉडलिंग, समस्या-समाधान, संचार कौशल
|
SQL, Python, Java, Hadoop, Spark, ETL टूल्स, NoSQL डेटाबेस
|
|
मशीन लर्निंग इंजीनियर
|
मशीन लर्निंग सिस्टम्स का डिज़ाइन और परिनियोजन, ML से जटिल समस्याएँ हल करना, टीमों के साथ सहयोग
|
Python, Java, Scala, मशीन लर्निंग फ़्रेमवर्क, डेटा स्ट्रक्चर्स, सॉफ़्टवेयर आर्किटेक्चर, गणित, टीमवर्क, समस्या-समाधान कौशल
|
Scikit-learn, TensorFlow, Pandas, NumPy, क्लाउड प्लेटफ़ॉर्म (जैसे AWS, Google Cloud Platform), वर्शन कंट्रोल सिस्टम्स (जैसे Git)
|
|
एआई रिसर्च साइंटिस्ट
|
उन्नत एआई मॉडल विकसित करना, एल्गोरिदम में सुधार, और NLP या कंप्यूटर विज़न जैसी जटिल समस्याएँ सुलझाना
|
मशीन लर्निंग, न्यूरल नेटवर्क्स, नेचुरल लैंग्वेज प्रोसेसिंग, कंप्यूटर विज़न, Python, TensorFlow, PyTorch, गणितीय कौशल
|
TensorFlow, PyTorch, Jupyter Notebooks, क्लाउड प्लेटफ़ॉर्म (जैसे AWS, Google Cloud), उच्च-प्रदर्शन कंप्यूटिंग के लिए GPUs
|
डेटा साइंस की शुरुआत कैसे करें
डेटा साइंस एक बहुविषयक क्षेत्र है, और शुरुआत करने के लिए आपको गणित, सांख्यिकी, कंप्यूटर साइंस, और डोमेन-विशिष्ट ज्ञान के मिश्रण की आवश्यकता होगी। आइए डेटा साइंस में अपनी यात्रा शुरू करने के लिए एक संभावित रोडमैप देखें।


डेटा साइंस को 21वीं सदी की 'सबसे आकर्षक नौकरी' कहा गया है, और यह केवल अतिशयोक्ति नहीं है। यूएस ब्यूरो ऑफ लेबर स्टैटिस्टिक्स का अनुमान है कि 2023 से 2033 के बीच डेटा वैज्ञानिक भूमिकाएँ 36% बढ़ेंगी, जो इस क्षेत्र के बढ़ते महत्व का स्पष्ट प्रमाण है।
लेकिन वास्तव में डेटा साइंस है क्या, और यह इतना महत्वपूर्ण क्यों है? यह लेख आपको डेटा साइंस की दुनिया में ले जाएगा—डेटा साइंस लाइफसाइकल से लेकर विभिन्न उद्योगों में इसके अनुप्रयोगों तक, डेटा साइंस में प्रवेश करने के लिए आवश्यक कौशलों तक, और भी बहुत कुछ। हम बताएंगे कि आज यह उद्योग इतना गतिशील क्यों है और कैसे डेटा साइंस ने प्रमुखता हासिल की है।
डेटा साइंस क्या है?
डेटा साइंस एक बहुविषयक क्षेत्र है जो संरचित और असंरचित डेटा से ज्ञान और अंतर्दृष्टि निकालने के लिए वैज्ञानिक तरीकों, प्रक्रियाओं, एल्गोरिदम और प्रणालियों का उपयोग करता है। सरल शब्दों में, डेटा साइंस का मतलब है डेटा को प्राप्त करना, उसे संसाधित करना, और विश्लेषण करके विभिन्न उद्देश्यों के लिए अंतर्दृष्टि पाना।
डेटा साइंस लाइफसाइकल
डेटा साइंस लाइफसाइकल उन चरणों को संदर्भित करता है जिनसे एक डेटा साइंस प्रोजेक्ट आमतौर पर गुजरता है—प्रारंभिक परिकल्पना और डेटा संग्रह से लेकर परिणामों और अंतर्दृष्टियों के संप्रेषण तक।
हालाँकि हर डेटा साइंस प्रोजेक्ट अपने आप में अनोखा होता है—समस्या, लागू उद्योग, और शामिल डेटा पर निर्भर—अधिकांश प्रोजेक्ट्स एक समान लाइफसाइकल का अनुसरण करते हैं।
यह लाइफसाइकल जटिल डेटा को संभालने, सटीक निष्कर्ष निकालने, और डेटा-आधारित निर्णय लेने के लिए एक संरचित दृष्टिकोण प्रदान करता है।
डेटा साइंस लाइफसाइकल
यहाँ डेटा साइंस लाइफसाइकल की पाँच मुख्य अवस्थाएँ दी गई हैं:
डेटा संग्रह और भंडारण
इस प्रारंभिक चरण में विभिन्न स्रोतों से डेटा एकत्र किया जाता है, जैसे डेटाबेस, Excel फाइलें, टेक्स्ट फाइलें, APIs, वेब स्क्रैपिंग, या रियल-टाइम डेटा स्ट्रीम्स। एकत्र किए गए डेटा का प्रकार और मात्रा मुख्यतः उस समस्या पर निर्भर करता है जिसे आप संबोधित कर रहे हैं।
एकत्रण के बाद, इस डेटा को आगे की प्रोसेसिंग के लिए उपयुक्त स्वरूप में संग्रहीत किया जाता है। डेटा का सुरक्षित और कुशल भंडारण महत्वपूर्ण है ताकि शीघ्र पुनर्प्राप्ति और प्रोसेसिंग संभव हो सके।
डेटा तैयारी
अक्सर सबसे समय लेने वाला चरण माना जाने वाला डेटा तैयारी, कच्चे डेटा को विश्लेषण के लिए उपयुक्त रूप में बदलने और साफ करने से जुड़ा है। इसमें मिसिंग या असंगत डेटा को संभालना, डुप्लीकेट्स हटाना, नॉर्मलाइज़ेशन, और डेटा टाइप रूपांतरण शामिल हैं। उद्देश्य एक साफ-सुथरा, उच्च-गुणवत्ता वाला डेटासेट बनाना है जो सटीक और विश्वसनीय विश्लेषणात्मक परिणाम दे सके।
अन्वेषण और विज़ुअलाइज़ेशन
इस चरण में, डेटा वैज्ञानिक तैयार किए गए डेटा का अन्वेषण करते हैं ताकि उसके पैटर्न, विशेषताओं, और संभावित विसंगतियों को समझ सकें। सांख्यिकीय विश्लेषण और डेटा विज़ुअलाइज़ेशन जैसी तकनीकें डेटा की मुख्य विशेषताओं का सार प्रस्तुत करती हैं, अक्सर दृश्य तरीकों से।
चार्ट्स और ग्राफ़ जैसी विज़ुअलाइज़ेशन टूल्स डेटा को अधिक समझने योग्य बनाते हैं, जिससे हितधारक ट्रेंड्स और पैटर्न्स को बेहतर ढंग से समझ सकें।
प्रयोग और पूर्वानुमान
डेटा वैज्ञानिक इस चरण में मशीन लर्निंग एल्गोरिदम और सांख्यिकीय मॉडलों का उपयोग करके पैटर्न की पहचान करते हैं, पूर्वानुमान लगाते हैं, या अंतर्दृष्टियाँ खोजते हैं। लक्ष्य प्रोजेक्ट के उद्देश्यों के अनुरूप डेटा से सार्थक निष्कर्ष निकालना है—चाहे भविष्य के परिणामों का पूर्वानुमान हो, डेटा का वर्गीकरण हो, या छिपे पैटर्न्स का पता लगाना।
डेटा स्टोरीटेलिंग और संचार
अंतिम चरण डेटा विश्लेषण से प्राप्त परिणामों की व्याख्या और उनका संप्रेषण करने से जुड़ा है। केवल अंतर्दृष्टि होना पर्याप्त नहीं है; आपको उन्हें स्पष्ट, संक्षिप्त भाषा और प्रभावशाली विज़ुअल्स के माध्यम से प्रभावी ढंग से संप्रेषित करना चाहिए। लक्ष्य यह है कि गैर-तकनीकी हितधारकों तक निष्कर्ष इस तरह पहुँचें कि वे निर्णय लेने या रणनीतिक पहलों को प्रभावित कर सकें।
इस लाइफसाइकल को समझना और लागू करना डेटा साइंस प्रोजेक्ट्स के लिए अधिक व्यवस्थित और सफल दृष्टिकोण को संभव बनाता है। अब देखते हैं कि डेटा साइंस इतना महत्वपूर्ण क्यों है।
डेटा साइंस महत्वपूर्ण क्यों है?
डेटा साइंस एक क्रांतिकारी क्षेत्र के रूप में उभरा है जो डेटा से अंतर्दृष्टियाँ उत्पन्न करने और व्यवसायों को बदलने में महत्वपूर्ण भूमिका निभाता है। यह कहना अतिशयोक्ति नहीं होगी कि डेटा साइंस आधुनिक उद्योगों की रीढ़ है। लेकिन इसे इतना महत्व क्यों मिला है?
डेटा साइंस का उपयोग किसके लिए होता है?
डेटा साइंस का उपयोग अनेक अनुप्रयोगों में होता है—ग्राहक व्यवहार का पूर्वानुमान लगाने से लेकर व्यावसायिक प्रक्रियाओं का अनुकूलन करने तक। डेटा साइंस का दायरा व्यापक है और यह विभिन्न प्रकार के एनालिटिक्स को समेटता है।
डिस्क्रिप्टिव से डायग्नोस्टिक से प्रेडिक्टिव से प्रेस्क्रिप्टिव एनालिटिक्स तक बढ़ती परिष्कृतता कंपनियों को निर्णय-निर्धारण और रणनीतिक योजना के लिए मूल्यवान अंतर्दृष्टियाँ प्रदान कर सकती है। आप एनालिटिक्स के चार प्रकार पर एक अलग लेख में अधिक पढ़ सकते हैं।
डेटा साइंस के लाभ क्या हैं?
डेटा साइंस किसी भी ऐसे व्यवसाय में मूल्य जोड़ सकता है जो अपने डेटा का उपयोग करता है। आँकड़ों से लेकर पूर्वानुमानों तक, प्रभावी डेटा-आधारित प्रथाएँ किसी कंपनी को सफलता की तेज़ राह पर ला सकती हैं। यहाँ कुछ तरीके हैं जिनसे डेटा साइंस का उपयोग होता है:
व्यावसायिक प्रक्रियाओं का अनुकूलन
डेटा साइंस लॉजिस्टिक्स और सप्लाई चेन से लेकर एचआर और आगे तक विभिन्न विभागों में कंपनी के संचालन में उल्लेखनीय सुधार कर सकता है। यह संसाधन आवंटन, प्रदर्शन मूल्यांकन, और प्रक्रिया स्वचालन में मदद कर सकता है। उदाहरण के लिए, एक लॉजिस्टिक्स कंपनी मार्गों का अनुकूलन, डिलीवरी समय कम करने, ईंधन लागत बचाने, और ग्राहक संतुष्टि बढ़ाने के लिए डेटा साइंस का उपयोग कर सकती है।
नई अंतर्दृष्टियों का पता लगाना
डेटा साइंस ऐसे छिपे पैटर्न और अंतर्दृष्टियाँ उजागर कर सकता है जो पहली नज़र में स्पष्ट नहीं होते। ये अंतर्दृष्टियाँ कंपनियों को प्रतिस्पर्धात्मक बढ़त दे सकती हैं और उन्हें अपने व्यवसाय को बेहतर समझने में मदद कर सकती हैं। उदाहरण के लिए, कोई कंपनी ग्राहक डेटा का उपयोग करके रुझान और पसंद की पहचान कर सकती है, जिससे वे अपने उत्पादों या सेवाओं को उसी अनुरूप ढाल सकें।
नवोन्मेषी उत्पाद और समाधान बनाना
कंपनियाँ ग्राहक की आवश्यकताओं और पसंद के आधार पर नए उत्पाद या सेवाएँ विकसित करने और नवाचार करने के लिए डेटा साइंस का उपयोग कर सकती हैं। यह व्यवसायों को बाज़ार रुझानों का पूर्वानुमान लगाने और प्रतिस्पर्धा से आगे रहने में भी सक्षम बनाता है। उदाहरण के लिए, Netflix जैसी स्ट्रीमिंग सेवाएँ दर्शकों की पसंद समझने और व्यक्तिगत सिफारिशें बनाने के लिए डेटा साइंस का उपयोग करती हैं, जिससे उपयोगकर्ता अनुभव बेहतर होता है।
कौन-से उद्योग डेटा साइंस का उपयोग करते हैं?
डेटा साइंस के प्रभाव सभी उद्योगों में फैले हुए हैं, जिससे संगठनों के संचालन और निर्णय लेने के तरीके बुनियादी तौर पर बदल रहे हैं। जबकि हर उद्योग डेटा साइंस लागू करने से लाभान्वित हो सकता है, यह विशेष रूप से डेटा-समृद्ध क्षेत्रों में प्रभावशाली है।
आइए देखें कि डेटा साइंस इन प्रमुख उद्योगों में कैसे क्रांति ला रहा है:
वित्त में डेटा साइंस के अनुप्रयोग
वित्त क्षेत्र ने डेटा साइंस की शक्ति को तेजी से अपनाया है। फ्रॉड डिटेक्शन और एल्गोरिथमिक ट्रेडिंग से लेकर पोर्टफोलियो प्रबंधन और जोखिम आकलन तक, डेटा साइंस ने जटिल वित्तीय कार्यों को अधिक कुशल और सटीक बना दिया है। उदाहरण के लिए, क्रेडिट कार्ड कंपनियाँ धोखाधड़ी वाले लेनदेन का पता लगाने और रोकने के लिए डेटा साइंस तकनीकों का उपयोग करती हैं, जिससे हर साल अरबों डॉलर की बचत होती है।
Python में वित्त के मूल सिद्धांत और हमारी स्किल ट्रैक के साथ डेटा-आधारित वित्तीय निर्णय लेने के बारे में और जानें।
हेल्थकेयर में डेटा साइंस के अनुप्रयोग
हेल्थकेयर एक और उद्योग है जहाँ डेटा साइंस का गहरा प्रभाव है। अनुप्रयोगों में रोग प्रकोपों का पूर्वानुमान लगाने और रोगी देखभाल की गुणवत्ता में सुधार करने से लेकर अस्पताल प्रबंधन और दवा खोज को बेहतर बनाना शामिल है। प्रेडिक्टिव मॉडल डॉक्टरों को बीमारियों का शुरुआती निदान करने में मदद करते हैं, और उपचार योजनाएँ रोगी की विशिष्ट आवश्यकताओं के अनुरूप अनुकूलित की जा सकती हैं, जिससे बेहतर परिणाम मिलते हैं।
आप DataFramed पॉडकास्ट के एक एपिसोड में डेटा साइंस कैसे हेल्थकेयर को बदल रहा है के बारे में और जान सकते हैं।
मार्केटिंग में डेटा साइंस के अनुप्रयोग
मार्केटिंग वह क्षेत्र है जो डेटा साइंस के आगमन से उल्लेखनीय रूप से बदल गया है। यहाँ के अनुप्रयोग विविध हैं—ग्राहक विभाजन और लक्षित विज्ञापन से लेकर बिक्री पूर्वानुमान और सेंटिमेंट एनालिसिस तक। डेटा साइंस मार्केटर्स को उपभोक्ता व्यवहार को अभूतपूर्व विवरण में समझने देता है, जिससे वे अधिक प्रभावी अभियानों का निर्माण कर सकें। प्रेडिक्टिव एनालिटिक्स संभावित बाज़ार रुझानों की पहचान में भी मदद कर सकता है, जिससे प्रतिस्पर्धात्मक बढ़त मिलती है। पर्सनलाइज़ेशन एल्गोरिदम व्यक्तिगत ग्राहकों के लिए उत्पाद सिफारिशें तैयार कर सकते हैं, जिससे बिक्री और ग्राहक संतुष्टि बढ़ती है।
हमारे पास मार्केटिंग में डेटा साइंस का उपयोग करने के पाँच तरीके पर एक अलग ब्लॉग पोस्ट है, जो उद्योग में प्रयुक्त कुछ तरीकों का अन्वेषण करता है। आप हमारी Marketing Analytics with Python स्किल ट्रैक में भी अधिक सीख सकते हैं।
प्रौद्योगिकी में डेटा साइंस के अनुप्रयोग
टेक कंपनियाँ शायद डेटा साइंस की सबसे बड़ी लाभार्थी हैं। रिकमेंडेशन इंजन को शक्ति देने से लेकर इमेज और स्पीच रिकॉग्निशन को बेहतर बनाने तक, डेटा साइंस के अनुप्रयोग विविध हैं। उदाहरण के लिए, राइड-हेलिंग प्लेटफ़ॉर्म चालक और सवारों को जोड़ने और दिन के समय के अनुसार ड्राइवर सप्लाई को अनुकूलित करने के लिए डेटा साइंस पर निर्भर करते हैं।
डेटा साइंस अन्य डेटा-संबंधित क्षेत्रों से कैसे भिन्न है?
हालाँकि डेटा साइंस कई ऐसे क्षेत्रों से ओवरलैप करता है जो डेटा के साथ काम करते हैं, यह सिद्धांतों, टूल्स, और तकनीकों के एक अद्वितीय मिश्रण के साथ आता है, जो डेटा से सार्थक पैटर्न निकालने के लिए डिज़ाइन किया गया है।
डेटा साइंस और संबंधित क्षेत्रों के बीच अंतर करना परिदृश्य को बेहतर समझने और सही करियर पथ तय करने में मदद कर सकता है। आइए इन अंतरों को स्पष्ट करें।
डेटा साइंस बनाम डेटा एनालिटिक्स
डेटा साइंस और डेटा एनालिटिक्स दोनों डेटा से मूल्य निकालने में महत्वपूर्ण भूमिका निभाते हैं, लेकिन उनका फोकस अलग होता है। डेटा साइंस एक व्यापक क्षेत्र है जो मशीन लर्निंग और प्रेडिक्टिव एनालिटिक्स सहित तरीकों का उपयोग कर डेटा से अंतर्दृष्टियाँ निकालता है। इसके विपरीत, डेटा एनालिटिक्स विशिष्ट प्रश्नों के उत्तर देने के लिए मौजूदा डेटासेट्स को प्रोसेस करने और उन पर सांख्यिकीय विश्लेषण करने पर केंद्रित है।
डेटा साइंस बनाम बिज़नेस एनालिटिक्स
बिज़नेस एनालिटिक्स भी डेटा विश्लेषण से संबंधित है, लेकिन यह रणनीतिक व्यावसायिक निर्णयों के लिए डेटा का लाभ उठाने पर अधिक केंद्रित होता है। यह आमतौर पर डेटा साइंस की तुलना में कम तकनीकी और अधिक व्यवसाय-केंद्रित होता है। डेटा साइंस, भले ही वह व्यावसायिक रणनीतियों को सूचित कर सकता है, अक्सर प्रोग्रामिंग और मशीन लर्निंग जैसे तकनीकी पहलुओं में गहराई तक जाता है।
डेटा साइंस बनाम डेटा इंजीनियरिंग
डेटा इंजीनियरिंग डेटा संग्रह, भंडारण, और प्रोसेसिंग के लिए इन्फ्रास्ट्रक्चर का निर्माण और रखरखाव करने पर केंद्रित है, ताकि डेटा साफ़ और सुलभ रहे। दूसरी ओर, डेटा साइंस इसी डेटा का विश्लेषण कर सांख्यिकीय और मशीन लर्निंग मॉडलों से मूल्यवान अंतर्दृष्टियाँ निकालता है, जो व्यावसायिक निर्णयों को प्रभावित करती हैं। सार रूप में, डेटा इंजीनियर्स डेटा की 'सड़कें' बनाते हैं, जबकि डेटा साइंटिस्ट्स उन पर 'ड्राइव' कर सार्थक अंतर्दृष्टियाँ निकालते हैं। दोनों भूमिकाएँ डेटा-चालित संगठन में महत्वपूर्ण हैं।
डेटा साइंस बनाम मशीन लर्निंग
मशीन लर्निंग डेटा साइंस का एक उप-समुच्चय है, जो ऐसे एल्गोरिदम बनाने और लागू करने पर केंद्रित है जो मशीनों को डेटा से सीखने और निर्णय लेने में सक्षम बनाते हैं। जबकि डेटा साइंस व्यापक है और डेटा से सार्थक जानकारी निकालने के लिए मशीन लर्निंग सहित कई तकनीकों को समेटता है।
डेटा साइंस बनाम सांख्यिकी
सांख्यिकी, जो डेटा संग्रह, विश्लेषण, व्याख्या, और संगठन से संबंधित एक गणितीय विधा है, डेटा साइंस का एक प्रमुख घटक है। हालाँकि, डेटा साइंस डेटा से अंतर्दृष्टियाँ निकालने के लिए सांख्यिकी को अन्य तरीकों के साथ एकीकृत करता है, जिससे यह अधिक बहुविषयक क्षेत्र बन जाता है।
उद्योग
फोकस
तकनीकी जोर
डेटा साइंस
एनालिटिक्स के 4 स्तरों में डेटा से मूल्य संचालित करना
प्रोग्रामिंग, ML, सांख्यिकी
डेटा एनालिटिक्स
मौजूदा डेटासेट्स पर सांख्यिकीय विश्लेषण करना
सांख्यिकीय विश्लेषण
बिज़नेस एनालिटिक्स
रणनीतिक व्यावसायिक निर्णयों के लिए डेटा का लाभ उठाना
व्यावसायिक रणनीतियाँ, डेटा विश्लेषण
डेटा इंजीनियरिंग
डेटा इन्फ्रास्ट्रक्चर बनाना और बनाए रखना
डेटा संग्रह, भंडारण, प्रोसेसिंग
मशीन लर्निंग
मशीन लर्निंग के लिए एल्गोरिदम बनाना और लागू करना
एल्गोरिदम विकास, मॉडल इम्प्लीमेंटेशन
सांख्यिकी
डेटा का संग्रह, विश्लेषण, व्याख्या, और संगठन
सांख्यिकीय विश्लेषण, गणितीय सिद्धांत
इन अंतरों को समझने के बाद, अब हम उन प्रमुख अवधारणाओं पर आते हैं जिन्हें हर डेटा वैज्ञानिक को सीखना चाहिए।
मुख्य डेटा साइंस अवधारणाएँ
एक सफल डेटा वैज्ञानिक को केवल तकनीकी कौशल ही नहीं, बल्कि उन आधारभूत अवधारणाओं की समझ भी चाहिए जो इस क्षेत्र की नींव हैं। यहाँ कुछ प्रमुख अवधारणाएँ हैं:
सांख्यिकी और प्रायिकता
ये डेटा साइंस की आधारशिला हैं। सांख्यिकी डेटा से सार्थक अंतर्दृष्टि निकालने में काम आती है, जबकि प्रायिकता उपलब्ध डेटा के आधार पर भविष्य की घटनाओं का पूर्वानुमान लगाने देती है। डिस्ट्रीब्यूशंस, सांख्यिकीय परीक्षण, और प्रायिकता सिद्धांतों की समझ किसी भी डेटा वैज्ञानिक के लिए आवश्यक है।
शुरू करने के लिए संसाधन
प्रोग्रामिंग
प्रोग्रामिंग वह साधन है जिससे डेटा वैज्ञानिक डेटा के साथ काम करते हैं। Python और R भाषाएँ विशेष रूप से लोकप्रिय हैं—उनकी सरलता और शक्तिशाली डेटा हैंडलिंग लाइब्रेरीज़ के कारण। इन भाषाओं से परिचय डेटा को साफ़ करने, प्रोसेस करने, और प्रभावी ढंग से विश्लेषित करने में सहायक होता है।
शुरू करने के लिए संसाधन
डेटा विज़ुअलाइज़ेशन
डेटा विज़ुअलाइज़ेशन जटिल डेटा को दृश्य और आसानी से समझ आने वाले स्वरूप में प्रस्तुत करने की कला है। यह निष्कर्षों का संप्रेषण करने में मदद करता है और जटिल डेटासेट्स को समझना आसान बनाता है। Tableau, Matplotlib, और Seaborn जैसे टूल आमतौर पर प्रयुक्त होते हैं।
शुरू करने के लिए संसाधन
मशीन लर्निंग
मशीन लर्निंग, जो आर्टिफिशियल इंटेलिजेंस का उप-समुच्चय है, में ऐसे मॉडलों को डेटा पर प्रशिक्षित करना शामिल है जो बिना स्पष्ट रूप से प्रोग्राम किए पूर्वानुमान या निर्णय लेते हैं। यह आधुनिक डेटा साइंस अनुप्रयोगों—रिकमेंडेशन सिस्टम से लेकर प्रेडिक्टिव एनालिटिक्स तक—के केंद्र में है।
शुरू करने के लिए संसाधन
डेटा इंजीनियरिंग
डेटा इंजीनियरिंग डेटा को एकत्र करने, संग्रहीत करने, और प्रोसेस करने के लिए प्रणालियों के डिज़ाइन और निर्माण से संबंधित है। इसी आधार पर डेटा विश्लेषण और मशीन लर्निंग मॉडल बनाए जाते हैं।
शुरू करने के लिए संसाधन
मुख्य डेटा साइंस टूल्स
डेटा वैज्ञानिकों को अपने कार्य प्रभावी ढंग से करने के लिए टूल्स के एक सेट की आवश्यकता होती है। ये टूल्स प्रोग्रामिंग भाषाओं से लेकर डेटा विज़ुअलाइज़ेशन सॉफ़्टवेयर तक हो सकते हैं। यहाँ कुछ आवश्यक डेटा साइंस टूल्स हैं।
प्रोग्रामिंग भाषाएँ
डेटा साइंस के क्षेत्र में, प्रोग्रामिंग भाषाएँ ही कार्य करने के औज़ार हैं। ये कंप्यूटर को विशिष्ट कार्य—जैसे डेटा मैनिपुलेशन, सांख्यिकीय विश्लेषण, और मशीन लर्निंग—करने के निर्देश देने का ढांचा प्रदान करती हैं। यहाँ कुछ प्रमुख भाषाएँ हैं जिन्हें हर डेटा वैज्ञानिक को सीखने पर विचार करना चाहिए:
शुरू करने के लिए संसाधन
बिज़नेस इंटेलिजेंस टूल्स
बिज़नेस इंटेलिजेंस (BI) टूल्स ऐसे सॉफ़्टवेयर अनुप्रयोग हैं जिनका उपयोग किसी संगठन के कच्चे डेटा का विश्लेषण करने के लिए किया जाता है। ये विज़ुअलाइज़ेशन, रिपोर्टिंग, और डेटा अंतर्दृष्टियों को साझा करने में मदद करते हैं, जिससे कंपनियाँ डेटा-आधारित निर्णय ले सकें। डेटा साइंस के लिए कुछ आवश्यक BI टूल्स इस प्रकार हैं:
शुरू करने के लिए संसाधन
मशीन लर्निंग लाइब्रेरीज़
मशीन लर्निंग लाइब्रेरीज़ पूर्व-लिखित कोड का संग्रह होती हैं जिन्हें डेटा वैज्ञानिक समय बचाने के लिए उपयोग कर सकते हैं। ये पूर्व-पैकेज्ड एल्गोरिदम और लर्निंग रूटीन प्रदान करती हैं जिन्हें प्रोग्राम्स में एकीकृत किया जा सकता है। यहाँ कुछ प्रमुख लाइब्रेरीज़ हैं जो मशीन लर्निंग कार्यों को सरल बनाती हैं:
aResources to get you started
डेटाबेस मैनेजमेंट सिस्टम्स
डेटाबेस मैनेजमेंट सिस्टम्स (DBMS) ऐसे सॉफ़्टवेयर अनुप्रयोग हैं जो उपयोगकर्ता, अन्य अनुप्रयोगों, और डेटाबेस के साथ इंटरैक्ट कर डेटा कैप्चर और विश्लेषित करते हैं। DBMS डेटा को बनाने, पुनः प्राप्त करने, अपडेट करने, और प्रबंधित करने का एक व्यवस्थित तरीका प्रदान करता है। डेटा साइंस में प्रयुक्त कुछ लोकप्रिय DBMS इस प्रकार हैं:
शुरू करने के लिए संसाधन
शीर्ष डेटा साइंस नौकरियाँ
डेटा साइंस एक विशाल क्षेत्र है जिसमें कई विशेषज्ञ भूमिकाएँ हैं—प्रत्येक की अपनी विशिष्ट ज़िम्मेदारियाँ, कौशल आवश्यकताएँ, और वेतन अपेक्षाएँ हैं। यहाँ डेटा साइंस के क्षेत्र में सबसे अधिक माँग वाली कुछ जॉब टाइटल्स दी गई हैं:
डेटा एनालिस्ट
डेटा एनालिस्ट किसी संगठन के डेटा की व्याख्या करने में महत्वपूर्ण भूमिका निभाते हैं। वे गणितीय और सांख्यिकीय विश्लेषण में विशेषज्ञ होते हैं, जिससे वे जटिल डेटासेट्स को क्रियान्वयन योग्य अंतर्दृष्टियों में बदलते हैं जो व्यावसायिक निर्णयों को संचालित करती हैं। डेटा विज़ुअलाइज़ेशन टूल्स का उपयोग करके वे अपने निष्कर्ष तकनीकी और गैर-तकनीकी दोनों हितधारकों तक प्रभावी ढंग से पहुँचाते हैं।
डेटा एनालिस्ट डेटा में गहराई तक जाकर रिपोर्ट और विज़ुअलाइज़ेशन प्रदान करते हैं जो छिपी अंतर्दृष्टियों को उजागर करते हैं। वे उन्नत एल्गोरिदम विकसित करने में शामिल न भी हों, फिर भी वे डेटा को समझने के लिए कई टूल्स का उपयोग करते हैं। उनकी ज़िम्मेदारियों में SQL क्वेरीज़, डेटा क्लीनिंग, और डेटा मैनेजमेंट भी शामिल हो सकते हैं। डेटा एनालिस्ट कैसे बनें पर एक अलग लेख में अधिक पढ़ें।
मुख्य कौशल:
आवश्यक टूल्स:
डेटा साइंटिस्ट
डेटा साइंटिस्ट किसी संगठन के डेटा में गहराई तक जाकर सार्थक अंतर्दृष्टियाँ निकालते और संप्रेषित करते हैं। वे मशीन लर्निंग वर्कफ़्लोज़ और उन्हें वास्तविक व्यावसायिक अनुप्रयोगों में लागू करने की समझ रखते हैं। डेटा साइंटिस्ट मुख्यतः कोडिंग टूल्स के साथ काम करते हैं, गहन विश्लेषण करते हैं, और अक्सर बिग डेटा टूल्स का उपयोग करते हैं।
डेटा साइंटिस्ट डेटा जगत के जासूसों की तरह होते हैं। वे समृद्ध डेटा स्रोतों को ढूँढ़ने और उनकी व्याख्या करने, बड़े डेटासेट्स को संभालने, और डेटा पॉइंट्स को मिलाकर रुझान पहचानने के लिए ज़िम्मेदार होते हैं। विश्लेषणात्मक, सांख्यिकीय, और प्रोग्रामिंग कौशल का लाभ लेकर वे व्यापक डेटासेट्स को एकत्रित, विश्लेषित, और व्याख्यायित करते हैं। ये अंतर्दृष्टियाँ जटिल व्यावसायिक समस्याओं के डेटा-आधारित समाधान विकसित करने में सहायक होती हैं—अक्सर मशीन लर्निंग एल्गोरिदम बनाकर जो नई अंतर्दृष्टियाँ उत्पन्न करें, प्रक्रियाओं को स्वचालित करें, या ग्राहकों को बेहतर मूल्य दें।
हमारे पास डेटा साइंटिस्ट कैसे बनें पर एक संपूर्ण गाइड है, जो इस भूमिका में शुरुआत करने के लिए आवश्यक प्रमुख चरणों को बताता है।
मुख्य कौशल:
आवश्यक टूल्स:
डेटा इंजीनियर
डेटा इंजीनियर्स डेटा साइंस जगत के वास्तुकार हैं। वे डेटा इन्फ्रास्ट्रक्चर को डिज़ाइन, निर्मित, और प्रबंधित करते हैं, जिससे डेटा साइंटिस्ट्स डेटा का कुशल विश्लेषण कर सकें। डेटा इंजीनियर्स डेटा संग्रह, भंडारण, और प्रोसेसिंग पर ध्यान केंद्रित करते हैं और ऐसे डेटा पाइपलाइन्स बनाते हैं जो विश्लेषणात्मक प्रक्रिया को सुव्यवस्थित करें।
डेटा इंजीनियर्स अक्सर सूचना निष्कर्षण के लिए एल्गोरिदम डिज़ाइन करते हैं और डेटाबेस सिस्टम्स बनाते हैं। वे डेटा आर्किटेक्चर, डेटाबेस, और प्रोसेसिंग सिस्टम्स का प्रबंधन कर सर्वोत्तम प्रदर्शन सुनिश्चित करते हैं। इस भूमिका के लिए प्रोग्रामिंग भाषाओं की व्यापक समझ और रिलेशनल व नॉन-रिलेशनल डेटाबेसेज़ का अनुभव आवश्यक है। डेटा इंजीनियर बनने पर अलग पोस्ट में अधिक पढ़ें।
मुख्य कौशल:
टूल्स:
मशीन लर्निंग इंजीनियर
मशीन लर्निंग इंजीनियर्स एआई जगत के वास्तुकार हैं। वे ऐसे मशीन लर्निंग सिस्टम्स का डिज़ाइन और इम्प्लीमेंटेशन करते हैं जो संगठनात्मक डेटा का उपयोग कर पूर्वानुमान लगाते हैं। उनकी ज़िम्मेदारियों में कस्टमर चर्न का पूर्वानुमान, लाइफ़टाइम वैल्यू का आकलन जैसे चुनौतियों का समाधान और मॉडलों को संगठन में परिनियोजित करना शामिल है। मशीन लर्निंग इंजीनियर्स मुख्यतः कोडिंग-आधारित टूल्स के साथ काम करते हैं।
अलग लेख में हमारा पूर्ण गाइड देखें—मशीन लर्निंग इंजीनियर कैसे बनें।
मुख्य कौशल:
टूल्स:
एआई रिसर्च साइंटिस्ट
एआई रिसर्च साइंटिस्ट्स कृत्रिम बुद्धिमत्ता को आगे बढ़ाने के लिए एल्गोरिदम और मॉडलों का निर्माण और सुधार करते हैं। वे भाषा समझ, इमेज पहचान, या अनुभव से सीखने जैसी जटिल चुनौतियों को हल करते हैं। उनका कार्य अकादमिक शोध और व्यावहारिक अनुप्रयोगों के बीच पुल बनाता है, जो एआई में नवाचार को आगे बढ़ाता है।
उदाहरण के लिए, वे अधिक स्मार्ट चैटबॉट्स विकसित कर सकते हैं, सेल्फ-ड्राइविंग कार सिस्टम्स में सुधार कर सकते हैं, या हेल्थकेयर के लिए एआई मॉडल डिज़ाइन कर सकते हैं। इस भूमिका में तकनीकी विशेषज्ञता के साथ रचनात्मक समस्या-समाधान भी आवश्यक है।
मुख्य कौशल:
आवश्यक टूल्स:
एआई रिसर्च साइंटिस्ट्स एआई के भविष्य को आकार देने में अहम भूमिका निभाते हैं—ऐसी तकनीकें बनाकर जो अधिक स्मार्ट अनुप्रयोगों को शक्ति दें, स्वचालन को बढ़ाएँ, और वास्तविक दुनिया की समस्याएँ सुलझाएँ।
भूमिका
ज़िम्मेदारियाँ
मुख्य कौशल
आवश्यक टूल्स
डेटा एनालिस्ट
व्यावसायिक समस्याओं के समाधान हेतु डेटा से अंतर्दृष्टियाँ निकालना और रिपोर्ट करना
SQL, Python, या R
SQL, Python या R, डेटा विज़ुअलाइज़ेशन टूल्स (जैसे Tableau, PowerBI), सांख्यिकीय सॉफ़्टवेयर (जैसे SPSS, SAS), स्प्रेडशीट टूल्स
डेटा साइंटिस्ट
सार्थक अंतर्दृष्टियाँ निकालना, मशीन लर्निंग से डेटा-आधारित समाधान विकसित करना, निष्कर्षों का संप्रेषण
Python, R, SQL, मशीन लर्निंग और एआई अवधारणाएँ, सांख्यिकीय विश्लेषण, डेटा विज़ुअलाइज़ेशन, संचार और प्रस्तुति कौशल
Pandas, NumPy, Scikit-learn, Matplotlib, Tableau, Airflow, Spark, Git, Bash
डेटा इंजीनियर
डेटा इन्फ्रास्ट्रक्चर का डिज़ाइन, निर्माण और प्रबंधन, डेटा पाइपलाइन्स बनाना, सर्वोत्तम प्रदर्शन सुनिश्चित करना
SQL, Python, Java, डेटाबेस डिज़ाइन, बिग डेटा तकनीकें, डेटा मॉडलिंग, समस्या-समाधान, संचार कौशल
SQL, Python, Java, Hadoop, Spark, ETL टूल्स, NoSQL डेटाबेस
मशीन लर्निंग इंजीनियर
मशीन लर्निंग सिस्टम्स का डिज़ाइन और परिनियोजन, ML से जटिल समस्याएँ हल करना, टीमों के साथ सहयोग
Python, Java, Scala, मशीन लर्निंग फ़्रेमवर्क, डेटा स्ट्रक्चर्स, सॉफ़्टवेयर आर्किटेक्चर, गणित, टीमवर्क, समस्या-समाधान कौशल
Scikit-learn, TensorFlow, Pandas, NumPy, क्लाउड प्लेटफ़ॉर्म (जैसे AWS, Google Cloud Platform), वर्शन कंट्रोल सिस्टम्स (जैसे Git)
एआई रिसर्च साइंटिस्ट
उन्नत एआई मॉडल विकसित करना, एल्गोरिदम में सुधार, और NLP या कंप्यूटर विज़न जैसी जटिल समस्याएँ सुलझाना
मशीन लर्निंग, न्यूरल नेटवर्क्स, नेचुरल लैंग्वेज प्रोसेसिंग, कंप्यूटर विज़न, Python, TensorFlow, PyTorch, गणितीय कौशल
TensorFlow, PyTorch, Jupyter Notebooks, क्लाउड प्लेटफ़ॉर्म (जैसे AWS, Google Cloud), उच्च-प्रदर्शन कंप्यूटिंग के लिए GPUs
डेटा साइंस की शुरुआत कैसे करें
डेटा साइंस एक बहुविषयक क्षेत्र है, और शुरुआत करने के लिए आपको गणित, सांख्यिकी, कंप्यूटर साइंस, और डोमेन-विशिष्ट ज्ञान के मिश्रण की आवश्यकता होगी। आइए डेटा साइंस में अपनी यात्रा शुरू करने के लिए एक संभावित रोडमैप देखें।