
शीर्ष 9 डेटा एनालिटिक्स टूल्स
उपरोक्त कारकों को ध्यान में रखते हुए, यहाँ डेटा विश्लेषकों के लिए शीर्ष 9 डेटा एनालिटिक्स टूल्स की सूची है।
1. Python
कई प्रोग्रामिंग भाषाओं की लोकप्रियता रैंकिंग में प्रथम स्थान पर रहने वाला Python डेटा विश्लेषकों के लिए अपरिहार्य टूल है। Python एक ओपन-सोर्स और अत्यंत बहुमुखी प्रोग्रामिंग भाषा है जिसका उपयोग डेटा साइंस उद्योग और अन्य क्षेत्रों, जैसे वेब डेवलपमेंट और वीडियो गेम डेवलपमेंट, में व्यापक रूप से किया जाता है। आप अलग पोस्ट में पढ़ सकते हैं कि Python का उपयोग किस लिए होता है।
Python किसी भी डेटा साइंस कार्य को कर सकता है। इसका मुख्य कारण इसकी समृद्ध लाइब्रेरी इकोसिस्टम है। हजारों शक्तिशाली पैकेजों और विशाल यूज़र कम्युनिटी के समर्थन के साथ, Python डेटा प्रीप्रोसेसिंग, विज़ुअलाइज़ेशन, और सांख्यिकीय विश्लेषण से लेकर मशीन लर्निंग और डीप लर्निंग मॉडल डिप्लॉय करने तक हर तरह के ऑपरेशन कर सकता है।
सरल और पठनीय सिंटैक्स के कारण, Python को अक्सर शुरुआती लोगों के लिए सीखने में सबसे आसान प्रोग्रामिंग भाषाओं में से एक माना जाता है।
हालाँकि, जब भारी मात्रा में डेटा प्रोसेस करने की बात आती है, तो Julia या Spark जैसी अन्य भाषाएँ और समाधान Python की तुलना में बेहतर प्रदर्शन और दक्षता प्रदान कर सकते हैं।
यदि आप Python विशेषज्ञ बनना चाहते हैं, तो DataCamp आपकी मदद के लिए है। हमारे कोर्स कैटलॉग में सभी स्तरों के लिए अनेक Python कोर्स मिलेंगे। हमारे Data Analyst with Python करियर ट्रैक पर नज़र डालें और अपनी Python लर्निंग यात्रा शुरू करें।
2. R Programming
भले ही यह Python जितना ट्रेंडिंग न हो, R अब भी डेटा विश्लेषकों के लिए शीर्ष विकल्प है। अक्सर Python के मुख्य प्रतिस्पर्धी के रूप में प्रस्तुत किया जाने वाला R और Python—इनमें से किसी एक (या दोनों) को सीखना डेटा विश्लेषक बनने की दिशा में एक महत्वपूर्ण कदम है। अधिक विवरण के लिए हमारा Python बनाम R तुलना देखें।
R एक ओपन-सोर्स, डोमेन-विशिष्ट भाषा है जिसे विशेष रूप से डेटा साइंस और उन्नत कंप्यूटिंग के लिए डिज़ाइन किया गया है। वित्त और शिक्षा जगत में बेहद लोकप्रिय, R डेटा मैनिपुलेशन, प्रोसेसिंग, विज़ुअलाइज़ेशन, सांख्यिकीय कंप्यूटिंग और मशीन लर्निंग के लिए एक उत्कृष्ट भाषा है।
R के पास उपयोगकर्ताओं का बड़ा समुदाय और डेटा विश्लेषण व मशीन लर्निंग के लिए विशेषीकृत लाइब्रेरीज़ का विशाल संग्रह है। इनमें से सबसे उल्लेखनीय Tidyverse परिवार से हैं—डेटा साइंस पैकेजों का संग्रह। इसमें डेटा मैनिपुलेशन के लिए dplyr और शक्तिशाली ggplot2 शामिल हैं, जो R में डेटा विज़ुअलाइज़ेशन के लिए मानक लाइब्रेरी है।
Python की तुलना में, शुरुआती लोगों को R अधिक कठिन और कम बहुमुखी लग सकता है। फिर भी, यदि आप डेटा साइंस में नए हैं या अपनी भाषाओं की सूची बढ़ाना चाहते हैं, तो R सीखना एक उत्कृष्ट विकल्प है। आज ही अपने कौशल निखारने के लिए हमारे समृद्ध R कोर्स कैटलॉग को देखें, जिसमें हमारा लोकप्रिय Introduction to R कोर्स भी शामिल है। आप हमारा Data Analyst with R करियर ट्रैक भी फॉलो कर सकते हैं।
3. SQL
दुनिया के अधिकांश डेटा डेटाबेस में संग्रहीत हैं। SQL (Structured Query Language) एक डोमेन-विशिष्ट भाषा है जो प्रोग्रामर्स को डेटाबेस से संवाद करने, उन्हें संपादित करने और उनसे डेटा निकालने में सक्षम बनाती है। यदि आप डेटा विश्लेषक बनना चाहते हैं, तो डेटाबेस और SQL का ठोस ज्ञान अनिवार्य है।
SQL जानने से आप विभिन्न रिलेशनल डेटाबेस—जैसे SQLite, MySQL, और PostgreSQL—के साथ काम कर सकेंगे।
चाहे आप अपनी डेटा विश्लेषक यात्रा शुरू करने के लिए Python चुनें या R, आपको SQL सीखने पर भी विचार करना चाहिए। घोषणात्मक और सरल सिंटैक्स के कारण, SQL अन्य भाषाओं की तुलना में सीखने में बहुत आसान है और आपके रास्ते में बहुत मददगार साबित होगा।
फिर भी, भले ही SQL सिंटैक्स सरल लगे, बड़े और जटिल डेटाबेस के साथ काम करते समय उन्नत SQL क्वेरी लिखना चुनौतीपूर्ण हो सकता है।
SQL में शुरुआत करना चाहते हैं? हमारे Data Analyst in SQL करियर ट्रैक पर नज़र डालें और क्वेरी के माहिर बनें।
4. Julia
तुलनात्मक रूप से एक युवा भाषा होने के बावजूद—इसे 2011 में ही जारी किया गया था—Julia ने संख्यात्मक कंप्यूटिंग की दुनिया को पहले ही प्रभावित कर दिया है।
Julia एक नई और रोमांचक प्रोग्रामिंग भाषा है जिसे आधार से इस उद्देश्य से विकसित किया गया है कि यह वैज्ञानिक कंप्यूटिंग, मशीन लर्निंग और डेटा माइनिंग के लिए आदर्श भाषा हो। Julia यह लक्ष्य C की गति, Python की सामान्य प्रोग्रामिंग क्षमता, और R की सांख्यिकीय दक्षता को समेटकर हासिल करती है।
हाल के वर्षों में, Julia लगातार गति पकड़ रही है, और अधिक से अधिक डेटा पेशेवर उसके चौंकाने वाले प्रदर्शन के कारण Python के बजाय Julia चुन रहे हैं। हमारे अलग गाइड में पढ़ें कि Julia का उपयोग किस लिए होता है।
हालाँकि, Julia अभी तक Python और R जैसी भाषाओं जितनी व्यापक रूप से अपनाई नहीं गई है। इसका समुदाय छोटा है और इसके पास अपने प्रमुख प्रतिस्पर्धियों जितनी लाइब्रेरीज़ नहीं हैं।
DataCamp अपने कैटलॉग को नए Julia कोर्स के साथ अपडेट करने के लिए लगातार काम कर रहा है। इस उभरते डेटा साइंस सितारे पर शुरुआत करने के लिए हमारा Julia Fundamentals स्किल ट्रैक देखें।
5. Excel
Microsoft Excel का ज़्यादा परिचय कराने की आवश्यकता नहीं—हर कोई इसे जानता है। डेटा विश्लेषण का एक क्लासिक टूल, कई गुरुओं ने पिछले दशकों में इसकी मृत्यु की भविष्यवाणी की है। हालाँकि, ये भविष्यवाणियाँ बिल्कुल गलत साबित हुईं। अधिक लचीले और शक्तिशाली टूल्स के उभार के बावजूद, Excel अब भी रोज़मर्रा के कई डेटा विश्लेषण कार्यों के लिए प्रमुख टूल है।
Excel शक्तिशाली क्षमताओं को उपयोगकर्ता-अनुकूल इंटरफ़ेस के साथ जोड़ता है, जिससे यह अनुभवी डेटा विश्लेषकों और कम तकनीकी उपयोगकर्ताओं, दोनों के लिए उपयुक्त बनता है। यह Microsoft BI स्टैक, जिसमें PowerBI शामिल है, के साथ सहज एकीकरण के कारण भी बेहतरीन टूल है।
Excel को विशेष रूप से सुलभ और उपयोग में आसान होने के लिए डिज़ाइन किया गया है। हालाँकि, इसकी एक कीमत है: Excel अन्य टूल्स जैसे Python या R जितना लचीला नहीं है, और कुछ जटिल ऑपरेशन सीधे-सीधे नहीं हो पाते।
फिर भी, Excel सीखना समझदारी है, क्योंकि एक डेटा विश्लेषक के रूप में आपके काम का एक हिस्सा Excel स्प्रेडशीट्स से जुड़ा होना बहुत संभव है। हमारे कैटलॉग पर नज़र डालें, जहाँ आपको इस विषय पर कोर्स मिलेंगे, जैसे Data Analysis in Excel, Data Preparation in Excel, और Data Visualization in Excel।
6. Spark
पारंपरिक डेटा एनालिटिक्स टूल्स, जैसे Python या R, बहुत बड़े डेटासेट्स के साथ काम करते समय कम पड़ सकते हैं। लाखों रो वाले डेटासेट्स को उच्च गति से प्रोसेस करने के लिए एक अलग सेट के टूल्स की आवश्यकता होती है, जो उच्च प्रदर्शन प्रदान करने के लिए उन्नत तकनीकों को शामिल करते हैं।
इन समाधानों में, Apache Spark शायद सबसे लोकप्रिय है। Spark क्लस्टर कंप्यूटिंग के लिए एक प्लेटफ़ॉर्म है। Spark आपको डेटा और कंप्यूटेशन को कई नोड्स वाले क्लस्टर्स (प्रत्येक नोड को एक अलग कंप्यूटर समझें) में बाँटने देता है। डेटा को विभाजित करने से बहुत बड़े डेटासेट्स के साथ काम करना आसान हो जाता है क्योंकि प्रत्येक नोड केवल थोड़े से डेटा पर काम करता है।
Spark का एक प्रमुख पहलू अन्य डेटा एनालिटिक्स टूल्स, जिनमें Python भी शामिल है, के साथ इसका एकीकरण है। PySpark वह Python पैकेज है जो यह जादू करता है। ये इंटीग्रेशन डेटा विश्लेषकों के लिए Spark के साथ शुरुआत करना आसान बनाते हैं।
Spark सीखना चाहते हैं? हमारा Introduction to PySpark कोर्स शुरुआत करने के लिए बेहतरीन जगह है,
7. Power BI
Power BI एक क्लाउड-आधारित बिज़नेस एनालिटिक्स समाधान है जो आपको विभिन्न डेटा स्रोतों को संयोजित करने, उनका विश्लेषण करने, और विज़ुअलाइज़ेशन, रिपोर्ट्स, तथा डैशबोर्ड्स के माध्यम से विश्लेषण प्रस्तुत करने की सुविधा देता है।
Gartner Magic Quadrant के अनुसार, Microsoft का PowerBI BI समाधानों में उद्योग का अग्रणी है। Power BI संगठन के अंदर और बाहर लगभग किसी भी डिवाइस पर डेटा तक पहुँच आसान बनाता है।
इसकी प्रमुख विशेषताओं में शामिल हैं:
- Excel से प्रत्यक्ष कनेक्टिविटी और अन्य Microsoft उत्पादों के साथ आसान एकीकरण
- डेटा को संपीड़ित करने और बड़े डेटासेट्स से अंतर्दृष्टि निकालने की क्षमता
- R और Python का उपयोग करके कस्टमाइज़ेबिलिटी
- Power Query का उपयोग करके डेटा आयात करना, फ़िल्टर करना और ट्रांसफ़ॉर्म करना
- एडैप्टिव और उपयोगकर्ता-अनुकूल अनुभव।
हालाँकि, Excel की तरह, Power BI भी कभी-कभी सुलभता के नाम पर लचीलापन त्याग देता है। कुछ ऑपरेशन करना मुश्किल हो सकता है और कुछ क्षेत्रों में कार्यक्षमताएँ सीमित हो सकती हैं। उसी तरह, सहज इंटरफ़ेस के बावजूद, PowerBI जटिल हो सकता है, खासकर जब इसे अन्य परस्पर संबंधित टूल्स के साथ उपयोग किया जाता है।
हर उदीयमान डेटा विश्लेषक को कम से कम एक BI टूल में निपुण होना चाहिए। Power BI निस्संदेह सबसे अच्छे विकल्पों में से एक है। DataCamp के पास इस टूल पर ढेर सारा सामग्री है—हमारे Introduction to Power BI कोर्स से लेकर अधिक उन्नत विषयों तक, जैसे हमारा Reports in Power BI कोर्स।
8. Tableau
2003 में Stanford University में स्थापित, Tableau एक शक्तिशाली और लोकप्रिय डेटा विज़ुअलाइज़ेशन टूल है जो आपको एक साथ कई स्रोतों के डेटा का विश्लेषण करने देता है।
Tableau सर्वश्रेष्ठ-श्रेणी के BI टूल्स में से एक है। शीर्ष कंपनियाँ कच्चे डेटा की भारी मात्रा से अंतर्दृष्टि निकालने के लिए इसका उपयोग करती हैं। इसके सहज और शक्तिशाली प्लेटफ़ॉर्म के कारण, तकनीकी और गैर-तकनीकी दोनों प्रकार के उपयोगकर्ता विज़ुअल डैशबोर्ड और वर्कशीट बना सकते हैं।
कई पहलुओं में, Tableau Power BI जैसी ही क्षमताएँ प्रदान करता है। हालाँकि, इसे शुरुआती लोगों के लिए अधिक जटिल माना जाता है। इसलिए, यदि आप केवल सरल चार्ट बनाना चाहते हैं, तो आपको कम जटिल विकल्प चुनने चाहिए। साथ ही, Tableau की एक महत्वपूर्ण कमी यह है कि इसका कोई निःशुल्क संस्करण उपलब्ध नहीं है, इसलिए इसका उपयोग करने के लिए आपको काफ़ी महंगी सदस्यता लेनी पड़ेगी।
फिर भी, कई संगठन इसकी अनूठी और शक्तिशाली क्षमताओं के कारण Tableau चुन रहे हैं। इस शानदार टूल को खोजने के लिए हमारा Introduction to Tableau कोर्स और Creating Dashboard in Tableau कोर्स देखें।
9. DataLab
IDEs (Integrated Development Environments) के बिना डेटा विश्लेषक का काम संभव नहीं होता। ये कोडिंग टूल्स शक्तिशाली, सहज इंटरफ़ेस प्रदान करते हैं जो आपका कोड लिखना, डिबग करना और टेस्ट करना आसान बनाते हैं।
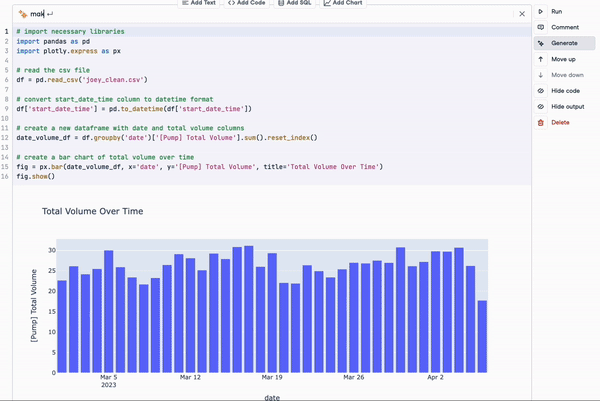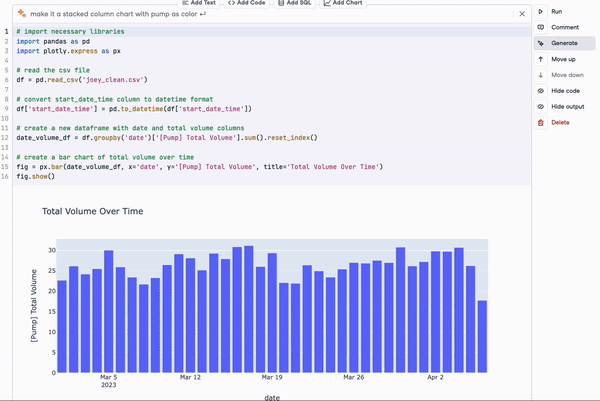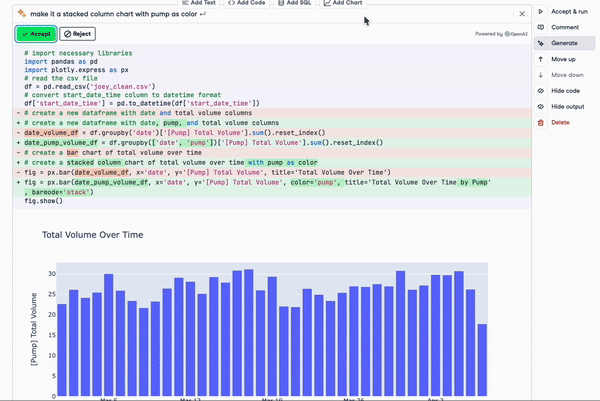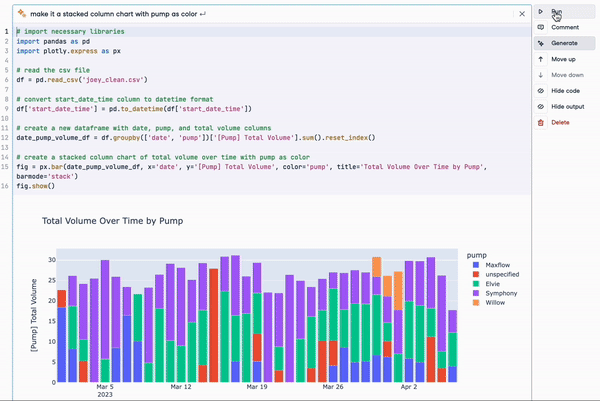
कई लोकप्रिय IDEs मौजूद हैं, जैसे JupyterLab या RStudio, लेकिन हम इस अवसर को नहीं छोड़ना चाहते कि आपको DataCamp के अपने DataLab के बारे में बताएँ।
डेटा लोकतंत्रीकरण को ध्यान में रखकर डिज़ाइन किया गया DataLab, विभिन्न उद्योगों में टीम सहयोग और संगठनात्मक लर्निंग के लिए एक मूल्यवान टूल है।
नए AI Assistant के साथ, DataLab का लक्ष्य अपने उपयोगकर्ताओं के लिए डेटा साइंस को और भी सुलभ और उत्पादक बनाना है। AI Assistant की प्रमुख विशेषताओं में "Fix Error" बटन शामिल है, जो न केवल कोड त्रुटियों को ठीक करता है बल्कि उन्हें समझाता भी है, जिससे उपयोगकर्ता सीख सकें और वही गलतियाँ दोहराने से बच सकें।
“Generate Code” फ़ीचर आपको प्राकृतिक भाषा क्वेरी के आधार पर कोड जेनरेट करने और किसी डेटासेट से जुड़े प्रमुख प्रश्नों के उत्तर देने की सुविधा देता है। इसके अतिरिक्त, AI Assistant मौजूदा कोड और संदर्भ के आधार पर बुद्धिमान सुझाव देता है, जिससे कोड लिखना और भी स्मार्ट और कुशल हो जाता है।
नि:शुल्क और सशुल्क, दोनों प्रकार की DataLab योजनाओं पर उपलब्ध, AI Assistant आधुनिक डेटा वैज्ञानिकों के टूलिंग स्टैक में और सहज एकीकरण का वादा करता है, जिससे डेटा के साथ काम करने वाला कोई भी व्यक्ति सूचित निर्णय ले सके। आप DataLab के साथ निःशुल्क शुरुआत कर सकते हैं।
10. Google BigQuery
Google BigQuery एक पूर्ण-प्रबंधित, सर्वरलेस डेटा वेयरहाउस है जो बड़े डेटासेट्स के स्केलेबल विश्लेषण में सक्षम बनाता है। यह Google Cloud Platform का हिस्सा है और बड़े पैमाने पर डेटा पर उच्च-गति क्वेरी करने के लिए डिज़ाइन किया गया है।
BigQuery विशेष रूप से उन संगठनों के लिए उपयोगी है जो आधारभूत संरचना का प्रबंधन किए बिना बड़े डेटासेट्स का तेजी और कुशलता से विश्लेषण करना चाहते हैं।
BigQuery बड़े पैमाने पर डेटा विश्लेषण से निपटने वाले व्यवसायों के लिए विशेष रूप से मूल्यवान है, खासकर वे जो पहले से Google Cloud सेवाओं का उपयोग कर रहे हैं। हालाँकि, प्रोसेस किए गए डेटा की मात्रा के आधार पर लागत बढ़ सकती है, इसलिए लागत अनुकूलन के लिए अपनी क्वेरीज़ को कुशलतापूर्वक प्रबंधित करना महत्वपूर्ण है।
इन टूल्स को अपने टूलबॉक्स में जोड़ने से आप डेटा विश्लेषण कार्यों की व्यापक श्रेणी को संभालने में सक्षम हो सकते हैं, खासकर विशेष क्षेत्रों में या बड़े पैमाने के डेटा प्रोसेसिंग के समय।
इस अद्भुत टूल के बारे में अधिक जानने के लिए हमारा Introduction to BigQuery कोर्स देखें।
डेटा एनालिटिक्स टूल्स में भविष्य के रुझान
डेटा साइंस उद्योग में सब कुछ तेजी से विकसित हो रहा है। कोई भी छोटा-सा नवाचार ब्रेकथ्रू पूरी तकनीकी तस्वीर को बदल सकता है। जो टूल्स और समाधान आज मेनस्ट्रीम दिखते हैं, वे कल अप्रचलित हो सकते हैं, क्योंकि नई और शक्तिशाली क्षमताओं वाली उभरती तकनीकें बाजार में आ जाती हैं।
यह बात ChatGPT के लॉन्च के बाद आने वाली AI क्रांति से स्पष्ट होती है। अपनी प्रभावशाली क्षमताओं के साथ, ChatGPT और बड़े भाषा मॉडलों द्वारा संचालित कई अन्य जनरेटिव AI तकनीकें तेजी से डेटा साइंस और सॉफ्टवेयर डेवलपमेंट की परिकल्पना को बदल रही हैं।
ये टूल्स शीघ्र ही डेटा विश्लेषक के टूलबॉक्स का आवश्यक हिस्सा बन जाएंगे। इसलिए, इन्हें सीखना अनिवार्य है। सौभाग्य से, DataCamp में हम आपकी मदद के लिए तैयार हैं। हम आपको AI क्रांति में नेविगेट करने के लिए बेहतरीन कोर्स और सामग्री प्रदान करने के लिए कड़ी मेहनत कर रहे हैं—जिनमें हमारा लोकप्रिय Generative AI Concepts कोर्स और हमारा AI Essentials स्किल ट्रैक शामिल है।
अंतिम विचार
डेटा विश्लेषक बनना किसी भी डेटा साइंस में रुचि रखने वाले व्यक्ति का बेहतरीन निर्णय हो सकता है। सही डेटा एनालिटिक्स टूल्स सीखना आपकी यात्रा का केंद्रीय भाग होगा। हम केवल आपको शुभकामनाएँ दे सकते हैं और आशा करते हैं कि हमारे कोर्स, ट्यूटोरियल, चीट शीट्स और अन्य सामग्री आपको मदद करें।
शुरुआत करने के लिए हमारी सीखने संबंधी सिफारिशों की सूची यहाँ है:
Data Analyst with Python
यह ट्रैक डेटा विश्लेषण के लिए Python प्रोग्रामिंग भाषा की बुनियाद से शुरू होता है। बुनियाद कवर करने के बाद, आप डेटा रैंगलिंग और डेटा विज़ुअलाइज़ेशन तकनीकों में गहराई से जाएँगे।
आप यह भी सीखेंगे कि वेब, डेटाबेस, और JSON फ़ाइलों जैसे विभिन्न स्रोतों से डेटा कैसे प्राप्त करें। अंततः, यह ट्रैक अन्वेषणात्मक डेटा विश्लेषण तकनीकों का अवलोकन प्रदान करता है और शिक्षार्थी को रिलेशनल डेटाबेस और SQL अवधारणाओं पर अपस्किल करता है।
Data Analyst with R
यह ट्रैक R प्रोग्रामिंग भाषा के साथ काम करने वाले डेटा विश्लेषकों द्वारा आवश्यक प्राथमिक कौशल पर केंद्रित है। यह tidyverse, ggplot, और dplyr जैसे सबसे आम उपयोग किए जाने वाले R पैकेजों को कवर करने वाली व्यापक सामग्री प्रदान करता है।
Python ट्रैक की तरह, यह कोर्स डेटा सोर्सिंग, मैनिपुलेशन, और विज़ुअलाइज़ेशन जैसे डेटा विश्लेषक कौशलों की मध्यम समझ विकसित करने में मदद करता है।
Data Analyst with SQL
यह करियर ट्रैक शिक्षार्थी को SQL Server, रिलेशनल डेटाबेस की अवधारणाएँ, उनका डिज़ाइन, और प्रदर्शन अनुकूलन की गहन समझ विकसित करने में मदद करता है।
FAQs
कई टूल्स सीखने और किसी एक में विशेषज्ञता के बीच सही संतुलन कैसे तय करूँ?
हालाँकि विभिन्न टूल्स की व्यापक समझ होना आवश्यक है, शुरुआत में एक या दो प्रमुख टूल—जैसे Python या SQL—में महारत हासिल करने पर ध्यान केंद्रित करना एक मजबूत नींव देता है। एक बार जब आप इनमें दक्ष हो जाते हैं, तो आप धीरे-धीरे अपनी प्राथमिक विशेषज्ञता के पूरक अन्य टूल्स सीखकर अपना कौशल सेट बढ़ा सकते हैं। सही संतुलन आपके करियर लक्ष्यों और उस उद्योग या कंपनी की विशिष्ट आवश्यकताओं पर निर्भर करता है जिसमें आप काम करना चाहते हैं।
डेटा एनालिटिक्स के लिए नि:शुल्क टूल्स और सशुल्क टूल्स के बीच निर्णय लेते समय मुझे क्या विचार करना चाहिए?
नि:शुल्क और सशुल्क टूल्स के बीच चयन करते समय, आपको आवश्यक विशिष्ट फीचर्स, टूल की स्केलेबिलिटी, और जिन डेटा सेट्स पर आप काम करेंगे, उनके आकार पर विचार करें। Python या R जैसे नि:शुल्क टूल्स अपनी व्यापक लाइब्रेरीज़ के कारण बहुत शक्तिशाली हो सकते हैं। हालाँकि, Tableau या Power BI जैसे सशुल्क टूल्स बेहतर सपोर्ट, उन्नत फीचर्स, और इंटीग्रेशन क्षमताएँ प्रदान कर सकते हैं जो विशेष रूप से प्रोफेशनल सेटिंग में उनकी लागत को उचित ठहरा सकती हैं।
नवीनतम डेटा एनालिटिक्स टूल्स और रुझानों से अपडेट रहना कितना महत्वपूर्ण है?
तेजी से विकसित हो रहे डेटा साइंस क्षेत्र में नवीनतम टूल्स और रुझानों से अपडेट रहना अत्यंत महत्वपूर्ण है। नए टूल्स अक्सर बेहतर प्रदर्शन, बेहतर इंटीग्रेशन, या नई कार्यक्षमताएँ प्रदान करते हैं जो आपकी उत्पादकता और विश्लेषण की गुणवत्ता को काफी बढ़ा सकते हैं। प्रोफेशनल समुदायों से नियमित रूप से जुड़ना, वेबिनार में भाग लेना, और रिफ्रेशर कोर्स करना आपकी स्किल्स को करंट रखने में मदद करता है।
नए टूल्स को वर्कफ़्लो में एकीकृत करते समय डेटा विश्लेषकों को किन सामान्य चुनौतियों का सामना करना पड़ता है?
सामान्य चुनौतियों में मौजूदा टूल्स के साथ संगतता मुद्दे, नए टूल्स से जुड़ी तीखी सीखने की वक्र, और उन टीम सदस्यों का प्रतिरोध शामिल है जो कुछ टूल्स के आदी हैं। इसके अतिरिक्त, किसी नए टूल पर संक्रमण के लिए सेटअप, डेटा माइग्रेशन, और प्रोसेस समायोजन के संदर्भ में पर्याप्त समय और प्रयास की आवश्यकता हो सकती है।
टीम या प्रबंधन को नए टूल्स अपनाने की आवश्यकता को डेटा विश्लेषक प्रभावी ढंग से कैसे संप्रेषित कर सकता है?
नए टूल्स की आवश्यकता को प्रभावी ढंग से संप्रेषित करने के लिए, डेटा विश्लेषक को मौजूदा टूल्स की सीमाएँ और नए टूल्स इन अंतरालों को कैसे भरते हैं, यह स्पष्ट रूप से प्रस्तुत करना चाहिए। इसमें संभावित समय-बचत, बेहतर सटीकता, बेहतर स्केलेबिलिटी, और कंपनी के दीर्घकालिक लाभों का प्रदर्शन शामिल हो सकता है। अन्य कंपनियों के केस स्टडीज़ या उदाहरण प्रस्तुत करना भी आपके तर्क को मजबूत कर सकता है।

मैं एक स्वतंत्र डेटा विश्लेषक हूँ और दुनिया भर की कंपनियों व संगठनों के साथ डेटा साइंस परियोजनाओं पर सहयोग करता/करती हूँ। मैं 2+ वर्षों के अनुभव वाला/वाली डेटा साइंस प्रशिक्षक भी हूँ। मैं नियमित रूप से अंग्रेज़ी और स्पेनिश में डेटा साइंस से संबंधित लेख लिखता/लिखती हूँ, जिनमें से कुछ DataCamp, Towards Data Science और Analytics Vidhya जैसी स्थापित वेबसाइटों पर प्रकाशित हुए हैं। राजनीतिक विज्ञान और क़ानून की पृष्ठभूमि वाले/वाली डेटा वैज्ञानिक के रूप में, मेरा लक्ष्य लोक नीति, क़ानून और प्रौद्योगिकी के संगम पर काम करना है—विचारों की शक्ति का उपयोग करके ऐसे अभिनव समाधान और कथाएँ विकसित करना जो हमें तात्कालिक चुनौतियों, विशेषकर जलवायु संकट, से निपटने में मदद कर सकें। मैं स्वयं-अध्येता, सतत सीखने वाला/वाली और बहुविषयक दृष्टिकोण का प्रबल समर्थक/समर्थक हूँ। नई चीज़ें सीखने में कभी देर नहीं होती।
क्या आप एक प्लंबर को टूलबॉक्स के बिना कल्पना कर सकते हैं? नहीं, सही? यही बात डेटा पेशेवरों पर भी लागू होती है। अपने डेटा एनालिटिक्स टूल्स के बिना, डेटा पेशेवर डेटा का विश्लेषण, विज़ुअलाइज़ेशन, उससे अंतर्दृष्टि निकालना—और वे कई शानदार काम—जो वे रोज करते हैं, नहीं कर सकते।
आपका डेटा साइंस टूलबॉक्स इस बात पर थोड़ा अलग होगा कि आप किस करियर में सबसे अधिक रुचि रखते हैं—डेटा विश्लेषक, डेटा वैज्ञानिक, डेटा इंजीनियर, आदि.
इस लेख में, हम उन आवश्यक डेटा एनालिटिक्स टूल्स की सूची देंगे जो हर अनुभवी डेटा विश्लेषक के पास होने चाहिए। मूल रूप से, एक डेटा विश्लेषक इन बातों पर केंद्रित होता है:
अब जबकि आप जानते हैं कि डेटा विश्लेषक क्या करता है, आइए उसके टूलबॉक्स पर नज़र डालें!
डेटा एनालिटिक्स टूल चुनने के मानदंड
डेटा साइंस एक तेजी से विकसित हो रहा उद्योग है। नए सॉफ्टवेयर और टूल्स—जिनमें डेटा एनालिटिक्स टूल्स भी शामिल हैं—लगभग हर दिन लॉन्च हो रहे हैं। इतने जीवंत इकोसिस्टम में सही टूल्स चुनना चुनौतीपूर्ण हो सकता है, खासकर यदि आप डेटा साइंस में नए हैं।
किसी भी टूलबॉक्स की तरह, ऐसा कोई टूल नहीं है जो बतौर डेटा विश्लेषक आपके सामने आने वाली हर समस्या का सर्वोत्तम समाधान हो। इसके बजाय, सफलता की कुंजी एक पूर्ण और संतुलित टूलसेट रखना है जो हर परिस्थिति में आपकी मदद करे।
हर केस अलग होता है, और आपको या आपकी कंपनी को अपनी ज़रूरतों के लिए सर्वोत्तम फिट खोजने के लिए कई कारकों पर विचार करना होगा। नीचे वे कारक दिए गए हैं जिनका मूल्यांकन आपको अपने डेटा एनालिटिक्स टूल्स चुनने से पहले करना चाहिए:
व्यावसायिक आवश्यकताओं की पहचान
यह शायद सबसे महत्वपूर्ण कारक है। जबकि यह पूछना ज़रूरी है कि आप कौन से टूल सीखना चाहते हैं और आपको कौन से सबसे ज्यादा पसंद हैं, आपको यह पूछना नहीं भूलना चाहिए कि आपकी कंपनी—या वह कंपनी जिसमें आप काम करना चाहेंगे—को क्या चाहिए। यह तर्कसंगत है: यदि टीम के बाकी सदस्य Python का उपयोग करते हैं, तो पहले R सीखना शायद सबसे समझदारी भरा निर्णय नहीं है।
साथ ही, आपको हमेशा हालिया रुझानों और अत्याधुनिक डेटा तकनीकों पर नज़र रखनी चाहिए ताकि आप उन्हें सीखकर टीम में अपनी वैल्यू बढ़ा सकें।
स्केलेबिलिटी और लचीलापन
पिछले कुछ वर्षों में बिग डेटा परिदृश्य नाटकीय रूप से बदल गया है। आज, डेटा-चालित कंपनियां अलग-अलग फॉर्मैट्स में विशाल मात्रा में डेटा से निपटती हैं, जिन्हें अक्सर लगभग वास्तविक समय में प्रोसेस किया जाता है।
ऐसे परिदृश्य में, स्केलेबिलिटी और लचीलापन सफलता के लिए अत्यंत महत्वपूर्ण हैं। डेटा साइंस टेक्नोलॉजी लैंडस्केप तेजी से बढ़ रहा है, और इसमें कई टूल्स और एप्लिकेशन शामिल हैं जो बढ़ते डेटा वॉल्यूम, वेग, और विविधता की चुनौतियों से निपटने के लिए विशेष रूप से डिज़ाइन किए गए हैं। इसलिए, अपने टूल्स चुनते समय, हमेशा यह विचार करें कि आपको या आपकी टीम को कितना लचीलापन और स्केलेबिलिटी चाहिए।
उपयोग में सरलता और सीखने की वक्र
डेटा एनालिटिक्स टूल्स की उपयोग-सुलभता और जटिलता काफी भिन्न होती है। जितनी अधिक सुविधाएँ और उन्नत क्षमताएँ, सीखने की वक्र उतनी ही तीखी। इसके विपरीत, सरल डेटा एनालिटिक्स टूल्स गैर-तकनीकी उपयोगकर्ताओं के लिए अधिक उपयुक्त होते हैं, जो जल्दी शुरुआत कर सकते हैं।