Kursus
AI Praktis dengan Google Gemini dan NotebookLM
2 jam
10K
Google merilis model Flash dengan kecepatan yang sulit diimbangi. Gemini 3.8 Flash adalah rilis Flash ketiga perusahaan dalam enam minggu, dan hadir sebagai model penalaran dan pengodean terbaiknya di tier Flash, dengan kecepatan dan biaya rendah yang sama seperti 3.7 Flash tiga minggu sebelumnya.
Bersamaan dengan model standar, Google memperkenalkan Gemini 3.8 Flash Cyber, varian yang disetel untuk pekerjaan keamanan siber dan hanya tersedia bagi pembela tepercaya melalui Program Fairwind, sebuah inisiatif akses terbatas yang diluncurkan bersamaan dengan model baru. Keduanya berbagi kecerdasan fondasional yang sama.
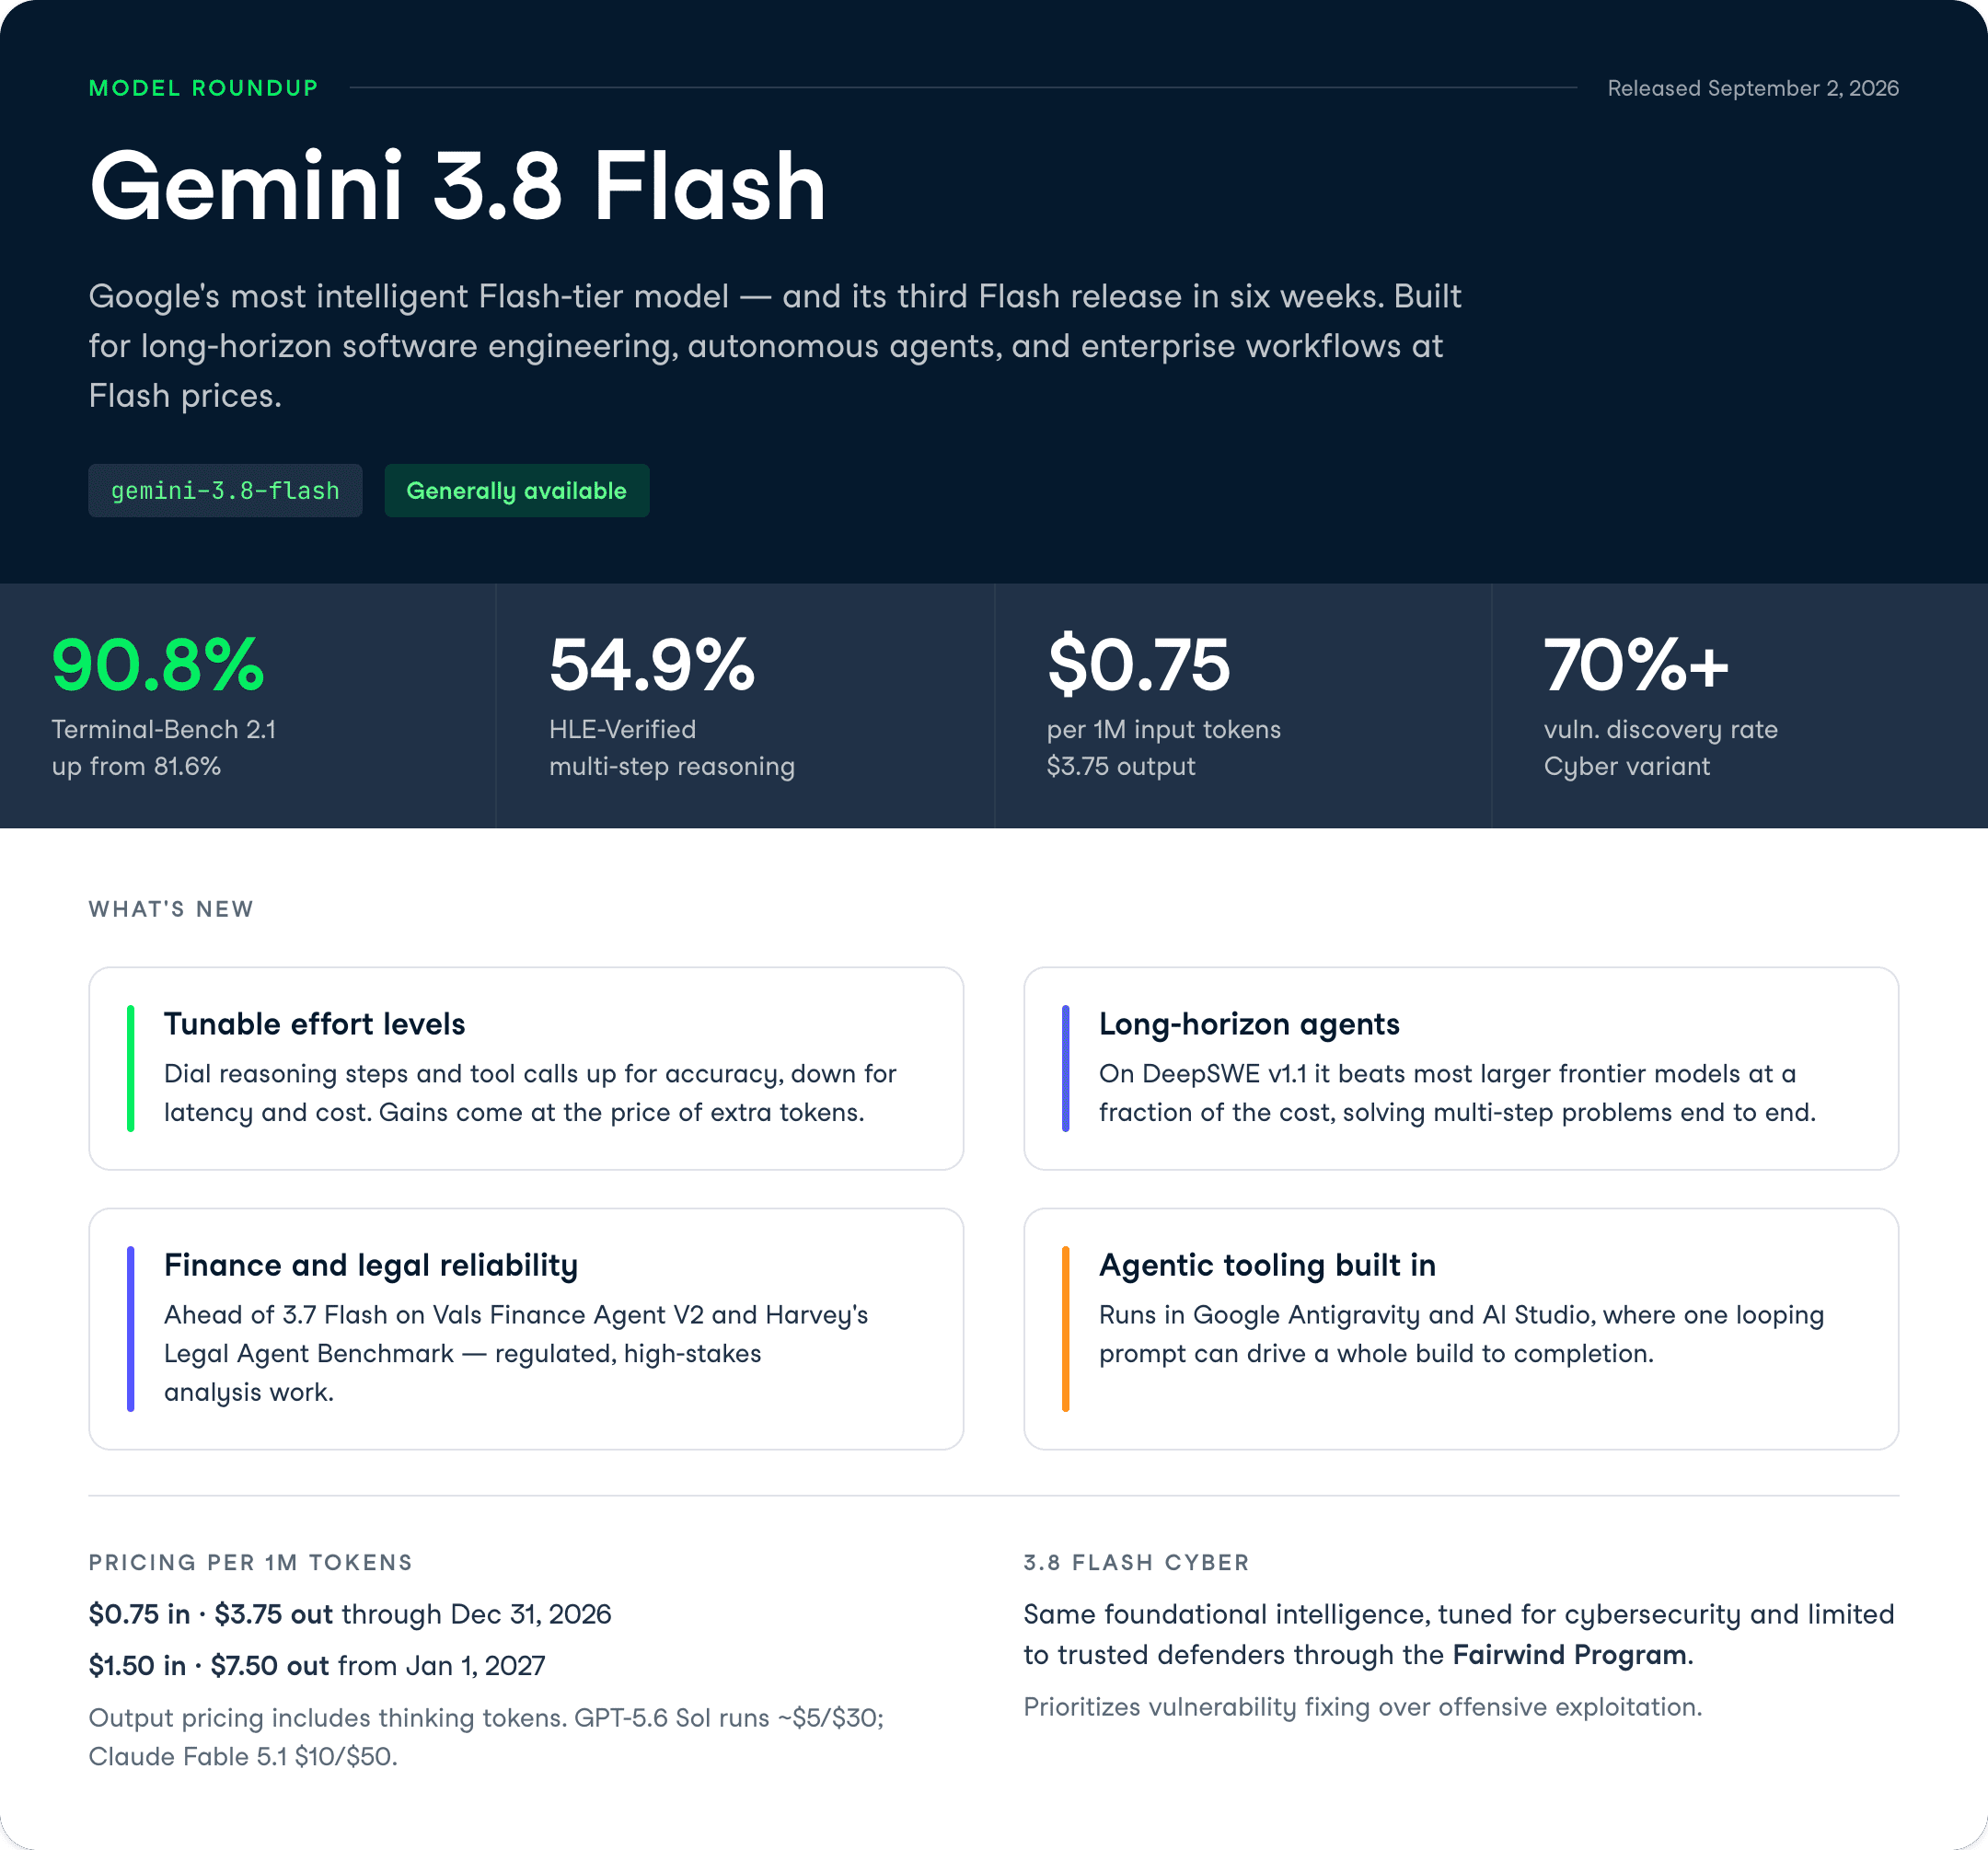
Angka utama tampil kuat: Gemini 3.8 Flash mencetak 90,8% pada Terminal-Bench 2.1 (naik dari 81,6% untuk 3.7 Flash), 54,9% pada HLE-Verified, dan tingkat penemuan kerentanan di dunia nyata di atas 70% untuk varian Cyber.
Dalam artikel ini, saya akan membahas semua hal baru pada Gemini 3.8 Flash dan 3.8 Flash Cyber—mulai dari fitur, eksplorasi tolok ukur, hingga uji langsung dengan contoh praktis. Lihat model ini beraksi dalam tutorial API Gemini 3.8 Flash kami, dan baca tentang model asisten suara terbaru Google di panduan Gemini 3.8 Live.
Untuk memahami model pesaing yang bersaing dengannya, lihat panduan kami tentang DeepSeek v4.1 vs Gemini 3.8 Flash dan Claude Opus 5 vs Sonnet 5.
Gemini 3.8 Flash adalah model tier Flash paling cerdas dari Google, dirancang untuk rekayasa perangkat lunak berjangka panjang, agen otonom, dan alur kerja perusahaan yang kompleks.
Model ini berada di bawah tier Pro (seperti Gemini 3.1 Pro) tetapi dihargai jauh lebih murah, mempertahankan tarif perkenalan $0,75 per 1M token input dan $3,75 per 1M token output hingga 31 Desember 2026.
Perubahan utama dari 3.7 Flash adalah 3.8 Flash bekerja lebih keras.
Pada tugas kompleks, model menjalankan langkah penalaran tambahan dan memanggil alat secara iteratif, itulah sebabnya kinerjanya bisa mendekati model frontier berbiaya lebih tinggi. Konsekuensinya adalah overhead token: pada tingkat upaya yang lebih tinggi, model mungkin menghabiskan lebih banyak token untuk memeras beberapa poin akurasi terakhir.
Judul tolok ukur yang paling mencolok ada pada Terminal-Bench 2.1, di mana 3.8 Flash mencetak 90,8% dibanding 81,6% milik 3.7 Flash. Terminal-Bench mengukur seberapa andal model dapat menyelesaikan tugas command-line dan pengodean nyata dari ujung ke ujung, jadi lonjakan 9 poin langsung menunjukkan perilaku pengodean agen yang lebih baik.
 Apa yang Baru di Gemini 3.8 Flash?
Fitur di 3.8 Flash ditujukan untuk pengembang yang menjalankan agen dan sesi pengodean panjang, bukan pengguna chat kasual.
Berikut kemampuan yang perlu Anda ketahui.
Anda dapat memutar tingkat upaya model naik atau turun tergantung apakah Anda lebih mengutamakan akurasi atau biaya.
Ini penting karena peningkatan 3.8 Flash datang dengan harga token ekstra.
Jika beban kerja Anda mengutamakan efisiensi, Google secara eksplisit mengatakan Anda dapat tetap menggunakan 3.7 Flash, yang tetap sepenuhnya didukung.
Itu adalah catatan yang tidak biasa jujurnya untuk disertakan Google dalam tulisan peluncuran, dan ini memberi tahu Anda bahwa kenop upaya adalah pertukaran nyata, bukan performa gratis.
Gemini 3.8 Flash dibangun untuk menjalankan agen yang menyelesaikan masalah rekayasa multi-langkah tanpa banyak arahan.
Pada DeepSWE v1.1, tolok ukur rekayasa perangkat lunak berjangka panjang, model ini mengungguli sebagian besar model frontier yang lebih besar dengan biaya yang jauh lebih rendah sambil menyelesaikan masalah kompleks dari ujung ke ujung.
Bagi praktisi yang membangun agen pengodean, inilah angka yang paling berarti.
Pengguna Reddit dan X yang membocorkan kesan pra-rilis menggambarkannya sebagai "performa setara Fable 5 dengan harga Flash," dan laporan Wall Street Journal mencatat bahwa dalam pengujian head-to-head Jetski internal Google, para insinyur lebih memilih 3.8 Flash dibanding model Opus dari Anthropic untuk pengodean.
Itu klaim kompetitif yang agresif, dan patut diverifikasi setelah API tersedia luas.
3.8 Flash menargetkan bidang teregulasi dan berisiko tinggi, di mana jawaban yang salah berbiaya mahal.
Model ini mengungguli 3.7 Flash dan model frontier lain pada Vals Finance Agent V2 dan Harvey's Legal Agent Benchmark, keduanya menguji analisis dan pelaporan di bidang keuangan dan hukum.
Bayangkan alur kerja di mana agen membaca serangkaian laporan kuartalan dan menyusun ringkasan kepatuhan, atau meninjau klausul kontrak terhadap kebijakan. Keandalan yang dibutuhkan berbeda dari chat umum, dan Google memosisikan 3.8 Flash langsung untuk otonomi perusahaan di domain pengetahuan ini.
Gemini 3.8 Flash berjalan di dalam Google Antigravity dan Google AI Studio, di mana satu prompt berulang dapat mendorongnya menyelesaikan seluruh pembuatan.
Contoh Google sendiri adalah versi Google Maps gaya DOS yang sepenuhnya dapat dimainkan, dihasilkan dari satu prompt di Antigravity, lengkap dengan lokasi, petunjuk arah, dan Street View.
Untuk pekerjaan Anda, bayangkan memberi satu instruksi seperti "bangun dasbor interaktif yang mengambil CSV ini, membuat tiga jenis bagan, dan memungkinkan saya memfilter berdasarkan wilayah," lalu biarkan loop agenik beriterasi sampai berjalan.
Pola instruksi berulang inilah yang membuat tingkat upaya tambahan terbayar, karena model terus menyempurnakan alih-alih berhenti di draf pertama.
Gambar tolok ukur tidak merata—lebih berguna daripada sapuan bersih karena memberi tahu Anda di mana peningkatan sebenarnya terjadi.
Tugas pengodean dan terminal meningkat tajam, sementara penalaran bergaya ujian nyaris tidak bergerak.
Berikut angka-angka dari dokumentasi pengembang dan pengumuman Google.
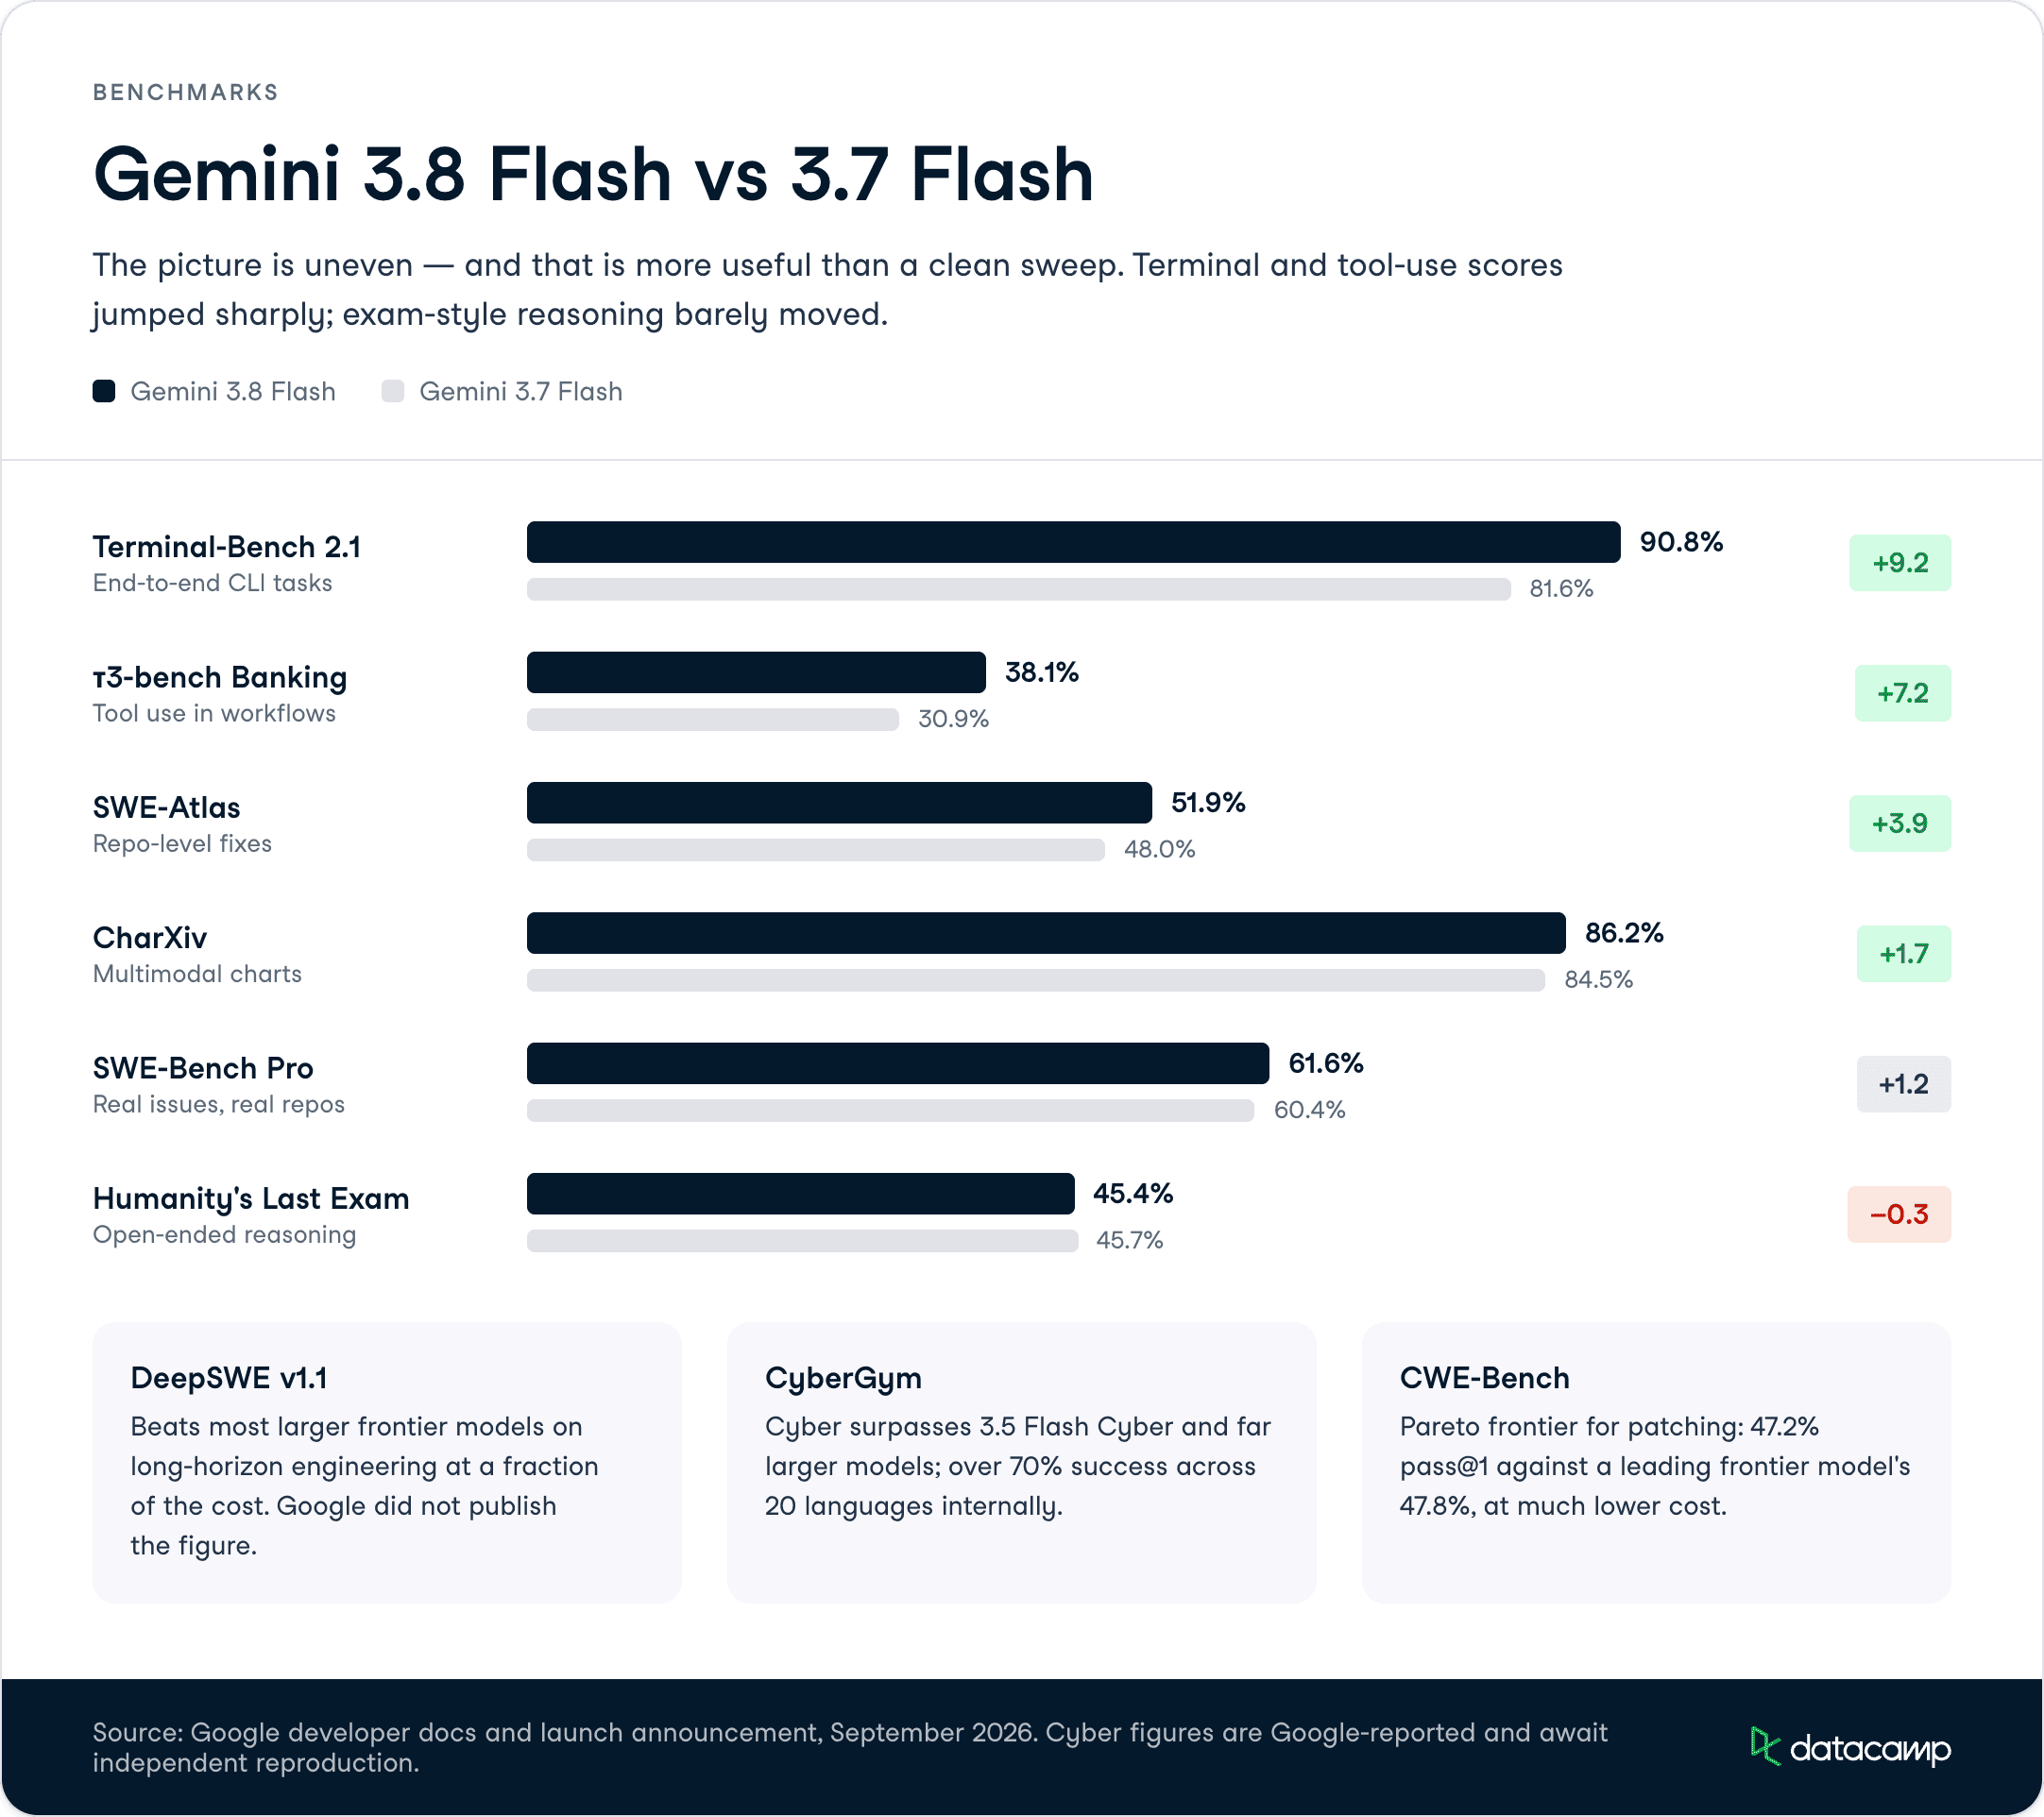
Gemini 3.8 Flash mencetak 90,8% pada Terminal-Bench 2.1, naik dari 81,6% milik 3.7 Flash.
Tolok ukur ini mengukur seberapa andal model menyelesaikan tugas command-line dan pengodean nyata dari awal hingga akhir, termasuk menjalankan alat dan memulihkan dari kesalahan.
Untuk konteks model mid-tier pesaing, dalam perbandingan GPT-5.6 Terra vs Claude Sonnet 5 kami, Terra mencetak 87,4% pada Terminal-Bench 2.1 dan Sonnet 5 mencetak 80,4%. Dengan skor tersebut, 90,8% milik 3.8 Flash sedikit unggul dari keduanya—klaim yang patut dicatat untuk model tier Flash dengan harga input $0,75.
Pada DeepSWE v1.1, tolok ukur rekayasa perangkat lunak berjangka panjang, 3.8 Flash mengungguli sebagian besar model frontier yang lebih besar dengan biaya yang jauh lebih rendah.
Google tidak menerbitkan persentase tepatnya dalam catatan yang diekstrak, tetapi konteksnya adalah model ini menyelesaikan masalah rekayasa kompleks secara otonom, dari ujung ke ujung.
Inilah tolok ukur yang mendukung gagasan "agen yang menyelesaikan pekerjaan".
Jika beban kerja Anda melibatkan agen yang beriterasi pada sebuah codebase selama banyak langkah, DeepSWE lebih dekat dengan realitas Anda dibanding skor pengodean sekali jalan.
Pada SWE-Bench Pro, 3.8 Flash mencetak 61,6% dibanding 60,4% milik 3.7 Flash, dan pada SWE-Atlas mencapai 51,9% versus 48,0%.
Ini adalah tolok ukur rekayasa perangkat lunak tingkat repositori yang mengukur perbaikan isu nyata di codebase nyata.
Kenaikan lebih dari 1 poin pada SWE-Bench Pro tergolong moderat—patut dicatat. Lompatan yang lebih besar ada di Terminal-Bench, jadi jika Anda peduli pada keandalan terminal dan alat, di situlah 3.8 Flash berpisah dari pendahulunya.
3.8 Flash meraih 54,9% pada HLE-Verified, uji penalaran multi-langkah lintas STEM, humaniora, dan bidang profesional.
Namun pada perbandingan Humanity's Last Exam yang lebih luas di dokumentasi pengembang Google, skornya praktis datar: 45,4% untuk 3.8 Flash versus 45,7% untuk 3.7 Flash.
Penalaran bergaya ujian umum tidak banyak maju, jadi jika kasus penggunaan Anda adalah penalaran terbuka yang sulit alih-alih pengodean dan penggunaan alat, peningkatan dari 3.7 ke 3.8 Flash mungkin tidak sepadan dengan token ekstra.
Gemini 3.8 Flash Cyber mencatat hasil setara frontier pada penemuan dan patching kerentanan.
Pada CyberGym, tolok ukur standar industri untuk penemuan kerentanan otonom, model ini melampaui 3.5 Flash Cyber dan model frontier yang jauh lebih besar; pada tolok ukur internal Google yang mencakup 20 bahasa pemrograman, model ini melampaui tingkat keberhasilan 70%.
Pada CWE-Bench, tolok ukur patching eksternal yang dijalankan Collinear, Cyber berada di Pareto frontier dengan pass@1 sebesar 47,2% dibanding 47,8% milik model frontier terkemuka, dengan biaya jauh lebih rendah.
Google dengan sengaja memprioritaskan perbaikan kerentanan dibanding eksploitasi ofensif, yang mencerminkan bagaimana Anthropic merilis Sonnet 5 dengan pengaman siber aktif secara bawaan (0,0% pada evaluasi pengembangan eksploit Firefox, seperti yang kami catat dalam ulasan Opus 5 vs Sonnet 5).
Pada tabel di bawah, Anda dapat melihat perbandingan model baru dengan pendahulunya yang baru beberapa minggu:
| Tolok ukur | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Terminal-Bench 2.1 | 90,8% | 81,6% |
| SWE-Bench Pro | 61,6% | 60,4% |
| SWE-Atlas | 51,9% | 48,0% |
| τ³-bench Banking | 38,1% | 30,9% |
| CharXiv (multimodal) | 86,2% | 84,5% |
| Humanity's Last Exam | 45,4% | 45,7% |
Gemini 3.8 Flash tersedia umum melalui Google AI Studio dan Gemini Enterprise Agent Platform, dirilis 2 September 2026, dengan ID model API gemini-3.8-flash.
Varian 3.8 Flash Cyber terbatas untuk pembela tepercaya melalui Program Fairwind dan tidak dirilis umum.
Harga mempertahankan tarif perkenalan yang sama seperti 3.7 Flash:
Jika dibandingkan dengan pesaing per September 2026: GPT-5.6 Sol sekitar $5 input dan $30 output per 1M token, dan Claude Fable 5.1 $10 input dan $50 output.
Gemini 3.8 Flash jauh lebih murah dari keduanya—itulah inti dari tier Flash.
Gemini 3.8 Flash menunjukkan dorongan agresif Google di sisi nilai untuk model pengodean, dengan strategi yang jelas: menyamai performa pengodean nyaris setara frontier pada harga input $0,75 sambil mengirimkan model Flash baru setiap beberapa minggu.
Skor 90,8% pada Terminal-Bench 2.1 dan harga di bawah $1 menjadikannya kandidat default yang serius untuk beban kerja pengodean agenik.
Pandangan saya: rilis ini tidak merata, dan Google transparan soal itu.
Skor terminal dan penggunaan alat melonjak, DeepSWE serta tolok ukur keuangan dan hukum meningkat, tetapi HLE tetap datar dan SWE-Bench Pro nyaris tidak bergerak.
Jika Anda membangun agen pengodean, ini adalah peningkatan yang berarti dari 3.7 Flash.
Jika Anda membutuhkan penalaran terbuka yang sulit, alasannya lebih lemah, dan tetap pada 3.7 Flash untuk pekerjaan yang mengutamakan efisiensi adalah keputusan yang masuk akal.
Varian Cyber adalah langkah jangka panjang yang lebih menarik. Tingkat penemuan kerentanan dunia nyata 70%+ dan patching di Pareto frontier, dibatasi oleh Program Fairwind dan condong ke pertahanan daripada eksploitasi, adalah posisi yang dapat dipertahankan bagi perusahaan yang sudah menggunakannya untuk mengamankan kodenya sendiri.
Saya ingin melihat reproduksi independen sebelum menerima angka CyberGym dan CWE-Bench mentah-mentah, karena hampir semua data sejauh ini berasal dari Google sendiri.
Jika Anda ingin membangun agen dan alur kerja pengodean di sekitar model seperti ini, AI Agent Fundamentals skill track kami adalah tempat yang solid untuk memulai.
Kursus DataCamp Teratas
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt