
Kursus
Retrieval Augmented Generation (RAG) dengan LangChain
3 jam
20.8K
Wan2.1 dari Qwen adalah model generasi video open-source yang dirancang agar bertenaga sekaligus mudah diakses, karena dapat dijalankan pada GPU kelas konsumen.
Dengan kinerjanya yang kuat, Wan2.1 bersaing dengan model open-source seperti HunyuanVideo dan SkyReels serta solusi komersial seperti Sora dan Runway.
Dalam artikel ini, saya akan membahas apa itu Wan2.1, fitur utamanya, dan cara kerjanya. Selain itu, saya akan memandu Anda cara mengaksesnya dan menggunakannya untuk membuat video dari berbagai prompt, sekaligus menampilkan kemampuan nyatanya.
Wan 2.1 adalah model generasi video canggih yang dikembangkan oleh Qwen. Model ini termasuk keluarga model fondasi video skala besar, artinya dapat membuat video berkualitas tinggi dari berbagai jenis masukan, dalam hal ini deskripsi teks dan gambar.
Wan 2.1 menggabungkan kemampuan generasi video yang kuat dengan kemudahan akses. Model ini dapat berjalan pada GPU kelas konsumen, tidak seperti banyak model video AI lain yang memerlukan perangkat keras mahal, sehingga lebih praktis. Selain itu, model ini bersifat open source.
Model ini dibangun di atas teknologi diffusion transformer, pendekatan yang memungkinkannya menghasilkan video yang mulus dan realistis dengan kualitas gerak yang mengesankan. Wan 2.1 juga memperkenalkan Video Variational Autoencoder (VAE) unik, yang membantu menjaga konsistensi dan detail video, bahkan pada resolusi lebih tinggi seperti 1080p.
Berikut fitur utamanya:
Wan 2.1 melampaui model video AI open-source dan komersial pada berbagai tolok ukur, yang berarti menghasilkan video yang lebih realistis dan berkualitas tinggi dibanding banyak alternatif.
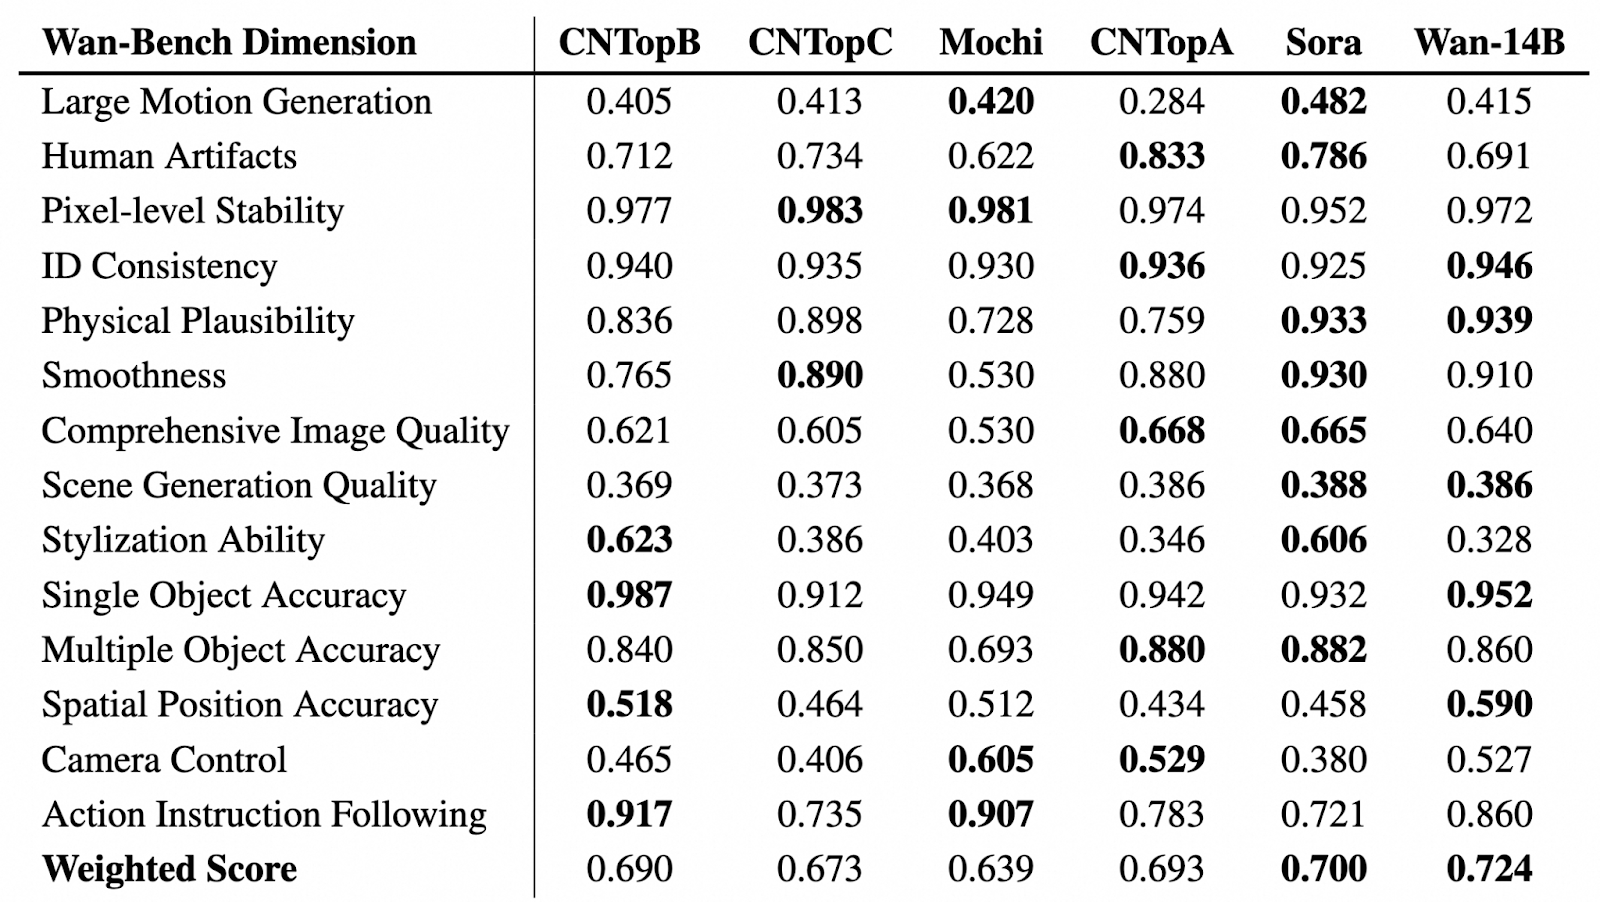
Sumber: GitHub (Wan-Video/Wan2.1)
Pada tabel di atas, kita dapat melihat evaluasi komparatif model generasi video di berbagai dimensi Wan-Bench, menilai kinerja pada aspek kunci seperti pembuatan gerak, stabilitas visual, akurasi objek, dan kepatuhan pada instruksi. Model dengan performa tertinggi di tiap kategori ditandai tebal.
Wan-14B meraih skor tertimbang keseluruhan tertinggi (0,724), menunjukkan kemampuannya yang kuat di berbagai tolok ukur.
Dibandingkan sebagian besar model video AI kelas atas yang memerlukan perangkat keras mahal, model T2V-1.3B milik Wan 2.1 hanya membutuhkan 8,19GB VRAM. Artinya, Anda dapat membuat video menggunakan GPU biasa, seperti RTX 4090, dalam hitungan menit tanpa memerlukan superkomputer.
Dengan Wan, Anda bisa melakukan lebih dari sekadar Text-to-Video (T2V). Model ini menawarkan fitur lanjutan untuk meningkatkan pembuatan dan kustomisasi video, termasuk:
Selain itu, Wan mendukung Image-to-Video (I2V) sehingga Anda dapat mengubah gambar diam menjadi video animasi. Anda dapat menambahkan prompt teks opsional untuk kontrol lebih besar atas pembuatan video serta menentukan frame pertama dan terakhir untuk membentuk komposisi dan alur video.
Wan 2.1 adalah model video AI pertama yang dapat menghasilkan teks yang terbaca di dalam video dalam bahasa Inggris dan Mandarin. Ini sangat berguna untuk membuat takarir, teks animasi, dan overlay grafis di dalam konten video.
Wan 2.1 menggunakan Video Variational Auto Encoder (Wan-VAE) canggih yang memungkinkannya:
Ada beberapa cara untuk memulai—Anda bisa mencobanya secara online atau menjalankannya secara lokal di komputer Anda.
Jika Anda ingin bereksperimen dengan Wan 2.1 tanpa menginstal apa pun, Anda dapat mengaksesnya melalui:
1. Ruang Hugging Face: Anda dapat menjalankan model langsung di antarmuka web.
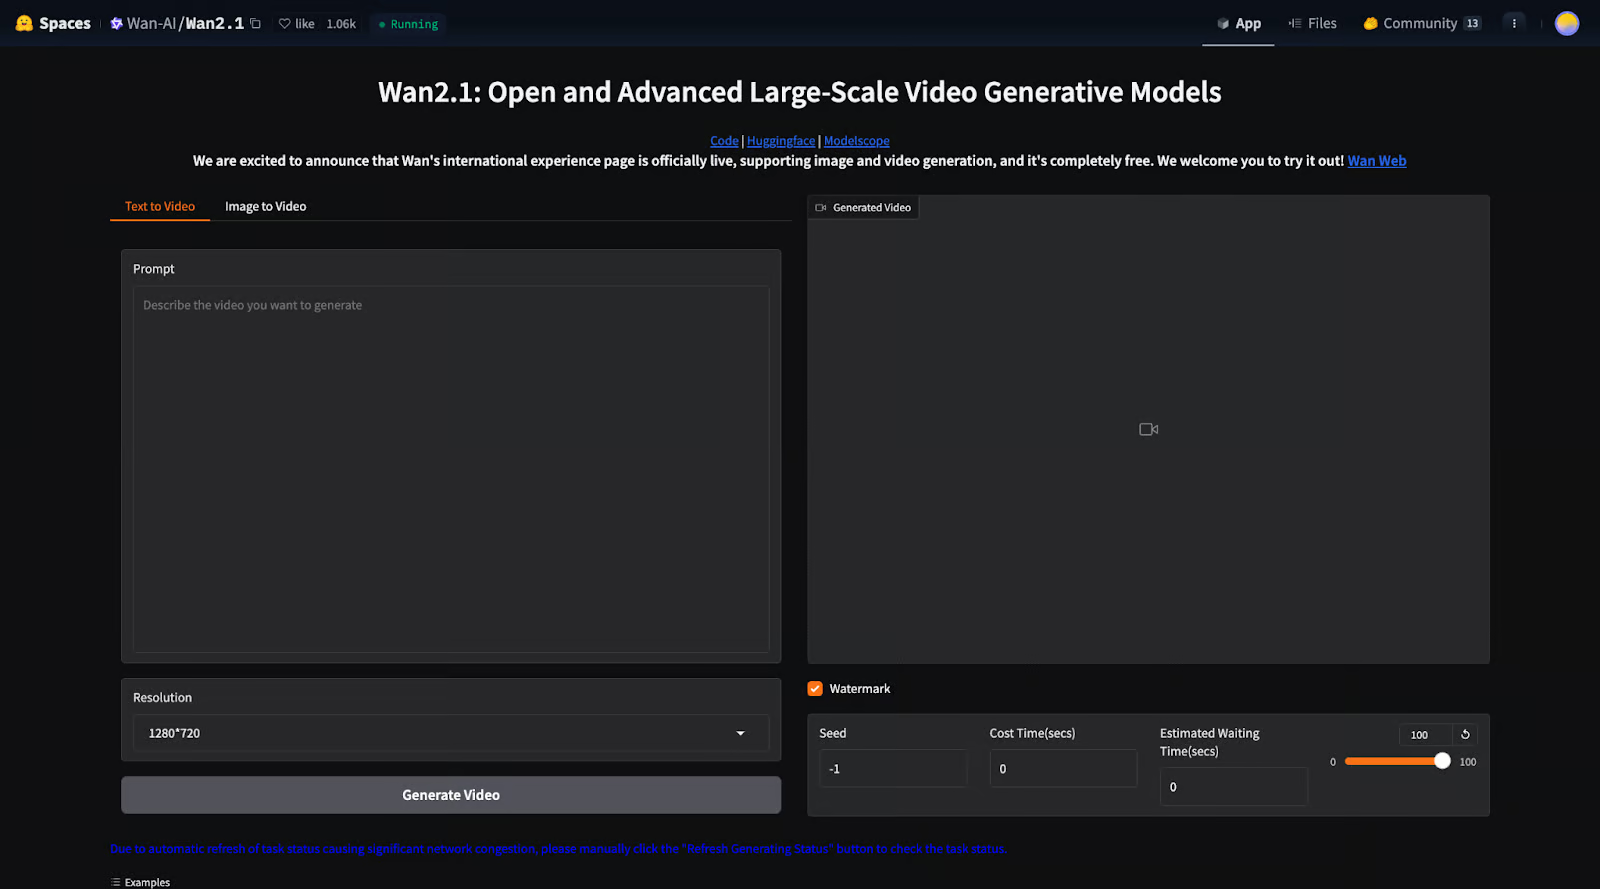
2. Situs WanVideo: Di sini, Anda bisa melakukan lebih dari sekadar membuat video. Situs resmi juga memungkinkan Anda membuat gambar dan menjelajahi koleksi video serta gambar yang dibuat pengguna lain, lengkap dengan prompt yang mereka gunakan.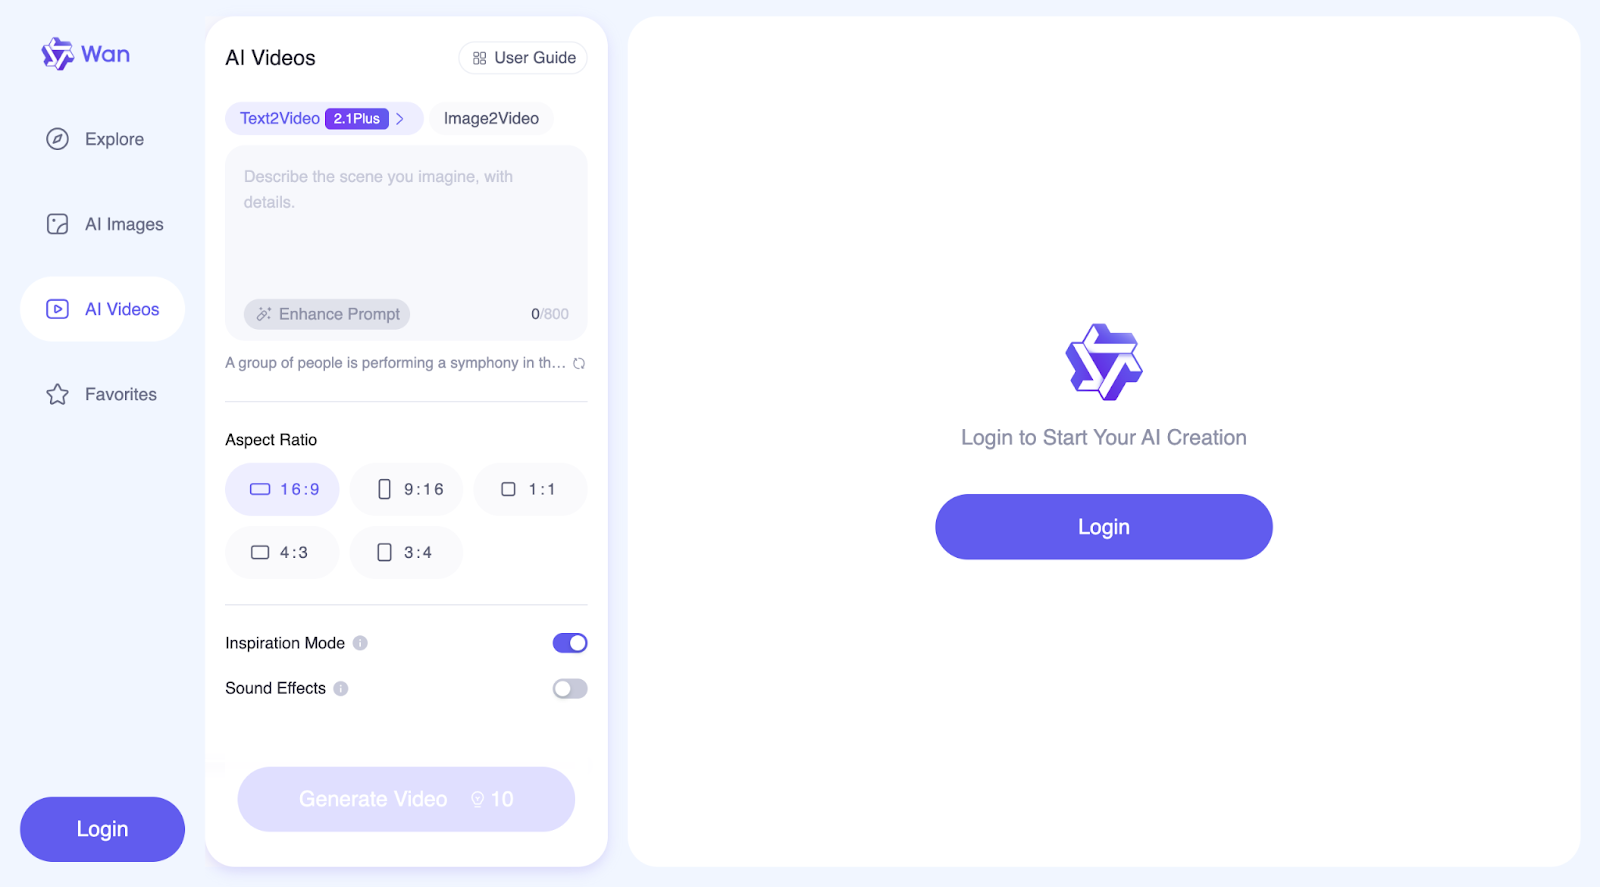
Opsi ini memungkinkan Anda menguji model dengan cepat tanpa repot pengaturan atau perangkat keras.
Jika Anda menginginkan kontrol penuh dan kustomisasi, Anda dapat menginstal Wan 2.1 di mesin Anda sendiri. Mari ikuti langkah demi langkah cara melakukannya:
Pertama, unduh kode Wan 2.1 dari GitHub:
git clone https://github.com/Wan-Video/Wan2.1.git
cd Wan2.1Pastikan Anda telah memasang Python dan PyTorch (versi 2.4.0 atau lebih baru), lalu instal pustaka yang diperlukan:
pip install -r requirements.txtAnda perlu mengunduh file model terlatih dari Hugging Face (lihat info selengkapnya di sini) atau ModelScope (lihat info selengkapnya di sini).Ada beberapa model yang dapat Anda unduh:
|
Model |
Tautan Unduhan |
Catatan |
|
T2V-14B |
Mendukung 480P dan 720P |
|
|
I2V-14B-720P |
Mendukung 720P |
|
|
I2V-14B-480P |
Mendukung 480P |
|
|
T2V-1.3B |
Mendukung 480P |
Model 1.3B dapat menghasilkan video dalam resolusi 720P, tetapi karena pelatihannya pada kualitas ini lebih sedikit, hasilnya mungkin kurang stabil dibanding 480P. Untuk performa terbaik, disarankan resolusi 480P.
Wan 2.1 memungkinkan Anda membuat video dari deskripsi teks menggunakan dua versi model:
Jika Anda hanya ingin membuat video dengan cepat, Anda dapat menggunakan perintah berikut, tanpa mengaktifkan penyempurnaan prompt.
Untuk model T2V-14B (kualitas lebih tinggi, model lebih besar):
python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights."Untuk model T2V-1.3B (lebih kecil, berjalan pada GPU kelas bawah):
python generate.py --task t2v-1.3B --size 832*480 --ckpt_dir ./Wan2.1-T2V-1.3B --prompt "A futuristic city with flying cars and neon lights."Jika komputer Anda kehabisan memori (error OOM), Anda dapat menggunakan --offload_model True dan --t5_cpu untuk mengurangi penggunaan memori.
Jika Anda memiliki beberapa GPU, Anda dapat mempercepat pembuatan video dengan menjalankan perintah ini:
torchrun --nproc_per_node=8 generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --dit_fsdp --t5_fsdp --ulysses_size 8 --prompt "A futuristic city with flying cars and neon lights.`Ini memungkinkan beban kerja dibagi di beberapa GPU, sehingga proses menjadi lebih cepat.
Wan 2.1 dapat menyempurnakan prompt Anda secara otomatis, sehingga video menjadi lebih detail dan menarik secara visual.
Ada dua cara untuk memperluas prompt:
Untuk menggunakan Dashscope API:
DASH_API_KEY=your_key python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights." --use_prompt_extend --prompt_extend_method 'dashscope'Untuk menggunakan model lokal Anda sendiri:
python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights." --use_prompt_extend --prompt_extend_method 'local_qwen'Jika Anda ingin menggunakan pustaka Diffusers dari Hugging Face alih-alih menjalankan skrip mentah, Anda dapat membuat video dengan Python:
import torch
from diffusers.utils import export_to_video
from diffusers import AutoencoderKLWan, WanPipeline
from diffusers.schedulers.scheduling_unipc_multistep import UniPCMultistepScheduler
# Available models: Wan-AI/Wan2.1-T2V-14B-Diffusers, Wan-AI/Wan2.1-T2V-1.3B-Diffusers
model_id = "Wan-AI/Wan2.1-T2V-14B-Diffusers"
# Load the autoencoder for video generation
vae = AutoencoderKLWan.from_pretrained(model_id, subfolder="vae", torch_dtype=torch.float32)
# Define the scheduler for controlling video motion flow
flow_shift = 5.0  # 5.0 for 720P, 3.0 for 480P
scheduler = UniPCMultistepScheduler(
    prediction_type='flow_prediction',
    use_flow_sigmas=True,
    num_train_timesteps=1000,
    flow_shift=flow_shift
)
# Load the video generation pipeline with the model
pipe = WanPipeline.from_pretrained(model_id, vae=vae, torch_dtype=torch.bfloat16)
pipe.scheduler = scheduler
pipe.to("cuda")
# New prompt
prompt = "A futuristic city at sunset, filled with flying cars and neon lights. The buildings have a sleek, cyberpunk design, and people walk on glowing sidewalks. The scene is full of vibrant colors, reflections, and dynamic movement."
# New negative prompt
negative_prompt = "Dull colors, grainy texture, washed-out details, static frames, incorrect lighting, unnatural shadows, distorted faces, artifacts, low-resolution elements, flickering, blurry motion, repetitive patterns, unrealistic reflections, overly simplistic backgrounds, three legged people, walking backwards."
# Generate the video frames
output = pipe(
     prompt=prompt,
     negative_prompt=negative_prompt,
     height=720,
     width=1280,
     num_frames=81,
     guidance_scale=5.0,
).frames[0]
# Export the generated frames as a video
export_to_video(output, "output.mp4", fps=16)
Skrip dimulai dengan memuat model Wan2.1-T2V-14B-Diffusers, yang digunakan untuk membuat video. Skrip juga memuat VAE (Autoencoder), yang membantu memproses dan meningkatkan frame video. Untuk mengontrol seberapa mulus gerakan dalam video, skrip menggunakan scheduler (UniPCMultistepScheduler). Pengaturan flow_shift menyesuaikan penanganan gerak, dengan 5,0 lebih cocok untuk resolusi lebih tinggi (720P) dan 3,0 untuk resolusi lebih rendah (480P).
Selanjutnya, skrip menyiapkan pipeline pembuatan video (WanPipeline) dan menerapkan scheduler untuk memastikan transisi antarframe lebih mulus. Prompt menggambarkan kota futuristis dengan mobil terbang dan lampu neon menyala, sementara negative prompt membantu menghilangkan efek yang tidak diinginkan, seperti detail buram, warna pudar, dan frame yang berkedip.
Model kemudian membuat 81 frame, yang menghasilkan sekitar 5 detik video pada 16 frame per detik (FPS). guidance_scale diatur ke 5,0, yang membantu model mengikuti prompt sambil tetap memberi ruang kreativitas. Setelah video dibuat, frame digabungkan dan disimpan sebagai "output.mp4" pada 16 FPS.
Negative prompt berperan penting dalam meningkatkan video akhir dengan memberi tahu model apa yang harus dihindari. Ini membantu menyingkirkan hal-hal seperti kualitas gambar buruk, distorsi aneh, atau apa pun yang membuat video terlihat tidak realistis. Dalam kasus ini, negative prompt memastikan adegan futuristis tampak bersih, tajam, dan menarik secara visual.
Jika Anda lebih suka antarmuka web interaktif untuk membuat video alih-alih menggunakan kode, Anda dapat menjalankan Wan 2.1 dengan Gradio:
Untuk ekstensi prompt Dashscope:
DASH_API_KEY=your_key python t2v_14B_singleGPU.py --prompt_extend_method 'dashscope' --ckpt_dir ./Wan2.1-T2V-14BUntuk ekstensi prompt lokal:
python t2v_14B_singleGPU.py --prompt_extend_method 'local_qwen' --ckpt_dir ./Wan2.1-T2V-14BSerupa dengan teks-ke-video, gambar-ke-video juga dibagi menjadi proses dengan dan tanpa langkah ekstensi prompt. Untuk detail implementasi lebih lanjut, Anda dapat mengunjungi GitHub resmi. Anda juga bisa bergabung dengan saluran Discord mereka untuk berdiskusi tentang Wan2.1, berbagi karya Anda, mendapatkan pembaruan fitur dan pengembangan terbaru, serta mengunjungi situs resmi untuk menjelajahi contoh yang dihasilkan.
Wan 2.1 dibangun menggunakan teknik AI canggih untuk menghasilkan video yang realistis dan berkualitas tinggi. Model ini menggunakan pendekatan berbasis difusi dan mengintegrasikan transformer untuk memastikan gerakan yang mulus, konsisten, dan detail di seluruh frame.
Wan 2.1 menggunakan teknik bernama diffusion models, yang bekerja dalam dua langkah:
Ibaratnya seperti memproses foto di kamar gelap—gambar awalnya buram dan berbintik, namun menjadi semakin jelas di setiap langkah pemrosesan.
Wan 2.1 menyempurnakan pendekatan ini dengan menggunakan Diffusion Transformer (DiT), yang membantu menjaga detail tajam dan gerakan mulus saat menghasilkan banyak frame video.
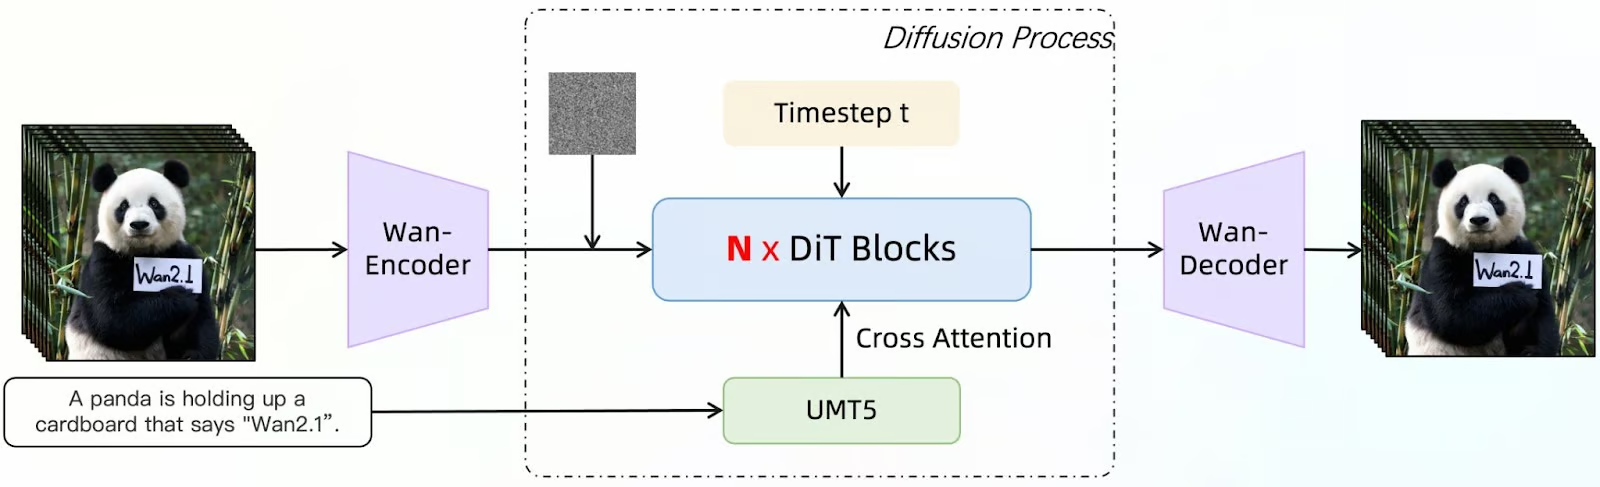
Sumber: GitHub (Wan-Video/Wan2.1)
Diagram ini menunjukkan bagaimana Wan 2.1 menghasilkan frame video menggunakan model difusi yang ditingkatkan dengan Diffusion Transformer (DiT). Proses dimulai dengan deskripsi masukan (misalnya, "A panda is holding up a cardboard that says 'Wan2.1'"). Teks ini diproses oleh UMT5, model bahasa yang membantu sistem memahami dan menyempurnakan prompt.
Secara bersamaan, gambar awal yang bernoise diperkenalkan sebagai titik awal. Wan-Encoder kemudian memproses masukan tersebut, mengenkodenya menjadi bentuk yang dapat dimanipulasi model. N x DiT Blocks menyempurnakan gambar secara iteratif.
Model difusi secara progresif menghilangkan noise dari frame, menggunakan cross-attention untuk menyelaraskan keluaran dengan prompt yang diberikan. Timestep (t) menunjukkan langkah progresif dalam denoising, memastikan video berkembang mulus dari waktu ke waktu.
Setelah beberapa kali penyempurnaan, Wan-Decoder merekonstruksi frame video akhir dari data yang telah diproses. Keluaran berupa rangkaian frame yang selaras dengan deskripsi masukan asli, mempertahankan detail tajam, gerakan mulus, dan konsistensi.
Wan 2.1 menampilkan Wan-VAE, alat kompresi bertenaga yang membantu model untuk:
Ibarat saat Anda mengompresi berkas video: VAE mengompresi dan menyimpan detail kunci, lalu merekonstruksinya secara akurat saat menghasilkan video.
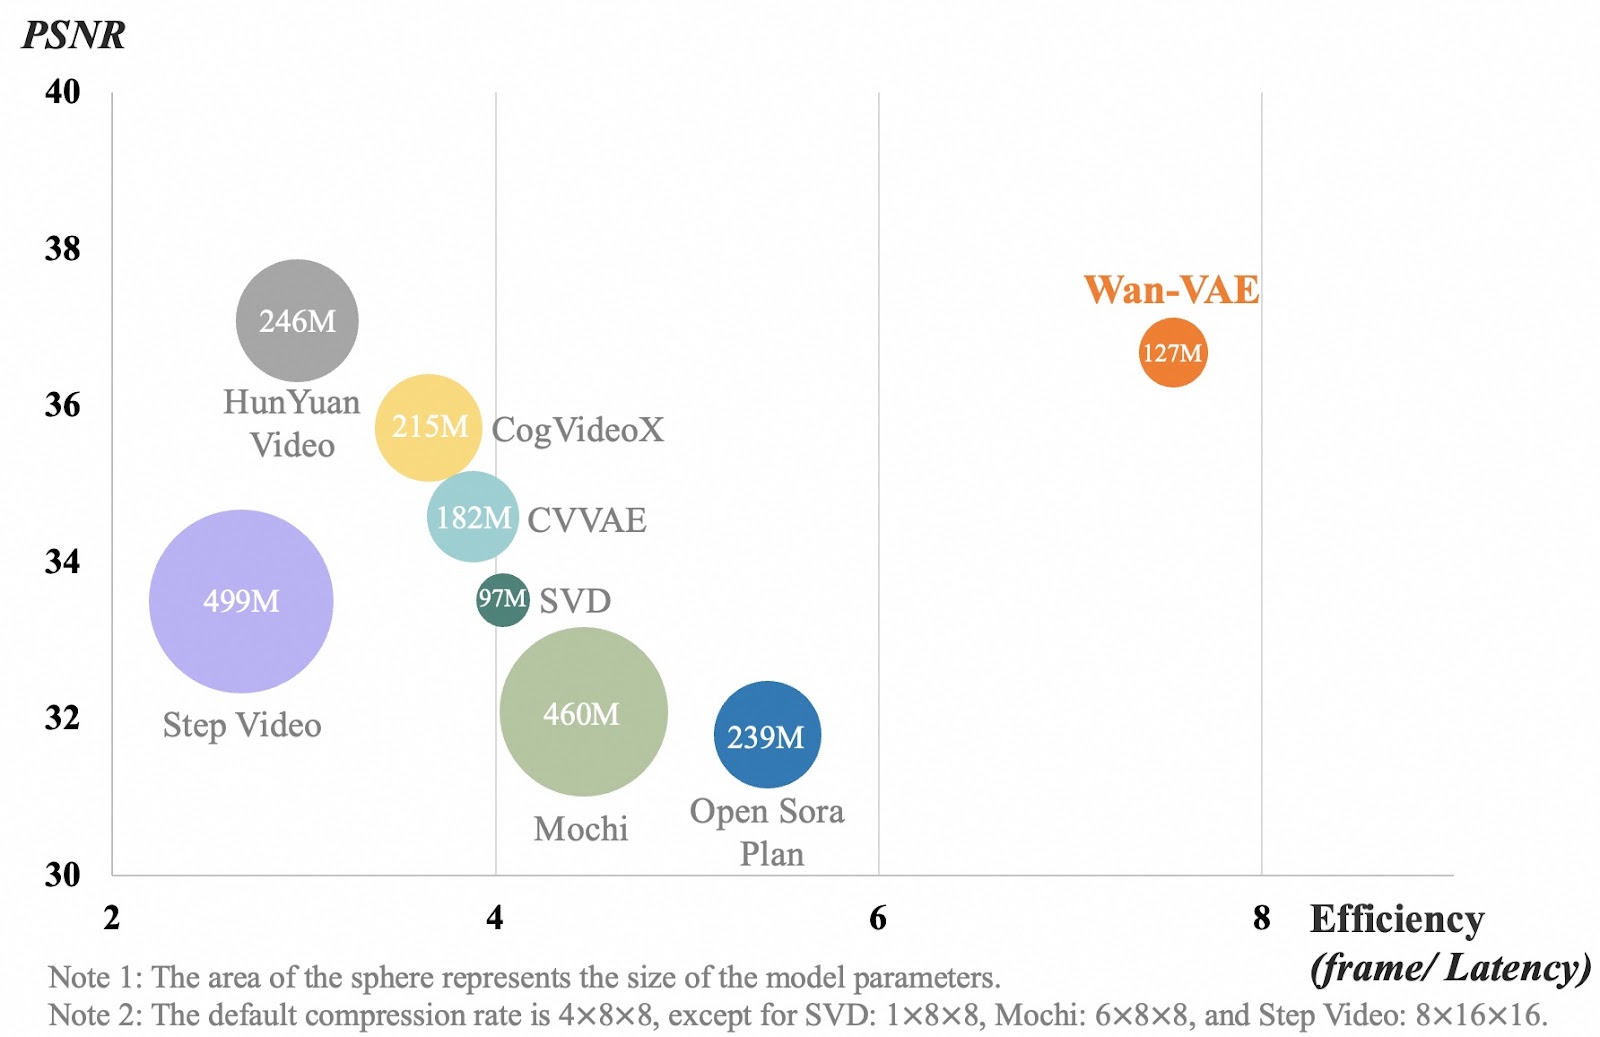
Sumber: GitHub (Wan-Video/Wan2.1)
Bagan ini membandingkan berbagai model kompresi video berdasarkan kualitas video (PSNR) dan efisiensi (seberapa cepat mereka memproses frame). Setiap gelembung mewakili sebuah model, dan ukurannya menunjukkan seberapa besar model tersebut. Sumbu x mengukur efisiensi pemrosesan frame video. Angka lebih tinggi berarti model bekerja lebih cepat. Sumbu y menunjukkan kualitas video, di mana angka lebih tinggi berarti video lebih jelas dan detail.
Wan-VAE, ditampilkan dalam warna oranye, berkinerja lebih baik daripada model lain dengan menyeimbangkan kualitas video tinggi dan pemrosesan cepat sambil tetap relatif kecil (127M parameter). Model lain, seperti Step Video dan Mochi, jauh lebih besar namun tidak memproses frame seefisien itu. Ini berarti Wan-VAE dapat menghasilkan video panjang berkualitas tinggi sambil menjaga detail tetap tajam dan gerakan mulus, tanpa memperlambat.
Wan 2.1 adalah model generasi video AI serbaguna yang dapat digunakan di banyak industri. Pada bagian ini, saya akan mencoba beberapa contoh untuk berbagai kasus penggunaan.
Wan 2.1 dapat membantu Anda membuat konten video unik tanpa peralatan mahal atau jam pengeditan yang panjang. Jadi, bayangkan saya seorang influencer gaya hidup dan ingin membuat konten tentang hari yang hangat dan nyaman dalam hidup saya.Saya akan menggunakan prompt berikut untuk membuat sebuah klip untuk video saya:
Animasi time-lapse sebuah kafe yang hangat dan nyaman dari pagi hingga malam, menampilkan orang-orang yang datang dan pergi, kopi yang diseduh, dan matahari terbenam yang terpantul di jendela.
Karena saya menginginkannya se-realistis mungkin, saya juga menggunakan mode inspirasi. Ini hasil yang saya dapatkan:
Saat video dihasilkan, sekilas saya sangat terkesan. Namun setelah diperhatikan lebih dekat, saya menyadari beberapa hal. Pertama, ada seseorang yang menghilang di latar belakang. Selain itu, ini bukan time-lapse, dan tidak ada kopi yang sedang diseduh. Jadi, meskipun videonya terlihat cukup realistis, hasilnya tidak sepenuhnya mencerminkan prompt.
Sekarang, bayangkan Anda seorang pengembang gim. Anda dapat menggunakan Wan 2.1 untuk membuat cutscene realistis, animasi latar, atau konsep visual untuk proyek Anda. Misalnya, jika Anda sudah memiliki konsep karakter dan tim kreatif telah menyediakan beberapa desain, Anda dapat menghidupkannya menggunakan fitur image-to-video dari Wan.
Selain animasi karakter, Wan 2.1 juga dapat membantu membuat lingkungan dinamis, seperti efek cuaca yang berubah, lanskap kota yang ramai, atau lanskap magis, tanpa perlu menganimasi setiap frame secara manual.
Juga, dengan kontrol rasio aspek, Anda dapat memastikan animasi pas sempurna ke berbagai adegan gim, seperti sinematik layar lebar (16:9), bidikan vertikal yang ramah seluler (9:16), atau komposisi persegi (1:1) untuk teaser media sosial.
Anda bahkan dapat menggunakan fitur efek suara untuk menghasilkan suasana latar, seperti desiran daun, dengung kota futuristis, atau lanskap suara pertempuran.
Mari kita coba sesuatu!Saya membuat rancangan ksatria abad pertengahan ini dengan DALL-E:
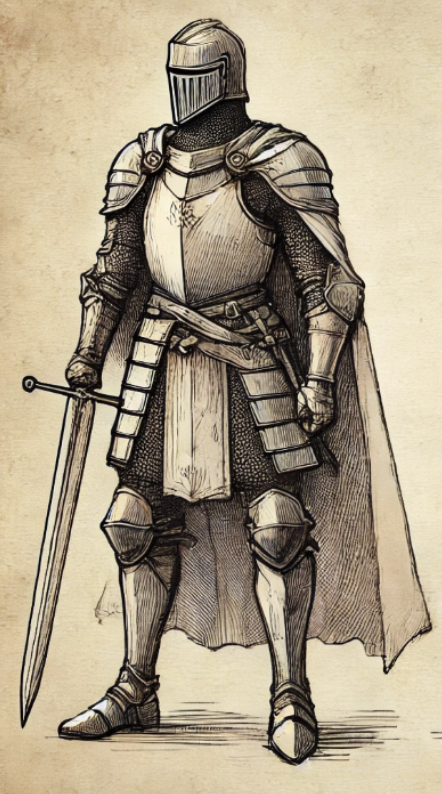
Dengan Wan, saya memasukkan prompt berikut menggunakan GPT-4o-mini:
Seorang ksatria abad pertengahan berdiri dalam pose heroik, memegang erat pedang besar dengan kedua tangan. Jubahnya berkibar ditiup angin saat ia mengamati medan perang. Sang ksatria perlahan menoleh, menyapu cakrawala dengan ekspresi tekad. Animasi bergaya sinematik.Namun kemudian, saya mengeklik Enhanced Prompt, dan ini yang saya dapatkan:
Ksatria Abad Pertengahan Sinematik: Seorang ksatria gagah berdiri teguh, mengenakan zirah pelat penuh, menggenggam pedang broadsword yang garang dengan kedua tangan. Helm berpenutup wajah dan pelindung bahunya berkilau diterpa matahari, sementara lambang bangsawan menghiasi pelat dadanya. Sebuah selempang mengikat pinggangnya, menyatukan keseluruhan busananya. Jubah merahnya berkibar dramatis ditiup angin, menambah kewibawaannya. Dengan tatapan baja, ia memutar kepalanya, menyapu medan perang berpasir yang luas. Adegan tersaji di atas kertas bertekstur mirip perkamen, membangkitkan nuansa manuskrip kuno. Ini adalah bidikan tubuh penuh yang megah, menangkap sang ksatria dalam pose kemenangan, mengingatkan pada sinema epik abad pertengahan.
Saya mematikan Mode Inspirasi namun mengaktifkan Efek Suara. Berikut hasilnya:
Tidak buruk! Meski harus diakui, saya berharap versi yang lebih sinematik dari rancangan tersebut, alih-alih animasi dari rancangan itu sendiri. Namun mungkin saya bisa lebih jelas dalam prompt. Musiknya menarik, dan rasanya cukup pas dengan animasinya!
Jika Anda seorang pemasar, Anda dapat menggunakan Wan 2.1 untuk membuat video promosi bagi merek, produk, dan layanan, atau bahkan untuk menganimasi logo.
Bayangkan Anda memiliki bisnis es krim, dan ingin menganimasi logo untuk ditempatkan di akhir iklan atau video promosi Anda.Untuk menguji ide ini, saya kembali membuat gambar berikut dengan DALL-E:
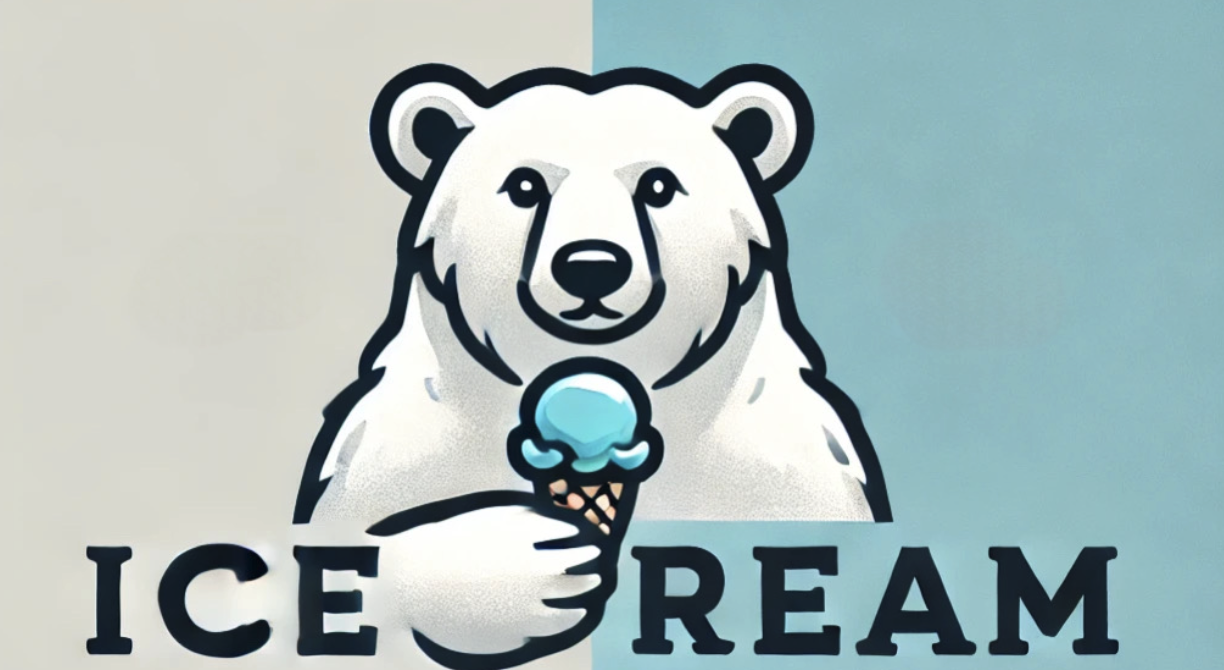
Lalu, saya menggunakan prompt ini: Beruang kutub memakan es krim. Ini hasil generasi image-to-video:
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




