Last chance! 50% off DataCamp Premium
Sale ends in
Sebagai seorang Insinyur Gen AI, saya memprioritaskan untuk tetap mengikuti alat dan teknologi terbaru dengan terus membaca dan mengeksplorasi kemajuan baru. Baru-baru ini, saya menemukan sebuah makalah riset dari peneliti Microsoft yang memperkenalkan BridgeTower, sebuah model yang menyederhanakan integrasi kemampuan visi dan bahasa, sehingga tugas multimodal jauh lebih mudah diimplementasikan.
Dalam panduan ini, saya akan menunjukkan cara membangun sistem penelusuran gambar-teks yang sederhana namun andal menggunakan BridgeTower dari perpustakaan Hugging Face Transformers. Tutorial ini ramah untuk pemula dan akan memandu Anda melalui langkah-langkah berikut:
Di akhir tutorial ini, Anda akan memiliki sistem fungsional penuh yang dapat secara efektif mencocokkan gambar dengan kueri teks, menunjukkan kekuatan dan kesederhanaan AI multimodal.
Model BridgeTower, sebagaimana dijelaskan dalam makalah BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning oleh Xiao Xu dan lainnya, bertujuan untuk meningkatkan cara model visi dan bahasa bekerja bersama.
Bayangkan tugas di mana model perlu memahami sebuah gambar dan deskripsi teks, seperti "anjing berlari di taman."
Biasanya, model akan memproses gambar dan teks secara terpisah menggunakan encoder visi dan bahasa. Model BridgeTower menambahkan sebuah "jembatan" antara encoder-encoder ini dan encoder lintas-modal (yang menggabungkan visi dan bahasa), memungkinkan mereka berinteraksi lebih baik di setiap langkah.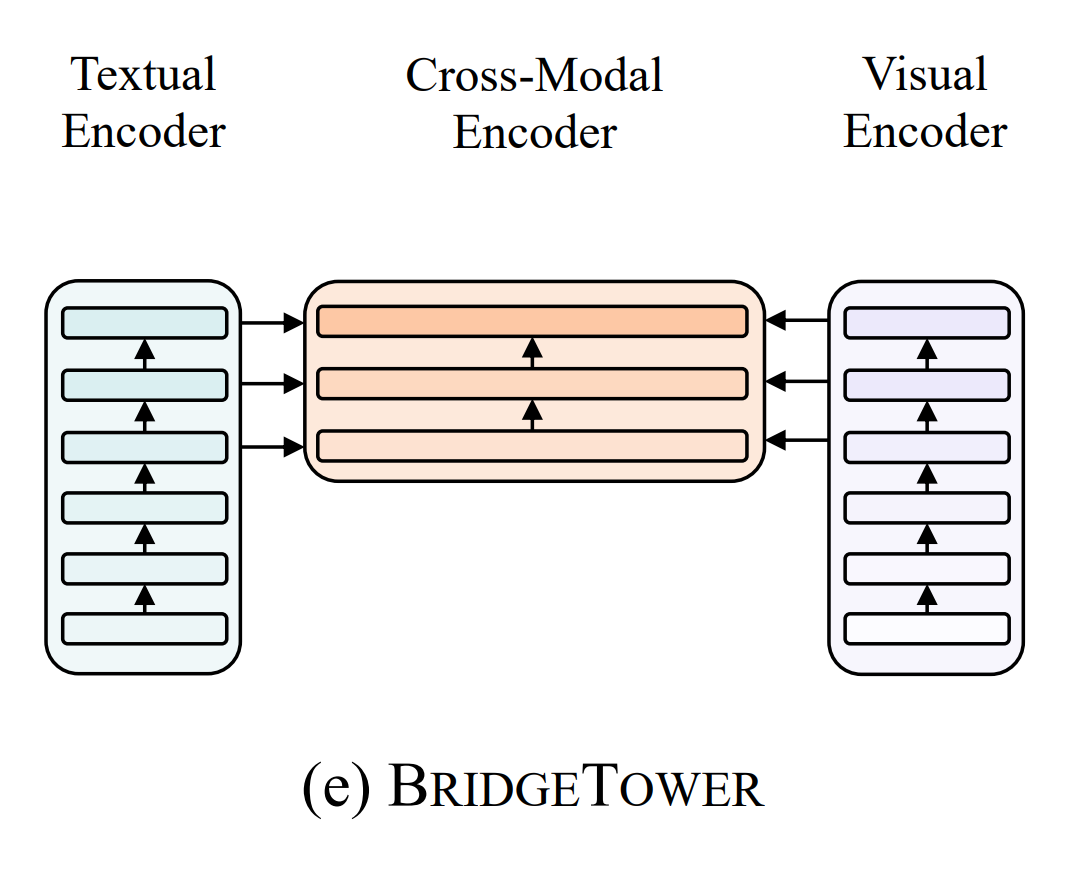
Sebagai contoh, ketika memproses gambar anjing, encoder visi mungkin mendeteksi bentuk dan gerakan anjing. Sementara itu, encoder bahasa memahami teks "berlari" dan "anjing."
Jembatan ini memungkinkan kedua potongan informasi tersebut berinteraksi secara detail, membantu model menghubungkan petunjuk visual dan tekstual dengan lebih efektif. Dengan cara ini, model berkinerja lebih baik pada tugas seperti pembuatan keterangan gambar atau tanya jawab, tanpa memerlukan banyak komputasi tambahan atau memperlambat proses.
Kita akan menjaga semuanya tetap rapi dan terorganisasi. Direktori proyek Anda sebaiknya seperti ini:
/image-search-app/
│
├── app.py          # Frontend (Streamlit UI)
├── search.py       # Backend logic (embeddings & similarity search)
├── images/         # Directory for uploaded images
│   ├── image1.jpg
│   ├── image2.png
│   ├── image3.jpeg
│
└── requirements.txt # Python dependenciesSebelum masuk ke kode, mari siapkan lingkungan agar proses pengembangan dan pengujian berjalan lancar. Ikuti langkah-langkah berikut:
Pertama, pastikan Anda telah menginstal Python (disarankan versi 3.7 atau lebih tinggi). Lalu, jalankan perintah berikut di terminal untuk memasang pustaka yang diperlukan:
pip install torch transformers streamlit PillowUntuk menguji aplikasi, tempatkan beberapa gambar contoh di direktori /images. Pastikan gambar-gambar tersebut dalam format yang didukung seperti JPG, PNG, atau JPEG, karena format ini diakui secara universal dan kompatibel dengan sebagian besar pustaka.
Gunakan beragam gambar untuk memastikan model dapat mengambil kecocokan dengan akurat berdasarkan kueri teks.
Fungsionalitas inti aplikasi dibagi menjadi dua komponen utama: Backend (search.py) dan Frontend (app.py). Masing-masing memainkan peran penting agar aplikasi berjalan mulus.
Berkas ini berisi logika embedding teks dan gambar serta mekanisme pencarian.
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch.nn.functional as F
import osprocessor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)Ini menginisialisasi model dan prosesor yang diperlukan untuk embedding.
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
   return best_match
Cara kerjanya:
Berkas ini menggunakan Streamlit untuk menyediakan antarmuka yang ramah pengguna.
import streamlit as st
from search import search_best_match
import osst.title("🖼️ AI-Powered Image Search App")
uploaded_files = st.file_uploader("Upload images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)Pengguna dapat mengunggah beberapa gambar. Gambar disimpan di folder images/ dan ditampilkan.
query = st.text_input("Enter your search query:")

if query and uploaded_files:
    best_match, score = search_best_match(image_folder, query)
    st.write("### Most Relevant Image:")
    st.image(best_match, caption=f"Score: {score:.4f}", use_column_width=True)
Pengguna memasukkan kueri pencarian. Aplikasi mencari gambar yang paling cocok dan menampilkannya.
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch
import torch.nn.functional as F
import os

# Load Bridgetower processor and model
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")

# Search for the best matching image
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
return best_matchimport streamlit as st
from search import image_search
import os
# Title of the app
st.title("🖼️ Image Search Application with BridgeTower")
# Image upload section
uploaded_files = st.file_uploader("Upload your images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
# Create image folder if not exists
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)
# Text input for query
query = st.text_input("Enter your search query:")
# Display search results
if query and uploaded_files:
best_match, score = image_search(image_folder, query)
st.write("### Most Relevant Image:")
st.image(best_match, caption=f"Similarity Score: {score:.4f}", use_column_width=True)streamlit run app.pyBerikut contoh aplikasi saat berjalan! Sebuah gambar diunggah, dan pengguna mengetik kueri pencarian “cat.” Aplikasi dengan cepat menganalisis gambar dan teks, lalu mencocokkannya menggunakan model BridgeTower.
Aplikasi menemukan kecocokan terbaik dan menampilkan gambar kucing yang benar. Ini menunjukkan seberapa baik aplikasi mengaitkan gambar dan teks untuk memberikan hasil yang akurat.
Rasa ingin tahu tidak perlu berhenti sampai di sini. Potensi aplikasi seperti ini melampaui apa yang saat ini diterapkan, membuka peluang menarik untuk pertumbuhan dan inovasi. Kemungkinan untuk meningkatkan pengalaman pengguna, kinerja, dan fungsionalitas sangat luas. Di bawah ini, saya mengusulkan beberapa peningkatan yang dapat membawa aplikasi seperti ini ke level berikutnya.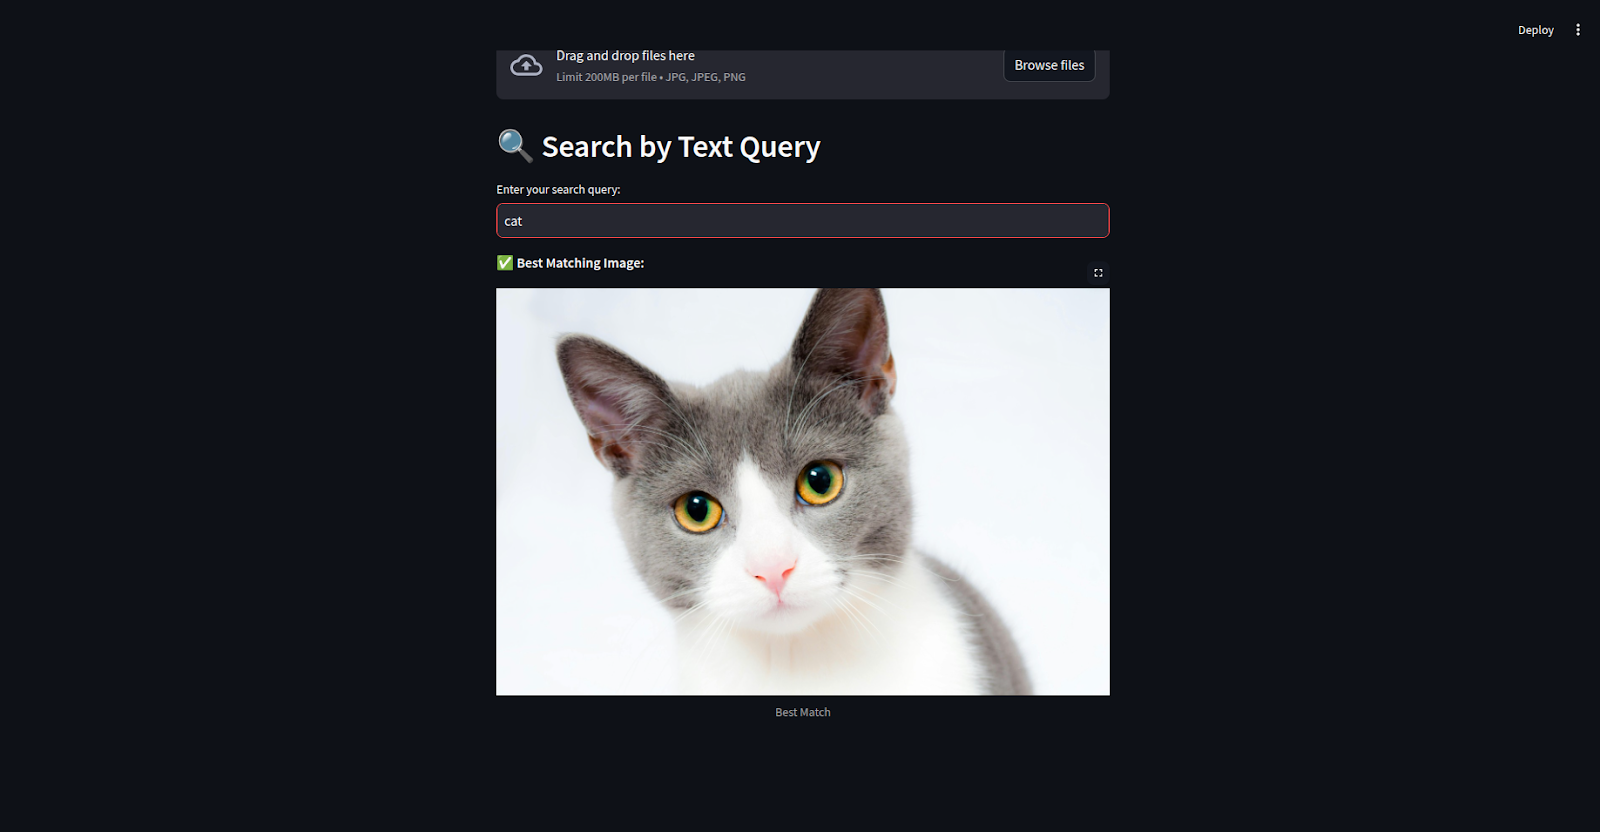
Ada beberapa cara untuk meningkatkan aplikasi yang kita buat, misalnya:
Terapkan pengindeksan FAISS untuk meningkatkan kecepatan pencarian gambar pada dataset besar. Ini memungkinkan Anda mengonversi gambar menjadi vektor fitur, membangun indeks, dan melakukan pencarian kemiripan dengan cepat, memastikan pengambilan gambar tetap efisien seiring pertumbuhan dataset.
Deploy aplikasi di Streamlit Cloud untuk penyiapan yang cepat dan mudah, terutama jika Anda bekerja dengan Python dan Streamlit. Atau, deploy di AWS untuk kontrol yang lebih besar, skalabilitas, dan kemampuan menangani lalu lintas yang lebih tinggi, memastikan performa lebih baik seiring pengembangan aplikasi.
Siapkan pembaruan secara real-time sehingga ketika gambar baru diunggah, gambar tersebut langsung muncul untuk semua pengguna tanpa perlu memuat ulang halaman. Dengan teknologi seperti WebSockets atau Socket.IO, Anda dapat mendorong pembaruan ke semua pengguna yang terhubung segera setelah gambar diunggah, meningkatkan interaktivitas dan pengalaman aplikasi.
Kita telah berhasil membangun aplikasi pencarian gambar bertenaga AI menggunakan Bridgetower, Streamlit, dan PyTorch, menunjukkan bagaimana AI dapat menyederhanakan dan meningkatkan interaksi dengan konten digital.
Meskipun sudah berfungsi penuh, masih ada ruang untuk perbaikan, seperti mengoptimalkan kecepatan pencarian dengan pengindeksan FAISS, melakukan deploy di platform seperti AWS untuk skalabilitas, dan menambahkan pembaruan real-time untuk pengalaman pengguna yang lebih mulus. Proyek ini merupakan fondasi kuat untuk inovasi lebih lanjut dalam sistem pencarian cerdas.
Jika Anda ingin mempelajari lebih lanjut, saya dapat merekomendasikan sumber berikut:
Kursus Teratas di DataCamp
Program
Program
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt