Programa
Desenvolvimento de aplicativos de IA
21 h
Como engenheiro de Gen AI, faço questão de me manter atualizado com as ferramentas e tecnologias mais recentes, lendo e explorando continuamente novas inovações. Recentemente, me deparei com um artigo de pesquisa de pesquisadores da Microsoft apresentando o BridgeTower, um modelo que simplifica a integração de capacidades de visão e linguagem, facilitando muito a implementação de tarefas multimodais.
Neste guia, vou mostrar como criar um sistema simples, mas poderoso, de recuperação imagem-texto usando o BridgeTower da biblioteca Hugging Face Transformers. Este tutorial é amigável para iniciantes e vai conduzir você pelos seguintes passos:
Ao final deste tutorial, você terá um sistema totalmente funcional que consegue associar imagens a consultas em texto com eficiência, demonstrando o poder e a simplicidade da IA multimodal.
O modelo BridgeTower, conforme explicado no artigo BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning de Xiao Xu e outros autores, busca melhorar como os modelos de visão e linguagem trabalham juntos.
Imagine uma tarefa em que o modelo precisa entender uma imagem e uma descrição em texto, como "um cachorro correndo no parque".
Normalmente, o modelo processaria a imagem e o texto separadamente usando codificadores de visão e de linguagem. O BridgeTower adiciona uma "ponte" entre esses codificadores e o codificador cruzado (que combina visão e linguagem), permitindo que eles interajam melhor a cada etapa.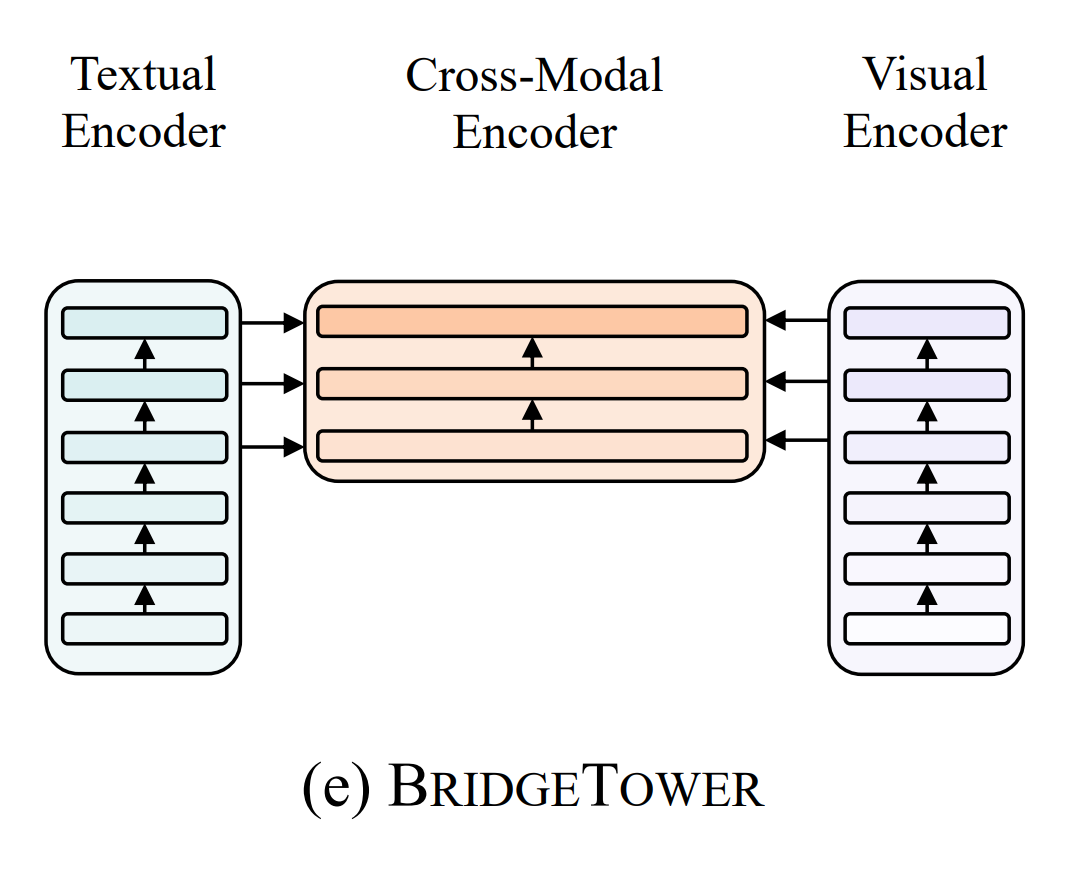
Por exemplo, ao processar a foto do cachorro, o codificador de visão pode detectar o formato e o movimento do animal. Ao mesmo tempo, o codificador de linguagem entende palavras como "correndo" e "cachorro".
A ponte permite que essas informações interajam em detalhes, ajudando o modelo a conectar melhor os indícios visuais e textuais. Assim, o desempenho melhora em tarefas como geração de legendas para imagens ou perguntas e respostas, sem exigir muita computação adicional nem tornar o processo mais lento.
Vamos manter tudo limpo e organizado. Seu diretório do projeto deve ficar assim:
/image-search-app/
│
├── app.py          # Frontend (Streamlit UI)
├── search.py       # Backend logic (embeddings & similarity search)
├── images/         # Directory for uploaded images
│   ├── image1.jpg
│   ├── image2.png
│   ├── image3.jpeg
│
└── requirements.txt # Python dependenciesAntes de mergulhar no código, vamos preparar o ambiente para garantir um processo de desenvolvimento e testes sem atritos. Siga estes passos:
Primeiro, certifique-se de ter o Python instalado (recomendado a versão 3.7 ou superior). Em seguida, rode o comando abaixo no terminal para instalar as bibliotecas necessárias:
pip install torch transformers streamlit PillowPara testar o aplicativo, coloque algumas imagens de exemplo no diretório /images. Certifique-se de que estejam em formatos compatíveis, como JPG, PNG ou JPEG, já que são amplamente reconhecidos e compatíveis com a maioria das bibliotecas.
Use uma variedade de imagens para garantir que o modelo consiga recuperar correspondências com precisão a partir da consulta em texto.
A funcionalidade principal do aplicativo está dividida em dois componentes: o backend (search.py) e o frontend (app.py). Cada um tem um papel essencial para que tudo funcione sem fricção.
Este arquivo contém a lógica de embeddings de texto e imagem e o mecanismo de busca.
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch.nn.functional as F
import osprocessor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)Isso inicializa o modelo e o processor necessários para gerar embeddings.
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
   return best_match
Como funciona:
Este arquivo usa o Streamlit para fornecer uma interface amigável.
import streamlit as st
from search import search_best_match
import osst.title("🖼️ AI-Powered Image Search App")
uploaded_files = st.file_uploader("Upload images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)Os usuários podem enviar várias imagens. As imagens são salvas na pasta images/ e exibidas.
query = st.text_input("Enter your search query:")

if query and uploaded_files:
    best_match, score = search_best_match(image_folder, query)
    st.write("### Most Relevant Image:")
    st.image(best_match, caption=f"Score: {score:.4f}", use_column_width=True)
Os usuários digitam a consulta de busca. O app encontra a imagem mais relevante e a exibe.
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch
import torch.nn.functional as F
import os

# Load Bridgetower processor and model
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")

# Search for the best matching image
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
return best_matchimport streamlit as st
from search import image_search
import os
# Title of the app
st.title("🖼️ Image Search Application with BridgeTower")
# Image upload section
uploaded_files = st.file_uploader("Upload your images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
# Create image folder if not exists
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)
# Text input for query
query = st.text_input("Enter your search query:")
# Display search results
if query and uploaded_files:
best_match, score = image_search(image_folder, query)
st.write("### Most Relevant Image:")
st.image(best_match, caption=f"Similarity Score: {score:.4f}", use_column_width=True)streamlit run app.pyAqui vai um exemplo do app em ação! Uma imagem foi enviada e o usuário digitou a consulta de busca “cat”. O app analisou rapidamente a imagem e o texto e os relacionou usando o modelo BridgeTower.
Ele encontrou a melhor correspondência e exibiu a imagem correta de um gato. Isso mostra como o app conecta imagens e texto para entregar resultados precisos.
A curiosidade não deve parar por aqui. O potencial de aplicativos como este vai muito além do que está implementado hoje, abrindo oportunidades empolgantes de crescimento e inovação. As possibilidades de aprimorar a experiência do usuário, o desempenho e as funcionalidades são enormes. Abaixo, proponho alguns incrementos que podem levar soluções como esta a outro nível.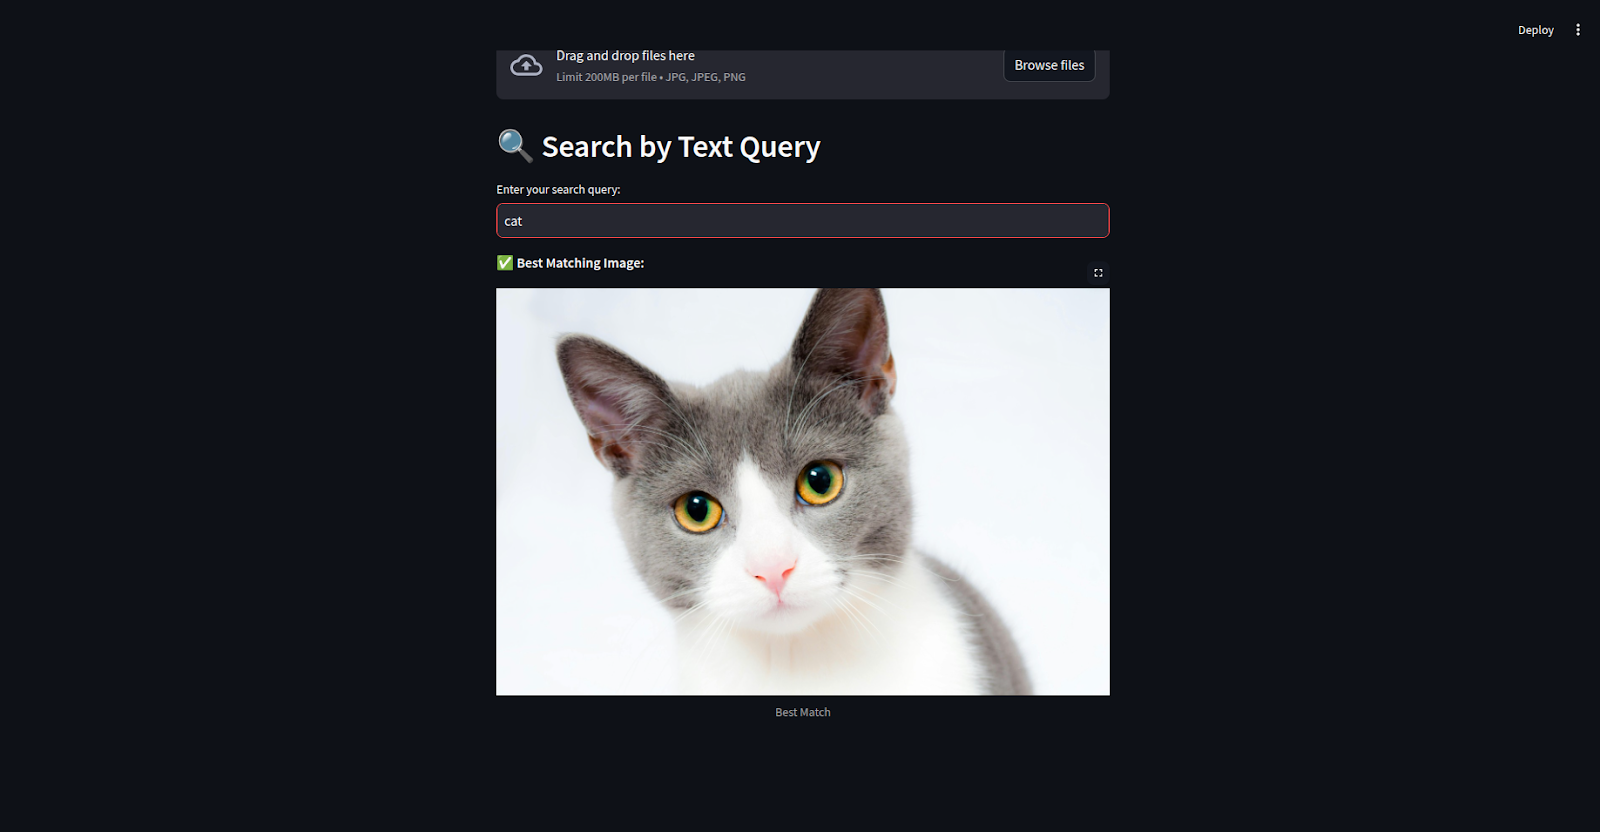
Há várias formas de melhorar o app que criamos, por exemplo:
Implemente indexação com FAISS para acelerar a busca de imagens em grandes conjuntos de dados. Assim, você converte imagens em vetores de características, constrói um índice e executa buscas por similaridade rapidamente, mantendo a eficiência mesmo com o crescimento do dataset.
Faça o deploy no Streamlit Cloud para uma configuração rápida e simples, especialmente se você trabalha com Python e Streamlit. Alternativamente, use a AWS para ter mais controle, escalabilidade e capacidade de lidar com mais tráfego, garantindo melhor performance conforme o app cresce.
Configure atualizações em tempo real para que, quando novas imagens forem enviadas, elas apareçam instantaneamente para todos os usuários, sem precisar recarregar a página. Usando tecnologias como WebSockets ou Socket.IO, você pode enviar atualizações a todos os usuários conectados assim que uma imagem é adicionada, elevando a interatividade e a experiência do app.
Construímos com sucesso um aplicativo de busca por imagens com IA usando BridgeTower, Streamlit e PyTorch, mostrando como a IA pode simplificar e melhorar a interação com conteúdo digital.
Embora totalmente funcional, ainda há espaço para evoluir: otimizar a velocidade de busca com FAISS, fazer deploy em plataformas como AWS para escalar e adicionar atualizações em tempo real para uma experiência mais fluida. Este projeto é uma base sólida para inovar ainda mais em sistemas inteligentes de busca.
Se você quiser se aprofundar, recomendo estes recursos:
Principais cursos da DataCamp
Programa
Programa
Curso
blog
Dr Ana Rojo-Echeburúa
9 min
blog
DataCamp Team
4 min
Tutorial
Moez Ali
12 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Nadia mhadhbi
15 min
Tutorial
Kurtis Pykes
12 min