Crea un’app di ricerca immagini con IA usando BridgeTower e Streamlit
Scopri come creare un’app di ricerca immagini basata sull’IA usando BridgeTower, Streamlit e Hugging Face Transformers. Tutorial passo passo sull’IA multimodale.
Come Gen AI Engineer, do la priorità a restare aggiornato sugli ultimi strumenti e tecnologie leggendo e esplorando continuamente le novità. Di recente, mi sono imbattuto in un paper di ricerca di Microsoft che presenta BridgeTower, un modello che semplifica l’integrazione tra capacità visive e linguistiche, rendendo molto più facile implementare compiti multimodali.
In questa guida, ti mostrerò come costruire un semplice ma potente sistema di retrieval immagine-testo usando BridgeTower dalla libreria Hugging Face Transformers. Questo tutorial è pensato per chi parte da zero e ti guiderà attraverso i seguenti passaggi:
Configurazione delle librerie necessarie.
Elaborazione di immagini e testo con BridgeTower.
Generazione di embedding per immagini e testo.
Confronto di questi embedding tramite similarità coseno.
Alla fine del tutorial, avrai un sistema perfettamente funzionante in grado di mettere in corrispondenza immagini e query testuali, dimostrando la potenza e la semplicità dell’IA multimodale.
Immagina un compito in cui il modello deve capire sia un’immagine sia una descrizione testuale, ad esempio "un cane che corre in un parco".
In genere, il modello elaborerebbe separatamente immagine e testo usando encoder di visione e di linguaggio. BridgeTower aggiunge un "ponte" tra questi encoder e l’encoder cross-modale (che combina visione e linguaggio), consentendo loro di interagire meglio a ogni passaggio.
Per esempio, mentre elabora l’immagine del cane, l’encoder di visione potrebbe rilevarne forma e movimento. Nel frattempo, l’encoder di linguaggio comprende le parole "corre" e "cane".
Il ponte consente a queste due informazioni di interagire in dettaglio, aiutando il modello a collegare in modo più efficace indizi visivi e testuali. Così, il modello rende meglio in compiti come image captioning o question answering, senza richiedere molta computazione extra o rallentamenti.
Struttura delle cartelle dell’app
Manteniamo tutto pulito e organizzato. La directory del progetto dovrebbe essere così:
app.py: Gestisce il frontend e le interazioni con l’utente.
search.py: Contiene la logica per generare gli embedding ed eseguire le ricerche.
images/: Archivia i file immagine caricati.
requirements.txt: Elenca le librerie richieste.
Setup e installazione
Prima di entrare nel codice, configuriamo l’ambiente per garantire uno sviluppo e un testing senza intoppi. Segui questi passaggi:
1. Installa le dipendenze
Per prima cosa assicurati di avere Python installato (consigliata la versione 3.7 o superiore). Poi esegui il seguente comando nel terminale per installare le librerie necessarie:
pip install torch transformers streamlit PillowOfferto da
torch: Il framework di deep learning usato per costruire ed eseguire il modello Bridgetower.
transformers: Fornisce modelli pre-addestrati come Bridgetower per un’elaborazione efficiente di testo e immagini.
streamlit: Un framework web leggero per creare un’interfaccia utente interattiva per l’applicazione.
Pillow: Una libreria per l’elaborazione di immagini, usata per gestire upload e ridimensionamento.
2. Prepara immagini di esempio
Per testare l’applicazione, inserisci alcune immagini di esempio nella directory /images. Assicurati che siano in formati supportati come JPG, PNG o JPEG, poiché sono universalmente riconosciuti e compatibili con la maggior parte delle librerie.
Usa immagini varie per assicurarti che il modello riesca a recuperare con precisione le corrispondenze in base alla query testuale.
Logica di base di BridgeTower spiegata
La funzionalità principale dell’applicazione è suddivisa in due componenti: il Backend (search.py) e il Frontend (app.py). Ogni componente gioca un ruolo cruciale per garantire che l’app funzioni senza intoppi.
Logica backend (search.py)
Questo file contiene la logica per gli embedding di testo e immagini e il meccanismo di ricerca.
1. Importa le librerie
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch.nn.functional as F
import osOfferto da
BridgeTowerProcessor: Una classe di utilità che prepara i dati (immagini e testo) nel formato corretto per il modello BridgeTower. Esegue operazioni come la tokenizzazione per il testo e il preprocessing per le immagini.
BridgeTowerForImageAndTextRetrieval: Una classe di modello BridgeTower pre-addestrato progettata specificamente per compiti di retrieval immagine-testo, in cui cerchi l’immagine più rilevante in base a una query testuale o viceversa.
PIL (Python Imaging Library) è usata per la gestione delle immagini. In questo caso, serve per aprire e manipolare le immagini (ad es. ridimensionamento, ritaglio) prima di passarle al modello.
torch.nn.functional fornisce una gamma di funzioni, come funzioni di attivazione (ReLU, softmax), funzioni di loss (cross-entropy, ecc.) e altre operazioni sui tensori. È spesso usato quando si lavora con reti neurali in PyTorch.
os è usato per interagire con il sistema operativo. Può essere utile per leggere file, controllare directory e gestire i percorsi (ad es. per individuare immagini o pesi del modello).
2. Carica il modello e il processor
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
device = torch.device("cuda"if torch.cuda.is_available()else"cpu")
model.to(device)Offerto da
Questo inizializza il modello e il processor necessari per gli embedding.
Gli utenti possono caricare più immagini. Le immagini vengono salvate nella cartella images/ e visualizzate.
3. Aggiungi la query di ricerca
query = st.text_input("Enter your search query:")if query and uploaded_files:
best_match, score = search_best_match(image_folder, query)
st.write("### Most Relevant Image:")
st.image(best_match, caption=f"Score: {score:.4f}", use_column_width=True)Offerto da
L’utente inserisce una query di ricerca. L’app cerca l’immagine con la corrispondenza migliore e la mostra.
Implementazione completa: crea un’app di ricerca immagini con BridgeTower e Streamlit
1. search.py - Logica backend
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch
import torch.nn.functional as F
import os
# Load Bridgetower processor and model
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")# Search for the best matching imagedefimage_search(query, image_dir):
image_files =[os.path.join(image_dir, img)for img in os.listdir(image_dir)if img.lower().endswith(('jpg','jpeg','png'))]
scores ={}for img_path in image_files:
image = Image.open(img_path).convert("RGB")
encoding = processor(text=query, images=image, return_tensors="pt").to(device)
outputs = model(**encoding)
scores[img_path]= outputs.logits[0,1].item()
best_match =max(scores, key=scores.get)return best_matchOfferto da
2. app.py - Interfaccia Streamlit
import streamlit as st
from search import image_search
import os
# Title of the app
st.title("🖼️ Image Search Application with BridgeTower")# Image upload section
uploaded_files = st.file_uploader("Upload your images", accept_multiple_files=True,type=['jpg','jpeg','png'])# Create image folder if not exists
image_folder ='images'
os.makedirs(image_folder, exist_ok=True)if uploaded_files:for uploaded_file in uploaded_files:withopen(os.path.join(image_folder, uploaded_file.name),'wb')as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)# Text input for query
query = st.text_input("Enter your search query:")# Display search resultsif query and uploaded_files:
best_match, score = image_search(image_folder, query)
st.write("### Most Relevant Image:")
st.image(best_match, caption=f"Similarity Score: {score:.4f}", use_column_width=True)Offerto da
Ecco un esempio dell’app in azione! È stata caricata un’immagine e l’utente ha digitato la query di ricerca “cat”. L’app ha analizzato rapidamente immagine e testo, quindi li ha messi in corrispondenza usando il modello BridgeTower.
Ha trovato la corrispondenza migliore e ha mostrato l’immagine corretta di un gatto. Questo mostra quanto bene l’app colleghi immagini e testo per fornire risultati accurati.
La curiosità non dovrebbe fermarsi qui. Il potenziale di applicazioni come questa va ben oltre quanto implementato ora, aprendo opportunità entusiasmanti di crescita e innovazione. Le possibilità di migliorare esperienza d’uso, prestazioni e funzionalità sono enormi. Di seguito propongo alcuni miglioramenti che possono portare applicazioni di questo tipo al livello successivo.
Miglioramenti futuri per BridgeTower
Ci sono diversi modi per migliorare l’app che abbiamo creato, ad esempio:
Aggiungi l’indicizzazione FAISS per ricerche più veloci
Implementa l’indicizzazione FAISS per aumentare la velocità delle ricerche d’immagini su dataset di grandi dimensioni. Questo ti permetterà di convertire le immagini in vettori di caratteristiche, costruire un indice ed eseguire ricerche per similarità rapidamente, mantenendo efficiente il retrieval anche quando il dataset cresce.
Distribuisci l’app su Streamlit Cloud o AWS
Distribuisci l’app su Streamlit Cloud per un setup rapido e semplice, soprattutto se lavori con Python e Streamlit. In alternativa, distribuiscila su AWS per maggiore controllo, scalabilità e capacità di gestire traffico più elevato, garantendo prestazioni migliori man mano che l’app si espande.
Implementa aggiornamenti in tempo reale per gli upload
Imposta aggiornamenti in tempo reale in modo che, quando vengono caricate nuove immagini, compaiano subito per tutti gli utenti senza ricaricare la pagina. Usando tecnologie come WebSocket o Socket.IO, puoi inviare aggiornamenti a tutti gli utenti connessi non appena un’immagine viene caricata, migliorando interattività ed esperienza d’uso dell’app.
Conclusione
Abbiamo creato con successo un’app di ricerca immagini basata sull’IA usando Bridgetower, Streamlit e PyTorch, mostrando come l’IA possa semplificare e migliorare l’interazione con i contenuti digitali.
Pur essendo pienamente funzionante, ci sono margini di miglioramento, come ottimizzare la velocità di ricerca con l’indicizzazione FAISS, distribuire su piattaforme come AWS per la scalabilità e aggiungere aggiornamenti in tempo reale per un’esperienza più fluida. Questo progetto è una base solida per ulteriori innovazioni nei sistemi di ricerca intelligenti.
Se vuoi approfondire, ti consiglio queste risorse:
Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Impara a creare applicazioni basate sull'intelligenza artificiale con i più recenti strumenti per sviluppatori di AI, tra cui OpenAI API, Hugging Face e LangChain.
Scopri i modelli di IA open source, i dataset e le app più recenti, crea agenti di IA e metti a punto gli LLM con Hugging Face. Entra oggi nella più grande community di IA!



 Abid Ali Awan• 10 min


 Tim Lu• 12 min
Come Gen AI Engineer, do la priorità a restare aggiornato sugli ultimi strumenti e tecnologie leggendo e esplorando continuamente le novità. Di recente, mi sono imbattuto in un paper di ricerca di Microsoft che presenta BridgeTower, un modello che semplifica l’integrazione tra capacità visive e linguistiche, rendendo molto più facile implementare compiti multimodali.
In questa guida, ti mostrerò come costruire un semplice ma potente sistema di retrieval immagine-testo usando BridgeTower dalla libreria Hugging Face Transformers. Questo tutorial è pensato per chi parte da zero e ti guiderà attraverso i seguenti passaggi:
Alla fine del tutorial, avrai un sistema perfettamente funzionante in grado di mettere in corrispondenza immagini e query testuali, dimostrando la potenza e la semplicità dell’IA multimodale.
Che cos’è BridgeTower?
Il modello BridgeTower, come spiegato nel paper BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning di Xiao Xu e altri, mira a migliorare la collaborazione tra modelli di visione e linguaggio.
Immagina un compito in cui il modello deve capire sia un’immagine sia una descrizione testuale, ad esempio "un cane che corre in un parco".
In genere, il modello elaborerebbe separatamente immagine e testo usando encoder di visione e di linguaggio. BridgeTower aggiunge un "ponte" tra questi encoder e l’encoder cross-modale (che combina visione e linguaggio), consentendo loro di interagire meglio a ogni passaggio.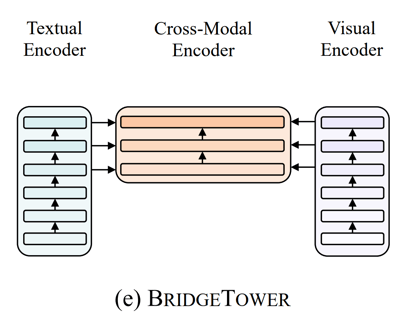
Fonte
Per esempio, mentre elabora l’immagine del cane, l’encoder di visione potrebbe rilevarne forma e movimento. Nel frattempo, l’encoder di linguaggio comprende le parole "corre" e "cane".
Il ponte consente a queste due informazioni di interagire in dettaglio, aiutando il modello a collegare in modo più efficace indizi visivi e testuali. Così, il modello rende meglio in compiti come image captioning o question answering, senza richiedere molta computazione extra o rallentamenti.
Struttura delle cartelle dell’app
Manteniamo tutto pulito e organizzato. La directory del progetto dovrebbe essere così:
Setup e installazione
Prima di entrare nel codice, configuriamo l’ambiente per garantire uno sviluppo e un testing senza intoppi. Segui questi passaggi:
1. Installa le dipendenze
Per prima cosa assicurati di avere Python installato (consigliata la versione 3.7 o superiore). Poi esegui il seguente comando nel terminale per installare le librerie necessarie:
2. Prepara immagini di esempio
Per testare l’applicazione, inserisci alcune immagini di esempio nella directory /images. Assicurati che siano in formati supportati come JPG, PNG o JPEG, poiché sono universalmente riconosciuti e compatibili con la maggior parte delle librerie.
Usa immagini varie per assicurarti che il modello riesca a recuperare con precisione le corrispondenze in base alla query testuale.
Logica di base di BridgeTower spiegata
La funzionalità principale dell’applicazione è suddivisa in due componenti: il Backend (search.py) e il Frontend (app.py). Ogni componente gioca un ruolo cruciale per garantire che l’app funzioni senza intoppi.
Logica backend (search.py)
Questo file contiene la logica per gli embedding di testo e immagini e il meccanismo di ricerca.
1. Importa le librerie
2. Carica il modello e il processor
Questo inizializza il modello e il processor necessari per gli embedding.
3. Trova la corrispondenza migliore
Come funziona:
Interfaccia frontend (app.py)
Questo file usa Streamlit per fornire un’interfaccia facile da usare.
1. Importa le librerie
2. Crea l’interfaccia
Gli utenti possono caricare più immagini. Le immagini vengono salvate nella cartella images/ e visualizzate.
3. Aggiungi la query di ricerca
L’utente inserisce una query di ricerca. L’app cerca l’immagine con la corrispondenza migliore e la mostra.
Implementazione completa: crea un’app di ricerca immagini con BridgeTower e Streamlit
1. search.py - Logica backend
2. app.py - Interfaccia Streamlit
3. Esegui l’applicazione
Esempio di app con BridgeTower e Streamlit
Ecco un esempio dell’app in azione! È stata caricata un’immagine e l’utente ha digitato la query di ricerca “cat”. L’app ha analizzato rapidamente immagine e testo, quindi li ha messi in corrispondenza usando il modello BridgeTower.
Ha trovato la corrispondenza migliore e ha mostrato l’immagine corretta di un gatto. Questo mostra quanto bene l’app colleghi immagini e testo per fornire risultati accurati.
La curiosità non dovrebbe fermarsi qui. Il potenziale di applicazioni come questa va ben oltre quanto implementato ora, aprendo opportunità entusiasmanti di crescita e innovazione. Le possibilità di migliorare esperienza d’uso, prestazioni e funzionalità sono enormi. Di seguito propongo alcuni miglioramenti che possono portare applicazioni di questo tipo al livello successivo.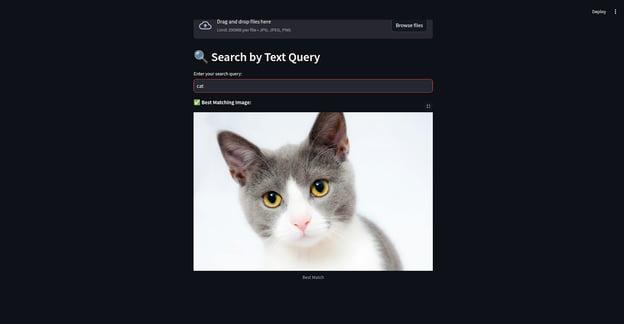
Miglioramenti futuri per BridgeTower
Ci sono diversi modi per migliorare l’app che abbiamo creato, ad esempio:
Aggiungi l’indicizzazione FAISS per ricerche più veloci
Implementa l’indicizzazione FAISS per aumentare la velocità delle ricerche d’immagini su dataset di grandi dimensioni. Questo ti permetterà di convertire le immagini in vettori di caratteristiche, costruire un indice ed eseguire ricerche per similarità rapidamente, mantenendo efficiente il retrieval anche quando il dataset cresce.
Distribuisci l’app su Streamlit Cloud o AWS
Distribuisci l’app su Streamlit Cloud per un setup rapido e semplice, soprattutto se lavori con Python e Streamlit. In alternativa, distribuiscila su AWS per maggiore controllo, scalabilità e capacità di gestire traffico più elevato, garantendo prestazioni migliori man mano che l’app si espande.
Implementa aggiornamenti in tempo reale per gli upload
Imposta aggiornamenti in tempo reale in modo che, quando vengono caricate nuove immagini, compaiano subito per tutti gli utenti senza ricaricare la pagina. Usando tecnologie come WebSocket o Socket.IO, puoi inviare aggiornamenti a tutti gli utenti connessi non appena un’immagine viene caricata, migliorando interattività ed esperienza d’uso dell’app.
Conclusione
Abbiamo creato con successo un’app di ricerca immagini basata sull’IA usando Bridgetower, Streamlit e PyTorch, mostrando come l’IA possa semplificare e migliorare l’interazione con i contenuti digitali.
Pur essendo pienamente funzionante, ci sono margini di miglioramento, come ottimizzare la velocità di ricerca con l’indicizzazione FAISS, distribuire su piattaforme come AWS per la scalabilità e aggiungere aggiornamenti in tempo reale per un’esperienza più fluida. Questo progetto è una base solida per ulteriori innovazioni nei sistemi di ricerca intelligenti.
Se vuoi approfondire, ti consiglio queste risorse: