लर्निंग पाथ
एआई अनुप्रयोग विकसित करना
21 घंटा
एक Gen AI इंजीनियर के रूप में, मैं लगातार पढ़कर और नए विकासों का पता लगाकर नवीनतम टूल और तकनीकों से अपडेट रहना अपनी प्राथमिकता बनाता/बनाती हूं। हाल ही में मैंने Microsoft के शोधकर्ताओं का एक शोध-पत्र देखा जिसमें BridgeTower, एक मॉडल पेश किया गया है जो विज़न और भाषा क्षमताओं के एकीकरण को सरल बनाता है, जिससे मल्टीमोडल कार्यों को लागू करना काफी आसान हो जाता है।
इस गाइड में, मैं आपको दिखाऊंगा/दिखाऊंगी कि Hugging Face Transformers लाइब्रेरी से BridgeTower का उपयोग करके एक सरल लेकिन शक्तिशाली इमेज-टेक्स्ट रिट्रीवल सिस्टम कैसे बनाएं। यह ट्यूटोरियल शुरुआती लोगों के लिए अनुकूल है और आपको निम्न चरणों से होकर ले जाएगा:
ट्यूटोरियल के अंत तक, आपके पास एक पूरी तरह कार्यशील सिस्टम होगा जो इमेज को टेक्स्ट क्वेरी से प्रभावी रूप से मिलाता है, जिससे मल्टीमोडल AI की शक्ति और सरलता प्रदर्शित होगी।
BridgeTower मॉडल, जैसा कि Xiao Xu और अन्य द्वारा लिखित शोध-पत्र BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning में समझाया गया है, का उद्देश्य विज़न और भाषा मॉडल्स के बीच बेहतर समन्वय स्थापित करना है।
कल्पना कीजिए एक कार्य की जिसमें मॉडल को एक इमेज और उसका टेक्स्ट विवरण—जैसे "a dog running in a park."—दोनों समझने होते हैं।
आम तौर पर, मॉडल इमेज और टेक्स्ट को अलग-अलग विज़न और लैंग्वेज एन्कोडर्स से प्रोसेस करता है। BridgeTower मॉडल इन एन्कोडर्स और क्रॉस-मोडल एन्कोडर (जो विज़न और भाषा दोनों को संयोजित करता है) के बीच एक "ब्रिज" जोड़ता है, जिससे वे हर चरण पर बेहतर तरीके से इंटरैक्ट कर सकें।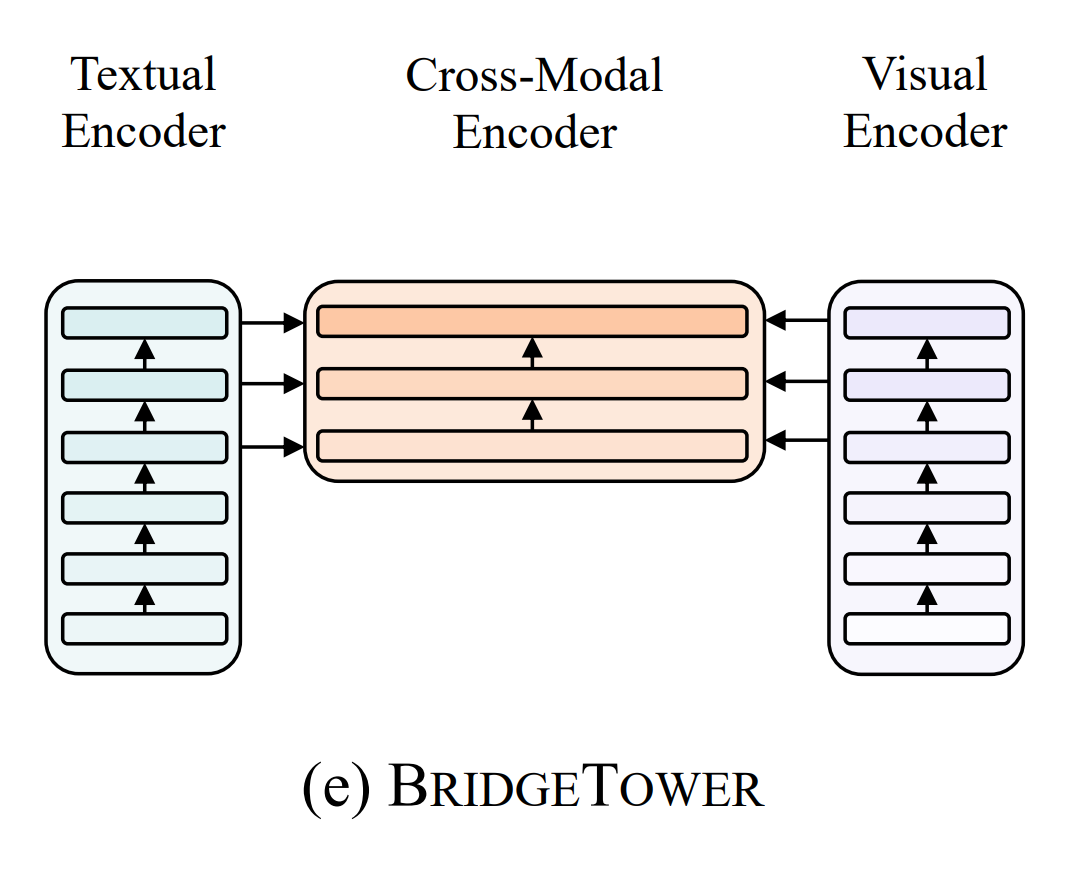
उदाहरण के लिए, कुत्ते की इमेज को प्रोसेस करते समय, विज़न एन्कोडर कुत्ते का आकार और गति पकड़ सकता है। इसी बीच, लैंग्वेज एन्कोडर "running" और "dog" जैसे शब्दों को समझता है।
यह ब्रिज इन दोनों जानकारियों को विस्तार से परस्पर क्रिया करने देता है, जिससे मॉडल दृश्य और पाठ्य संकेतों को अधिक प्रभावी ढंग से जोड़ पाता है। इस तरह, मॉडल इमेज कैप्शनिंग या प्रश्नोत्तर जैसे कार्यों में बेहतर प्रदर्शन करता है, वह भी बिना अतिरिक्त कंप्यूटेशन या गति में कमी के।
हम चीज़ों को साफ-सुथरा और व्यवस्थित रखेंगे। आपका प्रोजेक्ट डायरेक्टरी कुछ इस प्रकार दिखना चाहिए:
/image-search-app/
│
├── app.py          # Frontend (Streamlit UI)
├── search.py       # Backend logic (embeddings & similarity search)
├── images/         # Directory for uploaded images
│   ├── image1.jpg
│   ├── image2.png
│   ├── image3.jpeg
│
└── requirements.txt # Python dependenciesकोड में जाने से पहले, एक सुचारू विकास और परीक्षण प्रक्रिया सुनिश्चित करने के लिए वातावरण सेट करें। इन चरणों का पालन करें:
सबसे पहले सुनिश्चित करें कि आपके पास Python इंस्टॉल है (संस्करण 3.7 या उससे ऊपर अनुशंसित है)। फिर, आवश्यक लाइब्रेरीज़ इंस्टॉल करने के लिए अपने टर्मिनल में निम्न कमांड चलाएँ:
pip install torch transformers streamlit Pillowएप्लिकेशन का परीक्षण करने के लिए कुछ सैंपल इमेज /images डायरेक्टरी में रखें। सुनिश्चित करें कि ये इमेज सपोर्टेड फ़ॉर्मैट जैसे JPG, PNG या JPEG में हों, क्योंकि ये व्यापक रूप से मान्य और अधिकांश लाइब्रेरीज़ के साथ संगत हैं।
विविध प्रकार की इमेज का उपयोग करें ताकि मॉडल टेक्स्ट क्वेरी के आधार पर सटीक मिलान निकाल सके।
एप्लिकेशन की मूल कार्यक्षमता दो मुख्य घटकों में बंटी है: बैकएंड (search.py) और फ्रंटएंड (app.py)। दोनों मिलकर ऐप के निर्बाध संचालन में अहम भूमिका निभाते हैं।
इस फ़ाइल में टेक्स्ट और इमेज एम्बेडिंग्स तथा सर्च मैकेनिज़्म की लॉजिक है।
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch.nn.functional as F
import osprocessor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)यह एम्बेडिंग्स के लिए आवश्यक मॉडल और प्रोसेसर इनिशियलाइज़ करता है।
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
   return best_match
यह कैसे काम करता है:
यह फ़ाइल Streamlit का उपयोग करके एक उपयोगकर्ता-अनुकूल इंटरफ़ेस प्रदान करती है।
import streamlit as st
from search import search_best_match
import osst.title("🖼️ AI-Powered Image Search App")
uploaded_files = st.file_uploader("Upload images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)उपयोगकर्ता एक से अधिक इमेज अपलोड कर सकते हैं। इमेज images/ फोल्डर में सहेजी और प्रदर्शित की जाती हैं।
query = st.text_input("Enter your search query:")

if query and uploaded_files:
    best_match, score = search_best_match(image_folder, query)
    st.write("### Most Relevant Image:")
    st.image(best_match, caption=f"Score: {score:.4f}", use_column_width=True)
उपयोगकर्ता सर्च क्वेरी दर्ज करते हैं। ऐप सर्वश्रेष्ठ मिलान करने वाली इमेज खोजकर दिखाता है।
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch
import torch.nn.functional as F
import os

# Load Bridgetower processor and model
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")

# Search for the best matching image
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
return best_matchimport streamlit as st
from search import image_search
import os
# Title of the app
st.title("🖼️ Image Search Application with BridgeTower")
# Image upload section
uploaded_files = st.file_uploader("Upload your images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
# Create image folder if not exists
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)
# Text input for query
query = st.text_input("Enter your search query:")
# Display search results
if query and uploaded_files:
best_match, score = image_search(image_folder, query)
st.write("### Most Relevant Image:")
st.image(best_match, caption=f"Similarity Score: {score:.4f}", use_column_width=True)streamlit run app.pyयहाँ ऐप के काम करने का एक उदाहरण है! एक इमेज अपलोड की गई और उपयोगकर्ता ने सर्च क्वेरी “cat” टाइप की। ऐप ने तेजी से इमेज और टेक्स्ट का विश्लेषण किया और BridgeTower मॉडल का उपयोग करके उन्हें मिलाया।
इसने सर्वश्रेष्ठ मिलान पाया और बिल्ली की सही इमेज प्रदर्शित की। यह दिखाता है कि ऐप किस तरह इमेज और टेक्स्ट को जोड़कर सटीक परिणाम देता है।
जिज्ञासा यहीं नहीं रुकनी चाहिए। इस तरह के एप्लिकेशनों की क्षमता वर्तमान कार्यान्वयन से कहीं आगे जाती है, जो विकास और नवाचार के लिए रोमांचक अवसर खोलती है। उपयोगकर्ता अनुभव, प्रदर्शन और कार्यक्षमता को बढ़ाने की संभावनाएँ व्यापक हैं। नीचे, मैं कुछ ऐसे सुधार प्रस्तावित कर रहा/रही हूं जो ऐसे एप्लिकेशनों को अगले स्तर तक ले जा सकते हैं।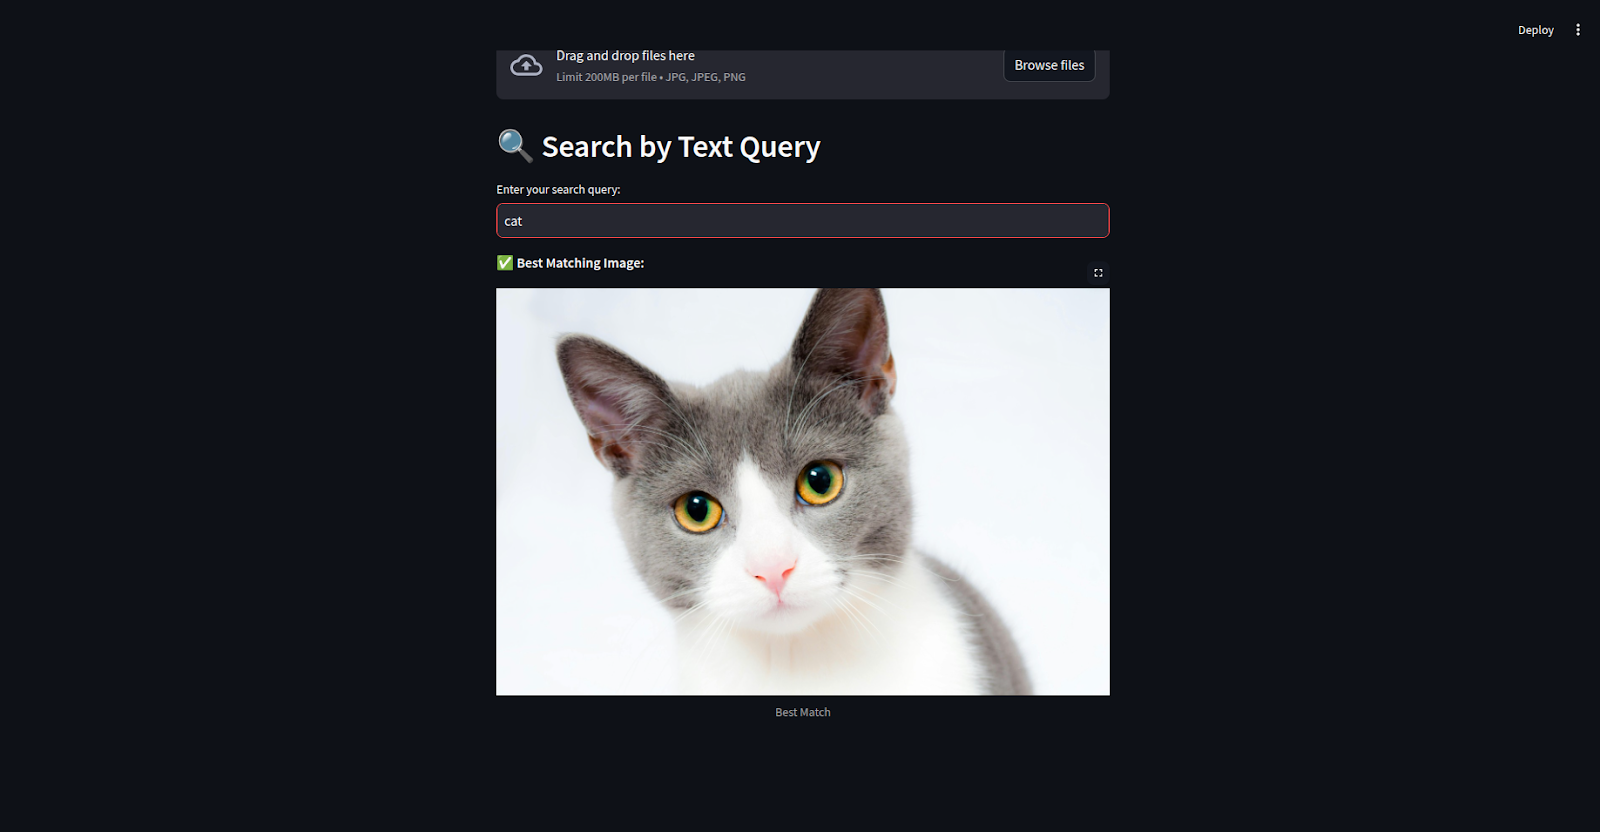
हमने जो ऐप बनाया है, उसे कई तरीकों से बेहतर किया जा सकता है, उदाहरण के लिए:
बड़े डेटासेट में इमेज सर्च की गति बढ़ाने के लिए FAISS इंडेक्सिंग लागू करें। इससे आप इमेज को फीचर वेक्टर में बदलकर एक इंडेक्स बना सकेंगे और तेजी से समानता सर्च कर पाएंगे, जिससे डेटासेट बढ़ने पर भी रिट्रीवल कुशल बना रहेगा।
तेज़ और आसान सेटअप के लिए ऐप को Streamlit Cloud पर डिप्लॉय करें, खासकर यदि आप Python और Streamlit के साथ काम कर रहे हैं। वैकल्पिक रूप से, इसे AWS पर डिप्लॉय करें ताकि अधिक नियंत्रण, स्केलेबिलिटी और उच्च ट्रैफ़िक संभालने की क्षमता मिले, जिससे ऐप के विस्तार के साथ बेहतर प्रदर्शन सुनिश्चित हो।
ऐसा रीयल-टाइम अपडेट सेट करें कि नई इमेज अपलोड होते ही वे सभी उपयोगकर्ताओं के लिए बिना पेज रिफ्रेश के तुरंत दिखाई दें। WebSockets या Socket.IO जैसी तकनीकों का उपयोग करके, आप इमेज अपलोड होते ही सभी कनेक्टेड उपयोगकर्ताओं को अपडेट पुश कर सकते हैं, जिससे ऐप की इंटरैक्टिविटी और अनुभव बेहतर होगा।
हमने Bridgetower, Streamlit और PyTorch का उपयोग करके सफलतापूर्वक एक AI-संचालित इमेज सर्च एप्लिकेशन बनाया, जो दिखाता है कि AI किस तरह डिजिटल कंटेंट के साथ इंटरैक्शन को सरल और बेहतर बनाता है।
हालाँकि यह पूरी तरह कार्यशील है, फिर भी सुधार की गुंजाइश है—जैसे FAISS इंडेक्सिंग से सर्च गति का अनुकूलन, AWS जैसी प्लेटफ़ॉर्म पर स्केलेबिलिटी के लिए डिप्लॉयमेंट, और रीयल-टाइम अपडेट जोड़ना ताकि उपयोगकर्ता अनुभव और सहज हो। यह प्रोजेक्ट बुद्धिमान सर्च सिस्टम्स में आगे नवाचार के लिए एक मजबूत आधार है।
यदि आप और सीखना चाहते हैं, तो मैं ये संसाधन सुझा सकता/सकती हूं:
शीर्ष DataCamp कोर्स
लर्निंग पाथ
लर्निंग पाथ
कोर्स