50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Als Gen AI Engineer vind ik het belangrijk om bij te blijven met de nieuwste tools en technologieën door continu te lezen en nieuwe ontwikkelingen te verkennen. Onlangs stuitte ik op een onderzoekspaper van Microsoft-onderzoekers waarin BridgeTower, een model, wordt geïntroduceerd dat de integratie van visie- en taalcapaciteiten vereenvoudigt, waardoor multimodale taken veel makkelijker te implementeren zijn.
In deze gids laat ik je zien hoe je een eenvoudig maar krachtig systeem voor beeld-tekst-opvraging bouwt met BridgeTower uit de Hugging Face Transformers-bibliotheek. Deze tutorial is bedoeld voor beginners en neemt je mee door de volgende stappen:
Aan het einde van deze tutorial heb je een volledig functioneel systeem dat afbeeldingen effectief kan koppelen aan tekstqueries, wat de kracht en eenvoud van multimodale AI laat zien.
Het BridgeTower-model, zoals uitgelegd in het paper BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning door Xiao Xu en anderen, heeft als doel om te verbeteren hoe vision- en taalmodellen samenwerken.
Stel je een taak voor waarbij het model zowel een afbeelding als een tekstbeschrijving moet begrijpen, zoals "een hond die in een park rent."
Gewoonlijk zou het model de afbeelding en tekst apart verwerken met vision- en taal-encoders. Het BridgeTower-model voegt een "brug" toe tussen deze encoders en de cross-modale encoder (die zowel visie als taal combineert), zodat ze bij elke stap beter kunnen interageren.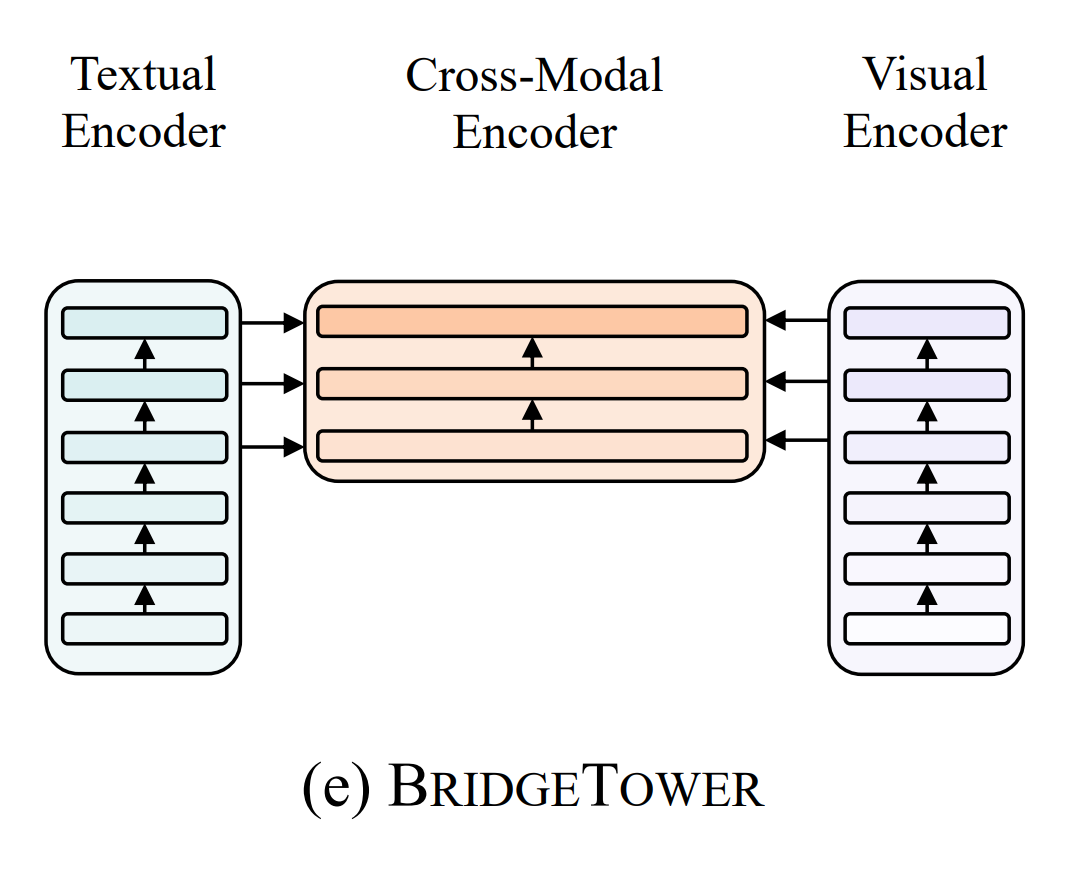
Bijvoorbeeld: tijdens het verwerken van de afbeelding van de hond kan de vision-encoder de vorm en beweging van de hond detecteren. Ondertussen begrijpt de taal-encoder de woorden "rennen" en "hond."
De brug zorgt ervoor dat deze twee informatiebronnen gedetailleerd kunnen interageren, waardoor het model visuele en tekstuele aanwijzingen effectiever met elkaar kan verbinden. Zo presteert het model beter bij taken zoals beeldonderschriften of vraag-antwoordsystemen, zonder veel extra rekenkracht of vertraging.
We houden het netjes en overzichtelijk. Je projectmap ziet er zo uit:
/image-search-app/
│
├── app.py          # Frontend (Streamlit UI)
├── search.py       # Backend logic (embeddings & similarity search)
├── images/         # Directory for uploaded images
│   ├── image1.jpg
│   ├── image2.png
│   ├── image3.jpeg
│
└── requirements.txt # Python dependenciesVoordat we in de code duiken, richten we de omgeving in voor een soepel ontwikkel- en testproces. Volg deze stappen:
Zorg er eerst voor dat je Python hebt geïnstalleerd (versie 3.7 of hoger aanbevolen). Voer vervolgens de volgende opdracht uit in je terminal om de benodigde bibliotheken te installeren:
pip install torch transformers streamlit PillowPlaats om de applicatie te testen een aantal voorbeeldafbeeldingen in de map /images. Zorg dat deze afbeeldingen in ondersteunde formaten staan zoals JPG, PNG of JPEG, omdat deze algemeen erkend en compatibel zijn met de meeste bibliotheken.
Gebruik een verscheidenheid aan afbeeldingen om ervoor te zorgen dat het model nauwkeurig matches kan vinden op basis van de tekstquery.
De kernfunctionaliteit van de applicatie is verdeeld in twee hoofdcomponenten: de backend (search.py) en de frontend (app.py). Elke component speelt een cruciale rol om de app soepel te laten werken.
Dit bestand bevat de logica voor tekst- en afbeeldings-embeddings en het zoeksysteem.
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch.nn.functional as F
import osprocessor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)Dit initialiseert het model en de processor die nodig zijn voor embeddings.
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
   return best_match
Zo werkt het:
Dit bestand gebruikt Streamlit om een gebruiksvriendelijke interface te bieden.
import streamlit as st
from search import search_best_match
import osst.title("🖼️ AI-Powered Image Search App")
uploaded_files = st.file_uploader("Upload images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)Gebruikers kunnen meerdere afbeeldingen uploaden. Afbeeldingen worden opgeslagen in de map images/ en weergegeven.
query = st.text_input("Enter your search query:")

if query and uploaded_files:
    best_match, score = search_best_match(image_folder, query)
    st.write("### Most Relevant Image:")
    st.image(best_match, caption=f"Score: {score:.4f}", use_column_width=True)
Gebruikers voeren een zoekquery in. De app zoekt de best passende afbeelding en toont die.
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch
import torch.nn.functional as F
import os

# Load Bridgetower processor and model
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")

# Search for the best matching image
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
return best_matchimport streamlit as st
from search import image_search
import os
# Title of the app
st.title("🖼️ Image Search Application with BridgeTower")
# Image upload section
uploaded_files = st.file_uploader("Upload your images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
# Create image folder if not exists
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)
# Text input for query
query = st.text_input("Enter your search query:")
# Display search results
if query and uploaded_files:
best_match, score = image_search(image_folder, query)
st.write("### Most Relevant Image:")
st.image(best_match, caption=f"Similarity Score: {score:.4f}", use_column_width=True)streamlit run app.pyHier zie je een voorbeeld van de app in actie! Er werd een afbeelding geüpload en de gebruiker typte de zoekquery "cat" in. De app analyseerde snel de afbeelding en tekst en koppelde ze vervolgens met het BridgeTower-model.
Hij vond de beste match en toonde de juiste afbeelding van een kat. Dit laat zien hoe goed de app afbeeldingen en tekst verbindt om nauwkeurige resultaten te geven.
De nieuwsgierigheid hoeft hier niet te stoppen. De potentie van dit soort applicaties reikt veel verder dan wat nu is geïmplementeerd en opent spannende kansen voor groei en innovatie. De mogelijkheden om gebruikerservaring, prestaties en functionaliteit te verbeteren zijn groot. Hieronder stel ik een paar verbeteringen voor die zulke applicaties naar een hoger niveau kunnen tillen.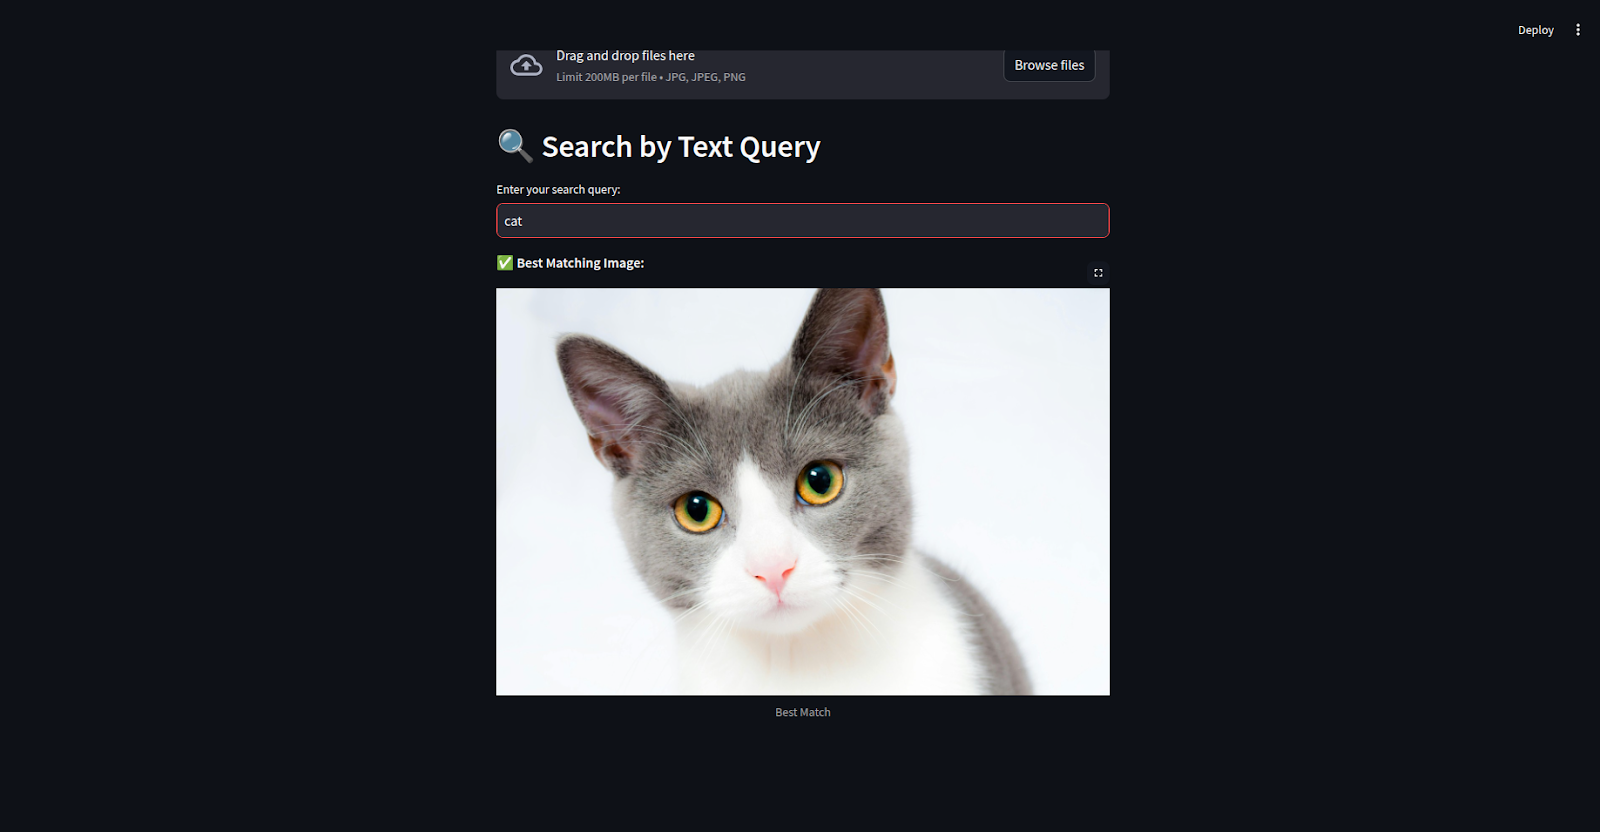
Er zijn verschillende manieren om de app die we hebben gemaakt te verbeteren, bijvoorbeeld:
Implementeer FAISS-indexering om de snelheid van zoekopdrachten in grote datasets te verbeteren. Hiermee kun je afbeeldingen omzetten in featurevectoren, een index bouwen en snel similariteitszoekopdrachten uitvoeren, zodat het ophalen van afbeeldingen efficiënt blijft naarmate de dataset groeit.
Deploy de app op Streamlit Cloud voor een snelle, eenvoudige setup, vooral als je met Python en Streamlit werkt. Of deploy hem op AWS voor meer controle, schaalbaarheid en de mogelijkheid om meer traffic aan te kunnen, zodat de prestaties beter blijven naarmate de app groeit.
Zorg voor realtime updates zodat nieuwe uploads direct voor alle gebruikers verschijnen zonder de pagina te verversen. Met technologieën zoals WebSockets of Socket.IO kun je updates pushen naar alle verbonden gebruikers zodra er een afbeelding is geüpload, wat de interactiviteit en ervaring van de app verbetert.
We hebben met succes een AI-aangedreven afbeeldingszoekapp gebouwd met Bridgetower, Streamlit en PyTorch, en laten zien hoe AI interacties met digitale content kan vereenvoudigen en verbeteren.
Hoewel volledig functioneel, is er ruimte voor verbetering, zoals het optimaliseren van de zoeksnelheid met FAISS-indexering, deployen op platforms zoals AWS voor schaalbaarheid en het toevoegen van realtime updates voor een soepelere gebruikerservaring. Dit project vormt een sterke basis voor verdere innovatie in intelligente zoeksystemen.
Als je meer wilt leren, kan ik deze bronnen aanraden:
Topcursussen op DataCamp
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min