
学习路径
开发 AI 应用程序
21 小时
实践并学习路径你的进步。
使用 Google 继续作为一名生成式 AI 工程师,我始终把紧跟最新工具与技术放在首位,通过持续阅读与探索来了解新进展。最近,我读到微软研究人员的一篇论文,介绍了BridgeTower 模型,它简化了视觉与语言能力的整合,使多模态任务更易于实现。
在本指南中,我将向您展示如何使用来自Hugging Face Transformers 库的 BridgeTower 构建一个简单而强大的图文检索系统。本教程对初学者友好,将带您完成以下步骤:
在本教程结束时,您将拥有一个可运行的系统,能够有效将图片与文本查询进行匹配,充分展示多模态 AI的强大与简洁。
BridgeTower 模型在论文 BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning(作者:Xiao Xu 等)中进行了阐释,旨在提升视觉与语言模型的协同工作方式。
想象一个需要同时理解图片与文本描述的任务,例如“a dog running in a park(狗在公园里奔跑)”。
通常,模型会分别使用视觉与语言编码器来处理图片和文本。BridgeTower 模型在这些编码器与跨模态编码器(将视觉与语言融合)之间加入了一座“桥”,让它们在每一步都能更好地交互。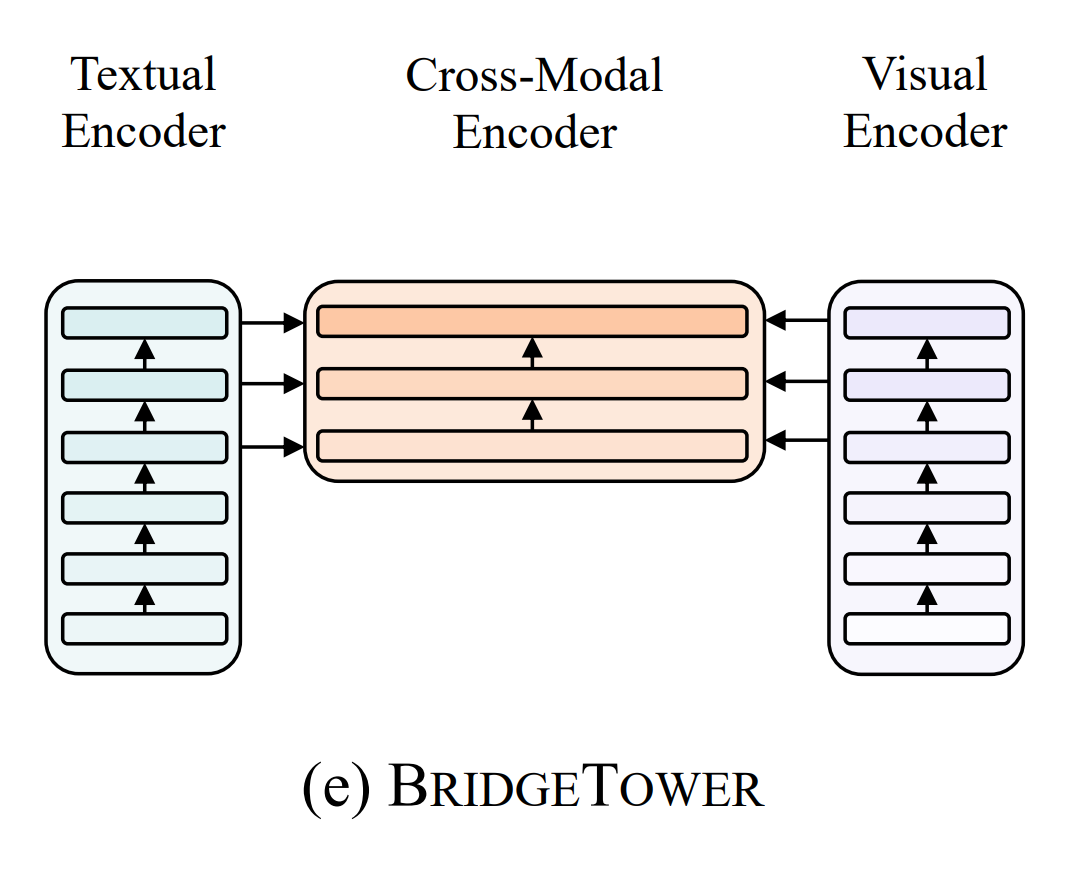
例如,在处理狗的图片时,视觉编码器可能会检测到狗的形状与运动;与此同时,语言编码器理解“running”和“dog”。
这座“桥”让两类信息能够更细致地交互,帮助模型更有效地关联视觉与文本线索。因此,在图像描述或视觉问答等任务中,模型表现更好,同时无需大量额外计算或造成延迟。
我们将保持整洁有序。您的项目目录应如下所示:
/image-search-app/
│
├── app.py          # Frontend (Streamlit UI)
├── search.py       # Backend logic (embeddings & similarity search)
├── images/         # Directory for uploaded images
│   ├── image1.jpg
│   ├── image2.png
│   ├── image3.jpeg
│
└── requirements.txt # Python dependencies在编写代码之前,先完成环境配置,确保开发与测试顺利进行。请按以下步骤操作:
首先确保已安装 Python(建议 3.7 或更高版本)。然后在终端运行以下命令安装必要的库:
pip install torch transformers streamlit Pillow为了测试应用,请将一些示例图片放入/images目录。请确保这些图片为以下受支持格式:JPG、PNG或JPEG,这些格式通用且与大多数库兼容。
请使用多样化的图片,以确保模型能根据文本查询准确检索匹配结果。
应用的核心功能分为两个主要组件:后端(search.py)与前端(app.py)。每个组件都对应用的顺畅运行至关重要。
此文件包含文本与图像向量表示及检索机制的逻辑。
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch.nn.functional as F
import osprocessor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)这将初始化用于生成向量表示的模型与处理器。
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
   return best_match
工作原理:
该文件使用 Streamlit 提供友好的用户界面。
import streamlit as st
from search import search_best_match
import osst.title("🖼️ AI-Powered Image Search App")
uploaded_files = st.file_uploader("Upload images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)用户可以上传多张图片。图片会保存至 images/ 文件夹并显示。
query = st.text_input("Enter your search query:")

if query and uploaded_files:
    best_match, score = search_best_match(image_folder, query)
    st.write("### Most Relevant Image:")
    st.image(best_match, caption=f"Score: {score:.4f}", use_column_width=True)
用户输入搜索查询。应用会检索最佳匹配图片并展示。
from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
from PIL import Image
import torch
import torch.nn.functional as F
import os

# Load Bridgetower processor and model
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")

# Search for the best matching image
def image_search(query, image_dir):
   image_files = [os.path.join(image_dir, img) for img in os.listdir(image_dir) if img.lower().endswith(('jpg', 'jpeg', 'png'))]
   scores = {}

   for img_path in image_files:
       image = Image.open(img_path).convert("RGB")
       encoding = processor(text=query, images=image, return_tensors="pt").to(device)
       outputs = model(**encoding)
       scores[img_path] = outputs.logits[0, 1].item()

   best_match = max(scores, key=scores.get)
return best_matchimport streamlit as st
from search import image_search
import os
# Title of the app
st.title("🖼️ Image Search Application with BridgeTower")
# Image upload section
uploaded_files = st.file_uploader("Upload your images", accept_multiple_files=True, type=['jpg', 'jpeg', 'png'])
# Create image folder if not exists
image_folder = 'images'
os.makedirs(image_folder, exist_ok=True)
if uploaded_files:
for uploaded_file in uploaded_files:
with open(os.path.join(image_folder, uploaded_file.name), 'wb') as f:
f.write(uploaded_file.getbuffer())
st.image(uploaded_file, caption="Uploaded Image", use_column_width=True)
# Text input for query
query = st.text_input("Enter your search query:")
# Display search results
if query and uploaded_files:
best_match, score = image_search(image_folder, query)
st.write("### Most Relevant Image:")
st.image(best_match, caption=f"Similarity Score: {score:.4f}", use_column_width=True)streamlit run app.py下面是应用运行时的一个示例!上传了一张图片,用户输入了搜索查询“cat(猫)”。应用快速分析了图片与文本,并使用 BridgeTower 模型进行匹配。
应用找到了最佳匹配并展示了正确的猫的图片。这显示了应用如何有效连接图像与文本,从而给出准确结果。
好奇心不应止步于此。此类应用的潜力远超当前实现,为增长与创新带来令人兴奋的机遇。在用户体验、性能与功能方面仍有广阔的提升空间。下面我提出一些可将此类应用提升到新水平的改进方向。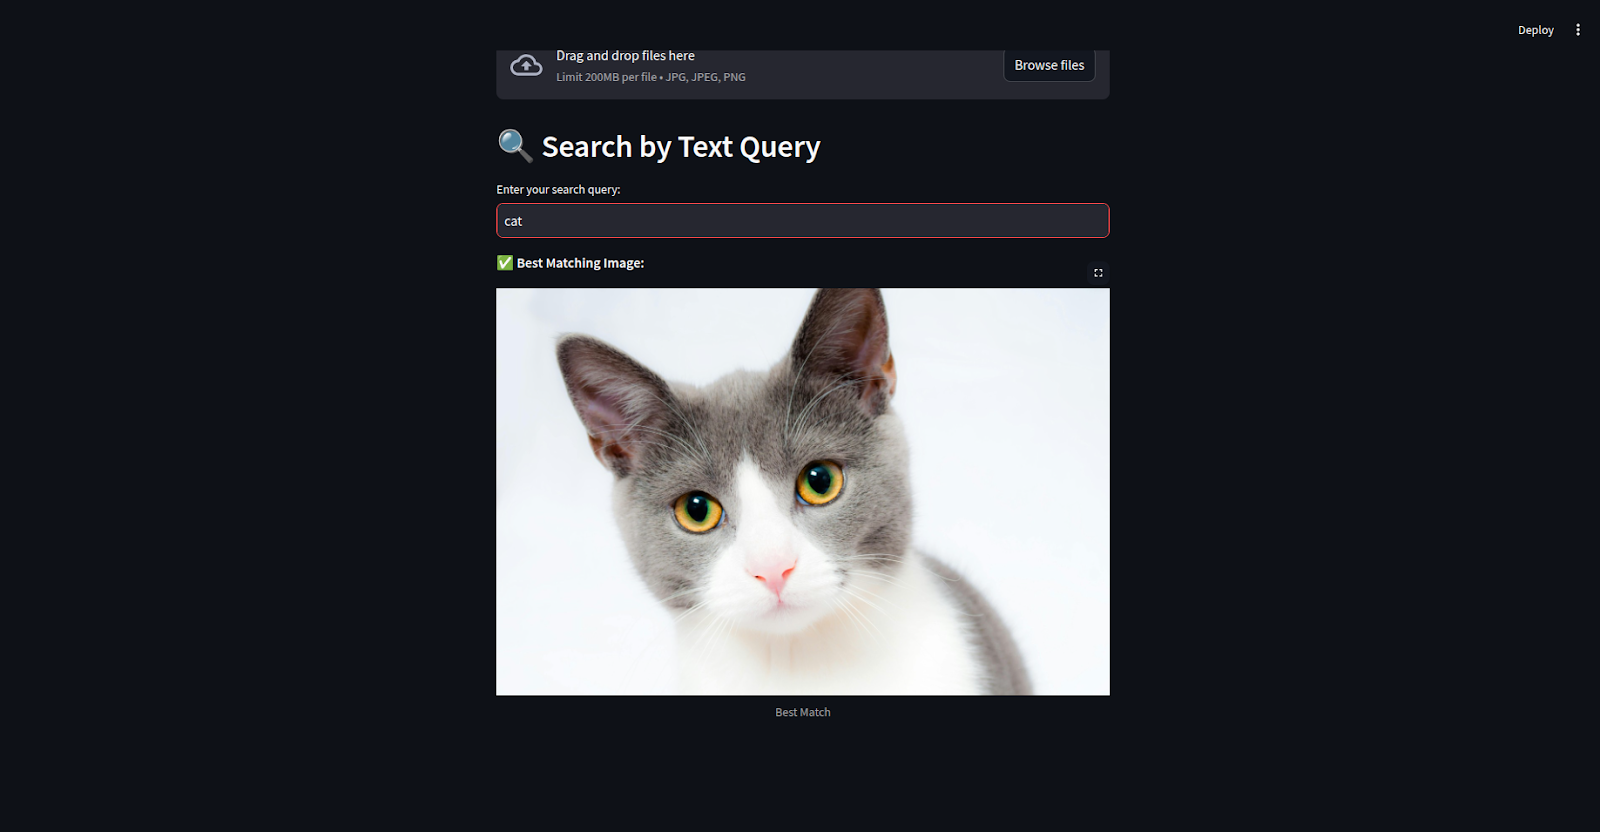
我们创建的应用可以通过多种方式增强,例如:
实现 FAISS 索引以提升在大规模数据集上的搜索速度。您可以将图片转换为特征向量、建立索引并快速进行相似度搜索,确保随着数据集增长,图像检索依然高效。
如果您使用 Python 与 Streamlit,部署到 Streamlit Cloud 可实现快速、便捷的上线。或者,将其部署在 AWS 上可获得更强的可控性、可扩展性与更高的流量承载能力,从而在应用扩展时提供更好的性能。
设置实时更新,使新图片上传后无需刷新页面即可立即呈现给所有用户。借助 WebSocket 或 Socket.IO 等技术,可在图片上传后立刻向所有连接用户推送更新,增强应用的交互性与体验。
我们已成功使用 Bridgetower、Streamlit 与 PyTorch 构建了一款 AI 驱动的图片搜索应用,展示了 AI 如何简化并提升与数字内容的交互方式。
尽管功能完备,但仍有改进空间,例如通过 FAISS 索引优化搜索速度、在 AWS 等平台上部署以增强可扩展性,以及加入实时更新以带来更顺畅的用户体验。该项目为智能搜索系统的进一步创新奠定了坚实基础。
如果您希望深入学习,我推荐以下资源:
DataCamp 热门课程
学习路径
学习路径
实践并学习路径你的进步。
使用 Google 继续