
Last chance! 50% off DataCamp Premium
Sale ends in
Claude Opus 4.8 menambahkan parameter effort yang memungkinkan Anda mengontrol kedalaman penalaran per permintaan. Anggaplah ini sebagai tombol dengan tiga posisi:
low: Model merespons lebih langsung, menggunakan lebih sedikit thinking tokens, cocok untuk tugas yang ruang lingkupnya jelas, faktual, atau terstruktur.
medium: Menjadi titik tengah di mana model menalar lebih hati-hati namun tidak mengeksplorasi semua edge case secara menyeluruh.
high: Ini adalah default model, dengan kedalaman thinking yang meningkat dan terbaik untuk penalaran kompleks, masalah desain multi-langkah, serta tugas yang mahal jika melewatkan edge case.
xhigh: Dirancang untuk tugas agentic dan coding jangka panjang yang memerlukan koherensi berkelanjutan di banyak langkah.
max: Tingkat kapabilitas maksimum, menyisihkan anggaran komputasi penuh untuk tugas paling menuntut.
Parameter effort hanya berfungsi bersama thinking: {type: "adaptive"}. Adaptive thinking memungkinkan model memutuskan per giliran apakah penalaran mendalam diperlukan. Bersama-sama, keduanya memberi Anda kendali bermakna atas cara model membelanjakan anggaran komputasinya.
Tutorial ini berfokus pada low, medium, dan high, tiga tingkat yang paling relevan untuk beban kerja produksi serbaguna, namun struktur aplikasi yang sama berlaku jika Anda ingin memperluasnya ke xhigh atau max.
Tingkat effort teratas tersebut dibangun untuk kerja agentic berkelanjutan — jenis yang dibahas dalam tutorial kami Spec-Driven Development with Claude Code.
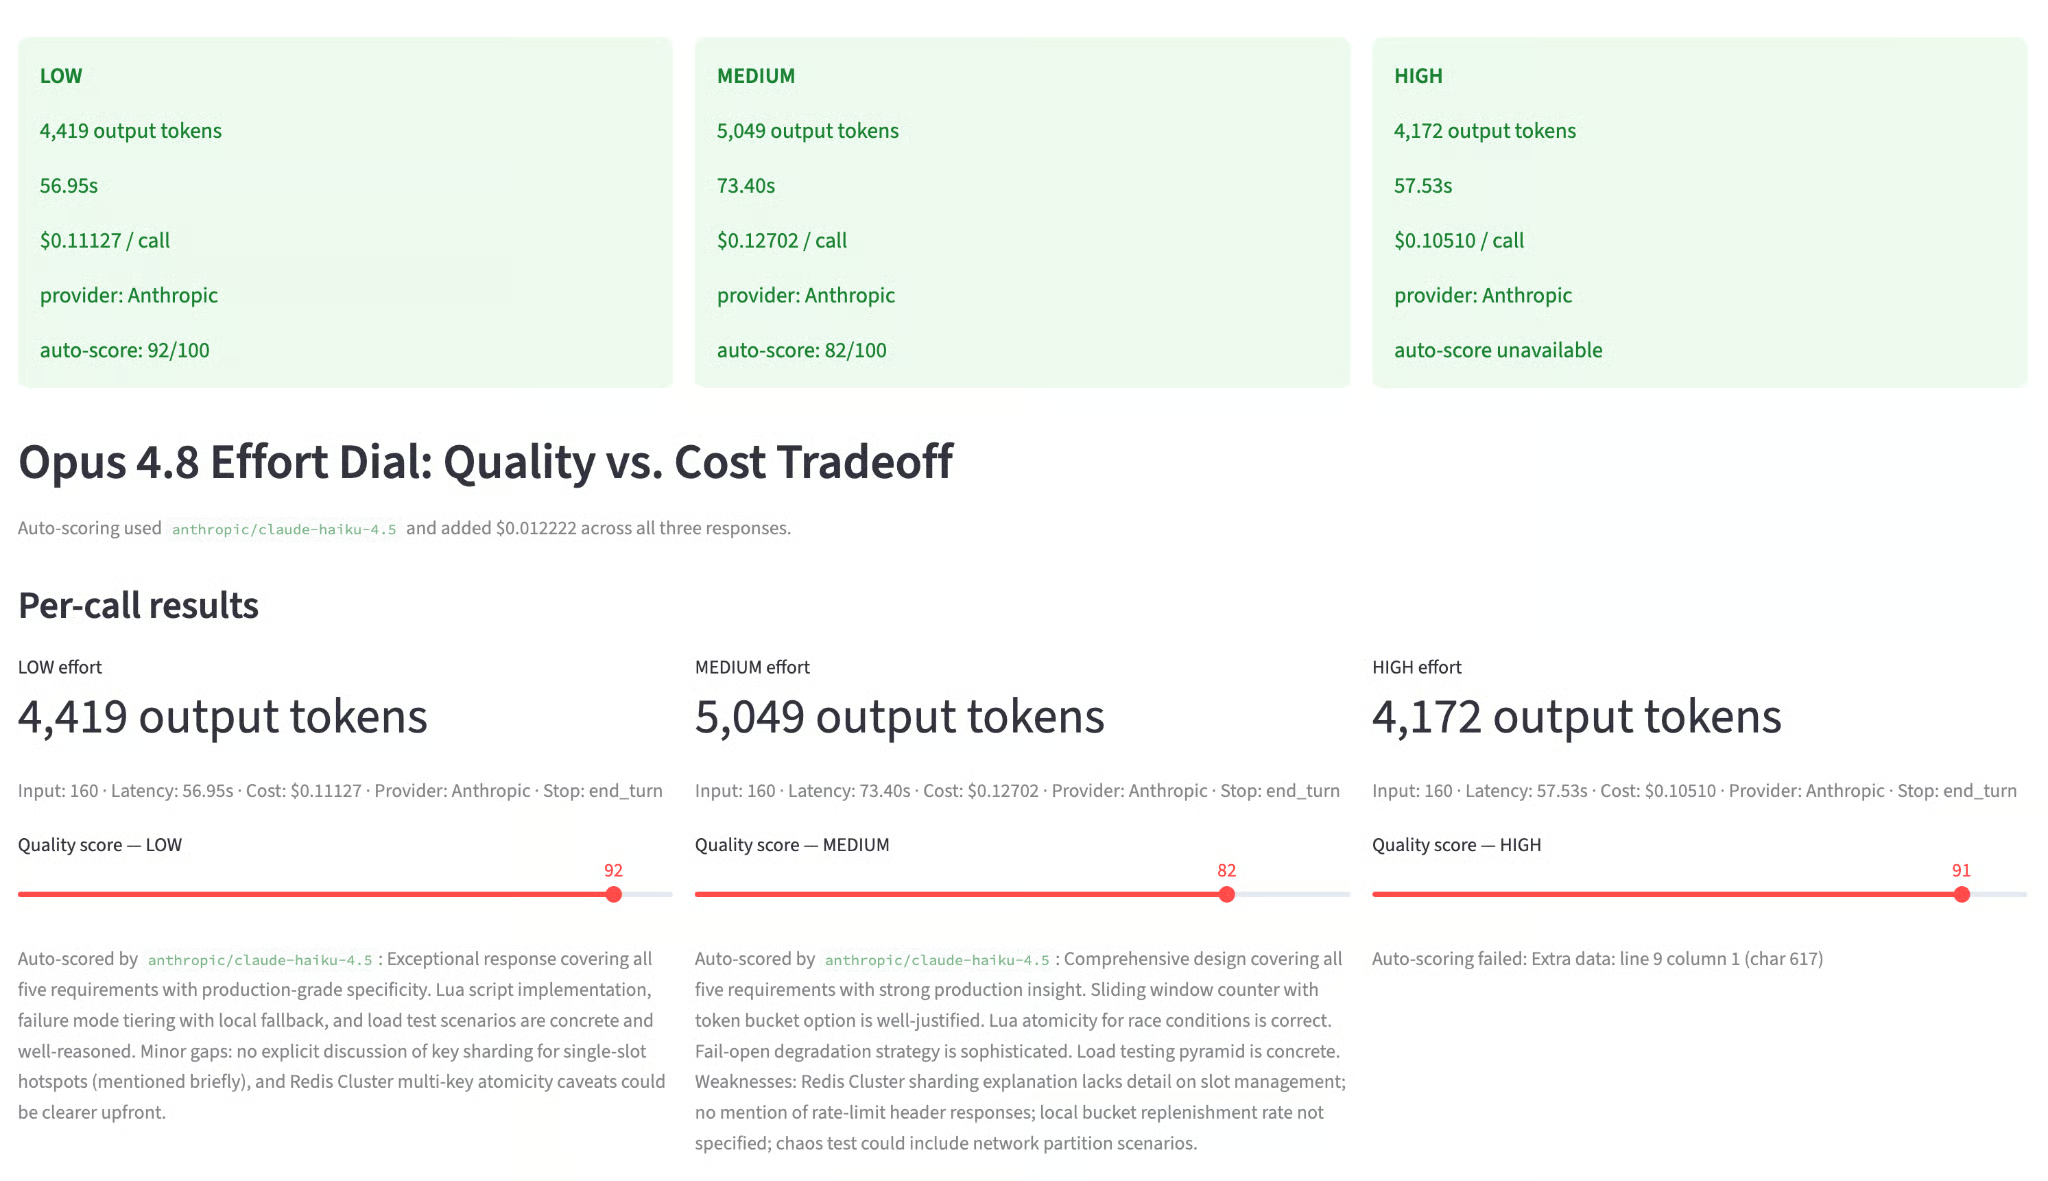
Aplikasinya berupa satu file Python. Saat dijalankan, Anda melihat sidebar dengan input prompt dan slider tasks-per-day, serta panel utama dengan empat tab:
Alur kerja pada setiap run adalah:
claude-opus-4-8 dengan effort diatur ke low, medium, dan high, masing-masingclaude-haiku-4-5 sebagai penilai berbasis rubrikPrompt default adalah pertanyaan desain sistem terdistribusi yang secara alami menskalakan dengan tingkat effort.
Untuk mengikuti tutorial ini, Anda memerlukan:
Python 3.10 atau lebih baru
Kunci API Anthropic dengan akses ke claude-opus-4-8
Dasar-dasar Streamlit
Buat virtual environment dan instal paket yang diperlukan:
bashpython -m venv .venv
source .venv/bin/activate
pip install anthropic streamlit plotly pandas python-dotenv
Di Windows, gunakan .venv\Scripts\activate alih-alih source .venv/bin/activate.
Tambahkan kunci API Anthropic Anda ke file .env di root proyek:
.env
ANTHROPIC_API_KEY=sk-ant-...
Setelah environment siap, kita akan mendefinisikan skema effort_dial untuk UI.
Buat file bernama effort_dial.py dan tambahkan blok konfigurasi di bagian atas:
import os
import time
import json
import re
import anthropic
import pandas as pd
import plotly.graph_objects as go
import streamlit as st
from dotenv import load_dotenv

load_dotenv()
st.set_page_config(
    page_title="Opus 4.8 Effort Dial — Claude Opus 4.8",
    layout="wide",
)
MODEL              = "claude-opus-4-8"
SCORER_MODEL       = "claude-haiku-4-5"
MAX_OUTPUT_TOKENS  = 16000
SCORER_MAX_TOKENS  = 500
PRICE_OUT_PER_TOK        = 25 / 1_000_000
PRICE_IN_PER_TOK         = 5  / 1_000_000
SCORER_PRICE_OUT_PER_TOK = 5  / 1_000_000
SCORER_PRICE_IN_PER_TOK  = 1  / 1_000_000
EFFORT_ORDER  = ["low", "medium", "high"]
EFFORT_COLORS = {"low": "#185FA5", "medium": "#639922", "high": "#EF9F27"}
DEFAULT_QUALITY = {"low": 68, "medium": 82, "high": 91}
Nilai MAX_OUTPUT_TOKENS diatur ke 16.000, bukan default 4.096. Ini penting karena dengan batas 4.096 token, effort medium dan high akan terpotong di titik yang sama, menghapus perbedaan yang terlihat di antara keduanya. Anda memerlukan ruang yang cukup agar respons dapat terpisah secara alami.
Alasan stop end_turn pada keluaran akhir, alih-alih max_tokens, juga mengonfirmasi bahwa model selesai dengan sendirinya.
Prompt sederhana seperti "jelaskan rekursi" memberikan jawaban serupa di ketiga tingkat effort karena tidak ada hal yang cukup sulit untuk memicu penalaran mendalam. Jadi, kami menggunakan pertanyaan desain sistem multi-bagian sebagai gantinya:
DEFAULT_PROMPT = """\
Design a production-ready rate-limiting system for a distributed API gateway
handling 100k requests/second. Cover:
1. Algorithm choice (token bucket vs sliding window vs leaky bucket) with tradeoffs
2. Redis data structure design and TTL strategy
3. Race condition handling across 50 pods
4. Failure mode behavior when Redis is unavailable
5. How you'd test this under load
Be specific about implementation details, not just concepts.
"""
Prompt ini memiliki lima submasalah yang berbeda. Pendekatan ber-effort rendah cenderung membahasnya di tingkat permukaan, menyentuh konsep utama tetapi melewatkan detail implementasi. Effort tinggi mencakup kondisi batas, menyertakan contoh skrip Lua, membahas atomicity EVALSHA, dan menambahkan rencana pengujian beban dengan ambang konkret.
Sekarang definisikan fungsi inti yang memanggil model. Dua detail penting di sini adalah thinking={"type": "adaptive"} dan output_config={"effort": effort}:
def call_opus(client: anthropic.Anthropic, effort: str, prompt: str) -> dict:
    t0 = time.perf_counter()
    response = client.messages.create(
        model=MODEL,
        max_tokens=MAX_OUTPUT_TOKENS,
        thinking={"type": "adaptive"},
        output_config={"effort": effort},
        # Do NOT set temperature, top_p, or top_k — those 400-error on Opus 4.8
        messages=[{"role": "user", "content": prompt}],
    )
    latency_ms = (time.perf_counter() - t0) * 1000
    in_tok  = response.usage.input_tokens
    out_tok = response.usage.output_tokens
    text = next(
        (b.text for b in response.content if b.type == "text"), "(no text block)"
    )
    return {
        "effort":        effort,
        "in_tokens":     in_tok,
        "out_tokens":    out_tok,
        "latency_ms":    latency_ms,
        "cost_usd":      in_tok * PRICE_IN_PER_TOK + out_tok * PRICE_OUT_PER_TOK,
        "response":      text,
        "stop_reason":   response.stop_reason,
        "hit_token_cap": out_tok >= MAX_OUTPUT_TOKENS,
    }
Mari kita ulas keputusan kunci dalam fungsi ini.
thinking={"type": "adaptive"}: Diperlukan agar parameter effort berpengaruh. Tanpanya, ketiga panggilan berperilaku identik terlepas dari nilai effort yang Anda berikan. Adaptive thinking memungkinkan model memutuskan, per giliran, apakah penalaran mendalam diperlukan, lalu mengontrol berapa banyak anggaran yang dialokasikan saat menalar.
output_config={"effort": effort}: Ini adalah cara Anthropic Python SDK meneruskan parameter yang belum diekspos sebagai argumen bernama. Secara internal, SDK menggabungkan dict tersebut ke dalam body permintaan API mentah sebelum mengirim.
time.perf_counter(): Metode ini digunakan untuk mengukur latensi wall-clock alih-alih time.time() karena perf_counter memiliki resolusi lebih tinggi dan tidak terpengaruh oleh penyesuaian jam sistem.
response.content: Opus 4.8 dengan adaptive thinking dapat mengembalikan beberapa blok konten, termasuk blok thinking yang berisi rantai penalaran internal model, dan blok teks yang berisi respons akhir. Kita hanya menginginkan blok teks untuk ditampilkan. Pemanggilan next() melewati blok thinking dan mengekstrak jawaban yang menghadap pengguna saja.
hit_token_cap: Ini adalah flag diagnostik yang disetel ke True ketika out_tokens sama dengan MAX_OUTPUT_TOKENS. Jika ini True untuk medium atau high, berarti respons terpotong di tengah jawaban.
Menilai secara manual tiga respons panjang pada setiap run itu lambat dan subjektif. Sebagai gantinya, teruskan setiap respons ke Claude Haiku 4.5 dengan rubrik, dan minta ia mengembalikan skor JSON terstruktur.
Menggunakan satu model untuk menilai model lain adalah bentuk evaluasi LLM-as-a-judge; panduan kami tentang Evaluasi LLM membahas cara merancang rubrik yang benar-benar dapat Anda percaya.
Rubrik membagi kualitas menjadi empat subskor:
Ini langsung memetakan perbedaan tingkat effort pada prompt desain sistem:
def score_response_with_haiku(client: anthropic.Anthropic, original_prompt: str,
                               response_text: str, effort: str) -> dict:
    rubric = (
        "You are grading an answer to a difficult systems design prompt. "
        "Score the response from 0 to 100 using this rubric: "
        "completeness 30 points, technical correctness 30 points, "
        "edge-case coverage 20 points, implementation specificity 20 points. "
        "Return strict JSON only with keys: score, rationale, completeness, "
        "correctness, edge_cases, specificity. "
        "The rationale must be concise, concrete, and no more than 80 words."
    )
    grader_prompt = (
        f"{rubric}\n\n"
        f"Original prompt:\n{original_prompt}\n\n"
        f"Effort level being graded: {effort}\n\n"
        f"Candidate response:\n{response_text}"
    )
    result = client.messages.create(
        model=SCORER_MODEL,
        max_tokens=SCORER_MAX_TOKENS,
        messages=[{"role": "user", "content": grader_prompt}],
    )
    raw    = next((b.text for b in result.content if b.type == "text"), "")
    parsed = extract_json_object(raw)
    in_tok  = result.usage.input_tokens
    out_tok = result.usage.output_tokens
    score = max(0, min(100, int(round(float(parsed["score"])))))
    return {
        "score":     score,
        "rationale": str(parsed.get("rationale", "")).strip(),
        "subscores": {
            "completeness": parsed.get("completeness"),
            "correctness":  parsed.get("correctness"),
            "edge_cases":   parsed.get("edge_cases"),
            "specificity":  parsed.get("specificity"),
        },
        "scorer_model":      SCORER_MODEL,
        "scorer_cost_usd":   in_tok * SCORER_PRICE_IN_PER_TOK + out_tok * SCORER_PRICE_OUT_PER_TOK,
        "scorer_in_tokens":  in_tok,
        "scorer_out_tokens": out_tok,
    }
Helper extract_json menangani kasus ketika Haiku sesekali membungkus keluaran JSON-nya dengan pagar Markdown. Ini adalah mode kegagalan umum saat memancing model yang lebih kecil.
Total biaya penilaian di ketiga respons biasanya di bawah $0,002. Ini adalah overhead yang dapat diabaikan yang menggantikan langkah manual subjektif dengan rubrik yang dapat diulang.
Aplikasi memiliki tiga bagan:
Mari kita bangun masing-masing bagan ini:
def quality_tradeoff_chart(results: list[dict], scores: dict) -> go.Figure:
    fig = go.Figure()
    for r in results:
        effort = r["effort"]
        fig.add_trace(go.Scatter(
            x=[r["cost_usd"]],
            y=[scores[effort]],
            mode="markers+text",
            name=effort.capitalize(),
            text=[effort.capitalize()],
            textposition="top center",
            marker=dict(size=18, color=EFFORT_COLORS[effort],
                        line=dict(color="white", width=2)),
            hovertemplate=(
                "<b>%{text}</b><br>"
                "Cost / call: $%{x:.5f}<br>"
                "Quality: %{y}<extra></extra>"
            ),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Cost / call (USD)", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Quality score", range=[0, 100],
                   gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def projection_chart(results: list[dict], tasks: int) -> go.Figure:
    fig = go.Figure()
    fig.add_traces([
        go.Bar(
            name="Output tokens", x=[r["effort"] for r in results],
            y=[r["out_tokens"] for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            yaxis="y1", text=[f"{r['out_tokens']:,}" for r in results],
            textposition="outside", width=0.35, offset=-0.2,
        ),
        go.Bar(
            name=f"Daily cost ({tasks:,} tasks)",
            x=[r["effort"] for r in results],
            y=[r["cost_usd"] * tasks for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            marker_opacity=0.45, yaxis="y2",
            text=[f"${r['cost_usd']*tasks:.4f}" for r in results],
            textposition="outside", width=0.35, offset=0.2,
        ),
    ])
    fig.update_layout(
        barmode="group", plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        yaxis=dict(title="Output tokens", gridcolor="rgba(128,128,128,0.15)"),
        yaxis2=dict(title="Daily cost (USD)", overlaying="y", side="right"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def breakeven_chart(results: list[dict]) -> go.Figure:
    volumes = list(range(100, 5001, 100))
    fig = go.Figure()
    for r in results:
        fig.add_trace(go.Scatter(
            x=volumes, y=[r["cost_usd"] * v for v in volumes],
            mode="lines", name=r["effort"].capitalize(),
            line=dict(color=EFFORT_COLORS[r["effort"]], width=2.5),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Tasks / day", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Daily cost (USD)", gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig
Setiap bagan menjawab pertanyaan yang berbeda tentang tiga titik data yang sama.
quality_tradeoff_chart memplot biaya pada sumbu x dan skor kualitas pada sumbu y, sehingga bentuk frontier langsung terlihat.
projection_chart mengambil jangkar biaya per panggilan dari hasil API dan mengalikannya dengan nilai slider tasks-per-day, sehingga setiap batang mencerminkan jumlah token, bukan perkiraan.
breakeven_chart menggeser dari 100 hingga 5.000 tugas per hari menggunakan jangkar biaya nyata yang sama, sehingga garis-garisnya menyimpang pada laju yang didasari respons API. Tim yang menjalankan 500 tugas per hari melihat gambaran biaya yang sangat berbeda dibanding tim yang menjalankan 5.000, dan bagan ini membuatnya konkret.
Pada langkah berikutnya, kita akan menyambungkan ketiga fungsi bagan ini ke UI Streamlit dan menghubungkannya ke hasil API langsung.
Bagian terakhir adalah antarmuka Streamlit. Sidebar menangani pemuatan kunci, input prompt, dan slider tasks-per-day. Panel utama menjalankan panggilan secara berurutan dan memperbarui kartu progres saat setiap panggilan selesai.
def main():
    api_key = os.getenv("ANTHROPIC_API_KEY", "").strip()
    with st.sidebar:
        st.title("Opus 4.8 Effort Dial")
        st.divider()
        if api_key:
            st.success("Key loaded.")
        else:
            st.error("Missing ANTHROPIC_API_KEY. Set it in your .env file.")
        prompt = st.text_area(
            "Prompt (runs at all 3 effort levels)",
            value=DEFAULT_PROMPT, height=220,
        )
        run = st.button("▶ Run 3 calls", use_container_width=True, type="primary")
        st.divider()
        tasks = st.slider("Tasks / day", min_value=10, max_value=5000, value=500, step=10)
    if "results" not in st.session_state:
        st.session_state.results = []
    for effort, default in DEFAULT_QUALITY.items():
        if f"quality_{effort}" not in st.session_state:
            st.session_state[f"quality_{effort}"] = default
    if run:
        if not api_key:
            st.error("Set ANTHROPIC_API_KEY first.")
            st.stop()
        client = anthropic.Anthropic(api_key=api_key)
        collected = []
        progress   = st.progress(0, text="Starting calls…")
        cols       = st.columns(3)
        holders    = {e: cols[i].empty() for i, e in enumerate(EFFORT_ORDER)}
        for i, effort in enumerate(EFFORT_ORDER):
            holders[effort].info(f"**{effort.upper()}** — calling…")
            progress.progress(i / 3, text=f"Running {effort} effort…")
            try:
                result = call_opus(client, effort, prompt)
                try:
                    scored = score_response_with_haiku(
                        client, prompt, result["response"], effort
                    )
                    result.update(scored)
                    st.session_state[f"quality_{effort}"] = scored["score"]
                    score_line = f"auto-score: {scored['score']}/100"
                except Exception as e:
                    result["score_error"] = str(e)
                    score_line = "auto-score unavailable"
                collected.append(result)
                holders[effort].success(
                    f"**{effort.upper()}**\n\n"
                    f"{result['out_tokens']:,} output tokens\n\n"
                    f"{result['latency_ms']/1000:.2f}s\n\n"
                    f"${result['cost_usd']:.5f} / call\n\n"
                    f"{score_line}"
                )
            except Exception as exc:
                holders[effort].error(f"**{effort.upper()}** failed: {exc}")
            progress.progress((i + 1) / 3)
        st.session_state.results = sorted(
            collected, key=lambda r: EFFORT_ORDER.index(r["effort"])
        )
        progress.empty()
    st.header("Opus 4.8 Effort Dial: Quality vs. Cost Tradeoff")
    results = st.session_state.results
    if not results:
        st.info("Set your API key and click **▶ Run 3 calls** to start.")
        st.stop()
    if any(r.get("hit_token_cap") for r in results):
        st.warning(
            f"One or more calls hit the {MAX_OUTPUT_TOKENS:,}-token cap. "
            "Raise MAX_OUTPUT_TOKENS if medium and high still look similar."
        )
    scorer_spend = sum(r.get("scorer_cost_usd", 0) for r in results)
    if scorer_spend > 0:
        st.caption(
            f"Auto-scoring used {SCORER_MODEL} and added "
            f"${scorer_spend:.6f} across all three responses."
        )
    # Per-call metric cards
    st.subheader("Per-call results")
    scores = {e: int(st.session_state.get(f"quality_{e}", DEFAULT_QUALITY[e]))
              for e in EFFORT_ORDER}
    mcols = st.columns(3)
    for row, col in zip(results, mcols):
        effort = row["effort"]
        with col:
            st.metric(f"{effort.UPPER()} effort", f"{row['out_tokens']:,} output tokens")
            st.caption(
                f"Input: {row['in_tokens']:,} · "
                f"Latency: {row['latency_ms']/1000:.2f}s · "
                f"Cost: ${row['cost_usd']:.5f} · "
                f"Stop: {row.get('stop_reason', 'n/a')}"
            )
            st.slider(
                f"Quality score — {effort.UPPER()}",
                min_value=0, max_value=100,
                value=DEFAULT_QUALITY[effort],
                key=f"quality_{effort}",
            )
            if row.get("rationale"):
                st.caption(f"Auto-scored by {SCORER_MODEL}: {row['rationale']}")
    st.divider()
    # Tabs
    t1, t2, t3, t4 = st.tabs(
        ["Quality vs cost", "Volume projection", "Raw responses", "Raw data"]
    )
    with t1:
        left, right = st.columns([1.1, 1], gap="large")
        with left:
            st.plotly_chart(quality_tradeoff_chart(results, scores),
                            use_container_width=True)
        with right:
            low  = next((r for r in results if r["effort"] == "low"),  None)
            med  = next((r for r in results if r["effort"] == "medium"), None)
            high = next((r for r in results if r["effort"] == "high"), None)
            if low and med and high:
                st.markdown("#### Read on the current anchor set")
                st.write(
                    f"Low → medium adds **${med['cost_usd'] - low['cost_usd']:.5f}** per call "
                    f"for **{scores['medium'] - scores['low']}** quality points."
                )
                st.write(
                    f"Medium → high adds **${high['cost_usd'] - med['cost_usd']:.5f}** per call "
                    f"for **{scores['high'] - scores['medium']}** more quality points."
                )
                st.write(
                    f"High vs low: **${high['cost_usd'] - low['cost_usd']:.5f}** "
                    f"total per-call delta."
                )
                st.caption(
                    "Quality scores are auto-generated by Haiku 4.5 using a rubric, "
                    "but you can override them with the sliders above."
                )
    with t2:
        st.plotly_chart(projection_chart(results, tasks), use_container_width=True)
        st.plotly_chart(breakeven_chart(results), use_container_width=True)
        if low and high:
            daily_delta   = (high["cost_usd"] - low["cost_usd"]) * tasks
            monthly_delta = daily_delta * 30
            st.caption(
                f"High vs low at {tasks:,} tasks/day: "
                f"**+${daily_delta:.4f}/day** · **+${monthly_delta:.2f}/month**"
            )
    with t3:
        for row in results:
            with st.expander(
                f"{row['effort'].upper()} — {row['out_tokens']:,} tokens",
                expanded=True,
            ):
                if row.get("rationale"):
                    st.info(
                        f"Auto-score: **{scores[row['effort']]}/100**. "
                        f"{row['rationale']}"
                    )
                st.markdown(row["response"])
    with t4:
        df = pd.DataFrame([{
            "Effort":            r["effort"],
            "Quality score":     scores[r["effort"]],
            "Input tokens":      r["in_tokens"],
            "Output tokens":     r["out_tokens"],
            "Latency (s)":       round(r["latency_ms"] / 1000, 2),
            "Cost / call ($)":   round(r["cost_usd"], 6),
            "Auto-score cost ($)": round(r.get("scorer_cost_usd", 0), 6),
            f"Daily @ {tasks} tasks ($)": round(r["cost_usd"] * tasks, 4),
            f"Monthly @ {tasks} tasks/day ($)": round(r["cost_usd"] * tasks * 30, 2),
        } for r in results])
        st.dataframe(df, use_container_width=True, hide_index=True)
        st.download_button(
            "Download CSV",
            df.to_csv(index=False),
            file_name="effort_dial_results.csv",
            mime="text/csv",
        )
if __name__ == "__main__":
    main()
Sidebar menangani semua konfigurasi, termasuk memuat kunci API, input prompt, dan slider tasks-per-day, menjaga panel utama tetap bersih untuk hasil. Panel utama dibagi menjadi empat tab untuk menjaga alur kerja tetap terstruktur.
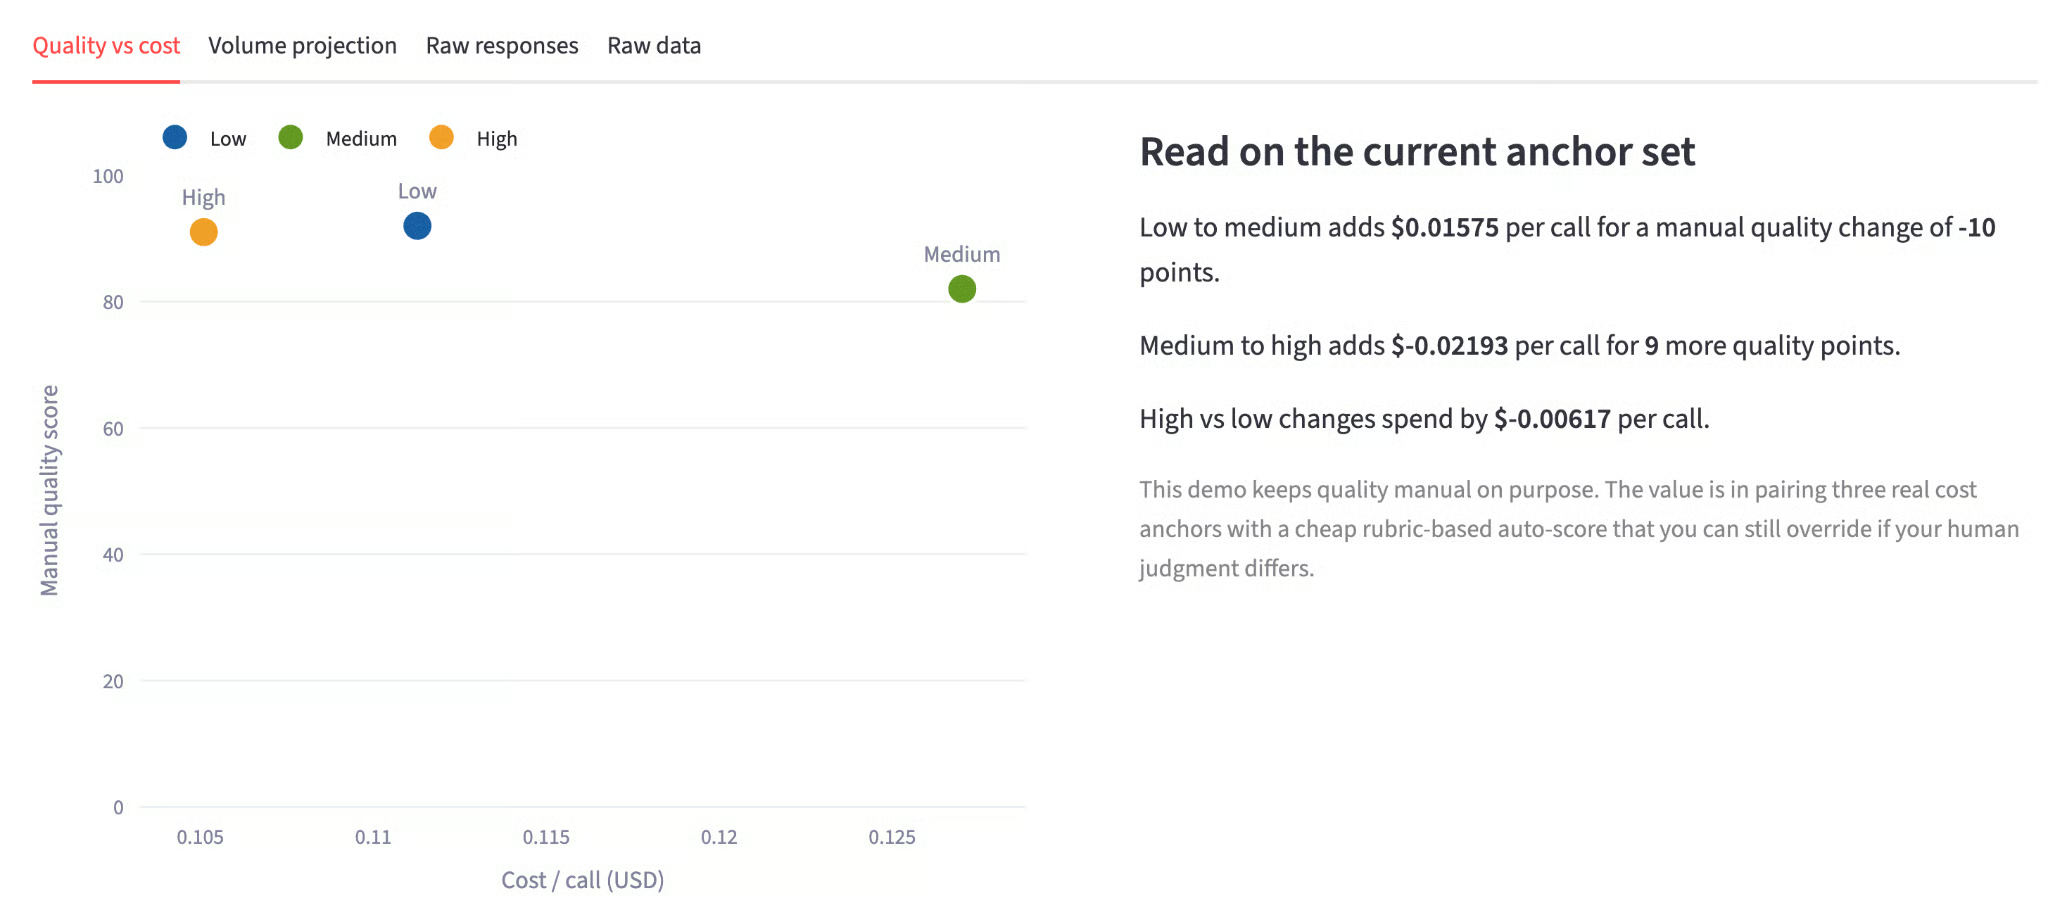
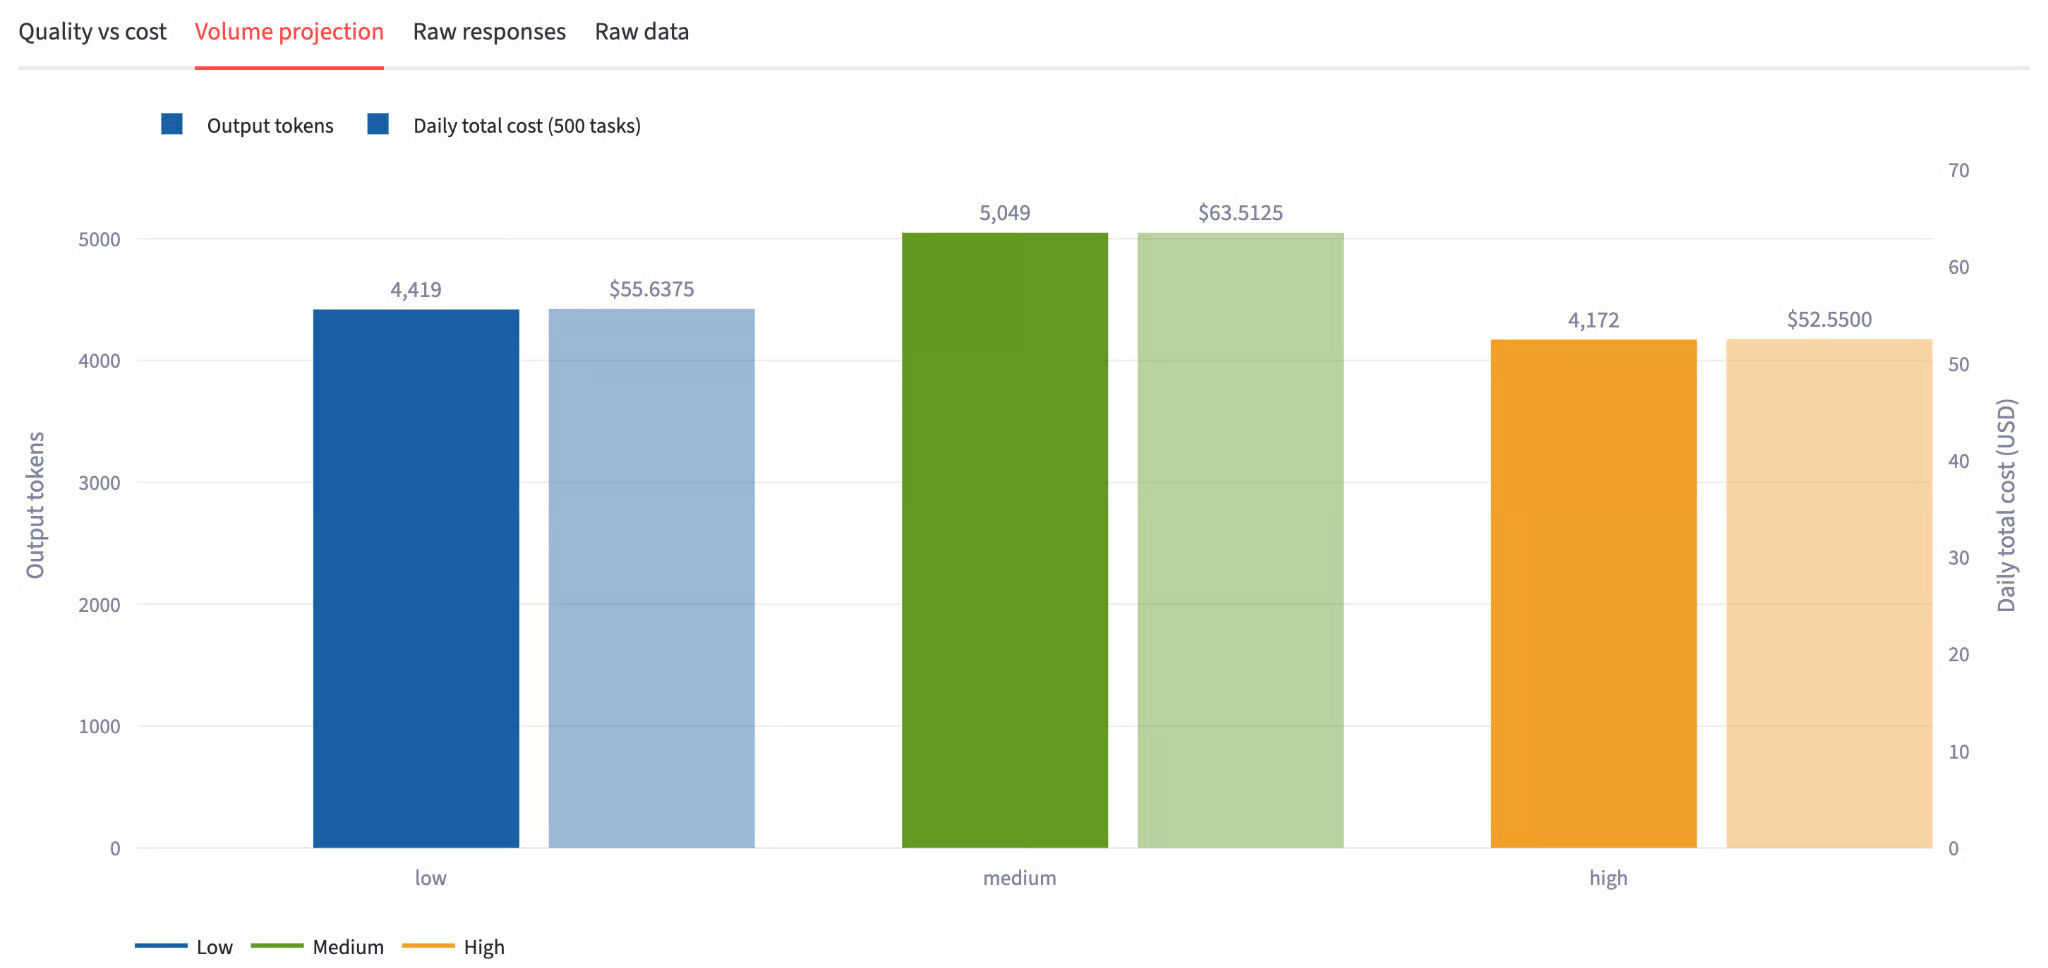
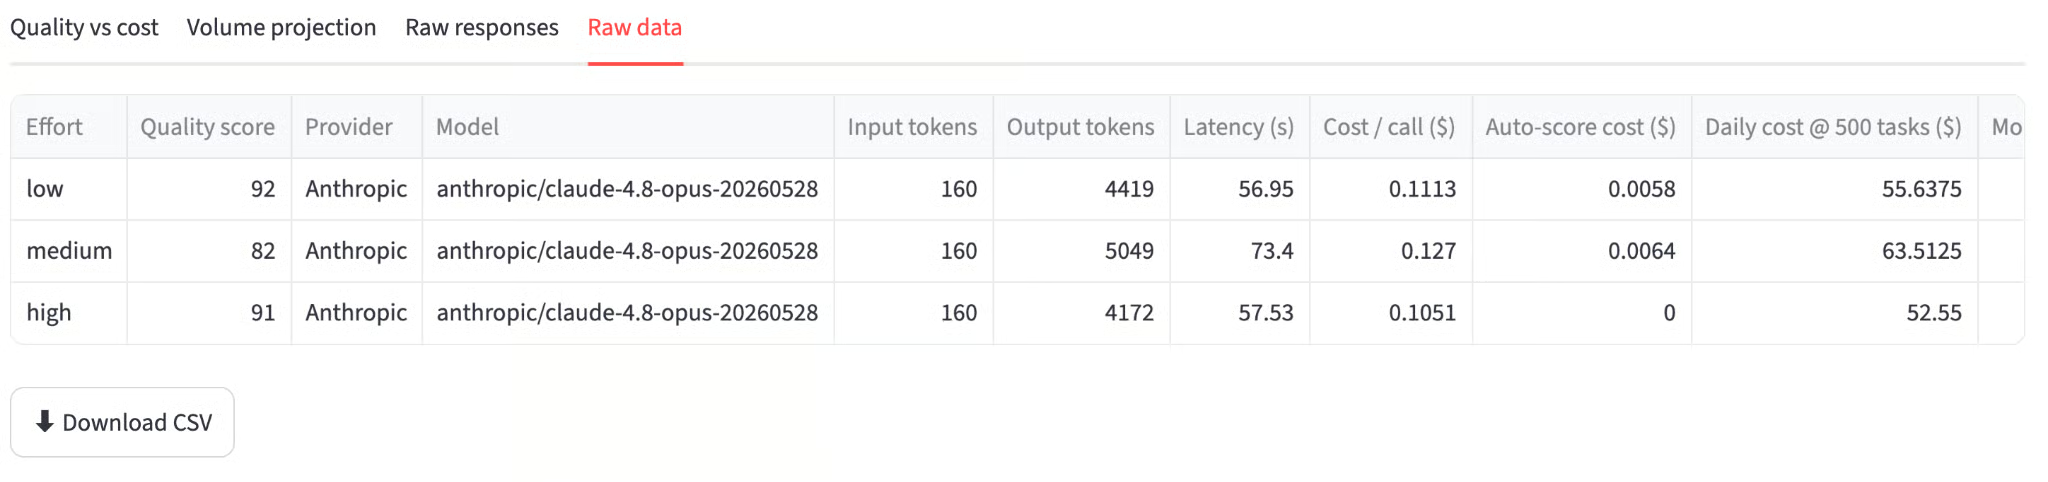
Dengan backend, bagan, dan UI yang sudah siap, aplikasi siap dijalankan.
Mulai server Streamlit:
streamlit run effort_dial.pyBuka http://localhost:8501 dan tetap prompt default atau ganti dengan sesuatu dari pipeline Anda sendiri, lalu klik Run 3 calls.
Aplikasi menjalankan setiap tingkat effort secara berurutan, menampilkan kartu status setelah masing-masing selesai. Setelah ketiganya selesai, aplikasi menjalankan tiga panggilan penilaian Haiku dan mengisi bagan. Total waktu wall-clock biasanya 2–3 menit untuk prompt default, sebagian besar untuk panggilan ber-effort tinggi.
Berikut angka dari salah satu run perwakilan pada prompt rate-limiting:
|
Effort |
Output tokens |
Latency |
Cost/call |
Auto-score |
|
Low |
3.276 |
46 dtk |
$0,0827 |
72/100 |
|
Medium |
5.109 |
70 dtk |
$0,1285 |
82/100 |
|
High |
5.382 |
71 dtk |
$0,1354 |
92/100 |
Berikut beberapa hal yang menonjol:
Jumlah token terurut (3.276 -> 5.109 -> 5.382) dengan end_turn sebagai alasan stop pada ketiganya. Ini mengonfirmasi parameter effort diterapkan dengan benar dan respons selesai secara alami.
Lompatan kualitas dari low ke medium (+10 poin) berbiaya $0,046 per panggilan. Lompatan dari medium ke high (+10 poin) hanya berbiaya $0,007. Medium menangkap sebagian besar kenaikan kualitas dengan sekitar enam kali biaya tambahan yang lebih rendah daripada langkah terakhir ke high.
Diagram sebar membuat asimetri ini langsung terlihat. Low berada di kiri bawah, murah tetapi kurang lengkap. Medium berada di tengah diagram. High berada di kanan atas, namun hanya sedikit lebih mahal daripada medium karena perbedaan jumlah token antara dua tingkat tersebut kecil pada prompt ini.
Alasan dari penilai Haiku juga informatif. Pada respons low, ia mencatat: "kedalaman teknis kuat pada pemilihan algoritme dan skrip Lua, tetapi kurang logika routing pod-ke-shard yang konkret dan detail tentang bagaimana sharding dikoordinasikan antar pod." Pada high: "respons luar biasa yang mencakup kelima persyaratan dengan kedalaman setara produksi, dengan skrip EVALSHA dan contoh kondisi batas yang konkret."
Dalam tutorial ini, kita membangun aplikasi Streamlit yang menjalankan tiga panggilan API Claude Opus 4.8 nyata (satu per tingkat effort) yang menilai otomatis setiap respons dengan Haiku 4.5, dan memproyeksikan biaya di seluruh volume tugas Anda.
Gagasan intinya adalah effort dan thinking: {type: "adaptive"} bekerja bersama untuk mengontrol kedalaman penalaran, bahwa model juri murah dapat menggantikan penilaian manual dengan rubrik yang dapat diulang dengan biaya yang dapat diabaikan. Kita juga melihat bahwa frontier biaya-kualitas tidak linear, yakni medium menangkap sebagian besar kenaikan kualitas dengan sebagian kecil dari biaya tambahan pada high.
Pada 1.000 tugas per hari, beralih dari high ke medium menghemat sekitar $207/bulan dengan penurunan skor kualitas sekitar 10 poin pada rubrik 100 poin. Untuk tugas yang ruang lingkupnya jelas seperti klasifikasi, ekstraksi, atau rangkuman, medium kemungkinan cukup. Namun, untuk tugas yang memerlukan penalaran teknis mendalam atau cakupan edge case yang komprehensif, seperti code review, desain arsitektur, dan analisis kebijakan, effort high sepadan dengan biayanya.
Beberapa pengembangan lanjutan termasuk menambahkan jenis prompt kedua untuk menunjukkan bagaimana delta effort menyusut ketika masalah tidak memerlukan penalaran mendalam, atau menambahkan tampilan respons berdampingan yang menyoroti secara tepat di mana effort tinggi menambahkan detail konkret yang luput pada medium.
Belajar AI bersama DataCamp!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




