
Cursus
Introductie tot Claude-modellen
3 uur
14.7K
Claude Opus 4.8 heeft een effort-parameter toegevoegd waarmee je de redeneer-diepte per request kunt regelen. Zie het als een draaiknop met drie standen:
low: Het model reageert directer en gebruikt minder thinking-tokens, geschikt voor goed afgebakende, feitelijke of gestructureerde taken.
medium: Een tussenweg waarbij het model zorgvuldiger redeneert, maar randgevallen niet uitputtend verkent.
high: Dit is de standaard van het model, met verhoogde denkdiepte; het best voor complexe redenering, meerstaps ontwerpproblemen en taken waarbij een gemist randgeval kostbaar is.
xhigh: Ontworpen voor agentische taken en coding op lange horizon die over veel stappen consistente coherentie vereisen.
max: Het absolute maximale capaciteitsniveau, waarbij het volledige compute-budget wordt gereserveerd voor de meest veeleisende taken.
De effort-parameter werkt alleen samen met thinking: {type: "adaptive"}. Adaptief denken laat het model per beurt beslissen of diepe redenering nodig is. Samen geven ze je zinvolle controle over hoe het model zijn compute-budget besteedt.
Deze tutorial focust op low, medium en high, de drie niveaus die het meest relevant zijn voor algemene productie-werkstromen, maar dezelfde app-structuur werkt ook als je wilt uitbreiden naar xhigh of max.
Die hoogste effort-niveaus zijn gebouwd voor langdurig agentisch werk — het type dat we stap voor stap behandelen in onze tutorial Spec-driven development met Claude Code.
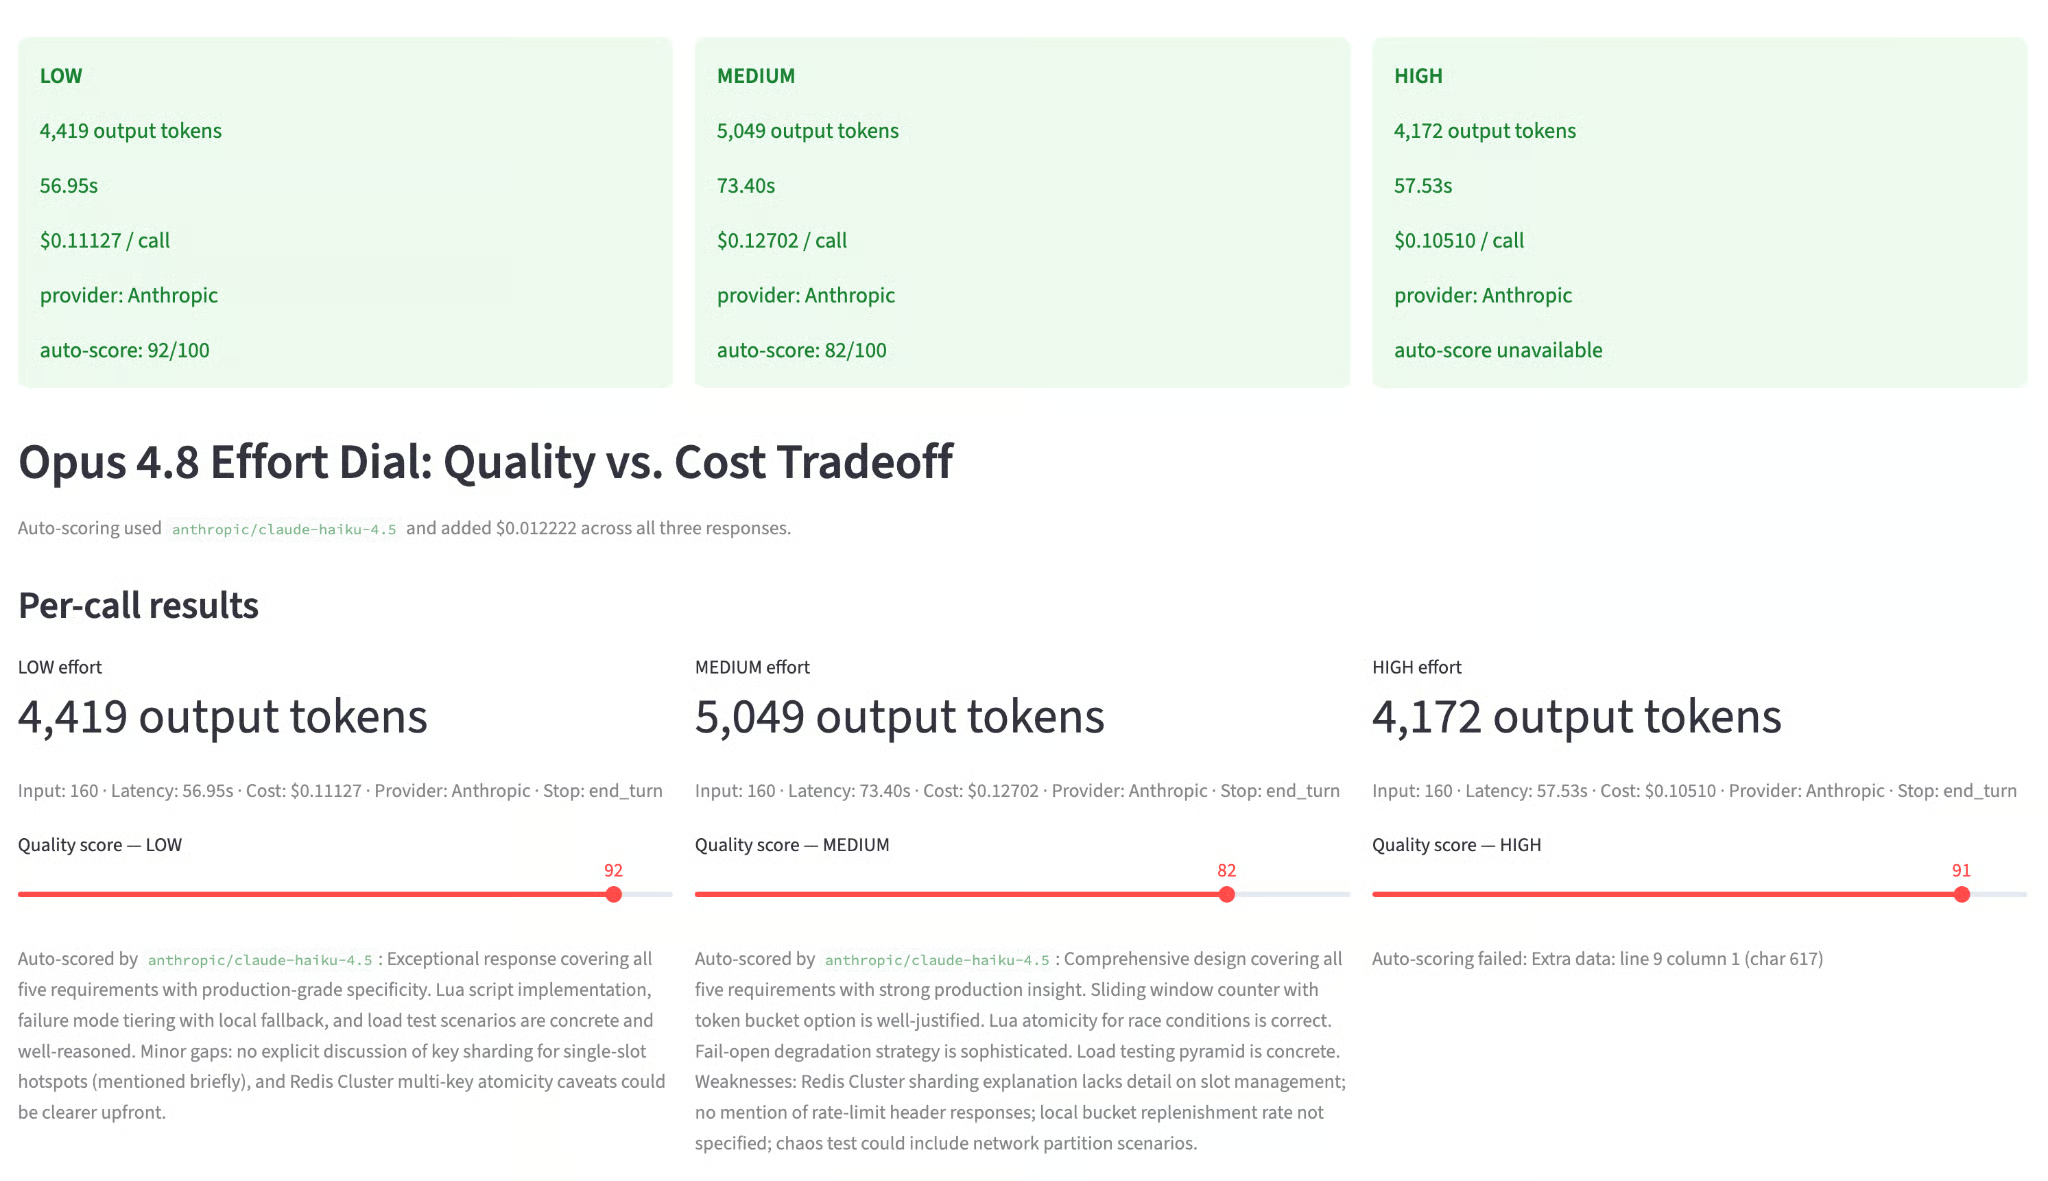
De app is één Python-bestand. Wanneer je het draait, zie je een zijbalk met een prompt-invoer en een slider voor taken per dag, en een hoofdscherm met vier tabs:
De workflow per run is:
claude-opus-4-8 met effort ingesteld op respectievelijk low, medium en highclaude-haiku-4-5 als rubriek-gebaseerde beoordelaarDe standaardprompt is een vraag over distributed systems design die natuurlijk schaalt met het effort-niveau.
Om deze tutorial te volgen, heb je nodig:
Python 3.10 of later
Een Anthropic API-sleutel met toegang tot claude-opus-4-8
Basiskennis van Streamlit
Maak een virtual environment en installeer de vereiste packages:
bashpython -m venv .venv
source .venv/bin/activate
pip install anthropic streamlit plotly pandas python-dotenv
Onder Windows gebruik je .venv\Scripts\activate in plaats van source .venv/bin/activate.
Voeg je Anthropic API-sleutel toe aan een .env-bestand in de projectroot:
.env
ANTHROPIC_API_KEY=sk-ant-...
Zodra de omgeving is ingesteld, definiëren we het effort_dial-schema voor de UI.
Maak een bestand met de naam effort_dial.py en voeg bovenaan het configuratieblok toe:
import os
import time
import json
import re
import anthropic
import pandas as pd
import plotly.graph_objects as go
import streamlit as st
from dotenv import load_dotenv

load_dotenv()
st.set_page_config(
    page_title="Opus 4.8 Effort Dial — Claude Opus 4.8",
    layout="wide",
)
MODEL              = "claude-opus-4-8"
SCORER_MODEL       = "claude-haiku-4-5"
MAX_OUTPUT_TOKENS  = 16000
SCORER_MAX_TOKENS  = 500
PRICE_OUT_PER_TOK        = 25 / 1_000_000
PRICE_IN_PER_TOK         = 5  / 1_000_000
SCORER_PRICE_OUT_PER_TOK = 5  / 1_000_000
SCORER_PRICE_IN_PER_TOK  = 1  / 1_000_000
EFFORT_ORDER  = ["low", "medium", "high"]
EFFORT_COLORS = {"low": "#185FA5", "medium": "#639922", "high": "#EF9F27"}
DEFAULT_QUALITY = {"low": 68, "medium": 82, "high": 91}
De MAX_OUTPUT_TOKENS staat op 16.000 in plaats van de standaard 4.096. Dit is belangrijk omdat bij een limiet van 4.096 tokens zowel medium als high op hetzelfde punt worden afgekapt, waardoor elk zichtbaar verschil verdwijnt. Je hebt genoeg ruimte nodig zodat de responses zich natuurlijk kunnen onderscheiden.
De stopreden end_turn in de uiteindelijke output, in plaats van max_tokens, bevestigt ook dat het model op eigen voorwaarden klaar was.
Een eenvoudige prompt zoals "leg recursie uit" geeft op alle drie effort-niveaus vergelijkbare antwoorden, omdat er niets lastig genoeg is om diepe redenering te triggeren. Daarom gebruikten we in plaats daarvan een meerledige systems design-vraag:
DEFAULT_PROMPT = """\
Design a production-ready rate-limiting system for a distributed API gateway
handling 100k requests/second. Cover:
1. Algorithm choice (token bucket vs sliding window vs leaky bucket) with tradeoffs
2. Redis data structure design and TTL strategy
3. Race condition handling across 50 pods
4. Failure mode behavior when Redis is unavailable
5. How you'd test this under load
Be specific about implementation details, not just concepts.
"""
Deze prompt heeft vijf afzonderlijke deelproblemen. Benaderingen met lage effort behandelen ze meestal oppervlakkig: ze raken de hoofdconcepten maar slaan implementatiedetails over. Hoge effort dekt randvoorwaarden, bevat Lua-scriptvoorbeelden, bespreekt EVALSHA-atomiciteit en voegt een loadtestplan toe met concrete drempels.
Definieer nu de kernfunctie die het model aanroept. De twee cruciale details hier zijn thinking={"type": "adaptive"} en output_config={"effort": effort}:
def call_opus(client: anthropic.Anthropic, effort: str, prompt: str) -> dict:
    t0 = time.perf_counter()
    response = client.messages.create(
        model=MODEL,
        max_tokens=MAX_OUTPUT_TOKENS,
        thinking={"type": "adaptive"},
        output_config={"effort": effort},
        # Do NOT set temperature, top_p, or top_k — those 400-error on Opus 4.8
        messages=[{"role": "user", "content": prompt}],
    )
    latency_ms = (time.perf_counter() - t0) * 1000
    in_tok  = response.usage.input_tokens
    out_tok = response.usage.output_tokens
    text = next(
        (b.text for b in response.content if b.type == "text"), "(no text block)"
    )
    return {
        "effort":        effort,
        "in_tokens":     in_tok,
        "out_tokens":    out_tok,
        "latency_ms":    latency_ms,
        "cost_usd":      in_tok * PRICE_IN_PER_TOK + out_tok * PRICE_OUT_PER_TOK,
        "response":      text,
        "stop_reason":   response.stop_reason,
        "hit_token_cap": out_tok >= MAX_OUTPUT_TOKENS,
    }
Laten we de belangrijkste keuzes in deze functie doornemen.
thinking={"type": "adaptive"}: Dit is vereist om de effort-parameter enig effect te laten hebben. Zonder dit gedragen alle drie de calls zich identiek, ongeacht welke effort je meegeeft. Adaptief denken laat het model per beurt beslissen of diepe redenering nodig is en bepaalt vervolgens hoeveel budget het toewijst als het redeneert.
output_config={"effort": effort}: Zo laat de Anthropic Python SDK je parameters doorgeven die nog niet als benoemde argumenten beschikbaar zijn. Intern voegt het de dict samen met de ruwe API-request body voordat deze wordt verzonden.
time.perf_counter(): Deze methode wordt gebruikt voor wall-clock latency in plaats van time.time(), omdat perf_counter een hogere resolutie heeft en niet wordt beïnvloed door aanpassingen van de systeemtijd.
response.content: Opus 4.8 met adaptief denken kan meerdere contentblokken teruggeven, waaronder een thinking-blok met de interne redeneerketen van het model en een tekstblok met de uiteindelijke respons. Voor weergave willen we alleen het tekstblok. De next()-aanroep slaat het thinking-blok over en haalt alleen het antwoord voor de gebruiker op.
hit_token_cap: Dit is een diagnostische vlag die op True staat wanneer out_tokens gelijk is aan MAX_OUTPUT_TOKENS. Als dit True is voor medium of high, betekent het dat de respons halverwege is afgekapt.
Handmatig drie lange responses per run beoordelen is traag en subjectief. Geef elke respons in plaats daarvan door aan Claude Haiku 4.5 met een rubriek en laat die een gestructureerde JSON-score teruggeven.
Eén model gebruiken om een ander te beoordelen is een vorm van LLM-as-a-judge-evaluatie; onze gids LLM Evaluation behandelt hoe je rubrieken ontwerpt die je daadwerkelijk kunt vertrouwen.
De rubriek splitst kwaliteit op in vier deelpunten:
Deze sluiten direct aan bij wat effort-niveaus onderscheidt op een systems design-prompt:
def score_response_with_haiku(client: anthropic.Anthropic, original_prompt: str,
                               response_text: str, effort: str) -> dict:
    rubric = (
        "You are grading an answer to a difficult systems design prompt. "
        "Score the response from 0 to 100 using this rubric: "
        "completeness 30 points, technical correctness 30 points, "
        "edge-case coverage 20 points, implementation specificity 20 points. "
        "Return strict JSON only with keys: score, rationale, completeness, "
        "correctness, edge_cases, specificity. "
        "The rationale must be concise, concrete, and no more than 80 words."
    )
    grader_prompt = (
        f"{rubric}\n\n"
        f"Original prompt:\n{original_prompt}\n\n"
        f"Effort level being graded: {effort}\n\n"
        f"Candidate response:\n{response_text}"
    )
    result = client.messages.create(
        model=SCORER_MODEL,
        max_tokens=SCORER_MAX_TOKENS,
        messages=[{"role": "user", "content": grader_prompt}],
    )
    raw    = next((b.text for b in result.content if b.type == "text"), "")
    parsed = extract_json_object(raw)
    in_tok  = result.usage.input_tokens
    out_tok = result.usage.output_tokens
    score = max(0, min(100, int(round(float(parsed["score"])))))
    return {
        "score":     score,
        "rationale": str(parsed.get("rationale", "")).strip(),
        "subscores": {
            "completeness": parsed.get("completeness"),
            "correctness":  parsed.get("correctness"),
            "edge_cases":   parsed.get("edge_cases"),
            "specificity":  parsed.get("specificity"),
        },
        "scorer_model":      SCORER_MODEL,
        "scorer_cost_usd":   in_tok * SCORER_PRICE_IN_PER_TOK + out_tok * SCORER_PRICE_OUT_PER_TOK,
        "scorer_in_tokens":  in_tok,
        "scorer_out_tokens": out_tok,
    }
De helper extract_json behandelt gevallen waarin Haiku zijn JSON-uitvoer soms in Markdown fences verpakt. Dit is een veelvoorkomende faalmodus bij het prompten van kleinere modellen.
De totale beoordelingskosten over alle drie de responses liggen doorgaans onder $0,002. Het is een verwaarloosbare overhead die een subjectieve handmatige stap vervangt door een herhaalbare rubriek.
De app heeft drie grafieken:
Laten we elk van deze grafieken bouwen:
def quality_tradeoff_chart(results: list[dict], scores: dict) -> go.Figure:
    fig = go.Figure()
    for r in results:
        effort = r["effort"]
        fig.add_trace(go.Scatter(
            x=[r["cost_usd"]],
            y=[scores[effort]],
            mode="markers+text",
            name=effort.capitalize(),
            text=[effort.capitalize()],
            textposition="top center",
            marker=dict(size=18, color=EFFORT_COLORS[effort],
                        line=dict(color="white", width=2)),
            hovertemplate=(
                "<b>%{text}</b><br>"
                "Cost / call: $%{x:.5f}<br>"
                "Quality: %{y}<extra></extra>"
            ),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Cost / call (USD)", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Quality score", range=[0, 100],
                   gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def projection_chart(results: list[dict], tasks: int) -> go.Figure:
    fig = go.Figure()
    fig.add_traces([
        go.Bar(
            name="Output tokens", x=[r["effort"] for r in results],
            y=[r["out_tokens"] for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            yaxis="y1", text=[f"{r['out_tokens']:,}" for r in results],
            textposition="outside", width=0.35, offset=-0.2,
        ),
        go.Bar(
            name=f"Daily cost ({tasks:,} tasks)",
            x=[r["effort"] for r in results],
            y=[r["cost_usd"] * tasks for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            marker_opacity=0.45, yaxis="y2",
            text=[f"${r['cost_usd']*tasks:.4f}" for r in results],
            textposition="outside", width=0.35, offset=0.2,
        ),
    ])
    fig.update_layout(
        barmode="group", plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        yaxis=dict(title="Output tokens", gridcolor="rgba(128,128,128,0.15)"),
        yaxis2=dict(title="Daily cost (USD)", overlaying="y", side="right"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def breakeven_chart(results: list[dict]) -> go.Figure:
    volumes = list(range(100, 5001, 100))
    fig = go.Figure()
    for r in results:
        fig.add_trace(go.Scatter(
            x=volumes, y=[r["cost_usd"] * v for v in volumes],
            mode="lines", name=r["effort"].capitalize(),
            line=dict(color=EFFORT_COLORS[r["effort"]], width=2.5),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Tasks / day", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Daily cost (USD)", gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig
Elke grafiek beantwoordt een andere vraag over dezelfde drie datapunten.
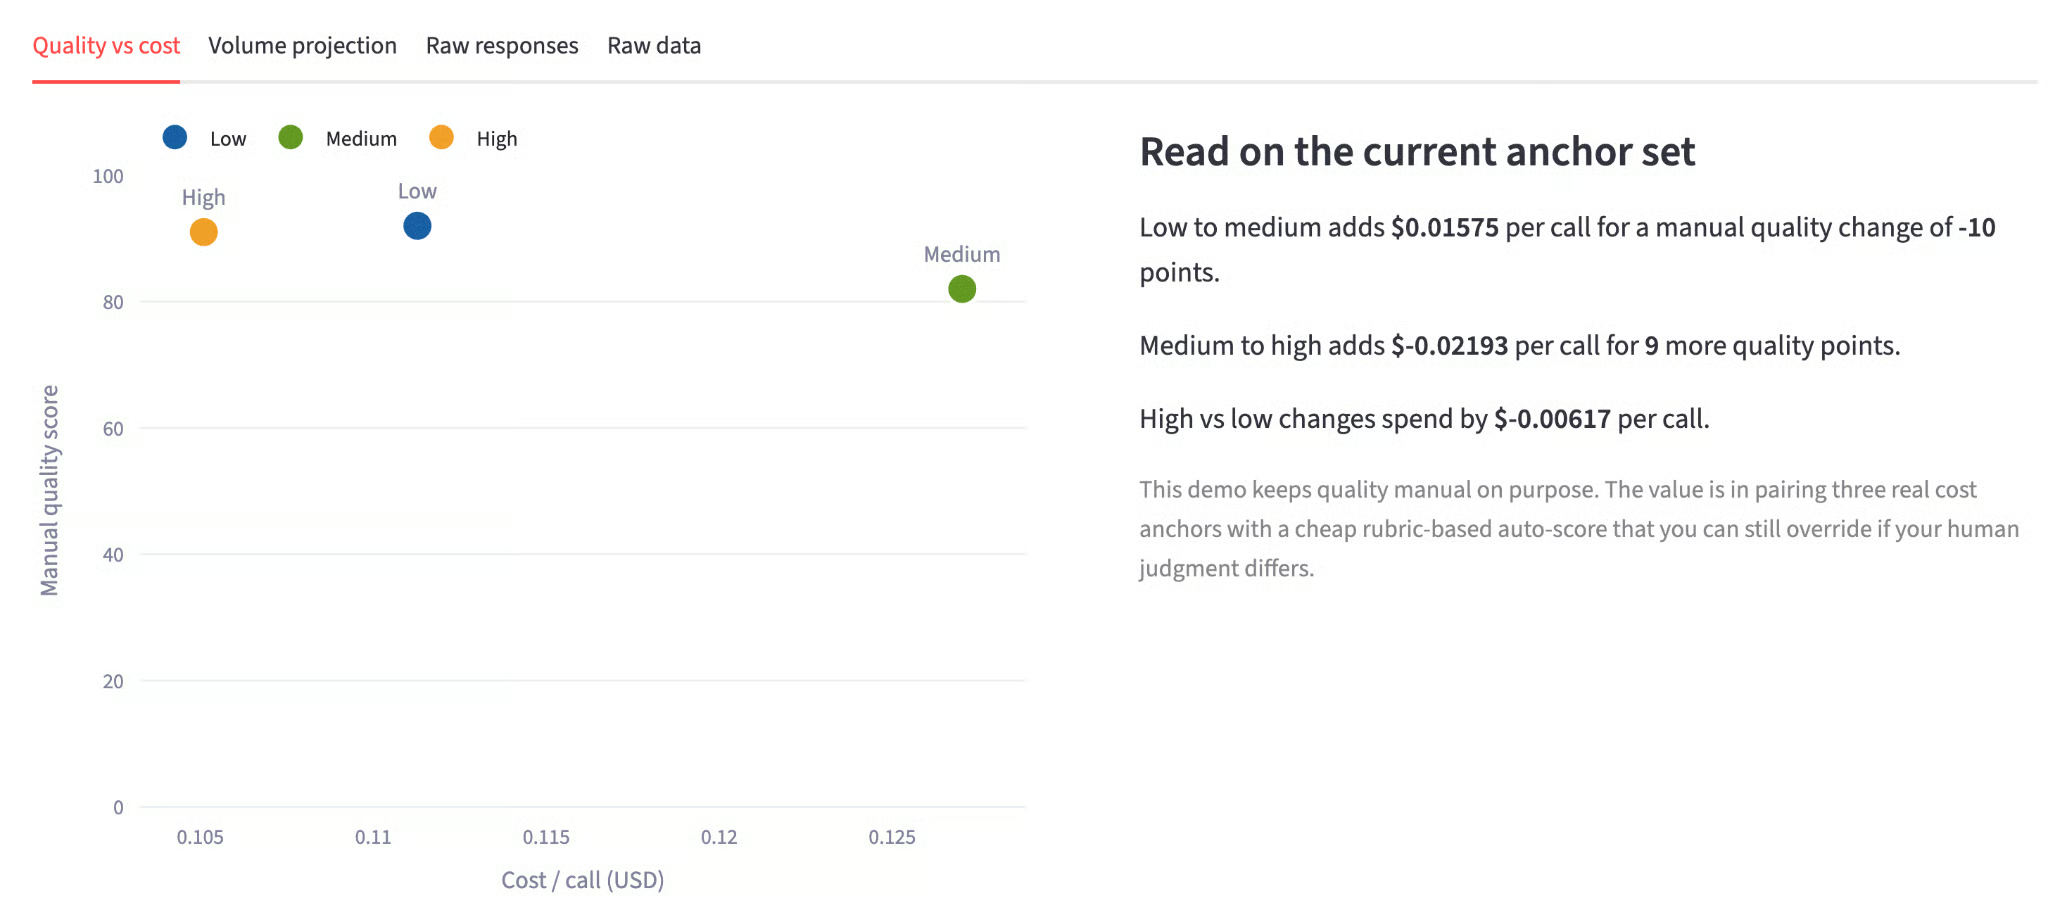
quality_tradeoff_chart zet kosten op de x-as en kwaliteitscore op de y-as, zodat de vorm van de frontier direct zichtbaar is.
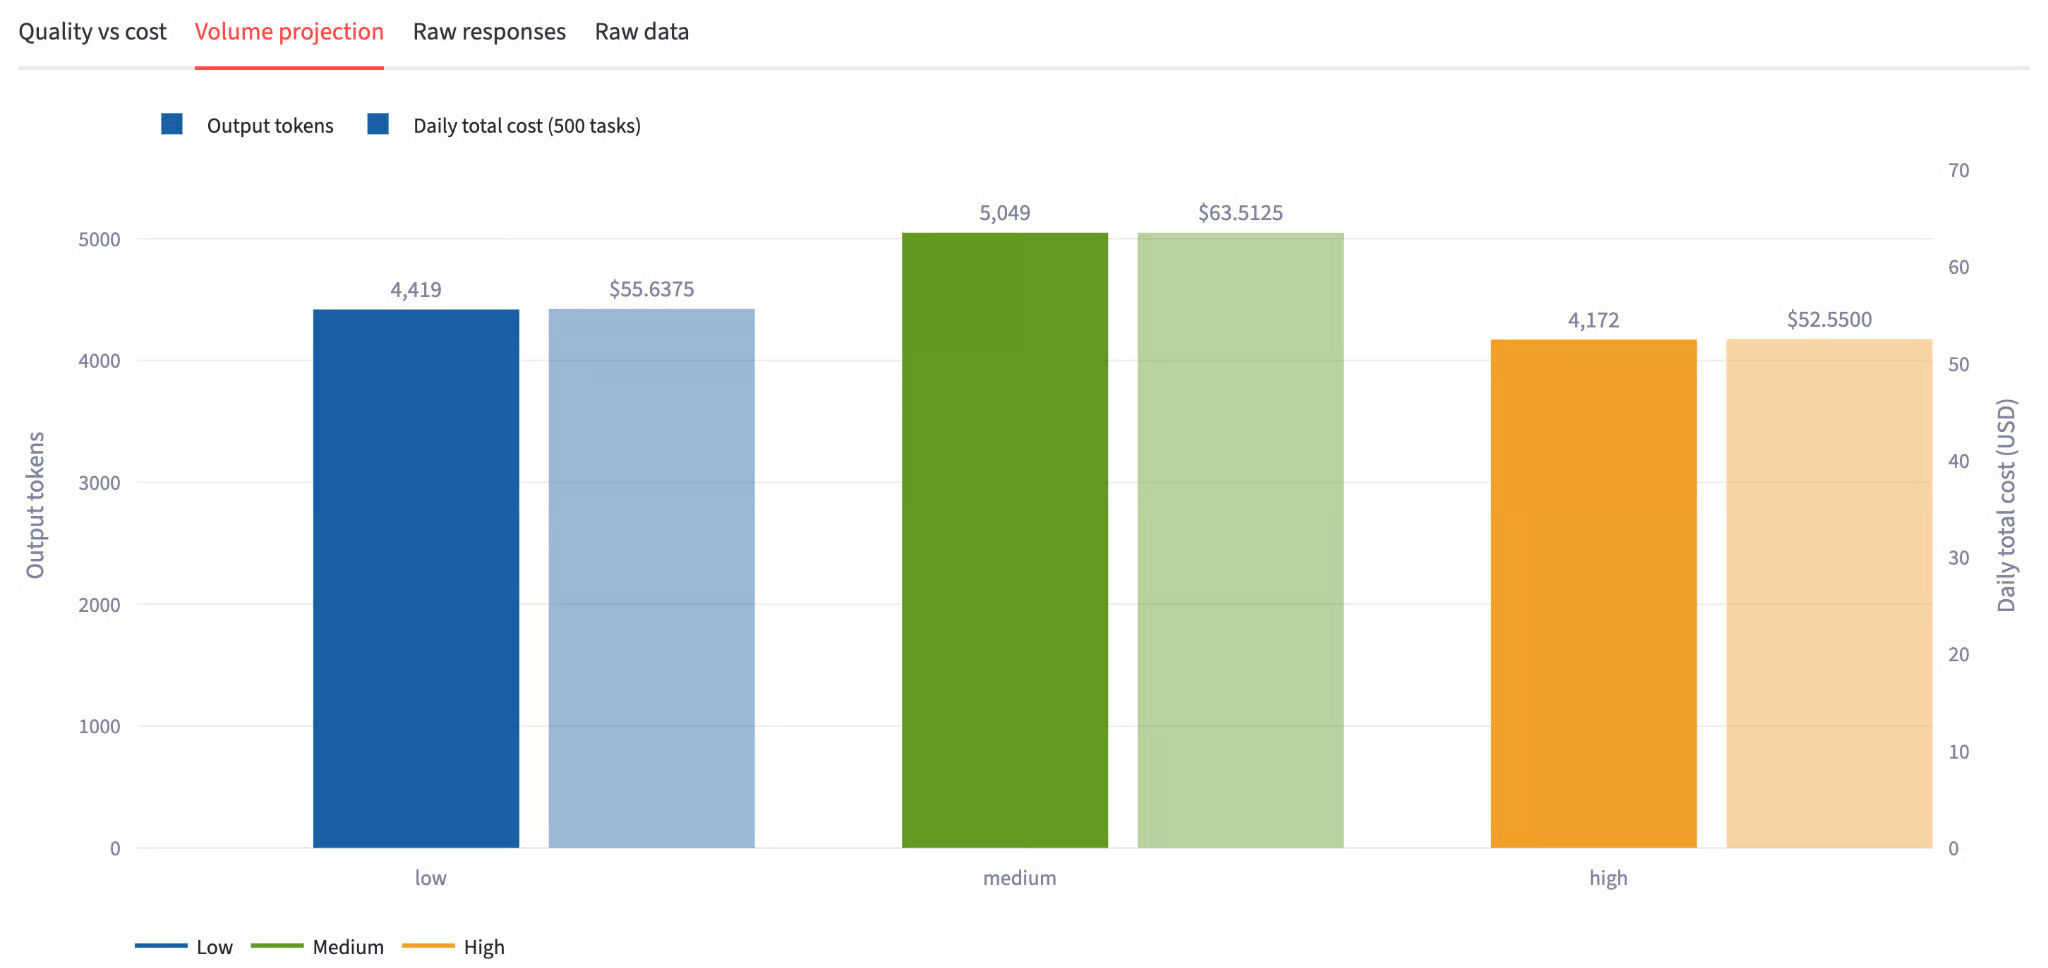
projection_chart neemt de kosten per call uit de API-resultaten en vermenigvuldigt die met de waarde van de slider voor taken per dag, zodat elke staaf een tokenaantal weerspiegelt in plaats van een schatting.
breakeven_chart veegt van 100 tot 5.000 taken per dag met dezelfde echte kosten-ankers, zodat de lijnen uiteengaan met een tempo dat verankerd is in API-responses. Een team dat 500 taken per dag draait, ziet een heel ander kostenplaatje dan een team met 5.000, en deze grafiek maakt dat concreet.
In de volgende stap koppelen we deze drie grafiekfuncties aan de Streamlit-UI en verbinden we ze met de live API-resultaten.
Het laatste onderdeel is de Streamlit-interface. De zijbalk regelt sleutelresolutie, prompt-invoer en de slider voor taken per dag. Het hoofdscherm voert de calls sequentieel uit en werkt voortgangskaarten bij zodra elke call klaar is.
def main():
    api_key = os.getenv("ANTHROPIC_API_KEY", "").strip()
    with st.sidebar:
        st.title("Opus 4.8 Effort Dial")
        st.divider()
        if api_key:
            st.success("Key loaded.")
        else:
            st.error("Missing ANTHROPIC_API_KEY. Set it in your .env file.")
        prompt = st.text_area(
            "Prompt (runs at all 3 effort levels)",
            value=DEFAULT_PROMPT, height=220,
        )
        run = st.button("▶ Run 3 calls", use_container_width=True, type="primary")
        st.divider()
        tasks = st.slider("Tasks / day", min_value=10, max_value=5000, value=500, step=10)
    if "results" not in st.session_state:
        st.session_state.results = []
    for effort, default in DEFAULT_QUALITY.items():
        if f"quality_{effort}" not in st.session_state:
            st.session_state[f"quality_{effort}"] = default
    if run:
        if not api_key:
            st.error("Set ANTHROPIC_API_KEY first.")
            st.stop()
        client = anthropic.Anthropic(api_key=api_key)
        collected = []
        progress   = st.progress(0, text="Starting calls…")
        cols       = st.columns(3)
        holders    = {e: cols[i].empty() for i, e in enumerate(EFFORT_ORDER)}
        for i, effort in enumerate(EFFORT_ORDER):
            holders[effort].info(f"**{effort.upper()}** — calling…")
            progress.progress(i / 3, text=f"Running {effort} effort…")
            try:
                result = call_opus(client, effort, prompt)
                try:
                    scored = score_response_with_haiku(
                        client, prompt, result["response"], effort
                    )
                    result.update(scored)
                    st.session_state[f"quality_{effort}"] = scored["score"]
                    score_line = f"auto-score: {scored['score']}/100"
                except Exception as e:
                    result["score_error"] = str(e)
                    score_line = "auto-score unavailable"
                collected.append(result)
                holders[effort].success(
                    f"**{effort.upper()}**\n\n"
                    f"{result['out_tokens']:,} output tokens\n\n"
                    f"{result['latency_ms']/1000:.2f}s\n\n"
                    f"${result['cost_usd']:.5f} / call\n\n"
                    f"{score_line}"
                )
            except Exception as exc:
                holders[effort].error(f"**{effort.upper()}** failed: {exc}")
            progress.progress((i + 1) / 3)
        st.session_state.results = sorted(
            collected, key=lambda r: EFFORT_ORDER.index(r["effort"])
        )
        progress.empty()
    st.header("Opus 4.8 Effort Dial: Quality vs. Cost Tradeoff")
    results = st.session_state.results
    if not results:
        st.info("Set your API key and click **▶ Run 3 calls** to start.")
        st.stop()
    if any(r.get("hit_token_cap") for r in results):
        st.warning(
            f"One or more calls hit the {MAX_OUTPUT_TOKENS:,}-token cap. "
            "Raise MAX_OUTPUT_TOKENS if medium and high still look similar."
        )
    scorer_spend = sum(r.get("scorer_cost_usd", 0) for r in results)
    if scorer_spend > 0:
        st.caption(
            f"Auto-scoring used {SCORER_MODEL} and added "
            f"${scorer_spend:.6f} across all three responses."
        )
    # Per-call metric cards
    st.subheader("Per-call results")
    scores = {e: int(st.session_state.get(f"quality_{e}", DEFAULT_QUALITY[e]))
              for e in EFFORT_ORDER}
    mcols = st.columns(3)
    for row, col in zip(results, mcols):
        effort = row["effort"]
        with col:
            st.metric(f"{effort.upper()} effort", f"{row['out_tokens']:,} output tokens")
            st.caption(
                f"Input: {row['in_tokens']:,} · "
                f"Latency: {row['latency_ms']/1000:.2f}s · "
                f"Cost: ${row['cost_usd']:.5f} · "
                f"Stop: {row.get('stop_reason', 'n/a')}"
            )
            st.slider(
                f"Quality score — {effort.upper()}",
                min_value=0, max_value=100,
                value=DEFAULT_QUALITY[effort],
                key=f"quality_{effort}",
            )
            if row.get("rationale"):
                st.caption(f"Auto-scored by {SCORER_MODEL}: {row['rationale']}")
    st.divider()
    # Tabs
    t1, t2, t3, t4 = st.tabs(
        ["Quality vs cost", "Volume projection", "Raw responses", "Raw data"]
    )
    with t1:
        left, right = st.columns([1.1, 1], gap="large")
        with left:
            st.plotly_chart(quality_tradeoff_chart(results, scores),
                            use_container_width=True)
        with right:
            low  = next((r for r in results if r["effort"] == "low"),  None)
            med  = next((r for r in results if r["effort"] == "medium"), None)
            high = next((r for r in results if r["effort"] == "high"), None)
            if low and med and high:
                st.markdown("#### Read on the current anchor set")
                st.write(
                    f"Low → medium adds **${med['cost_usd'] - low['cost_usd']:.5f}** per call "
                    f"for **{scores['medium'] - scores['low']}** quality points."
                )
                st.write(
                    f"Medium → high adds **${high['cost_usd'] - med['cost_usd']:.5f}** per call "
                    f"for **{scores['high'] - scores['medium']}** more quality points."
                )
                st.write(
                    f"High vs low: **${high['cost_usd'] - low['cost_usd']:.5f}** "
                    f"total per-call delta."
                )
                st.caption(
                    "Quality scores are auto-generated by Haiku 4.5 using a rubric, "
                    "but you can override them with the sliders above."
                )
    with t2:
        st.plotly_chart(projection_chart(results, tasks), use_container_width=True)
        st.plotly_chart(breakeven_chart(results), use_container_width=True)
        if low and high:
            daily_delta   = (high["cost_usd"] - low["cost_usd"]) * tasks
            monthly_delta = daily_delta * 30
            st.caption(
                f"High vs low at {tasks:,} tasks/day: "
                f"**+${daily_delta:.4f}/day** · **+${monthly_delta:.2f}/month**"
            )
    with t3:
        for row in results:
            with st.expander(
                f"{row['effort'].upper()} — {row['out_tokens']:,} tokens",
                expanded=True,
            ):
                if row.get("rationale"):
                    st.info(
                        f"Auto-score: **{scores[row['effort']]}/100**. "
                        f"{row['rationale']}"
                    )
                st.markdown(row["response"])
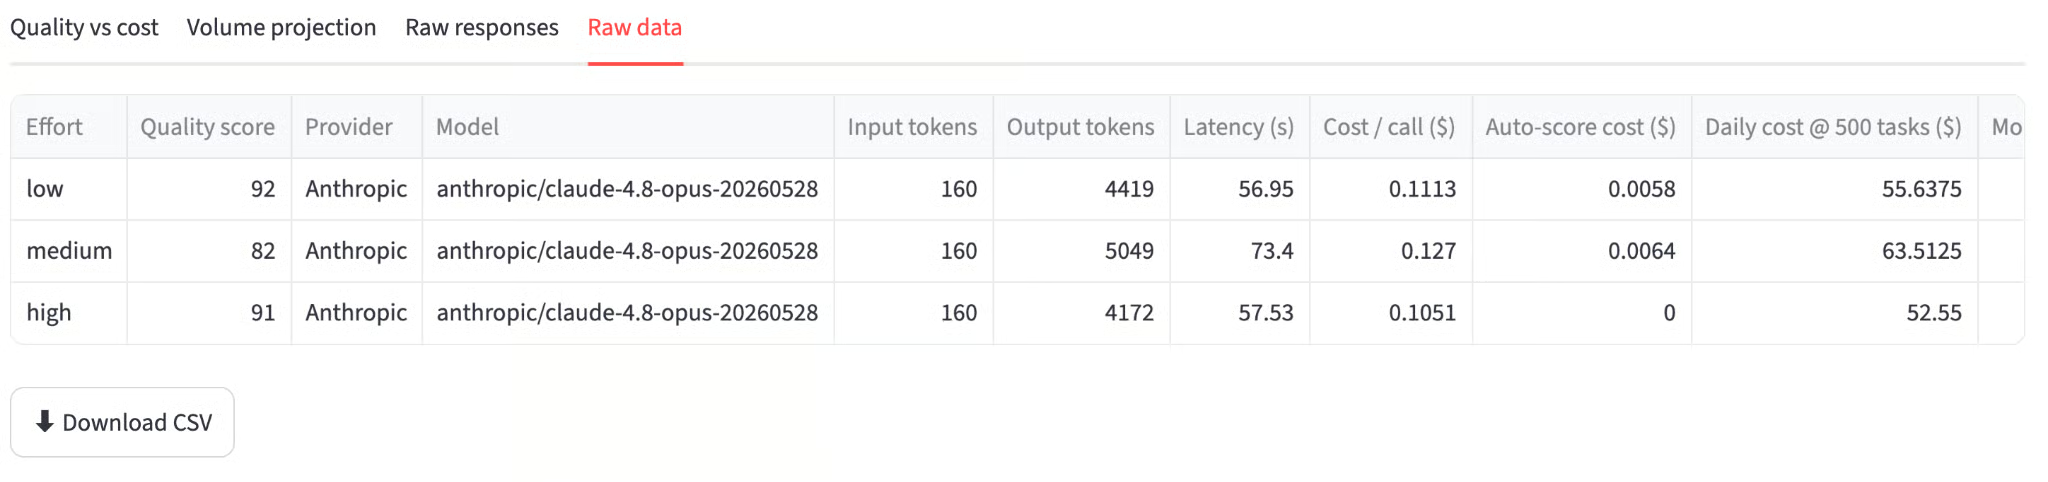
    with t4:
        df = pd.DataFrame([{
            "Effort":            r["effort"],
            "Quality score":     scores[r["effort"]],
            "Input tokens":      r["in_tokens"],
            "Output tokens":     r["out_tokens"],
            "Latency (s)":       round(r["latency_ms"] / 1000, 2),
            "Cost / call ($)":   round(r["cost_usd"], 6),
            "Auto-score cost ($)": round(r.get("scorer_cost_usd", 0), 6),
            f"Daily @ {tasks} tasks ($)": round(r["cost_usd"] * tasks, 4),
            f"Monthly @ {tasks} tasks/day ($)": round(r["cost_usd"] * tasks * 30, 2),
        } for r in results])
        st.dataframe(df, use_container_width=True, hide_index=True)
        st.download_button(
            "Download CSV",
            df.to_csv(index=False),
            file_name="effort_dial_results.csv",
            mime="text/csv",
        )
if __name__ == "__main__":
    main()
De zijbalk regelt alle configuratie, waaronder het laden van de API-sleutel, de promptinvoer en de slider voor taken per dag, zodat het hoofdscherm schoon blijft voor de resultaten. Het hoofdscherm is opgesplitst in vier tabs om de workflow gestructureerd te houden.
Met de backend, grafieken en UI op hun plek is de app klaar om te draaien.
Start de Streamlit-server:
streamlit run effort_dial.pyOpen http://localhost:8501 en houd de standaardprompt aan of vervang die door iets uit je eigen pijplijn, en klik vervolgens op Run 3 calls.
De app draait elk effort-niveau sequentieel en toont na elke call een statuskaart. Zodra alle drie klaar zijn, draait hij de drie Haiku-beoordelingscalls en vult hij de grafieken. De totale wall-clock tijd is meestal 2–3 minuten voor de standaardprompt, waarvan het grootste deel de high-effort call is.
Hier zijn de cijfers van een representatieve run op de rate-limiting-prompt:
|
Effort |
Output tokens |
Latency |
Kosten/call |
Auto-score |
|
Low |
3.276 |
46s |
$0,0827 |
72/100 |
|
Medium |
5.109 |
70s |
$0,1285 |
82/100 |
|
High |
5.382 |
71s |
$0,1354 |
92/100 |
Hier zijn een paar dingen die opvielen:
De tokenaantallen zijn geordend (3.276 -> 5.109 -> 5.382) met end_turn als stopreden bij alle drie. Dit bevestigt dat de effort-parameter correct landt en dat responses natuurlijk afronden.
De kwaliteitsstap van low naar medium (+10 punten) kost $0,046 per call. De stap van medium naar high (+10 punten) kost slechts $0,007. Medium pakt het grootste deel van de kwaliteitswinst mee tegen ongeveer zes keer minder incrementele kosten dan de laatste stap naar high.
De scatterplot maakt deze asymmetrie direct zichtbaar. Low zit linksonder: goedkoop maar minder compleet. Medium staat midden in de grafiek. High zit rechtsboven, maar slechts iets duurder dan medium omdat het verschil in tokenaantal tussen die twee niveaus bij deze prompt klein is.
De rationale van de Haiku-beoordelaar is ook leerzaam. Bij de low-respons merkte die op: "sterke technische diepgang bij algoritmekeuze en Lua-scripting, maar mist concrete pod-naar-shard-routeringslogica en details over hoe sharding over pods coördineert." Bij high: "uitzonderlijke respons die alle vijf vereisten dekt met productie-waardige diepgang, met EVALSHA-scripts en concrete randgevalvoorbeelden."
In deze tutorial hebben we een Streamlit-app gebouwd die drie echte Claude Opus 4.8 API-calls draait (één per effort-niveau), elke respons automatisch beoordeelt met Haiku 4.5 en kosten projecteert over jouw taakvolume.
De kernideeën waren dat effort en thinking: {type: "adaptive"} samenwerken om de redeneergraad te sturen, en dat een goedkoop beoordelingsmodel handmatige scoring kan vervangen door een herhaalbare rubriek tegen verwaarloosbare kosten. We zagen ook dat de kosten-kwaliteit-frontier niet lineair is; het medium-niveau pakt het grootste deel van de kwaliteitswinst mee tegen een fractie van de incrementele kosten van high.
Bij 1.000 taken per dag bespaart de switch van high naar medium ongeveer $207/maand met een kwaliteitsdaling van circa 10 punten op een 100-puntsrubriek. Voor goed afgebakende taken zoals classificatie, extractie of samenvatten is medium waarschijnlijk voldoende. Voor taken die diepe technische redenering of uitgebreide dekking van randgevallen vereisen, zoals code review, architectuurontwerp en beleidsanalyse, is de high-effort de kosten waard.
Uitbreidingen vanaf hier zijn onder meer een tweede prompttype toevoegen om te laten zien hoe het effort-verschil verdwijnt wanneer het probleem geen diepe redenering vereist, of een weergave naast elkaar die precies markeert waar high-effort concrete details toevoegt die medium mist.
Leer AI met DataCamp!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

