
Metrik Utama untuk Evaluasi LLM
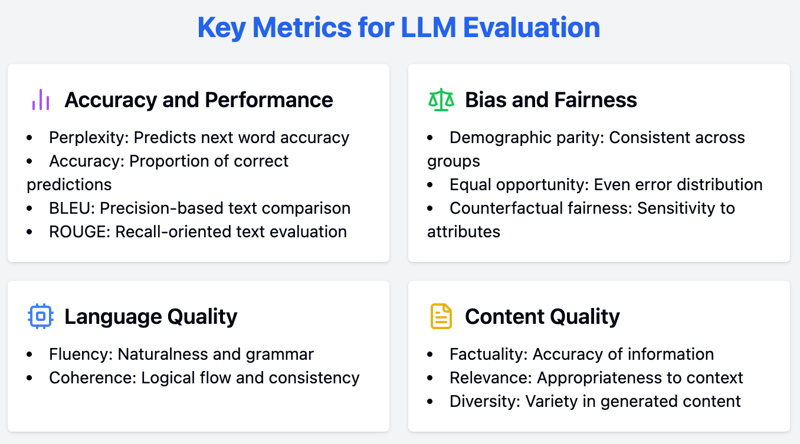
Mengevaluasi LLM memerlukan pendekatan komprehensif, dengan menggunakan berbagai ukuran untuk menilai beragam aspek kinerjanya. Dalam pembahasan ini, kita menelaah kriteria evaluasi utama untuk LLM, termasuk akurasi dan kinerja, bias dan keadilan, serta metrik penting lainnya.
Metrik akurasi dan kinerja
Mengukur kinerja secara akurat adalah langkah penting untuk memahami kapabilitas sebuah LLM. Bagian ini membahas metrik utama yang digunakan untuk mengevaluasi akurasi dan kinerja.
Perplexity
Perplexity adalah metrik mendasar untuk mengevaluasi dan mengukur kemampuan LLM memprediksi kata berikutnya dalam sebuah urutan. Berikut cara menghitungnya:
- Probabilitas: Pertama, model menghitung probabilitas setiap kata yang mungkin muncul berikutnya dalam sebuah kalimat.
- Probabilitas invers: Kita mengambil kebalikan dari probabilitas ini. Misalnya, jika sebuah kata memiliki probabilitas tinggi (artinya model menganggap kata itu mungkin), probabilitas inversnya akan lebih rendah.
- Normalisasi: Lalu kita merata-ratakan probabilitas invers ini untuk semua kata dalam himpunan uji (teks yang kita gunakan untuk menguji model).
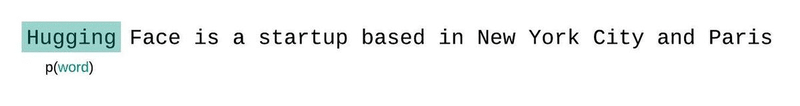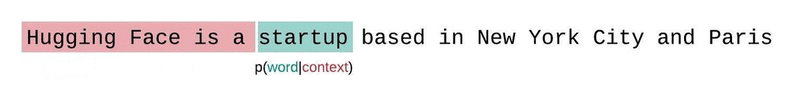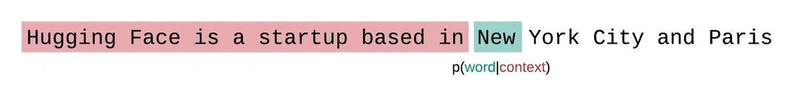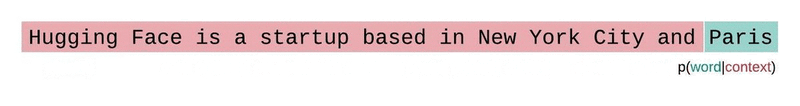
Ilustrasi LLM yang memprediksi probabilitas kata berikutnya berdasarkan konteks. Sumber
Skor perplexity yang lebih rendah menunjukkan bahwa model lebih akurat dalam memprediksi kata berikutnya, mencerminkan performa yang lebih baik. Intinya, metrik ini mengukur seberapa baik sebuah distribusi probabilitas atau model prediktif memprediksi sebuah sampel.
Untuk LLM, perplexity yang lebih rendah berarti model lebih yakin dalam prediksi katanya, menghasilkan teks yang lebih koheren dan sesuai konteks.
Akurasi
Akurasi adalah metrik yang banyak digunakan untuk tugas klasifikasi, yang merepresentasikan proporsi prediksi yang benar oleh model. Meski ini metrik yang umumnya intuitif, dalam konteks tugas generasi terbuka, metrik ini sering kali bisa menyesatkan.
Misalnya, saat menghasilkan teks kreatif atau bernuansa konteks, "kebenaran" keluaran tidak sesederhana definisinya seperti pada tugas analisis sentimen atau klasifikasi topik. Oleh karena itu, meskipun akurasi berguna untuk tugas tertentu, metrik ini perlu dilengkapi dengan metrik lain saat mengevaluasi LLM.
Skor BLEU/ROUGE
Skor BLEU (Bilingual Evaluation Understudy) dan ROUGE (Recall-Oriented Understudy for Gisting Evaluation) digunakan untuk mengevaluasi kualitas teks yang dihasilkan dengan membandingkannya dengan teks referensi.
BLEU berfokus pada presisi: jika terjemahan mesin menggunakan kata-kata yang persis sama seperti terjemahan manusia, skornya akan tinggi. Misalnya, jika referensi manusia adalah "The cat is on the mat," dan keluaran mesin adalah "The cat sits on the mat," skor BLEU akan tinggi karena banyak kata yang tumpang tindih.
ROUGE berfokus pada recall: metrik ini memeriksa apakah teks yang dihasilkan mesin menangkap semua gagasan penting dari referensi manusia. Misalnya, ringkasan buatan manusia adalah "The study found that people who exercise regularly tend to have lower blood pressure." Jika ringkasan yang dihasilkan AI adalah "Exercise linked to lower blood pressure," ROUGE akan memberi skor tinggi karena inti pesan tertangkap meski susunan kata berbeda.
Metrik ini bermanfaat untuk tugas seperti penerjemahan mesin, peringkasan, dan generasi teks, dengan menyediakan penilaian kuantitatif tentang seberapa dekat keluaran model dengan teks referensi buatan manusia.
Metrik bias dan keadilan
Memastikan keadilan dan mengurangi bias dalam LLM sangat penting untuk penerapan yang adil. Di sini, kami membahas metrik utama untuk mengevaluasi bias dan keadilan pada LLM.
Paritas demografis
Paritas demografis menunjukkan apakah kinerja model konsisten di berbagai kelompok demografis. Metrik ini mengevaluasi proporsi hasil positif di antara kelompok yang didefinisikan oleh atribut seperti ras, gender, atau usia.
Mencapai paritas demografis berarti prediksi model tidak bias terhadap kelompok tertentu, sehingga memastikan keadilan dalam penerapannya.
Kesetaraan peluang
Kesetaraan peluang berfokus pada apakah kesalahan model terdistribusi secara merata di berbagai kelompok demografis. Metrik ini menilai tingkat false negative untuk setiap kelompok, memastikan bahwa model tidak secara tidak proporsional gagal pada demografi tertentu.
Metrik ini sangat penting untuk aplikasi yang menuntut keadilan dan akses yang setara, seperti algoritme perekrutan atau proses persetujuan pinjaman.
Keadilan kontrafaktual
Keadilan kontrafaktual mengevaluasi apakah prediksi model akan berubah jika atribut sensitif tertentu berbeda. Ini melibatkan pembuatan contoh kontrafaktual di mana atribut sensitif (misalnya, gender atau ras) diubah sementara fitur lain tetap konstan.
Jika prediksi model berubah berdasarkan perubahan ini, itu menunjukkan adanya bias terkait atribut sensitif. Keadilan kontrafaktual penting untuk mengidentifikasi dan mengurangi bias yang mungkin tidak terlihat melalui metrik lainnya.
Metrik lainnya
Di luar kinerja dan keadilan, kriteria tambahan berguna untuk evaluasi LLM yang menyeluruh. Bagian ini menyoroti aspek-aspek tersebut.
Kefasihan
Kefasihan menilai keekonomisan bahasa dan ketepatan tata bahasa dari teks yang dihasilkan. LLM yang fasih menghasilkan keluaran yang mudah dibaca dan dipahami, meniru alur bahasa manusia.
Penilaian ini dapat dilakukan melalui alat otomatis atau penilaian manusia, dengan fokus pada aspek seperti tata bahasa, sintaksis, dan keterbacaan keseluruhan.
Koherensi
Koherensi membantu menganalisis alur logis dan konsistensi teks yang dihasilkan. Teks yang koheren mempertahankan struktur yang jelas dan perkembangan gagasan yang logis, sehingga mudah diikuti pembaca. Koherensi sangat penting untuk teks panjang, seperti esai atau artikel, di mana menjaga narasi yang konsisten adalah kunci.
Faktualitas
Faktualitas mengevaluasi ketepatan informasi yang diberikan oleh LLM, terutama pada tugas pencarian informasi. Metrik ini memastikan bahwa model menghasilkan teks yang tidak hanya masuk akal, tetapi juga faktual.
Faktualitas sangat penting untuk aplikasi seperti pembuatan berita, konten edukasi, dan dukungan pelanggan, di mana penyediaan informasi yang akurat adalah tujuan utama.
Metodologi Evaluasi
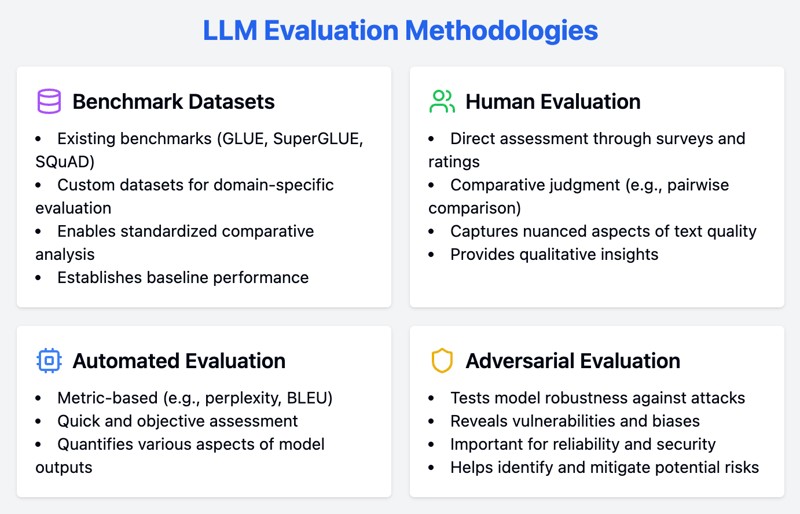
Evaluasi LLM yang kuat melibatkan penggabungan pendekatan kuantitatif dan kualitatif. Bagian ini merinci beragam metodologi, seperti dataset tolok ukur, teknik evaluasi manusia, dan metode evaluasi otomatis, untuk menilai kinerja LLM secara menyeluruh.
Dataset tolok ukur
Dataset tolok ukur adalah alat berharga untuk mengevaluasi LLM, menyediakan tugas standar yang memungkinkan analisis komparatif lintas model. Dataset ini membantu menetapkan baseline kinerja model dan memfasilitasi benchmarking.
Tolok ukur yang ada
Dataset tolok ukur penting untuk mengevaluasi LLM, menyediakan tugas standar yang memungkinkan analisis komparatif lintas model. Beberapa dataset tolok ukur paling populer untuk berbagai tugas pemrosesan bahasa alami (NLP) meliputi:
- GLUE (General Language Understanding Evaluation): Kumpulan tugas beragam yang dirancang untuk mengevaluasi kapabilitas linguistik umum LLM, termasuk analisis sentimen, entailment tekstual, dan tanya jawab.
- SuperGLUE: Versi lanjutan dari GLUE, terdiri atas tugas yang lebih menantang untuk menguji ketangguhan dan pemahaman bernuansa dari LLM.
- SQuAD (Stanford Question Answering Dataset): Dataset yang berfokus pada pemahaman bacaan, di mana model dinilai berdasarkan kemampuan menjawab pertanyaan yang berasal dari artikel Wikipedia.
Dataset kustom
Meskipun tolok ukur yang ada sangat berharga, membuat dataset kustom penting untuk evaluasi spesifik domain. Dataset kustom memungkinkan kita menyesuaikan proses evaluasi dengan kebutuhan dan tantangan unik dari aplikasi atau industri tertentu.
Sebagai contoh, sebuah organisasi kesehatan dapat membuat dataset catatan medis dan catatan klinis untuk mengevaluasi kemampuan LLM menangani terminologi dan konteks medis. Dataset kustom memastikan kinerja model selaras dengan kasus penggunaan nyata, memberikan wawasan yang lebih relevan dan dapat ditindaklanjuti.
Evaluasi oleh manusia
Metode evaluasi manusia sangat diperlukan untuk menilai aspek-aspek bernuansa dari keluaran LLM yang mungkin luput dari metrik otomatis. Teknik ini melibatkan umpan balik langsung dari penilai manusia, memberikan wawasan kualitatif tentang kinerja model.
Penilaian langsung
Evaluasi oleh manusia tetap menjadi standar emas untuk menilai kualitas keluaran LLM. Metode penilaian langsung melibatkan pengumpulan umpan balik dari penilai manusia menggunakan survei dan skala penilaian.
Metode ini dapat menangkap aspek-aspek bernuansa dari kualitas teks, seperti kefasihan, koherensi, dan relevansi, yang mungkin diabaikan oleh metrik otomatis. Penilai manusia dapat memberikan umpan balik kualitatif tentang kekuatan dan kelemahan spesifik, membantu mengidentifikasi area perbaikan.
Penilaian komparatif
Penilaian komparatif melibatkan teknik seperti perbandingan berpasangan, di mana evaluator manusia membandingkan keluaran dari model yang berbeda secara langsung. Metode ini bisa lebih andal daripada skala penilaian absolut, karena mengurangi subjektivitas yang terkait dengan penilaian individual.
Para penilai diminta memilih keluaran yang lebih baik dari pasangan teks yang dihasilkan, sehingga menghasilkan pemeringkatan relatif kinerja model. Penilaian komparatif sangat berguna untuk fine-tuning model dan memilih varian dengan performa terbaik.
Evaluasi otomatis
Metode evaluasi otomatis menyediakan cara cepat dan objektif untuk menilai kinerja LLM. Metode ini menggunakan berbagai metrik untuk mengkuantifikasi beragam aspek keluaran model, memastikan evaluasi yang komprehensif.
Berbasis metrik
Metrik otomatis menyediakan cara cepat dan objektif untuk mengevaluasi kinerja LLM. Metrik seperti perplexity dan BLEU banyak digunakan untuk menilai berbagai aspek generasi teks.
Seperti dibahas sebelumnya, perplexity mengukur kemampuan prediktif model, dengan skor lebih rendah menandakan kinerja yang lebih baik. Sementara itu, BLEU mengevaluasi kualitas teks yang dihasilkan dengan membandingkannya dengan teks referensi, berfokus pada presisi n-gram.
Evaluasi adversarial
Evaluasi adversarial melibatkan pemaparan LLM pada serangan adversarial untuk menguji ketangguhannya. Serangan ini dirancang untuk mengeksploitasi kelemahan dan bias dalam model, mengungkap kerentanan yang mungkin tidak terlihat melalui metode evaluasi standar.
Serangan adversarial dapat berupa pemberian masukan yang sedikit diubah atau menyesatkan untuk menganalisis respons model. Pendekatan ini berguna untuk aplikasi yang sangat menjunjung keandalan dan keamanan, karena membantu mengidentifikasi dan mengurangi potensi risiko.
Praktik Terbaik untuk Evaluasi LLM
Untuk menilai kapabilitas LLM secara efektif, diperlukan pendekatan strategis. Menerapkan praktik terbaik memastikan proses evaluasi Anda menyeluruh, transparan, dan disesuaikan dengan kebutuhan unik Anda. Di sini, kami membahas praktik terbaik yang perlu diikuti.
|
Praktik Terbaik |
Deskripsi |
Contoh Kasus |
Metrik Terkait |
|
Tentukan Tujuan yang Jelas |
Identifikasi tugas dan sasaran yang harus dicapai LLM sebelum memulai proses evaluasi. |
Meningkatkan performa penerjemahan mesin pada sebuah LLM |
Skor BLEU/ROUGE |
|
Pertimbangkan Audiens Anda |
Sesuaikan evaluasi dengan pengguna yang dituju dari LLM, mempertimbangkan ekspektasi dan kebutuhan mereka. |
LLM untuk menghasilkan teks |
Perplexity, Kefasihan, Koherensi |
|
Transparansi dan Reproduksibilitas |
Pastikan proses evaluasi terdokumentasi dengan baik dan dapat direplikasi oleh pihak lain untuk verifikasi dan perbaikan. |
Merilis secara publik dataset evaluasi dan kode yang digunakan untuk menilai kapabilitas LLM |
Metrik apa pun yang relevan, bergantung pada tugas dan sasaran evaluasi yang spesifik |
Kesimpulan
Panduan ini telah menyajikan tinjauan komprehensif tentang metrik dan metodologi penting untuk menilai LLM, mulai dari perplexity dan akurasi hingga ukuran bias dan keadilan.
Dengan menerapkan teknik evaluasi kuantitatif dan kualitatif serta mematuhi praktik terbaik, kita dapat memastikan penilaian model yang menyeluruh dan andal.
Dengan pengetahuan ini, kita lebih siap untuk memilih dan menerapkan LLM yang paling memenuhi kebutuhan kita, memastikan performa dan keandalannya optimal dalam aplikasi yang dipilih.

Lulusan MSc terbaru yang berspesialisasi dalam Kecerdasan Buatan




Large language models (LLMs) dengan cepat menjadi bagian integral dari berbagai aplikasi, mulai dari chatbot hingga pembuatan konten.
Namun, mengevaluasi model-model yang kuat ini menghadirkan tantangan. Bagaimana kita mengukur kinerja dan keandalannya secara akurat, mengingat beragam kapabilitas dan implementasinya?
Panduan ini memberikan tinjauan menyeluruh tentang evaluasi LLM, mencakup metrik penting, metodologi, dan praktik terbaik untuk membantu Anda membuat keputusan yang tepat tentang model mana yang paling sesuai dengan kebutuhan Anda.