Kurs
Einführung in die Claude-Modelle
3 Std.
14.4K
Claude Opus 4.8 hat einen effort-Parameter eingeführt, mit dem du die Reasoning-Tiefe pro Anfrage steuerst. Denk daran wie an einen Regler mit fünf Stufen:
low: Das Modell antwortet direkter und nutzt weniger Thinking-Tokens – ideal für klar abgegrenzte, faktische oder strukturierte Aufgaben.
medium: Der Mittelweg: sorgfältigeres Reasoning, ohne alle Randfälle vollständig auszureizen.
high: Standard des Modells – erhöhte Reasoning-Tiefe, geeignet für komplexes Reasoning, mehrstufige Designprobleme und Aufgaben, bei denen übersehene Randfälle teuer werden.
xhigh: Ausgelegt für langlaufende agentische und Coding-Aufgaben, die über viele Schritte kohärent bleiben müssen.
max: Das absolute Maximum – das volle Compute-Budget für die anspruchsvollsten Aufgaben.
Der effort-Parameter funktioniert nur zusammen mit thinking: {type: \"adaptive\"}. Adaptives Denken lässt das Modell pro Turn entscheiden, ob tiefes Reasoning nötig ist. Zusammen geben dir beide echte Kontrolle darüber, wie das Compute-Budget eingesetzt wird.
Dieses Tutorial konzentriert sich auf low, medium und high – die drei Stufen, die für generische Produktions-Workloads am relevantesten sind. Die gleiche App-Struktur gilt aber auch, wenn du auf xhigh oder max erweitern willst.
Die oberen Effort-Stufen sind für dauerhaft agentische Arbeit gedacht – wie im Tutorial Spec-Driven Development with Claude Code gezeigt.
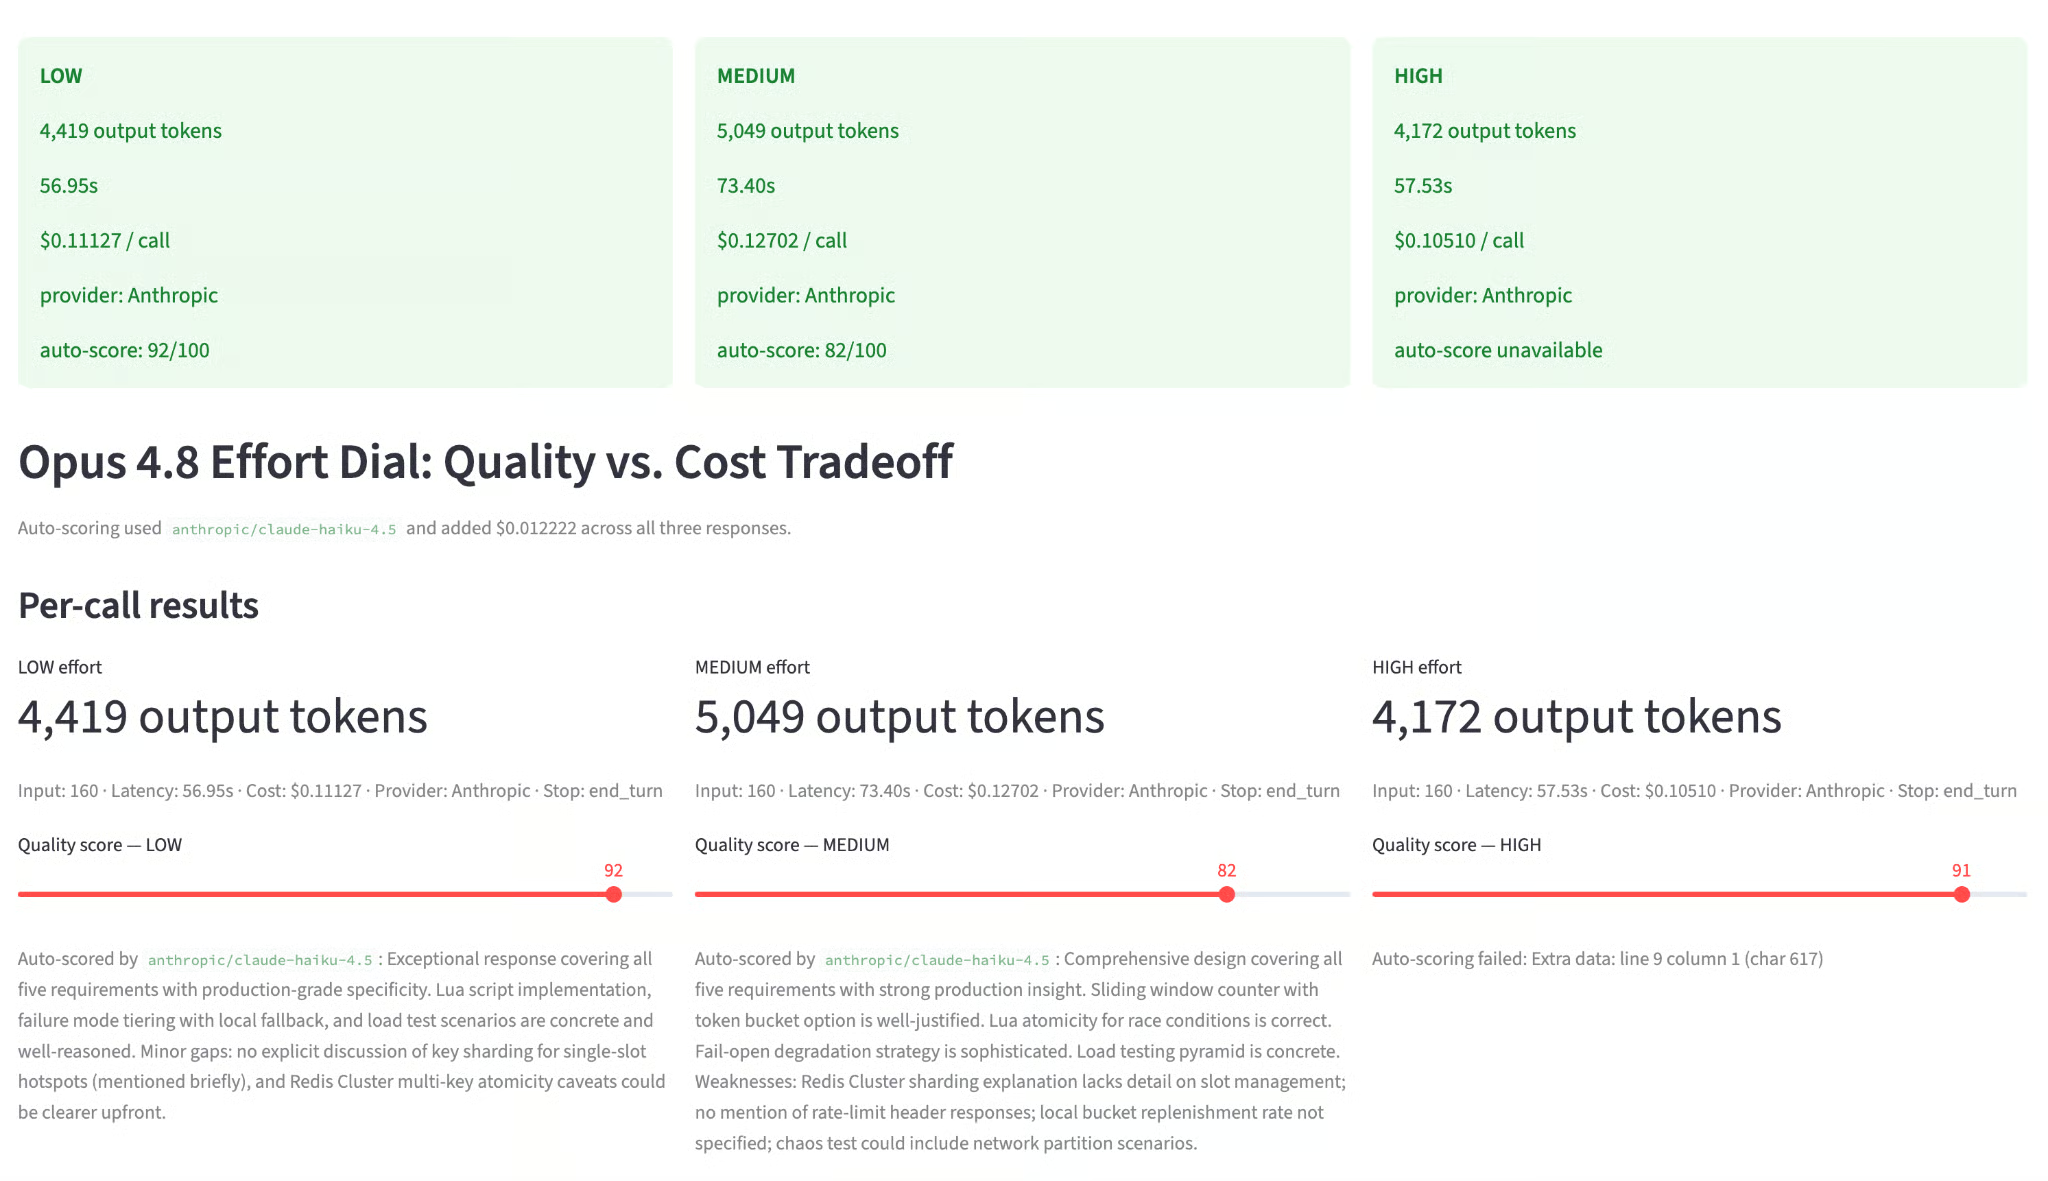
Die App besteht aus einer einzelnen Python-Datei. Beim Start siehst du eine Sidebar mit Prompt-Eingabe und einem Slider für Aufgaben pro Tag sowie ein Hauptpanel mit vier Tabs:
Der Ablauf pro Run ist:
claude-opus-4-8 mit effort auf low, medium und highclaude-haiku-4-5 als Rubrik-basierten Bewerter übergebenDer Standard-Prompt ist eine Distributed-Systems-Designfrage, die natürlich mit dem Effort-Level skaliert.
Du brauchst für dieses Tutorial:
Python 3.10 oder neuer
Einen Anthropic API-Key mit Zugriff auf claude-opus-4-8
Grundkenntnisse in Streamlit
Erstelle eine virtuelle Umgebung und installiere die benötigten Pakete:
bashpython -m venv .venv
source .venv/bin/activate
pip install anthropic streamlit plotly pandas python-dotenv
Unter Windows nutzt du .venv\Scripts\activate statt source .venv/bin/activate.
Füge deinen Anthropic API-Key in einer .env-Datei im Projektroot hinzu:
.env
ANTHROPIC_API_KEY=sk-ant-...
Sobald die Umgebung steht, definieren wir das effort_dial-Schema fürs UI.
Lege eine Datei effort_dial.py an und füge oben den Konfigurationsblock ein:
import os
import time
import json
import re
import anthropic
import pandas as pd
import plotly.graph_objects as go
import streamlit as st
from dotenv import load_dotenv

load_dotenv()
st.set_page_config(
    page_title="Opus 4.8 Effort Dial — Claude Opus 4.8",
    layout="wide",
)
MODEL              = "claude-opus-4-8"
SCORER_MODEL       = "claude-haiku-4-5"
MAX_OUTPUT_TOKENS  = 16000
SCORER_MAX_TOKENS  = 500
PRICE_OUT_PER_TOK        = 25 / 1_000_000
PRICE_IN_PER_TOK         = 5  / 1_000_000
SCORER_PRICE_OUT_PER_TOK = 5  / 1_000_000
SCORER_PRICE_IN_PER_TOK  = 1  / 1_000_000
EFFORT_ORDER  = ["low", "medium", "high"]
EFFORT_COLORS = {"low": "#185FA5", "medium": "#639922", "high": "#EF9F27"}
DEFAULT_QUALITY = {"low": 68, "medium": 82, "high": 91}
MAX_OUTPUT_TOKENS ist auf 16.000 statt auf den Standard 4.096 gesetzt. Das ist wichtig, weil bei 4.096 Tokens sowohl medium als auch high an derselben Stelle abgeschnitten würden – der Unterschied wäre nicht sichtbar. Du brauchst genug Spielraum, damit sich die Antworten natürlich auseinanderentwickeln.
Der Stop-Grund end_turn in der finalen Ausgabe (statt max_tokens) bestätigt außerdem, dass das Modell eigenständig abgeschlossen hat.
Ein einfacher Prompt wie „Erkläre Rekursion“ liefert auf allen drei Effort-Stufen ähnliche Antworten, weil nichts schwer genug ist, um tiefes Reasoning auszulösen. Daher nutzen wir stattdessen eine mehrteilige Systems-Design-Frage:
DEFAULT_PROMPT = """\
Design a production-ready rate-limiting system for a distributed API gateway
handling 100k requests/second. Cover:
1. Algorithm choice (token bucket vs sliding window vs leaky bucket) with tradeoffs
2. Redis data structure design and TTL strategy
3. Race condition handling across 50 pods
4. Failure mode behavior when Redis is unavailable
5. How you'd test this under load
Be specific about implementation details, not just concepts.
"""
Dieser Prompt enthält fünf Teilprobleme. Low-Effort-Ansätze streifen sie eher oberflächlich und treffen die Hauptkonzepte, lassen aber Implementierungsdetails aus. High-Effort deckt Randfälle ab, enthält Lua-Beispiele, diskutiert EVALSHA-Atomizität und ergänzt einen Lasttestplan mit konkreten Schwellwerten.
Jetzt definieren wir die Kernfunktion für den Modellaufruf. Entscheidend sind thinking={\"type\": \"adaptive\"} und output_config={\"effort\": effort}:
def call_opus(client: anthropic.Anthropic, effort: str, prompt: str) -> dict:
    t0 = time.perf_counter()
    response = client.messages.create(
        model=MODEL,
        max_tokens=MAX_OUTPUT_TOKENS,
        thinking={"type": "adaptive"},
        output_config={"effort": effort},
        # Do NOT set temperature, top_p, or top_k — those 400-error on Opus 4.8
        messages=[{"role": "user", "content": prompt}],
    )
    latency_ms = (time.perf_counter() - t0) * 1000
    in_tok  = response.usage.input_tokens
    out_tok = response.usage.output_tokens
    text = next(
        (b.text for b in response.content if b.type == "text"), "(no text block)"
    )
    return {
        "effort":        effort,
        "in_tokens":     in_tok,
        "out_tokens":    out_tok,
        "latency_ms":    latency_ms,
        "cost_usd":      in_tok * PRICE_IN_PER_TOK + out_tok * PRICE_OUT_PER_TOK,
        "response":      text,
        "stop_reason":   response.stop_reason,
        "hit_token_cap": out_tok >= MAX_OUTPUT_TOKENS,
    }
Die wichtigsten Entscheidungen in dieser Funktion:
thinking={\"type\": \"adaptive\"}: Pflicht, damit effort überhaupt wirkt. Ohne diese Einstellung verhalten sich alle drei Calls identisch, egal welcher effort-Wert gesetzt ist. Adaptives Denken entscheidet pro Turn über tieferes Reasoning und steuert dann das dafür genutzte Budget.
output_config={\"effort\": effort}: So übergibt das Anthropic-Python-SDK Parameter, die noch nicht als benannte Argumente verfügbar sind. Intern wird das Dict in den Roh-Request gemerged.
time.perf_counter(): Für die Wanduhr-Latenz statt time.time(), da perf_counter eine höhere Auflösung hat und nicht von Systemuhr-Anpassungen betroffen ist.
response.content: Opus 4.8 mit adaptivem Denken kann mehrere Content-Blöcke zurückgeben, u. a. einen Thinking-Block mit der internen Reasoning-Kette und einen Text-Block mit der finalen Antwort. Für die Anzeige wollen wir nur den Text-Block. Der next()-Aufruf überspringt den Thinking-Block.
hit_token_cap: Ein Diagnose-Flag, True, wenn out_tokens MAX_OUTPUT_TOKENS erreicht. Ist das bei medium oder high der Fall, wurde die Antwort abgeschnitten.
Drei lange Antworten pro Run manuell zu bewerten ist langsam und subjektiv. Stattdessen übergeben wir jede Antwort an Claude Haiku 4.5 mit einer Rubrik und lassen eine strukturierte JSON-Bewertung zurückgeben.
Ein Modell mit einem anderen zu bewerten ist LLM-as-a-judge. Unsere Anleitung zur LLM-Evaluation zeigt, wie du verlässliche Rubriken entwirfst.
Die Rubrik teilt Qualität in vier Teilwerte auf:
Das spiegelt direkt wider, was die Effort-Stufen bei einem Systems-Design-Prompt unterscheidet:
def score_response_with_haiku(client: anthropic.Anthropic, original_prompt: str,
                               response_text: str, effort: str) -> dict:
    rubric = (
        "You are grading an answer to a difficult systems design prompt. "
        "Score the response from 0 to 100 using this rubric: "
        "completeness 30 points, technical correctness 30 points, "
        "edge-case coverage 20 points, implementation specificity 20 points. "
        "Return strict JSON only with keys: score, rationale, completeness, "
        "correctness, edge_cases, specificity. "
        "The rationale must be concise, concrete, and no more than 80 words."
    )
    grader_prompt = (
        f"{rubric}\n\n"
        f"Original prompt:\n{original_prompt}\n\n"
        f"Effort level being graded: {effort}\n\n"
        f"Candidate response:\n{response_text}"
    )
    result = client.messages.create(
        model=SCORER_MODEL,
        max_tokens=SCORER_MAX_TOKENS,
        messages=[{"role": "user", "content": grader_prompt}],
    )
    raw    = next((b.text for b in result.content if b.type == "text"), "")
    parsed = extract_json_object(raw)
    in_tok  = result.usage.input_tokens
    out_tok = result.usage.output_tokens
    score = max(0, min(100, int(round(float(parsed["score"])))))
    return {
        "score":     score,
        "rationale": str(parsed.get("rationale", "")).strip(),
        "subscores": {
            "completeness": parsed.get("completeness"),
            "correctness":  parsed.get("correctness"),
            "edge_cases":   parsed.get("edge_cases"),
            "specificity":  parsed.get("specificity"),
        },
        "scorer_model":      SCORER_MODEL,
        "scorer_cost_usd":   in_tok * SCORER_PRICE_IN_PER_TOK + out_tok * SCORER_PRICE_OUT_PER_TOK,
        "scorer_in_tokens":  in_tok,
        "scorer_out_tokens": out_tok,
    }
Der Helper extract_json fängt Fälle ab, in denen Haiku sein JSON in Markdown-Fences einbettet – ein typisches Fehlverhalten kleinerer Modelle.
Die gesamten Scoring-Kosten über alle drei Antworten hinweg liegen meist unter 0,002 $. Das ist vernachlässigbar und ersetzt einen subjektiven manuellen Schritt durch eine wiederholbare Rubrik.
Die App enthält drei Charts:
So baust du die Charts:
def quality_tradeoff_chart(results: list[dict], scores: dict) -> go.Figure:
    fig = go.Figure()
    for r in results:
        effort = r["effort"]
        fig.add_trace(go.Scatter(
            x=[r["cost_usd"]],
            y=[scores[effort]],
            mode="markers+text",
            name=effort.capitalize(),
            text=[effort.capitalize()],
            textposition="top center",
            marker=dict(size=18, color=EFFORT_COLORS[effort],
                        line=dict(color="white", width=2)),
            hovertemplate=(
                "<b>%{text}</b><br>"
                "Cost / call: $%{x:.5f}<br>"
                "Quality: %{y}<extra></extra>"
            ),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Cost / call (USD)", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Quality score", range=[0, 100],
                   gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def projection_chart(results: list[dict], tasks: int) -> go.Figure:
    fig = go.Figure()
    fig.add_traces([
        go.Bar(
            name="Output tokens", x=[r["effort"] for r in results],
            y=[r["out_tokens"] for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            yaxis="y1", text=[f"{r['out_tokens']:,}" for r in results],
            textposition="outside", width=0.35, offset=-0.2,
        ),
        go.Bar(
            name=f"Daily cost ({tasks:,} tasks)",
            x=[r["effort"] for r in results],
            y=[r["cost_usd"] * tasks for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            marker_opacity=0.45, yaxis="y2",
            text=[f"${r['cost_usd']*tasks:.4f}" for r in results],
            textposition="outside", width=0.35, offset=0.2,
        ),
    ])
    fig.update_layout(
        barmode="group", plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        yaxis=dict(title="Output tokens", gridcolor="rgba(128,128,128,0.15)"),
        yaxis2=dict(title="Daily cost (USD)", overlaying="y", side="right"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def breakeven_chart(results: list[dict]) -> go.Figure:
    volumes = list(range(100, 5001, 100))
    fig = go.Figure()
    for r in results:
        fig.add_trace(go.Scatter(
            x=volumes, y=[r["cost_usd"] * v for v in volumes],
            mode="lines", name=r["effort"].capitalize(),
            line=dict(color=EFFORT_COLORS[r["effort"]], width=2.5),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Tasks / day", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Daily cost (USD)", gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig
Jedes Chart beantwortet eine andere Frage mit denselben drei Datenpunkten.
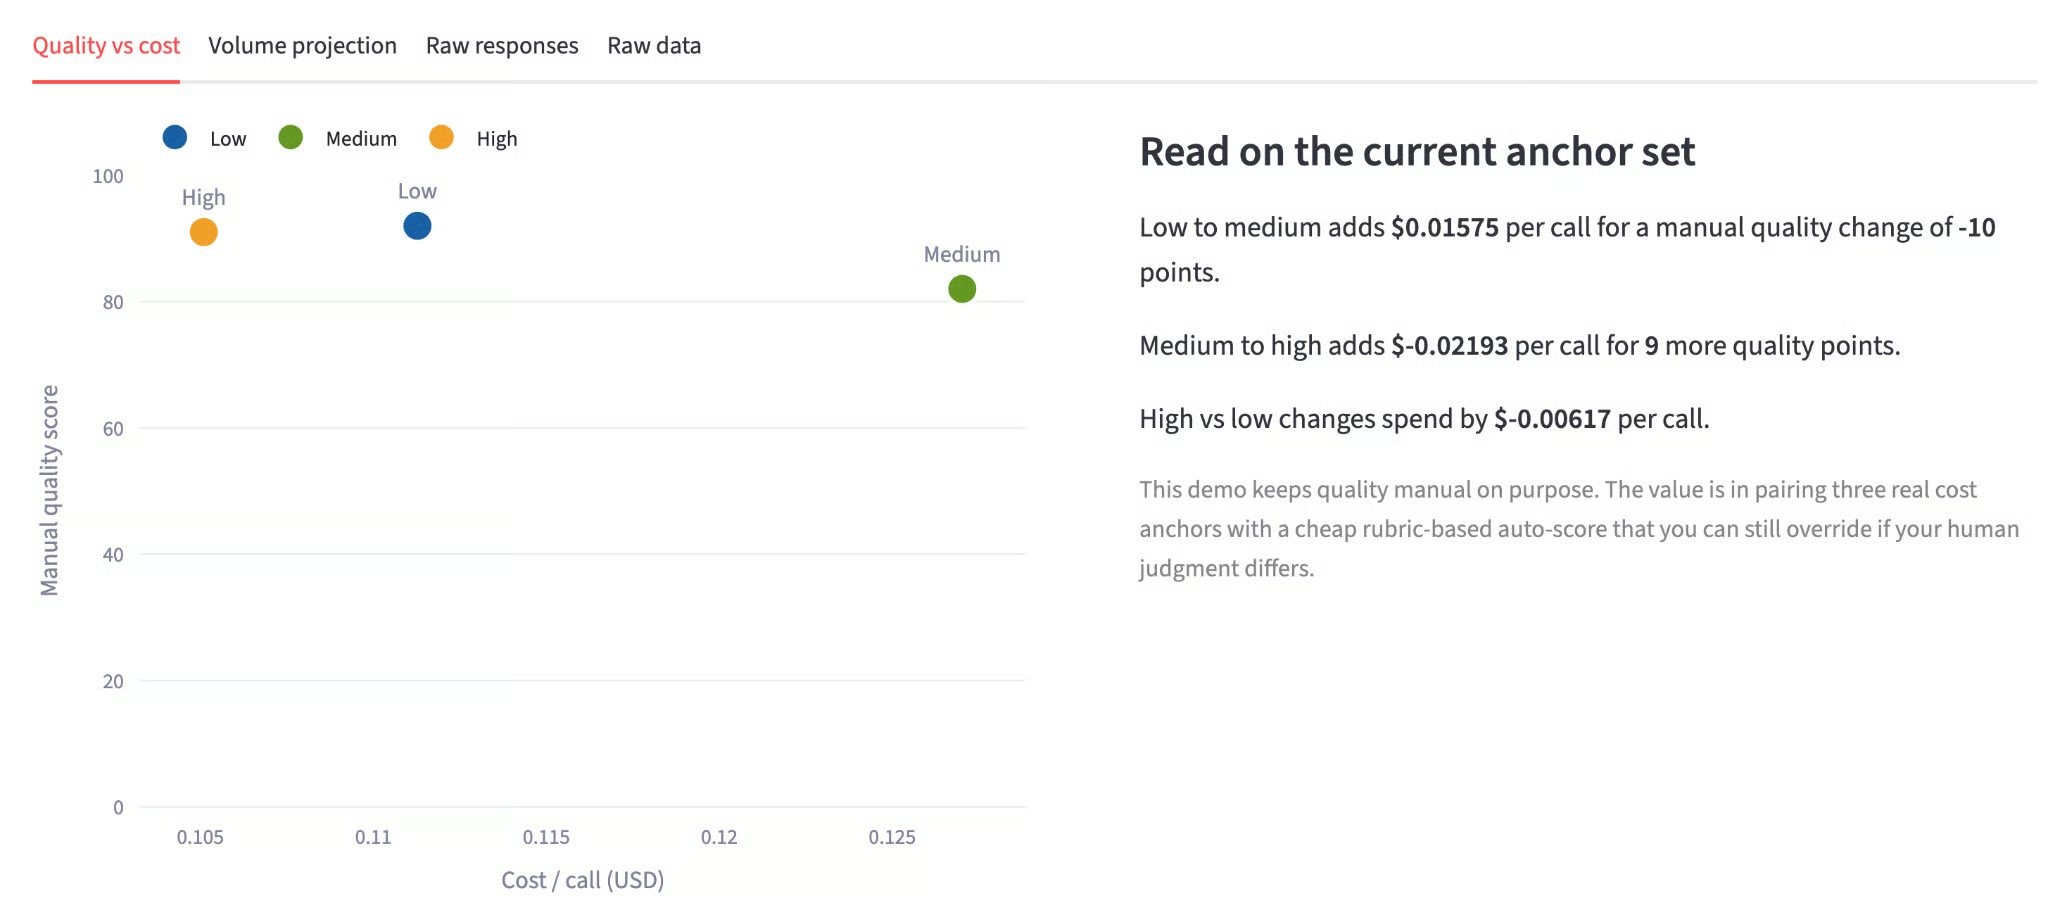
quality_tradeoff_chart trägt Kosten auf der x-Achse und Qualität auf der y-Achse auf – so ist die Frontier unmittelbar sichtbar.
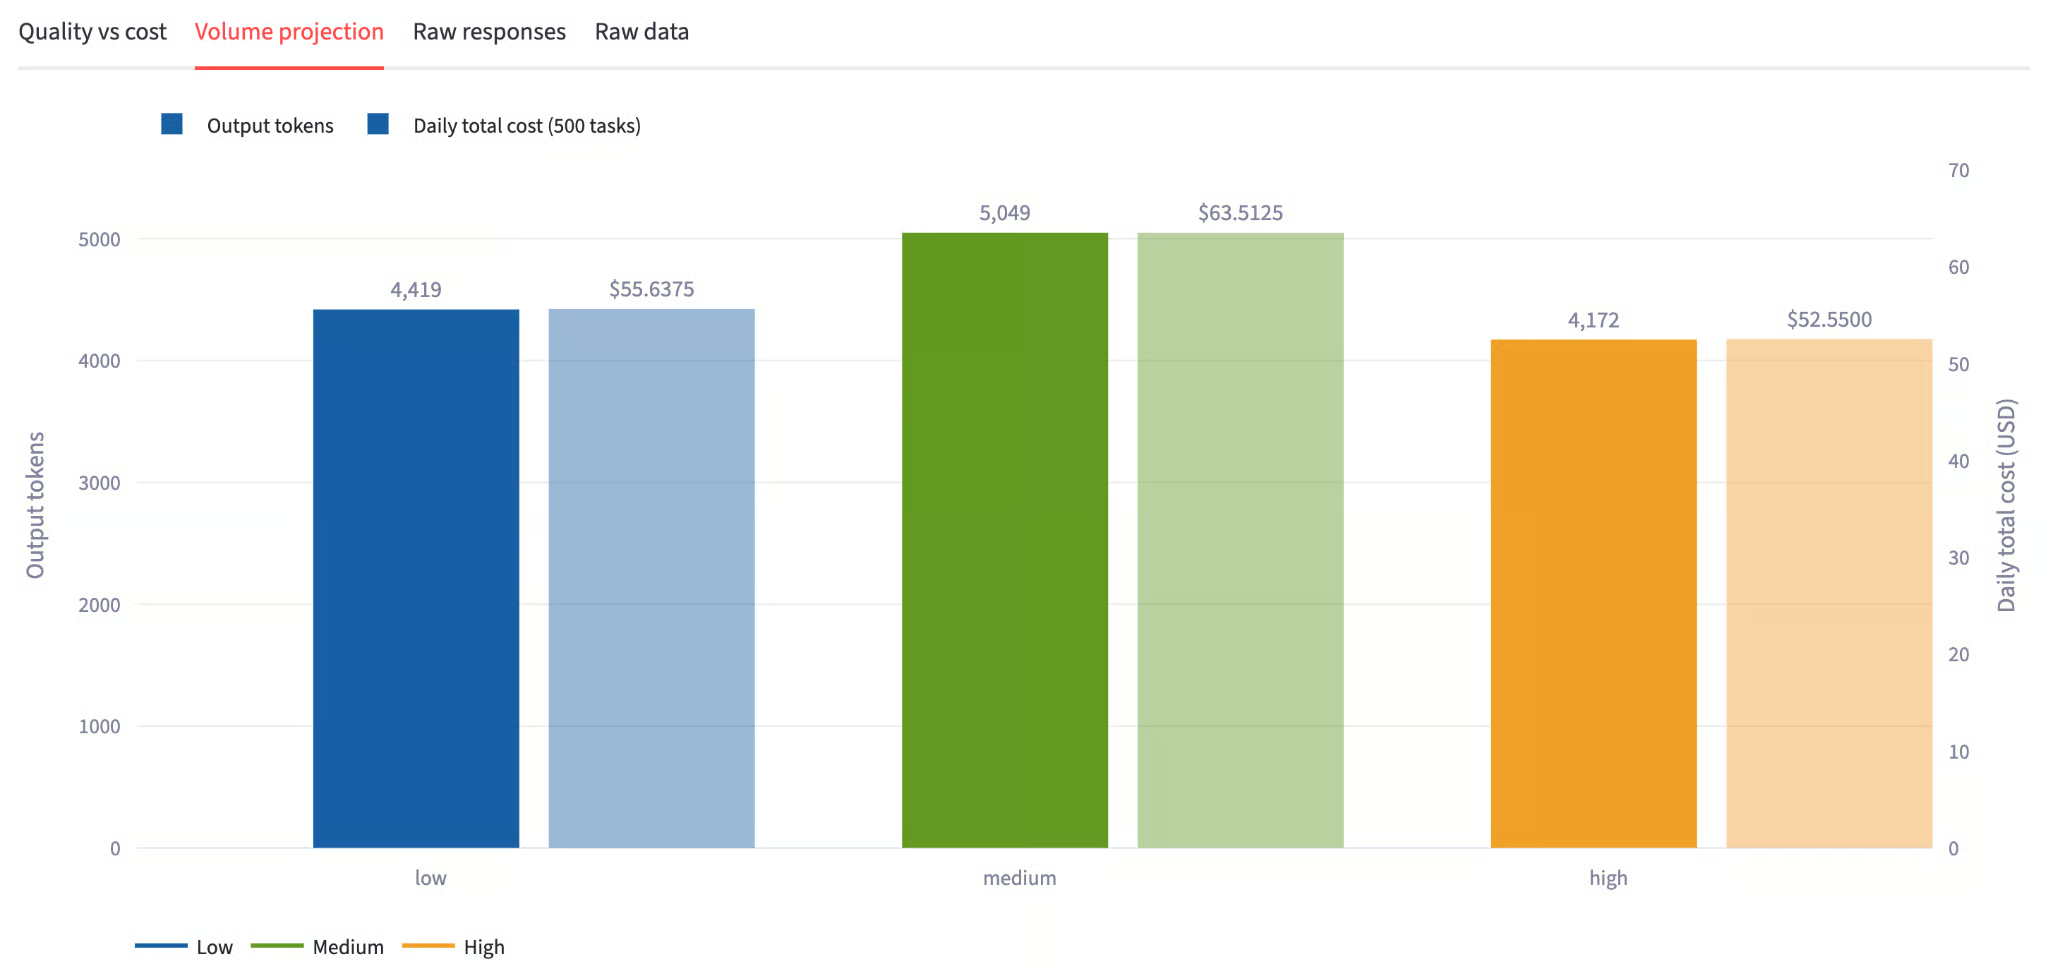
projection_chart nimmt die Kosten pro Call aus den API-Ergebnissen und multipliziert sie mit dem Slider-Wert „Aufgaben pro Tag“, sodass jeder Balken auf realen Tokenzahlen statt Schätzungen basiert.
breakeven_chart sweeped von 100 bis 5.000 Aufgaben/Tag mit denselben realen Kostenankern, sodass die Linien in einem Tempo auseinanderlaufen, das in API-Responses verankert ist. Ein Team mit 500 Aufgaben/Tag sieht eine andere Kostenrealität als eines mit 5.000 – dieses Chart macht das greifbar.
Im nächsten Schritt binden wir die drei Chart-Funktionen in das Streamlit-UI ein und verbinden sie mit den Live-API-Ergebnissen.
Zum Schluss das Streamlit-Interface. Die Sidebar kümmert sich um den Key, die Prompt-Eingabe und den Aufgaben-pro-Tag-Slider. Das Hauptpanel führt die Calls nacheinander aus und aktualisiert Fortschrittskarten, sobald ein Call fertig ist.
def main():
    api_key = os.getenv("ANTHROPIC_API_KEY", "").strip()
    with st.sidebar:
        st.title("Opus 4.8 Effort Dial")
        st.divider()
        if api_key:
            st.success("Key loaded.")
        else:
            st.error("Missing ANTHROPIC_API_KEY. Set it in your .env file.")
        prompt = st.text_area(
            "Prompt (runs at all 3 effort levels)",
            value=DEFAULT_PROMPT, height=220,
        )
        run = st.button("▶ Run 3 calls", use_container_width=True, type="primary")
        st.divider()
        tasks = st.slider("Tasks / day", min_value=10, max_value=5000, value=500, step=10)
    if "results" not in st.session_state:
        st.session_state.results = []
    for effort, default in DEFAULT_QUALITY.items():
        if f"quality_{effort}" not in st.session_state:
            st.session_state[f"quality_{effort}"] = default
    if run:
        if not api_key:
            st.error("Set ANTHROPIC_API_KEY first.")
            st.stop()
        client = anthropic.Anthropic(api_key=api_key)
        collected = []
        progress   = st.progress(0, text="Starting calls…")
        cols       = st.columns(3)
        holders    = {e: cols[i].empty() for i, e in enumerate(EFFORT_ORDER)}
        for i, effort in enumerate(EFFORT_ORDER):
            holders[effort].info(f"**{effort.upper()}** — calling…")
            progress.progress(i / 3, text=f"Running {effort} effort…")
            try:
                result = call_opus(client, effort, prompt)
                try:
                    scored = score_response_with_haiku(
                        client, prompt, result["response"], effort
                    )
                    result.update(scored)
                    st.session_state[f"quality_{effort}"] = scored["score"]
                    score_line = f"auto-score: {scored['score']}/100"
                except Exception as e:
                    result["score_error"] = str(e)
                    score_line = "auto-score unavailable"
                collected.append(result)
                holders[effort].success(
                    f"**{effort.upper()}**\n\n"
                    f"{result['out_tokens']:,} output tokens\n\n"
                    f"{result['latency_ms']/1000:.2f}s\n\n"
                    f"${result['cost_usd']:.5f} / call\n\n"
                    f"{score_line}"
                )
            except Exception as exc:
                holders[effort].error(f"**{effort.upper()}** failed: {exc}")
            progress.progress((i + 1) / 3)
        st.session_state.results = sorted(
            collected, key=lambda r: EFFORT_ORDER.index(r["effort"])
        )
        progress.empty()
    st.header("Opus 4.8 Effort Dial: Quality vs. Cost Tradeoff")
    results = st.session_state.results
    if not results:
        st.info("Set your API key and click **▶ Run 3 calls** to start.")
        st.stop()
    if any(r.get("hit_token_cap") for r in results):
        st.warning(
            f"One or more calls hit the {MAX_OUTPUT_TOKENS:,}-token cap. "
            "Raise MAX_OUTPUT_TOKENS if medium and high still look similar."
        )
    scorer_spend = sum(r.get("scorer_cost_usd", 0) for r in results)
    if scorer_spend > 0:
        st.caption(
            f"Auto-scoring used {SCORER_MODEL} and added "
            f"${scorer_spend:.6f} across all three responses."
        )
    # Per-call metric cards
    st.subheader("Per-call results")
    scores = {e: int(st.session_state.get(f"quality_{e}", DEFAULT_QUALITY[e]))
              for e in EFFORT_ORDER}
    mcols = st.columns(3)
    for row, col in zip(results, mcols):
        effort = row["effort"]
        with col:
            st.metric(f"{effort.upper()} effort", f"{row['out_tokens']:,} output tokens")
            st.caption(
                f"Input: {row['in_tokens']:,} · "
                f"Latency: {row['latency_ms']/1000:.2f}s · "
                f"Cost: ${row['cost_usd']:.5f} · "
                f"Stop: {row.get('stop_reason', 'n/a')}"
            )
            st.slider(
                f"Quality score — {effort.upper()}",
                min_value=0, max_value=100,
                value=DEFAULT_QUALITY[effort],
                key=f"quality_{effort}",
            )
            if row.get("rationale"):
                st.caption(f"Auto-scored by {SCORER_MODEL}: {row['rationale']}")
    st.divider()
    # Tabs
    t1, t2, t3, t4 = st.tabs(
        ["Quality vs cost", "Volume projection", "Raw responses", "Raw data"]
    )
    with t1:
        left, right = st.columns([1.1, 1], gap="large")
        with left:
            st.plotly_chart(quality_tradeoff_chart(results, scores),
                            use_container_width=True)
        with right:
            low  = next((r for r in results if r["effort"] == "low"),  None)
            med  = next((r for r in results if r["effort"] == "medium"), None)
            high = next((r for r in results if r["effort"] == "high"), None)
            if low and med and high:
                st.markdown("#### Read on the current anchor set")
                st.write(
                    f"Low → medium adds **${med['cost_usd'] - low['cost_usd']:.5f}** per call "
                    f"for **{scores['medium'] - scores['low']}** quality points."
                )
                st.write(
                    f"Medium → high adds **${high['cost_usd'] - med['cost_usd']:.5f}** per call "
                    f"for **{scores['high'] - scores['medium']}** more quality points."
                )
                st.write(
                    f"High vs low: **${high['cost_usd'] - low['cost_usd']:.5f}** "
                    f"total per-call delta."
                )
                st.caption(
                    "Quality scores are auto-generated by Haiku 4.5 using a rubric, "
                    "but you can override them with the sliders above."
                )
    with t2:
        st.plotly_chart(projection_chart(results, tasks), use_container_width=True)
        st.plotly_chart(breakeven_chart(results), use_container_width=True)
        if low and high:
            daily_delta   = (high["cost_usd"] - low["cost_usd"]) * tasks
            monthly_delta = daily_delta * 30
            st.caption(
                f"High vs low at {tasks:,} tasks/day: "
                f"**+${daily_delta:.4f}/day** · **+${monthly_delta:.2f}/month**"
            )
    with t3:
        for row in results:
            with st.expander(
                f"{row['effort'].upper()} — {row['out_tokens']:,} tokens",
                expanded=True,
            ):
                if row.get("rationale"):
                    st.info(
                        f"Auto-score: **{scores[row['effort']]}/100**. "
                        f"{row['rationale']}"
                    )
                st.markdown(row["response"])
    with t4:
        df = pd.DataFrame([{
            "Effort":            r["effort"],
            "Quality score":     scores[r["effort"]],
            "Input tokens":      r["in_tokens"],
            "Output tokens":     r["out_tokens"],
            "Latency (s)":       round(r["latency_ms"] / 1000, 2),
            "Cost / call ($)":   round(r["cost_usd"], 6),
            "Auto-score cost ($)": round(r.get("scorer_cost_usd", 0), 6),
            f"Daily @ {tasks} tasks ($)": round(r["cost_usd"] * tasks, 4),
            f"Monthly @ {tasks} tasks/day ($)": round(r["cost_usd"] * tasks * 30, 2),
        } for r in results])
        st.dataframe(df, use_container_width=True, hide_index=True)
        st.download_button(
            "Download CSV",
            df.to_csv(index=False),
            file_name="effort_dial_results.csv",
            mime="text/csv",
        )
if __name__ == "__main__":
    main()
Die Sidebar übernimmt die komplette Konfiguration – vom Laden des API-Keys über die Prompt-Eingabe bis zum Aufgaben-pro-Tag-Slider – und hält das Hauptpanel frei für Ergebnisse. Das Hauptpanel ist in vier Tabs aufgeteilt, damit der Ablauf klar strukturiert bleibt.
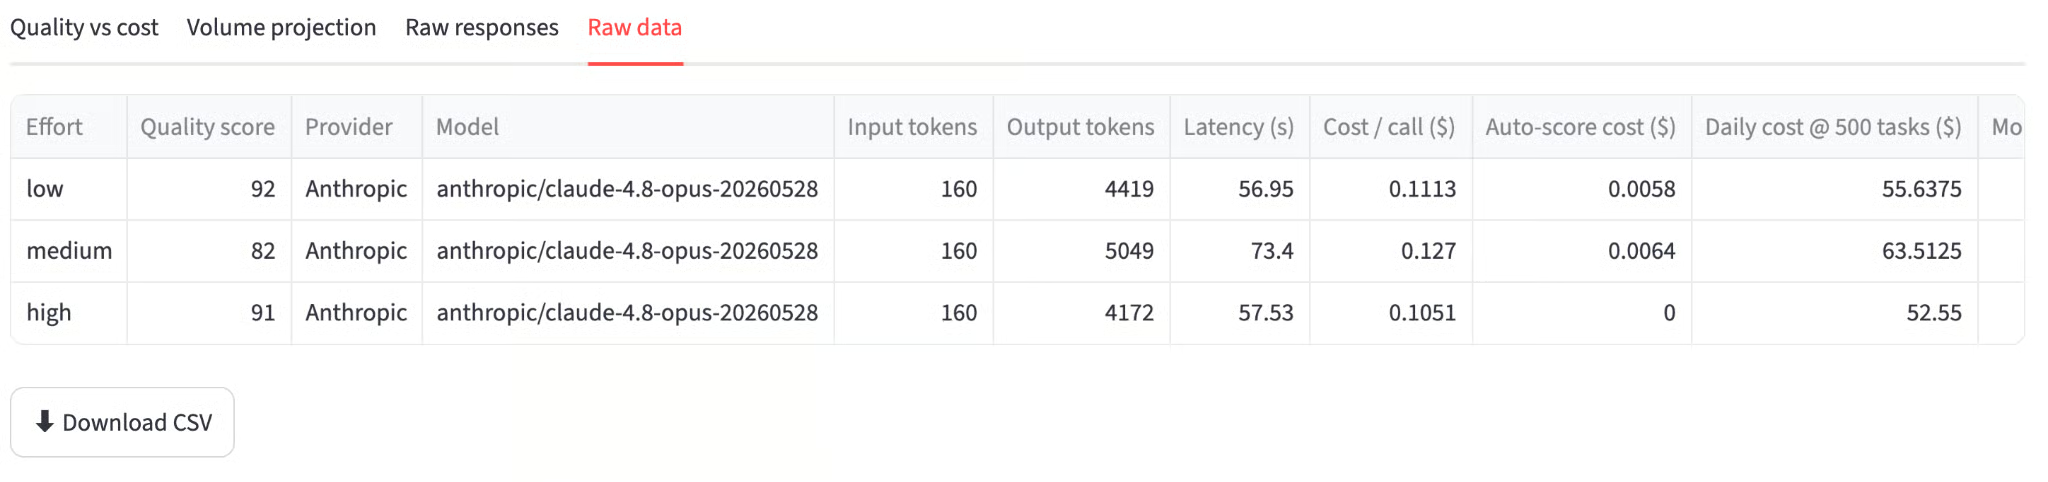
Mit Backend, Charts und UI ist die App startklar.
Starte den Streamlit-Server:
streamlit run effort_dial.pyÖffne http://localhost:8501 und behalte den Standard-Prompt bei oder ersetze ihn durch etwas aus deiner eigenen Pipeline, dann klicke auf Run 3 calls.
Die App führt jede Effort-Stufe nacheinander aus und zeigt nach jedem Abschluss eine Statuskarte. Sind alle drei fertig, folgen die drei Haiku-Bewertungen und die Charts werden befüllt. Die gesamte Wandzeit liegt beim Standard-Prompt typischerweise bei 2–3 Minuten, der Großteil entfällt auf den High-Effort-Call.
Hier sind die Zahlen eines repräsentativen Runs auf dem Rate-Limiting-Prompt:
|
Effort |
Ausgabetokens |
Latenz |
Kosten/Call |
Auto-Score |
|
Low |
3.276 |
46 s |
$0,0827 |
72/100 |
|
Medium |
5.109 |
70 s |
$0,1285 |
82/100 |
|
High |
5.382 |
71 s |
$0,1354 |
92/100 |
Auffällig war Folgendes:
Die Tokenzahlen steigen geordnet (3.276 -> 5.109 -> 5.382) und der Stop-Grund ist bei allen end_turn. Das bestätigt, dass der Effort-Parameter greift und die Antworten natürlich enden.
Der Qualitätssprung von low auf medium (+10 Punkte) kostet 0,046 $ pro Call. Der Sprung von medium auf high (+10 Punkte) kostet nur 0,007 $. Medium holt den Großteil des Qualitätsgewinns bei etwa dem sechsfach geringeren inkrementellen Kostenanstieg gegenüber dem letzten Schritt zu high.
Das Streudiagramm macht diese Asymmetrie sofort sichtbar. Low sitzt unten links – günstig, aber weniger vollständig. Medium liegt in der Mitte. High ist oben rechts, aber nur geringfügig teurer als medium, weil der Tokenunterschied in diesem Prompt klein ist.
Auch die Haiku-Begründung ist aufschlussreich. Zur Low-Antwort: „starke technische Tiefe bei Algorithmenwahl und Lua-Skripting, aber es fehlen konkrete Pod-zu-Shard-Routinglogik und Details zur Koordination des Shardings über Pods hinweg.“ Zur High-Antwort: „hervorragende Antwort, die alle fünf Anforderungen mit Produktionsreife abdeckt, mit EVALSHA-Skripten und konkreten Boundary-Case-Beispielen.“
In diesem Tutorial haben wir eine Streamlit-App gebaut, die drei echte Claude Opus 4.8 API-Calls (je eine Effort-Stufe) ausführt, jede Antwort mit Haiku 4.5 automatisch bewertet und die Kosten über dein Aufgabenvolumen projiziert.
Die Kerngedanken: effort und thinking: {type: \"adaptive\"} arbeiten zusammen, um die Reasoning-Tiefe zu steuern; ein günstiges Bewertungsmodell kann manuelles Scoring durch eine wiederholbare Rubrik praktisch ohne Mehrkosten ersetzen. Außerdem ist die Kosten-Qualitäts-Grenze nicht linear – medium erreicht meist den Großteil des Qualitätsgewinns zu einem Bruchteil der Mehrkosten von high.
Bei 1.000 Aufgaben pro Tag spart der Wechsel von high auf medium etwa 207 $/Monat bei rund 10 Punkten weniger auf einer 100-Punkte-Rubrik. Für klar umrissene Aufgaben wie Klassifikation, Extraktion oder Zusammenfassung reicht medium meist aus. Für Aufgaben, die tiefes technisches Reasoning oder umfassende Randfallabdeckung erfordern – etwa Code-Reviews, Architekturdesign oder Policy-Analysen – ist high den Aufpreis wert.
Mögliche Erweiterungen: einen zweiten Prompt-Typ hinzufügen, um zu zeigen, wie der Effort-Delta kollabiert, wenn kein tiefes Reasoning nötig ist; oder eine Side-by-Side-Ansicht, die genau jene Stellen hervorhebt, an denen high konkrete Details liefert, die medium fehlen.
Lerne KI mit DataCamp!
Kurs
Kurs
Lernpfad