
{count, plural, one {Kurs} other {Kurs}}
Claude Modellerine Giriş
{hours} sa
14.9K
Claude Opus 4.8, istek başına muhakeme derinliğini kontrol etmenizi sağlayan bir effort parametresi ekledi. Bunu üç konumlu bir ayar gibi düşünün:
low: Model daha doğrudan yanıt verir; daha az düşünme token’ı kullanır, bu da iyi tanımlanmış, olgusal ya da yapılandırılmış görevler için uygundur.
medium: Orta yol olarak davranır; model daha dikkatli muhakeme eder ancak uç durumları kapsamlı biçimde araştırmaz.
high: Modelin varsayılanıdır; artırılmış düşünme derinliğiyle karmaşık muhakeme, çok adımlı tasarım problemleri ve uç durum atlamanın maliyetli olduğu görevler için en iyisidir.
xhigh: Birçok adım boyunca tutarlı kalmayı gerektiren uzun ufuklu otonom ve kodlama görevleri için tasarlanmıştır.
max: En üst seviye yetenek; en zorlu görevler için tam hesaplama bütçesini ayırır.
effort parametresi yalnızca thinking: {type: "adaptive"} ile birlikte çalışır. Uyarlanabilir düşünme, modelin her turda derin muhakemeye ihtiyaç olup olmadığına karar vermesini sağlar. Birlikte, modelin hesaplama bütçesini nasıl harcadığı üzerinde anlamlı bir kontrol sunarlar.
Bu eğitim, genel amaçlı üretim iş yükleri için en ilgili üç seviye olan low, medium ve high’a odaklanır; ancak aynı uygulama yapısı bunu xhigh veya max’a genişletmek isterseniz de geçerlidir.
En üst effort seviyeleri, Claude Code ile Şartnameli (Spec-Driven) Geliştirme eğitimimizde adım adım gösterdiğimiz türde, uzun soluklu otonom çalışmalar için geliştirilmiştir.
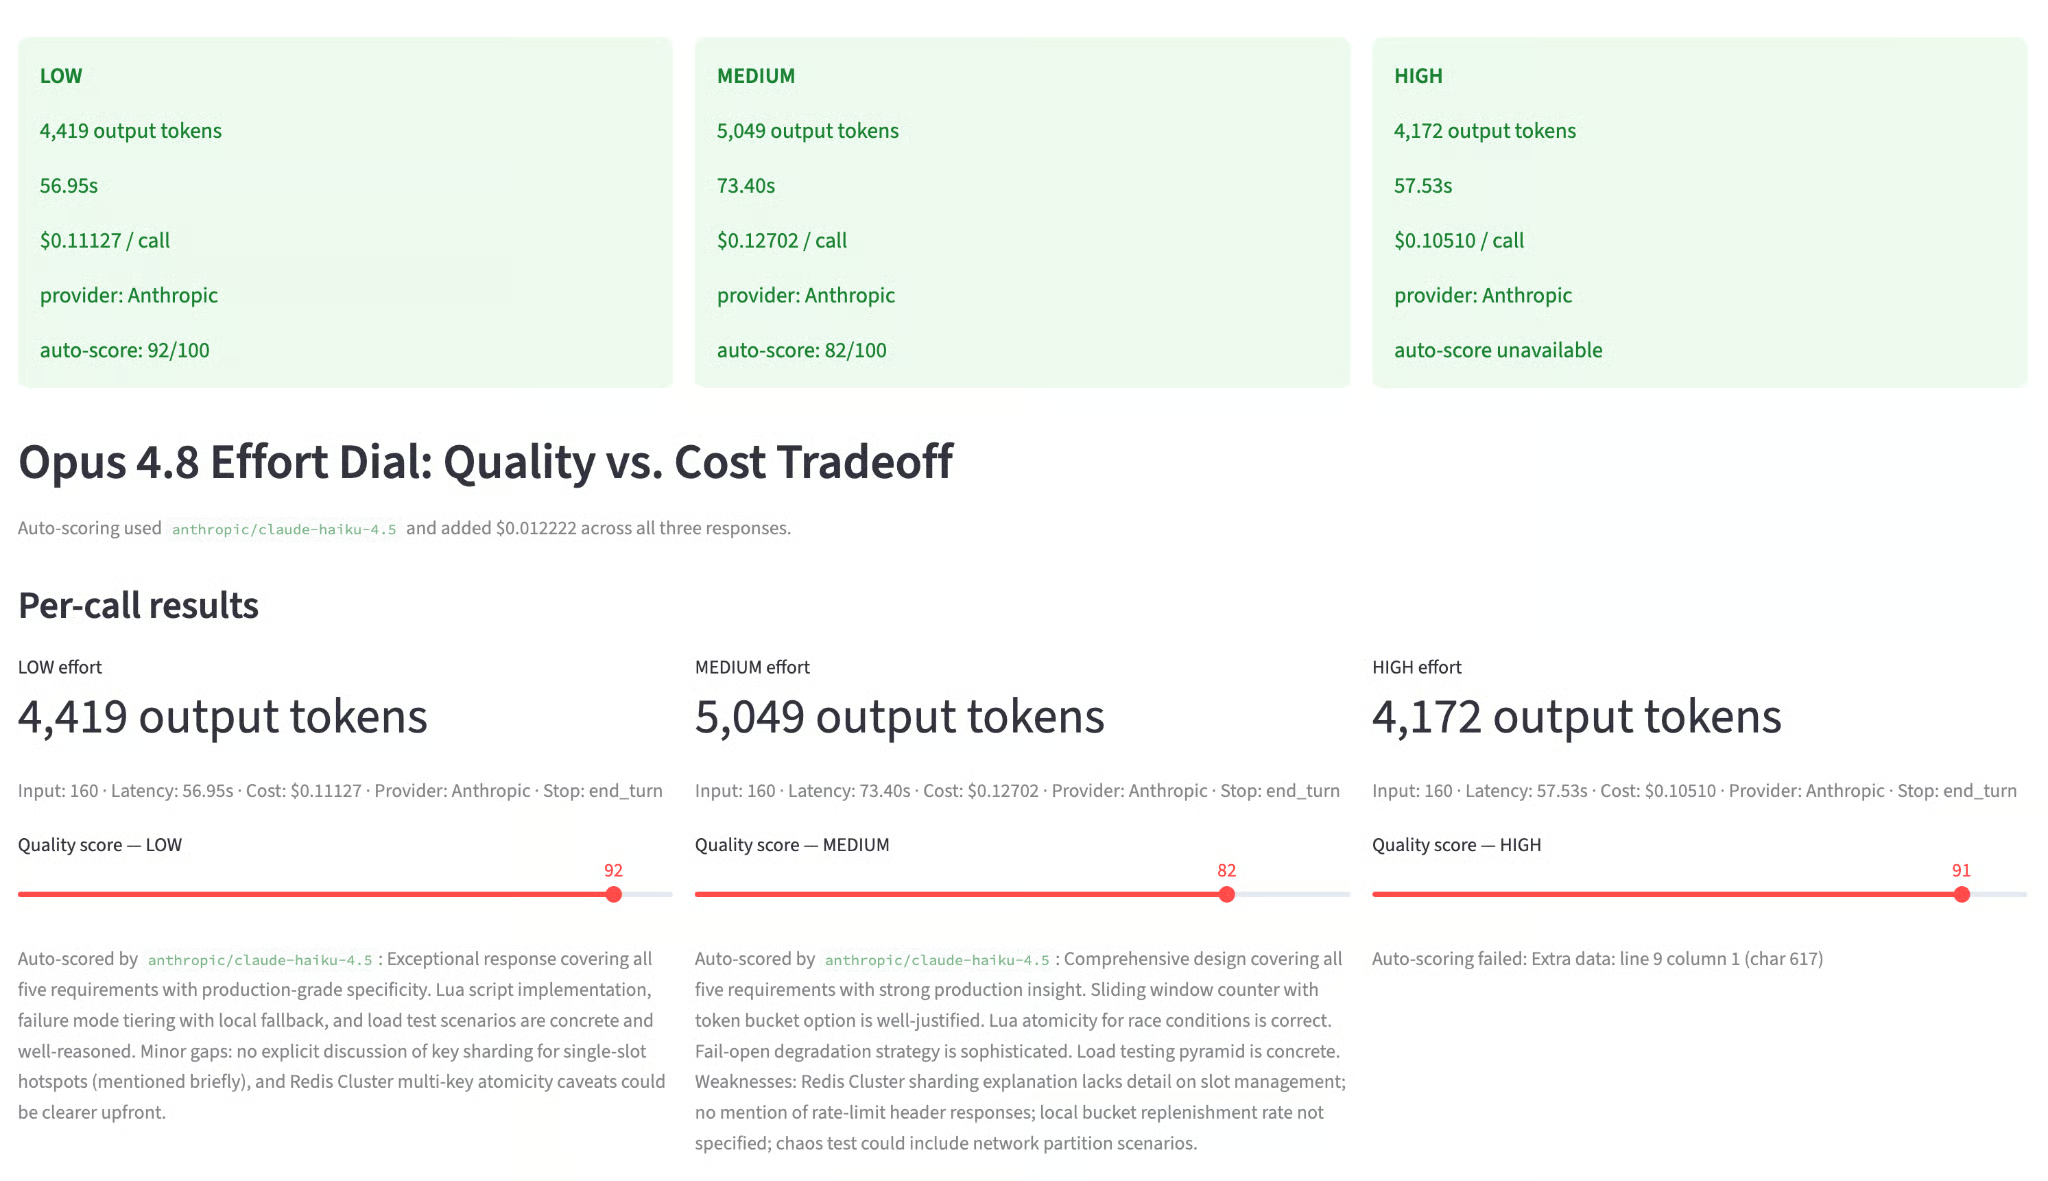
Uygulama tek bir Python dosyasından oluşur. Çalıştırdığınızda, bir yanda istem girişi ve günde görev sayısı kaydırıcısı olan bir kenar çubuğu, diğer yanda ise dört sekmeli bir ana panel görürsünüz:
Her çalıştırmadaki iş akışı şöyledir:
claude-opus-4-8 için sırasıyla low, medium ve high effort ile art arda üç API çağrısı yapınclaude-haiku-4-5’e gönderinVarsayılan istem, effort seviyesiyle doğal olarak ölçeklenen dağıtık sistemler tasarımı sorusudur.
Bu eğitimi takip etmek için şunlara ihtiyacınız olacak:
Python 3.10 veya üstü
claude-opus-4-8 erişimi olan bir Anthropic API anahtarı
Streamlit hakkında temel bilgi
Sanal bir ortam oluşturun ve gerekli paketleri yükleyin:
bashpython -m venv .venv
source .venv/bin/activate
pip install anthropic streamlit plotly pandas python-dotenv
Windows’ta, source .venv/bin/activate yerine .venv\Scripts\activate kullanın.
Anthropic API anahtarınızı proje kök dizinindeki .env dosyasına ekleyin:
.env
ANTHROPIC_API_KEY=sk-ant-...
Ortam kurulduktan sonra, arayüz için effort_dial şemasını tanımlayacağız.
effort_dial.py adında bir dosya oluşturun ve başına yapılandırma bloğunu ekleyin:
import os
import time
import json
import re
import anthropic
import pandas as pd
import plotly.graph_objects as go
import streamlit as st
from dotenv import load_dotenv

load_dotenv()
st.set_page_config(
    page_title="Opus 4.8 Effort Dial — Claude Opus 4.8",
    layout="wide",
)
MODEL              = "claude-opus-4-8"
SCORER_MODEL       = "claude-haiku-4-5"
MAX_OUTPUT_TOKENS  = 16000
SCORER_MAX_TOKENS  = 500
PRICE_OUT_PER_TOK        = 25 / 1_000_000
PRICE_IN_PER_TOK         = 5  / 1_000_000
SCORER_PRICE_OUT_PER_TOK = 5  / 1_000_000
SCORER_PRICE_IN_PER_TOK  = 1  / 1_000_000
EFFORT_ORDER  = ["low", "medium", "high"]
EFFORT_COLORS = {"low": "#185FA5", "medium": "#639922", "high": "#EF9F27"}
DEFAULT_QUALITY = {"low": 68, "medium": 82, "high": 91}
MAX_OUTPUT_TOKENS varsayılan 4.096 yerine 16.000’e ayarlanmıştır. Bunun önemi şudur: 4.096 token sınırında hem medium hem de high effort aynı noktada kesilir ve aralarındaki görünür fark kaybolur. Yanıtların doğal biçimde ayrışması için yeterli boşluk gerekir.
Son çıktıda max_tokens yerine end_turn durdurma nedeni görmek de modelin yanıtını kendi koşullarıyla tamamladığını doğrular.
"özyinelemeyi açıkla" gibi basit bir istem, derin muhakemeyi tetikleyecek kadar zor olmadığından üç effort seviyesinde de benzer yanıtlar üretir. Bu nedenle çok parçalı bir sistem tasarımı sorusu kullandık:
DEFAULT_PROMPT = """\
Design a production-ready rate-limiting system for a distributed API gateway
handling 100k requests/second. Cover:
1. Algorithm choice (token bucket vs sliding window vs leaky bucket) with tradeoffs
2. Redis data structure design and TTL strategy
3. Race condition handling across 50 pods
4. Failure mode behavior when Redis is unavailable
5. How you'd test this under load
Be specific about implementation details, not just concepts.
"""
Bu istem beş farklı alt problemi içerir. Düşük effort yaklaşımları ana kavramlara değinip uygulama ayrıntılarını atlayarak yüzeysel kalma eğilimindedir. Yüksek effort ise sınır koşullarını kapsar, Lua betik örnekleri ekler, EVALSHA atomikliğini tartışır ve somut eşiklerle yük testi planı sunar.
Şimdi modeli çağıran çekirdek işlevi tanımlayın. Buradaki iki kritik ayrıntı thinking={"type": "adaptive"} ve output_config={"effort": effort}’tır:
def call_opus(client: anthropic.Anthropic, effort: str, prompt: str) -> dict:
    t0 = time.perf_counter()
    response = client.messages.create(
        model=MODEL,
        max_tokens=MAX_OUTPUT_TOKENS,
        thinking={"type": "adaptive"},
        output_config={"effort": effort},
        # Do NOT set temperature, top_p, or top_k — those 400-error on Opus 4.8
        messages=[{"role": "user", "content": prompt}],
    )
    latency_ms = (time.perf_counter() - t0) * 1000
    in_tok  = response.usage.input_tokens
    out_tok = response.usage.output_tokens
    text = next(
        (b.text for b in response.content if b.type == "text"), "(no text block)"
    )
    return {
        "effort":        effort,
        "in_tokens":     in_tok,
        "out_tokens":    out_tok,
        "latency_ms":    latency_ms,
        "cost_usd":      in_tok * PRICE_IN_PER_TOK + out_tok * PRICE_OUT_PER_TOK,
        "response":      text,
        "stop_reason":   response.stop_reason,
        "hit_token_cap": out_tok >= MAX_OUTPUT_TOKENS,
    }
Bu işlevdeki kilit kararları kısaca inceleyelim.
thinking={"type": "adaptive"}: effort parametresinin etkili olması için gereklidir. Bu olmadan, effort’a ne verirseniz verin üç çağrı da aynı davranır. Uyarlanabilir düşünme, modelin her turda derin muhakemeye ihtiyaç olup olmadığına karar vermesini sağlar ve gerekirse ne kadar bütçe ayıracağını kontrol eder.
output_config={"effort": effort}: Anthropic Python SDK’sı henüz adlandırılmış argümanlar olarak açığa çıkarılmamış parametreleri bu şekilde iletmenize olanak tanır. İçeride, bu sözlük gönderilmeden önce ham API istek gövdesine birleştirilir.
time.perf_counter(): Sistem saat ayarlamalarından etkilenmeyen ve daha yüksek çözünürlük sunan bu yöntem, time.time() yerine gerçek zamanlı gecikme ölçümü için kullanılır.
response.content: Uyarlanabilir düşünmeyle Opus 4.8, modelin iç muhakeme zincirini içeren bir düşünme bloğu ve nihai yanıtı içeren bir metin bloğu dahil olmak üzere birden fazla içerik bloğu döndürebilir. Görüntüleme için yalnızca metin bloğunu istiyoruz. next() çağrısı düşünme bloğunu atlar ve yalnızca kullanıcıya yönelik yanıtı çıkarır.
hit_token_cap: out_tokens değeri MAX_OUTPUT_TOKENS’a eşit olduğunda True olan tanılama bayrağıdır. Bu değer medium veya high için True ise yanıtın ortasında kesildiği anlamına gelir.
Her çalıştırmada üç uzun yanıtı manuel olarak puanlamak yavaş ve özneldir. Bunun yerine, her yanıtı bir ölçütle birlikte Claude Haiku 4.5’e gönderin ve yapılandırılmış bir JSON puanı dönmesini sağlayın.
Bir modeli başka bir modeli değerlendirmek için kullanmak, yargıç olarak LLM değerlendirmesinin bir biçimidir; LLM Değerlendirmesi rehberimiz, gerçekten güvenebileceğiniz ölçütlerin nasıl tasarlanacağını açıklar.
Ölçüt, kaliteyi dört alt puana böler:
Bunlar, bir sistem tasarımı isteminde effort seviyelerini ayırt eden noktalarla doğrudan örtüşür:
def score_response_with_haiku(client: anthropic.Anthropic, original_prompt: str,
                               response_text: str, effort: str) -> dict:
    rubric = (
        "You are grading an answer to a difficult systems design prompt. "
        "Score the response from 0 to 100 using this rubric: "
        "completeness 30 points, technical correctness 30 points, "
        "edge-case coverage 20 points, implementation specificity 20 points. "
        "Return strict JSON only with keys: score, rationale, completeness, "
        "correctness, edge_cases, specificity. "
        "The rationale must be concise, concrete, and no more than 80 words."
    )
    grader_prompt = (
        f"{rubric}\n\n"
        f"Original prompt:\n{original_prompt}\n\n"
        f"Effort level being graded: {effort}\n\n"
        f"Candidate response:\n{response_text}"
    )
    result = client.messages.create(
        model=SCORER_MODEL,
        max_tokens=SCORER_MAX_TOKENS,
        messages=[{"role": "user", "content": grader_prompt}],
    )
    raw    = next((b.text for b in result.content if b.type == "text"), "")
    parsed = extract_json_object(raw)
    in_tok  = result.usage.input_tokens
    out_tok = result.usage.output_tokens
    score = max(0, min(100, int(round(float(parsed["score"])))))
    return {
        "score":     score,
        "rationale": str(parsed.get("rationale", "")).strip(),
        "subscores": {
            "completeness": parsed.get("completeness"),
            "correctness":  parsed.get("correctness"),
            "edge_cases":   parsed.get("edge_cases"),
            "specificity":  parsed.get("specificity"),
        },
        "scorer_model":      SCORER_MODEL,
        "scorer_cost_usd":   in_tok * SCORER_PRICE_IN_PER_TOK + out_tok * SCORER_PRICE_OUT_PER_TOK,
        "scorer_in_tokens":  in_tok,
        "scorer_out_tokens": out_tok,
    }
extract_json yardımcı işlevi, Haiku’nun zaman zaman JSON çıktısını Markdown çitleri içine sarması durumlarını ele alır. Bu, daha küçük modellerde yaygın bir hata türüdür.
Üç yanıtın tamamı için toplam puanlama maliyeti genellikle 0,002 $’ın altındadır. Bu, öznel bir manuel adımı tekrarlanabilir bir ölçütle değiştiren ihmal edilebilir bir ek yüktür.
Uygulamada üç grafik vardır:
Şimdi bu grafiklerin her birini oluşturalım:
def quality_tradeoff_chart(results: list[dict], scores: dict) -> go.Figure:
    fig = go.Figure()
    for r in results:
        effort = r["effort"]
        fig.add_trace(go.Scatter(
            x=[r["cost_usd"]],
            y=[scores[effort]],
            mode="markers+text",
            name=effort.capitalize(),
            text=[effort.capitalize()],
            textposition="top center",
            marker=dict(size=18, color=EFFORT_COLORS[effort],
                        line=dict(color="white", width=2)),
            hovertemplate=(
                "<b>%{text}</b><br>"
                "Cost / call: $%{x:.5f}<br>"
                "Quality: %{y}<extra></extra>"
            ),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Cost / call (USD)", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Quality score", range=[0, 100],
                   gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def projection_chart(results: list[dict], tasks: int) -> go.Figure:
    fig = go.Figure()
    fig.add_traces([
        go.Bar(
            name="Output tokens", x=[r["effort"] for r in results],
            y=[r["out_tokens"] for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            yaxis="y1", text=[f"{r['out_tokens']:,}" for r in results],
            textposition="outside", width=0.35, offset=-0.2,
        ),
        go.Bar(
            name=f"Daily cost ({tasks:,} tasks)",
            x=[r["effort"] for r in results],
            y=[r["cost_usd"] * tasks for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            marker_opacity=0.45, yaxis="y2",
            text=[f"${r['cost_usd']*tasks:.4f}" for r in results],
            textposition="outside", width=0.35, offset=0.2,
        ),
    ])
    fig.update_layout(
        barmode="group", plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        yaxis=dict(title="Output tokens", gridcolor="rgba(128,128,128,0.15)"),
        yaxis2=dict(title="Daily cost (USD)", overlaying="y", side="right"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def breakeven_chart(results: list[dict]) -> go.Figure:
    volumes = list(range(100, 5001, 100))
    fig = go.Figure()
    for r in results:
        fig.add_trace(go.Scatter(
            x=volumes, y=[r["cost_usd"] * v for v in volumes],
            mode="lines", name=r["effort"].capitalize(),
            line=dict(color=EFFORT_COLORS[r["effort"]], width=2.5),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Tasks / day", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Daily cost (USD)", gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig
Her grafik, aynı üç veri noktası hakkında farklı bir soruyu yanıtlar.
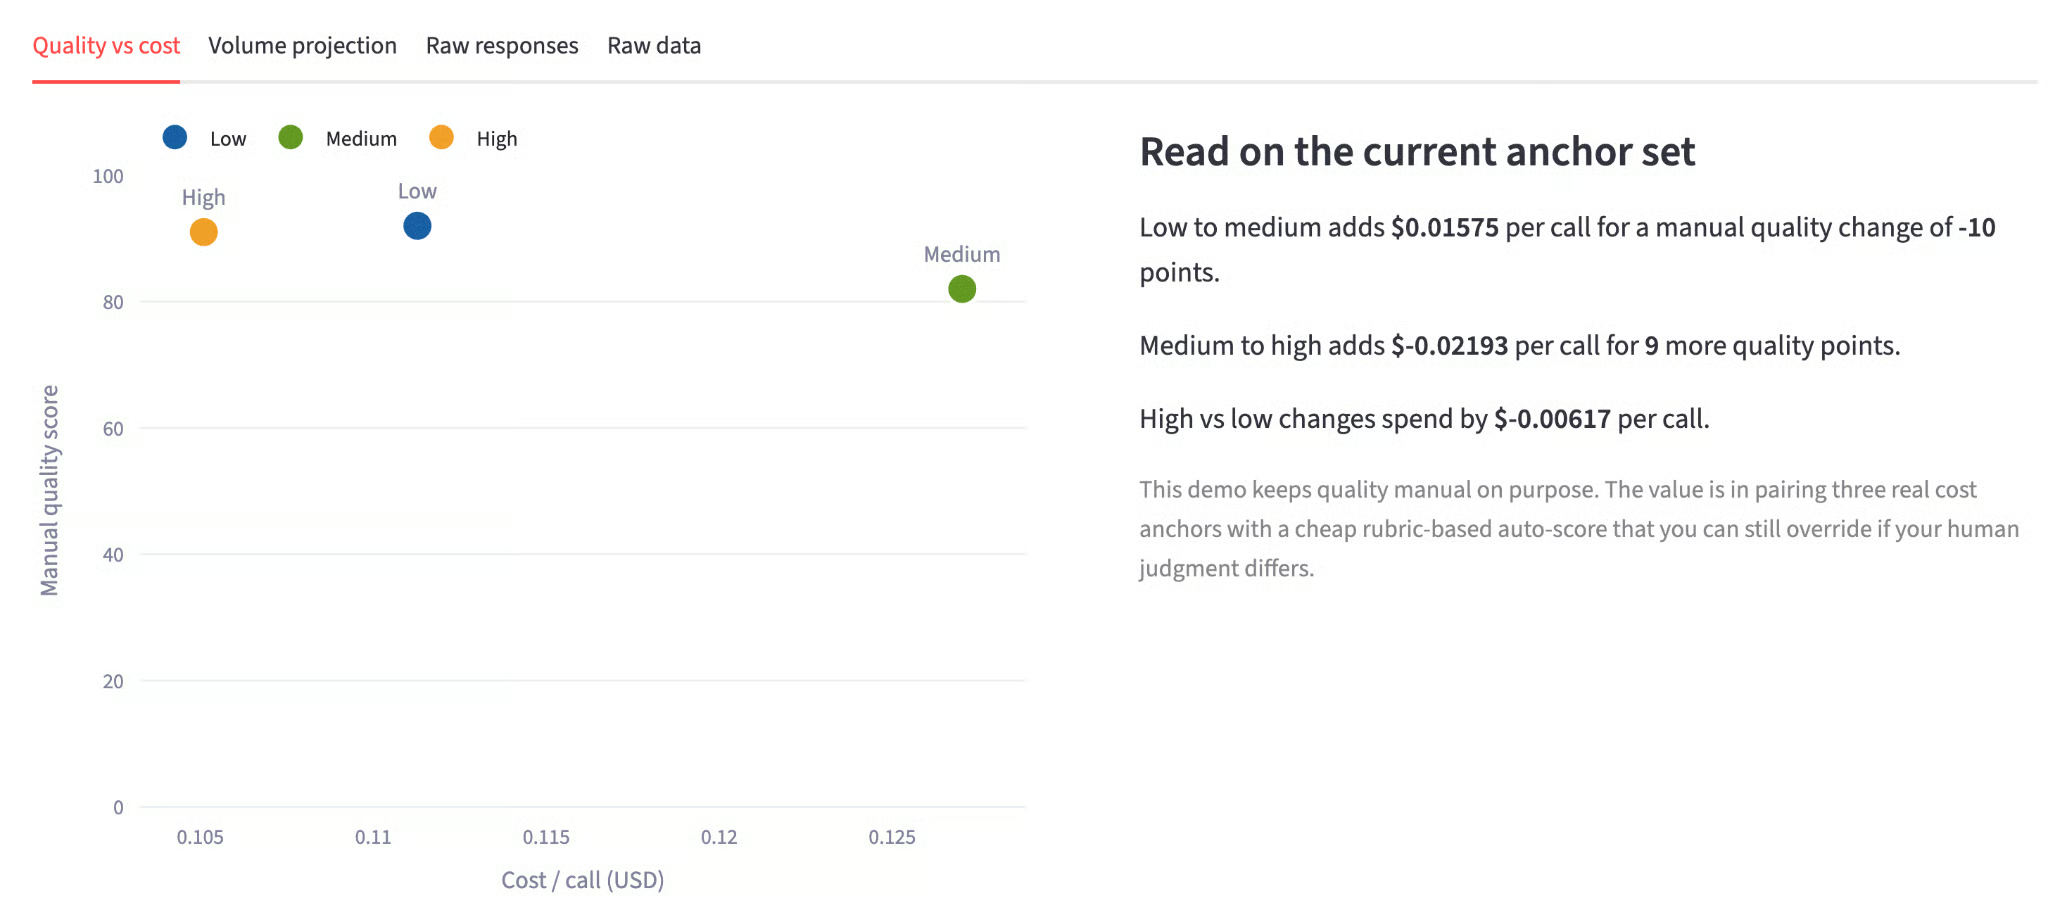
quality_tradeoff_chart, x eksenine maliyeti, y eksenine kalite puanını yerleştirir; böylece sınırın şekli hemen görünür.
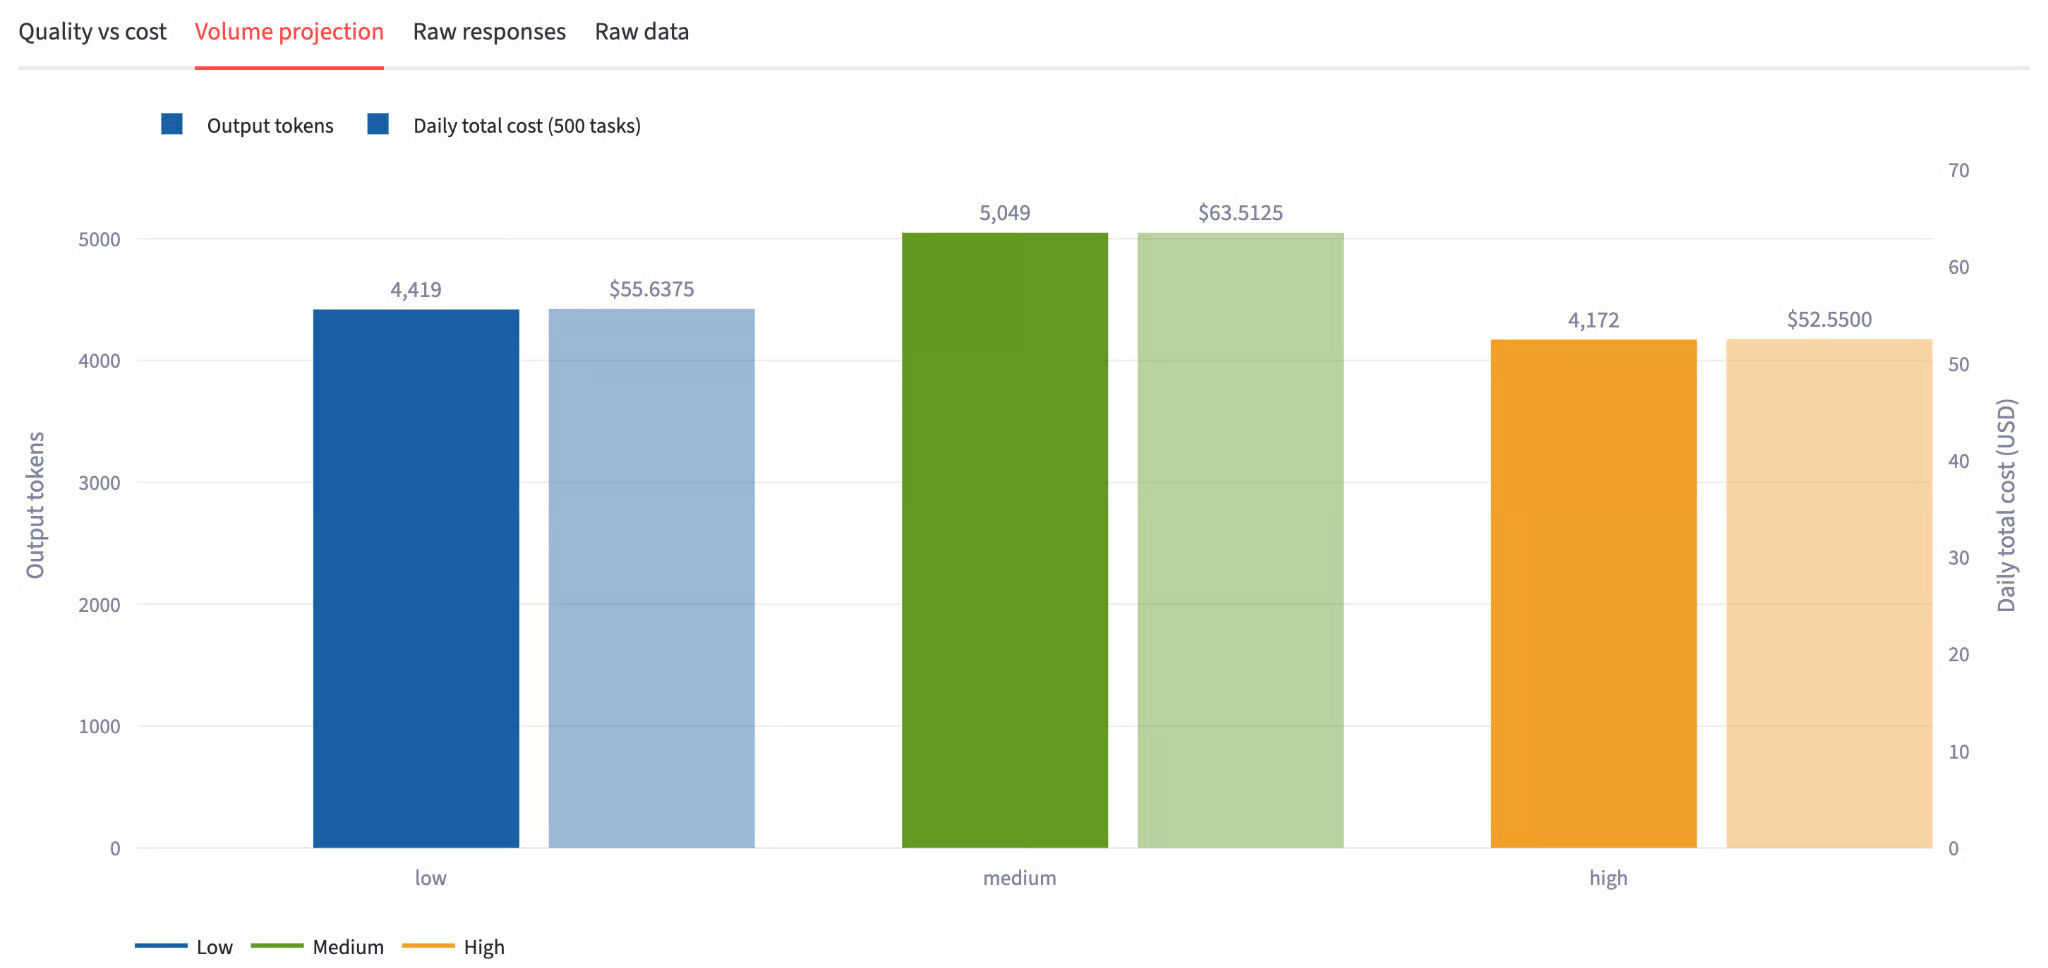
projection_chart, API sonuçlarından çağrı başına maliyet çıpasını alır ve bunu günde görev kaydırıcısının değeriyle çarpar; böylece her çubuk tahmin yerine gerçek token sayısını yansıtır.
breakeven_chart, aynı gerçek maliyet çıpalarını kullanarak günde 100’den 5.000’e kadar görev hacmini süpürür; böylece çizgiler API yanıtlarına dayalı bir hızda ayrışır. Günde 500 görev çalıştıran bir ekibin maliyet tablosu, 5.000 görev çalıştıran bir ekibinkinden çok farklıdır ve bu grafik bunu somutlaştırır.
Bir sonraki adımda, bu üç grafik işlevini Streamlit arayüzüne bağlayacak ve canlı API sonuçlarına iliştireceğiz.
Son parça Streamlit arayüzüdür. Kenar çubuğu anahtar yüklemeyi, istem girişini ve günde görev sayısı kaydırıcısını yönetir. Ana panel çağrıları sıralı olarak çalıştırır ve her biri tamamlandıkça ilerleme kartlarını günceller.
def main():
    api_key = os.getenv("ANTHROPIC_API_KEY", "").strip()
    with st.sidebar:
        st.title("Opus 4.8 Effort Dial")
        st.divider()
        if api_key:
            st.success("Key loaded.")
        else:
            st.error("Missing ANTHROPIC_API_KEY. Set it in your .env file.")
        prompt = st.text_area(
            "Prompt (runs at all 3 effort levels)",
            value=DEFAULT_PROMPT, height=220,
        )
        run = st.button("▶ Run 3 calls", use_container_width=True, type="primary")
        st.divider()
        tasks = st.slider("Tasks / day", min_value=10, max_value=5000, value=500, step=10)
    if "results" not in st.session_state:
        st.session_state.results = []
    for effort, default in DEFAULT_QUALITY.items():
        if f"quality_{effort}" not in st.session_state:
            st.session_state[f"quality_{effort}"] = default
    if run:
        if not api_key:
            st.error("Set ANTHROPIC_API_KEY first.")
            st.stop()
        client = anthropic.Anthropic(api_key=api_key)
        collected = []
        progress   = st.progress(0, text="Starting calls…")
        cols       = st.columns(3)
        holders    = {e: cols[i].empty() for i, e in enumerate(EFFORT_ORDER)}
        for i, effort in enumerate(EFFORT_ORDER):
            holders[effort].info(f"**{effort.upper()}** — calling…")
            progress.progress(i / 3, text=f"Running {effort} effort…")
            try:
                result = call_opus(client, effort, prompt)
                try:
                    scored = score_response_with_haiku(
                        client, prompt, result["response"], effort
                    )
                    result.update(scored)
                    st.session_state[f"quality_{effort}"] = scored["score"]
                    score_line = f"auto-score: {scored['score']}/100"
                except Exception as e:
                    result["score_error"] = str(e)
                    score_line = "auto-score unavailable"
                collected.append(result)
                holders[effort].success(
                    f"**{effort.upper()}**\n\n"
                    f"{result['out_tokens']:,} output tokens\n\n"
                    f"{result['latency_ms']/1000:.2f}s\n\n"
                    f"${result['cost_usd']:.5f} / call\n\n"
                    f"{score_line}"
                )
            except Exception as exc:
                holders[effort].error(f"**{effort.upper()}** failed: {exc}")
            progress.progress((i + 1) / 3)
        st.session_state.results = sorted(
            collected, key=lambda r: EFFORT_ORDER.index(r["effort"])
        )
        progress.empty()
    st.header("Opus 4.8 Effort Dial: Quality vs. Cost Tradeoff")
    results = st.session_state.results
    if not results:
        st.info("Set your API key and click **▶ Run 3 calls** to start.")
        st.stop()
    if any(r.get("hit_token_cap") for r in results):
        st.warning(
            f"One or more calls hit the {MAX_OUTPUT_TOKENS:,}-token cap. "
            "Raise MAX_OUTPUT_TOKENS if medium and high still look similar."
        )
    scorer_spend = sum(r.get("scorer_cost_usd", 0) for r in results)
    if scorer_spend > 0:
        st.caption(
            f"Auto-scoring used {SCORER_MODEL} and added "
            f"${scorer_spend:.6f} across all three responses."
        )
    # Per-call metric cards
    st.subheader("Per-call results")
    scores = {e: int(st.session_state.get(f"quality_{e}", DEFAULT_QUALITY[e]))
              for e in EFFORT_ORDER}
    mcols = st.columns(3)
    for row, col in zip(results, mcols):
        effort = row["effort"]
        with col:
            st.metric(f"{effort.UPPER()} effort", f"{row['out_tokens']:,} output tokens")
            st.caption(
                f"Input: {row['in_tokens']:,} · "
                f"Latency: {row['latency_ms']/1000:.2f}s · "
                f"Cost: ${row['cost_usd']:.5f} · "
                f"Stop: {row.get('stop_reason', 'n/a')}"
            )
            st.slider(
                f"Quality score — {effort.UPPER()}",
                min_value=0, max_value=100,
                value=DEFAULT_QUALITY[effort],
                key=f"quality_{effort}",
            )
            if row.get("rationale"):
                st.caption(f"Auto-scored by {SCORER_MODEL}: {row['rationale']}")
    st.divider()
    # Tabs
    t1, t2, t3, t4 = st.tabs(
        ["Quality vs cost", "Volume projection", "Raw responses", "Raw data"]
    )
    with t1:
        left, right = st.columns([1.1, 1], gap="large")
        with left:
            st.plotly_chart(quality_tradeoff_chart(results, scores),
                            use_container_width=True)
        with right:
            low  = next((r for r in results if r["effort"] == "low"),  None)
            med  = next((r for r in results if r["effort"] == "medium"), None)
            high = next((r for r in results if r["effort"] == "high"), None)
            if low and med and high:
                st.markdown("#### Read on the current anchor set")
                st.write(
                    f"Low → medium adds **${med['cost_usd'] - low['cost_usd']:.5f}** per call "
                    f"for **{scores['medium'] - scores['low']}** quality points."
                )
                st.write(
                    f"Medium → high adds **${high['cost_usd'] - med['cost_usd']:.5f}** per call "
                    f"for **{scores['high'] - scores['medium']}** more quality points."
                )
                st.write(
                    f"High vs low: **${high['cost_usd'] - low['cost_usd']:.5f}** "
                    f"total per-call delta."
                )
                st.caption(
                    "Quality scores are auto-generated by Haiku 4.5 using a rubric, "
                    "but you can override them with the sliders above."
                )
    with t2:
        st.plotly_chart(projection_chart(results, tasks), use_container_width=True)
        st.plotly_chart(breakeven_chart(results), use_container_width=True)
        if low and high:
            daily_delta   = (high["cost_usd"] - low["cost_usd"]) * tasks
            monthly_delta = daily_delta * 30
            st.caption(
                f"High vs low at {tasks:,} tasks/day: "
                f"**+${daily_delta:.4f}/day** · **+${monthly_delta:.2f}/month**"
            )
    with t3:
        for row in results:
            with st.expander(
                f"{row['effort'].upper()} — {row['out_tokens']:,} tokens",
                expanded=True,
            ):
                if row.get("rationale"):
                    st.info(
                        f"Auto-score: **{scores[row['effort']]}/100**. "
                        f"{row['rationale']}"
                    )
                st.markdown(row["response"])
    with t4:
        df = pd.DataFrame([{
            "Effort":            r["effort"],
            "Quality score":     scores[r["effort"]],
            "Input tokens":      r["in_tokens"],
            "Output tokens":     r["out_tokens"],
            "Latency (s)":       round(r["latency_ms"] / 1000, 2),
            "Cost / call ($)":   round(r["cost_usd"], 6),
            "Auto-score cost ($)": round(r.get("scorer_cost_usd", 0), 6),
            f"Daily @ {tasks} tasks ($)": round(r["cost_usd"] * tasks, 4),
            f"Monthly @ {tasks} tasks/day ($)": round(r["cost_usd"] * tasks * 30, 2),
        } for r in results])
        st.dataframe(df, use_container_width=True, hide_index=True)
        st.download_button(
            "Download CSV",
            df.to_csv(index=False),
            file_name="effort_dial_results.csv",
            mime="text/csv",
        )
if __name__ == "__main__":
    main()
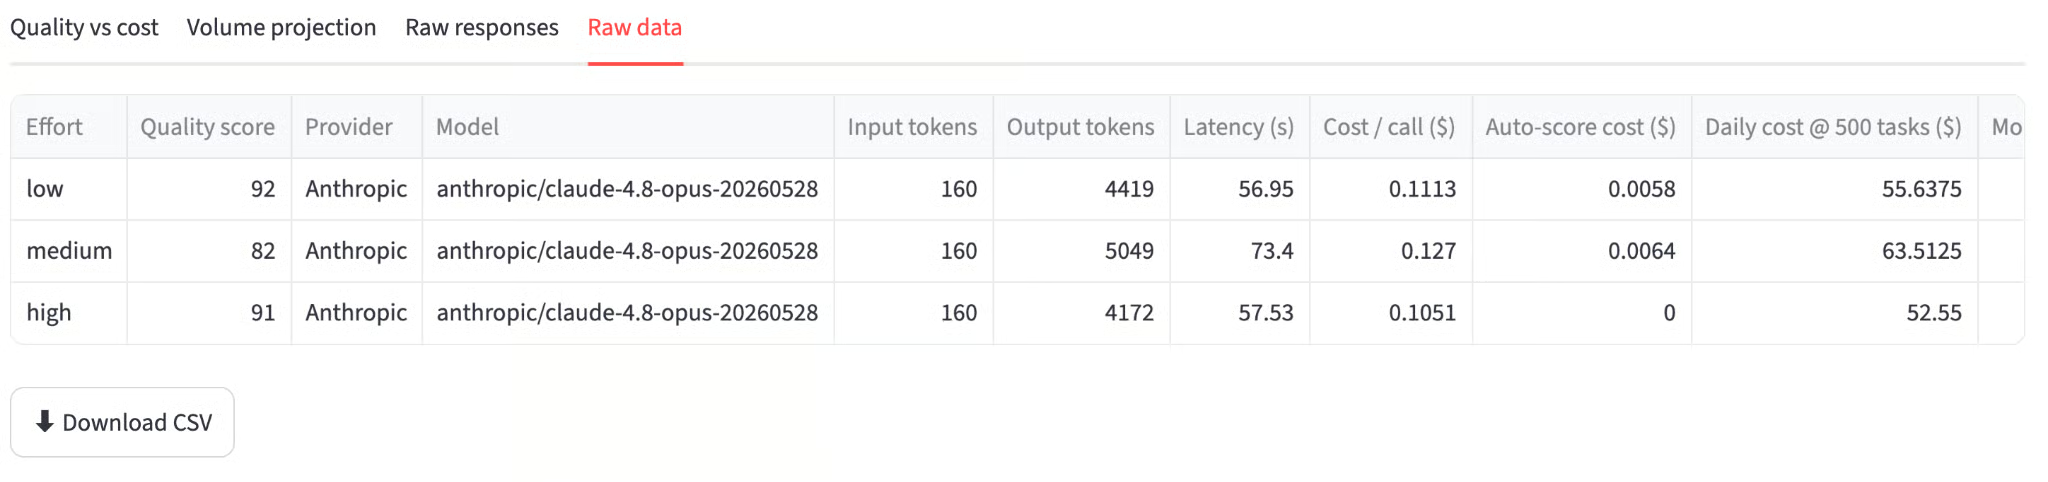
Kenar çubuğu, API anahtarını yükleme, giriş istemini alma ve günde görev sayısı kaydırıcısı dahil tüm yapılandırmayı yönetir ve ana paneli sonuçlar için temiz tutar. Ana panel, iş akışını düzenli tutmak için dört sekmeye ayrılmıştır.
Arka uç, grafikler ve arayüz hazır olduğuna göre, uygulama çalıştırmaya hazır.
Streamlit sunucusunu başlatın:
streamlit run effort_dial.pyhttp://localhost:8501 adresini açın ve varsayılan istemi kullanmaya devam edin ya da kendi hattınızdan bir şeyle değiştirin, ardından Run 3 calls’a tıklayın.
Uygulama her effort seviyesini ardışık olarak çalıştırır ve her tamamlandığında bir durum kartı gösterir. Üçü de bittikten sonra üç Haiku puanlama çağrısını çalıştırır ve grafikleri doldurur. Varsayılan istem için toplam gerçek zaman genellikle 2–3 dakikadır; bunun çoğu yüksek effort çağrısına gider.
Hız sınırlama istemi üzerinde temsilî bir çalıştırmadan alınan sayılar şunlardır:
|
Effort |
Output tokens |
Latency |
Cost/call |
Auto-score |
|
Low |
3,276 |
46s |
$0.0827 |
72/100 |
|
Medium |
5,109 |
70s |
$0.1285 |
82/100 |
|
High |
5,382 |
71s |
$0.1354 |
92/100 |
Bazı dikkat çeken noktalar şunlardı:
Token sayıları sıralı (3.276 -> 5.109 -> 5.382) ve üçünde de durdurma nedeni end_turn. Bu, effort parametresinin doğru şekilde uygulandığını ve yanıtların doğal biçimde tamamlandığını doğrular.
Düşükten ortaya kalite sıçraması (+10 puan) çağrı başına 0,046 $ maliyetlidir. Ortadan yükseğe sıçrama (+10 puan) yalnızca 0,007 $ maliyetlidir. Medium, yüksek seviyeye son adımın artan maliyetine göre yaklaşık altıda bir ek maliyetle kalite kazanımının çoğunu yakalar.
Dağılım grafiği bu asimetrik durumu anında görünür kılar. Low sol altta, ucuz ama daha az kapsamlıdır. Medium ortalarda yer alır. High sağ üstte konumlanır; ancak bu istemde medium ile high arasındaki token farkı küçük olduğundan medium’a göre yalnızca biraz daha pahalıdır.
Haiku puanlayıcısının gerekçesi de öğreticidir. Düşük yanıt için şunları belirtti: "algoritma seçimi ve Lua betiklerinde güçlü teknik derinlik, ancak pod’dan parçaya yönlendirme mantığı somut değil ve podlar arası parçalamanın nasıl koordine edildiğine dair ayrıntılar eksik." Yüksek için: "beş gereksinimin tamamını üretim düzeyinde derinlikle kapsayan mükemmel yanıt; EVALSHA betikleri ve somut sınır-durum örnekleri içeriyor."
Bu eğitimde, üç gerçek Claude Opus 4.8 API çağrısı (her effort seviyesi için bir) yapan, her yanıtı Haiku 4.5 ile otomatik puanlayan ve görev hacminiz boyunca maliyeti projekte eden bir Streamlit uygulaması oluşturduk.
Öz fikirler, muhakeme derinliğini kontrol etmek için effort ve thinking: {type: "adaptive"}’ın birlikte çalıştığı, ucuz bir yargıç modelinin ise ihmal edilebilir bir maliyetle manuel puanlamayı tekrarlanabilir bir ölçütle değiştirebileceğiydi. Ayrıca maliyet-kalite sınırının doğrusal olmadığını gördük; yani medium effort, high effort’un artan maliyetinin bir kısmıyla kalite kazanımının çoğunu yakalar.
Günde 1.000 görevde, high’dan medium’a geçiş, yaklaşık 10 puanlık bir kalite düşüşü karşılığında ayda yaklaşık 207 $ tasarruf sağlar (100 puanlık ölçekte). Sınıflandırma, çıkarım veya özetleme gibi iyi tanımlı görevlerde medium muhtemelen yeterlidir. Ancak, kod incelemesi, mimari tasarım ve politika analizi gibi derin teknik muhakeme veya kapsamlı uç durum kapsaması gerektiren görevler için high effort maliyetini hak eder.
Buradan yapılabilecek bazı genişletmeler arasında, problem derin muhakeme gerektirmediğinde effort farkının nasıl kapandığını göstermek için ikinci bir istem türü eklemek veya high effort’un medium’un kaçırdığı somut ayrıntıları tam olarak nerede eklediğini vurgulayan yan yana yanıt görünümü sağlamak yer alır.
DataCamp ile Yapay Zeka Öğrenin!
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.




