Curso
Introdução aos modelos Claude
3 h
14.4K
O Claude Opus 4.8 adicionou o parâmetro effort, que permite controlar a profundidade do raciocínio por requisição. Pense nele como um seletor com cinco posições:
low: O modelo responde de forma mais direta, usando menos tokens de pensamento — ideal para tarefas bem definidas, factuais ou estruturadas.
medium: Um meio-termo, em que o modelo raciocina com mais cuidado, mas sem explorar exaustivamente os casos de borda.
high: Padrão do modelo, com raciocínio mais profundo — melhor para problemas complexos, design em múltiplos passos e tarefas em que perder um caso de borda custa caro.
xhigh: Projetado para tarefas agentes e de coding de longo horizonte, que exigem coerência sustentada ao longo de muitos passos.
max: O nível máximo absoluto, reservando todo o orçamento de computação para as tarefas mais exigentes.
O parâmetro effort só funciona junto com thinking: {type: \"adaptive\"}. O raciocínio adaptativo permite ao modelo decidir a cada turno se precisa aprofundar. Juntos, eles dão a você controle real sobre como o modelo gasta seu orçamento de compute.
Este tutorial foca em low, medium e high, os três níveis mais relevantes para workloads gerais de produção, mas a mesma estrutura de app vale se você quiser estender para xhigh ou max.
Esses níveis superiores de esforço são feitos para trabalho agente sustentado — o tipo mostrado no nosso tutorial Spec-Driven Development with Claude Code.
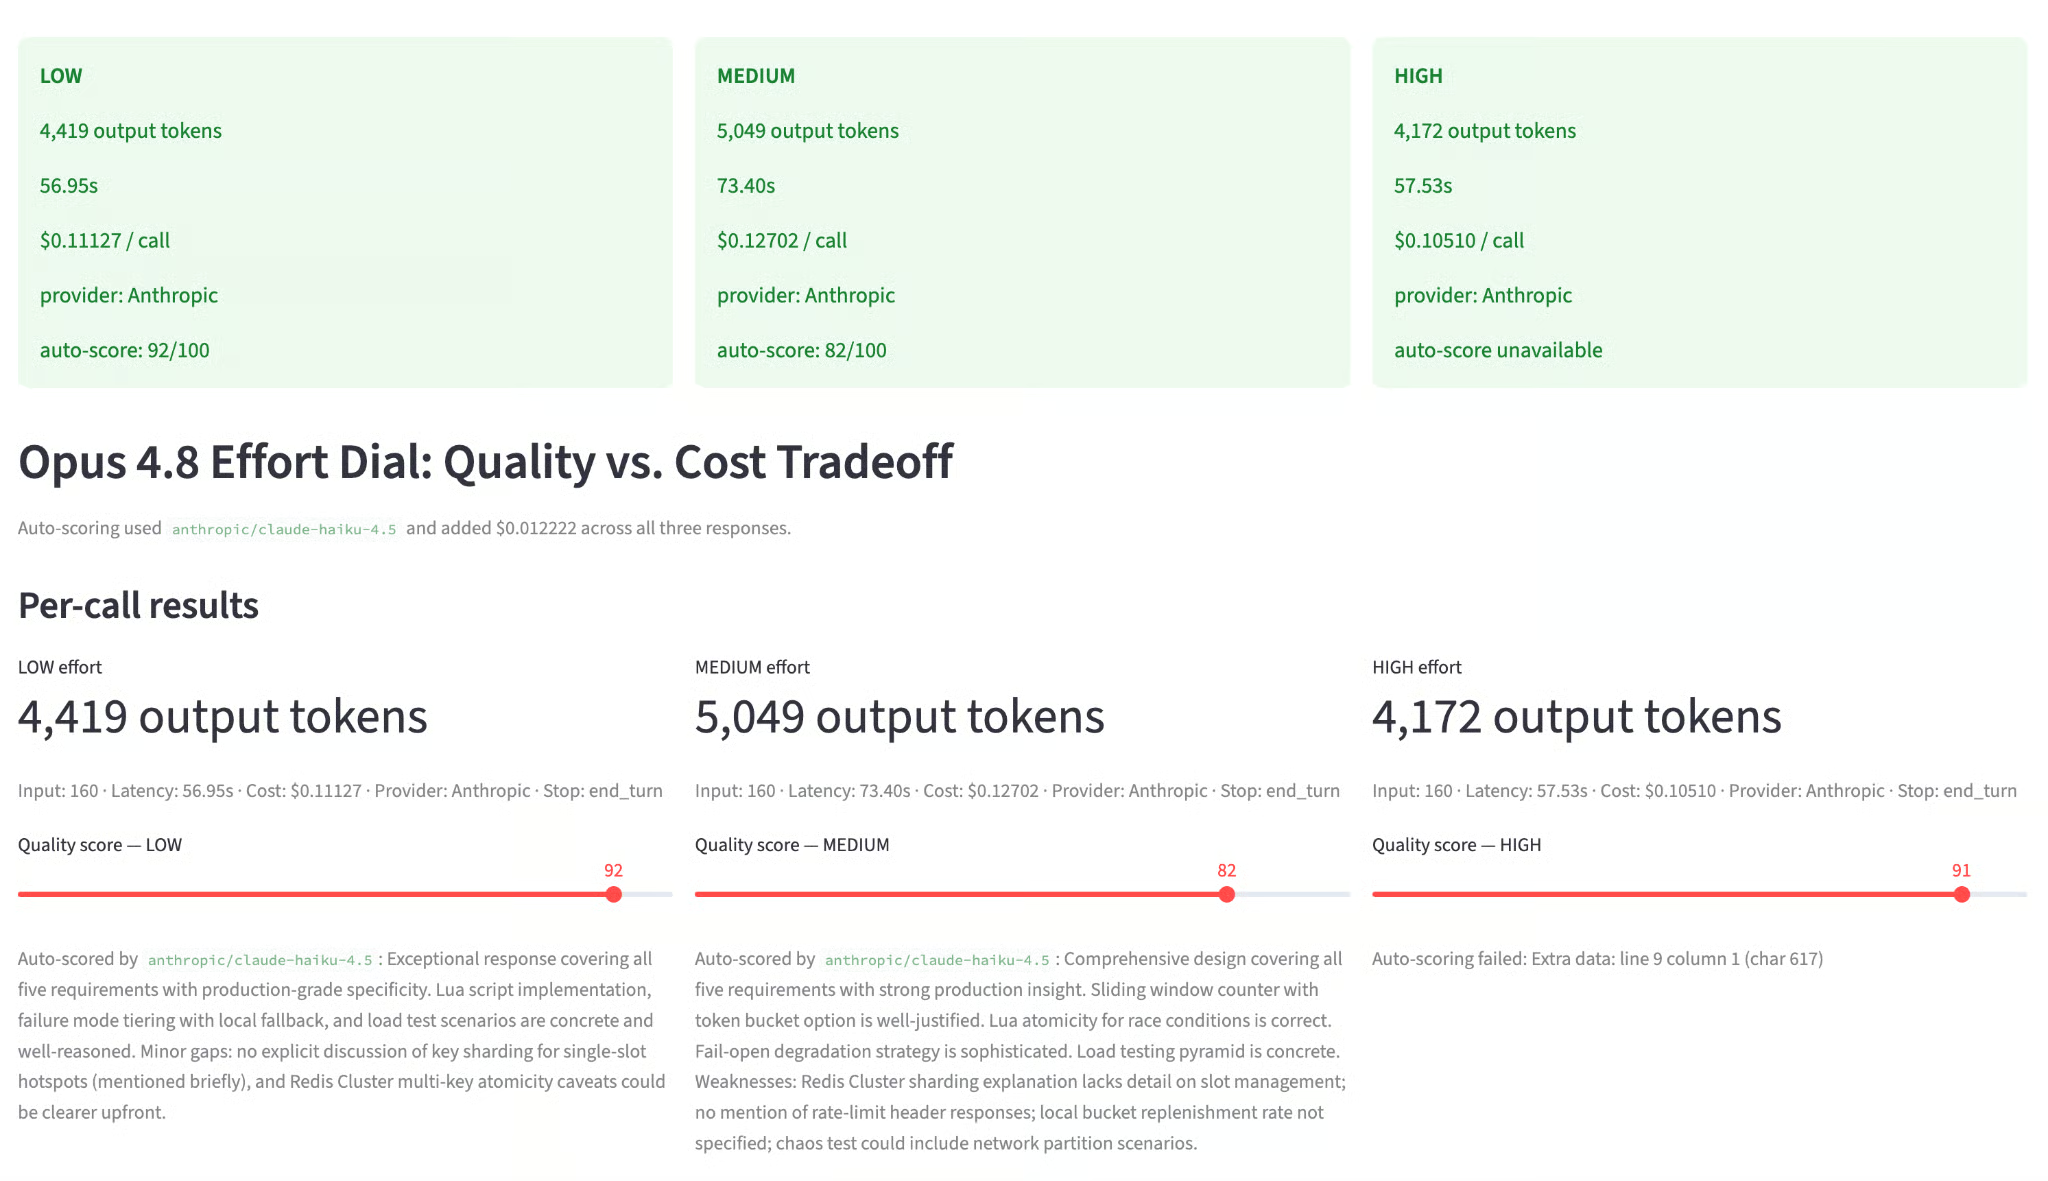
O app é um único arquivo Python. Ao rodá-lo, você vê uma barra lateral com campo de prompt e um slider de tarefas por dia, e um painel principal com quatro abas:
O fluxo em cada execução é:
claude-opus-4-8 com esforço low, medium e high, respectivamenteclaude-haiku-4-5 como avaliador baseado em rubricaO prompt padrão é uma pergunta de design de sistemas distribuídos que escala naturalmente com o nível de esforço.
Para acompanhar este tutorial, você vai precisar de:
Python 3.10 ou superior
Uma chave da Anthropic API com acesso a claude-opus-4-8
Noções básicas de Streamlit
Crie um ambiente virtual e instale os pacotes necessários:
bashpython -m venv .venv
source .venv/bin/activate
pip install anthropic streamlit plotly pandas python-dotenv
No Windows, use .venv\Scripts\activate em vez de source .venv/bin/activate.
Adicione sua chave da Anthropic a um arquivo .env na raiz do projeto:
.env
ANTHROPIC_API_KEY=sk-ant-...
Com o ambiente pronto, vamos definir o esquema effort_dial para a interface.
Crie um arquivo chamado effort_dial.py e adicione o bloco de configuração no topo:
import os
import time
import json
import re
import anthropic
import pandas as pd
import plotly.graph_objects as go
import streamlit as st
from dotenv import load_dotenv

load_dotenv()
st.set_page_config(
    page_title="Opus 4.8 Effort Dial — Claude Opus 4.8",
    layout="wide",
)
MODEL              = "claude-opus-4-8"
SCORER_MODEL       = "claude-haiku-4-5"
MAX_OUTPUT_TOKENS  = 16000
SCORER_MAX_TOKENS  = 500
PRICE_OUT_PER_TOK        = 25 / 1_000_000
PRICE_IN_PER_TOK         = 5  / 1_000_000
SCORER_PRICE_OUT_PER_TOK = 5  / 1_000_000
SCORER_PRICE_IN_PER_TOK  = 1  / 1_000_000
EFFORT_ORDER  = ["low", "medium", "high"]
EFFORT_COLORS = {"low": "#185FA5", "medium": "#639922", "high": "#EF9F27"}
DEFAULT_QUALITY = {"low": 68, "medium": 82, "high": 91}
O MAX_OUTPUT_TOKENS está em 16.000, e não no padrão 4.096. Isso importa porque, com limite de 4.096 tokens, tanto medium quanto high seriam truncados no mesmo ponto, apagando qualquer diferença visível entre eles. Você precisa de folga suficiente para as respostas se diferenciarem naturalmente.
O motivo de parada end_turn na saída final, em vez de max_tokens, também confirma que o modelo terminou por conta própria.
Um prompt simples como "explique recursão" gera respostas parecidas nos três níveis, pois não há nada difícil o bastante para acionar raciocínio profundo. Então usamos uma questão de design de sistemas em múltiplas partes:
DEFAULT_PROMPT = """\
Design a production-ready rate-limiting system for a distributed API gateway
handling 100k requests/second. Cover:
1. Algorithm choice (token bucket vs sliding window vs leaky bucket) with tradeoffs
2. Redis data structure design and TTL strategy
3. Race condition handling across 50 pods
4. Failure mode behavior when Redis is unavailable
5. How you'd test this under load
Be specific about implementation details, not just concepts.
"""
Esse prompt tem cinco subproblemas distintos. Abordagens de baixo esforço tendem a tratá-los de forma superficial, cobrindo os conceitos principais, mas sem detalhes de implementação. Em alto esforço, há cobertura de condições de borda, exemplos com Lua, discussão sobre atomicidade com EVALSHA e um plano de teste de carga com limiares concretos.
Agora defina a função central que chama o modelo. Os dois detalhes críticos são thinking={\"type\": \"adaptive\"} e output_config={\"effort\": effort}:
def call_opus(client: anthropic.Anthropic, effort: str, prompt: str) -> dict:
    t0 = time.perf_counter()
    response = client.messages.create(
        model=MODEL,
        max_tokens=MAX_OUTPUT_TOKENS,
        thinking={"type": "adaptive"},
        output_config={"effort": effort},
        # Do NOT set temperature, top_p, or top_k — those 400-error on Opus 4.8
        messages=[{"role": "user", "content": prompt}],
    )
    latency_ms = (time.perf_counter() - t0) * 1000
    in_tok  = response.usage.input_tokens
    out_tok = response.usage.output_tokens
    text = next(
        (b.text for b in response.content if b.type == "text"), "(no text block)"
    )
    return {
        "effort":        effort,
        "in_tokens":     in_tok,
        "out_tokens":    out_tok,
        "latency_ms":    latency_ms,
        "cost_usd":      in_tok * PRICE_IN_PER_TOK + out_tok * PRICE_OUT_PER_TOK,
        "response":      text,
        "stop_reason":   response.stop_reason,
        "hit_token_cap": out_tok >= MAX_OUTPUT_TOKENS,
    }
Vamos passar pelas decisões principais desta função.
thinking={\"type\": \"adaptive\"}: obrigatório para o parâmetro effort ter efeito. Sem isso, as três chamadas se comportam de forma idêntica, independentemente do effort enviado. O raciocínio adaptativo decide, a cada turno, se deve aprofundar e quanto orçamento alocar.
output_config={\"effort\": effort}: é como o SDK Python da Anthropic permite passar parâmetros ainda não expostos como argumentos nomeados. Internamente, ele mescla o dicionário ao corpo cru da requisição antes de enviar.
time.perf_counter(): usado para medir latência de relógio de parede, em vez de time.time(), pois tem maior resolução e não é afetado por ajustes do relógio do sistema.
response.content: o Opus 4.8 com raciocínio adaptativo pode retornar vários blocos, incluindo um bloco de pensamento (cadeia interna de raciocínio) e um bloco de texto (resposta final). Queremos apenas o texto para exibição. A chamada next() ignora o bloco de pensamento e extrai só a resposta para o usuário.
hit_token_cap: flag diagnóstica que fica True quando out_tokens atinge MAX_OUTPUT_TOKENS. Se isso ocorrer em medium ou high, a resposta foi cortada no meio.
Avaliar manualmente três respostas longas a cada execução é lento e subjetivo. Em vez disso, passe cada resposta para o Claude Haiku 4.5 com uma rubrica e receba uma nota estruturada em JSON.
Usar um modelo para avaliar outro é uma forma de LLM-as-a-judge; nosso guia de avaliação de LLMs explica como desenhar rubricas confiáveis.
A rubrica divide qualidade em quatro subnotas:
Isso mapeia diretamente o que diferencia os níveis de esforço em um prompt de design de sistemas:
def score_response_with_haiku(client: anthropic.Anthropic, original_prompt: str,
                               response_text: str, effort: str) -> dict:
    rubric = (
        "You are grading an answer to a difficult systems design prompt. "
        "Score the response from 0 to 100 using this rubric: "
        "completeness 30 points, technical correctness 30 points, "
        "edge-case coverage 20 points, implementation specificity 20 points. "
        "Return strict JSON only with keys: score, rationale, completeness, "
        "correctness, edge_cases, specificity. "
        "The rationale must be concise, concrete, and no more than 80 words."
    )
    grader_prompt = (
        f"{rubric}\n\n"
        f"Original prompt:\n{original_prompt}\n\n"
        f"Effort level being graded: {effort}\n\n"
        f"Candidate response:\n{response_text}"
    )
    result = client.messages.create(
        model=SCORER_MODEL,
        max_tokens=SCORER_MAX_TOKENS,
        messages=[{"role": "user", "content": grader_prompt}],
    )
    raw    = next((b.text for b in result.content if b.type == "text"), "")
    parsed = extract_json_object(raw)
    in_tok  = result.usage.input_tokens
    out_tok = result.usage.output_tokens
    score = max(0, min(100, int(round(float(parsed["score"])))))
    return {
        "score":     score,
        "rationale": str(parsed.get("rationale", "")).strip(),
        "subscores": {
            "completeness": parsed.get("completeness"),
            "correctness":  parsed.get("correctness"),
            "edge_cases":   parsed.get("edge_cases"),
            "specificity":  parsed.get("specificity"),
        },
        "scorer_model":      SCORER_MODEL,
        "scorer_cost_usd":   in_tok * SCORER_PRICE_IN_PER_TOK + out_tok * SCORER_PRICE_OUT_PER_TOK,
        "scorer_in_tokens":  in_tok,
        "scorer_out_tokens": out_tok,
    }
O helper extract_json lida com casos em que o Haiku ocasionalmente envolve o JSON em fences de Markdown. Esse é um modo de falha comum ao promptar modelos menores.
O custo total de avaliação dos três outputs geralmente fica abaixo de US$ 0,002. É um overhead desprezível que substitui uma etapa manual e subjetiva por uma rubrica repetível.
O app tem três gráficos:
Vamos criar cada um deles:
def quality_tradeoff_chart(results: list[dict], scores: dict) -> go.Figure:
    fig = go.Figure()
    for r in results:
        effort = r["effort"]
        fig.add_trace(go.Scatter(
            x=[r["cost_usd"]],
            y=[scores[effort]],
            mode="markers+text",
            name=effort.capitalize(),
            text=[effort.capitalize()],
            textposition="top center",
            marker=dict(size=18, color=EFFORT_COLORS[effort],
                        line=dict(color="white", width=2)),
            hovertemplate=(
                "<b>%{text}</b><br>"
                "Cost / call: $%{x:.5f}<br>"
                "Quality: %{y}<extra></extra>"
            ),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Cost / call (USD)", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Quality score", range=[0, 100],
                   gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def projection_chart(results: list[dict], tasks: int) -> go.Figure:
    fig = go.Figure()
    fig.add_traces([
        go.Bar(
            name="Output tokens", x=[r["effort"] for r in results],
            y=[r["out_tokens"] for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            yaxis="y1", text=[f"{r['out_tokens']:,}" for r in results],
            textposition="outside", width=0.35, offset=-0.2,
        ),
        go.Bar(
            name=f"Daily cost ({tasks:,} tasks)",
            x=[r["effort"] for r in results],
            y=[r["cost_usd"] * tasks for r in results],
            marker_color=[EFFORT_COLORS[r["effort"]] for r in results],
            marker_opacity=0.45, yaxis="y2",
            text=[f"${r['cost_usd']*tasks:.4f}" for r in results],
            textposition="outside", width=0.35, offset=0.2,
        ),
    ])
    fig.update_layout(
        barmode="group", plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        yaxis=dict(title="Output tokens", gridcolor="rgba(128,128,128,0.15)"),
        yaxis2=dict(title="Daily cost (USD)", overlaying="y", side="right"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig

def breakeven_chart(results: list[dict]) -> go.Figure:
    volumes = list(range(100, 5001, 100))
    fig = go.Figure()
    for r in results:
        fig.add_trace(go.Scatter(
            x=volumes, y=[r["cost_usd"] * v for v in volumes],
            mode="lines", name=r["effort"].capitalize(),
            line=dict(color=EFFORT_COLORS[r["effort"]], width=2.5),
        ))
    fig.update_layout(
        plot_bgcolor="rgba(0,0,0,0)", paper_bgcolor="rgba(0,0,0,0)",
        margin=dict(t=20, b=20, l=0, r=0),
        xaxis=dict(title="Tasks / day", gridcolor="rgba(128,128,128,0.15)"),
        yaxis=dict(title="Daily cost (USD)", gridcolor="rgba(128,128,128,0.15)"),
        legend=dict(orientation="h", yanchor="bottom", y=1.02, x=0),
    )
    return fig
Cada gráfico responde a uma pergunta diferente sobre os mesmos três pontos de dados.
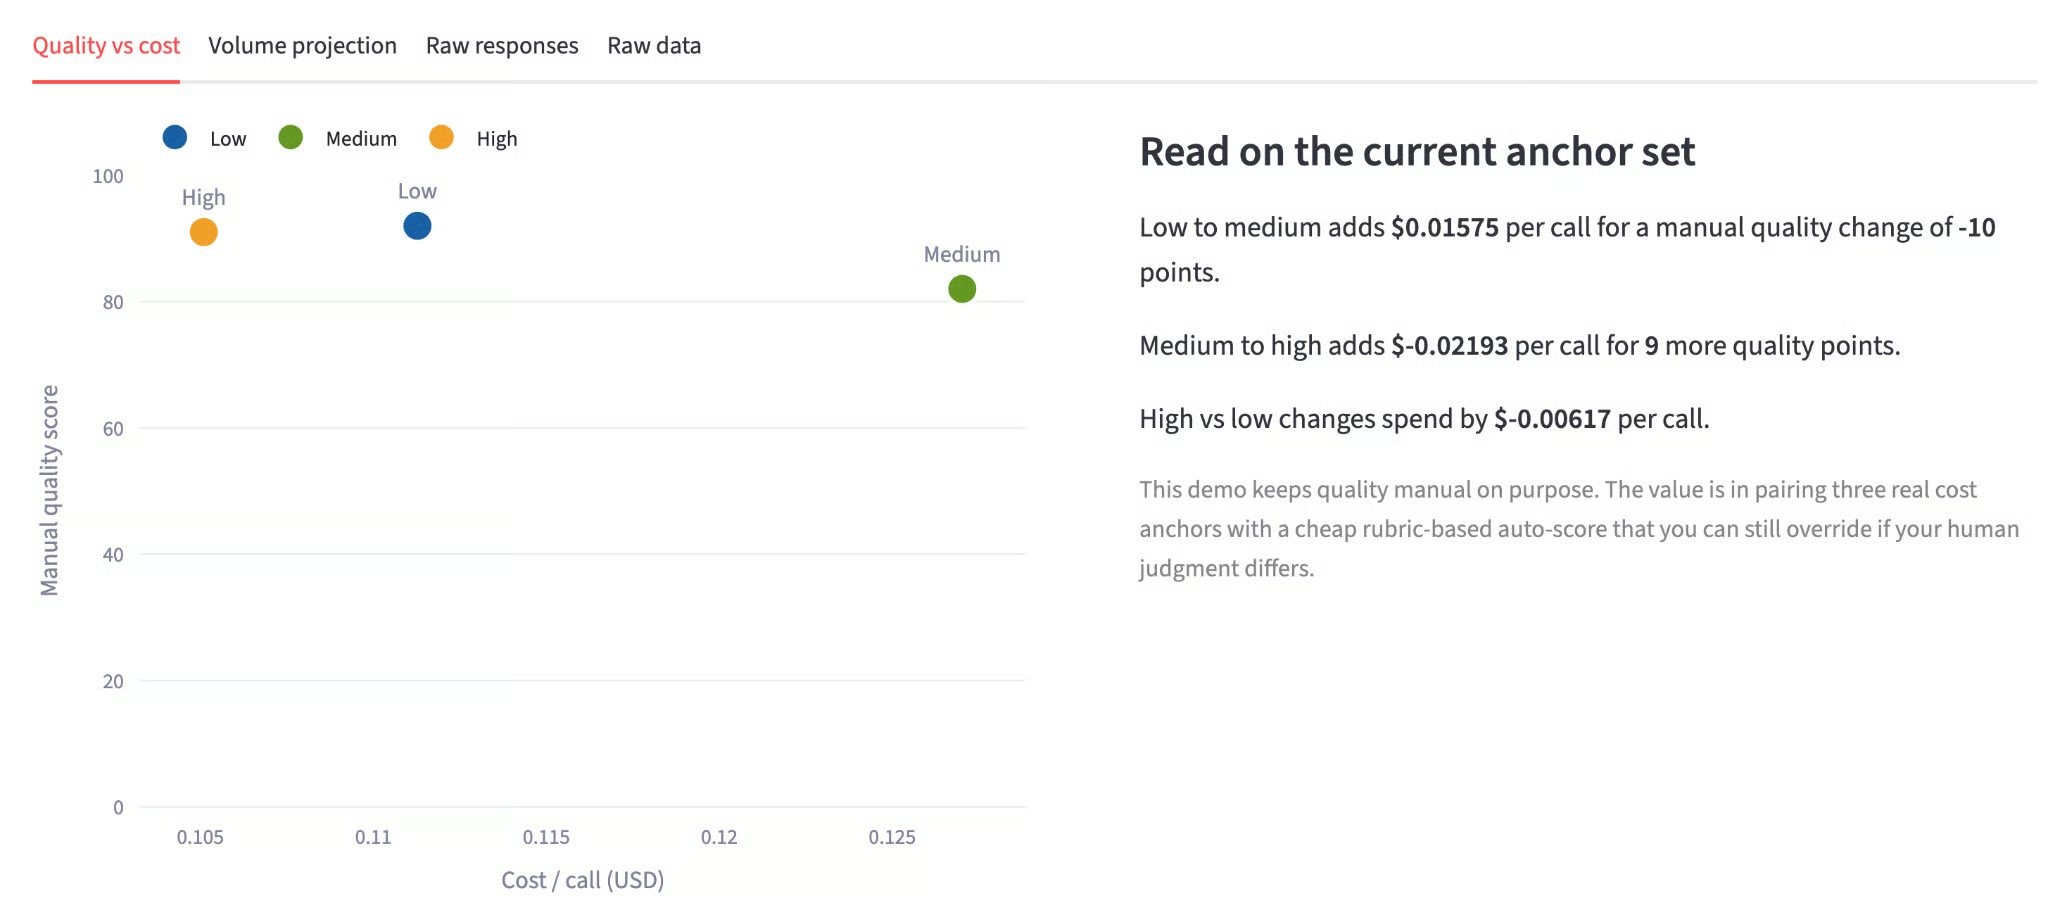
quality_tradeoff_chart plota custo no eixo x e qualidade no eixo y, deixando o formato da fronteira visível de imediato.
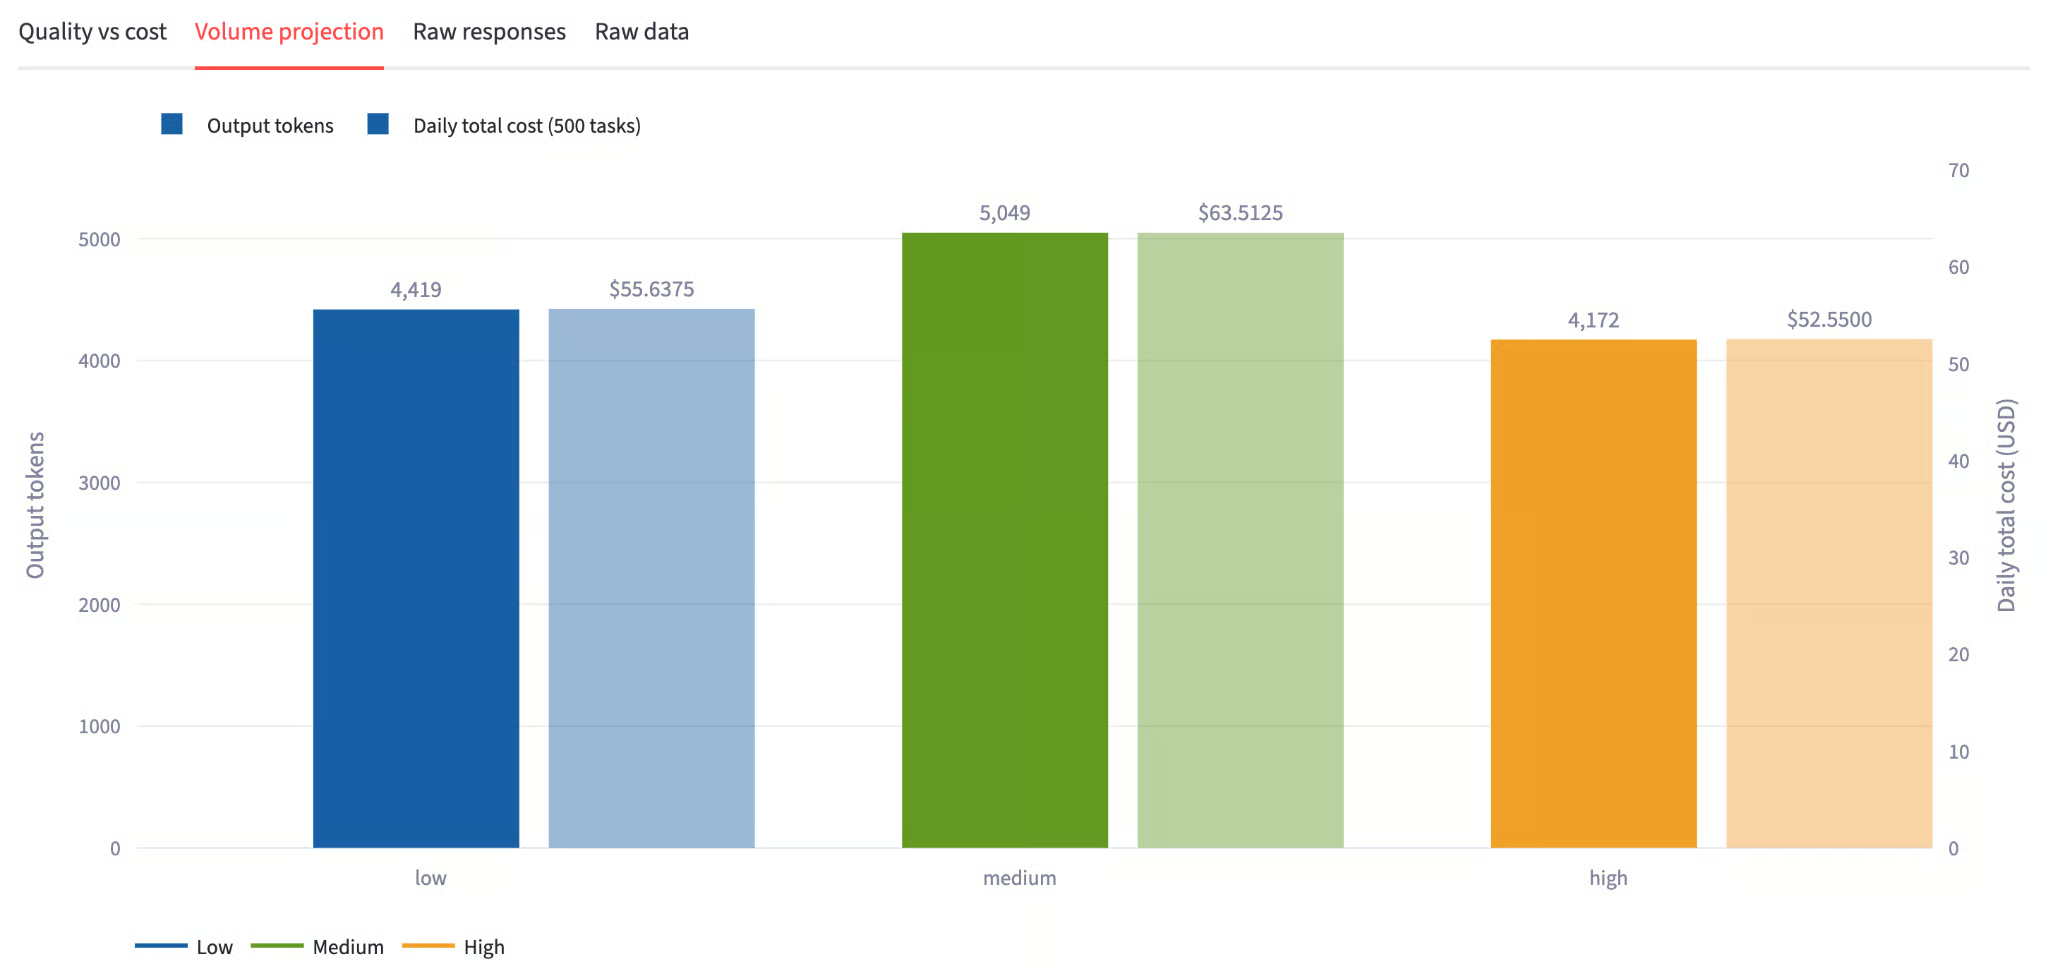
projection_chart usa o custo por chamada obtido nas respostas da API e multiplica pelo valor do slider de tarefas por dia, então cada barra reflete contagem real de tokens, não uma estimativa.
breakeven_chart varre de 100 a 5.000 tarefas/dia usando os mesmos custos reais, de modo que as linhas divergem a uma taxa ancorada nas respostas da API. Um time que roda 500 tarefas/dia vê um cenário de custo muito diferente de outro que roda 5.000 — e esse gráfico deixa isso claro.
No próximo passo, vamos conectar essas três funções de gráfico à UI do Streamlit e aos resultados vivos da API.
A última peça é a interface no Streamlit. A barra lateral cuida da chave, do prompt e do slider de tarefas por dia. O painel principal executa as chamadas sequencialmente e atualiza os cards de progresso conforme cada uma termina.
def main():
    api_key = os.getenv("ANTHROPIC_API_KEY", "").strip()
    with st.sidebar:
        st.title("Opus 4.8 Effort Dial")
        st.divider()
        if api_key:
            st.success("Key loaded.")
        else:
            st.error("Missing ANTHROPIC_API_KEY. Set it in your .env file.")
        prompt = st.text_area(
            "Prompt (runs at all 3 effort levels)",
            value=DEFAULT_PROMPT, height=220,
        )
        run = st.button("▶ Run 3 calls", use_container_width=True, type="primary")
        st.divider()
        tasks = st.slider("Tasks / day", min_value=10, max_value=5000, value=500, step=10)
    if "results" not in st.session_state:
        st.session_state.results = []
    for effort, default in DEFAULT_QUALITY.items():
        if f"quality_{effort}" not in st.session_state:
            st.session_state[f"quality_{effort}"] = default
    if run:
        if not api_key:
            st.error("Set ANTHROPIC_API_KEY first.")
            st.stop()
        client = anthropic.Anthropic(api_key=api_key)
        collected = []
        progress   = st.progress(0, text="Starting calls…")
        cols       = st.columns(3)
        holders    = {e: cols[i].empty() for i, e in enumerate(EFFORT_ORDER)}
        for i, effort in enumerate(EFFORT_ORDER):
            holders[effort].info(f"**{effort.upper()}** — calling…")
            progress.progress(i / 3, text=f"Running {effort} effort…")
            try:
                result = call_opus(client, effort, prompt)
                try:
                    scored = score_response_with_haiku(
                        client, prompt, result["response"], effort
                    )
                    result.update(scored)
                    st.session_state[f"quality_{effort}"] = scored["score"]
                    score_line = f"auto-score: {scored['score']}/100"
                except Exception as e:
                    result["score_error"] = str(e)
                    score_line = "auto-score unavailable"
                collected.append(result)
                holders[effort].success(
                    f"**{effort.upper()}**\n\n"
                    f"{result['out_tokens']:,} output tokens\n\n"
                    f"{result['latency_ms']/1000:.2f}s\n\n"
                    f"${result['cost_usd']:.5f} / call\n\n"
                    f"{score_line}"
                )
            except Exception as exc:
                holders[effort].error(f"**{effort.upper()}** failed: {exc}")
            progress.progress((i + 1) / 3)
        st.session_state.results = sorted(
            collected, key=lambda r: EFFORT_ORDER.index(r["effort"])
        )
        progress.empty()
    st.header("Opus 4.8 Effort Dial: Quality vs. Cost Tradeoff")
    results = st.session_state.results
    if not results:
        st.info("Set your API key and click **▶ Run 3 calls** to start.")
        st.stop()
    if any(r.get("hit_token_cap") for r in results):
        st.warning(
            f"One or more calls hit the {MAX_OUTPUT_TOKENS:,}-token cap. "
            "Raise MAX_OUTPUT_TOKENS if medium and high still look similar."
        )
    scorer_spend = sum(r.get("scorer_cost_usd", 0) for r in results)
    if scorer_spend > 0:
        st.caption(
            f"Auto-scoring used {SCORER_MODEL} and added "
            f"${scorer_spend:.6f} across all three responses."
        )
    # Per-call metric cards
    st.subheader("Per-call results")
    scores = {e: int(st.session_state.get(f"quality_{e}", DEFAULT_QUALITY[e]))
              for e in EFFORT_ORDER}
    mcols = st.columns(3)
    for row, col in zip(results, mcols):
        effort = row["effort"]
        with col:
            st.metric(f"{effort.upper()} effort", f"{row['out_tokens']:,} output tokens")
            st.caption(
                f"Input: {row['in_tokens']:,} · "
                f"Latency: {row['latency_ms']/1000:.2f}s · "
                f"Cost: ${row['cost_usd']:.5f} · "
                f"Stop: {row.get('stop_reason', 'n/a')}"
            )
            st.slider(
                f"Quality score — {effort.upper()}",
                min_value=0, max_value=100,
                value=DEFAULT_QUALITY[effort],
                key=f"quality_{effort}",
            )
            if row.get("rationale"):
                st.caption(f"Auto-scored by {SCORER_MODEL}: {row['rationale']}")
    st.divider()
    # Tabs
    t1, t2, t3, t4 = st.tabs(
        ["Quality vs cost", "Volume projection", "Raw responses", "Raw data"]
    )
    with t1:
        left, right = st.columns([1.1, 1], gap="large")
        with left:
            st.plotly_chart(quality_tradeoff_chart(results, scores),
                            use_container_width=True)
        with right:
            low  = next((r for r in results if r["effort"] == "low"),  None)
            med  = next((r for r in results if r["effort"] == "medium"), None)
            high = next((r for r in results if r["effort"] == "high"), None)
            if low and med and high:
                st.markdown("#### Read on the current anchor set")
                st.write(
                    f"Low → medium adds **${med['cost_usd'] - low['cost_usd']:.5f}** per call "
                    f"for **{scores['medium'] - scores['low']}** quality points."
                )
                st.write(
                    f"Medium → high adds **${high['cost_usd'] - med['cost_usd']:.5f}** per call "
                    f"for **{scores['high'] - scores['medium']}** more quality points."
                )
                st.write(
                    f"High vs low: **${high['cost_usd'] - low['cost_usd']:.5f}** "
                    f"total per-call delta."
                )
                st.caption(
                    "Quality scores are auto-generated by Haiku 4.5 using a rubric, "
                    "but you can override them with the sliders above."
                )
    with t2:
        st.plotly_chart(projection_chart(results, tasks), use_container_width=True)
        st.plotly_chart(breakeven_chart(results), use_container_width=True)
        if low and high:
            daily_delta   = (high["cost_usd"] - low["cost_usd"]) * tasks
            monthly_delta = daily_delta * 30
            st.caption(
                f"High vs low at {tasks:,} tasks/day: "
                f"**+${daily_delta:.4f}/day** · **+${monthly_delta:.2f}/month**"
            )
    with t3:
        for row in results:
            with st.expander(
                f"{row['effort'].upper()} — {row['out_tokens']:,} tokens",
                expanded=True,
            ):
                if row.get("rationale"):
                    st.info(
                        f"Auto-score: **{scores[row['effort']]}/100**. "
                        f"{row['rationale']}"
                    )
                st.markdown(row["response"])
    with t4:
        df = pd.DataFrame([{
            "Effort":            r["effort"],
            "Quality score":     scores[r["effort"]],
            "Input tokens":      r["in_tokens"],
            "Output tokens":     r["out_tokens"],
            "Latency (s)":       round(r["latency_ms"] / 1000, 2),
            "Cost / call ($)":   round(r["cost_usd"], 6),
            "Auto-score cost ($)": round(r.get("scorer_cost_usd", 0), 6),
            f"Daily @ {tasks} tasks ($)": round(r["cost_usd"] * tasks, 4),
            f"Monthly @ {tasks} tasks/day ($)": round(r["cost_usd"] * tasks * 30, 2),
        } for r in results])
        st.dataframe(df, use_container_width=True, hide_index=True)
        st.download_button(
            "Download CSV",
            df.to_csv(index=False),
            file_name="effort_dial_results.csv",
            mime="text/csv",
        )
if __name__ == "__main__":
    main()
A barra lateral concentra toda a configuração — carregar a chave da API, inserir o prompt e ajustar o slider de tarefas por dia — deixando o painel principal limpo para os resultados. O painel principal é dividido em quatro abas para manter o fluxo organizado.
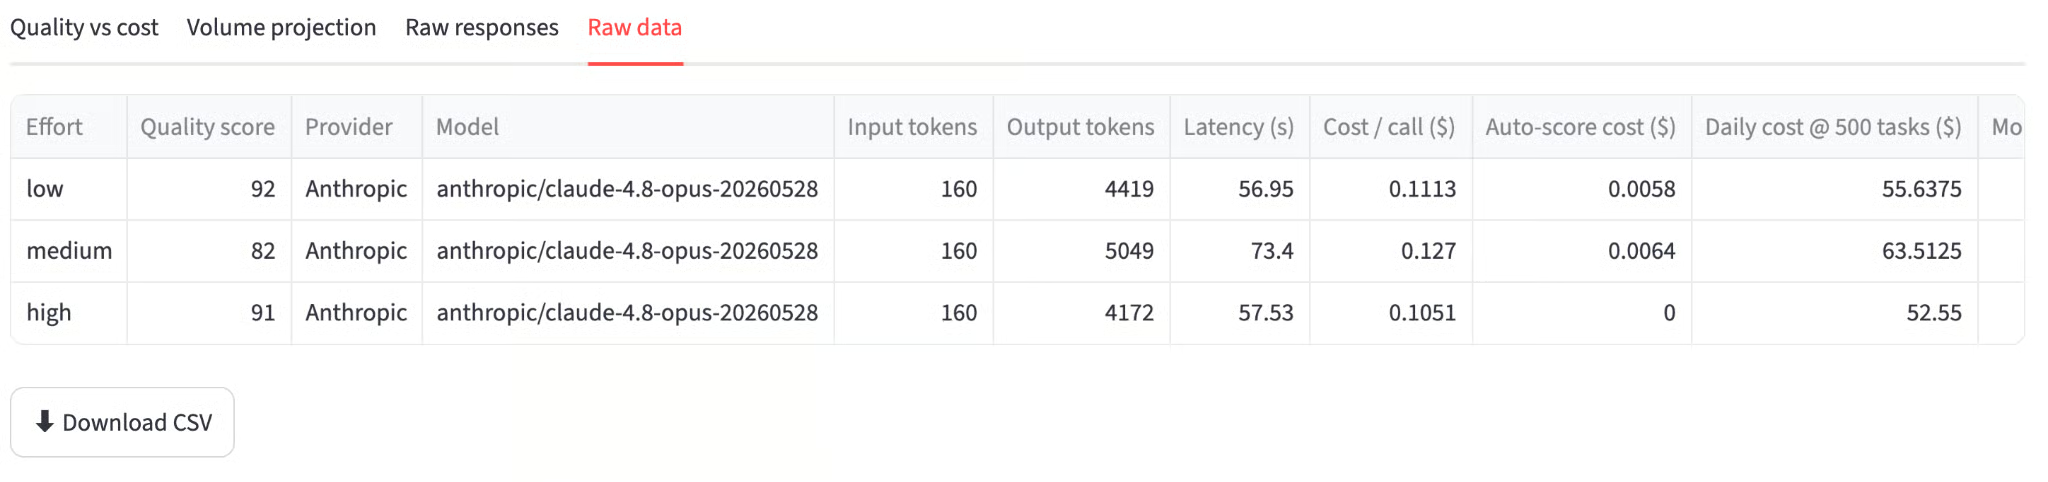
Com backend, gráficos e UI prontos, o app está pronto para rodar.
Inicie o servidor do Streamlit:
streamlit run effort_dial.pyAbra http://localhost:8501 e mantenha o prompt padrão ou troque por algo do seu pipeline e clique em Run 3 calls.
O app executa cada nível de esforço em sequência, exibindo um card de status após cada término. Quando os três acabam, ele roda as três chamadas de avaliação no Haiku e preenche os gráficos. O tempo total de parede costuma ficar entre 2 e 3 minutos com o prompt padrão — a maior parte no nível high.
Aqui estão os números de uma execução representativa com o prompt de rate limiting:
|
Esforço |
Tokens de saída |
Latência |
Custo/chamada |
Auto-score |
|
Low |
3.276 |
46s |
US$ 0,0827 |
72/100 |
|
Medium |
5.109 |
70s |
US$ 0,1285 |
82/100 |
|
High |
5.382 |
71s |
US$ 0,1354 |
92/100 |
Aqui vão alguns destaques:
As contagens de tokens estão em ordem (3.276 -> 5.109 -> 5.382), com end_turn como motivo de parada nas três. Isso confirma que o parâmetro de esforço está sendo aplicado corretamente e que as respostas finalizam naturalmente.
O salto de qualidade de low para medium (+10 pontos) custa US$ 0,046 por chamada. O salto de medium para high (+10 pontos) custa apenas US$ 0,007. O nível medium captura a maior parte do ganho de qualidade por um custo incremental cerca de seis vezes menor que o último passo para high.
O scatter plot deixa essa assimetria evidente. Low fica no canto inferior esquerdo — barato, porém menos completo. Medium fica no meio. High fica no topo à direita, mas só um pouco mais caro que medium porque a diferença de tokens entre esses dois níveis é pequena nesse prompt.
A justificativa do Haiku também é instrutiva. Na resposta low, notou: "forte profundidade técnica na escolha de algoritmos e scripting em Lua, mas faltam detalhes concretos de roteamento pod-to-shard e como o sharding se coordena entre pods". Em high: "resposta excepcional cobrindo os cinco requisitos com profundidade de produção, com scripts EVALSHA e exemplos concretos de casos de borda".
Neste tutorial, criamos um app em Streamlit que faz três chamadas reais à API do Claude Opus 4.8 (uma por nível de esforço), atribui nota automática a cada resposta com o Haiku 4.5 e projeta o custo no seu volume de tarefas.
Os pontos centrais: effort e thinking: {type: \"adaptive\"} trabalham juntos para controlar a profundidade do raciocínio; um modelo juiz barato pode substituir avaliação manual com uma rubrica repetível a custo irrisório. Também vimos que a fronteira custo-qualidade não é linear — o nível medium captura a maior parte do ganho de qualidade por uma fração do custo incremental do high.
Em 1.000 tarefas/dia, mudar de high para medium economiza aproximadamente US$ 207/mês, com queda de cerca de 10 pontos em uma rubrica de 100 pontos. Para tarefas bem definidas como classificação, extração ou sumarização, medium tende a ser suficiente. Já para tarefas que exigem raciocínio técnico profundo ou cobertura abrangente de casos de borda — como revisão de código, design de arquitetura e análise de políticas — o nível high justifica o custo.
Extensões possíveis incluem adicionar um segundo tipo de prompt para mostrar como o delta de esforço colapsa quando o problema não requer raciocínio profundo, ou uma visualização lado a lado destacando exatamente onde o high adiciona detalhes concretos que o medium não traz.
Aprenda IA com a DataCamp!
Curso
Curso
Programa
blog
Abid Ali Awan
9 min
Tutorial
Abid Ali Awan
Tutorial
Abid Ali Awan
8 min
Tutorial
Nadia mhadhbi
15 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Moez Ali
11 min