Kursus
Mengembangkan Aplikasi LLM dengan LangChain
3 jam
51.9K
Mendeploy large language model (LLM) ke produksi dapat mentransformasi aplikasi Anda, menghadirkan kemampuan canggih dalam pemahaman dan generasi bahasa alami. Namun, proses ini penuh tantangan yang dapat menghambat bahkan pengembang paling berpengalaman sekalipun.
Dalam panduan ini, kami akan membahas cara mendeploy aplikasi LLM menggunakan LangServe, sebuah alat yang dirancang untuk menyederhanakan dan merampingkan proses kompleks ini. Mulai dari instalasi hingga integrasi, Anda akan mempelajari langkah-langkah penting untuk berhasil mengimplementasikan LLM dan membuka seluruh potensinya.
Membangun aplikasi berbasis LLM lebih kompleks daripada sekadar memanggil API. Meskipun integrasi LLM ke proyek Anda dapat meningkatkan kapabilitasnya secara signifikan, hal ini hadir dengan serangkaian tantangan unik yang memerlukan pertimbangan cermat. Di bawah ini, kami jabarkan hambatan utama yang mungkin Anda temui dan sorotan aspek deployment yang memerlukan perhatian.
Memilih model yang tepat untuk aplikasi Anda adalah rintangan pertama. Pilihan ini bergantung pada berbagai faktor, seperti tugas spesifik, akurasi yang dibutuhkan, dan sumber daya komputasi yang tersedia. Selain itu, menyesuaikan model pra-latih agar sesuai kebutuhan aplikasi dapat kompleks, melibatkan fine-tuning dengan data spesifik domain.
LLM menuntut komputasi intensif dan membutuhkan sumber daya besar. Memastikan infrastruktur Anda mampu menangani kebutuhan memori dan daya pemrosesan yang tinggi sangatlah krusial. Ini termasuk perencanaan skalabilitas untuk mengakomodasi pertumbuhan di masa depan dan potensi peningkatan penggunaan.
Mencapai latensi rendah penting untuk pengalaman pengguna yang mulus. LLM dapat lambat memproses permintaan, terutama saat beban tinggi. Optimalisasi kinerja meliputi strategi seperti kompresi model, kerangka kerja serving yang efisien, dan kemungkinan mengalihkan sebagian tugas pemrosesan ke perangkat edge.
Setelah dideploy, pemantauan berkelanjutan terhadap aplikasi LLM diperlukan. Ini mencakup pelacakan metrik kinerja, deteksi anomali, dan pengelolaan model drift. Pemeliharaan rutin memastikan model tetap akurat dan efisien seiring waktu, memerlukan pembaruan berkala dan pelatihan ulang dengan data baru.
Mengintegrasikan LLM dengan sistem dan alur kerja yang ada bisa menjadi tantangan. Memastikan kompatibilitas dengan berbagai lingkungan perangkat lunak, API, dan format data memerlukan perencanaan dan eksekusi yang cermat. Integrasi tanpa hambatan adalah kunci untuk memaksimalkan potensi LLM dalam aplikasi Anda.
Tuntutan komputasi tinggi dari LLM dapat menyebabkan biaya operasional signifikan. Menyeimbangkan kinerja dengan efisiensi biaya adalah pertimbangan penting. Strategi pengelolaan biaya termasuk mengoptimalkan alokasi sumber daya, menggunakan layanan cloud yang hemat biaya, dan meninjau pola penggunaan secara berkala untuk mengidentifikasi area penghematan.
Mendeploy LLM ke produksi adalah proses kompleks yang melibatkan orkestrasi banyak sistem dan komponen. Ini melampaui sekadar mengintegrasikan model bahasa yang kuat ke aplikasi Anda; dibutuhkan infrastruktur yang kohesif di mana tiap bagian memainkan peran penting.
Untuk memahami seluk-beluk deployment aplikasi LLM, sangat penting mengeksplorasi berbagai komponen yang terlibat dan interaksinya. Diagram berikut menggambarkan arsitektur aplikasi LLM modern, menyoroti elemen kunci dan relasinya dalam sistem.
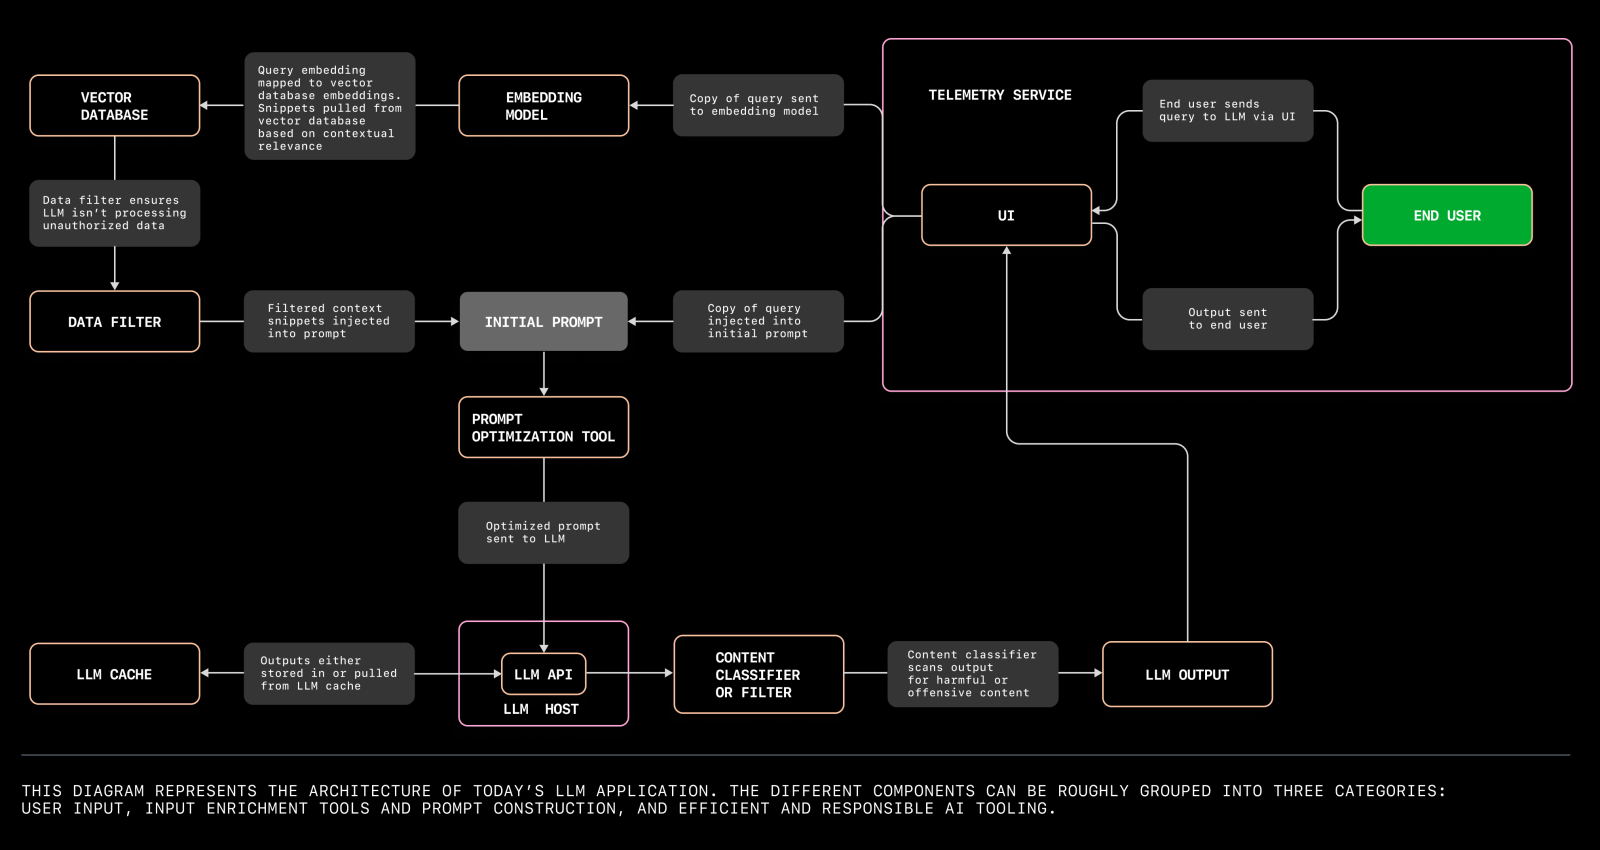
Diagram yang menggambarkan arsitektur aplikasi LLM modern. Sumber
Arsitektur aplikasi LLM dapat dipecah menjadi beberapa aspek inti:
Basis data vektor merupakan fondasi untuk mengelola data berdimensi tinggi yang dihasilkan LLM. Basis data ini menyimpan dan mengambil vektor secara efisien, memungkinkan pencarian kemiripan yang cepat dan akurat. Ini sangat diperlukan untuk aplikasi seperti pencarian semantik, sistem rekomendasi, dan pengalaman pengguna yang dipersonalisasi.
Saat mendeploy LLM, memilih basis data vektor yang tangguh dan dapat diskalakan seiring aplikasi Anda adalah kunci untuk menjaga performa dan responsivitas.
Template prompt adalah struktur pradefinisi yang membantu menstandarkan interaksi dengan LLM. Ini memastikan konsistensi dan keandalan dalam respons yang dihasilkan model.
Merancang template prompt yang efektif membutuhkan pemahaman terhadap nuansa model dan kebutuhan spesifik aplikasi Anda. Template yang disusun dengan baik dapat meningkatkan kualitas dan relevansi keluaran secara signifikan, sehingga meningkatkan kepuasan pengguna.
Mendeploy aplikasi LLM melibatkan koordinasi berbagai tugas seperti prapemrosesan data, inferensi model, dan pascapemrosesan. Alat manajemen alur kerja dan kerangka orkestrasi seperti Apache Airflow atau Kubernetes membantu mengotomatiskan dan merampingkan proses ini. Alat-alat tersebut memastikan tiap komponen beroperasi dengan lancar dan efisien, mengurangi risiko kesalahan dan downtime.
Infrastruktur yang mendukung aplikasi LLM Anda harus tangguh dan dapat diskalakan. Ini mencakup layanan cloud, akselerator perangkat keras (seperti GPU atau TPU), dan kapabilitas jaringan. Skalabilitas memastikan aplikasi Anda dapat menangani peningkatan beban dan permintaan pengguna tanpa mengorbankan performa.
Memanfaatkan kebijakan autoscaling dan strategi load balancing dapat membantu mengelola sumber daya secara efektif dan menjaga kualitas layanan.
Pemantauan dan logging berkelanjutan sangat penting untuk menjaga kesehatan dan kinerja aplikasi LLM Anda. Alat pemantauan memberikan wawasan real-time tentang performa sistem, pola penggunaan, dan potensi masalah.
Mekanisme logging menangkap informasi detail tentang operasi aplikasi, yang sangat berharga untuk debugging dan optimalisasi. Keduanya membantu memastikan aplikasi berjalan lancar dan dapat cepat beradaptasi terhadap perubahan atau anomali.
Mendeploy LLM juga melibatkan pemenuhan kebutuhan keamanan dan kepatuhan. Ini mencakup melindungi data sensitif, menerapkan kontrol akses, dan memastikan kepatuhan terhadap regulasi yang relevan seperti GDPR atau HIPAA. Langkah-langkah keamanan harus diintegrasikan pada setiap lapisan proses deployment untuk melindungi dari kebocoran data dan akses tidak sah.
Aplikasi LLM Anda harus terintegrasi mulus dengan sistem dan alur kerja yang ada. Ini melibatkan memastikan kompatibilitas dengan alat perangkat lunak lain, API, dan format data yang digunakan di organisasi Anda.
Integrasi yang efektif meningkatkan fungsionalitas dan efisiensi keseluruhan aplikasi Anda, memungkinkan pemanfaatan sumber daya dan infrastruktur yang sudah ada.
Ada beberapa pendekatan untuk mendeploy LLM ke produksi, masing-masing dengan kelebihan dan tantangannya.
Deployment on-premises melibatkan hosting LLM di server lokal atau pusat data, menawarkan kendali lebih besar atas data dan infrastruktur namun memerlukan investasi signifikan pada perangkat keras dan pemeliharaan.
Deployment berbasis cloud memanfaatkan layanan cloud untuk meng-host LLM, menyediakan skalabilitas, fleksibilitas, dan biaya awal yang lebih rendah, meski dapat menimbulkan kekhawatiran terkait privasi data dan biaya operasional berkelanjutan.
Deployment hibrida menggabungkan sumber daya on-premises dan cloud, menawarkan keseimbangan antara kontrol dan skalabilitas, memungkinkan organisasi mengoptimalkan kinerja dan biaya sesuai kebutuhan spesifik.
Memahami kelebihan dan kekurangan tiap pendekatan sangat penting untuk membuat keputusan yang tepat dan selaras dengan tujuan serta sumber daya organisasi Anda.
Mendeploy large language models (LLM) ke produksi membutuhkan rangkaian alat yang dapat menangani berbagai aspek proses deployment, dari manajemen infrastruktur hingga pemantauan dan optimalisasi. Pada bagian ini, kami membahas lima alat teratas yang banyak digunakan untuk mendeploy LLM ke produksi.
Setiap alat dievaluasi berdasarkan skalabilitas, kemudahan penggunaan, kapabilitas integrasi, dan efektivitas biaya.
LangServe dirancang khusus untuk mendeploy aplikasi LLM. Alat ini menyederhanakan proses deployment dengan menyediakan alat yang andal untuk instalasi, integrasi, dan optimalisasi. LangServe mendukung berbagai LLM dan menawarkan integrasi mulus dengan sistem yang ada.
Kubernetes adalah platform orkestrasi kontainer open source yang mengotomatiskan deployment, penskalaan, dan manajemen aplikasi terkontainerisasi. Sangat fleksibel dan dapat digunakan untuk mengelola infrastruktur yang dibutuhkan deployment LLM.
TensorFlow Serving adalah sistem serving yang fleksibel dan berkinerja tinggi untuk model machine learning, dirancang untuk lingkungan produksi. Memudahkan deployment algoritma baru dan eksperimen sambil mempertahankan arsitektur server dan API yang sama.
Amazon SageMaker adalah layanan terkelola penuh yang menyediakan kemampuan bagi setiap pengembang dan data scientist untuk membangun, melatih, dan mendeploy model machine learning dengan cepat. Terintegrasi dengan layanan AWS lainnya, menjadikannya alat yang komprehensif untuk deployment LLM.
MLflow adalah platform open source untuk mengelola siklus hidup ML, termasuk eksperimen, reprodusibilitas, dan deployment. Menyediakan repositori terpusat untuk model dan dapat diintegrasikan dengan banyak pustaka machine learning.
|
Alat |
Skalabilitas |
Kemudahan Penggunaan |
Kapabilitas Integrasi |
Efektivitas Biaya |
|
LangServe |
Tinggi |
Tinggi |
Sangat baik |
Sedang |
|
Kubernetes |
Tinggi |
Sedang |
Sangat baik |
Tinggi (Open Source) |
|
TensorFlow Serving |
Tinggi |
Sedang |
Sangat baik |
Tinggi (Open Source) |
|
Amazon SageMaker |
Tinggi |
Tinggi |
Sangat baik (dengan AWS) |
Sedang hingga Tinggi |
|
MLflow |
Sedang hingga Tinggi |
Sedang |
Sangat baik |
Tinggi (Open Source) |
LangServe adalah alat khusus yang dirancang untuk menyederhanakan proses deployment aplikasi LLM. Pada bagian ini, kami memberikan walkthrough teknis penggunaan LangServe untuk mendeploy aplikasi chatGPT guna merangkum teks.
Pertama, kita perlu menginstal LangServe. Anda dapat memasang komponen klien dan server sekaligus atau hanya salah satunya, sesuai kebutuhan.
pip install "langserve[all]"Sebagai alternatif, Anda dapat memasang komponen secara terpisah:
install "langserve[client]"install "langserve[server]"LangChain CLI adalah alat berguna untuk dengan cepat mem-bootstrapping proyek LangServe. Pastikan Anda telah memasang versi terbaru:
install -U langchain-cliGunakan LangChain CLI untuk membuat aplikasi baru, lalu ubah direktori kerja Anda saat ini ke my-app:
app new my-appmy-appLangServe menggunakan Poetry untuk manajemen dependensi. Jika Anda belum familiar dengan Poetry, lihat dokumentasi Poetry untuk informasi lebih lanjut.
Untuk menambahkan paket yang relevan, gunakan:
add langchain-openai langchain langchain communityPerintah ini memastikan semua dependensi yang diperlukan tersedia untuk proyek kita.
Pastikan Anda menyiapkan variabel lingkungan yang diperlukan untuk aplikasi kita. Dalam kasus ini, kita perlu menetapkan kunci API OpenAI untuk membuat permintaan yang valid:
OPENAI_API_KEY="sk-..."Pastikan untuk mengganti “sk-...” dengan kunci API Anda yang sebenarnya. Anda dapat membuat kunci API melalui platform OpenAI.
Arahkan ke berkas ```server.py```. Berkas ini berisi logika utama untuk aplikasi LangServe kita. Berikut contoh aplikasi LangServe sederhana yang menyertakan rute untuk merangkum teks menggunakan model bahasa OpenAI:
fastapi import FastAPI
from langchain.prompts import ChatPromptTemplate
from langchain.chat_models import ChatOpenAI
from langserve import add_routes
app = FastAPI(
	title="LangChain Server",
	version="1.0",
	description="A simple API server using Langchain's Runnable interfaces",
)
# Define a route for the OpenAI chat model
add_routes(
	app,
	ChatOpenAI(),
	path="/openai",
)
# Define a route with a custom prompt
summarize_prompt = ChatPromptTemplate.from_template("Summarize the following text: {text}")
add_routes(
	app,
	summarize_prompt | ChatOpenAI(),
	path="/summarize",
)
if __name__ == "__main__":
	import uvicorn
	uvicorn.run(app, host="localhost", port=8000)
Mari kita cermati komponen kunci dari aplikasi LangServe dasar kita:
FastAPI digunakan untuk membuat server web.ChatPromptTemplate dan ChatOpenAI digunakan dari LangChain untuk mendefinisikan prompt dan model.add_routes dari LangServe digunakan untuk menambahkan rute ke aplikasi FastAPI.FastAPI diinisialisasi dengan metadata seperti judul, versi, dan deskripsi.add_routes pertama menambahkan rute /openai yang terhubung langsung dengan model chat OpenAI.add_routes kedua mendefinisikan rute prompt kustom /summarize. Rute ini menerima teks masukan dan menggunakan prompt untuk menghasilkan versi ringkasan teks menggunakan model OpenAI.Fungsi uvicorn.run digunakan untuk memulai server FastAPI pada localhost di port 8000.
Pada contoh ini, kita menambahkan rute /summarize yang menggunakan prompt untuk merangkum teks. Anda juga dapat memperluas fungsionalitas aplikasi LangServe dengan mendefinisikan rute dan prompt tambahan. Misalnya:
joke_prompt = ChatPromptTemplate.from_template("Tell me a joke about {topic}")
add_routes(
            app,
            joke_prompt | ChatOpenAI(),
            path="/joke",
)
Terakhir, gunakan Poetry untuk melayani aplikasi Anda pada port yang diinginkan:
run langchain serve --port=8100Jika semuanya sudah disiapkan dengan benar, Anda akan melihat sesuatu seperti ini di terminal:
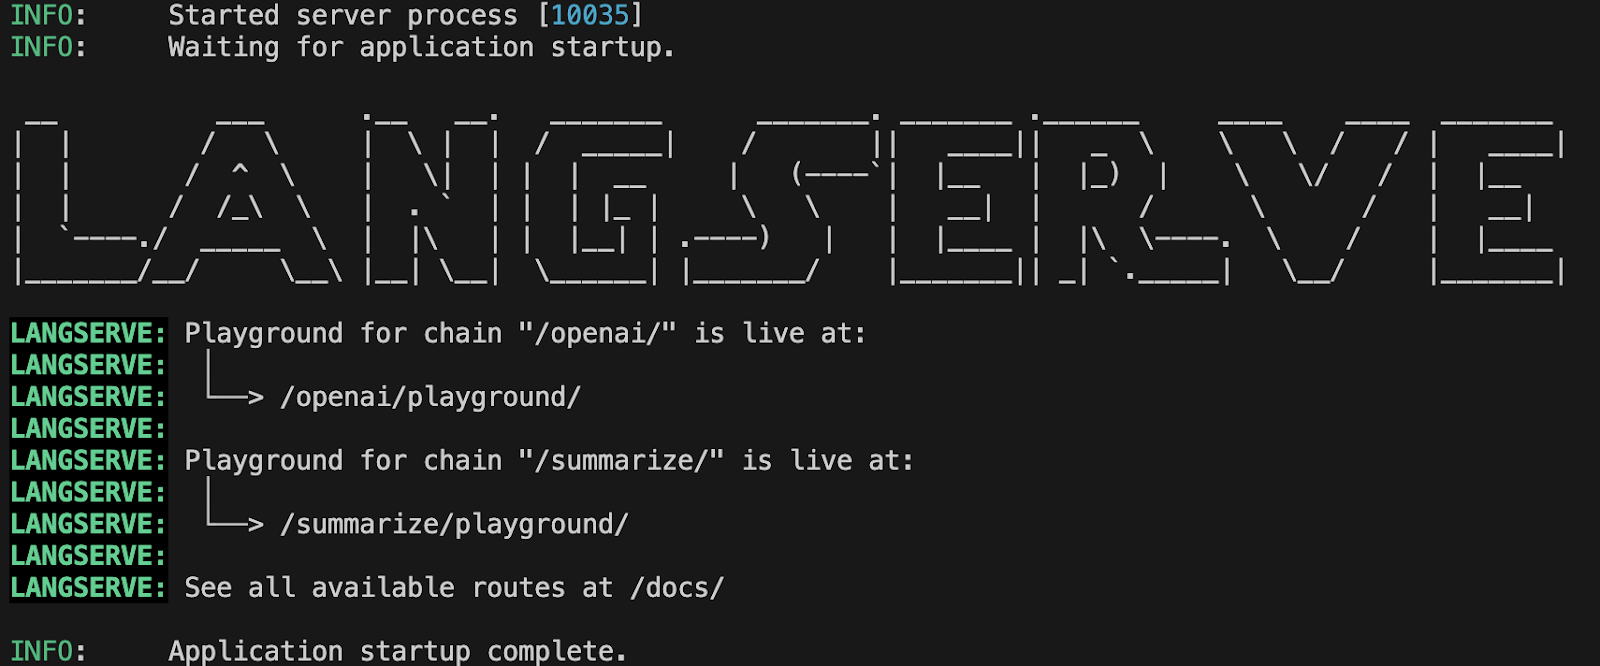 Keluaran terminal yang menunjukkan startup aplikasi LangServe berhasil.
Sekarang Anda dapat membuka http://127.0.0.1:8100/summarize/playground/ di peramban Anda. URL ini menyediakan antarmuka ramah pengguna untuk menguji aplikasi Anda. T
he playground memungkinkan Anda mengeksekusi runnable, melihat keluaran streaming, dan mengamati langkah-langkah perantara, memudahkan interaksi dan debugging aplikasi LLM yang dideploy.
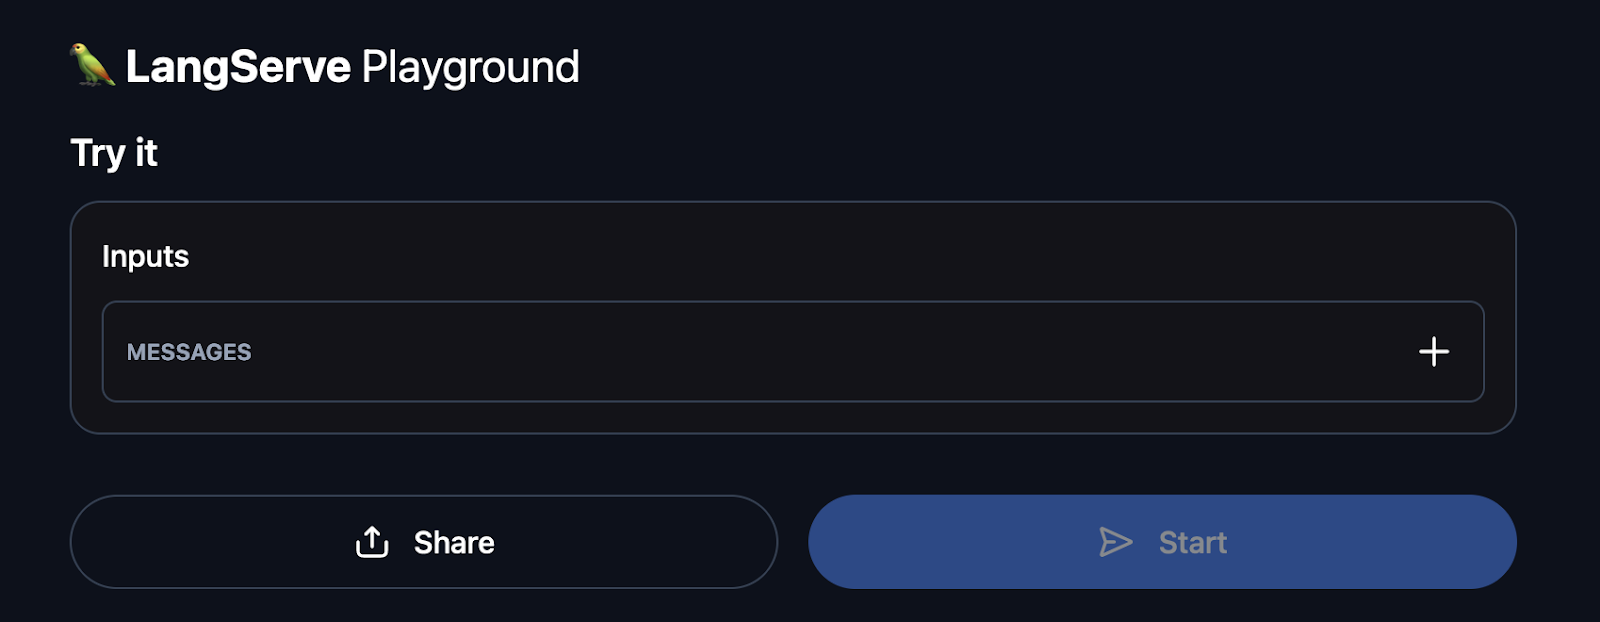
Contoh UI playground LangServe
Selain itu, Anda dapat mengunjungi http://127.0.0.1:8100/docs untuk mengakses dokumentasi API yang dihasilkan secara otomatis oleh FastAPI.
Dokumentasi interaktif ini memungkinkan Anda menelusuri dan menguji semua endpoint yang tersedia pada aplikasi LangServe Anda. Anda dapat melihat informasi detail tentang setiap endpoint, termasuk masukan yang diperlukan dan keluaran yang diharapkan, yang membantu memahami cara berinteraksi dengan API Anda serta memverifikasi bahwa semua rute berfungsi dengan benar.
Memastikan keandalan, kinerja, dan akurasi aplikasi Large Language Model (LLM) di produksi sangatlah penting. Meskipun LangServe tidak memiliki fitur pemantauan bawaan, alat ini terintegrasi mulus dengan alat yang umum digunakan untuk melacak dan menganalisis kesehatan aplikasi.
Bagian ini menawarkan walkthrough teknis tentang cara menggunakan LangServe bersama alat-alat tersebut untuk memelihara dan mengawasi aplikasi LLM.
Logging adalah langkah pertama dalam memantau aplikasi LLM Anda. Ini membantu melacak perilaku aplikasi dan mengidentifikasi anomali. Berikut cara menyiapkan logging di aplikasi FastAPI dengan LangServe:
import logging

# Configure logging
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("langchain_server")

app = FastAPI()

# Example of logging within a route
@app.get("/status")
async def status():
	logger.info("Status endpoint was called")
	return {"status": "Running"}
Dengan penyiapan ini, setiap pemanggilan endpoint /status akan mencatat pesan yang menunjukkan endpoint diakses. Ini dapat diperluas untuk mencatat peristiwa penting dan kesalahan lainnya.
Prometheus adalah alat populer untuk pemantauan dan peringatan. Alat ini dapat diintegrasikan dengan FastAPI untuk mengumpulkan metrik dan memberikan wawasan tentang kinerja aplikasi. Berikut cara menyiapkan Prometheus dengan LangServe:
install prometheus_clientimport time
from prometheus_client import start_http_server, Summary
from fastapi.middleware import Middleware
# Start Prometheus server
start_http_server(8001)
# Define a Prometheus metric
REQUEST_TIME = Summary('request_processing_seconds', 'Time spent processing request')
app = FastAPI()
# Middleware for tracking request processing time
@app.middleware("http")
async def add_prometheus_middleware(request: Request, call_next):
start_time = time.time()
response = await call_next(request)
duration = time.time() - start_time
REQUEST_TIME.observe(duration)
return response
Penyiapan ini akan menjalankan server Prometheus pada port 8001 dan melacak waktu yang dibutuhkan untuk memproses setiap permintaan.
Prometheus dapat dikonfigurasi untuk memicu peringatan berdasarkan kondisi tertentu, dan Grafana dapat digunakan untuk memvisualisasikan metrik tersebut. Berikut garis besar singkat untuk menyiapkan peringatan:
Buat berkas bernama alert.rules:
groups:
- name: example
  rules:
  - alert: HighRequestLatency
	expr: request_processing_seconds_bucket{le="0.5"} > 0.5
	for: 5m
	labels:
  	severity: page
	annotations:
  	summary: High request latency
description: "Request latency is above 0.5 seconds for more than 5 minutes."Perbarui konfigurasi Prometheus Anda (prometheus.yml):
rule_files:
  - "alert.rules"
Untuk memasang dan mengonfigurasi Grafana, lihat dokumentasi instalasi dan konfigurasi. Setelah siap, Anda dapat membuat dasbor dan panel untuk memvisualisasikan metrik seperti latensi permintaan, tingkat kesalahan, dan lain-lain.
Health check penting untuk memantau kesehatan aplikasi dan memastikan aplikasi berjalan sebagaimana mestinya. Berikut cara membuat endpoint health check sederhana:
@app.get("/health")
async def health():
	return {"status": "Healthy"}
Endpoint ini dapat dipanggil secara berkala oleh alat pemantauan untuk memastikan aplikasi dalam kondisi sehat.
Menangkap dan memantau error serta pengecualian sangat krusial untuk mengidentifikasi masalah dalam aplikasi. Berikut cara memperluas logging untuk menangkap pengecualian:
from fastapi import Request, HTTPException
from fastapi.responses import JSONResponse

@app.exception_handler(Exception)
async def global_exception_handler(request: Request, exc: Exception):
	logger.error(f"An error occurred: {exc}")
             return JSONResponse(status_code=500, content={"message": "Internal Server Error"})
@app.exception_handler(HTTPException)
async def http_exception_handler(request: Request, exc: HTTPException):
	logger.error(f"HTTP error occurred: {exc.detail}")
	return JSONResponse(status_code=exc.status_code, content={"message": exc.detail})
Dengan penyiapan ini, setiap pengecualian yang tidak tertangani akan dicatat, memberikan wawasan tentang potensi masalah.
Mendeploy large language models (LLM) ke produksi dapat mentransformasi aplikasi Anda, namun prosesnya melibatkan kompleksitas seperti pemilihan model, manajemen sumber daya, dan integrasi. LangServe menyederhanakan tantangan ini, memungkinkan pengembang untuk mendeploy, memantau, dan memelihara aplikasi LLM secara efisien.
Dengan menggunakan LangServe, Anda dapat merampingkan deployment, memastikan kinerja yang andal, dan mencapai integrasi mulus dengan sistem Anda.
Untuk pendalaman tentang membangun dan mendeploy aplikasi LLM, pertimbangkan untuk mengeksplorasi kursus Developing LLM Applications with LangChain di DataCamp. Sumber ini membahas topik penting termasuk pembuatan chatbot, integrasi data eksternal menggunakan LangChain Expression Language (LCEL), dan lainnya.
Terus Belajar tentang LLM
Kursus
Program
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



