Kurs
Entwickeln von LLM-Anwendungen mit LangChain
3 Std.
50.6K
Ein Large Language Model (LLM) in die Produktion zu bringen, kann deine Anwendung nachhaltig verändern: Du erschließt fortgeschrittene Funktionen für natürliches Sprachverständnis und -generierung. Der Weg dorthin ist jedoch voller Hürden, die selbst erfahrene Entwickler ausbremsen können.
In dieser Anleitung zeigen wir dir, wie du LLM-Anwendungen mit LangServe bereitstellst – einem Tool, das diesen komplexen Prozess deutlich vereinfacht. Von der Installation bis zur Integration lernst du die entscheidenden Schritte, um ein LLM erfolgreich einzusetzen und sein volles Potenzial auszuschöpfen.
Eine LLM-basierte Anwendung zu entwickeln, ist weit mehr als nur ein API-Aufruf. Die Integration eines LLMs kann dein Projekt massiv aufwerten, bringt aber eigene Herausforderungen mit sich, die du sorgfältig abwägen solltest. Im Folgenden fassen wir die wichtigsten Stolpersteine zusammen und zeigen, worauf es bei der Bereitstellung ankommt.
Die Wahl des passenden Modells ist die erste Hürde. Sie hängt von Faktoren wie Aufgabe, geforderter Genauigkeit und verfügbaren Rechenressourcen ab. Zusätzlich kann die Anpassung eines vortrainierten Modells an deine Anforderungen komplex sein und Feintuning mit domänenspezifischen Daten erfordern.
LLMs sind rechenintensiv und benötigen erhebliche Ressourcen. Es ist entscheidend, dass deine Infrastruktur den hohen Speicher- und Rechenbedarf stemmen kann. Plane außerdem Skalierung ein, um Wachstum und steigende Nutzung abzufangen.
Niedrige Latenz ist für ein nahtloses Nutzererlebnis entscheidend. LLMs können bei hoher Last träge reagieren. Performance-Tuning umfasst Strategien wie Modellkomprimierung, effiziente Serving-Frameworks und gegebenenfalls das Auslagern bestimmter Verarbeitungsschritte an Edge-Geräte.
Nach dem Rollout brauchst du kontinuierliches Monitoring. Dazu gehören Performance-Kennzahlen, Anomalieerkennung und das Management von Modelldrift. Regelmäßige Wartung stellt sicher, dass das Modell über die Zeit präzise und effizient bleibt – inklusive Updates und Retraining mit aktuellen Daten.
Die Einbindung von LLMs in bestehende Systeme und Workflows ist anspruchsvoll. Kompatibilität mit Softwareumgebungen, APIs und Datenformaten erfordert sorgfältige Planung und Umsetzung. Eine reibungslose Integration ist der Schlüssel, um das volle Potenzial von LLMs in deiner Anwendung zu nutzen.
Der hohe Rechenbedarf von LLMs kann zu beträchtlichen Betriebskosten führen. Performance und Kosteneffizienz in Balance zu halten, ist zentral. Hebel dafür sind optimierte Ressourcenzuteilung, kosteneffiziente Cloud-Services und regelmäßige Nutzungsanalysen, um Sparpotenziale zu heben.
Ein LLM produktiv zu betreiben, bedeutet, mehrere Systeme und Komponenten nahtlos zu orchestrieren. Es geht über die reine Integration eines leistungsfähigen Sprachmodells hinaus und verlangt eine stimmige Infrastruktur, in der jedes Teil eine zentrale Rolle spielt.
Um die Feinheiten der Bereitstellung zu verstehen, lohnt sich der Blick auf die Bausteine und ihr Zusammenspiel. Die folgende Grafik zeigt die Architektur einer modernen LLM-Anwendung und hebt die wichtigsten Elemente sowie ihre Beziehungen im System hervor.
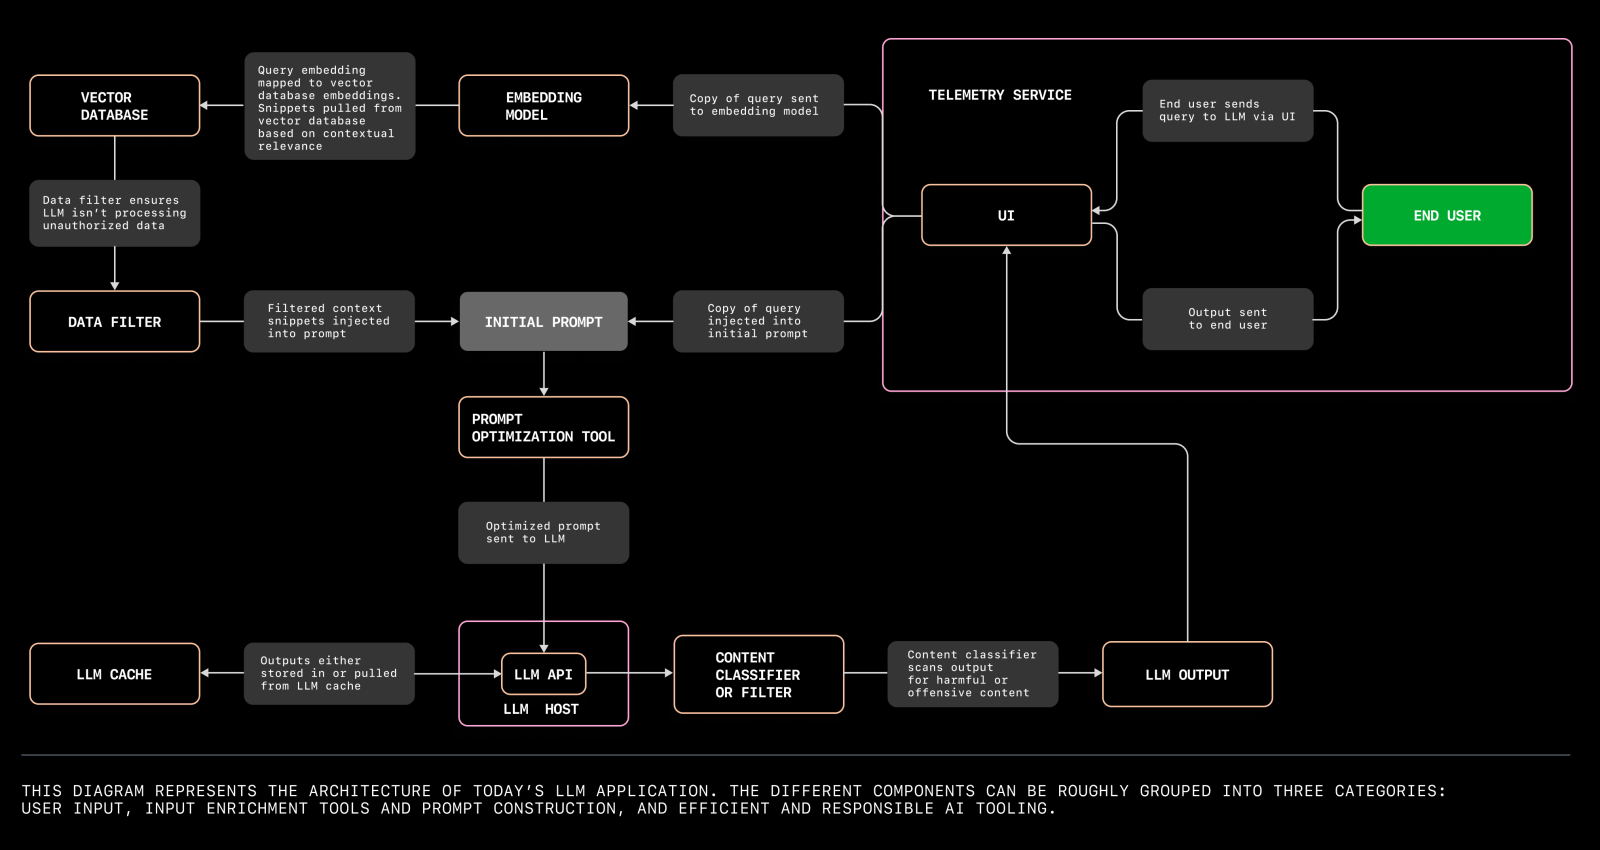
Eine Grafik, die die Architektur einer modernen LLM-Anwendung veranschaulicht. Quelle
Die Architektur einer LLM-Anwendung lässt sich in mehrere Kernelemente gliedern:
Vektordatenbanken sind essenziell, um die hochdimensionalen Daten von LLMs zu verwalten. Sie speichern und holen Vektoren effizient ab und ermöglichen schnelle, präzise Ähnlichkeitssuchen. Unverzichtbar für semantische Suche, Empfehlungssysteme und personalisierte Nutzererlebnisse.
Für die Produktion ist die Wahl einer robusten, skalierbaren Vektordatenbank entscheidend, um Performance und Reaktionsfähigkeit zu sichern.
Prompt-Vorlagen sind vordefinierte Strukturen, die Interaktionen mit dem LLM standardisieren. Sie sorgen für Konsistenz und Verlässlichkeit der Modellantworten.
Wirksame Prompts setzen Verständnis für Modellnuancen und die Anforderungen deiner Anwendung voraus. Gut formulierte Vorlagen steigern Qualität und Relevanz der Ausgaben – und damit die Zufriedenheit der Nutzer.
Die Bereitstellung umfasst das Zusammenspiel von Aufgaben wie Datenvorverarbeitung, Inferenz und Nachbearbeitung. Workflow-Tools und Orchestrierungs-Frameworks wie Apache Airflow oder Kubernetes automatisieren und verschlanken diese Prozesse. Sie stellen sicher, dass alle Komponenten stabil und effizient laufen – mit geringem Fehlerrisiko und minimalen Ausfällen.
Die Infrastruktur deiner LLM-Anwendung muss robust und skalierbar sein. Dazu gehören Cloud-Services, Hardwarebeschleuniger (wie GPUs oder TPUs) und Netzwerkleistung. Skalierbarkeit stellt sicher, dass steigende Last und Nutzungsanforderungen ohne Performanceeinbruch bewältigt werden.
Auto-Scaling-Richtlinien und Load-Balancing-Strategien helfen, Ressourcen effizient zu nutzen und die Servicequalität zu halten.
Kontinuierliches Monitoring und Logging sind entscheidend für Stabilität und Performance. Monitoring-Tools liefern Echtzeit-Einblicke in Systemleistung, Nutzungsmuster und mögliche Probleme.
Logging erfasst detaillierte Betriebsinformationen – unverzichtbar für Debugging und Optimierung. Zusammen sorgen sie dafür, dass deine Anwendung rundläuft und zügig auf Änderungen oder Auffälligkeiten reagieren kann.
Bei LLMs musst du Sicherheits- und Compliance-Anforderungen adressieren. Dazu zählen der Schutz sensibler Daten, Zugriffskontrollen und die Einhaltung relevanter Vorgaben wie DSGVO oder HIPAA. Sicherheitsmechanismen gehören in jede Schicht der Bereitstellung, um Datenlecks und unbefugten Zugriff zu verhindern.
Deine LLM-Anwendung sollte nahtlos mit bestehenden Systemen und Workflows zusammenspielen. Dazu gehört die Kompatibilität mit Tools, APIs und Datenformaten in deiner Organisation.
Gute Integration erhöht Funktionsumfang und Effizienz – und nutzt vorhandene Ressourcen und Infrastruktur optimal aus.
Es gibt mehrere Wege, LLMs in Produktion zu bringen – mit jeweils eigenen Stärken und Herausforderungen.
On-Premises-Bereitstellung bedeutet Hosting auf eigenen Servern oder im Rechenzentrum. Das bietet maximale Kontrolle über Daten und Infrastruktur, erfordert aber erhebliche Investitionen in Hardware und Wartung.
Cloud-basierte Bereitstellung nutzt Cloud-Services für Hosting, liefert Skalierbarkeit, Flexibilität und geringe Einstiegskosten, wirft jedoch Fragen zu Datenschutz und laufenden Betriebskosten auf.
Hybride Bereitstellung kombiniert On-Premises und Cloud-Ressourcen. Sie balanciert Kontrolle und Skalierung und erlaubt, Performance und Kosten bedarfsgerecht zu optimieren.
Die Vor- und Nachteile zu verstehen, ist entscheidend, um eine fundierte Entscheidung zu treffen, die zu Zielen und Ressourcen deiner Organisation passt.
Für die produktive Bereitstellung großer Sprachmodelle brauchst du einen Werkzeugkasten, der alle Phasen abdeckt – von Infrastruktur über Monitoring bis Optimierung. In diesem Abschnitt stellen wir fünf verbreitete Tools vor, die sich dafür bewährt haben.
Wir betrachten jeweils Skalierbarkeit, Bedienkomfort, Integrationsfähigkeit und Kosteneffizienz.
LangServe ist speziell auf die Bereitstellung von LLM-Anwendungen ausgelegt. Es vereinfacht den Prozess mit leistungsfähigen Tools für Installation, Integration und Optimierung. LangServe unterstützt verschiedene LLMs und lässt sich nahtlos in bestehende Systeme einbinden.
Kubernetes ist eine Open-Source-Plattform zur Container-Orchestrierung, die Bereitstellung, Skalierung und Betrieb containerisierter Anwendungen automatisiert. Sie ist äußerst flexibel und kann die Infrastruktur für LLM-Deployments managen.
TensorFlow Serving ist ein flexibles, leistungsstarkes Serving-System für ML-Modelle in Produktionsumgebungen. Neue Algorithmen und Experimente lassen sich bereitstellen, ohne die Serverarchitektur oder APIs zu ändern.
Amazon SageMaker ist ein vollständig verwalteter Service, mit dem Entwicklerinnen und Entwickler sowie Data Scientists ML-Modelle schnell erstellen, trainieren und bereitstellen können. Enge Integration mit anderen AWS-Services macht es zu einem umfassenden Tool für LLM-Deployments.
MLflow ist eine Open-Source-Plattform für den ML-Lebenszyklus inklusive Experimentieren, Reproduzierbarkeit und Bereitstellung. Sie bietet ein zentrales Modell-Repository und lässt sich mit vielen ML-Bibliotheken integrieren.
|
Tool |
Skalierbarkeit |
Bedienkomfort |
Integrationsfähigkeit |
Kosteneffizienz |
|
LangServe |
Hoch |
Hoch |
Exzellent |
Mittel |
|
Kubernetes |
Hoch |
Mittel |
Exzellent |
Hoch (Open Source) |
|
TensorFlow Serving |
Hoch |
Mittel |
Exzellent |
Hoch (Open Source) |
|
Amazon SageMaker |
Hoch |
Hoch |
Exzellent (mit AWS) |
Mittel bis hoch |
|
MLflow |
Mittel bis hoch |
Mittel |
Exzellent |
Hoch (Open Source) |
LangServe ist ein spezialisiertes Tool, das die Bereitstellung von LLM-Anwendungen vereinfacht. In diesem Abschnitt zeigen wir dir Schritt für Schritt, wie du mit LangServe eine ChatGPT-Anwendung zum Zusammenfassen von Text aufsetzt.
Zunächst installieren wir LangServe. Du kannst Client- und Server-Komponenten gemeinsam oder jeweils einzeln installieren – je nach Bedarf.
pip install "langserve[all]"Alternativ installierst du die Komponenten separat:
install "langserve[client]"install "langserve[server]"Die LangChain-CLI hilft dir, ein LangServe-Projekt schnell zu bootstrappen. Stelle sicher, dass eine aktuelle Version installiert ist:
install -U langchain-cliNutze die LangChain-CLI, um eine neue Anwendung anzulegen, und wechsle in das Arbeitsverzeichnis my-app:
app new my-appmy-appLangServe verwendet Poetry für das Abhängigkeitsmanagement. Wenn du Poetry noch nicht kennst, schau in die Poetry-Dokumentation.
Füge die relevanten Pakete so hinzu:
add langchain-openai langchain langchain communityDamit stellst du sicher, dass alle erforderlichen Abhängigkeiten für unser Projekt verfügbar sind.
Lege die nötigen Umgebungsvariablen für unsere Anwendung an. In diesem Fall benötigen wir den OpenAI-API-Schlüssel, um gültige Anfragen zu senden:
OPENAI_API_KEY="sk-..."Ersetze „sk-..." durch deinen tatsächlichen API-Schlüssel. Einen Schlüssel kannst du über die OpenAI-Plattform erstellen.
Wechsle zur Datei ```server.py```. Hier liegt die Hauptlogik unserer LangServe-Anwendung. Das folgende Beispiel zeigt eine einfache App mit einer Route zum Zusammenfassen von Text mithilfe des Sprachmodells von OpenAI:
fastapi import FastAPI
from langchain.prompts import ChatPromptTemplate
from langchain.chat_models import ChatOpenAI
from langserve import add_routes
app = FastAPI(
	title="LangChain Server",
	version="1.0",
	description="A simple API server using Langchain's Runnable interfaces",
)
# Define a route for the OpenAI chat model
add_routes(
	app,
	ChatOpenAI(),
	path="/openai",
)
# Define a route with a custom prompt
summarize_prompt = ChatPromptTemplate.from_template("Summarize the following text: {text}")
add_routes(
	app,
	summarize_prompt | ChatOpenAI(),
	path="/summarize",
)
if __name__ == "__main__":
	import uvicorn
	uvicorn.run(app, host="localhost", port=8000)
Schauen wir uns die zentralen Bausteine dieser Basis-App genauer an:
FastAPI erzeugt den Webserver.ChatPromptTemplate und ChatOpenAI aus LangChain definieren Prompts und Modelle.add_routes aus LangServe fügt der FastAPI-App Routen hinzu.FastAPI-App wird mit Metadaten wie Titel, Version und Beschreibung initialisiert.add_routes fügt die Route /openai hinzu, die direkt mit dem Chatmodell von OpenAI interagiert./summarize. Diese nimmt Eingabetext entgegen und erzeugt mithilfe eines Prompts eine Zusammenfassung über das OpenAI-Modell.Mit der Funktion uvicorn.run startest du den FastAPI-Server auf localhost am Port 8000.
Im Beispiel haben wir die Route /summarize hinzugefügt, die Text zusammenfasst. Du kannst die Funktionalität deiner LangServe-App erweitern, indem du weitere Routen und Prompts definierst. Zum Beispiel:
joke_prompt = ChatPromptTemplate.from_template("Tell me a joke about {topic}")
add_routes(
            app,
            joke_prompt | ChatOpenAI(),
            path="/joke",
)
Zum Schluss nutzt du Poetry, um die Anwendung auf dem gewünschten Port zu starten:
run langchain serve --port=8100Wenn alles korrekt eingerichtet ist, solltest du in deinem Terminal eine ähnliche Ausgabe sehen:
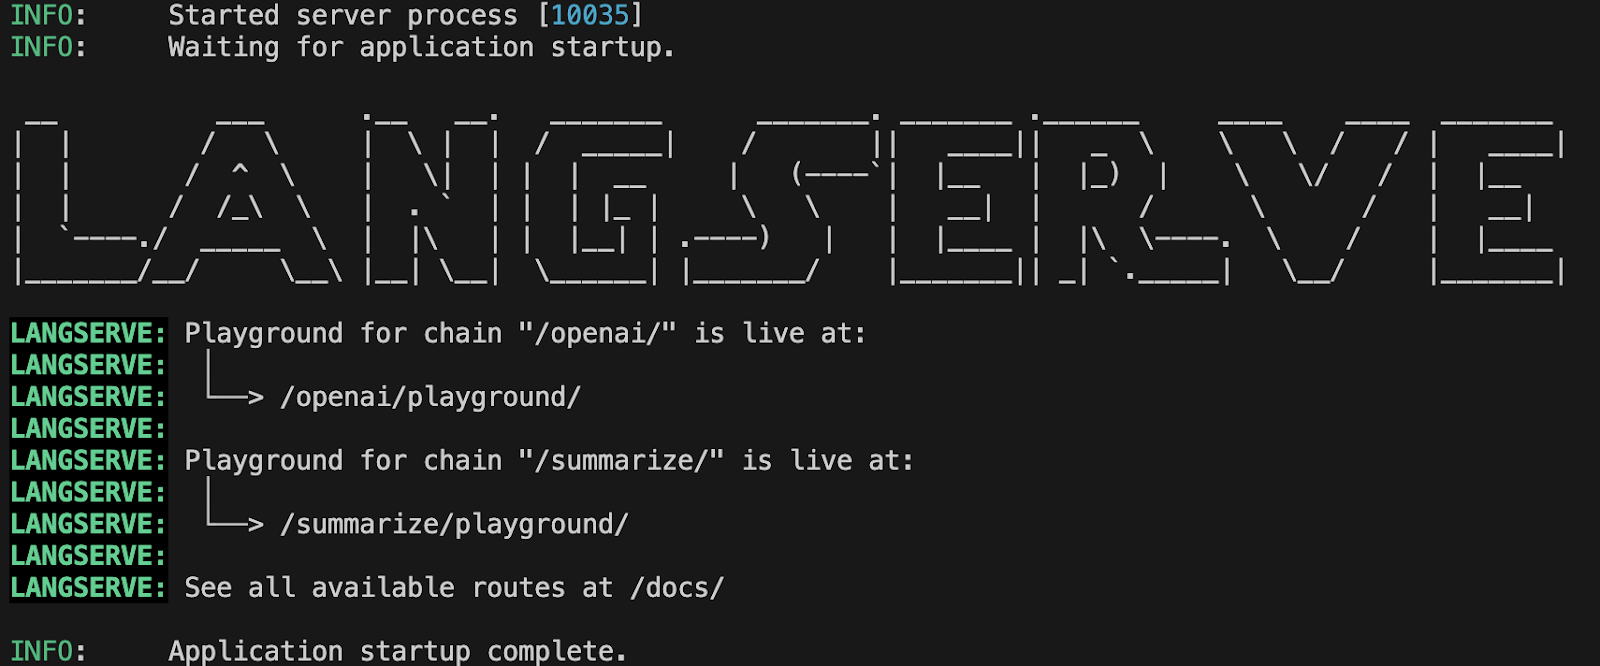 Terminalausgabe, die den erfolgreichen Start der LangServe-Anwendung zeigt.
Du kannst jetzt im Browser zu http://127.0.0.1:8100/summarize/playground/ navigieren. Diese URL führt dich zu einer benutzerfreundlichen Oberfläche, in der du deine Anwendung testen kannst. D
er Playground ermöglicht es dir, dein Runnable auszuführen, Streaming-Ausgaben zu sehen und Zwischenschritte zu beobachten – ideal für Interaktion und Debugging deiner bereitgestellten LLM-Anwendung.
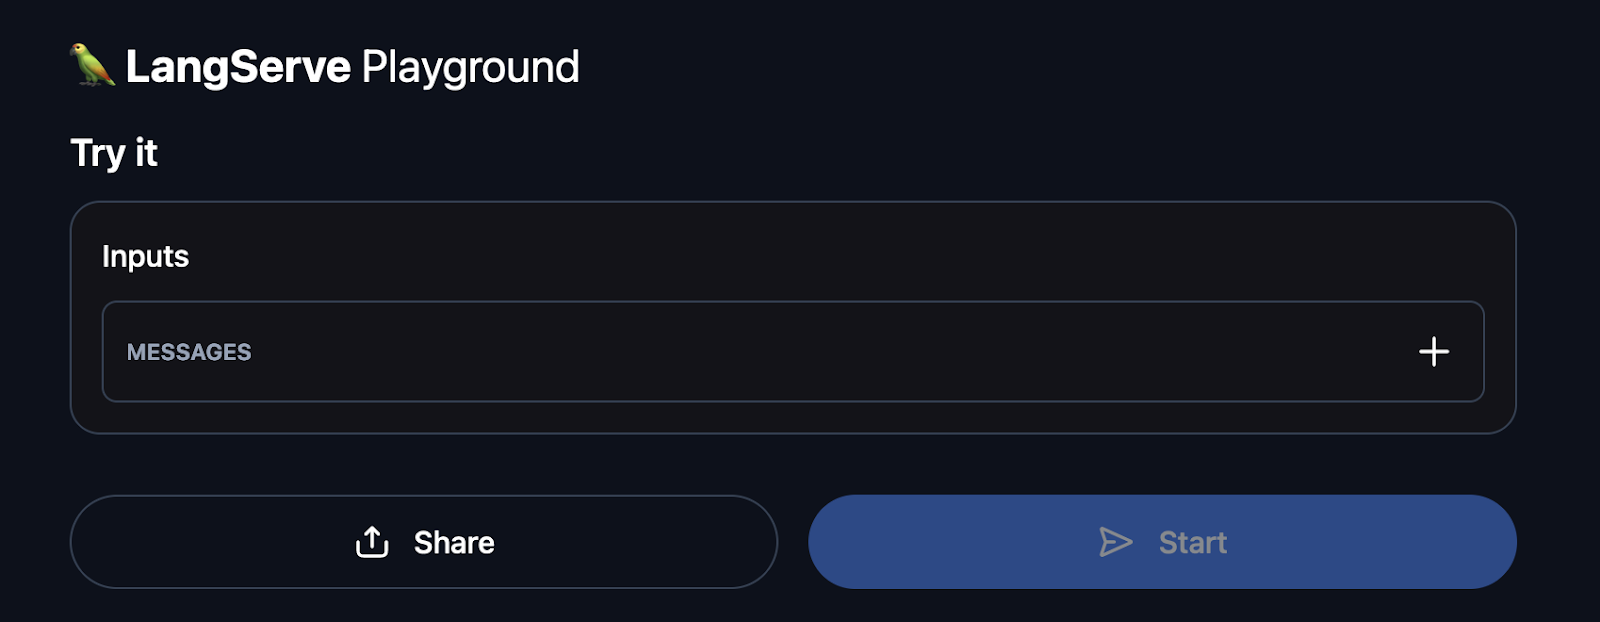
Beispiel der LangServe-Playground-Oberfläche
Zusätzlich findest du unter http://127.0.0.1:8100/docs die automatisch generierte API-Dokumentation von FastAPI.
Diese interaktive Doku zeigt alle verfügbaren Endpunkte deiner LangServe-Anwendung. Du siehst Details zu Eingaben und erwarteten Ausgaben und kannst so besser verstehen, wie du mit der API interagierst und ob alle Routen korrekt funktionieren.
Zuverlässigkeit, Performance und Genauigkeit einer LLM-Anwendung in Produktion sind zentral. Zwar bringt LangServe kein eigenes Monitoring mit, es integriert sich jedoch nahtlos mit gängigen Tools zur Überwachung und Analyse der Anwendungsgesundheit.
In diesem Abschnitt zeigen wir technisch, wie du LangServe zusammen mit diesen Tools nutzt, um eine LLM-Anwendung zu betreiben und zu überwachen.
Logging ist der erste Schritt im Monitoring. Es hilft, das Verhalten der Anwendung nachzuvollziehen und Auffälligkeiten zu erkennen. So richtest du Logging in deiner FastAPI-App mit LangServe ein:
import logging

# Configure logging
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("langchain_server")

app = FastAPI()

# Example of logging within a route
@app.get("/status")
async def status():
	logger.info("Status endpoint was called")
	return {"status": "Running"}
Mit diesem Setup protokolliert jeder Aufruf des Endpunkts /status eine Meldung. Du kannst das erweitern, um weitere Ereignisse und Fehler zu loggen.
Prometheus ist ein populäres Tool für Monitoring und Alerting. Es lässt sich mit FastAPI integrieren, um Metriken zu sammeln und Einblicke in die Performance zu geben. So setzt du Prometheus mit LangServe auf:
install prometheus_clientimport time
from prometheus_client import start_http_server, Summary
from fastapi.middleware import Middleware
# Start Prometheus server
start_http_server(8001)
# Define a Prometheus metric
REQUEST_TIME = Summary('request_processing_seconds', 'Time spent processing request')
app = FastAPI()
# Middleware for tracking request processing time
@app.middleware("http")
async def add_prometheus_middleware(request: Request, call_next):
start_time = time.time()
response = await call_next(request)
duration = time.time() - start_time
REQUEST_TIME.observe(duration)
return response
Dieses Setup startet einen Prometheus-Server auf Port 8001 und misst die Bearbeitungszeit jeder Anfrage.
Prometheus kann bei bestimmten Bedingungen Alarme auslösen, und Grafana visualisiert die Metriken. Ein kurzer Überblick zur Einrichtung:
Erstelle eine Datei alert.rules:
groups:
- name: example
  rules:
  - alert: HighRequestLatency
	expr: request_processing_seconds_bucket{le="0.5"} > 0.5
	for: 5m
	labels:
  	severity: page
	annotations:
  	summary: High request latency
description: "Request latency is above 0.5 seconds for more than 5 minutes."Aktualisiere die Prometheus-Konfiguration (prometheus.yml):
rule_files:
  - "alert.rules"
Zur Installation und Konfiguration von Grafana siehe die Installations- und Konfigurations-Doku. Danach kannst du Dashboards und Panels erstellen, um Metriken wie Latenzen oder Fehlerraten zu visualisieren.
Health-Checks sind wichtig, um den Zustand der Anwendung zu prüfen. So erstellst du einen einfachen Health-Check-Endpunkt:
@app.get("/health")
async def health():
	return {"status": "Healthy"}
Dieser Endpunkt kann regelmäßig von Monitoring-Tools aufgerufen werden, um die Gesundheit der Anwendung sicherzustellen.
Das Erfassen und Überwachen von Fehlern ist entscheidend, um Probleme frühzeitig zu erkennen. So erweiterst du das Logging für Ausnahmen:
from fastapi import Request, HTTPException
from fastapi.responses import JSONResponse

@app.exception_handler(Exception)
async def global_exception_handler(request: Request, exc: Exception):
	logger.error(f"An error occurred: {exc}")
             return JSONResponse(status_code=500, content={"message": "Internal Server Error"})
@app.exception_handler(HTTPException)
async def http_exception_handler(request: Request, exc: HTTPException):
	logger.error(f"HTTP error occurred: {exc.detail}")
	return JSONResponse(status_code=exc.status_code, content={"message": exc.detail})
Damit werden unbehandelte Ausnahmen protokolliert – eine wertvolle Grundlage zur Fehlersuche.
LLMs in Produktion können deine Anwendungen auf ein neues Niveau heben. Der Weg dorthin erfordert jedoch kluge Entscheidungen bei Modellauswahl, Ressourcensteuerung und Integration. LangServe nimmt dir vieles davon ab und hilft, LLM-Anwendungen effizient bereitzustellen, zu überwachen und zu warten.
Mit LangServe beschleunigst du das Deployment, sicherst robuste Performance und integrierst dich reibungslos in bestehende Systeme.
Wenn du tiefer in Entwicklung und Bereitstellung von LLM-Anwendungen einsteigen möchtest, wirf einen Blick auf den DataCamp-Kurs Developing LLM Applications with LangChain. Dort lernst du unter anderem Chatbots zu bauen, externe Daten per LangChain Expression Language (LCEL) einzubinden und mehr.
Bleib bei LLMs am Ball
Kurs
Lernpfad
Lernpfad