Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
51.9K
Een large language model (LLM) in productie brengen kan je applicatie transformeren, met geavanceerde mogelijkheden voor natuurlijke taalverwerking en -generatie. Maar het proces zit vol uitdagingen die zelfs doorgewinterde developers kunnen hinderen.
In deze gids bekijken we hoe je LLM-applicaties uitrolt met LangServe, een tool die dit complexe proces vereenvoudigt en stroomlijnt. Van installatie tot integratie: je leert de essentiële stappen om een LLM succesvol te implementeren en het volledige potentieel te benutten.
Een LLM-gebaseerde applicatie bouwen is meer dan alleen een API aanroepen. Hoewel een LLM integreren je project aanzienlijk kan verbeteren, brengt het unieke uitdagingen met zich mee die om zorgvuldige afweging vragen. Hieronder zetten we de belangrijkste obstakels op een rij en lichten we de aspecten van deployment toe die aandacht vereisen.
Het kiezen van het juiste model voor je applicatie is de eerste horde. De keuze hangt af van verschillende factoren, zoals de specifieke taak, vereiste nauwkeurigheid en beschikbare rekenbronnen. Daarnaast kan het maatwerk van een voorgetraind model voor jouw toepassing complex zijn en fine-tuning met domeinspecifieke data vereisen.
LLM’s zijn rekenintensief en vragen aanzienlijke resources. Het is cruciaal dat je infrastructuur de hoge geheugen- en rekenvereisten aankan. Dit omvat ook plannen voor schaalbaarheid om toekomstige groei en mogelijk hoger gebruik op te vangen.
Lage latentie is essentieel voor een soepele gebruikerservaring. LLM’s kunnen traag verzoeken verwerken, zeker bij zware belasting. Performance optimaliseren kan met strategieën zoals modelcompressie, efficiënte serving-frameworks en eventueel het offloaden van taken naar edge-devices.
Na uitrol is continue monitoring van de LLM-applicatie nodig. Denk aan het volgen van performancemetrics, het detecteren van afwijkingen en het beheersen van model drift. Regelmatig onderhoud houdt het model op termijn accuraat en efficiënt, met periodieke updates en retraining op nieuwe data.
LLM’s integreren met bestaande systemen en workflows kan lastig zijn. Compatibiliteit met diverse softwareomgevingen, API’s en dataformaten vereist nauwkeurige planning en uitvoering. Naadloze integratie is de sleutel om het volledige potentieel van LLM’s in je applicatie te benutten.
De hoge rekeneisen van LLM’s kunnen leiden tot aanzienlijke operationele kosten. Prestaties balanceren met kostenefficiëntie is een cruciale afweging. Kosten verlagen kan met optimalisatie van resourceallocatie, gebruik van kosteneffectieve clouddiensten en het regelmatig analyseren van gebruikspatronen om besparingen te vinden.
Een LLM in productie brengen is een complex proces waarbij meerdere systemen en componenten samenkomen. Het gaat verder dan een krachtig taalmodel integreren; je hebt een samenhangende infrastructuur nodig waarin elk onderdeel een cruciale rol speelt.
Om de complexiteit van LLM-deployments te begrijpen, is het essentieel de betrokken componenten en hun interacties te verkennen. Het volgende diagram toont de architectuur van een moderne LLM-applicatie en benadrukt de kernonderdelen en hun relaties binnen het systeem.
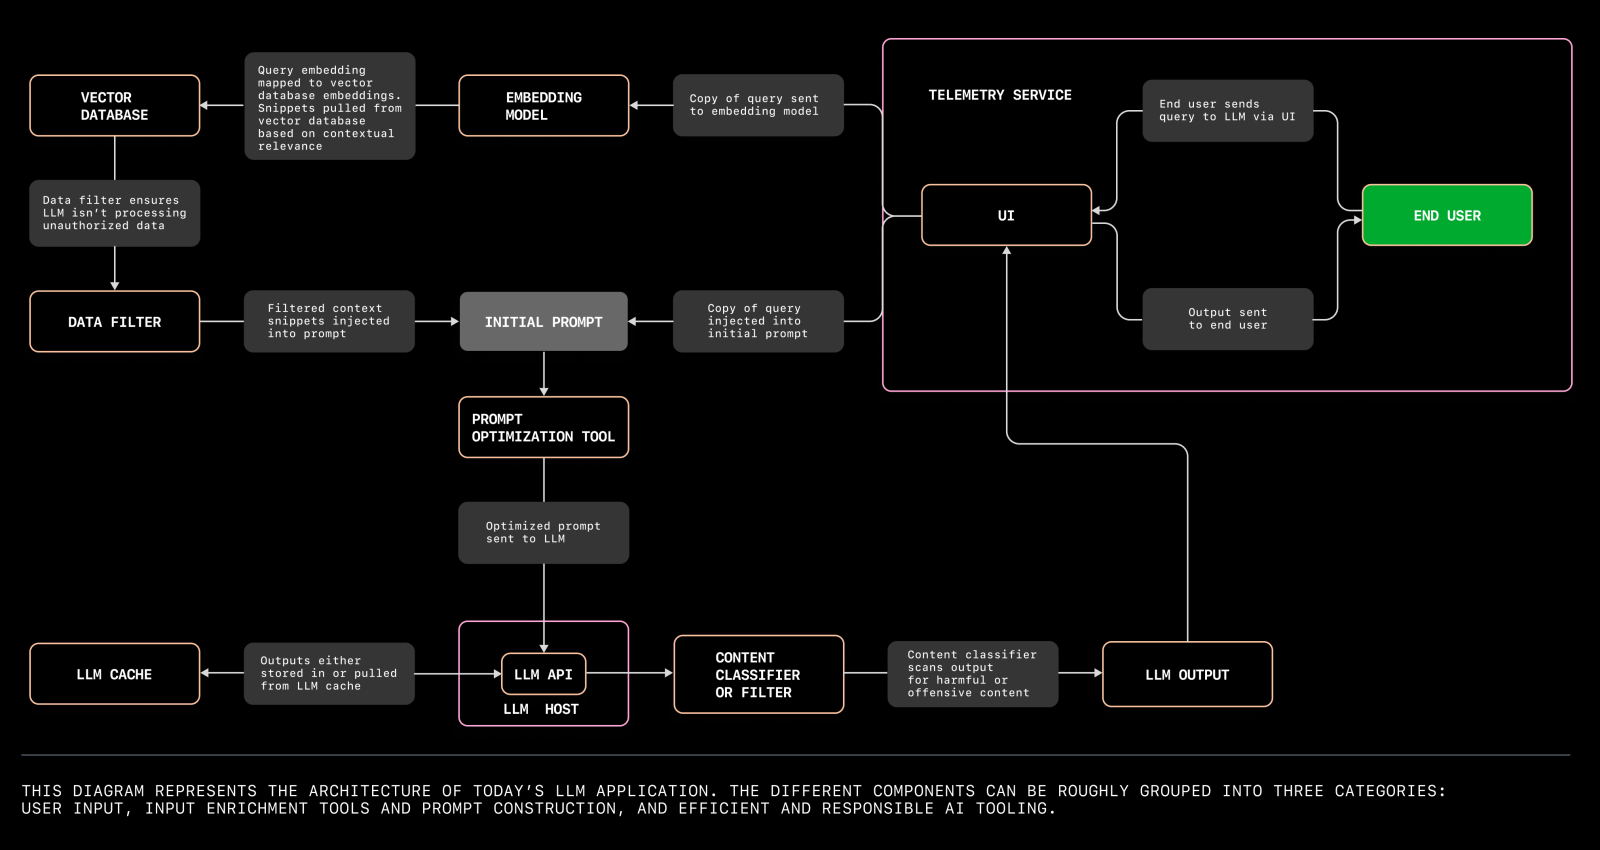
Een diagram dat de architectuur van een moderne LLM-applicatie illustreert. Bron
De architectuur van een LLM-applicatie is op te delen in verschillende kernaspecten:
Vector-databases zijn essentieel voor het beheren van de hoog-dimensionale data die LLM’s genereren. Ze slaan vectoren efficiënt op en halen ze snel op, wat snelle en nauwkeurige similariteitszoektochten mogelijk maakt. Ze zijn onmisbaar voor toepassingen als semantische zoekopdrachten, aanbevelingssystemen en gepersonaliseerde gebruikerservaringen.
Bij het uitrollen van LLM’s is het kiezen van een robuuste, schaalbare vector-database cruciaal om performance en responsiviteit te behouden.
Prompt-templates zijn vooraf gedefinieerde structuren die interacties met de LLM standaardiseren. Ze zorgen voor consistentie en betrouwbaarheid in de reacties die het model genereert.
Effectieve prompt-templates ontwerpen vraagt inzicht in de nuances van het model en de specifieke eisen van je applicatie. Goed doordachte templates kunnen de kwaliteit en relevantie van de output sterk verbeteren, wat leidt tot hogere gebruikerstevredenheid.
Een LLM-applicatie uitrollen betekent het coördineren van taken zoals data-preprocessing, modelinference en post-processing. Workflowmanagementtools en orchestratie-frameworks zoals Apache Airflow of Kubernetes helpen deze processen te automatiseren en te stroomlijnen. Zo werkt elk onderdeel soepel en efficiënt, met minder kans op fouten en downtime.
De infrastructuur achter je LLM-applicatie moet robuust en schaalbaar zijn. Denk aan clouddiensten, hardwareversnellers (zoals GPU’s of TPU’s) en netwerkcapaciteit. Schaalbaarheid zorgt ervoor dat je applicatie toenemende belasting en gebruikersvraag aankan zonder in te leveren op performance.
Met autoscaling-beleid en loadbalancing-strategieën beheer je resources effectief en houd je de servicekwaliteit op peil.
Continue monitoring en logging zijn cruciaal om de gezondheid en prestaties van je LLM-applicatie te bewaken. Monitoringtools geven realtime inzicht in systeemprestaties, gebruikspatronen en mogelijke problemen.
Logging legt gedetailleerde informatie vast over de werking van de applicatie en is van onschatbare waarde voor debuggen en optimalisatie. Samen zorgen ze ervoor dat je applicatie soepel draait en snel kan reageren op veranderingen of anomalieën.
LLM’s uitrollen betekent ook rekening houden met beveiliging en compliance. Dat omvat het beschermen van gevoelige data, toegangsbeheer en naleving van relevante regelgeving zoals GDPR of HIPAA. Beveiligingsmaatregelen moeten in elke laag van het deploymentproces zijn geïntegreerd om datalekken en ongeautoriseerde toegang te voorkomen.
Je LLM-applicatie moet naadloos integreren met bestaande systemen en workflows. Dat vraagt compatibiliteit met andere tools, API’s en dataformaten binnen je organisatie.
Effectieve integratie verbetert de algehele functionaliteit en efficiëntie van je applicatie, zodat je optimaal gebruikmaakt van bestaande resources en infrastructuur.
Er zijn meerdere manieren om LLM’s in productie te brengen, elk met eigen voor- en nadelen.
On-premises deployment betekent het hosten van de LLM op lokale servers of datacenters, wat meer controle geeft over data en infrastructuur, maar aanzienlijke investeringen in hardware en onderhoud vergt.
Cloud-deployment maakt gebruik van clouddiensten om de LLM te hosten en biedt schaalbaarheid, flexibiliteit en lagere initiële kosten, maar kan zorgen oproepen rond dataprivacy en doorlopende operationele kosten.
Hybride deployment combineert on-premises en cloudresources en biedt een balans tussen controle en schaalbaarheid, zodat organisaties prestaties en kosten kunnen optimaliseren op basis van hun specifieke behoeften.
De voor- en nadelen van elke aanpak begrijpen is essentieel om een weloverwogen keuze te maken die past bij de doelen en middelen van je organisatie.
LLM’s in productie brengen vereist een set tools die verschillende aspecten van het deploymentproces aankunnen, van infrastructuurbeheer tot monitoring en optimalisatie. In dit onderdeel bespreken we vijf veelgebruikte tools voor het uitrollen van LLM’s naar productie.
Elke tool beoordelen we op schaalbaarheid, gebruiksgemak, integratiemogelijkheden en kosteneffectiviteit.
LangServe is specifiek ontworpen voor het uitrollen van LLM-applicaties. Het vereenvoudigt het proces met robuuste tools voor installatie, integratie en optimalisatie. LangServe ondersteunt diverse LLM’s en integreert naadloos met bestaande systemen.
Kubernetes is een open-source platform voor containerorchestratie dat deployment, schaling en beheer van gecontaineriseerde applicaties automatiseert. Het is zeer flexibel en kan de infrastructuur beheren die nodig is voor LLM-deployments.
TensorFlow Serving is een flexibel, high-performance servingsysteem voor machinelearningmodellen, ontworpen voor productieomgevingen. Het maakt het eenvoudig om nieuwe algoritmes en experimenten uit te rollen met behoud van dezelfde serverarchitectuur en API’s.
Amazon SageMaker is een volledig beheerde service waarmee elke developer en data scientist snel machinelearningmodellen kan bouwen, trainen en uitrollen. Het integreert met andere AWS-diensten en is daardoor een complete tool voor LLM-deployment.
MLflow is een open-source platform voor het beheren van de ML-levenscyclus, inclusief experimentatie, reproduceerbaarheid en deployment. Het biedt een centrale repository voor modellen en kan met veel ML-bibliotheken integreren.
|
Tool |
Schaalbaarheid |
Gebruiksgemak |
Integratiemogelijkheden |
Kosteneffectiviteit |
|
LangServe |
Hoog |
Hoog |
Uitstekend |
Gemiddeld |
|
Kubernetes |
Hoog |
Gemiddeld |
Uitstekend |
Hoog (Open Source) |
|
TensorFlow Serving |
Hoog |
Gemiddeld |
Uitstekend |
Hoog (Open Source) |
|
Amazon SageMaker |
Hoog |
Hoog |
Uitstekend (met AWS) |
Gemiddeld tot hoog |
|
MLflow |
Gemiddeld tot hoog |
Gemiddeld |
Uitstekend |
Hoog (Open Source) |
LangServe is een gespecialiseerde tool die het uitrollen van LLM-applicaties vereenvoudigt. In dit onderdeel geven we een technische walkthrough om met LangServe een chatGPT-applicatie te deployen die tekst samenvat.
We beginnen met het installeren van LangServe. Je kunt zowel de client- als servercomponenten installeren, of slechts één ervan, afhankelijk van je behoeften.
pip install "langserve[all]"Je kunt de componenten ook afzonderlijk installeren:
install "langserve[client]"install "langserve[server]"De LangChain CLI is handig om snel een LangServe-project te bootstrappen. Zorg dat je een recente versie hebt geïnstalleerd:
install -U langchain-cliGebruik de LangChain CLI om een nieuwe applicatie te maken en wijzig je huidige werkmap naar my-app:
app new my-appmy-appLangServe gebruikt Poetry voor dependencybeheer. Als je niet bekend bent met Poetry, raadpleeg dan de Poetry-documentatie voor meer informatie.
Voeg de relevante packages toe met:
add langchain-openai langchain langchain communityMet dit commando zorg je dat alle vereiste dependencies beschikbaar zijn voor ons project.
Zorg dat je de benodigde omgevingsvariabelen voor onze applicatie instelt. In dit geval moeten we onze OpenAI API-sleutel instellen om geldige requests te kunnen doen:
OPENAI_API_KEY="sk-..."Vervang “sk-...” door je echte API-sleutel. Je kunt een API-sleutel aanmaken via het OpenAI-platform.
Navigeer naar het bestand ```server.py```. Dit bevat de hoofdlogica voor onze LangServe-applicatie. Hieronder zie je een voorbeeld van een eenvoudige LangServe-applicatie met een route om tekst samen te vatten met het taalmodel van OpenAI:
fastapi import FastAPI
from langchain.prompts import ChatPromptTemplate
from langchain.chat_models import ChatOpenAI
from langserve import add_routes
app = FastAPI(
	title="LangChain Server",
	version="1.0",
	description="A simple API server using Langchain's Runnable interfaces",
)
# Define a route for the OpenAI chat model
add_routes(
	app,
	ChatOpenAI(),
	path="/openai",
)
# Define a route with a custom prompt
summarize_prompt = ChatPromptTemplate.from_template("Summarize the following text: {text}")
add_routes(
	app,
	summarize_prompt | ChatOpenAI(),
	path="/summarize",
)
if __name__ == "__main__":
	import uvicorn
	uvicorn.run(app, host="localhost", port=8000)
Laten we de belangrijkste onderdelen van onze basis LangServe-applicatie nader bekijken:
FastAPI wordt gebruikt om de webserver te maken.ChatPromptTemplate en ChatOpenAI komen uit LangChain om prompts en modellen te definiëren.add_routes uit LangServe wordt gebruikt om routes aan de FastAPI-app toe te voegen.FastAPI-app wordt geïnitialiseerd met metadata zoals titel, versie en beschrijving.add_routes voegt een route /openai toe die direct koppelt aan het chatmodel van OpenAI.add_routes definieert een custom prompt-route /summarize. Deze route neemt invoertekst en gebruikt een prompt om met het OpenAI-model een samenvatting te genereren.De functie uvicorn.run wordt gebruikt om de FastAPI-server te starten op localhost poort 8000.
In dit voorbeeld hebben we een route /summarize toegevoegd die met een prompt tekst samenvat. Je kunt de functionaliteit van je LangServe-applicatie uitbreiden door extra routes en prompts te definiëren. Bijvoorbeeld:
joke_prompt = ChatPromptTemplate.from_template("Tell me a joke about {topic}")
add_routes(
            app,
            joke_prompt | ChatOpenAI(),
            path="/joke",
)
Gebruik tot slot Poetry om je applicatie op de gewenste poort te serven:
run langchain serve --port=8100Als alles goed is ingesteld, zie je iets als dit in je terminal:
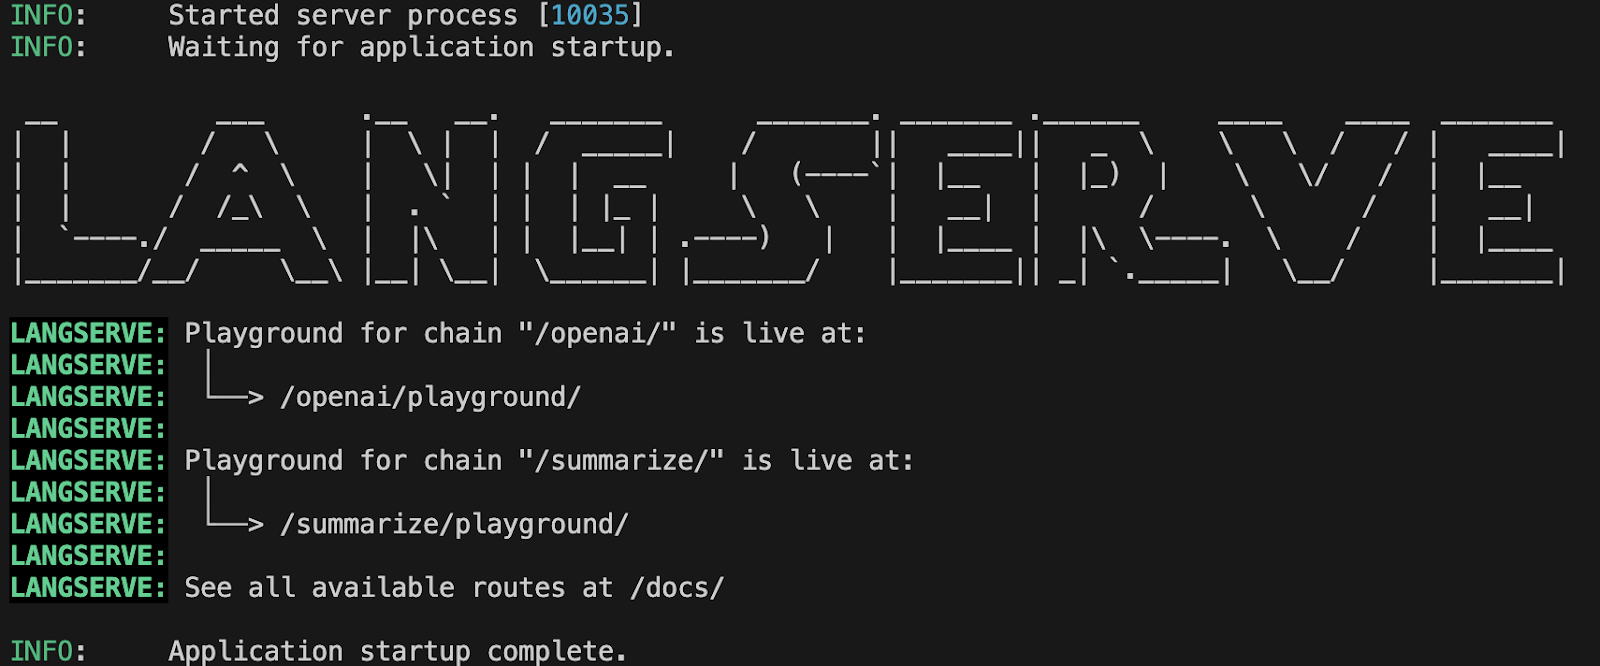 Terminaluitvoer die het succesvol opstarten van de LangServe-applicatie toont.
Je kunt nu naar http://127.0.0.1:8100/summarize/playground/ in je browser gaan. Deze URL biedt een gebruiksvriendelijke interface om je applicatie te testen. T
he playground laat je je runnable uitvoeren, streamingoutput bekijken en tussenstappen volgen, wat interactie en debuggen van je uitgerolde LLM-applicatie vergemakkelijkt.
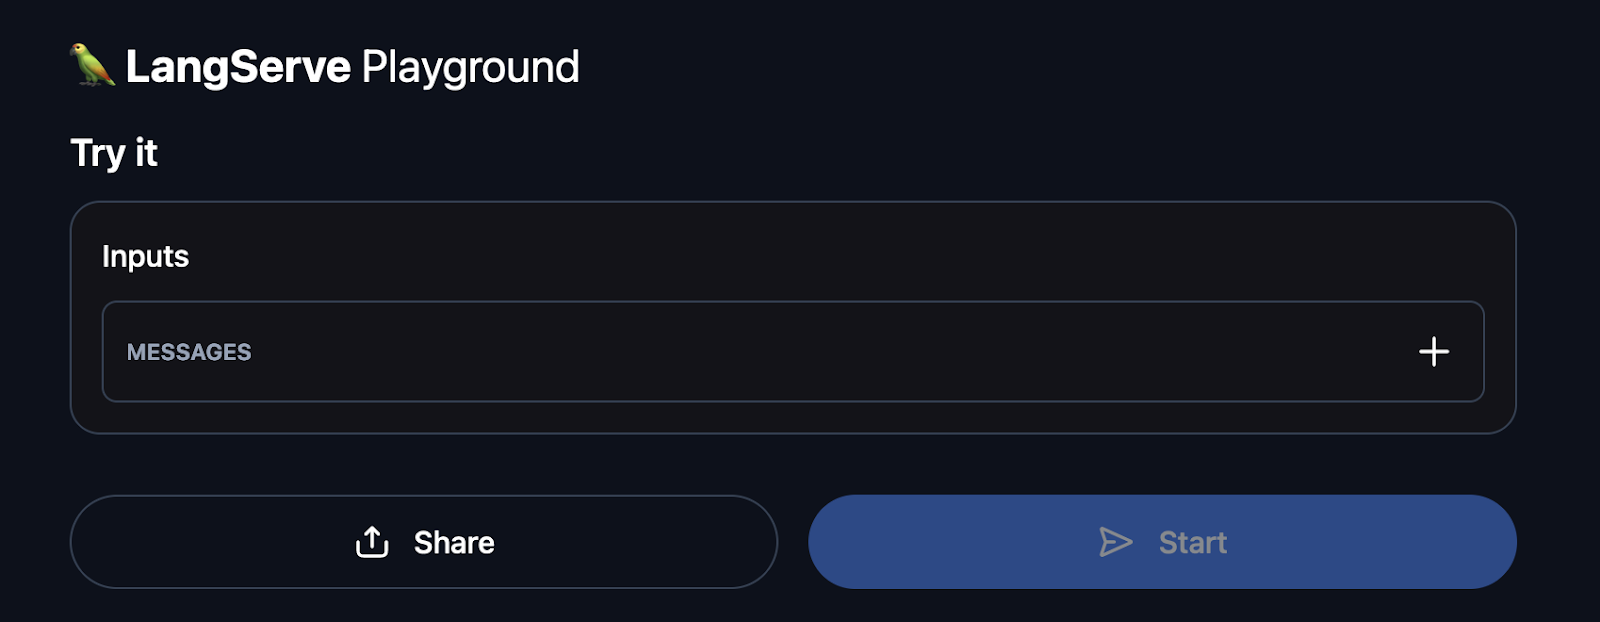
Voorbeeld van de LangServe playground-UI
Daarnaast kun je http://127.0.0.1:8100/docs bezoeken voor de automatisch gegenereerde API-documentatie van FastAPI.
Met deze interactieve documentatie kun je alle beschikbare endpoints van je LangServe-app verkennen en testen. Je ziet gedetailleerde informatie per endpoint, inclusief vereiste input en verwachte output, wat helpt om je API-interactie te begrijpen en te verifiëren dat alle routes correct werken.
Het is cruciaal om de betrouwbaarheid, performance en nauwkeurigheid van een LLM-applicatie in productie te borgen. Hoewel LangServe geen ingebouwde monitoring biedt, integreert het naadloos met veelgebruikte tools voor het volgen en analyseren van de gezondheid van je applicatie.
Dit onderdeel geeft een technische walkthrough van hoe je LangServe samen met deze tools gebruikt om een LLM-applicatie te beheren en te bewaken.
Logging is de eerste stap bij het monitoren van je LLM-applicatie. Het helpt het gedrag te volgen en afwijkingen te detecteren. Zo stel je logging in je FastAPI-app met LangServe in:
import logging

# Configure logging
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("langchain_server")

app = FastAPI()

# Example of logging within a route
@app.get("/status")
async def status():
	logger.info("Status endpoint was called")
	return {"status": "Running"}
Met deze setup logt elke call naar het /status -endpoint een bericht dat de endpoint is aangeroepen. Dit kun je uitbreiden om ook andere belangrijke events en fouten te loggen.
Prometheus is een populaire tool voor monitoring en alerting. Je kunt het met FastAPI integreren om metrics te verzamelen en inzicht te krijgen in de prestaties van je applicatie. Zo stel je Prometheus in met LangServe:
install prometheus_clientimport time
from prometheus_client import start_http_server, Summary
from fastapi.middleware import Middleware
# Start Prometheus server
start_http_server(8001)
# Define a Prometheus metric
REQUEST_TIME = Summary('request_processing_seconds', 'Time spent processing request')
app = FastAPI()
# Middleware for tracking request processing time
@app.middleware("http")
async def add_prometheus_middleware(request: Request, call_next):
start_time = time.time()
response = await call_next(request)
duration = time.time() - start_time
REQUEST_TIME.observe(duration)
return response
Deze setup start een Prometheus-server op poort 8001 en houdt de verwerkingstijd per request bij.
Prometheus kan alerts triggeren op basis van bepaalde condities, en Grafana kan deze metrics visualiseren. Hier is een korte schets voor het instellen van alerts:
Maak een bestand alert.rules aan:
groups:
- name: example
  rules:
  - alert: HighRequestLatency
	expr: request_processing_seconds_bucket{le="0.5"} > 0.5
	for: 5m
	labels:
  	severity: page
	annotations:
  	summary: High request latency
description: "Request latency is above 0.5 seconds for more than 5 minutes."Werk je Prometheus-configuratie (prometheus.yml) bij:
rule_files:
  - "alert.rules"
Raadpleeg voor installatie en configuratie van Grafana de installatie- en configuratie-documentatie. Zodra dit is ingesteld, kun je dashboards en panels maken om metrics zoals requestlatentie en foutpercentages te visualiseren.
Health checks zijn essentieel om de gezondheid van de applicatie te bewaken en te verzekeren dat alles draait zoals verwacht. Zo maak je een eenvoudige health-check-endpoint:
@app.get("/health")
async def health():
	return {"status": "Healthy"}
Monitoringtools kunnen deze endpoint periodiek aanroepen om te verifiëren dat de applicatie gezond is.
Fouten en exceptions vastleggen en monitoren is cruciaal om issues in de applicatie te identificeren. Zo breid je logging uit om exceptions te vangen:
from fastapi import Request, HTTPException
from fastapi.responses import JSONResponse

@app.exception_handler(Exception)
async def global_exception_handler(request: Request, exc: Exception):
	logger.error(f"An error occurred: {exc}")
             return JSONResponse(status_code=500, content={"message": "Internal Server Error"})
@app.exception_handler(HTTPException)
async def http_exception_handler(request: Request, exc: HTTPException):
	logger.error(f"HTTP error occurred: {exc.detail}")
	return JSONResponse(status_code=exc.status_code, content={"message": exc.detail})
Met deze setup wordt elke niet-afgehandelde exception gelogd, wat inzicht geeft in mogelijke problemen.
LLM’s in productie kunnen je applicaties transformeren, maar het proces vraagt om het navigeren van complexiteit zoals modelkeuze, resourcebeheer en integratie. LangServe vereenvoudigt deze uitdagingen en stelt developers in staat LLM-applicaties efficiënt uit te rollen, te monitoren en te onderhouden.
Met LangServe stroomlijn je deployment, borg je robuuste prestaties en realiseer je naadloze integratie met je systemen.
Wil je dieper duiken in het bouwen en uitrollen van LLM-applicaties? Bekijk dan de cursus Developing LLM Applications with LangChain op DataCamp. Deze bron behandelt essentiële onderwerpen zoals het bouwen van chatbots, externe data integreren met de LangChain Expression Language (LCEL), en meer.
Blijf leren over LLM’s
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

