Cours
Développement d'applications LLM avec LangChain
3 h
50.6K
Mettre en production un large modèle de langage (LLM) peut transformer votre application en lui apportant des capacités avancées de compréhension et de génération en langue naturelle. Mais le parcours est semé d'embûches, même pour des développeurs aguerris.
Dans ce guide, nous allons voir comment déployer des applications LLM avec LangServe, un outil conçu pour simplifier et industrialiser ce processus complexe. De l'installation à l'intégration, vous apprendrez les étapes essentielles pour mettre en œuvre un LLM avec succès et en exploiter tout le potentiel.
Concevoir une application s'appuyant sur un LLM, ce n'est pas seulement appeler une API. Si l'intégration d'un LLM peut considérablement enrichir votre produit, elle s'accompagne de contraintes spécifiques à bien anticiper. Ci-dessous, nous détaillons les principaux obstacles à prévoir et les points d'attention côté déploiement.
Choisir le bon modèle pour votre cas d'usage est la première étape critique. La décision dépend de facteurs tels que la tâche visée, la précision requise et les ressources de calcul disponibles. Adapter un modèle préentrainé à vos besoins peut être complexe et nécessiter un affinement sur des données spécifiques au domaine.
Les LLM sont très gourmands en calcul et exigent des ressources substantielles. Il est crucial de vérifier que votre infrastructure supporte les besoins en mémoire et en puissance de traitement, et de prévoir la montée en charge pour accompagner la croissance et les pics d'usage.
Une faible latence est vitale pour une expérience fluide. Les LLM peuvent traiter lentement les requêtes, surtout en forte charge. L'optimisation passe par des stratégies telles que la compression de modèle, des frameworks de serving efficaces et, le cas échéant, le déport de traitements en périphérie (edge).
Une fois en production, une supervision continue s'impose : suivi des métriques, détection d'anomalies, gestion du dérèglement du modèle (model drift). Une maintenance régulière, incluant mises à jour et réentraînements, garantit la précision et l'efficacité dans le temps.
L'intégration des LLM aux systèmes et processus existants peut s'avérer délicate. Assurer la compatibilité avec divers environnements logiciels, APIs et formats de données exige une planification et une exécution rigoureuses. Une intégration fluide est clé pour tirer pleinement parti des LLM.
Les exigences de calcul élevées des LLM peuvent générer des coûts importants. Trouver le bon équilibre entre performance et efficience économique est essentiel : optimisation de l'allocation des ressources, services cloud coûts maîtrisés, et revue régulière des usages pour identifier des leviers d'économie.
Déployer un LLM en production implique d'orchestrer plusieurs systèmes et composants. Au-delà de l'intégration du modèle, il s'agit de mettre en place une infrastructure cohérente où chaque brique joue un rôle critique.
Pour appréhender la complexité du déploiement, il est utile d'explorer les composants en jeu et leurs interactions. Le schéma suivant illustre l'architecture d'une application LLM moderne et les relations entre ses éléments clés.
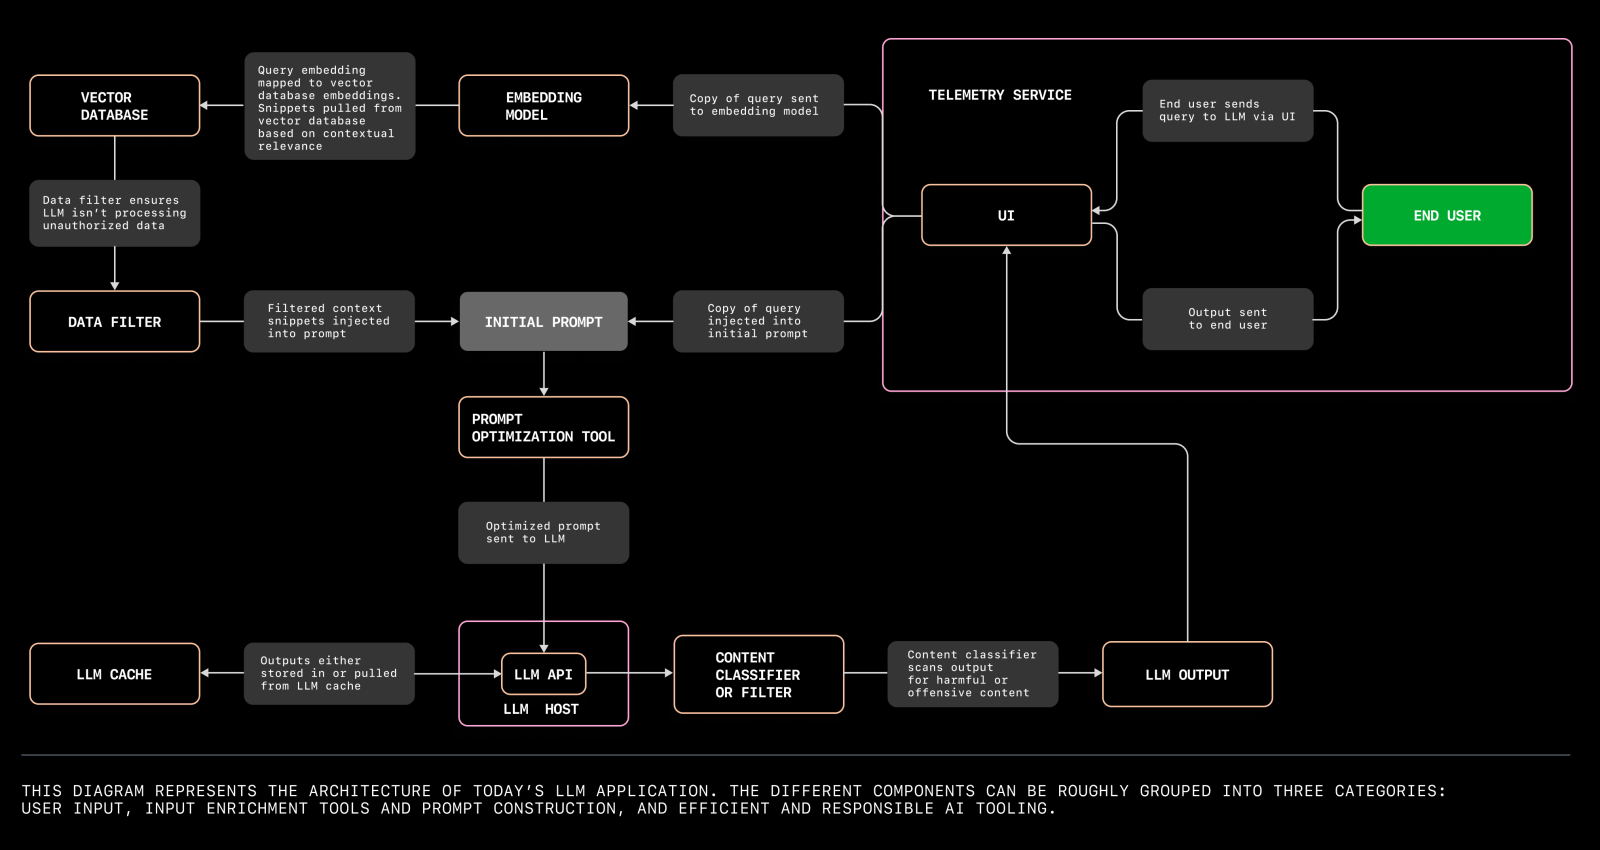
Schéma illustrant l'architecture d'une application LLM moderne. Source
L'architecture d'une application LLM se décline en plusieurs volets :
Les bases de données vectorielles sont essentielles pour gérer les données de grande dimension générées par les LLM. Elles stockent et récupèrent efficacement des vecteurs, pour des recherches par similarité rapides et précises : recherche sémantique, systèmes de recommandation, expériences personnalisées, etc.
Au déploiement, choisissez une base vectorielle robuste et scalable pour garantir performance et réactivité.
Les modèles d'invite sont des structures prédéfinies qui standardisent les interactions avec le LLM. Ils assurent cohérence et fiabilité des réponses générées.
Concevoir des invites efficaces suppose de bien saisir les spécificités du modèle et les besoins de votre application. De bons prompts améliorent sensiblement la qualité et la pertinence des sorties, au bénéfice de la satisfaction utilisateur.
Déployer une application LLM consiste à coordonner prétraitements, inférence et post-traitements. Des outils de gestion de flux et d'orchestration (Apache Airflow, Kubernetes) automatisent et fluidifient ces étapes, réduisant les risques d'erreurs et d'indisponibilité.
L'infrastructure doit être robuste et évolutive : services cloud, accélérateurs matériels (GPU ou TPU), réseau. La scalabilité garantit la tenue des charges et des demandes sans dégrader les performances.
Des politiques d'auto-scalage et le load balancing aident à optimiser l'usage des ressources et maintenir la qualité de service.
La supervision et la journalisation continues sont cruciales pour piloter la santé et la performance de l'application. Les outils de monitoring offrent une visibilité en temps réel sur les performances, les usages et les incidents potentiels.
La journalisation capture des détails précieux pour le débogage et l'optimisation. Ensemble, elles assurent une exploitation fluide et réactive face aux aléas.
Déployer des LLM suppose aussi de répondre aux exigences de sécurité et de conformité : protection des données sensibles, contrôles d'accès, respect des réglementations (RGPD, HIPAA, etc.). Les mesures de sécurité doivent être intégrées à chaque couche du déploiement.
Votre application LLM doit s'intégrer sans friction aux outils, APIs et formats de données en place.
Une intégration réussie renforce la valeur et l'efficacité de l'application en capitalisant sur l'existant.
Plusieurs stratégies de déploiement coexistent, chacune avec ses atouts et contraintes.
On-premise : héberger le LLM sur vos serveurs ou datacenters offre un contrôle accru sur les données et l'infra, au prix d'investissements matériels et de maintenance significatifs.
Cloud : s'appuyer sur des services cloud apporte flexibilité, élasticité et des coûts initiaux réduits, avec toutefois des questions de confidentialité et de coûts d'exploitation récurrents.
Hybride : combiner on-premise et cloud équilibre contrôle et scalabilité, pour adapter performance et coûts à vos besoins.
Connaître les avantages et limites de chaque approche vous aidera à aligner votre choix sur vos objectifs et ressources.
Déployer des LLM en production nécessite une boîte à outils couvrant l'infrastructure, le monitoring et l'optimisation. Voici cinq solutions largement adoptées.
Chaque outil est évalué selon la scalabilité, la facilité d'usage, les capacités d'intégration et le rapport coût-efficacité.
LangServe est spécifiquement conçu pour déployer des applications LLM. Il simplifie le déploiement via des outils robustes d'installation, d'intégration et d'optimisation, avec un support multi-LLM et une intégration fluide aux systèmes existants.
Kubernetes est une plateforme open source d'orchestration de conteneurs qui automatise déploiement, mise à l'échelle et gestion des applications conteneurisées. Très flexible, elle peut piloter l'infrastructure nécessaire aux déploiements de LLM.
TensorFlow Serving est un système de serving flexible et performant pour modèles de machine learning, conçu pour la production. Il facilite le déploiement de nouveaux algorithmes et expérimentations tout en conservant la même architecture serveur et les mêmes APIs.
Amazon SageMaker est un service entièrement géré qui permet de créer, entraîner et déployer rapidement des modèles de machine learning. Il s'intègre à l'écosystème AWS, en faisant un outil complet pour déployer des LLM.
MLflow est une plateforme open source pour gérer le cycle de vie ML : expérimentation, traçabilité et déploiement. Elle fournit un référentiel centralisé de modèles et s'intègre avec de nombreuses bibliothèques de machine learning.
|
Outil |
Scalabilité |
Facilité d'usage |
Capacités d'intégration |
Rapport coût-efficacité |
|
LangServe |
Élevée |
Élevée |
Excellentes |
Modéré |
|
Kubernetes |
Élevée |
Moyenne |
Excellentes |
Élevé (open source) |
|
TensorFlow Serving |
Élevée |
Moyenne |
Excellentes |
Élevé (open source) |
|
Amazon SageMaker |
Élevée |
Élevée |
Excellentes (avec AWS) |
Modéré à élevé |
|
MLflow |
Moyenne à élevée |
Moyenne |
Excellentes |
Élevé (open source) |
LangServe est un outil spécialisé qui simplifie le déploiement d'applications LLM. Dans cette section, nous proposons pas à pas la mise en ligne d'une application ChatGPT de résumé de texte avec LangServe.
Commencez par installer LangServe. Selon vos besoins, vous pouvez installer le client et le serveur, ou un seul des deux.
pip install "langserve[all]"Vous pouvez aussi installer les composants séparément :
install "langserve[client]"install "langserve[server]"Le CLI LangChain permet de démarrer rapidement un projet LangServe. Assurez-vous de disposer d'une version récente :
install -U langchain-cliUtilisez le CLI LangChain pour créer une application, puis placez-vous dans le répertoire my-app :
app new my-appmy-appLangServe utilise Poetry pour la gestion des dépendances. Si vous ne connaissez pas Poetry, consultez la documentation.
Pour ajouter les packages requis :
add langchain-openai langchain langchain communityCette commande garantit la présence de toutes les dépendances nécessaires au projet.
Paramétrez les variables d'environnement requises. Ici, nous devons renseigner la clé API OpenAI pour effectuer des requêtes valides :
OPENAI_API_KEY="sk-..."Remplacez « sk-... » par votre clé réelle. Vous pouvez créer une clé depuis la plateforme OpenAI.
Ouvrez le fichier ```server.py```. Il contiendra la logique principale de notre application LangServe. Voici un exemple d'application simple comprenant une route de résumé de texte via le modèle de langue d'OpenAI :
fastapi import FastAPI
from langchain.prompts import ChatPromptTemplate
from langchain.chat_models import ChatOpenAI
from langserve import add_routes
app = FastAPI(
	title="LangChain Server",
	version="1.0",
	description="A simple API server using Langchain's Runnable interfaces",
)
# Define a route for the OpenAI chat model
add_routes(
	app,
	ChatOpenAI(),
	path="/openai",
)
# Define a route with a custom prompt
summarize_prompt = ChatPromptTemplate.from_template("Summarize the following text: {text}")
add_routes(
	app,
	summarize_prompt | ChatOpenAI(),
	path="/summarize",
)
if __name__ == "__main__":
	import uvicorn
	uvicorn.run(app, host="localhost", port=8000)
Regardons de plus près les éléments clés de cette application LangServe de base :
FastAPI sert à créer le serveur web.ChatPromptTemplate et ChatOpenAI (LangChain) définissent les prompts et modèles.add_routes (LangServe) ajoute des routes à l'application FastAPI.FastAPI est initialisée avec titre, version et description.add_routes ajoute la route /openai qui dialogue directement avec le modèle de chat d'OpenAI./summarize avec un prompt personnalisé. Elle prend un texte en entrée et génère un résumé via le modèle d'OpenAI.La fonction uvicorn.run lance le serveur FastAPI sur localhost au port 8000.
Dans cet exemple, nous avons ajouté une route /summarize qui résume un texte via un prompt. Vous pouvez étendre votre application LangServe en définissant d'autres routes et prompts, par exemple :
joke_prompt = ChatPromptTemplate.from_template("Tell me a joke about {topic}")
add_routes(
            app,
            joke_prompt | ChatOpenAI(),
            path="/joke",
)
Enfin, utilisez Poetry pour servir votre application sur le port souhaité :
run langchain serve --port=8100Si tout est correctement configuré, votre terminal devrait afficher quelque chose de similaire :
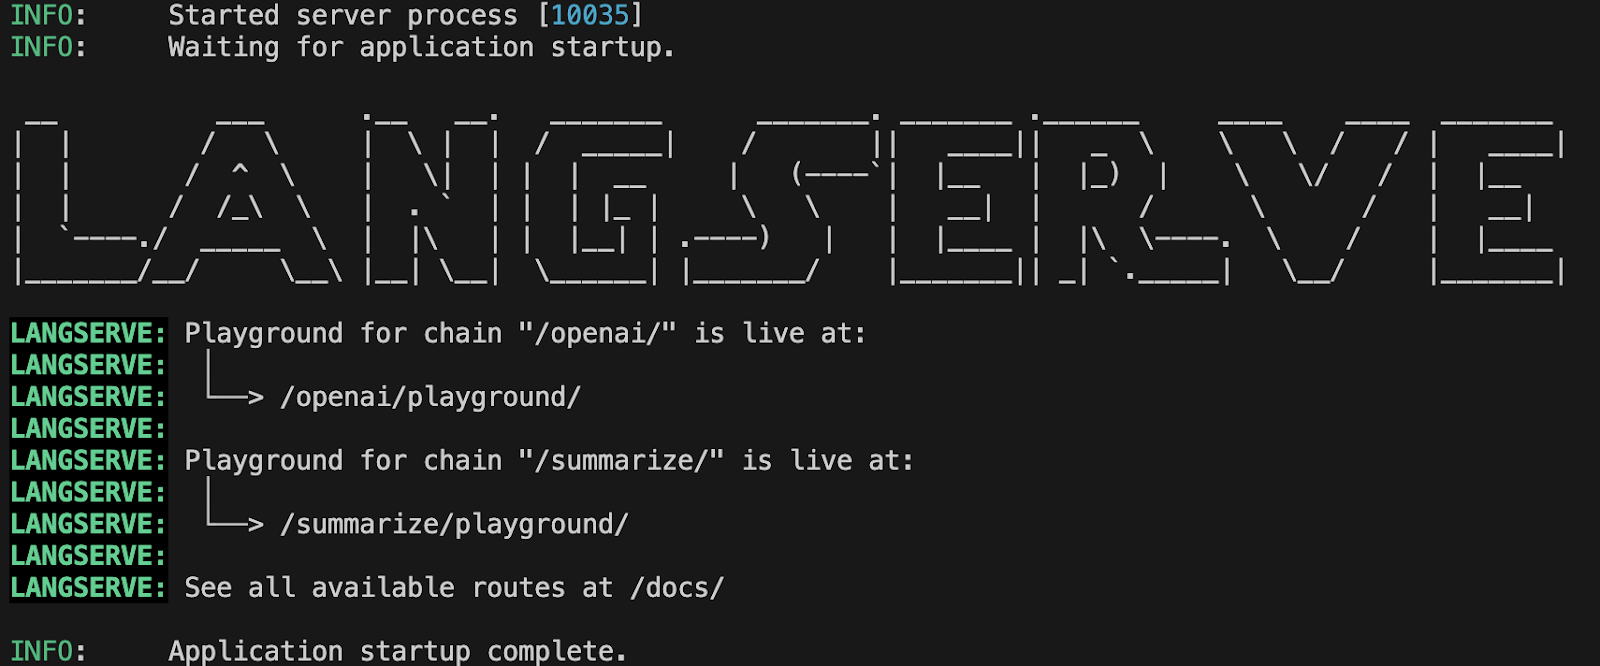 Sortie de terminal indiquant le démarrage réussi de l'application LangServe.
Vous pouvez maintenant accéder à http://127.0.0.1:8100/summarize/playground/ dans votre navigateur. Cette URL propose une interface conviviale pour tester votre application.
Le playground permet d'exécuter votre runnable, d'afficher le flux des résultats et d'observer les étapes intermédiaires, pour interagir facilement avec votre application LLM déployée et la déboguer.
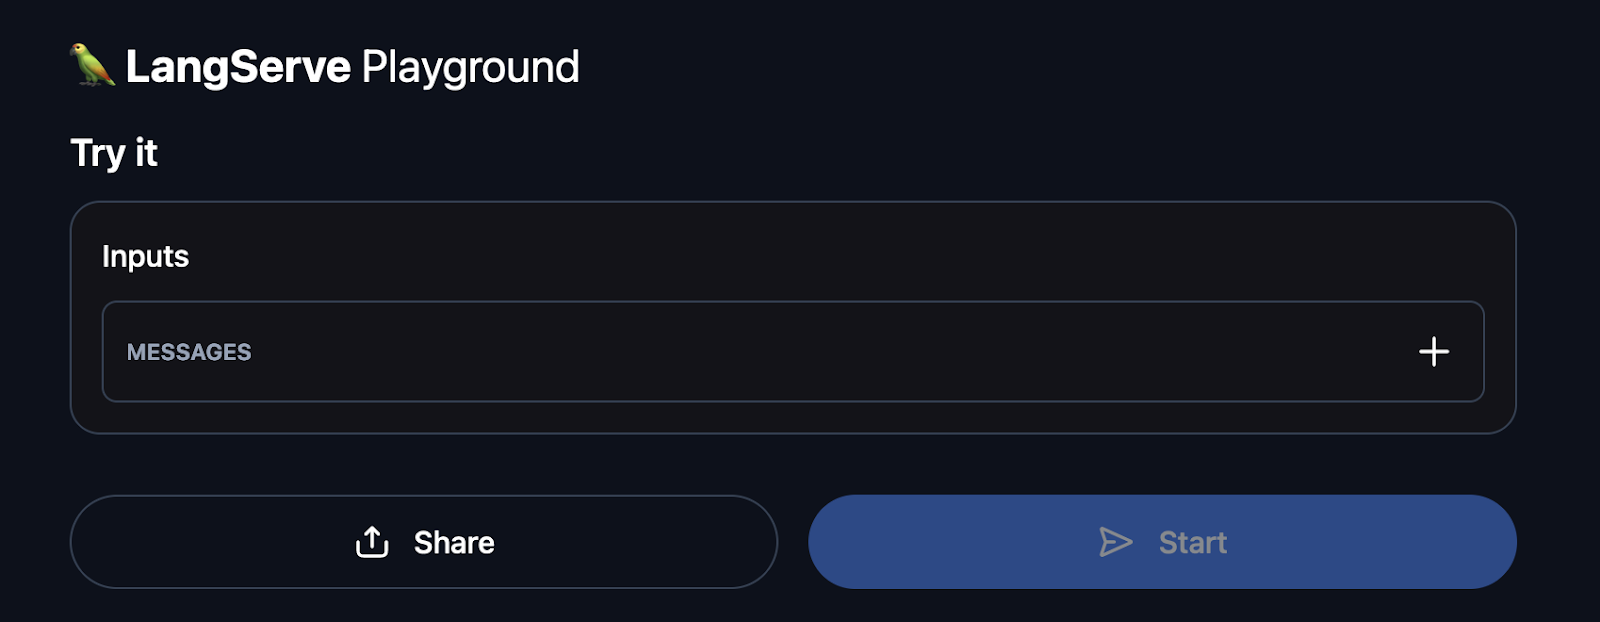
Exemple de l'interface playground de LangServe
Vous pouvez également visiter http://127.0.0.1:8100/docs pour accéder à la documentation API générée automatiquement par FastAPI.
Cette documentation interactive vous permet d'explorer et de tester tous les endpoints disponibles de votre application LangServe. Vous y trouverez les entrées attendues et les sorties prévues, utile pour comprendre l'utilisation de l'API et vérifier le bon fonctionnement des routes.
Assurer la fiabilité, la performance et la précision d'une application LLM en production est crucial. Bien que LangServe ne propose pas de monitoring intégré, il s'interface très bien avec des outils largement adoptés pour suivre et analyser la santé applicative.
Cette section présente, pas à pas, comment utiliser LangServe en combinaison avec ces outils pour maintenir et piloter une application LLM.
La journalisation est la première brique du monitoring. Elle permet de suivre le comportement de l'application et de détecter les anomalies. Voici comment l'activer dans votre application FastAPI avec LangServe :
import logging

# Configure logging
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("langchain_server")

app = FastAPI()

# Example of logging within a route
@app.get("/status")
async def status():
	logger.info("Status endpoint was called")
	return {"status": "Running"}
Avec ce paramétrage, chaque appel à /status écrit un message de log. Étendez ce principe pour tracer les événements importants et les erreurs.
Prometheus est un outil référent pour le monitoring et l'alerte. Il s'intègre à FastAPI pour collecter des métriques et analyser la performance. Voici comment l'utiliser avec LangServe :
install prometheus_clientimport time
from prometheus_client import start_http_server, Summary
from fastapi.middleware import Middleware
# Start Prometheus server
start_http_server(8001)
# Define a Prometheus metric
REQUEST_TIME = Summary('request_processing_seconds', 'Time spent processing request')
app = FastAPI()
# Middleware for tracking request processing time
@app.middleware("http")
async def add_prometheus_middleware(request: Request, call_next):
start_time = time.time()
response = await call_next(request)
duration = time.time() - start_time
REQUEST_TIME.observe(duration)
return response
Cette configuration démarre un serveur Prometheus sur le port 8001 et mesure le temps de traitement de chaque requête.
Prometheus peut déclencher des alertes selon des conditions définies, et Grafana permet de visualiser les métriques. Aperçu de la mise en place :
Créez un fichier alert.rules :
groups:
- name: example
  rules:
  - alert: HighRequestLatency
	expr: request_processing_seconds_bucket{le="0.5"} > 0.5
	for: 5m
	labels:
  	severity: page
	annotations:
  	summary: High request latency
description: "Request latency is above 0.5 seconds for more than 5 minutes."Mettez à jour la configuration (prometheus.yml) :
rule_files:
  - "alert.rules"
Pour l'installation et la configuration, référez-vous à la documentation d'installation et de configuration. Vous pourrez ensuite créer des dashboards pour visualiser la latence, les taux d'erreur, etc.
Les health checks sont indispensables pour vérifier que l'application fonctionne comme prévu. Exemple d'endpoint simple :
@app.get("/health")
async def health():
	return {"status": "Healthy"}
Un outil de supervision peut appeler périodiquement cet endpoint pour s'assurer que tout va bien.
La capture et le suivi des erreurs sont essentiels pour diagnostiquer les problèmes. Voici comment étendre la journalisation pour couvrir les exceptions :
from fastapi import Request, HTTPException
from fastapi.responses import JSONResponse

@app.exception_handler(Exception)
async def global_exception_handler(request: Request, exc: Exception):
	logger.error(f"An error occurred: {exc}")
             return JSONResponse(status_code=500, content={"message": "Internal Server Error"})
@app.exception_handler(HTTPException)
async def http_exception_handler(request: Request, exc: HTTPException):
	logger.error(f"HTTP error occurred: {exc.detail}")
	return JSONResponse(status_code=exc.status_code, content={"message": exc.detail})
Avec cette configuration, toute exception non gérée sera consignée, facilitant l'analyse des incidents.
Déployer des LLM en production peut transformer vos applications, mais implique de gérer des enjeux tels que le choix du modèle, les ressources et l'intégration. LangServe simplifie ces étapes et aide à déployer, superviser et maintenir efficacement des applications LLM.
Avec LangServe, vous accélérez le déploiement, renforcez la performance et intégrez vos systèmes sans friction.
Pour aller plus loin dans la création et le déploiement d'applications LLM, explorez le cours Developing LLM Applications with LangChain sur DataCamp. Vous y verrez notamment la création de chatbots et l'intégration de données externes avec le LangChain Expression Language (LCEL).
Continuez à apprendre sur les LLM
Cours
Cursus
Cursus