Kursus
Database Vektor untuk Embeddings dengan Pinecone
3 jam
12.2K
Intinya, vector database adalah sistem yang dibuat khusus untuk menyimpan dan mengambil data vektor. Dalam konteks ini, vektor merujuk pada sekumpulan nilai numerik berurutan yang dapat merepresentasikan apa pun, mulai dari koordinat spasial hingga atribut fitur, seperti pada kasus penggunaan machine learning dan data science di mana vektor sering digunakan untuk merepresentasikan fitur objek. Vector database dapat menyimpan dan mengambil feature vector ini secara efisien.
Gambar oleh Gary Alway
Vector embedding adalah proses merepresentasikan objek, seperti kata, kalimat, atau entitas, sebagai vektor dalam ruang vektor kontinu. Teknik ini umum digunakan untuk mengubah data berdimensi tinggi dan kategorikal menjadi vektor kontinu berdimensi lebih rendah, yang dapat lebih efektif digunakan oleh algoritma machine learning. Vector embedding sangat populer dalam pemrosesan bahasa alami (NLP), di mana embedding digunakan untuk merepresentasikan kata atau frasa.
Gagasan utama di balik vector embedding adalah menangkap hubungan semantik antarobjek. Dalam konteks word embedding, misalnya, kata-kata dengan makna serupa direpresentasikan oleh vektor yang saling berdekatan dalam ruang vektor. Ini memungkinkan model machine learning untuk lebih memahami hubungan kontekstual dan semantik antar kata.
Bertumpu pada konsep vector embedding, Large Language Model (LLM) memanfaatkan representasi numerik ini untuk menangani tugas pemahaman dan generasi bahasa yang kompleks.
Sebagai contoh konkret, arsitektur dasar model untuk chat GTP melibatkan penggunaan vektor. Model memproses data masukan, seperti teks, dengan mengonversinya menjadi vektor numerik.
Vektor-vektor ini menangkap informasi semantik dan kontekstual dari masukan, memungkinkan model memahami dan menghasilkan respons yang koheren serta relevan secara konteks. Arsitektur Transformer, yang menjadi dasar GPT-3.5, memanfaatkan mekanisme self-attention untuk memberi bobot pada pentingnya kata-kata berbeda dalam suatu urutan, sehingga semakin meningkatkan kemampuan model dalam menangkap hubungan dan konteks.
“Self-attention” merujuk pada kemampuan model untuk menetapkan tingkat kepentingan yang bervariasi pada kata-kata berbeda di dalam urutan masukan.
Jadi, pada dasarnya, model GPT-3.5 beroperasi pada representasi bahasa yang telah divektorkan untuk melakukan berbagai tugas pemahaman dan generasi bahasa alami. Pendekatan berbasis vektor ini merupakan faktor kunci keberhasilan model dalam berbagai aplikasi terkait bahasa.
PG Vector adalah pencarian kemiripan vektor open-source untuk Postgres. Mari langsung membuat database dengan Docker. Buat berkas bernama docker-compose.yml lalu di baris perintah jalankan perintah berikut: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
Langkah berikutnya adalah membuat tabel, dan untuk contoh ini, kita akan membuat katalog sumber belajar DataCamp, termasuk course, blog, tutorial, podcast, cheat sheet, code along, dan sertifikasi.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
Kolom embedding akan dihasilkan dari objek JSON yang di-stringify yang merepresentasikan atribut sumber daya { name, content, slug, type }. Untuk membuat vector embedding ini, kita akan memanfaatkan model embedding.
Salah satu model yang tersedia di AWS Bedrock adalah amazon.titan-embed-text-v1. Konfigurasi Bedrock tidak dibahas dalam artikel ini; ini hanya contoh dari sekian banyak model embedding yang mampu menghasilkan hasil serupa. Tujuan utamanya adalah mengambil masukan tekstual, menggunakan model embedding untuk menghasilkan vector embedding, lalu menyimpannya ke dalam kolom embedding.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]Dengan kemampuan menyimpan data bersama vector embedding-nya, kita membuka kekuatan vector database, memungkinkan kita melakukan percakapan layaknya bahasa alami dengan database dan dengan mudah mengambil hasil yang bermakna.
Cukup rumuskan pertanyaan apa pun yang ingin Anda “tanyakan pada data Anda” dan terapkan embedding yang sama pada teks tersebut. Berikut tampilan kueri SQL-nya:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Kueri ini menggunakan pencarian cosine similarity. Parameter $1 merepresentasikan hasil embedding dari teks pertanyaan masukan Anda, sementara parameter $2, yang berfungsi sebagai ambang kemiripan, adalah variabel yang akan lebih baik ditentukan melalui eksperimen. Nilai optimalnya bergantung pada faktor seperti ukuran dataset Anda dan relevansi hasil yang diinginkan, yang membentuk tingkat keterperincian informasi yang diambil.
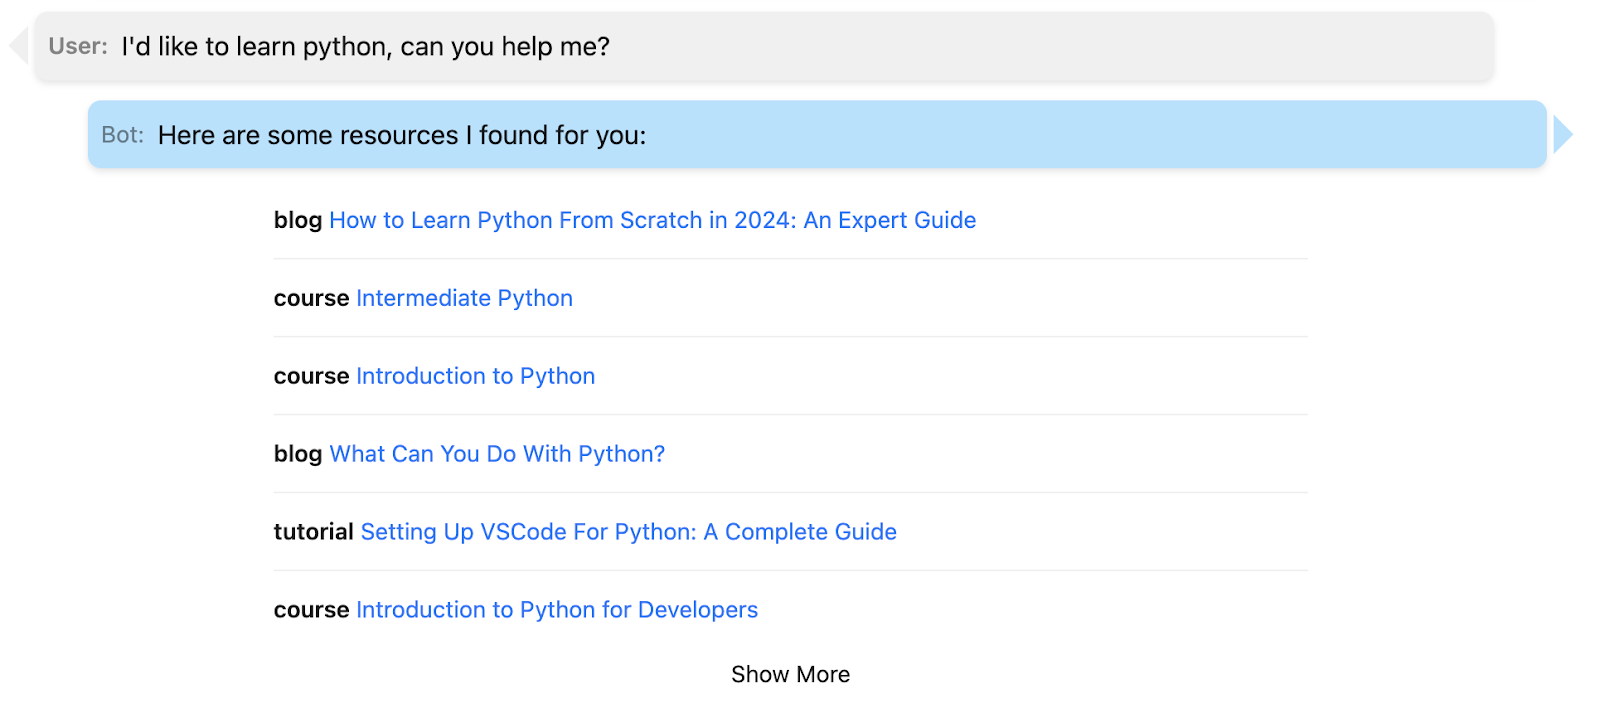
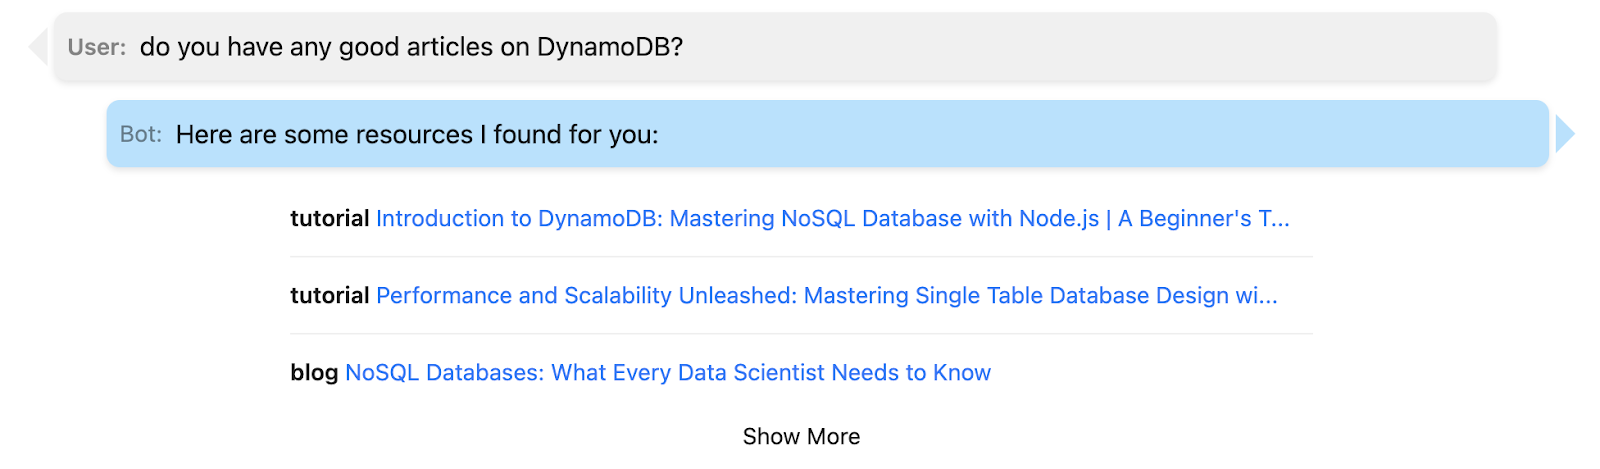
Dengan semua komponen ini, membuat UI bergaya chat menjadi mudah. Rincian penerapan antarmuka semacam itu berada di luar cakupan artikel ini, namun berikut beberapa contoh menggunakan dataset DataCamp saya, yang berisi lebih dari 600+ record:
Dalam artikel ini, kita telah menjelajahi ranah kuat vector database, memanfaatkan PG Vector untuk meningkatkan kemampuan penyimpanan dan pengambilan data. Saat Anda memulai perjalanan dengan vector embedding, masih banyak yang dapat ditemukan dan dipelajari. Untuk menggali lebih dalam tentang PG Vector, lihat readme mereka, yang membahas lebih detail dan menyertakan tautan ke klien untuk bahasa pemrograman pilihan Anda.
Kemajuan alami dari pemahaman vector embedding adalah Retrieval Augmented Generation (RAG). Ini adalah proses menyuntikkan data kontekstual ke dalam large language model (LLM). Dengan demikian, RAG memberikan pengetahuan di luar data pelatihan, memungkinkan respons yang lebih informatif dan relevan secara konteks.
Anda juga dapat menemukan berbagai sumber daya DataCamp yang membahas elemen lain dari vector database, termasuk:
Selamat ngoding, semoga upaya berbasis vektor Anda penuh wawasan dan memberi hasil yang memuaskan!
Lanjutkan Perjalanan Anda dengan Vektor Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



