Kursus
Pengantar LLM di Python
3 jam
36.6K
Google baru saja memperkenalkan Gemma 4, yang digambarkan sebagai keluarga model open-source paling cerdas sejauh ini, dibangun untuk penalaran yang kuat dan alur kerja agen. Model Gemma dirancang fleksibel di berbagai lingkungan, dengan dukungan resmi dan tooling untuk pengembangan lokal, penerapan di cloud, dan kustomisasi model, sehingga menjadi pilihan yang kuat untuk proyek fine-tuning.
Dalam tutorial ini, kita akan melakukan fine-tuning Gemma 4 E4B-it pada dataset klasifikasi emosi manusia dari Hugging Face. Kita akan menyiapkan lingkungan GPU 3090, memuat dan memeriksa dataset, menyiapkan dan memformat data untuk supervised fine-tuning, memuat model dasar, menjalankan evaluasi baseline sebelum pelatihan, melakukan fine-tuning pada model, lalu mengevaluasi kinerjanya lagi setelah pelatihan.
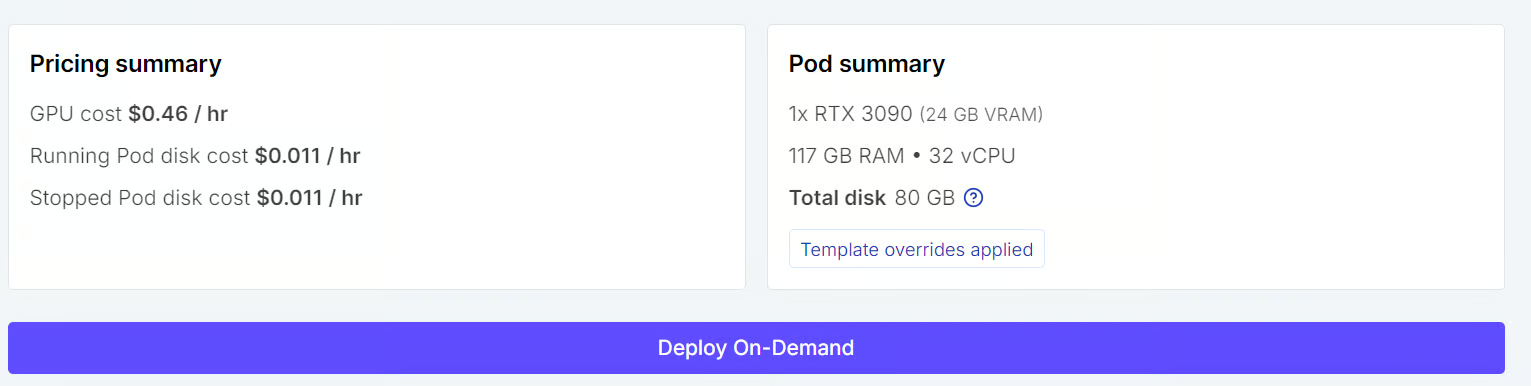
Mulailah dengan meluncurkan instance Runpod baru, dan pastikan akun Anda memiliki setidaknya kredit $5 sebelum memulai. Untuk tutorial ini, pilih pod GPU 3090 dan pilih template PyTorch terbaru.
Sebelum melakukan deployment, buka pengaturan template dan lakukan beberapa pembaruan. Tingkatkan disk container dan disk volume menjadi 40 GB agar Anda memiliki ruang yang cukup untuk model, dataset, berkas cache, dan checkpoint pelatihan.
Anda juga sebaiknya menambahkan token Hugging Face Anda sebagai variabel lingkungan. Anda dapat membuat token ini dari Settings > Access Tokens di akun Hugging Face Anda.
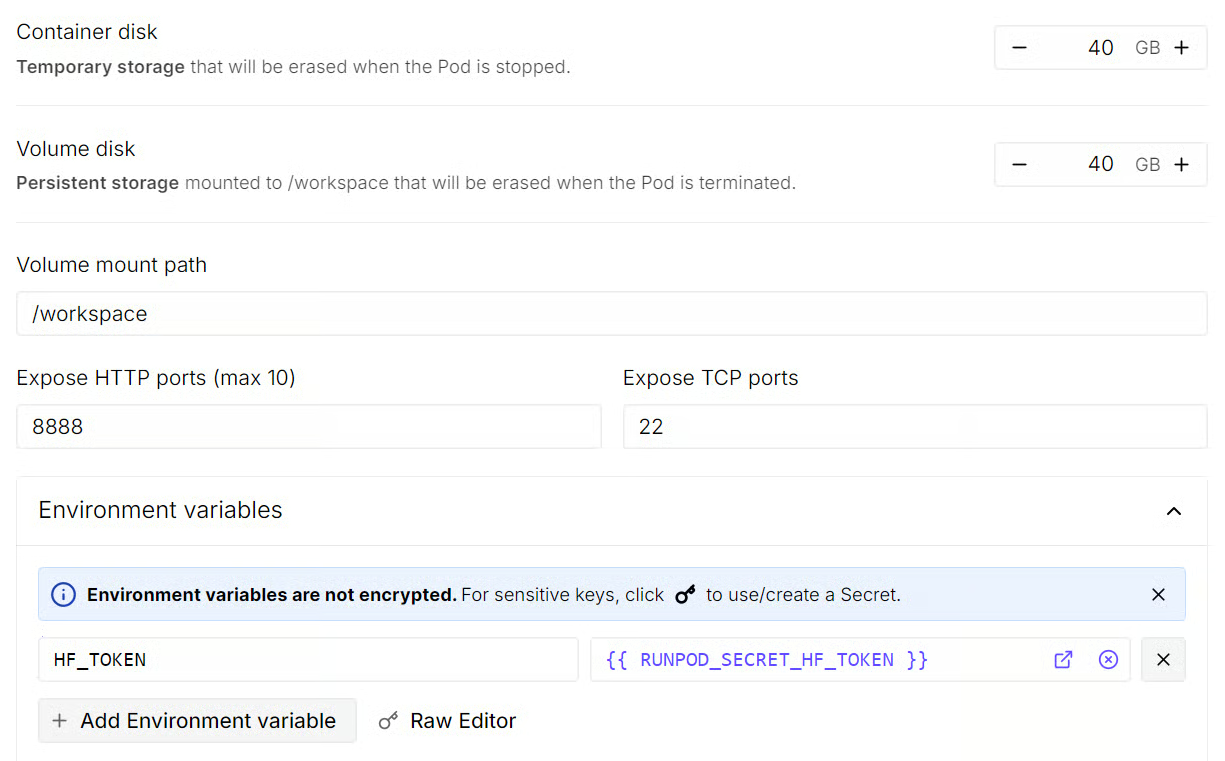
Setelah pengaturan ini diterapkan, lanjutkan dan deploy pod. Mungkin perlu satu hingga dua menit untuk instance mulai berjalan. Setelah siap, buka antarmuka JupyterLab agar Anda dapat mulai bekerja di dalam lingkungan tersebut.
Hal pertama yang perlu dilakukan di JupyterLab adalah meluncurkan notebook Python baru dan memasang semua paket Python yang diperlukan. Jalankan perintah berikut di sel notebook:
%%capture
!pip install -U transformers accelerate datasets trl peft bitsandbytes scikit-learn huggingface_hub
Paket-paket ini mencakup seluruh alur kerja, termasuk memuat dataset, menyiapkan model, fine-tuning, dan evaluasi.
Langkah terakhir adalah masuk ke Hugging Face Hub menggunakan token yang telah Anda simpan. Ini memberi Anda akses ke model berpembatas dan juga memudahkan untuk mengunggah berkas, membuat repositori, dan mendorong model hasil fine-tuning nanti.
import os
from huggingface_hub import login

hf_token = os.environ.get("HF_TOKEN")
if not hf_token:
    raise ValueError("Set HF_TOKEN in the RunPod environment before running this notebook.")

login(token=hf_token)
print("Logged in to Hugging Face.")Sekarang lingkungan sudah siap, langkah berikutnya adalah memuat dataset emosi dari Hugging Face dan menyiapkan split yang lebih kecil untuk pelatihan dan evaluasi.
Untuk tutorial ini, kita tidak menggunakan seluruh dataset. Sebagai gantinya, kita membuat split train, validation, dan test yang dibatasi agar proses fine-tuning tetap cepat dan mudah dijalankan pada satu GPU.
from datasets import load_dataset, DatasetDict

TRAIN_LIMIT = 4000
VALIDATION_LIMIT = 400
TEST_LIMIT = 400
EVAL_LIMIT = 400

raw_dataset = load_dataset("dair-ai/emotion")

def maybe_limit(split, limit):
    split = split.shuffle(seed=42)
    if limit is None:
        return split
    return split.select(range(min(limit, len(split))))

dataset = DatasetDict({
    "train": maybe_limit(raw_dataset["train"], TRAIN_LIMIT),
    "validation": maybe_limit(raw_dataset["validation"], VALIDATION_LIMIT),
    "test": maybe_limit(raw_dataset["test"], TEST_LIMIT),
})

dataset
Dataset final berisi 4.000 contoh pelatihan, 400 contoh validasi, dan 400 contoh pengujian.
DatasetDict({
    train: Dataset({
        features: ['text', 'label'],
        num_rows: 4000
    })
    validation: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
    test: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
})
Selanjutnya, kita melihat nama label yang disimpan dalam dataset. Ini adalah kelas emosi yang akan dipelajari model untuk diprediksi.
label_names = dataset["train"].features["label"].names
label_names
Ini menunjukkan bahwa tugas memiliki enam kategori emosi: sadness, joy, love, anger, fear, dan surprise.
['sadness', 'joy', 'love', 'anger', 'fear', 'surprise']Kita juga dapat memeriksa satu contoh dari split pelatihan untuk melihat bagaimana struktur datanya.
dataset["train"][0]Setiap contoh berisi potongan teks dan label numerik. Dalam kasus ini, label 4 dipetakan ke fear berdasarkan daftar label di atas.
{'text': 'while cycling in the country', 'label': 4}Sebelum kita dapat melakukan fine-tuning pada model, kita perlu mengonversi dataset ke format yang akan digunakan Gemma 4 selama pelatihan.
Alih-alih hanya memberikan teks mentah dan label, kita menyusun setiap contoh sebagai interaksi chat singkat dengan pesan sistem, pesan pengguna, dan respons asisten yang diharapkan.
Prompt sistem memberi tahu model secara tepat tugas apa yang harus dilakukan. Dalam kasus ini, kita ingin model bertindak sebagai asisten klasifikasi emosi dan mengembalikan hanya salah satu dari enam label yang diizinkan.
SYSTEM_PROMPT = """You are an emotion classification assistant.
Read the user's text and answer with exactly one label.
Only choose from: sadness, joy, love, anger, fear, surprise.
Return only the label and nothing else."""
Dalam pengaturan ini, pesan pengguna berisi teks masukan yang ingin kita klasifikasikan, dan pesan asisten berisi label yang benar. Ini adalah format yang digunakan untuk supervised fine-tuning, di mana model belajar menghasilkan respons yang tepat untuk setiap contoh pelatihan.
def to_prompt_completion(example):
    text = example["text"]
    label = label_names[example["label"]]
    return {
        "prompt": [
            {
                "role": "system",
                "content": SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": f"Classify the emotion of this text:\n\n{text}",
            },
        ],
        "completion": [
            {
                "role": "assistant",
                "content": label,
            }
        ],
    }

sft_dataset = dataset.map(to_prompt_completion, remove_columns=dataset["train"].column_names)
Setelah menerapkan fungsi pemformatan ini, kolom text dan label asli digantikan dengan field terstruktur prompt dan completion.
Kita dapat memeriksa satu contoh untuk memastikan dataset telah diformat dengan benar.
sft_dataset["train"][0]Outputnya menunjukkan struktur pelatihan lengkap dengan jelas. Model melihat instruksi, membaca teks masukan, dan belajar menghasilkan label emosi yang benar sebagai jawaban.
{'prompt': [{'content': "You are an emotion classification assistant.\nRead the user's text and answer with exactly one label.\nOnly choose from: sadness, joy, love, anger, fear, surprise.\nReturn only the label and nothing else.",
   'role': 'system'},
  {'content': 'Classify the emotion of this text:\n\nwhile cycling in the country',
   'role': 'user'}],
'completion': [{'content': 'fear', 'role': 'assistant'}]}Sekarang kita dapat memuat Gemma 4 E4B-it dan menyiapkannya untuk fine-tuning. Karena ini adalah model yang relatif besar, kita memuatnya dengan kuantisasi 4-bit untuk mengurangi penggunaan memori dan memudahkan menjalankannya pada GPU 3090. Kita juga menggunakan bfloat16 sebagai tipe komputasi, yang membantu menjaga efisiensi setup.
Kita mulai dengan mengimpor pustaka yang diperlukan dan mendefinisikan pengaturan utama model.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "google/gemma-4-E4B-it"
MODEL_DTYPE = torch.bfloat16
USE_4BIT = True
Selanjutnya, kita mengaktifkan beberapa optimalisasi CUDA dan memuat tokenizer.
if torch.cuda.is_available():
    torch.backends.cuda.matmul.allow_tf32 = True
    torch.backends.cudnn.allow_tf32 = True

processor = AutoTokenizer.from_pretrained(MODEL_ID, use_fast=True)
if processor.pad_token is None:
    processor.pad_token = processor.eos_token
Sekarang kita menyiapkan pengaturan kuantisasi dan argumen pemuatan model.
bnb_config = None
model_kwargs = {
    "device_map": "auto",
}
if USE_4BIT:
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=MODEL_DTYPE,
    )
    model_kwargs["quantization_config"] = bnb_config
else:
    model_kwargs["torch_dtype"] = MODEL_DTYPE
Terakhir, kita memuat model dan menyelaraskan konfigurasinya dengan tokenizer.
base_model = AutoModelForCausalLM.from_pretrained(MODEL_ID, **model_kwargs)
base_model.config.use_cache = False
base_model.config.pad_token_id = processor.pad_token_id
base_model.config.bos_token_id = processor.bos_token_id
base_model.config.eos_token_id = processor.eos_token_id
base_model.generation_config.pad_token_id = processor.pad_token_id
base_model.generation_config.bos_token_id = processor.bos_token_id
base_model.generation_config.eos_token_id = processor.eos_token_id

print(f"Base model loaded with 4-bit={USE_4BIT} and dtype={MODEL_DTYPE}.")
Ini memuat model dasar ke perangkat yang tersedia, menonaktifkan cache untuk pelatihan, dan memastikan ID token khusus disetel dengan benar untuk konfigurasi model dan konfigurasi generasi.
Base model loaded with 4-bit=True and dtype=torch.bfloat16.Sebelum fine-tuning, ada baiknya mengevaluasi model dasar terlebih dahulu agar kita memiliki baseline yang jelas untuk dibandingkan nanti.
Di bagian ini, kita mendefinisikan beberapa fungsi pembantu yang menghasilkan prediksi, mengekstrak label emosi yang valid, dan menjalankan evaluasi pada split test.
Kita mulai dengan membuat pola ekstraksi label sederhana dan fungsi pembantu untuk prediksi.
Fungsi-fungsi ini menangani alur prediksi penuh. Model menerima masukan dalam format chat, menghasilkan respons singkat, lalu kita mengekstrak label yang diprediksi. Jika model mengembalikan teks tambahan, fungsi pembantu akan mencoba mengambil label emosi valid pertama.
import re

LABEL_PATTERN = re.compile(r"\b(sadness|joy|love|anger|fear|surprise)\b", re.IGNORECASE)

def extract_label(raw_text: str) -> str:
    raw_text = raw_text.strip().lower()
    match = LABEL_PATTERN.search(raw_text)
    if match:
        return match.group(1)

    first_token = raw_text.split()[0].strip(".,!?:;\"'()[]{}") if raw_text.split() else ""
    return first_token

def generate_label(model, processor, user_text, system_prompt, max_new_tokens=4):
    messages = [
        {
            "role": "system",
            "content": system_prompt,
        },
        {
            "role": "user",
            "content": f"Classify the emotion of this text:\n\n{user_text}",
        },
    ]

    device = next(model.parameters()).device
    inputs = processor.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    ).to(device)

    input_len = inputs["input_ids"].shape[-1]

    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            do_sample=False,
            pad_token_id=processor.pad_token_id,
            eos_token_id=processor.eos_token_id,
        )

    raw_pred = processor.decode(outputs[0][input_len:], skip_special_tokens=True).strip()
    return extract_label(raw_pred)


def predict_emotion(user_text: str, model=None, proc=None) -> str:
    model = model or base_model
    proc = proc or processor
    return generate_label(model, proc, user_text, SYSTEM_PROMPT)
Sekarang kita dapat menguji setup pada satu contoh sebelum menjalankan evaluasi penuh.
predict_emotion("I feel so happy and excited today!")Prediksi contoh terlihat benar, jadi kita bisa lanjut mengevaluasi model di seluruh split test.
'joy'Kode ini mengevaluasi model pada split test dan mengumpulkan beberapa output berguna. Ia menyimpan label sebenarnya dan label prediksi, melacak apakah setiap prediksi benar, dan mengembalikan metrik ringkasan, classification report, dan dataframe berisi semua prediksi.
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix, f1_score
import pandas as pd
from tqdm.auto import tqdm

VALID_LABELS = set(label_names)
ALL_EVAL_LABELS = label_names + ["INVALID"]

def evaluate_model(model, processor, split="test", limit=EVAL_LIMIT):
    y_true, y_pred, rows = [], [], []
    raw_source = dataset[split]
    if limit is not None:
        raw_source = raw_source.select(range(min(limit, len(raw_source))))

    model.eval()

    for ex in tqdm(raw_source, desc=f"Evaluating {split}", leave=False):
        true_label = label_names[ex["label"]]
        raw_pred_label = generate_label(model, processor, ex["text"], SYSTEM_PROMPT)
        pred_label = raw_pred_label if raw_pred_label in VALID_LABELS else "INVALID"

        y_true.append(true_label)
        y_pred.append(pred_label)
        rows.append({
            "text": ex["text"],
            "true_label": true_label,
            "pred_label": pred_label,
            "raw_pred_label": raw_pred_label,
            "correct": true_label == pred_label,
        })

    metrics = {
        "accuracy": accuracy_score(y_true, y_pred),
        "macro_f1": f1_score(y_true, y_pred, labels=label_names, average="macro", zero_division=0),
        "invalid_predictions": sum(1 for p in y_pred if p == "INVALID"),
        "evaluated_examples": len(y_true),
    }

    report = classification_report(
        y_true,
        y_pred,
        labels=label_names,
        output_dict=True,
        zero_division=0,
    )

    df = pd.DataFrame(rows)
    return metrics, report, df

def confusion_matrix_df(pred_df):
    return pd.DataFrame(
        confusion_matrix(pred_df["true_label"], pred_df["pred_label"], labels=ALL_EVAL_LABELS),
        index=ALL_EVAL_LABELS,
        columns=ALL_EVAL_LABELS,
    )
Sekarang kita dapat menjalankan evaluasi baseline penuh pada model dasar.
pre_metrics, pre_report, pre_preds = evaluate_model(base_model, processor, "test")
pre_metrics
Hasil baseline ini menunjukkan bahwa model yang belum dituning sudah berkinerja cukup baik, namun masih ada ruang untuk perbaikan.
Akurasi sekitar 58,25%, skor F1 makro sekitar 0,42, dan model menghasilkan 33 prediksi tidak valid, yang berarti kadang-kadang mengembalikan sesuatu di luar himpunan label yang diharapkan.
{'accuracy': 0.5825,
 'macro_f1': 0.42112912841373906,
 'invalid_predictions': 33,
 'evaluated_examples': 400}
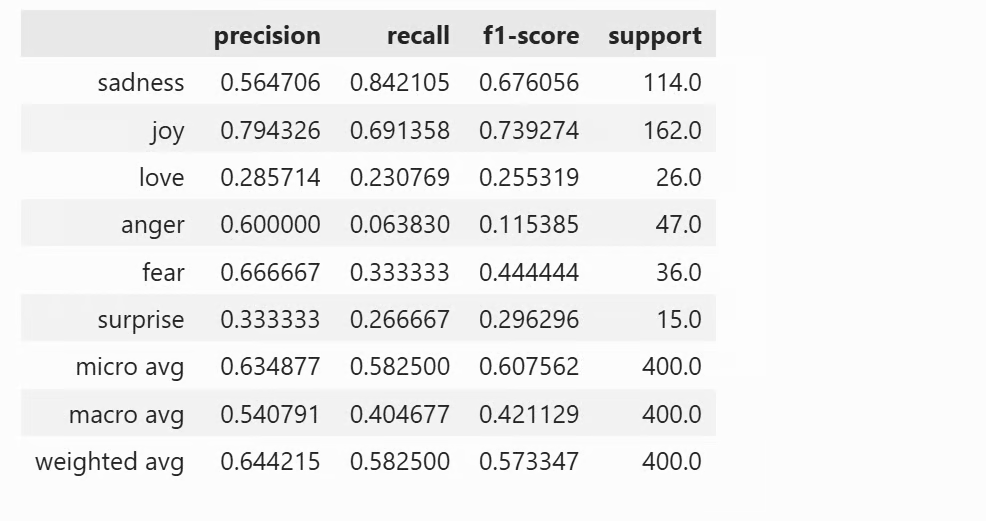
Selanjutnya, kita dapat melihat classification report lengkap untuk setiap kategori emosi.
pd.DataFrame(pre_report).transpose()Ini memberikan precision, recall, skor F1, dan support untuk setiap kelas. Ini membantu kita melihat emosi mana yang ditangani model dengan baik dan mana yang lebih sulit sebelum fine-tuning.
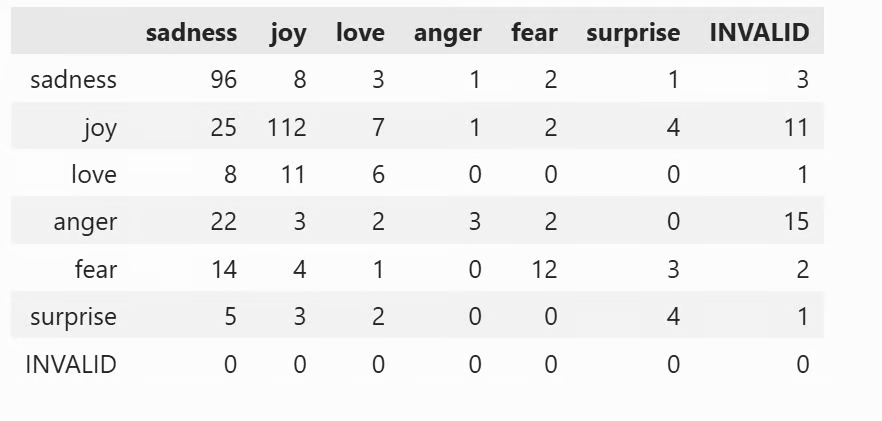
Terakhir, kita dapat memeriksa confusion matrix.
confusion_matrix_df(pre_preds)Confusion matrix menunjukkan bagaimana prediksi didistribusikan di berbagai kelas.
Di notebook, ini ditampilkan sebagai tabel, sehingga lebih mudah melihat emosi mana yang saling tertukar dan di mana model dasar paling kesulitan.
Sekarang kita telah memiliki hasil baseline, kita dapat melakukan fine-tuning Gemma 4 menggunakan LoRA.
LoRA adalah metode fine-tuning hemat parameter, yang berarti kita tidak memperbarui seluruh model. Sebagai gantinya, kita menambahkan sejumlah kecil bobot adaptor yang dapat dilatih di atas model dasar. Ini membuat pelatihan jauh lebih ringan dan praktis pada satu GPU.
Kita mulai dengan mendefinisikan konfigurasi LoRA.
Pengaturan ini mengontrol bagaimana adaptor LoRA dipasang ke model. Di sini, kita menggunakan rank 16, dropout 0,05, dan menerapkan LoRA ke semua lapisan linear, yang merupakan setup umum untuk fine-tuning yang efisien.
from peft import LoraConfig

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear"
)
Selanjutnya, kita mendefinisikan konfigurasi pelatihan dan menyiapkan trainer.
Setup pelatihan ini dirancang untuk menjaga penggunaan memori tetap terkendali sekaligus memberi model ruang yang cukup untuk belajar dari dataset. Kita melatih selama satu epoch, menggunakan akumulasi gradien untuk mensimulasikan ukuran batch yang lebih besar, dan mengaktifkan opsi seperti gradient checkpointing dan optimisasi 8-bit untuk membuat pelatihan lebih efisien.
from trl import SFTConfig, SFTTrainer

training_args = SFTConfig(
    output_dir="./gemma4-emotion-lora",
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=1e-4,
    weight_decay=0.01,
    lr_scheduler_type="linear",
    warmup_steps=50,
    num_train_epochs=1,
    logging_steps=50,
    eval_strategy="steps",
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    gradient_checkpointing=True,
    bf16=True,
    fp16=False,
    tf32=True,
    max_length=256,
    packing=False,
    completion_only_loss=True,
    remove_unused_columns=False,
    dataloader_num_workers=2,
    optim="paged_adamw_8bit",
    report_to="none",
)
Sekarang kita memastikan model dasar siap dan menginisialisasi trainer. Langkah ini memasang adaptor LoRA ke model dasar dan menyiapkan trainer supervised fine-tuning menggunakan split pelatihan dan validasi yang telah diformat.
from peft import PeftModel

if isinstance(base_model, PeftModel):
    base_model = base_model.unload()
    base_model.config.use_cache = False

trainer = SFTTrainer(
    model=base_model,
    train_dataset=sft_dataset["train"],
    eval_dataset=sft_dataset["validation"],
    peft_config=lora_config,
    args=training_args,
    processing_class=processor,
)
Sebelum mulai pelatihan, ada baiknya mengonfirmasi bahwa parameter LoRA terpasang dengan benar.
Ini menghitung jumlah parameter yang dapat dilatih dan memunculkan error jika tidak ada lapisan LoRA yang ditambahkan.
Setelah itu, pelatihan dimulai.
trainable_params = 0
for param in trainer.model.parameters():
    if param.requires_grad:
        trainable_params += param.numel()

if trainable_params == 0:
    raise RuntimeError("No trainable LoRA parameters were attached. Check target_modules before training.")

print(f"Trainable LoRA parameters: {trainable_params:,}")
train_result = trainer.train()
trainer.model.eval()
trainer.model.config.use_cache = True
train_result
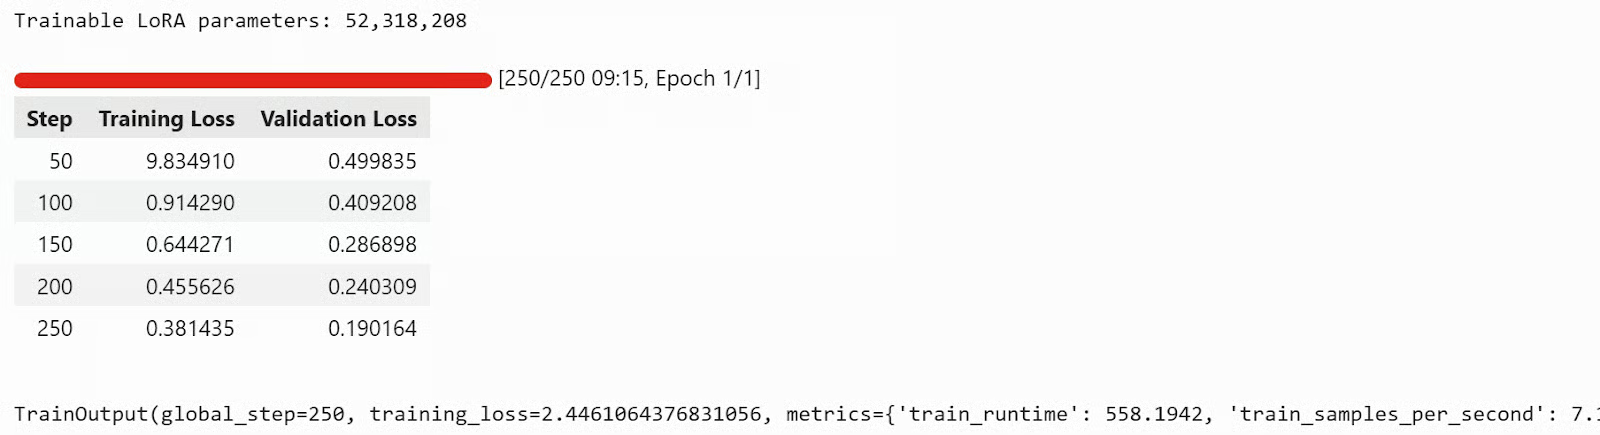
Pada run ini, pelatihan memakan waktu hampir 9 menit, dan baik training loss maupun validation loss terus menurun seiring waktu, yang merupakan pertanda baik bahwa model belajar dari dataset.
Setelah pelatihan selesai, kita dapat menyimpan adaptor dan tokenizer secara lokal.
trainer.model.save_pretrained("./gemma4-emotion-lora")
processor.save_pretrained("./gemma4-emotion-lora")
Terakhir, kita dapat mendorong model ke Hugging Face Hub.
Ini akan mengunggah adaptor hasil fine-tuning dan tokenizer ke Hub sehingga Anda dapat mengaksesnya dari mana saja, membagikannya dengan orang lain, atau memuatnya langsung ke notebook atau aplikasi lain.
repo_id = "kingabzpro/gemma4-emotion-lora"

# Push adapter + processor to the Hub
trainer.model.push_to_hub(
    repo_id,
    private=False,
)

processor.push_to_hub(
    repo_id,
    private=False,
)
Sekarang Anda dapat melihat kingabzpro/gemma4-emotion-lora di Hugging Face dan mencobanya sendiri. Repositori ini mencakup berkas model, petunjuk penggunaan, dan hasil fine-tuning.
Sumber: kingabzpro/gemma4-emotion-lora · Hugging Face
Sekarang pelatihan selesai, langkah terakhir adalah mengevaluasi model yang telah difine-tune pada split test yang sama dan membandingkan hasilnya dengan model dasar. Ini membantu kita melihat apakah fine-tuning LoRA meningkatkan kemampuan model untuk mengklasifikasikan emosi dengan lebih akurat.
Kita mulai dengan memuat model hasil fine-tuning dari trainer dan menjalankan evaluasi.
ft_model = trainer.model
ft_model.eval()
ft_model.config.use_cache = True
post_metrics, post_report, post_preds = evaluate_model(ft_model, processor, "test")
post_metrics
Ini memberi kita metrik evaluasi utama untuk model yang telah difine-tune.
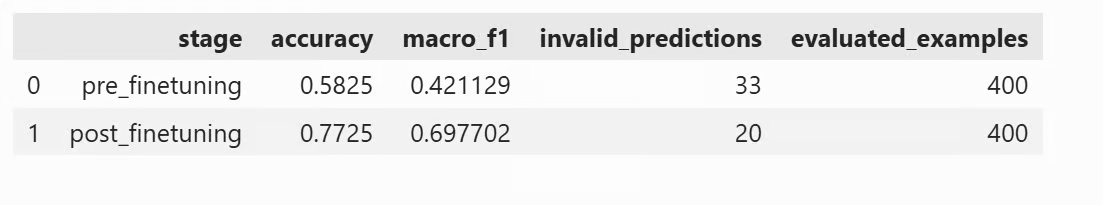
Hasil ini jelas lebih kuat daripada baseline. Setelah fine-tuning, model mencapai akurasi 77,25% dan skor F1 makro 0,698. Jumlah prediksi tidak valid juga turun dari 33 menjadi 20, yang menunjukkan bahwa model hasil fine-tuning tidak hanya lebih akurat, tetapi juga lebih konsisten dalam mengembalikan label yang valid.
{'accuracy': 0.7725,
 'macro_f1': 0.697702361480462,
 'invalid_predictions': 20,
 'evaluated_examples': 400}
Selanjutnya, kita dapat melihat classification report lengkap.
Ini menampilkan classification report sebagai pandas DataFrame langsung di notebook. Ini mencakup precision, recall, skor F1, dan support untuk setiap kelas emosi, sehingga lebih mudah melihat kategori mana yang paling banyak meningkat setelah fine-tuning.
pd.DataFrame(post_report).transpose()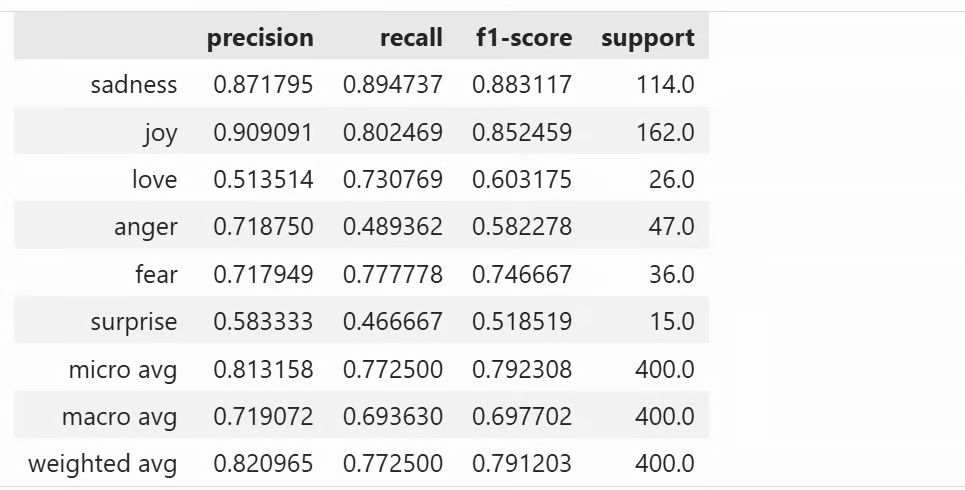
Ini juga ditampilkan di notebook sebagai tabel. Ini membantu Anda melihat di mana model yang telah difine-tune masih membuat kesalahan dan kategori emosi mana yang paling sering saling tertukar.
confusion_matrix_df(post_preds)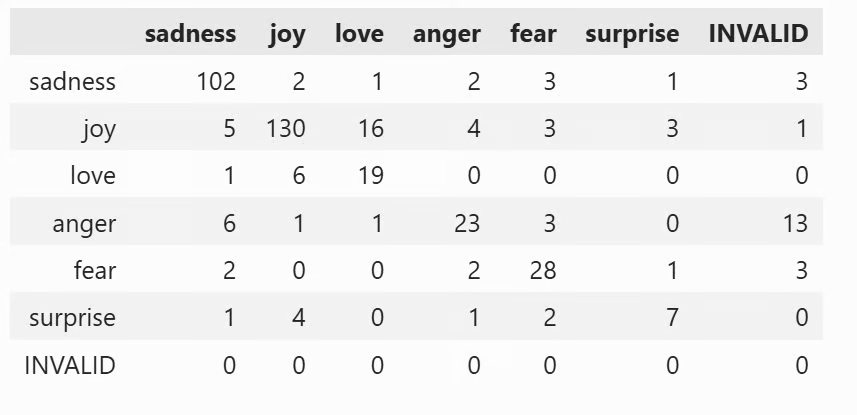
Untuk membuat perbandingan lebih jelas, kita dapat menempatkan metrik sebelum dan sesudah fine-tuning berdampingan.
comparison_df = pd.DataFrame([
    {"stage": "pre_finetuning", **pre_metrics},
    {"stage": "post_finetuning", **post_metrics},
])
comparison_df
Ini memberikan ringkasan cepat tentang seberapa besar peningkatan model setelah pelatihan.
Catatan: Jika Anda mengalami masalah saat menjalankan kode, Anda dapat merujuk notebook Jupyter lengkap di sini: fine-tune-gemma-4-on-emotions_final.ipynb
Fine-tuning Gemma 4 sangat sensitif terhadap setup, terutama struktur prompt dan argumen pelatihan. Jika format prompt salah, atau Anda tidak menggunakan template yang tepat secara konsisten, model mungkin menjalani pelatihan tanpa benar-benar mempelajari tugasnya dengan baik. Hal yang sama berlaku untuk pengaturan pelatihan. Ini biasanya menjadi alasan utama mengapa loss tidak menurun, atau mengapa loss menurun tetapi hasil evaluasi nyaris tidak membaik.
Pelajaran penting lainnya adalah max_length. Jika Anda menguranginya terlalu banyak, terutama di bawah sekitar 125, model mungkin tidak mempelajari polanya sama sekali. Saya mengalami beberapa masalah selama proses ini, namun terselesaikan satu per satu, dan sebagian besar kembali ke dua area yang sama: pemformatan prompt dan konfigurasi pelatihan.
Untuk meningkatkan hasil lebih lanjut, langkah bagus berikutnya adalah melakukan fine-tuning pada seluruh dataset dan melatih setidaknya selama 3 epoch, bukan hanya satu. Itu akan memberi model lebih banyak contoh untuk dipelajari dan lebih banyak waktu untuk beradaptasi, yang seharusnya menghasilkan akurasi dan skor F1 yang lebih kuat.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt