
कोर्स
Python में LLMs का परिचय
3 घंटा
36.6K
Google ने हाल ही में Gemma 4 पेश किया है, जिसे अब तक का इसका सबसे बुद्धिमान ओपन मॉडल परिवार बताया गया है, जो मजबूत तर्क और एजेंटिक वर्कफ़्लो के लिए बनाया गया है। Gemma मॉडल विभिन्न परिवेशों में लचीलेपन के लिए डिज़ाइन किए गए हैं, जिनमें लोकल डेवलपमेंट, क्लाउड डिप्लॉयमेंट और मॉडल कस्टमाइज़ेशन के लिए आधिकारिक सपोर्ट और टूलिंग शामिल है, जो उन्हें फाइन-ट्यूनिंग प्रोजेक्ट्स के लिए एक मजबूत विकल्प बनाता है।
इस ट्यूटोरियल में, हम Gemma 4 E4B-it को Hugging Face के मानव भावनाओं के वर्गीकरण डेटासेट पर फाइन-ट्यून करेंगे। हम एक 3090 GPU वातावरण सेटअप करेंगे, डेटासेट को लोड और निरीक्षण करेंगे, सुपरवाइज़्ड फाइन-ट्यूनिंग के लिए डेटा तैयार और फ़ॉर्मैट करेंगे, बेस मॉडल लोड करेंगे, ट्रेनिंग से पहले बेसलाइन मूल्यांकन चलाएंगे, मॉडल को फाइन-ट्यून करेंगे, और फिर ट्रेनिंग के बाद उसके प्रदर्शन का पुनः मूल्यांकन करेंगे।
शुरुआत एक नए Runpod इंस्टेंस लॉन्च करके करें, और सुनिश्चित करें कि आपके खाते में कम से कम $5 का क्रेडिट हो। इस ट्यूटोरियल के लिए, एक 3090 GPU pod चुनें और नवीनतम PyTorch टेम्पलेट का चयन करें।
डिप्लॉय करने से पहले, टेम्पलेट सेटिंग्स खोलें और कुछ अपडेट करें। कंटेनर डिस्क और वॉल्यूम डिस्क दोनों को 40 GB तक बढ़ाएँ ताकि मॉडल, डेटासेट, कैश्ड फ़ाइलें और ट्रेनिंग चेकपॉइंट्स के लिए पर्याप्त स्थान हो।
आपको अपना Hugging Face टोकन भी एक environment variable के रूप में जोड़ना चाहिए। आप अपने Hugging Face खाते में Settings > Access Tokens से यह टोकन जनरेट कर सकते हैं।
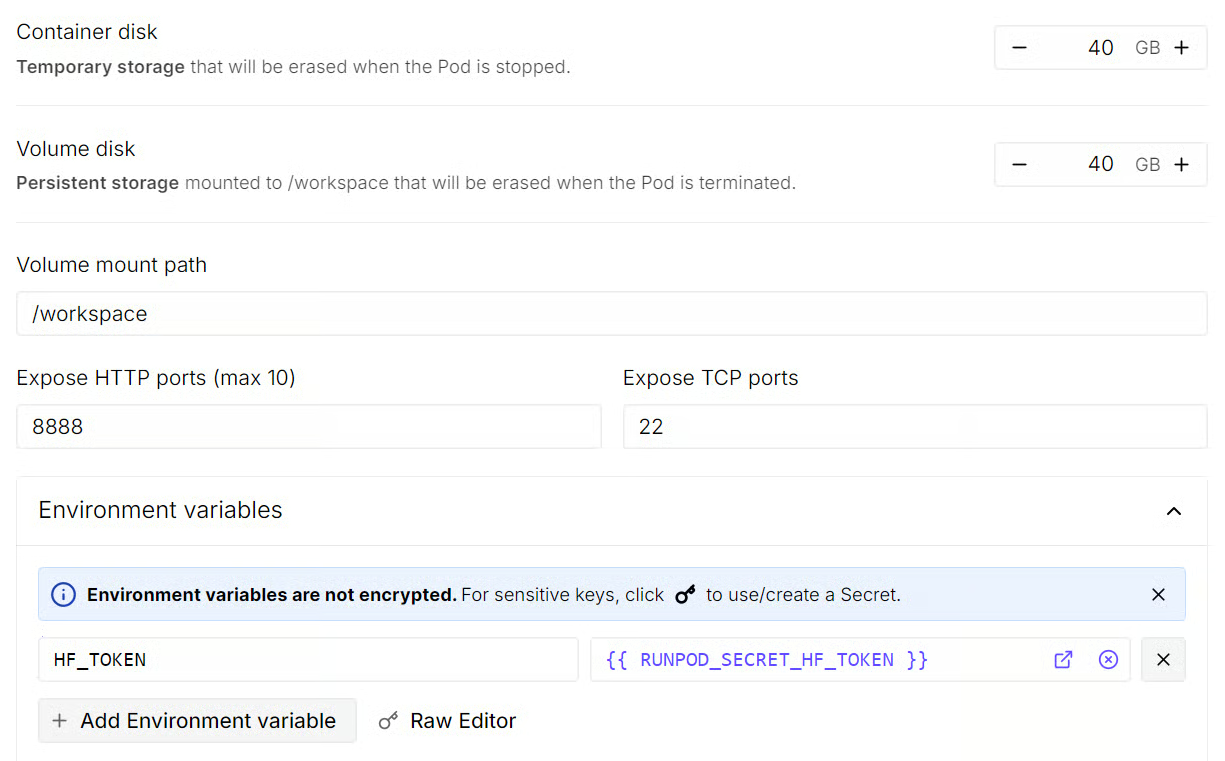
जब ये सेटिंग्स तैयार हों, तो pod डिप्लॉय करें। इंस्टेंस शुरू होने में एक-दो मिनट लग सकते हैं। तैयार होने के बाद, JupyterLab इंटरफेस खोलें ताकि आप वातावरण के अंदर काम शुरू कर सकें।
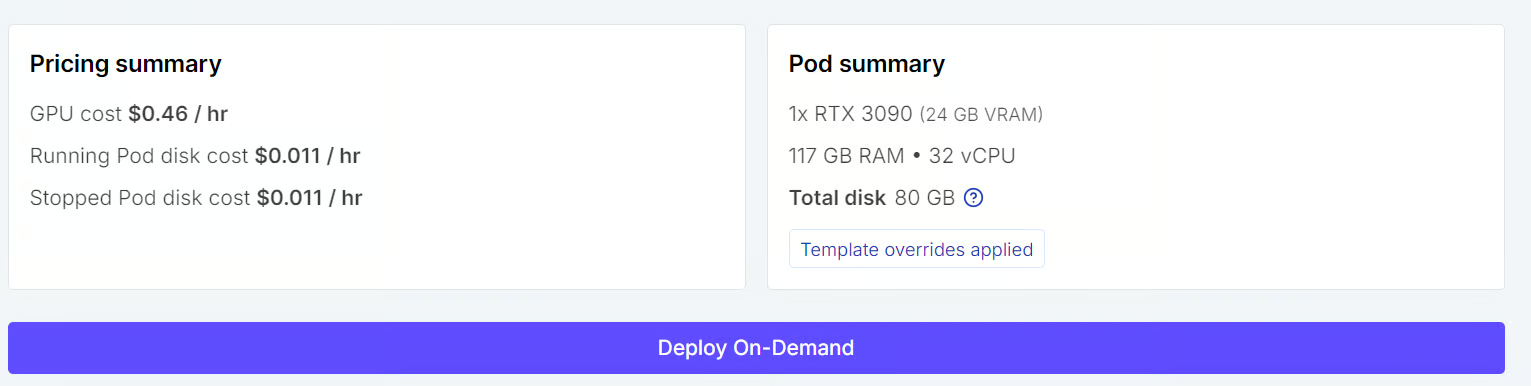
JupyterLab में सबसे पहले, नया Python नोटबुक लॉन्च करें और सभी आवश्यक Python पैकेज इंस्टॉल करें। नोटबुक सेल में निम्न कमांड चलाएँ:
%%capture
!pip install -U transformers accelerate datasets trl peft bitsandbytes scikit-learn huggingface_hub
ये पैकेज पूरे वर्कफ़्लो को कवर करेंगे, जिनमें डेटासेट लोड करना, मॉडल तैयार करना, फाइन-ट्यूनिंग, और मूल्यांकन शामिल है।
अंतिम चरण Hugging Face Hub में अपने सेव किए गए टोकन से साइन इन करना है। इससे आपको gated मॉडल तक पहुँच मिलती है और बाद में फ़ाइलें अपलोड करना, रिपॉजिटरी बनाना, और अपने फाइन-ट्यून किए गए मॉडल को पुश करना भी आसान हो जाता है।
import os
from huggingface_hub import login

hf_token = os.environ.get("HF_TOKEN")
if not hf_token:
    raise ValueError("Set HF_TOKEN in the RunPod environment before running this notebook.")

login(token=hf_token)
print("Logged in to Hugging Face.")अब जब वातावरण तैयार है, अगला कदम Hugging Face से इमोशन डेटासेट लोड करना और ट्रेनिंग व मूल्यांकन के लिए छोटे स्प्लिट्स तैयार करना है।
इस ट्यूटोरियल में, हम पूर्ण डेटासेट का उपयोग नहीं कर रहे हैं। इसके बजाय, हम सीमित train, validation, और test स्प्लिट्स बनाते हैं ताकि फाइन-ट्यूनिंग प्रक्रिया तेज़ रहे और एकल GPU पर चलाना आसान हो।
from datasets import load_dataset, DatasetDict

TRAIN_LIMIT = 4000
VALIDATION_LIMIT = 400
TEST_LIMIT = 400
EVAL_LIMIT = 400

raw_dataset = load_dataset("dair-ai/emotion")

def maybe_limit(split, limit):
    split = split.shuffle(seed=42)
    if limit is None:
        return split
    return split.select(range(min(limit, len(split))))

dataset = DatasetDict({
    "train": maybe_limit(raw_dataset["train"], TRAIN_LIMIT),
    "validation": maybe_limit(raw_dataset["validation"], VALIDATION_LIMIT),
    "test": maybe_limit(raw_dataset["test"], TEST_LIMIT),
})

dataset
अंतिम डेटासेट में 4,000 ट्रेनिंग उदाहरण, 400 वैलिडेशन उदाहरण, और 400 टेस्ट उदाहरण शामिल हैं।
DatasetDict({
    train: Dataset({
        features: ['text', 'label'],
        num_rows: 4000
    })
    validation: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
    test: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
})
अब हम डेटासेट में संरक्षित लेबल नाम देखते हैं। यही वे इमोशन क्लासेस हैं जिन्हें मॉडल भविष्यवाणी करना सीखेगा।
label_names = dataset["train"].features["label"].names
label_names
यह दर्शाता है कि कार्य में छह इमोशन श्रेणियाँ हैं: sadness, joy, love, anger, fear, और surprise।
['sadness', 'joy', 'love', 'anger', 'fear', 'surprise']हम ट्रेनिंग स्प्लिट से एक उदाहरण भी देख सकते हैं ताकि डेटा की संरचना समझ आए।
dataset["train"][0]प्रत्येक उदाहरण में एक टेक्स्ट और एक संख्यात्मक लेबल होता है। इस मामले में, लेबल 4 ऊपर दिए गए लेबल सूची के आधार पर fear से मैप होता है।
{'text': 'while cycling in the country', 'label': 4}मॉडल को फाइन-ट्यून करने से पहले, हमें डेटासेट को उस फ़ॉर्मैट में बदलना होगा जिसका उपयोग Gemma 4 ट्रेनिंग के दौरान करेगा।
केवल कच्चा टेक्स्ट और लेबल पास करने के बजाय, हम हर उदाहरण को एक छोटे चैट इंटरैक्शन के रूप में संरचित करते हैं जिसमें एक system message, एक user message, और अपेक्षित assistant response होता है।
सिस्टम प्रॉम्प्ट मॉडल को सटीक रूप से बताता है कि उसे कौन सा कार्य करना चाहिए। इस मामले में, हम चाहते हैं कि मॉडल इमोशन क्लासिफिकेशन असिस्टेंट की तरह काम करे और केवल छह में से किसी एक अनुमत लेबल को लौटाए।
SYSTEM_PROMPT = """You are an emotion classification assistant.
Read the user's text and answer with exactly one label.
Only choose from: sadness, joy, love, anger, fear, surprise.
Return only the label and nothing else."""
इस सेटअप में, user message में वह इनपुट टेक्स्ट होता है जिसे हम वर्गीकृत करना चाहते हैं, और assistant message में सही लेबल होता है। यही फ़ॉर्मैट सुपरवाइज़्ड फाइन-ट्यूनिंग के लिए इस्तेमाल होता है, जहां मॉडल हर ट्रेनिंग उदाहरण के लिए सही प्रतिक्रिया जनरेट करना सीखता है।
def to_prompt_completion(example):
    text = example["text"]
    label = label_names[example["label"]]
    return {
        "prompt": [
            {
                "role": "system",
                "content": SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": f"Classify the emotion of this text:\n\n{text}",
            },
        ],
        "completion": [
            {
                "role": "assistant",
                "content": label,
            }
        ],
    }

sft_dataset = dataset.map(to_prompt_completion, remove_columns=dataset["train"].column_names)
यह फ़ॉर्मैटिंग फ़ंक्शन लागू करने के बाद, मौलिक text और label कॉलम को संरचित prompt और completion फ़ील्ड्स से बदल दिया जाता है।
हम एक उदाहरण का निरीक्षण कर यह पुष्टि कर सकते हैं कि डेटासेट सही तरीके से फ़ॉर्मैट किया गया है।
sft_dataset["train"][0]आउटपुट में पूरा ट्रेनिंग स्ट्रक्चर स्पष्ट दिखता है। मॉडल निर्देश देखता है, इनपुट टेक्स्ट पढ़ता है, और उत्तर के रूप में सही इमोशन लेबल देना सीखता है।
{'prompt': [{'content': "You are an emotion classification assistant.\nRead the user's text and answer with exactly one label.\nOnly choose from: sadness, joy, love, anger, fear, surprise.\nReturn only the label and nothing else.",
   'role': 'system'},
  {'content': 'Classify the emotion of this text:\n\nwhile cycling in the country',
   'role': 'user'}],
'completion': [{'content': 'fear', 'role': 'assistant'}]}अब हम Gemma 4 E4B-it लोड कर सकते हैं और उसे फाइन-ट्यूनिंग के लिए तैयार कर सकते हैं। चूंकि यह अपेक्षाकृत बड़ा मॉडल है, हम इसे 4-बिट क्वांटाइज़ेशन के साथ लोड करते हैं ताकि मेमोरी उपयोग कम हो और 3090 GPU पर चलाना आसान हो जाए। हम bfloat16 को compute प्रकार के रूप में भी उपयोग करते हैं, जो सेटअप को कुशल बनाए रखता है।
हम आवश्यक लाइब्रेरी इम्पोर्ट करने और मुख्य मॉडल सेटिंग्स परिभाषित करने से शुरू करते हैं।
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "google/gemma-4-E4B-it"
MODEL_DTYPE = torch.bfloat16
USE_4BIT = True
अगला, हम कुछ CUDA ऑप्टिमाइज़ेशन सक्षम करते हैं और टोकनाइज़र लोड करते हैं।
if torch.cuda.is_available():
    torch.backends.cuda.matmul.allow_tf32 = True
    torch.backends.cudnn.allow_tf32 = True

processor = AutoTokenizer.from_pretrained(MODEL_ID, use_fast=True)
if processor.pad_token is None:
    processor.pad_token = processor.eos_token
अब हम क्वांटाइज़ेशन सेटिंग्स और मॉडल लोडिंग आर्गुमेंट्स तैयार करते हैं।
bnb_config = None
model_kwargs = {
    "device_map": "auto",
}
if USE_4BIT:
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=MODEL_DTYPE,
    )
    model_kwargs["quantization_config"] = bnb_config
else:
    model_kwargs["torch_dtype"] = MODEL_DTYPE
अंत में, हम मॉडल लोड करते हैं और उसकी कॉन्फ़िगरेशन को टोकनाइज़र के साथ संरेखित करते हैं।
base_model = AutoModelForCausalLM.from_pretrained(MODEL_ID, **model_kwargs)
base_model.config.use_cache = False
base_model.config.pad_token_id = processor.pad_token_id
base_model.config.bos_token_id = processor.bos_token_id
base_model.config.eos_token_id = processor.eos_token_id
base_model.generation_config.pad_token_id = processor.pad_token_id
base_model.generation_config.bos_token_id = processor.bos_token_id
base_model.generation_config.eos_token_id = processor.eos_token_id

print(f"Base model loaded with 4-bit={USE_4BIT} and dtype={MODEL_DTYPE}.")
यह बेस मॉडल को उपलब्ध डिवाइस पर लोड करता है, ट्रेनिंग के लिए कैशिंग को निष्क्रिय करता है, और सुनिश्चित करता है कि विशेष टोकन IDs मॉडल कॉन्फ़िग और जेनरेशन कॉन्फ़िग दोनों के लिए सही तरह से सेट हों।
Base model loaded with 4-bit=True and dtype=torch.bfloat16.फाइन-ट्यूनिंग से पहले, बाद में तुलना के लिए एक स्पष्ट बेसलाइन पाने हेतु पहले बेस मॉडल का मूल्यांकन करना उपयोगी होता है।
इस सेक्शन में, हम कुछ हेल्पर फ़ंक्शन्स परिभाषित करते हैं जो प्रिडिक्शन्स जनरेट करते हैं, वैध इमोशन लेबल निकालते हैं, और टेस्ट स्प्लिट पर मूल्यांकन चलाते हैं।
हम एक साधारण लेबल एक्सट्रैक्शन पैटर्न और प्रिडिक्शन के लिए हेल्पर फ़ंक्शन्स बनाकर शुरू करते हैं।
ये फ़ंक्शन पूरे प्रिडिक्शन फ़्लो को संभालते हैं। मॉडल को इनपुट चैट फ़ॉर्मैट में मिलता है, वह एक छोटा उत्तर जनरेट करता है, और फिर हम भविष्यवाणी किया गया लेबल निकालते हैं। यदि मॉडल अतिरिक्त टेक्स्ट लौटाता है, तो हेल्पर फ़ंक्शन पहला वैध इमोशन लेबल रिकवर करने की कोशिश करता है।
import re

LABEL_PATTERN = re.compile(r"\b(sadness|joy|love|anger|fear|surprise)\b", re.IGNORECASE)

def extract_label(raw_text: str) -> str:
    raw_text = raw_text.strip().lower()
    match = LABEL_PATTERN.search(raw_text)
    if match:
        return match.group(1)

    first_token = raw_text.split()[0].strip(".,!?:;\"'()[]{}") if raw_text.split() else ""
    return first_token

def generate_label(model, processor, user_text, system_prompt, max_new_tokens=4):
    messages = [
        {
            "role": "system",
            "content": system_prompt,
        },
        {
            "role": "user",
            "content": f"Classify the emotion of this text:\n\n{user_text}",
        },
    ]

    device = next(model.parameters()).device
    inputs = processor.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    ).to(device)

    input_len = inputs["input_ids"].shape[-1]

    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            do_sample=False,
            pad_token_id=processor.pad_token_id,
            eos_token_id=processor.eos_token_id,
        )

    raw_pred = processor.decode(outputs[0][input_len:], skip_special_tokens=True).strip()
    return extract_label(raw_pred)


def predict_emotion(user_text: str, model=None, proc=None) -> str:
    model = model or base_model
    proc = proc or processor
    return generate_label(model, proc, user_text, SYSTEM_PROMPT)
अब हम पूरे मूल्यांकन से पहले एकल उदाहरण पर सेटअप का परीक्षण कर सकते हैं।
predict_emotion("I feel so happy and excited today!")सैंपल भविष्यवाणी सही दिखती है, तो हम टेस्ट स्प्लिट पर पूरे मॉडल का मूल्यांकन करने की ओर बढ़ सकते हैं।
'joy'यह कोड मॉडल का टेस्ट स्प्लिट पर मूल्यांकन करता है और कई उपयोगी आउटपुट संग्रहित करता है। यह वास्तविक और भविष्यवाणी किए गए लेबल्स संग्रहीत करता है, प्रत्येक भविष्यवाणी के सही होने का ट्रैक रखता है, और समरी मेट्रिक्स, एक क्लासिफिकेशन रिपोर्ट, और सभी भविष्यवाणियों के साथ एक डेटा फ़्रेम लौटाता है।
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix, f1_score
import pandas as pd
from tqdm.auto import tqdm

VALID_LABELS = set(label_names)
ALL_EVAL_LABELS = label_names + ["INVALID"]

def evaluate_model(model, processor, split="test", limit=EVAL_LIMIT):
    y_true, y_pred, rows = [], [], []
    raw_source = dataset[split]
    if limit is not None:
        raw_source = raw_source.select(range(min(limit, len(raw_source))))

    model.eval()

    for ex in tqdm(raw_source, desc=f"Evaluating {split}", leave=False):
        true_label = label_names[ex["label"]]
        raw_pred_label = generate_label(model, processor, ex["text"], SYSTEM_PROMPT)
        pred_label = raw_pred_label if raw_pred_label in VALID_LABELS else "INVALID"

        y_true.append(true_label)
        y_pred.append(pred_label)
        rows.append({
            "text": ex["text"],
            "true_label": true_label,
            "pred_label": pred_label,
            "raw_pred_label": raw_pred_label,
            "correct": true_label == pred_label,
        })

    metrics = {
        "accuracy": accuracy_score(y_true, y_pred),
        "macro_f1": f1_score(y_true, y_pred, labels=label_names, average="macro", zero_division=0),
        "invalid_predictions": sum(1 for p in y_pred if p == "INVALID"),
        "evaluated_examples": len(y_true),
    }

    report = classification_report(
        y_true,
        y_pred,
        labels=label_names,
        output_dict=True,
        zero_division=0,
    )

    df = pd.DataFrame(rows)
    return metrics, report, df

def confusion_matrix_df(pred_df):
    return pd.DataFrame(
        confusion_matrix(pred_df["true_label"], pred_df["pred_label"], labels=ALL_EVAL_LABELS),
        index=ALL_EVAL_LABELS,
        columns=ALL_EVAL_LABELS,
    )
अब हम बेस मॉडल पर पूरा बेसलाइन मूल्यांकन चला सकते हैं।
pre_metrics, pre_report, pre_preds = evaluate_model(base_model, processor, "test")
pre_metrics
ये बेसलाइन परिणाम दिखाते हैं कि बिना ट्यून किया मॉडल पहले से ही ठीक-ठाक प्रदर्शन करता है, लेकिन सुधार की गुंजाइश है।
एक्यूरेसी लगभग 58.25% है, मैक्रो F1 स्कोर लगभग 0.42 है, और मॉडल ने 33 अमान्य भविष्यवाणियाँ दीं, यानी कभी-कभी अपेक्षित लेबल सेट के बाहर कुछ लौटाया।
{'accuracy': 0.5825,
 'macro_f1': 0.42112912841373906,
 'invalid_predictions': 33,
 'evaluated_examples': 400}
अगले चरण में, हम प्रत्येक इमोशन श्रेणी के लिए पूरी क्लासिफिकेशन रिपोर्ट देख सकते हैं।
pd.DataFrame(pre_report).transpose()यह हमें प्रत्येक क्लास के लिए precision, recall, F1 स्कोर, और support देता है। इससे हमें पता चलता है कि फाइन-ट्यूनिंग से पहले मॉडल किन भावनाओं को अच्छी तरह संभालता है और किन्हें अधिक कठिन पाता है।
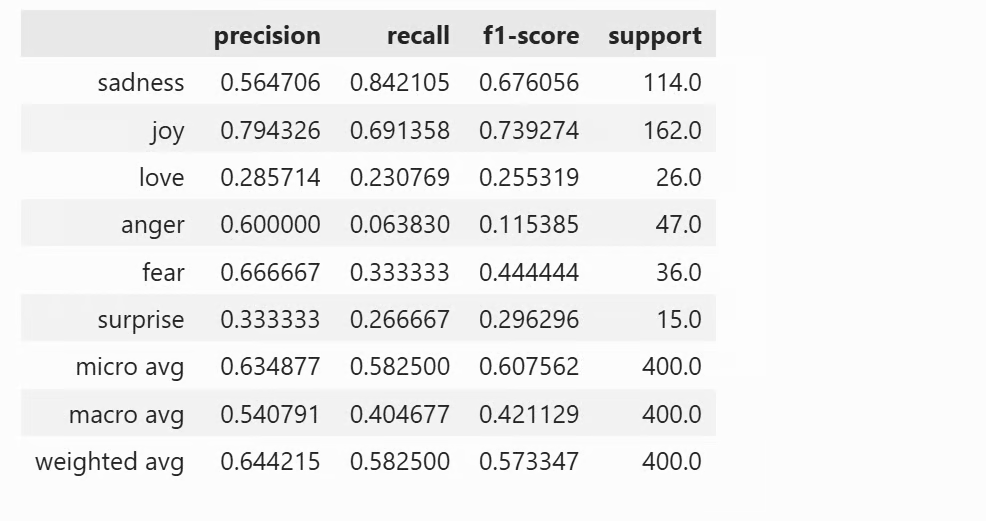
अंत में, हम कन्फ्यूजन मैट्रिक्स का निरीक्षण कर सकते हैं।
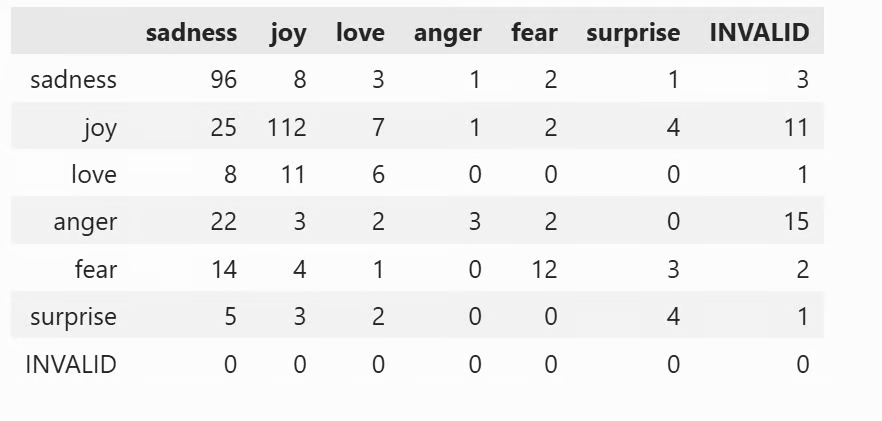
confusion_matrix_df(pre_preds)कन्फ्यूजन मैट्रिक्स दिखाता है कि विभिन्न क्लासेस में भविष्यवाणियाँ कैसे वितरित हुई हैं।
नोटबुक में, यह एक टेबल के रूप में प्रदर्शित होता है, जिससे यह देखना आसान हो जाता है कि किन भावनाओं में आपस में भ्रम हो रहा है और बेस मॉडल कहाँ सबसे अधिक संघर्ष करता है।
अब जब हमारे पास बेसलाइन परिणाम हैं, तो हम LoRA का उपयोग करके Gemma 4 को फाइन-ट्यून कर सकते हैं।
LoRA एक parameter-efficient फाइन-ट्यूनिंग विधि है, यानी हम पूरे मॉडल को अपडेट नहीं करते। इसके बजाय, हम बेस मॉडल के ऊपर कम संख्या में trainable एडेप्टर वेट्स जोड़ते हैं। इससे ट्रेनिंग काफी हल्की हो जाती है और एकल GPU पर व्यावहारिक रहती है।
हम LoRA कॉन्फ़िगरेशन परिभाषित करने से शुरू करते हैं।
ये सेटिंग्स नियंत्रित करती हैं कि LoRA एडेप्टर्स मॉडल पर कैसे लगाए जाएँ। यहाँ, हम रैंक 16, dropout 0.05 का उपयोग करते हैं, और LoRA को सभी linear लेयर्स पर लागू करते हैं, जो कुशल फाइन-ट्यूनिंग के लिए एक सामान्य सेटअप है।
from peft import LoraConfig

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear"
)
अगला, हम ट्रेनिंग कॉन्फ़िगरेशन परिभाषित करते हैं और ट्रेनर सेटअप करते हैं।
यह ट्रेनिंग सेटअप मेमोरी उपयोग को नियंत्रित रखने के लिए बनाया गया है, साथ ही मॉडल को डेटासेट से सीखने के लिए पर्याप्त गुंजाइश देता है। हम एक epoch के लिए ट्रेन करते हैं, बड़े बैच आकार का आभास देने के लिए gradient accumulation का उपयोग करते हैं, और ट्रेनिंग को अधिक कुशल बनाने के लिए gradient checkpointing और 8-बिट ऑप्टिमाइज़ेशन जैसी विकल्प सक्षम करते हैं।
from trl import SFTConfig, SFTTrainer

training_args = SFTConfig(
    output_dir="./gemma4-emotion-lora",
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=1e-4,
    weight_decay=0.01,
    lr_scheduler_type="linear",
    warmup_steps=50,
    num_train_epochs=1,
    logging_steps=50,
    eval_strategy="steps",
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    gradient_checkpointing=True,
    bf16=True,
    fp16=False,
    tf32=True,
    max_length=256,
    packing=False,
    completion_only_loss=True,
    remove_unused_columns=False,
    dataloader_num_workers=2,
    optim="paged_adamw_8bit",
    report_to="none",
)
अब हम सुनिश्चित करते हैं कि बेस मॉडल तैयार है और ट्रेनर इनिशियलाइज़ करते हैं। यह चरण बेस मॉडल पर LoRA एडेप्टर्स लगाता है और हमारे फ़ॉर्मैट किए गए ट्रेनिंग और वैलिडेशन स्प्लिट्स का उपयोग करते हुए सुपरवाइज़्ड फाइन-ट्यूनिंग ट्रेनर तैयार करता है।
from peft import PeftModel

if isinstance(base_model, PeftModel):
    base_model = base_model.unload()
    base_model.config.use_cache = False

trainer = SFTTrainer(
    model=base_model,
    train_dataset=sft_dataset["train"],
    eval_dataset=sft_dataset["validation"],
    peft_config=lora_config,
    args=training_args,
    processing_class=processor,
)
ट्रेनिंग शुरू करने से पहले, यह पुष्टि करना अच्छा रहता है कि LoRA पैरामीटर्स सही तरह से जुड़े हैं।
यह trainable पैरामीटर्स की संख्या गिनता है और यदि कोई LoRA लेयर नहीं जोड़ी गई है तो त्रुटि उठाता है।
इसके बाद, ट्रेनिंग शुरू होती है।
trainable_params = 0
for param in trainer.model.parameters():
    if param.requires_grad:
        trainable_params += param.numel()

if trainable_params == 0:
    raise RuntimeError("No trainable LoRA parameters were attached. Check target_modules before training.")

print(f"Trainable LoRA parameters: {trainable_params:,}")
train_result = trainer.train()
trainer.model.eval()
trainer.model.config.use_cache = True
train_result
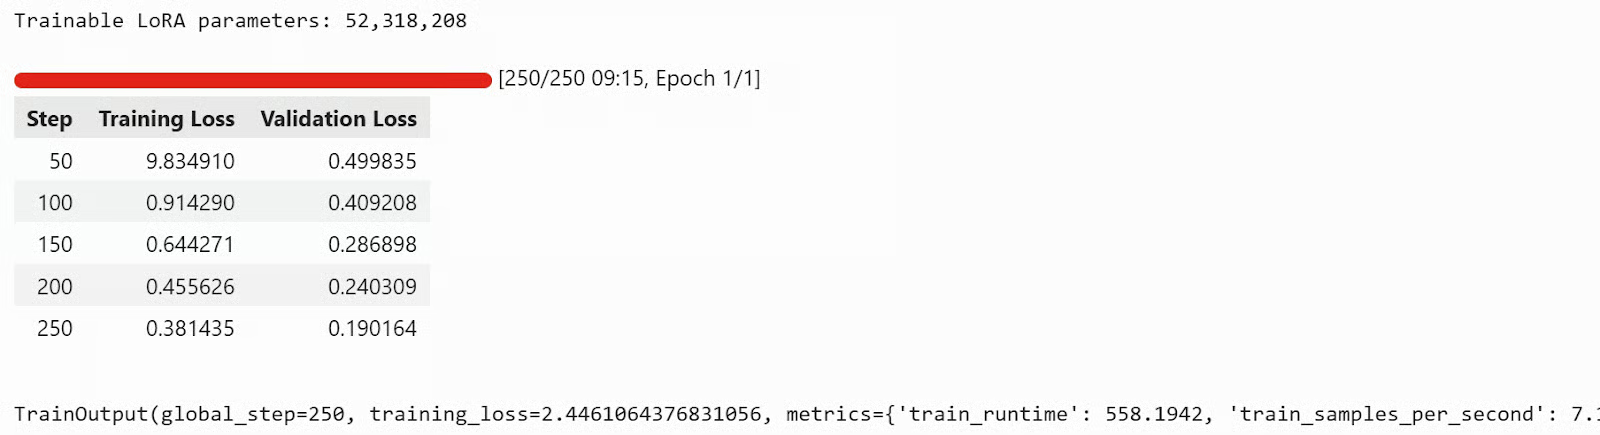
इस रन में, ट्रेनिंग में लगभग 9 मिनट लगे, और समय के साथ ट्रेनिंग लॉस और वैलिडेशन लॉस दोनों कम होते गए, जो इस बात का अच्छा संकेत है कि मॉडल डेटासेट से सीख रहा था।
ट्रेनिंग पूर्ण होने पर, हम एडेप्टर और टोकनाइज़र को लोकल सेव कर सकते हैं।
trainer.model.save_pretrained("./gemma4-emotion-lora")
processor.save_pretrained("./gemma4-emotion-lora")
अंत में, हम मॉडल को Hugging Face Hub पर पुश कर सकते हैं।
यह फाइन-ट्यून किए गए एडेप्टर और टोकनाइज़र को Hub पर अपलोड करता है ताकि आप उन्हें कहीं से भी एक्सेस कर सकें, दूसरों के साथ साझा कर सकें, या सीधे किसी अन्य नोटबुक या एप्लिकेशन में लोड कर सकें।
repo_id = "kingabzpro/gemma4-emotion-lora"

# Push adapter + processor to the Hub
trainer.model.push_to_hub(
    repo_id,
    private=False,
)

processor.push_to_hub(
    repo_id,
    private=False,
)
अब आप Hugging Face पर kingabzpro/gemma4-emotion-lora देख सकते हैं और स्वयं आज़मा सकते हैं। रिपॉजिटरी में मॉडल फ़ाइलें, उपयोग निर्देश, और फाइन-ट्यूनिंग परिणाम शामिल हैं।
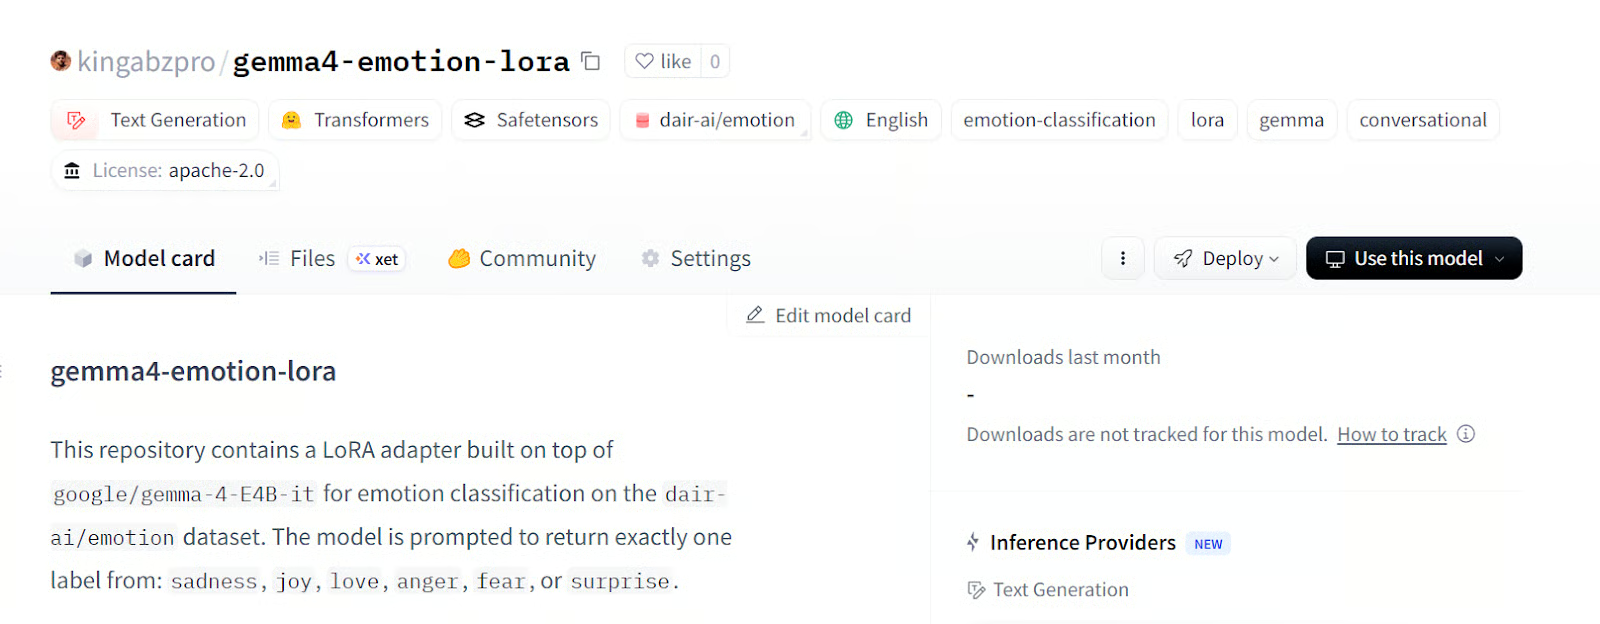
स्रोत: kingabzpro/gemma4-emotion-lora · Hugging Face
अब जब ट्रेनिंग पूर्ण हो गई है, अंतिम चरण है उसी टेस्ट स्प्लिट पर फाइन-ट्यून किए गए मॉडल का मूल्यांकन करना और परिणामों की तुलना बेस मॉडल से करना। इससे पता चलता है कि LoRA फाइन-ट्यूनिंग ने भावनाओं को अधिक सटीकता से वर्गीकृत करने की मॉडल की क्षमता में सुधार किया या नहीं।
हम ट्रेनर से फाइन-ट्यून किया मॉडल लोड करके और मूल्यांकन चलाकर शुरू करते हैं।
ft_model = trainer.model
ft_model.eval()
ft_model.config.use_cache = True
post_metrics, post_report, post_preds = evaluate_model(ft_model, processor, "test")
post_metrics
यह हमें फाइन-ट्यून किए गए मॉडल के मुख्य मूल्यांकन मेट्रिक्स देता है।
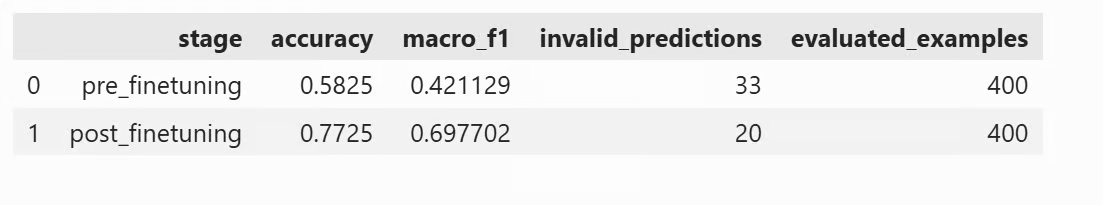
ये परिणाम बेसलाइन से स्पष्ट रूप से बेहतर हैं। फाइन-ट्यूनिंग के बाद, मॉडल 77.25% एक्यूरेसी और 0.698 का मैक्रो F1 स्कोर प्राप्त करता है। अमान्य भविष्यवाणियों की संख्या भी 33 से घटकर 20 रह जाती है, जो दिखाता है कि फाइन-ट्यून किया मॉडल न केवल अधिक सटीक है, बल्कि वैध लेबल लौटाने में अधिक सुसंगत भी है।
{'accuracy': 0.7725,
 'macro_f1': 0.697702361480462,
 'invalid_predictions': 20,
 'evaluated_examples': 400}
अगला, हम पूरी क्लासिफिकेशन रिपोर्ट देख सकते हैं।
यह नोटबुक में सीधे एक pandas DataFrame के रूप में क्लासिफिकेशन रिपोर्ट प्रदर्शित करता है। इसमें प्रत्येक इमोशन क्लास के लिए precision, recall, F1 स्कोर, और support शामिल हैं, जिससे देखना आसान हो जाता है कि फाइन-ट्यूनिंग के बाद किन श्रेणियों में सबसे अधिक सुधार हुआ।
pd.DataFrame(post_report).transpose()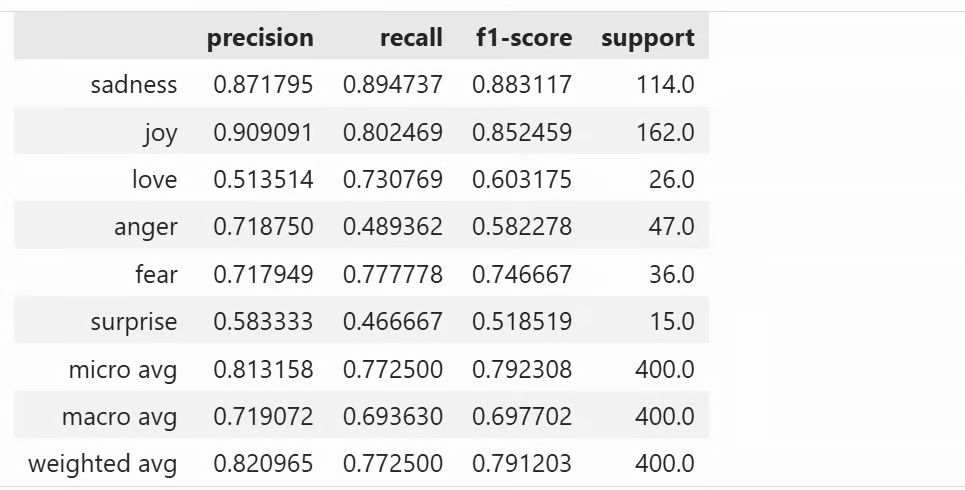
यह भी नोटबुक में एक टेबल के रूप में प्रदर्शित होता है। यह आपको यह देखने में मदद करता है कि फाइन-ट्यून किया मॉडल अभी कहाँ गलतियाँ कर रहा है और कौन सी इमोशन श्रेणियाँ अक्सर एक-दूसरे के साथ भ्रमित होती हैं।
confusion_matrix_df(post_preds)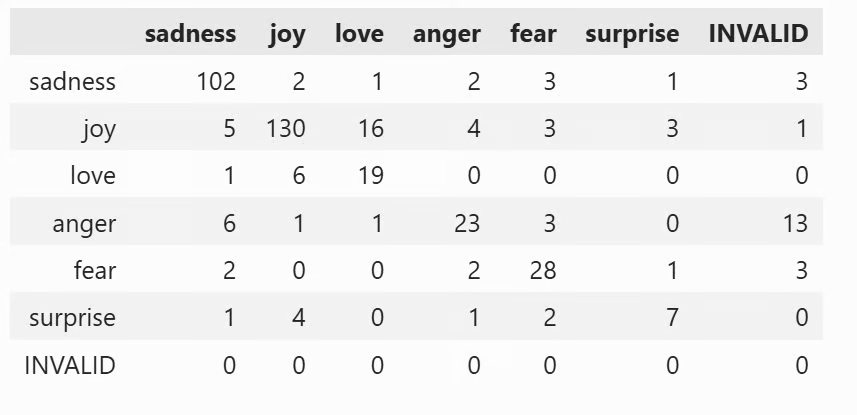
तुलना को और स्पष्ट करने के लिए, हम फाइन-ट्यूनिंग से पहले और बाद के मेट्रिक्स को साथ-साथ रख सकते हैं।
comparison_df = pd.DataFrame([
    {"stage": "pre_finetuning", **pre_metrics},
    {"stage": "post_finetuning", **post_metrics},
])
comparison_df
यह बताता है कि ट्रेनिंग के बाद मॉडल में कितना सुधार हुआ।
नोट: यदि आपको कोड चलाते समय कोई समस्या आती है, तो आप पूरा Jupyter नोटबुक यहाँ देख सकते हैं: fine-tune-gemma-4-on-emotions_final.ipynb
Gemma 4 को फाइन-ट्यून करना सेटअप के प्रति बहुत संवेदनशील है, खासकर प्रॉम्प्ट संरचना और ट्रेनिंग आर्गुमेंट्स के संदर्भ में। यदि प्रॉम्प्ट फ़ॉर्मैट गलत है, या आप उपयुक्त टेम्पलेट का लगातार उपयोग नहीं करते, तो मॉडल ट्रेनिंग से गुज़र सकता है लेकिन वास्तव में कार्य नहीं सीख पाता। यही बात ट्रेनिंग सेटिंग्स पर भी लागू होती है। प्रायः यही मुख्य कारण होते हैं कि लॉस कम नहीं होता, या लॉस कम होने के बावजूद मूल्यांकन परिणाम मुश्किल से सुधरते हैं।
एक और महत्वपूर्ण सीख max_length है। यदि आप इसे बहुत कम कर देते हैं, खासकर लगभग 125 से नीचे, तो मॉडल संभवतः पैटर्न को ठीक से सीख ही नहीं पाएगा। मुझे इस प्रक्रिया के दौरान कई समस्याएँ आईं, लेकिन वे एक-एक करके सुलझ गईं, और अधिकांश का संबंध इन्हीं दो क्षेत्रों से था: प्रॉम्प्ट फ़ॉर्मैटिंग और ट्रेनिंग कॉन्फ़िगरेशन।
परिणामों को और बेहतर बनाने के लिए, अगला अच्छा कदम पूर्ण डेटासेट पर फाइन-ट्यून करना और केवल एक के बजाय कम से कम 3 epochs के लिए ट्रेन करना होगा। इससे मॉडल के पास सीखने के लिए अधिक उदाहरण होंगे और अनुकूलन के लिए अधिक समय मिलेगा, जो बेहतर एक्यूरेसी और F1 स्कोर्स की ओर ले जाना चाहिए।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स