Kurs
Python ile LLM'lere Giriş
3 sa
36.6K
Google, güçlü akıl yürütme ve özdevinimli iş akışları için tasarlanan en zeki açık model ailesi olarak tanımladığı Gemma 4’ü yeni tanıttı. Gemma modelleri; yerel geliştirme, buluta dağıtım ve model özelleştirme için resmi destek ve araçlarla, ortamlar arasında esnek olacak şekilde tasarlanmıştır. Bu da onları ince ayar projeleri için güçlü bir seçenek yapar.
Bu öğreticide, Gemma 4 E4B-it’i Hugging Face’ten bir insan duygusu sınıflandırma veri kümesi üzerinde ince ayar yapacağız. 3090 GPU ortamı kuracak, veri kümesini yükleyip inceleyecek, veriyi denetimli ince ayar için hazırlayıp biçimlendirecek, temel modeli yükleyecek, eğitime başlamadan önce temel değerlendirme yapacak, modeli ince ayar yapacak ve ardından eğitim sonrası performansını tekrar ölçeceğiz.
Yeni bir Runpod örneği başlatarak başlayın ve hesabınızda en az 5 ABD doları kredi bulunduğundan emin olun. Bu öğretici için bir 3090 GPU pod seçin ve en güncel PyTorch şablonunu tercih edin.
Dağıtmadan önce, şablon ayarlarını açın ve birkaç güncelleme yapın. Hem konteyner diskini hem de hacim diskini 40 GB’a çıkarın; model, veri kümesi, önbellek ve eğitim kontrol noktaları için yeterli alanınız olsun.
Ayrıca Hugging Face token’ınızı bir ortam değişkeni olarak eklemelisiniz. Bu token’ı Hugging Face hesabınızda Settings > Access Tokens bölümünden oluşturabilirsiniz.
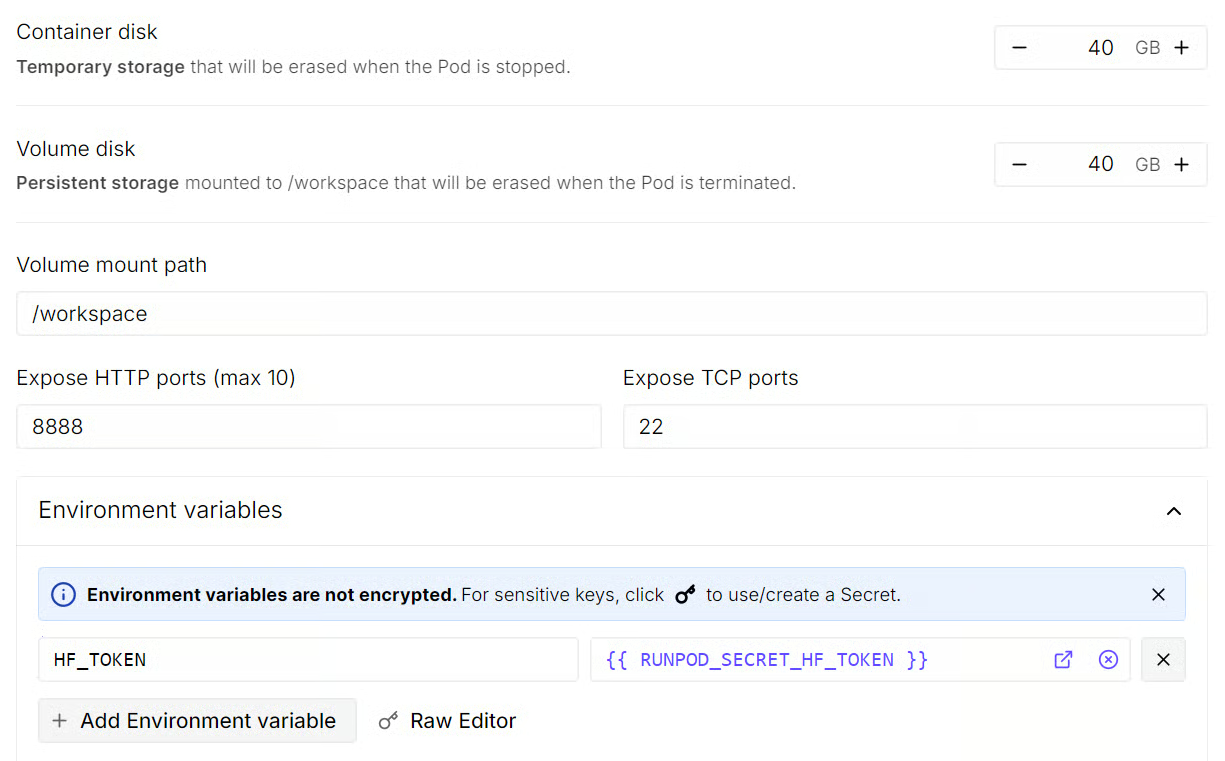
Bu ayarlar yapıldıktan sonra pod’u dağıtın. Örneğin başlaması bir iki dakika sürebilir. Hazır olduğunda JupyterLab arayüzünü açarak ortamda çalışmaya başlayın.
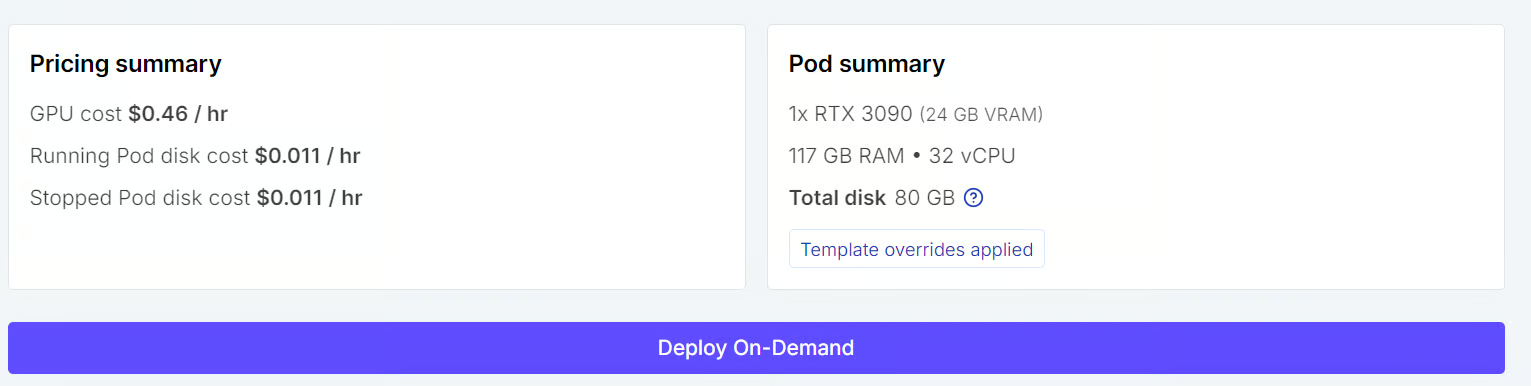
JupyterLab’de yapılacak ilk şey, yeni bir Python defteri başlatmak ve gerekli tüm Python paketlerini kurmaktır. Aşağıdaki komutu bir hücrede çalıştırın:
%%capture
!pip install -U transformers accelerate datasets trl peft bitsandbytes scikit-learn huggingface_hub
Bu paketler, veri kümesini yükleme, modeli hazırlama, ince ayar ve değerlendirme dahil tüm iş akışını kapsar.
Son adım, kaydedilmiş token’ınızı kullanarak Hugging Face Hub’a oturum açmaktır. Bu, kısıtlı modele erişim sağlar ve dosya yüklemeyi, depo oluşturmayı ve daha sonra ince ayarlı modeli göndermeyi kolaylaştırır.
import os
from huggingface_hub import login

hf_token = os.environ.get("HF_TOKEN")
if not hf_token:
    raise ValueError("Set HF_TOKEN in the RunPod environment before running this notebook.")

login(token=hf_token)
print("Logged in to Hugging Face.")Ortam hazır olduğuna göre, bir sonraki adım Hugging Face’ten duygu veri kümesini yüklemek ve eğitim ile değerlendirme için daha küçük bölümler hazırlamaktır.
Bu öğreticide tam veri kümesini kullanmıyoruz. Bunun yerine, ince ayarın tek bir GPU’da daha hızlı ve kolay çalışması için sınırlı eğitim, doğrulama ve test bölümleri oluşturuyoruz.
from datasets import load_dataset, DatasetDict

TRAIN_LIMIT = 4000
VALIDATION_LIMIT = 400
TEST_LIMIT = 400
EVAL_LIMIT = 400

raw_dataset = load_dataset("dair-ai/emotion")

def maybe_limit(split, limit):
    split = split.shuffle(seed=42)
    if limit is None:
        return split
    return split.select(range(min(limit, len(split))))

dataset = DatasetDict({
    "train": maybe_limit(raw_dataset["train"], TRAIN_LIMIT),
    "validation": maybe_limit(raw_dataset["validation"], VALIDATION_LIMIT),
    "test": maybe_limit(raw_dataset["test"], TEST_LIMIT),
})

dataset
Nihai veri kümesi 4.000 eğitim örneği, 400 doğrulama örneği ve 400 test örneği içerir.
DatasetDict({
    train: Dataset({
        features: ['text', 'label'],
        num_rows: 4000
    })
    validation: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
    test: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
})
Sonra, veri kümesinde saklanan etiket adlarına bakıyoruz. Bunlar, modelin tahmin etmeyi öğreneceği duygu sınıflarıdır.
label_names = dataset["train"].features["label"].names
label_names
Bu, görevin altı duygu kategorisine sahip olduğunu gösterir: sadness, joy, love, anger, fear ve surprise.
['sadness', 'joy', 'love', 'anger', 'fear', 'surprise']Ayrıca, verinin nasıl yapılandırıldığını görmek için eğitim bölümünden bir örneği de inceleyebiliriz.
dataset["train"][0]Her örnek bir metin parçası ve sayısal bir etiket içerir. Bu durumda, 4 etiketi yukarıdaki listeye göre fear ile eşleşir.
{'text': 'while cycling in the country', 'label': 4}Modeli ince ayar yapmadan önce, veri kümesini Gemma 4’ün eğitim sırasında kullanacağı biçime dönüştürmemiz gerekir.
Yalnızca ham metin ve etiketleri geçirmek yerine, her örneği kısa bir sohbet etkileşimi olarak yapılandırıyoruz: bir sistem mesajı, bir kullanıcı mesajı ve beklenen asistan yanıtı.
Sistem istemi, modelin tam olarak hangi görevi yapacağını söyler. Bu durumda, modelin bir duygu sınıflandırma asistanı gibi davranmasını ve yalnızca altı izinli etiketten birini döndürmesini istiyoruz.
SYSTEM_PROMPT = """You are an emotion classification assistant.
Read the user's text and answer with exactly one label.
Only choose from: sadness, joy, love, anger, fear, surprise.
Return only the label and nothing else."""
Bu kurulumda, kullanıcı mesajı sınıflandırmak istediğimiz girdi metnini içerir ve asistan mesajı doğru etiketi içerir. Bu, denetimli ince ayar için kullanılan biçimdir; model her eğitim örneği için doğru yanıtı üretmeyi öğrenir.
def to_prompt_completion(example):
    text = example["text"]
    label = label_names[example["label"]]
    return {
        "prompt": [
            {
                "role": "system",
                "content": SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": f"Classify the emotion of this text:\n\n{text}",
            },
        ],
        "completion": [
            {
                "role": "assistant",
                "content": label,
            }
        ],
    }

sft_dataset = dataset.map(to_prompt_completion, remove_columns=dataset["train"].column_names)
Bu biçimlendirme işlevini uyguladıktan sonra, özgün text ve label sütunları yapısal prompt ve completion alanlarıyla değiştirilir.
Veri kümesinin doğru biçimlendiğini doğrulamak için bir örneği inceleyebiliriz.
sft_dataset["train"][0]Çıktı, tam eğitim yapısını net şekilde gösterir. Model yönergeyi görür, girdi metnini okur ve yanıt olarak doğru duygu etiketini üretmeyi öğrenir.
{'prompt': [{'content': "You are an emotion classification assistant.\nRead the user's text and answer with exactly one label.\nOnly choose from: sadness, joy, love, anger, fear, surprise.\nReturn only the label and nothing else.",
   'role': 'system'},
  {'content': 'Classify the emotion of this text:\n\nwhile cycling in the country',
   'role': 'user'}],
'completion': [{'content': 'fear', 'role': 'assistant'}]}Artık Gemma 4 E4B-it’i yükleyip ince ayara hazırlayabiliriz. Göreli olarak büyük bir model olduğundan, 4-bit kuantizasyon ile yükleyerek bellek kullanımını azaltıyoruz; böylece 3090 GPU’da çalıştırmak kolaylaşıyor. Ayrıca hesaplama türü olarak bfloat16 kullanıyoruz; bu da kurulumu verimli tutmaya yardımcı olur.
Gerekli kütüphaneleri içe aktararak ve temel model ayarlarını tanımlayarak başlıyoruz.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "google/gemma-4-E4B-it"
MODEL_DTYPE = torch.bfloat16
USE_4BIT = True
Ardından birkaç CUDA optimizasyonunu etkinleştirip tokenizer’ı yüklüyoruz.
if torch.cuda.is_available():
    torch.backends.cuda.matmul.allow_tf32 = True
    torch.backends.cudnn.allow_tf32 = True

processor = AutoTokenizer.from_pretrained(MODEL_ID, use_fast=True)
if processor.pad_token is None:
    processor.pad_token = processor.eos_token
Şimdi kuantizasyon ayarlarını ve model yükleme argümanlarını hazırlıyoruz.
bnb_config = None
model_kwargs = {
    "device_map": "auto",
}
if USE_4BIT:
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=MODEL_DTYPE,
    )
    model_kwargs["quantization_config"] = bnb_config
else:
    model_kwargs["torch_dtype"] = MODEL_DTYPE
Son olarak modeli yüklüyor ve yapılandırmasını tokenizer ile hizalıyoruz.
base_model = AutoModelForCausalLM.from_pretrained(MODEL_ID, **model_kwargs)
base_model.config.use_cache = False
base_model.config.pad_token_id = processor.pad_token_id
base_model.config.bos_token_id = processor.bos_token_id
base_model.config.eos_token_id = processor.eos_token_id
base_model.generation_config.pad_token_id = processor.pad_token_id
base_model.generation_config.bos_token_id = processor.bos_token_id
base_model.generation_config.eos_token_id = processor.eos_token_id

print(f"Base model loaded with 4-bit={USE_4BIT} and dtype={MODEL_DTYPE}.")
Bu, temel modeli uygun cihaza yükler, eğitim için önbelleği devre dışı bırakır ve özel token ID’lerinin hem model yapılandırmasında hem de üretim yapılandırmasında doğru ayarlandığından emin olur.
Base model loaded with 4-bit=True and dtype=torch.bfloat16.İnce ayardan önce, daha sonra karşılaştırma yapmak için net bir temel oluşturmak amacıyla önce temel modeli değerlendirmek faydalıdır.
Bu bölümde, tahminler üreten, geçerli duygu etiketlerini çıkaran ve test bölümünde değerlendirme yapan birkaç yardımcı işlev tanımlıyoruz.
Basit bir etiket çıkarma deseni ve tahmin için yardımcı işlevler oluşturarak başlıyoruz.
Bu işlevler tüm tahmin akışını yönetir. Model girişi sohbet biçiminde alır, kısa bir yanıt üretir ve ardından tahmin edilen etiketi çıkarırız. Model fazladan metin döndürürse, yardımcı işlev ilk geçerli duygu etiketini kurtarmaya çalışır.
import re

LABEL_PATTERN = re.compile(r"\b(sadness|joy|love|anger|fear|surprise)\b", re.IGNORECASE)

def extract_label(raw_text: str) -> str:
    raw_text = raw_text.strip().lower()
    match = LABEL_PATTERN.search(raw_text)
    if match:
        return match.group(1)

    first_token = raw_text.split()[0].strip(".,!?:;\"'()[]{}") if raw_text.split() else ""
    return first_token

def generate_label(model, processor, user_text, system_prompt, max_new_tokens=4):
    messages = [
        {
            "role": "system",
            "content": system_prompt,
        },
        {
            "role": "user",
            "content": f"Classify the emotion of this text:\n\n{user_text}",
        },
    ]

    device = next(model.parameters()).device
    inputs = processor.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    ).to(device)

    input_len = inputs["input_ids"].shape[-1]

    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            do_sample=False,
            pad_token_id=processor.pad_token_id,
            eos_token_id=processor.eos_token_id,
        )

    raw_pred = processor.decode(outputs[0][input_len:], skip_special_tokens=True).strip()
    return extract_label(raw_pred)


def predict_emotion(user_text: str, model=None, proc=None) -> str:
    model = model or base_model
    proc = proc or processor
    return generate_label(model, proc, user_text, SYSTEM_PROMPT)
Tam değerlendirmeyi çalıştırmadan önce kurulumu tek bir örnek üzerinde test edebiliriz.
predict_emotion("I feel so happy and excited today!")Örnek tahmin doğru görünüyor; bu nedenle modeli test bölümü genelinde değerlendirmeye geçebiliriz.
'joy'Bu kod, modeli test bölümünde değerlendirir ve çeşitli çıktılar toplar. Gerçek ve tahmin edilen etiketleri depolar, her tahminin doğru olup olmadığını izler; özet metrikler, bir sınıflandırma raporu ve tüm tahminlerin yer aldığı bir veri çerçevesi döndürür.
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix, f1_score
import pandas as pd
from tqdm.auto import tqdm

VALID_LABELS = set(label_names)
ALL_EVAL_LABELS = label_names + ["INVALID"]

def evaluate_model(model, processor, split="test", limit=EVAL_LIMIT):
    y_true, y_pred, rows = [], [], []
    raw_source = dataset[split]
    if limit is not None:
        raw_source = raw_source.select(range(min(limit, len(raw_source))))

    model.eval()

    for ex in tqdm(raw_source, desc=f"Evaluating {split}", leave=False):
        true_label = label_names[ex["label"]]
        raw_pred_label = generate_label(model, processor, ex["text"], SYSTEM_PROMPT)
        pred_label = raw_pred_label if raw_pred_label in VALID_LABELS else "INVALID"

        y_true.append(true_label)
        y_pred.append(pred_label)
        rows.append({
            "text": ex["text"],
            "true_label": true_label,
            "pred_label": pred_label,
            "raw_pred_label": raw_pred_label,
            "correct": true_label == pred_label,
        })

    metrics = {
        "accuracy": accuracy_score(y_true, y_pred),
        "macro_f1": f1_score(y_true, y_pred, labels=label_names, average="macro", zero_division=0),
        "invalid_predictions": sum(1 for p in y_pred if p == "INVALID"),
        "evaluated_examples": len(y_true),
    }

    report = classification_report(
        y_true,
        y_pred,
        labels=label_names,
        output_dict=True,
        zero_division=0,
    )

    df = pd.DataFrame(rows)
    return metrics, report, df

def confusion_matrix_df(pred_df):
    return pd.DataFrame(
        confusion_matrix(pred_df["true_label"], pred_df["pred_label"], labels=ALL_EVAL_LABELS),
        index=ALL_EVAL_LABELS,
        columns=ALL_EVAL_LABELS,
    )
Şimdi temel model üzerinde tam temel değerlendirmeyi çalıştırabiliriz.
pre_metrics, pre_report, pre_preds = evaluate_model(base_model, processor, "test")
pre_metrics
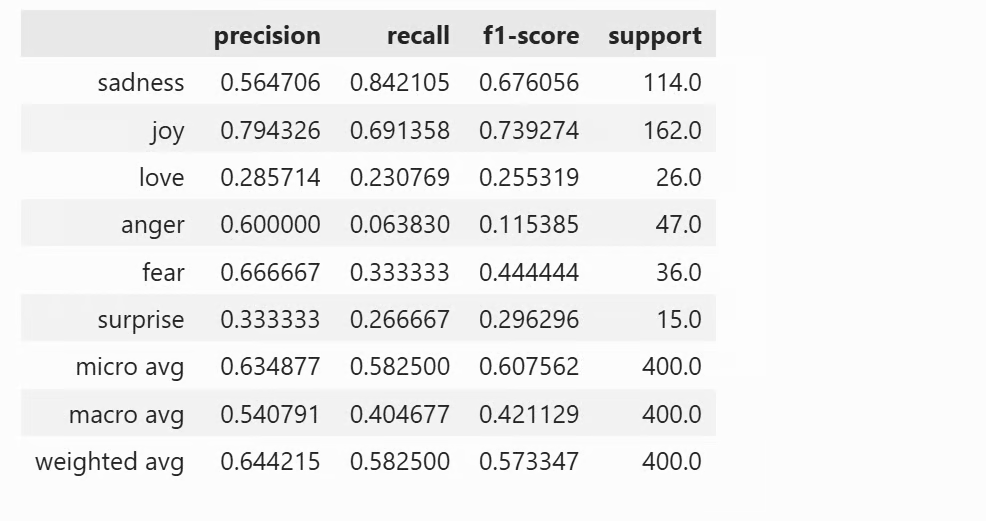
Bu temel sonuçlar, eğitimsiz modelin halihazırda fena olmayan bir performans sergilediğini, ancak hâlâ iyileştirme payı olduğunu gösteriyor.
Doğruluk yaklaşık %58,25, makro F1 skoru yaklaşık 0,42 ve model 33 geçersiz tahmin üretti; yani zaman zaman beklenen etiket kümesi dışındaki yanıtlar döndürdü.
{'accuracy': 0.5825,
 'macro_f1': 0.42112912841373906,
 'invalid_predictions': 33,
 'evaluated_examples': 400}
Sonraki adımda, her duygu kategorisi için tam sınıflandırma raporuna bakabiliriz.
pd.DataFrame(pre_report).transpose()Bu, her sınıf için kesinlik (precision), duyarlılık (recall), F1 skoru ve destek (support) değerlerini verir. İnce ayardan önce modelin hangi duygularda iyi, hangilerinde daha zorlandığını görmemize yardımcı olur.
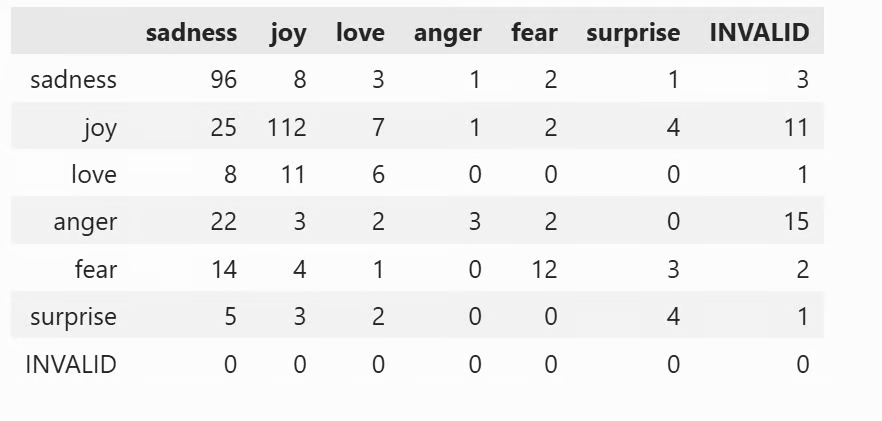
Son olarak karmaşıklık (confusion) matrisini inceleyebiliriz.
confusion_matrix_df(pre_preds)Karmaşıklık matrisi, tahminlerin farklı sınıflara nasıl dağıldığını gösterir.
Not defterinde bu tablo olarak görüntülenir; böylece hangi duyguların birbirine karıştırıldığını ve temel modelin en çok nerede zorlandığını saptamak kolaylaşır.
Artık temel sonuçlara sahip olduğumuza göre, Gemma 4’ü LoRA kullanarak ince ayar yapabiliriz.
LoRA, parametre-verimli bir ince ayar yöntemidir; yani tüm modeli güncellemeyiz. Bunun yerine, temel modelin üzerine az sayıda eğitilebilir adaptör ağırlıkları ekleriz. Bu, eğitimi çok daha hafif hale getirir ve tek bir GPU’da pratik yapmayı sağlar.
LoRA yapılandırmasını tanımlayarak başlıyoruz.
Bu ayarlar, LoRA adaptörlerinin modele nasıl ekleneceğini kontrol eder. Burada rank=16, dropout=0,05 kullanıyoruz ve LoRA’yı tüm doğrusal katmanlara uyguluyoruz; bu, verimli ince ayar için yaygın bir kurulumdur.
from peft import LoraConfig

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear"
)
Sonra, eğitim yapılandırmasını tanımlıyor ve eğiticiyi kuruyoruz.
Bu eğitim düzeni, belleği yönetilebilir tutacak şekilde tasarlanmıştır; modelin veri kümesinden öğrenmesi için yeterli alan bırakır. Bir dönem (epoch) eğitiyoruz, daha büyük bir yığın boyutunu simüle etmek için gradyan biriktirme kullanıyoruz ve eğitimi daha verimli kılmak için gradyan kontrol noktası alma ve 8-bit optimizasyon gibi seçenekleri etkinleştiriyoruz.
from trl import SFTConfig, SFTTrainer

training_args = SFTConfig(
    output_dir="./gemma4-emotion-lora",
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=1e-4,
    weight_decay=0.01,
    lr_scheduler_type="linear",
    warmup_steps=50,
    num_train_epochs=1,
    logging_steps=50,
    eval_strategy="steps",
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    gradient_checkpointing=True,
    bf16=True,
    fp16=False,
    tf32=True,
    max_length=256,
    packing=False,
    completion_only_loss=True,
    remove_unused_columns=False,
    dataloader_num_workers=2,
    optim="paged_adamw_8bit",
    report_to="none",
)
Şimdi temel modelin hazır olduğundan emin oluyor ve eğiticiyi başlatıyoruz. Bu adım, LoRA adaptörlerini temel modele ekler ve biçimlendirilmiş eğitim ve doğrulama bölümlerimizi kullanarak denetimli ince ayar eğiticisini hazırlar.
from peft import PeftModel

if isinstance(base_model, PeftModel):
    base_model = base_model.unload()
    base_model.config.use_cache = False

trainer = SFTTrainer(
    model=base_model,
    train_dataset=sft_dataset["train"],
    eval_dataset=sft_dataset["validation"],
    peft_config=lora_config,
    args=training_args,
    processing_class=processor,
)
Eğitime başlamadan önce, LoRA parametrelerinin doğru şekilde eklendiğini doğrulamak iyi bir fikirdir.
Bu, eğitilebilir parametre sayısını sayar ve hiçbir LoRA katmanı eklenmediyse hata verir.
Ardından eğitim başlar.
trainable_params = 0
for param in trainer.model.parameters():
    if param.requires_grad:
        trainable_params += param.numel()

if trainable_params == 0:
    raise RuntimeError("No trainable LoRA parameters were attached. Check target_modules before training.")

print(f"Trainable LoRA parameters: {trainable_params:,}")
train_result = trainer.train()
trainer.model.eval()
trainer.model.config.use_cache = True
train_result
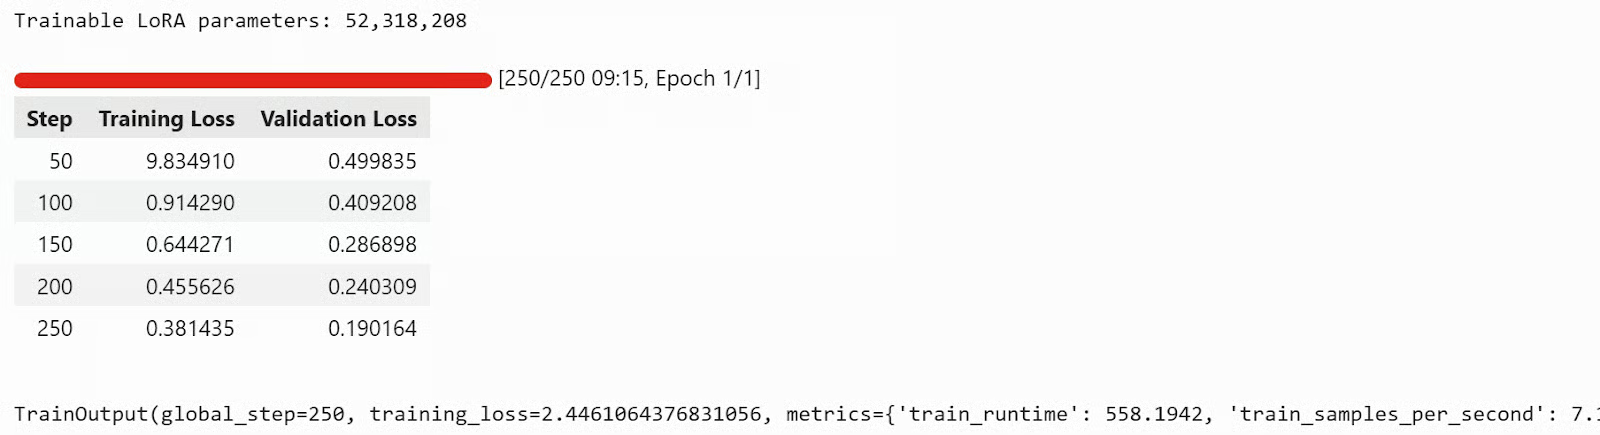
Bu çalıştırmada eğitim yaklaşık 9 dakika sürdü; eğitim kaybı ve doğrulama kaybı zamanla azaldı, bu da modelin veri kümesinden öğrendiğinin iyi bir göstergesidir.
Eğitim tamamlandığında, adaptörü ve tokenizer’ı yerel olarak kaydedebiliriz.
trainer.model.save_pretrained("./gemma4-emotion-lora")
processor.save_pretrained("./gemma4-emotion-lora")
Son olarak modeli Hugging Face Hub’a gönderebiliriz.
Bu işlem, ince ayarlı adaptörü ve tokenizer’ı Hub’a yükler; böylece onlara her yerden erişebilir, başkalarıyla paylaşabilir ya da doğrudan başka bir not defterine veya uygulamaya yükleyebilirsiniz.
repo_id = "kingabzpro/gemma4-emotion-lora"

# Push adapter + processor to the Hub
trainer.model.push_to_hub(
    repo_id,
    private=False,
)

processor.push_to_hub(
    repo_id,
    private=False,
)
Artık Hugging Face’te kingabzpro/gemma4-emotion-lora deposunu görüntüleyebilir ve kendiniz deneyebilirsiniz. Depo; model dosyalarını, kullanım talimatlarını ve ince ayar sonuçlarını içerir.
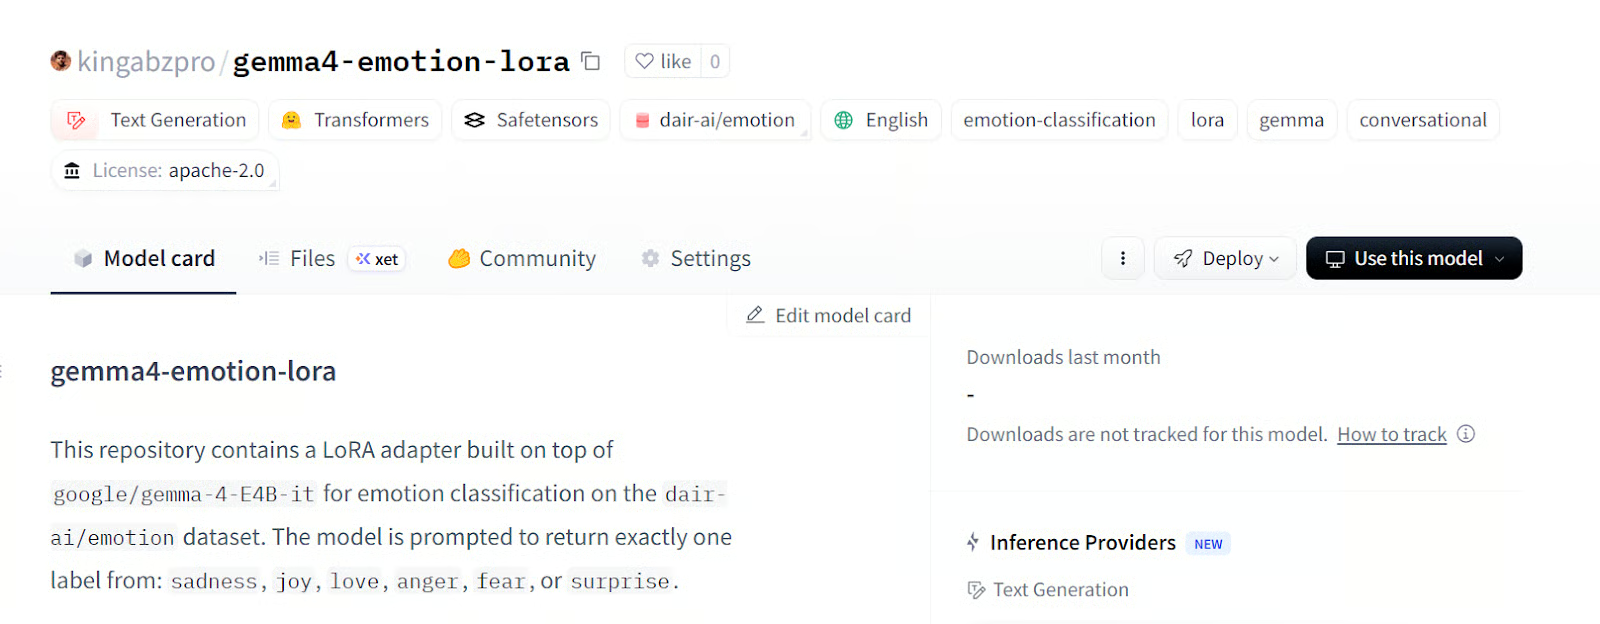
Kaynak: kingabzpro/gemma4-emotion-lora · Hugging Face
Eğitim tamamlandığına göre, son adım ince ayarlı modeli aynı test bölümünde değerlendirmek ve sonuçları temel modelle karşılaştırmaktır. Bu, LoRA ince ayarının modelin duyguları daha doğru sınıflandırma becerisini artırıp artırmadığını görmemize yardımcı olur.
Eğiticiden ince ayarlı modeli yükleyerek değerlendirmeyi çalıştırmakla başlıyoruz.
ft_model = trainer.model
ft_model.eval()
ft_model.config.use_cache = True
post_metrics, post_report, post_preds = evaluate_model(ft_model, processor, "test")
post_metrics
Bu, ince ayarlı model için temel değerlendirme metriklerini verir.
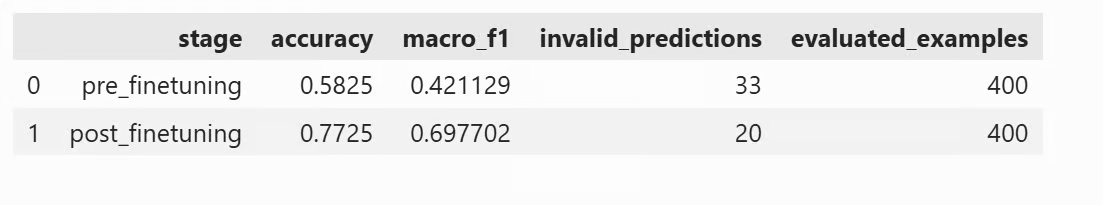
Bu sonuçlar temel skorlardan belirgin biçimde daha güçlü. İnce ayar sonrasında model %77,25 doğruluk ve 0,698 makro F1 skoru’na ulaşıyor. Geçersiz tahmin sayısı da 33’ten 20’ye düşüyor; bu da ince ayarlı modelin sadece daha doğru değil, aynı zamanda geçerli etiketler döndürme konusunda daha tutarlı olduğunu gösterir.
{'accuracy': 0.7725,
 'macro_f1': 0.697702361480462,
 'invalid_predictions': 20,
 'evaluated_examples': 400}
Sonraki adımda, tam sınıflandırma raporunu görüntüleyebiliriz.
Bu, sınıflandırma raporunu doğrudan not defterinde bir pandas DataFrame olarak gösterir. Her duygu sınıfı için kesinlik, duyarlılık, F1 skoru ve destek değerlerini içerir; böylece ince ayardan sonra en çok hangi kategorilerin iyileştiğini görmek kolaylaşır.
pd.DataFrame(post_report).transpose()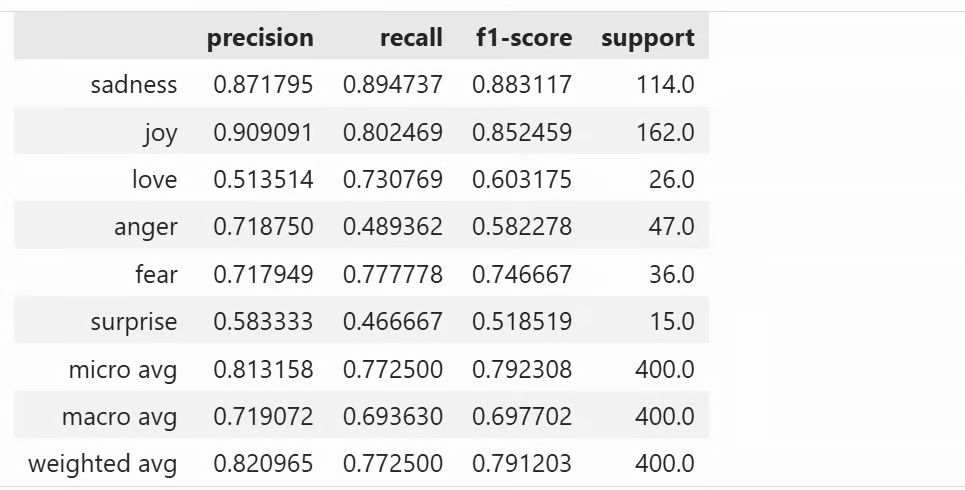
Bu da not defterinde tablo olarak görüntülenir. İnce ayarlı modelin hâlâ nerelerde hata yaptığını ve hangi duygu kategorilerinin en sık birbirine karıştırıldığını görmenize yardımcı olur.
confusion_matrix_df(post_preds)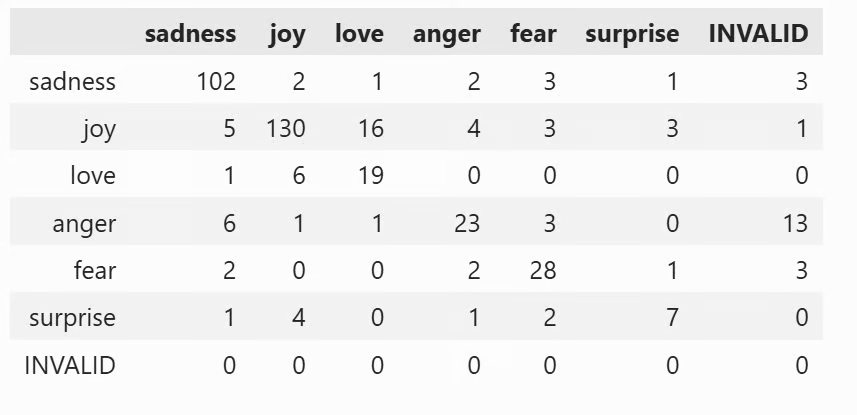
Karşılaştırmayı daha net kılmak için, ince ayar öncesi ve sonrası metrikleri yan yana koyabiliriz.
comparison_df = pd.DataFrame([
    {"stage": "pre_finetuning", **pre_metrics},
    {"stage": "post_finetuning", **post_metrics},
])
comparison_df
Bu, modelin eğitim sonrasında ne kadar iyileştiğine dair hızlı bir özet sunar.
Not: Kodu çalıştırırken herhangi bir sorun yaşarsanız, tam Jupyter not defterine buradan bakabilirsiniz: fine-tune-gemma-4-on-emotions_final.ipynb
Gemma 4’ün ince ayarı, özellikle istem yapısı ve eğitim argümanlarına karşı oldukça hassastır. İstem formatı yanlışsa veya uygun şablonu tutarlı biçimde kullanmazsanız, model eğitimi tamamlayıp yine de görevi iyi öğrenemeyebilir. Eğitim ayarları için de aynı durum geçerlidir. Genellikle kaybın düşmemesinin veya kayıp düşerken değerlendirme sonuçlarının zar zor iyileşmesinin başlıca nedenleri bunlardır.
Bir diğer önemli nokta max_length’tir. Bunu özellikle 125’in altına çok fazla düşürürseniz, model kalıbı hiç öğrenemeyebilir. Bu süreçte birkaç sorunla karşılaştım; ancak tek tek çözüldüler ve çoğu aynı iki noktaya dayanıyordu: istem biçimlendirme ve eğitim yapılandırması.
Sonuçları daha da iyileştirmek için iyi bir sonraki adım, tam veri kümesi üzerinde ince ayar yapmak ve yalnızca bir dönem yerine en az 3 dönem eğitmektir. Bu, modele öğrenmek için daha fazla örnek ve uyum sağlamak için daha fazla zaman vererek doğruluk ve F1 skorlarının güçlenmesine yardımcı olacaktır.
DataCamp ile öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme