
Khóa học
Nhập môn LLMs trong Python
3 giờ
36.6K
Google vừa giới thiệu Gemma 4, mô tả đây là dòng mô hình mở thông minh nhất của họ cho đến nay, được xây dựng cho khả năng suy luận mạnh và các quy trình tác vụ tự động. Các mô hình Gemma được thiết kế linh hoạt trên nhiều môi trường, có hỗ trợ và công cụ chính thức cho phát triển cục bộ, triển khai đám mây và tùy biến mô hình, khiến chúng trở thành lựa chọn mạnh mẽ cho các dự án tinh chỉnh.
Trong hướng dẫn này, chúng ta sẽ tinh chỉnh Gemma 4 E4B-it trên bộ dữ liệu phân loại cảm xúc con người từ Hugging Face. Chúng ta sẽ thiết lập môi trường GPU 3090, tải và khám phá bộ dữ liệu, chuẩn bị và định dạng dữ liệu cho tinh chỉnh có giám sát, tải mô hình gốc, chạy đánh giá đường cơ sở trước khi huấn luyện, tinh chỉnh mô hình, rồi đánh giá lại hiệu năng sau huấn luyện.
Bắt đầu bằng cách khởi chạy một phiên bản Runpod mới và đảm bảo tài khoản của bạn có ít nhất $5 tín dụng trước khi bắt đầu. Với hướng dẫn này, hãy chọn một pod GPU 3090 và chọn mẫu PyTorch mới nhất.
Trước khi triển khai, mở phần cài đặt mẫu và cập nhật một vài mục. Tăng cả dung lượng đĩa container và dung lượng volume lên 40 GB để có đủ chỗ cho mô hình, bộ dữ liệu, các tệp đệm và checkpoint huấn luyện.
Bạn cũng nên thêm token Hugging Face vào biến môi trường. Bạn có thể tạo token này trong Settings > Access Tokens của tài khoản Hugging Face.
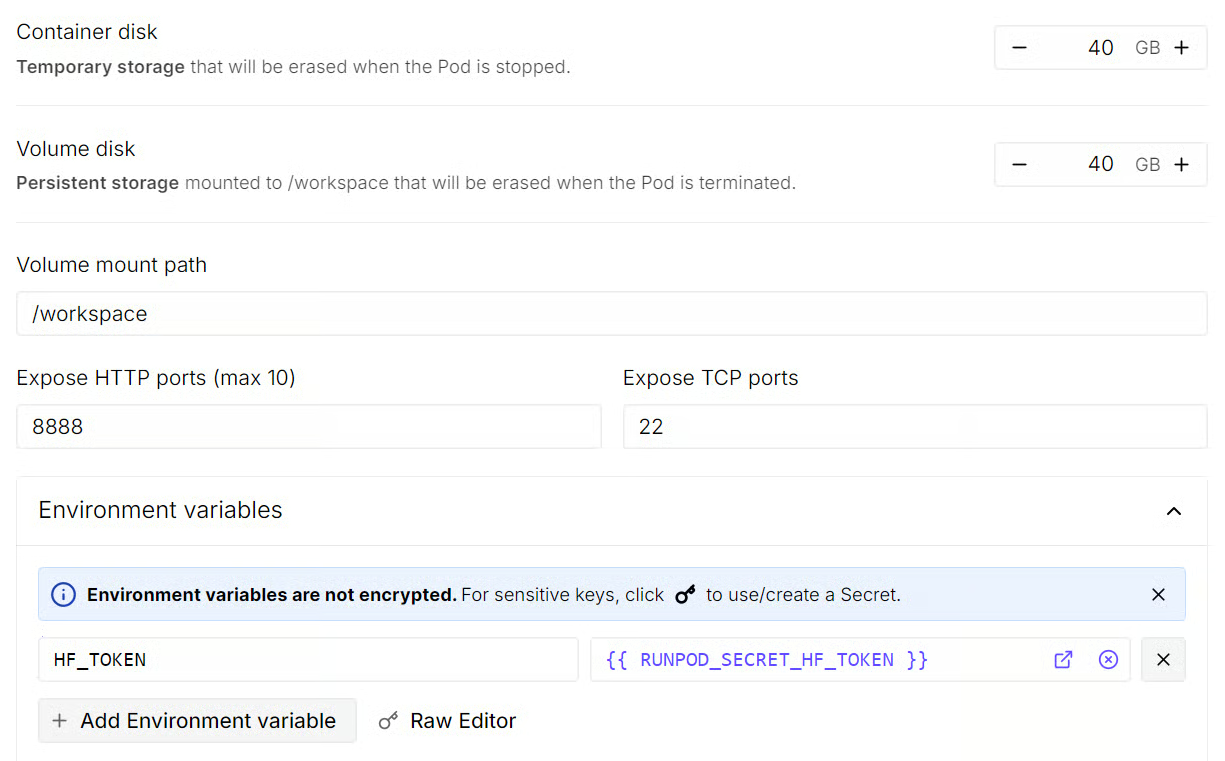
Khi đã thiết lập xong, hãy triển khai pod. Mất khoảng một đến hai phút để phiên bản khởi động. Sau khi sẵn sàng, mở giao diện JupyterLab để bắt đầu làm việc trong môi trường.
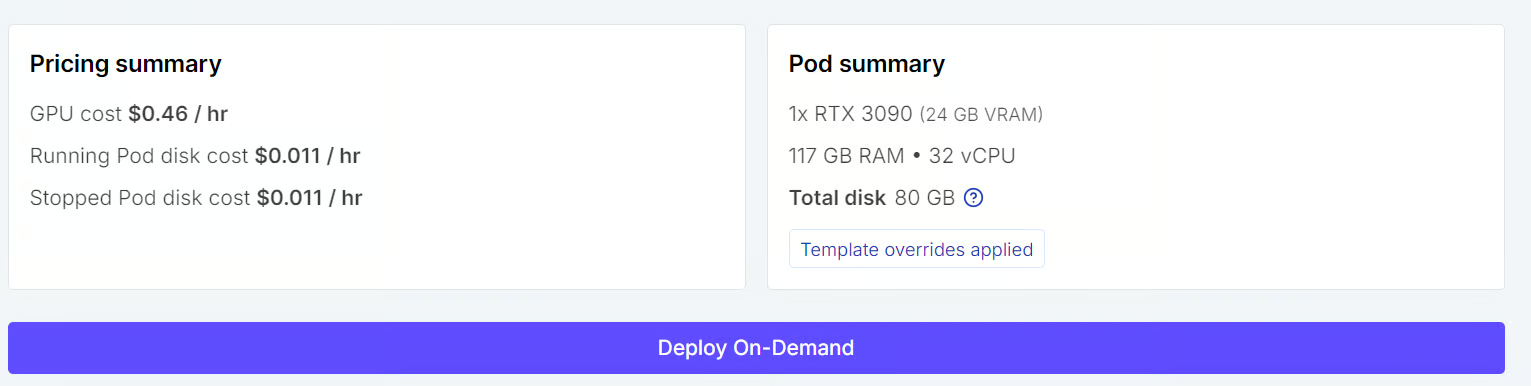
Việc đầu tiên trong JupyterLab là mở notebook Python mới và cài đặt toàn bộ các gói Python cần thiết. Chạy lệnh sau trong một ô notebook:
%%capture
!pip install -U transformers accelerate datasets trl peft bitsandbytes scikit-learn huggingface_hub
Các gói này bao quát toàn bộ quy trình, gồm tải bộ dữ liệu, chuẩn bị mô hình, tinh chỉnh và đánh giá.
Bước cuối là đăng nhập Hugging Face Hub bằng token đã lưu. Điều này cho phép bạn truy cập mô hình bị chặn và cũng giúp dễ dàng tải tệp, tạo kho lưu trữ và đẩy mô hình đã tinh chỉnh sau này.
import os
from huggingface_hub import login

hf_token = os.environ.get("HF_TOKEN")
if not hf_token:
    raise ValueError("Set HF_TOKEN in the RunPod environment before running this notebook.")

login(token=hf_token)
print("Logged in to Hugging Face.")Giờ môi trường đã sẵn sàng, bước tiếp theo là tải bộ dữ liệu cảm xúc từ Hugging Face và chuẩn bị các tập nhỏ hơn để huấn luyện và đánh giá.
Trong hướng dẫn này, chúng ta không dùng toàn bộ tập dữ liệu. Thay vào đó, chúng ta tạo các tập train, validation và test giới hạn để quá trình tinh chỉnh nhanh hơn và dễ chạy trên một GPU duy nhất.
from datasets import load_dataset, DatasetDict

TRAIN_LIMIT = 4000
VALIDATION_LIMIT = 400
TEST_LIMIT = 400
EVAL_LIMIT = 400

raw_dataset = load_dataset("dair-ai/emotion")

def maybe_limit(split, limit):
    split = split.shuffle(seed=42)
    if limit is None:
        return split
    return split.select(range(min(limit, len(split))))

dataset = DatasetDict({
    "train": maybe_limit(raw_dataset["train"], TRAIN_LIMIT),
    "validation": maybe_limit(raw_dataset["validation"], VALIDATION_LIMIT),
    "test": maybe_limit(raw_dataset["test"], TEST_LIMIT),
})

dataset
Bộ dữ liệu cuối cùng gồm 4.000 mẫu huấn luyện, 400 mẫu xác thực và 400 mẫu kiểm thử.
DatasetDict({
    train: Dataset({
        features: ['text', 'label'],
        num_rows: 4000
    })
    validation: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
    test: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
})
Tiếp theo, chúng ta xem các tên nhãn được lưu trong bộ dữ liệu. Đây là các lớp cảm xúc mà mô hình sẽ học để dự đoán.
label_names = dataset["train"].features["label"].names
label_names
Điều này cho thấy tác vụ có sáu nhóm cảm xúc: sadness, joy, love, anger, fear và surprise.
['sadness', 'joy', 'love', 'anger', 'fear', 'surprise']Chúng ta cũng có thể xem một ví dụ từ tập huấn luyện để hiểu cấu trúc dữ liệu.
dataset["train"][0]Mỗi ví dụ gồm một đoạn văn bản và một nhãn số. Ở đây, nhãn 4 ánh xạ tới fear theo danh sách nhãn ở trên.
{'text': 'while cycling in the country', 'label': 4}Trước khi tinh chỉnh mô hình, chúng ta cần chuyển bộ dữ liệu về định dạng mà Gemma 4 sử dụng trong quá trình huấn luyện.
Thay vì chỉ truyền văn bản thô và nhãn, chúng ta cấu trúc mỗi ví dụ như một tương tác trò chuyện ngắn với thông điệp hệ thống, thông điệp người dùng và phản hồi mong đợi của trợ lý.
Lời nhắc hệ thống (system prompt) hướng dẫn chính xác tác vụ mô hình cần thực hiện. Ở đây, chúng ta muốn mô hình đóng vai trò trợ lý phân loại cảm xúc và chỉ trả về một trong sáu nhãn cho phép.
SYSTEM_PROMPT = """You are an emotion classification assistant.
Read the user's text and answer with exactly one label.
Only choose from: sadness, joy, love, anger, fear, surprise.
Return only the label and nothing else."""
Trong thiết lập này, thông điệp người dùng chứa văn bản đầu vào cần phân loại, còn thông điệp trợ lý chứa nhãn đúng. Đây là định dạng dùng cho tinh chỉnh có giám sát, nơi mô hình học cách sinh ra phản hồi đúng cho mỗi ví dụ huấn luyện.
def to_prompt_completion(example):
    text = example["text"]
    label = label_names[example["label"]]
    return {
        "prompt": [
            {
                "role": "system",
                "content": SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": f"Classify the emotion of this text:\n\n{text}",
            },
        ],
        "completion": [
            {
                "role": "assistant",
                "content": label,
            }
        ],
    }

sft_dataset = dataset.map(to_prompt_completion, remove_columns=dataset["train"].column_names)
Sau khi áp dụng hàm định dạng này, các cột text và label gốc được thay bằng các trường có cấu trúc prompt và completion.
Chúng ta có thể kiểm tra một ví dụ để xác nhận bộ dữ liệu đã được định dạng đúng.
sft_dataset["train"][0]Kết quả hiển thị rõ cấu trúc huấn luyện đầy đủ. Mô hình thấy hướng dẫn, đọc văn bản đầu vào và học cách tạo ra nhãn cảm xúc đúng làm câu trả lời.
{'prompt': [{'content': "You are an emotion classification assistant.\nRead the user's text and answer with exactly one label.\nOnly choose from: sadness, joy, love, anger, fear, surprise.\nReturn only the label and nothing else.",
   'role': 'system'},
  {'content': 'Classify the emotion of this text:\n\nwhile cycling in the country',
   'role': 'user'}],
'completion': [{'content': 'fear', 'role': 'assistant'}]}Giờ chúng ta có thể tải Gemma 4 E4B-it và chuẩn bị cho tinh chỉnh. Vì đây là mô hình tương đối lớn, ta tải với lượng tử hóa 4-bit để giảm dùng bộ nhớ và dễ chạy trên GPU 3090. Chúng ta cũng dùng bfloat16 làm kiểu tính toán để giữ hiệu quả.
Bắt đầu bằng cách import các thư viện cần thiết và xác định cài đặt chính của mô hình.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "google/gemma-4-E4B-it"
MODEL_DTYPE = torch.bfloat16
USE_4BIT = True
Tiếp theo, bật một vài tối ưu hóa CUDA và tải tokenizer.
if torch.cuda.is_available():
    torch.backends.cuda.matmul.allow_tf32 = True
    torch.backends.cudnn.allow_tf32 = True

processor = AutoTokenizer.from_pretrained(MODEL_ID, use_fast=True)
if processor.pad_token is None:
    processor.pad_token = processor.eos_token
Giờ hãy chuẩn bị cài đặt lượng tử hóa và tham số tải mô hình.
bnb_config = None
model_kwargs = {
    "device_map": "auto",
}
if USE_4BIT:
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=MODEL_DTYPE,
    )
    model_kwargs["quantization_config"] = bnb_config
else:
    model_kwargs["torch_dtype"] = MODEL_DTYPE
Cuối cùng, tải mô hình và căn chỉnh cấu hình của nó với tokenizer.
base_model = AutoModelForCausalLM.from_pretrained(MODEL_ID, **model_kwargs)
base_model.config.use_cache = False
base_model.config.pad_token_id = processor.pad_token_id
base_model.config.bos_token_id = processor.bos_token_id
base_model.config.eos_token_id = processor.eos_token_id
base_model.generation_config.pad_token_id = processor.pad_token_id
base_model.generation_config.bos_token_id = processor.bos_token_id
base_model.generation_config.eos_token_id = processor.eos_token_id

print(f"Base model loaded with 4-bit={USE_4BIT} and dtype={MODEL_DTYPE}.")
Điều này tải mô hình gốc lên thiết bị sẵn có, tắt bộ đệm trong quá trình huấn luyện và đảm bảo các ID token đặc biệt được đặt đúng cho cả cấu hình mô hình và cấu hình sinh.
Base model loaded with 4-bit=True and dtype=torch.bfloat16.Trước khi tinh chỉnh, hữu ích khi đánh giá mô hình gốc để có đường cơ sở rõ ràng để so sánh sau này.
Trong phần này, chúng ta định nghĩa một vài hàm trợ giúp để tạo dự đoán, trích xuất nhãn cảm xúc hợp lệ và chạy đánh giá trên tập kiểm thử.
Bắt đầu bằng cách tạo mẫu trích xuất nhãn đơn giản và các hàm trợ giúp cho dự đoán.
Các hàm này xử lý toàn bộ luồng dự đoán. Mô hình nhận đầu vào ở định dạng chat, sinh phản hồi ngắn, sau đó chúng ta trích xuất nhãn dự đoán. Nếu mô hình trả thêm văn bản, hàm trợ giúp sẽ cố gắng lấy nhãn cảm xúc hợp lệ đầu tiên.
import re

LABEL_PATTERN = re.compile(r"\b(sadness|joy|love|anger|fear|surprise)\b", re.IGNORECASE)

def extract_label(raw_text: str) -> str:
    raw_text = raw_text.strip().lower()
    match = LABEL_PATTERN.search(raw_text)
    if match:
        return match.group(1)

    first_token = raw_text.split()[0].strip(".,!?:;\"'()[]{}") if raw_text.split() else ""
    return first_token

def generate_label(model, processor, user_text, system_prompt, max_new_tokens=4):
    messages = [
        {
            "role": "system",
            "content": system_prompt,
        },
        {
            "role": "user",
            "content": f"Classify the emotion of this text:\n\n{user_text}",
        },
    ]

    device = next(model.parameters()).device
    inputs = processor.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    ).to(device)

    input_len = inputs["input_ids"].shape[-1]

    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            do_sample=False,
            pad_token_id=processor.pad_token_id,
            eos_token_id=processor.eos_token_id,
        )

    raw_pred = processor.decode(outputs[0][input_len:], skip_special_tokens=True).strip()
    return extract_label(raw_pred)


def predict_emotion(user_text: str, model=None, proc=None) -> str:
    model = model or base_model
    proc = proc or processor
    return generate_label(model, proc, user_text, SYSTEM_PROMPT)
Giờ chúng ta có thể thử trên một ví dụ đơn lẻ trước khi chạy đánh giá đầy đủ.
predict_emotion("I feel so happy and excited today!")Dự đoán mẫu có vẻ đúng, vậy chúng ta có thể chuyển sang đánh giá mô hình trên toàn bộ tập kiểm thử.
'joy'Đoạn mã này đánh giá mô hình trên tập kiểm thử và thu thập một số kết quả hữu ích. Nó lưu nhãn thật và nhãn dự đoán, theo dõi dự đoán đúng/sai, và trả về các chỉ số tổng quan, báo cáo phân loại và một dataframe chứa toàn bộ dự đoán.
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix, f1_score
import pandas as pd
from tqdm.auto import tqdm

VALID_LABELS = set(label_names)
ALL_EVAL_LABELS = label_names + ["INVALID"]

def evaluate_model(model, processor, split="test", limit=EVAL_LIMIT):
    y_true, y_pred, rows = [], [], []
    raw_source = dataset[split]
    if limit is not None:
        raw_source = raw_source.select(range(min(limit, len(raw_source))))

    model.eval()

    for ex in tqdm(raw_source, desc=f"Evaluating {split}", leave=False):
        true_label = label_names[ex["label"]]
        raw_pred_label = generate_label(model, processor, ex["text"], SYSTEM_PROMPT)
        pred_label = raw_pred_label if raw_pred_label in VALID_LABELS else "INVALID"

        y_true.append(true_label)
        y_pred.append(pred_label)
        rows.append({
            "text": ex["text"],
            "true_label": true_label,
            "pred_label": pred_label,
            "raw_pred_label": raw_pred_label,
            "correct": true_label == pred_label,
        })

    metrics = {
        "accuracy": accuracy_score(y_true, y_pred),
        "macro_f1": f1_score(y_true, y_pred, labels=label_names, average="macro", zero_division=0),
        "invalid_predictions": sum(1 for p in y_pred if p == "INVALID"),
        "evaluated_examples": len(y_true),
    }

    report = classification_report(
        y_true,
        y_pred,
        labels=label_names,
        output_dict=True,
        zero_division=0,
    )

    df = pd.DataFrame(rows)
    return metrics, report, df

def confusion_matrix_df(pred_df):
    return pd.DataFrame(
        confusion_matrix(pred_df["true_label"], pred_df["pred_label"], labels=ALL_EVAL_LABELS),
        index=ALL_EVAL_LABELS,
        columns=ALL_EVAL_LABELS,
    )
Giờ chúng ta có thể chạy đánh giá đường cơ sở đầy đủ trên mô hình gốc.
pre_metrics, pre_report, pre_preds = evaluate_model(base_model, processor, "test")
pre_metrics
Kết quả đường cơ sở cho thấy mô hình chưa tinh chỉnh đã hoạt động khá ổn, nhưng vẫn còn dư địa cải thiện.
Độ chính xác khoảng 58,25%, macro F1 khoảng 0,42, và mô hình tạo ra 33 dự đoán không hợp lệ, nghĩa là đôi khi trả về thứ gì đó ngoài tập nhãn kỳ vọng.
{'accuracy': 0.5825,
 'macro_f1': 0.42112912841373906,
 'invalid_predictions': 33,
 'evaluated_examples': 400}
Tiếp theo, chúng ta xem báo cáo phân loại đầy đủ cho từng nhóm cảm xúc.
pd.DataFrame(pre_report).transpose()Điều này cung cấp precision, recall, F1 score và support cho từng lớp. Nó giúp ta thấy mô hình xử lý tốt cảm xúc nào và cảm xúc nào khó hơn trước khi tinh chỉnh.
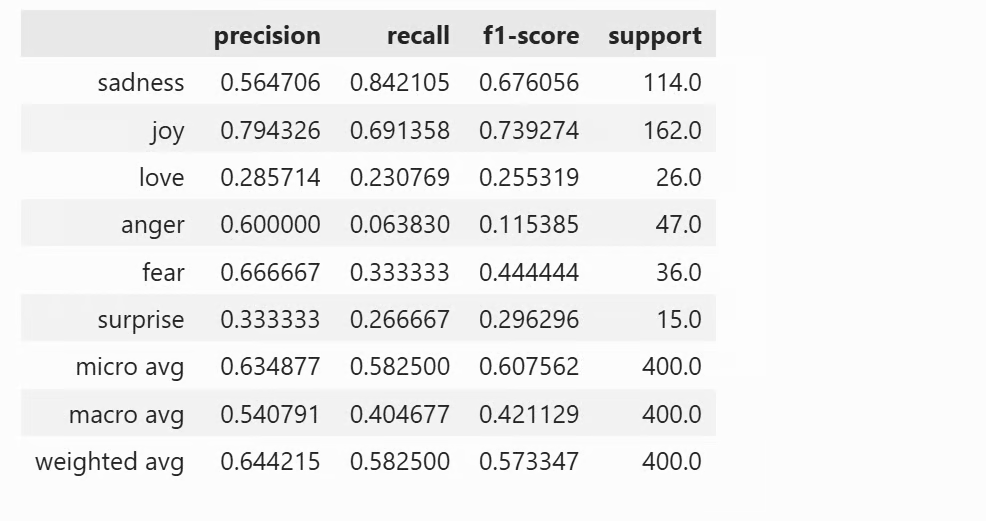
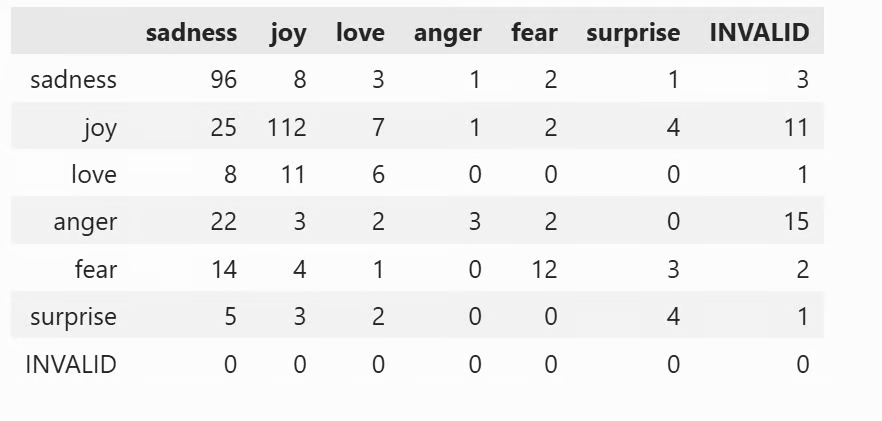
Cuối cùng, chúng ta xem ma trận nhầm lẫn.
confusion_matrix_df(pre_preds)Ma trận nhầm lẫn cho thấy phân bố dự đoán trên các lớp khác nhau.
Trong notebook, nó hiển thị dạng bảng, giúp dễ nhận ra cảm xúc nào hay bị nhầm với nhau và nơi mô hình gốc gặp khó khăn nhất.
Giờ chúng ta đã có kết quả đường cơ sở, hãy tinh chỉnh Gemma 4 bằng LoRA.
LoRA là phương pháp tinh chỉnh hiệu quả tham số, nghĩa là chúng ta không cập nhật toàn bộ mô hình. Thay vào đó, gắn một số ít trọng số bộ điều hợp có thể huấn luyện lên trên mô hình gốc. Điều này giúp huấn luyện nhẹ hơn và thực tế hơn trên một GPU duy nhất.
Bắt đầu bằng cách định nghĩa cấu hình LoRA.
Các cài đặt này kiểm soát cách gắn bộ điều hợp LoRA vào mô hình. Ở đây, chúng ta dùng rank 16, dropout 0,05 và áp dụng LoRA cho tất cả các lớp linear, đây là cấu hình thường dùng cho tinh chỉnh hiệu quả.
from peft import LoraConfig

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear"
)
Tiếp theo, chúng ta định nghĩa cấu hình huấn luyện và thiết lập trainer.
Thiết lập huấn luyện này được thiết kế để giữ mức sử dụng bộ nhớ ở mức vừa phải nhưng vẫn cho mô hình đủ không gian học từ dữ liệu. Chúng ta huấn luyện 1 epoch, dùng tích lũy gradient để mô phỏng batch lớn hơn và bật các tuỳ chọn như gradient checkpointing và tối ưu hóa 8-bit để huấn luyện hiệu quả hơn.
from trl import SFTConfig, SFTTrainer

training_args = SFTConfig(
    output_dir="./gemma4-emotion-lora",
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=1e-4,
    weight_decay=0.01,
    lr_scheduler_type="linear",
    warmup_steps=50,
    num_train_epochs=1,
    logging_steps=50,
    eval_strategy="steps",
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    gradient_checkpointing=True,
    bf16=True,
    fp16=False,
    tf32=True,
    max_length=256,
    packing=False,
    completion_only_loss=True,
    remove_unused_columns=False,
    dataloader_num_workers=2,
    optim="paged_adamw_8bit",
    report_to="none",
)
Giờ hãy đảm bảo mô hình gốc đã sẵn sàng và khởi tạo trainer. Bước này gắn các bộ điều hợp LoRA vào mô hình gốc và chuẩn bị trainer tinh chỉnh có giám sát bằng các tập train và validation đã định dạng của chúng ta.
from peft import PeftModel

if isinstance(base_model, PeftModel):
    base_model = base_model.unload()
    base_model.config.use_cache = False

trainer = SFTTrainer(
    model=base_model,
    train_dataset=sft_dataset["train"],
    eval_dataset=sft_dataset["validation"],
    peft_config=lora_config,
    args=training_args,
    processing_class=processor,
)
Trước khi bắt đầu huấn luyện, nên xác nhận rằng các tham số LoRA đã được gắn đúng.
Đoạn này đếm số tham số có thể huấn luyện và báo lỗi nếu không có lớp LoRA nào được thêm vào.
Sau đó, quá trình huấn luyện bắt đầu.
trainable_params = 0
for param in trainer.model.parameters():
    if param.requires_grad:
        trainable_params += param.numel()

if trainable_params == 0:
    raise RuntimeError("No trainable LoRA parameters were attached. Check target_modules before training.")

print(f"Trainable LoRA parameters: {trainable_params:,}")
train_result = trainer.train()
trainer.model.eval()
trainer.model.config.use_cache = True
train_result
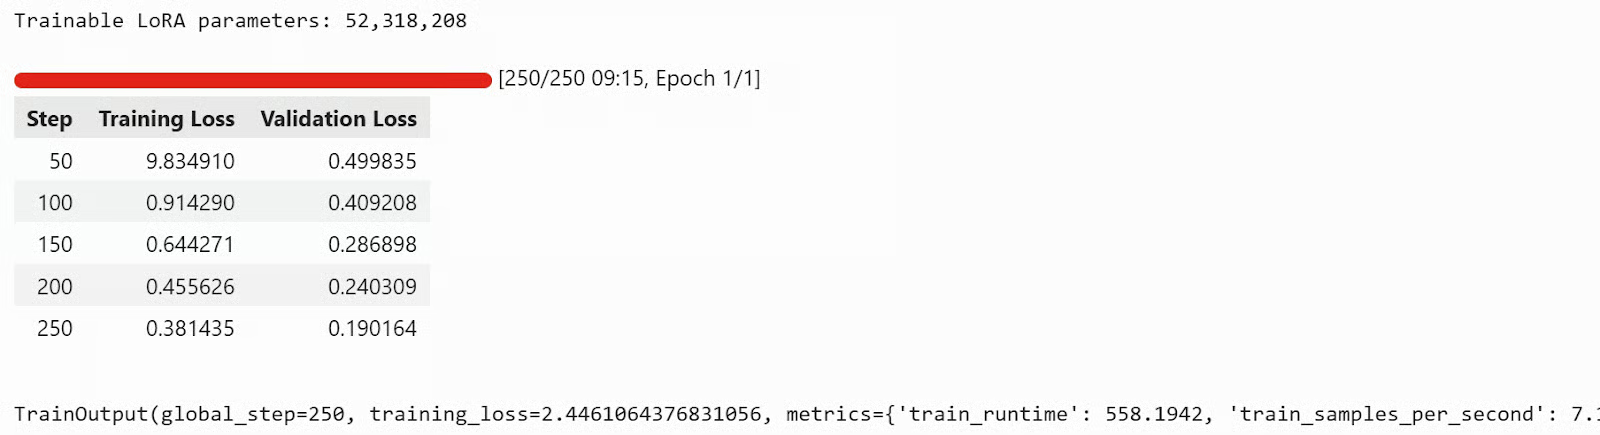
Trong lần chạy này, huấn luyện mất gần 9 phút, và cả training loss lẫn validation loss đều giảm dần theo thời gian, là dấu hiệu tốt cho thấy mô hình đang học từ dữ liệu.
Khi huấn luyện xong, chúng ta có thể lưu adapter và tokenizer cục bộ.
trainer.model.save_pretrained("./gemma4-emotion-lora")
processor.save_pretrained("./gemma4-emotion-lora")
Cuối cùng, chúng ta có thể đẩy mô hình lên Hugging Face Hub.
Điều này tải adapter đã tinh chỉnh và tokenizer lên Hub để bạn có thể truy cập từ bất kỳ đâu, chia sẻ với người khác, hoặc tải trực tiếp vào notebook hay ứng dụng khác.
repo_id = "kingabzpro/gemma4-emotion-lora"

# Push adapter + processor to the Hub
trainer.model.push_to_hub(
    repo_id,
    private=False,
)

processor.push_to_hub(
    repo_id,
    private=False,
)
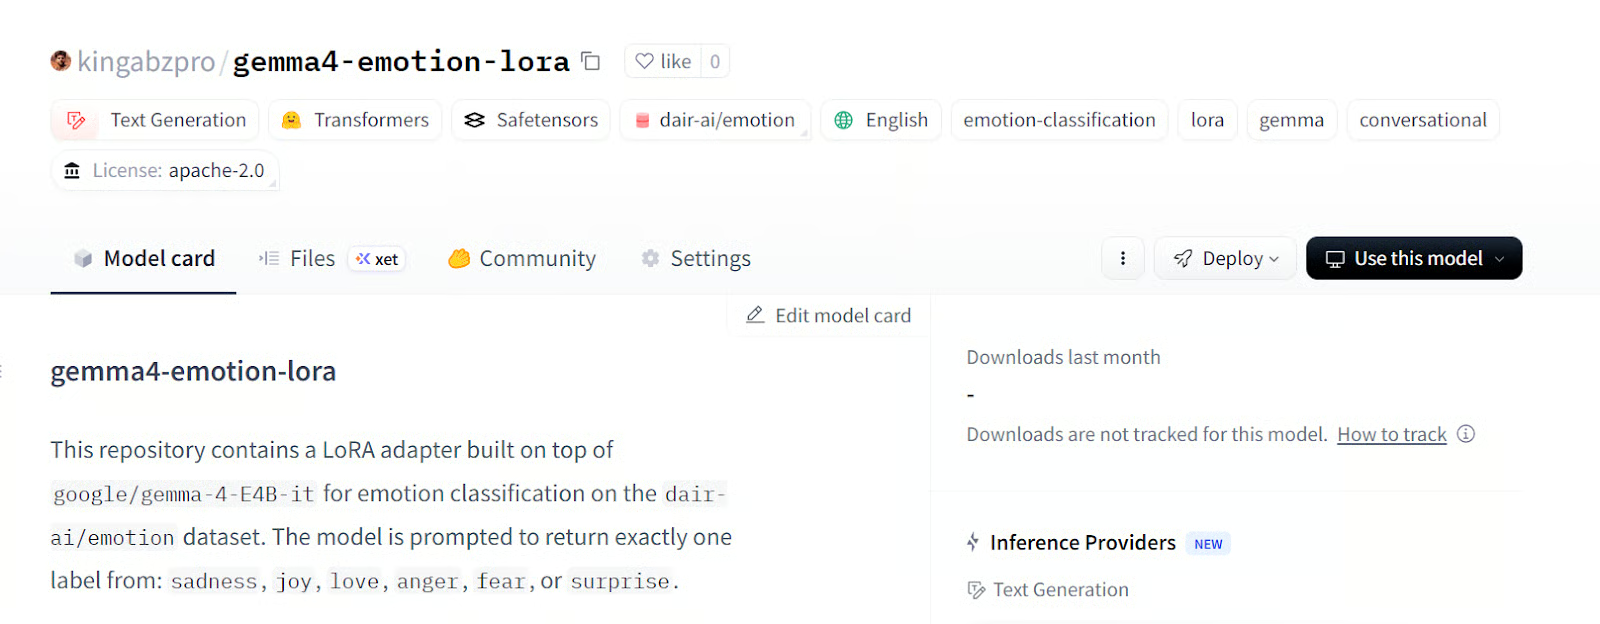
Bây giờ bạn có thể xem kingabzpro/gemma4-emotion-lora trên Hugging Face và tự thử. Kho lưu trữ bao gồm tệp mô hình, hướng dẫn sử dụng và kết quả tinh chỉnh.
Nguồn: kingabzpro/gemma4-emotion-lora · Hugging Face
Sau khi huấn luyện hoàn tất, bước cuối là đánh giá mô hình đã tinh chỉnh trên cùng tập kiểm thử và so sánh với mô hình gốc. Điều này giúp thấy liệu tinh chỉnh bằng LoRA có cải thiện khả năng phân loại cảm xúc chính xác hơn không.
Chúng ta bắt đầu bằng cách tải mô hình đã tinh chỉnh từ trainer và chạy đánh giá.
ft_model = trainer.model
ft_model.eval()
ft_model.config.use_cache = True
post_metrics, post_report, post_preds = evaluate_model(ft_model, processor, "test")
post_metrics
Điều này cho ta các chỉ số đánh giá chính cho mô hình đã tinh chỉnh.
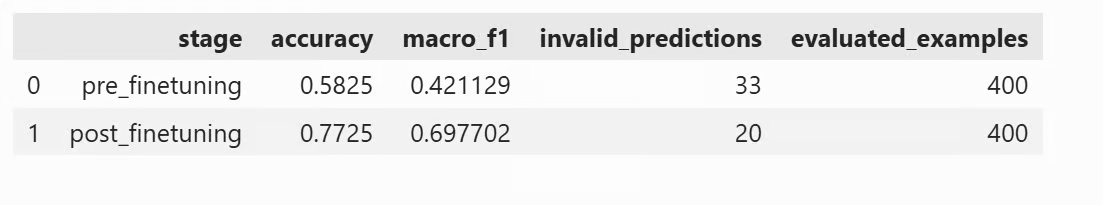
Kết quả này rõ ràng mạnh hơn đường cơ sở. Sau tinh chỉnh, mô hình đạt 77,25% độ chính xác và macro F1 là 0,698. Số dự đoán không hợp lệ cũng giảm từ 33 xuống 20, cho thấy mô hình đã tinh chỉnh không chỉ chính xác hơn mà còn nhất quán hơn trong việc trả về nhãn hợp lệ.
{'accuracy': 0.7725,
 'macro_f1': 0.697702361480462,
 'invalid_predictions': 20,
 'evaluated_examples': 400}
Tiếp theo, chúng ta có thể xem báo cáo phân loại đầy đủ.
Điều này hiển thị báo cáo phân loại dưới dạng pandas DataFrame trực tiếp trong notebook. Nó gồm precision, recall, F1 score và support cho từng lớp cảm xúc, giúp dễ thấy nhóm nào cải thiện nhiều nhất sau tinh chỉnh.
pd.DataFrame(post_report).transpose()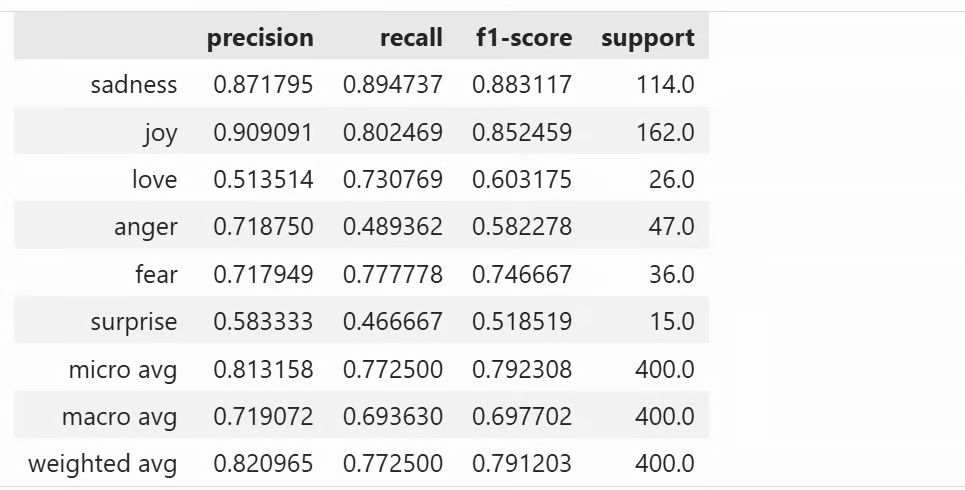
Điều này cũng hiển thị trong notebook dưới dạng bảng. Nó giúp bạn thấy nơi mô hình đã tinh chỉnh vẫn mắc lỗi và những nhóm cảm xúc nào thường bị nhầm lẫn với nhau.
confusion_matrix_df(post_preds)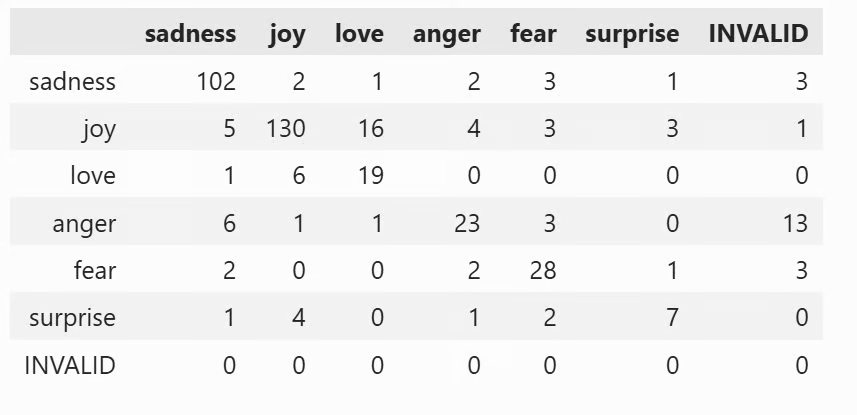
Để so sánh rõ ràng hơn, chúng ta có thể đặt các chỉ số trước và sau tinh chỉnh cạnh nhau.
comparison_df = pd.DataFrame([
    {"stage": "pre_finetuning", **pre_metrics},
    {"stage": "post_finetuning", **post_metrics},
])
comparison_df
Nó đưa ra tóm tắt nhanh mức độ cải thiện của mô hình sau huấn luyện.
Lưu ý: Nếu bạn gặp vấn đề khi chạy mã, có thể tham khảo toàn bộ notebook Jupyter tại đây: fine-tune-gemma-4-on-emotions_final.ipynb
Tinh chỉnh Gemma 4 rất nhạy với thiết lập, đặc biệt là cấu trúc prompt và tham số huấn luyện. Nếu định dạng prompt sai hoặc bạn không dùng đúng mẫu một cách nhất quán, mô hình có thể trải qua huấn luyện mà không thực sự học tốt tác vụ. Điều tương tự áp dụng cho cài đặt huấn luyện. Đây thường là nguyên nhân chính khiến loss không giảm, hoặc loss có giảm nhưng kết quả đánh giá hầu như không cải thiện.
Một bài học quan trọng khác là max_length. Nếu bạn giảm quá thấp, đặc biệt dưới khoảng 125, mô hình có thể không học đúng mẫu. Tôi đã gặp vài trục trặc trong quá trình này, nhưng đều được giải quyết lần lượt, và hầu hết quay lại hai vấn đề: định dạng prompt và cấu hình huấn luyện.
Để cải thiện hơn nữa, bước tiếp theo hợp lý là tinh chỉnh trên toàn bộ bộ dữ liệu và huấn luyện ít nhất 3 epoch thay vì chỉ một. Điều đó sẽ cho mô hình nhiều ví dụ để học và nhiều thời gian để thích nghi, từ đó cải thiện độ chính xác và điểm F1.
Học cùng DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
