Corso
Introduzione agli LLM in Python
3 ore
36.6K
Google ha appena presentato Gemma 4, descrivendola come la sua famiglia di modelli open più intelligente finora, pensata per un forte reasoning e workflow agentici. I modelli Gemma sono progettati per essere flessibili tra ambienti, con supporto ufficiale e strumenti per lo sviluppo locale, il deployment su cloud e la personalizzazione del modello, il che li rende una scelta solida per progetti di fine-tuning.
In questo tutorial, eseguiremo il fine-tuning di Gemma 4 E4B-it su un dataset di classificazione delle emozioni umane da Hugging Face. Imposteremo un ambiente con GPU 3090, caricheremo e ispezioneremo il dataset, prepareremo e formatteremo i dati per il supervised fine-tuning, caricheremo il modello base, eseguiremo una valutazione di baseline prima del training, faremo il fine-tuning del modello e poi valuteremo di nuovo le sue prestazioni dopo il training.
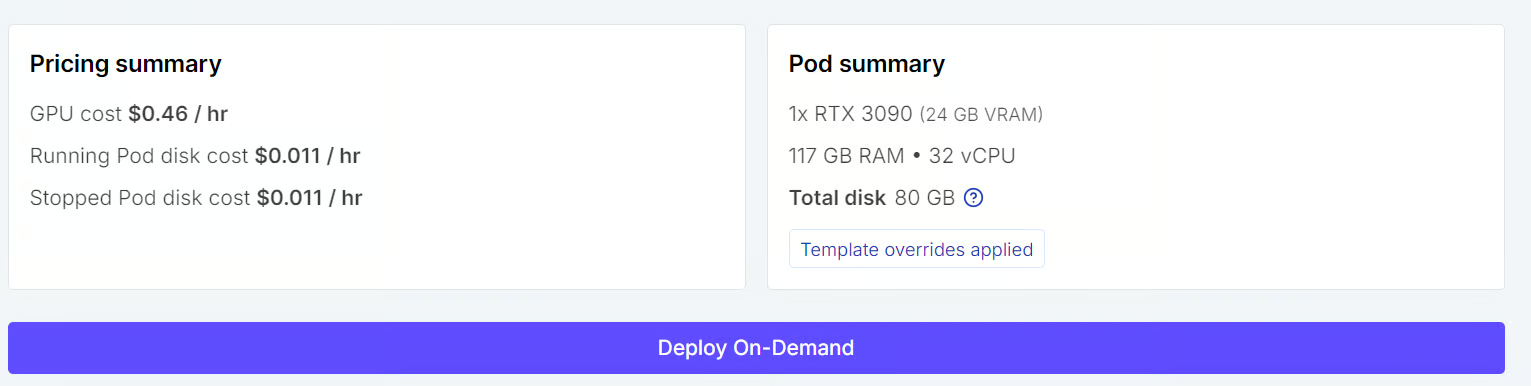
Inizia avviando una nuova istanza Runpod e assicurati che il tuo account abbia almeno 5 $ di credito prima di iniziare. Per questo tutorial, scegli un pod con GPU 3090 e seleziona il template PyTorch più recente.
Prima del deploy, apri le impostazioni del template e fai qualche aggiornamento. Aumenta sia il container disk sia il volume disk a 40 GB così da avere spazio sufficiente per modello, dataset, file in cache e checkpoint di training.
Dovresti anche aggiungere il tuo token di Hugging Face come variabile d'ambiente. Puoi generare questo token da Settings > Access Tokens nel tuo account Hugging Face.
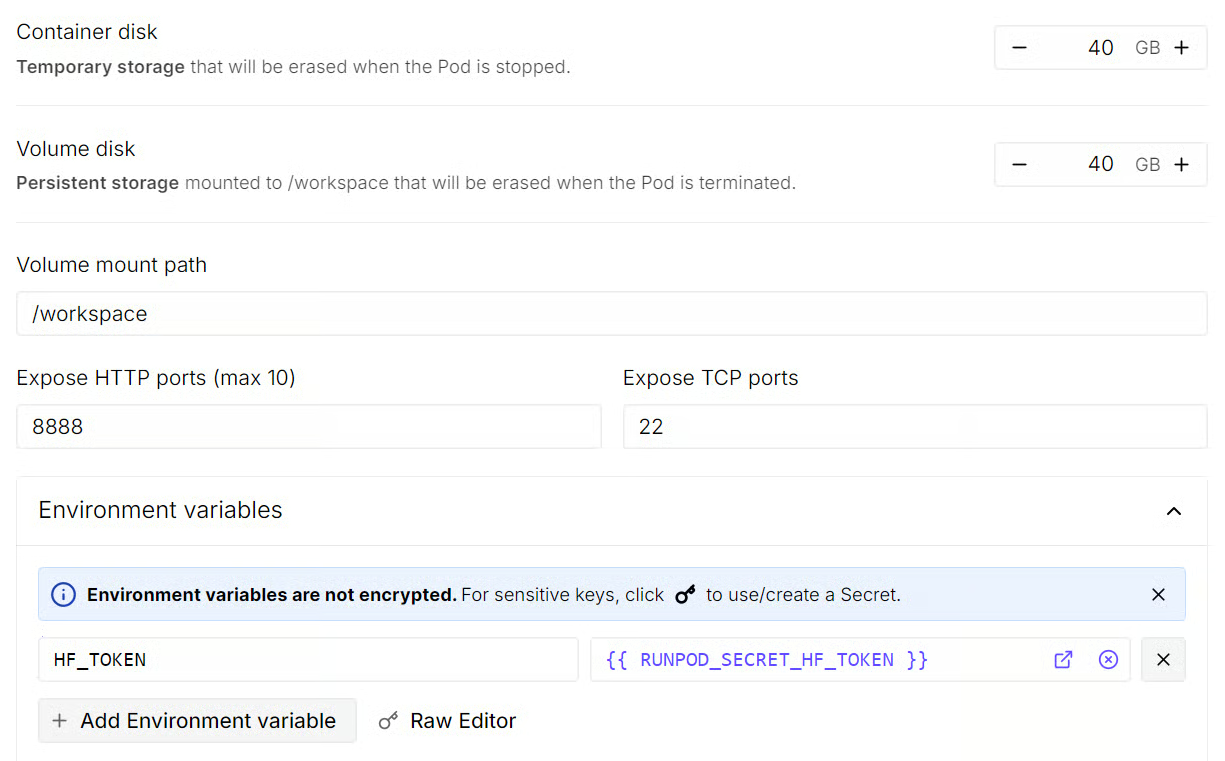
Una volta impostate queste opzioni, procedi a effettuare il deploy del pod. L'istanza potrebbe impiegare uno o due minuti per avviarsi. Quando è pronta, apri l'interfaccia JupyterLab per iniziare a lavorare nell'ambiente.
La prima cosa da fare in JupyterLab è avviare un nuovo notebook Python e installare tutti i pacchetti necessari. Esegui il seguente comando in una cella del notebook:
%%capture
!pip install -U transformers accelerate datasets trl peft bitsandbytes scikit-learn huggingface_hub
Questi pacchetti coprono l'intero workflow, inclusi il caricamento del dataset, la preparazione del modello, il fine-tuning e la valutazione.
L'ultimo passaggio è accedere a Hugging Face Hub usando il token salvato. Questo ti dà accesso al modello con accesso limitato e rende anche più semplice caricare file, creare repository e pubblicare in seguito il tuo modello con fine-tuning.
import os
from huggingface_hub import login

hf_token = os.environ.get("HF_TOKEN")
if not hf_token:
    raise ValueError("Set HF_TOKEN in the RunPod environment before running this notebook.")

login(token=hf_token)
print("Logged in to Hugging Face.")Ora che l'ambiente è pronto, il prossimo passo è caricare il dataset di emozioni da Hugging Face e preparare split più piccoli per training e valutazione.
Per questo tutorial, non usiamo l'intero dataset. Invece, creiamo split limitati di train, validation e test così che il processo di fine-tuning resti più veloce e facile da eseguire su una singola GPU.
from datasets import load_dataset, DatasetDict

TRAIN_LIMIT = 4000
VALIDATION_LIMIT = 400
TEST_LIMIT = 400
EVAL_LIMIT = 400

raw_dataset = load_dataset("dair-ai/emotion")

def maybe_limit(split, limit):
    split = split.shuffle(seed=42)
    if limit is None:
        return split
    return split.select(range(min(limit, len(split))))

dataset = DatasetDict({
    "train": maybe_limit(raw_dataset["train"], TRAIN_LIMIT),
    "validation": maybe_limit(raw_dataset["validation"], VALIDATION_LIMIT),
    "test": maybe_limit(raw_dataset["test"], TEST_LIMIT),
})

dataset
Il dataset finale contiene 4.000 esempi di training, 400 di validazione e 400 di test.
DatasetDict({
    train: Dataset({
        features: ['text', 'label'],
        num_rows: 4000
    })
    validation: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
    test: Dataset({
        features: ['text', 'label'],
        num_rows: 400
    })
})
Successivamente, vediamo i nomi delle etichette memorizzati nel dataset. Queste sono le classi di emozioni che il modello imparerà a predire.
label_names = dataset["train"].features["label"].names
label_names
Questo mostra che il task ha sei categorie di emozioni: sadness, joy, love, anger, fear e surprise.
['sadness', 'joy', 'love', 'anger', 'fear', 'surprise']Possiamo anche ispezionare un esempio dallo split di training per vedere com'è strutturato il dato.
dataset["train"][0]Ogni esempio contiene un testo e un'etichetta numerica. In questo caso, l'etichetta 4 corrisponde a fear in base alla lista delle etichette sopra.
{'text': 'while cycling in the country', 'label': 4}Prima di poter fare il fine-tuning del modello, dobbiamo convertire il dataset nel formato che Gemma 4 utilizzerà durante il training.
Invece di passare solo testo grezzo ed etichette, strutturiamo ogni esempio come una breve interazione in chat con un messaggio di sistema, un messaggio dell'utente e la risposta attesa dell'assistente.
Il prompt di sistema indica al modello esattamente quale compito deve svolgere. In questo caso, vogliamo che il modello agisca come un assistente per la classificazione delle emozioni e restituisca solo una delle sei etichette consentite.
SYSTEM_PROMPT = """You are an emotion classification assistant.
Read the user's text and answer with exactly one label.
Only choose from: sadness, joy, love, anger, fear, surprise.
Return only the label and nothing else."""
In questa configurazione, il messaggio dell'utente contiene il testo di input che vogliamo classificare e il messaggio dell'assistente contiene l'etichetta corretta. Questo è il formato usato per il supervised fine-tuning, in cui il modello impara a generare la risposta giusta per ogni esempio di training.
def to_prompt_completion(example):
    text = example["text"]
    label = label_names[example["label"]]
    return {
        "prompt": [
            {
                "role": "system",
                "content": SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": f"Classify the emotion of this text:\n\n{text}",
            },
        ],
        "completion": [
            {
                "role": "assistant",
                "content": label,
            }
        ],
    }

sft_dataset = dataset.map(to_prompt_completion, remove_columns=dataset["train"].column_names)
Dopo aver applicato questa funzione di formattazione, le colonne originali text e label vengono sostituite con campi strutturati prompt e completion.
Possiamo ispezionare un esempio per confermare che il dataset sia stato formattato correttamente.
sft_dataset["train"][0]L'output mostra chiaramente l'intera struttura di training. Il modello vede l'istruzione, legge il testo di input e impara a produrre l'etichetta di emozione corretta come risposta.
{'prompt': [{'content': "You are an emotion classification assistant.\nRead the user's text and answer with exactly one label.\nOnly choose from: sadness, joy, love, anger, fear, surprise.\nReturn only the label and nothing else.",
   'role': 'system'},
  {'content': 'Classify the emotion of this text:\n\nwhile cycling in the country',
   'role': 'user'}],
'completion': [{'content': 'fear', 'role': 'assistant'}]}Ora possiamo caricare Gemma 4 E4B-it e prepararlo per il fine-tuning. Poiché è un modello relativamente grande, lo carichiamo con quantizzazione a 4 bit per ridurre l'uso di memoria e renderlo più facile da eseguire su una GPU 3090. Usiamo anche bfloat16 come tipo di calcolo, che aiuta a mantenere l'impostazione efficiente.
Iniziamo importando le librerie necessarie e definendo le impostazioni principali del modello.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "google/gemma-4-E4B-it"
MODEL_DTYPE = torch.bfloat16
USE_4BIT = True
Poi abilitiamo alcune ottimizzazioni CUDA e carichiamo il tokenizer.
if torch.cuda.is_available():
    torch.backends.cuda.matmul.allow_tf32 = True
    torch.backends.cudnn.allow_tf32 = True

processor = AutoTokenizer.from_pretrained(MODEL_ID, use_fast=True)
if processor.pad_token is None:
    processor.pad_token = processor.eos_token
Ora prepariamo le impostazioni di quantizzazione e gli argomenti di caricamento del modello.
bnb_config = None
model_kwargs = {
    "device_map": "auto",
}
if USE_4BIT:
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=MODEL_DTYPE,
    )
    model_kwargs["quantization_config"] = bnb_config
else:
    model_kwargs["torch_dtype"] = MODEL_DTYPE
Infine, carichiamo il modello e allineiamo la sua configurazione con il tokenizer.
base_model = AutoModelForCausalLM.from_pretrained(MODEL_ID, **model_kwargs)
base_model.config.use_cache = False
base_model.config.pad_token_id = processor.pad_token_id
base_model.config.bos_token_id = processor.bos_token_id
base_model.config.eos_token_id = processor.eos_token_id
base_model.generation_config.pad_token_id = processor.pad_token_id
base_model.generation_config.bos_token_id = processor.bos_token_id
base_model.generation_config.eos_token_id = processor.eos_token_id

print(f"Base model loaded with 4-bit={USE_4BIT} and dtype={MODEL_DTYPE}.")
Questo carica il modello base sul dispositivo disponibile, disattiva la cache per il training e assicura che gli ID dei token speciali siano impostati correttamente sia per la config del modello sia per la config di generazione.
Base model loaded with 4-bit=True and dtype=torch.bfloat16.Prima del fine-tuning, è utile valutare prima il modello base così da avere una baseline chiara con cui confrontarsi più avanti.
In questa sezione, definiamo alcune funzioni di supporto che generano predizioni, estraggono etichette di emozioni valide ed eseguono la valutazione sullo split di test.
Iniziamo creando un semplice pattern di estrazione delle etichette e funzioni di supporto per la predizione.
Queste funzioni gestiscono l'intero flusso di predizione. Il modello riceve l'input in formato chat, genera una breve risposta e poi estraiamo l'etichetta predetta. Se il modello restituisce testo extra, la funzione di supporto prova a recuperare la prima etichetta di emozione valida.
import re

LABEL_PATTERN = re.compile(r"\b(sadness|joy|love|anger|fear|surprise)\b", re.IGNORECASE)

def extract_label(raw_text: str) -> str:
    raw_text = raw_text.strip().lower()
    match = LABEL_PATTERN.search(raw_text)
    if match:
        return match.group(1)

    first_token = raw_text.split()[0].strip(".,!?:;\"'()[]{}") if raw_text.split() else ""
    return first_token

def generate_label(model, processor, user_text, system_prompt, max_new_tokens=4):
    messages = [
        {
            "role": "system",
            "content": system_prompt,
        },
        {
            "role": "user",
            "content": f"Classify the emotion of this text:\n\n{user_text}",
        },
    ]

    device = next(model.parameters()).device
    inputs = processor.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    ).to(device)

    input_len = inputs["input_ids"].shape[-1]

    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            do_sample=False,
            pad_token_id=processor.pad_token_id,
            eos_token_id=processor.eos_token_id,
        )

    raw_pred = processor.decode(outputs[0][input_len:], skip_special_tokens=True).strip()
    return extract_label(raw_pred)


def predict_emotion(user_text: str, model=None, proc=None) -> str:
    model = model or base_model
    proc = proc or processor
    return generate_label(model, proc, user_text, SYSTEM_PROMPT)
Ora possiamo testare la configurazione su un singolo esempio prima di eseguire la valutazione completa.
predict_emotion("I feel so happy and excited today!")La predizione di esempio sembra corretta, quindi possiamo passare a valutare il modello sull'intero split di test.
'joy'Questo codice valuta il modello sullo split di test e raccoglie diversi output utili. Memorizza le etichette vere e predette, traccia se ogni predizione è corretta e restituisce metriche di riepilogo, un classification report e un dataframe con tutte le predizioni.
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix, f1_score
import pandas as pd
from tqdm.auto import tqdm

VALID_LABELS = set(label_names)
ALL_EVAL_LABELS = label_names + ["INVALID"]

def evaluate_model(model, processor, split="test", limit=EVAL_LIMIT):
    y_true, y_pred, rows = [], [], []
    raw_source = dataset[split]
    if limit is not None:
        raw_source = raw_source.select(range(min(limit, len(raw_source))))

    model.eval()

    for ex in tqdm(raw_source, desc=f"Evaluating {split}", leave=False):
        true_label = label_names[ex["label"]]
        raw_pred_label = generate_label(model, processor, ex["text"], SYSTEM_PROMPT)
        pred_label = raw_pred_label if raw_pred_label in VALID_LABELS else "INVALID"

        y_true.append(true_label)
        y_pred.append(pred_label)
        rows.append({
            "text": ex["text"],
            "true_label": true_label,
            "pred_label": pred_label,
            "raw_pred_label": raw_pred_label,
            "correct": true_label == pred_label,
        })

    metrics = {
        "accuracy": accuracy_score(y_true, y_pred),
        "macro_f1": f1_score(y_true, y_pred, labels=label_names, average="macro", zero_division=0),
        "invalid_predictions": sum(1 for p in y_pred if p == "INVALID"),
        "evaluated_examples": len(y_true),
    }

    report = classification_report(
        y_true,
        y_pred,
        labels=label_names,
        output_dict=True,
        zero_division=0,
    )

    df = pd.DataFrame(rows)
    return metrics, report, df

def confusion_matrix_df(pred_df):
    return pd.DataFrame(
        confusion_matrix(pred_df["true_label"], pred_df["pred_label"], labels=ALL_EVAL_LABELS),
        index=ALL_EVAL_LABELS,
        columns=ALL_EVAL_LABELS,
    )
Ora possiamo eseguire la valutazione completa di baseline sul modello base.
pre_metrics, pre_report, pre_preds = evaluate_model(base_model, processor, "test")
pre_metrics
Questi risultati di baseline mostrano che il modello non ottimizzato si comporta già abbastanza bene, ma c'è ancora margine di miglioramento.
L'accuratezza è circa 58,25%, la macro F1 è circa 0,42 e il modello ha prodotto 33 predizioni non valide, il che significa che a volte ha restituito qualcosa fuori dall'insieme di etichette atteso.
{'accuracy': 0.5825,
 'macro_f1': 0.42112912841373906,
 'invalid_predictions': 33,
 'evaluated_examples': 400}
Poi, possiamo consultare il classification report completo per ogni categoria di emozione.
pd.DataFrame(pre_report).transpose()Questo ci fornisce precision, recall, F1 score e support per ogni classe. Aiuta a vedere quali emozioni il modello gestisce bene e quali sono più difficili prima del fine-tuning.
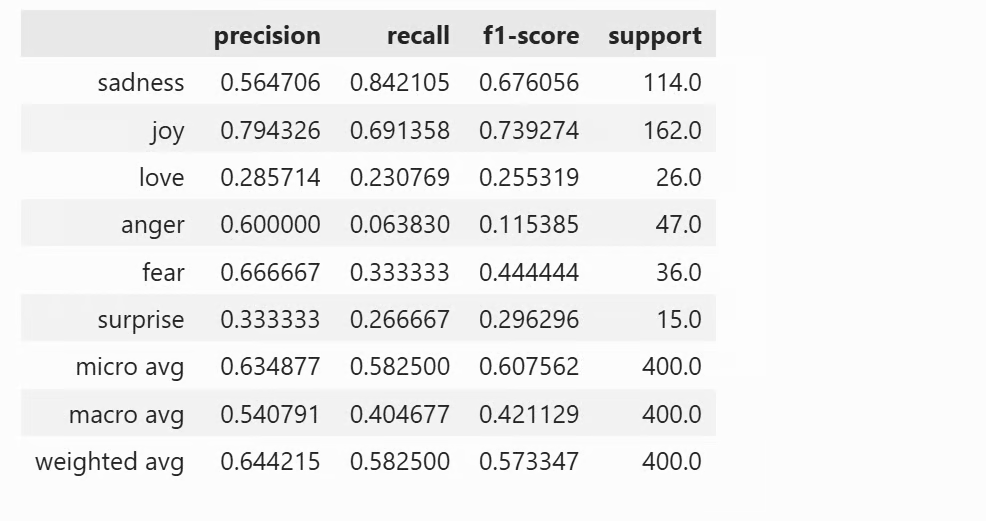
Infine, possiamo ispezionare la matrice di confusione.
confusion_matrix_df(pre_preds)La matrice di confusione mostra come le predizioni sono distribuite tra le diverse classi.
Nel notebook, è visualizzata come tabella, facilitando l'individuazione di quali emozioni vengono confuse tra loro e dove il modello base fatica di più.
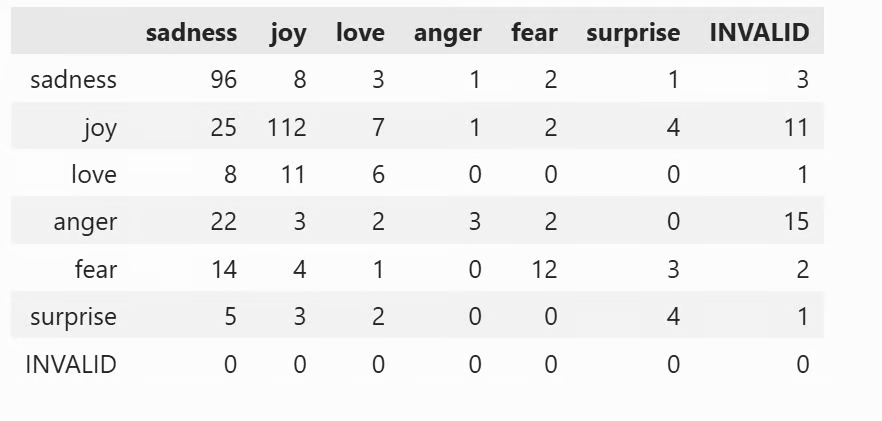
Ora che abbiamo i risultati di baseline, possiamo fare il fine-tuning di Gemma 4 usando LoRA.
LoRA è un metodo di fine-tuning efficiente sui parametri, il che significa che non aggiorniamo l'intero modello. Al contrario, aggiungiamo un piccolo numero di pesi adapter addestrabili sopra il modello base. Questo rende l'addestramento molto più leggero e praticabile su una singola GPU.
Iniziamo definendo la configurazione LoRA.
Queste impostazioni controllano come gli adapter LoRA vengono collegati al modello. Qui usiamo un rank di 16, un dropout di 0,05 e applichiamo LoRA a tutti i layer lineari, una configurazione comune per un fine-tuning efficiente.
from peft import LoraConfig

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules="all-linear"
)
Successivamente, definiamo la configurazione di training e impostiamo il trainer.
Questa configurazione di training è pensata per mantenere l'uso di memoria gestibile dando comunque al modello spazio sufficiente per imparare dal dataset. Alleniamo per un'epoca, usiamo l'accumulo dei gradienti per simulare una batch size più grande e abilitiamo opzioni come il gradient checkpointing e l'ottimizzazione a 8 bit per rendere il training più efficiente.
from trl import SFTConfig, SFTTrainer

training_args = SFTConfig(
    output_dir="./gemma4-emotion-lora",
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=1e-4,
    weight_decay=0.01,
    lr_scheduler_type="linear",
    warmup_steps=50,
    num_train_epochs=1,
    logging_steps=50,
    eval_strategy="steps",
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    gradient_checkpointing=True,
    bf16=True,
    fp16=False,
    tf32=True,
    max_length=256,
    packing=False,
    completion_only_loss=True,
    remove_unused_columns=False,
    dataloader_num_workers=2,
    optim="paged_adamw_8bit",
    report_to="none",
)
Ora ci assicuriamo che il modello base sia pronto e inizializziamo il trainer. Questo passaggio collega gli adapter LoRA al modello base e prepara il trainer per il supervised fine-tuning usando i nostri split di training e validation formattati.
from peft import PeftModel

if isinstance(base_model, PeftModel):
    base_model = base_model.unload()
    base_model.config.use_cache = False

trainer = SFTTrainer(
    model=base_model,
    train_dataset=sft_dataset["train"],
    eval_dataset=sft_dataset["validation"],
    peft_config=lora_config,
    args=training_args,
    processing_class=processor,
)
Prima di avviare il training, è una buona idea confermare che i parametri LoRA siano stati collegati correttamente.
Questo conta il numero di parametri addestrabili e genera un errore se non sono stati aggiunti layer LoRA.
Dopodiché, il training inizia.
trainable_params = 0
for param in trainer.model.parameters():
    if param.requires_grad:
        trainable_params += param.numel()

if trainable_params == 0:
    raise RuntimeError("No trainable LoRA parameters were attached. Check target_modules before training.")

print(f"Trainable LoRA parameters: {trainable_params:,}")
train_result = trainer.train()
trainer.model.eval()
trainer.model.config.use_cache = True
train_result
In questa esecuzione, il training ha richiesto quasi 9 minuti e sia la training loss sia la validation loss hanno continuato a diminuire nel tempo, un buon segnale che il modello stava imparando dal dataset.
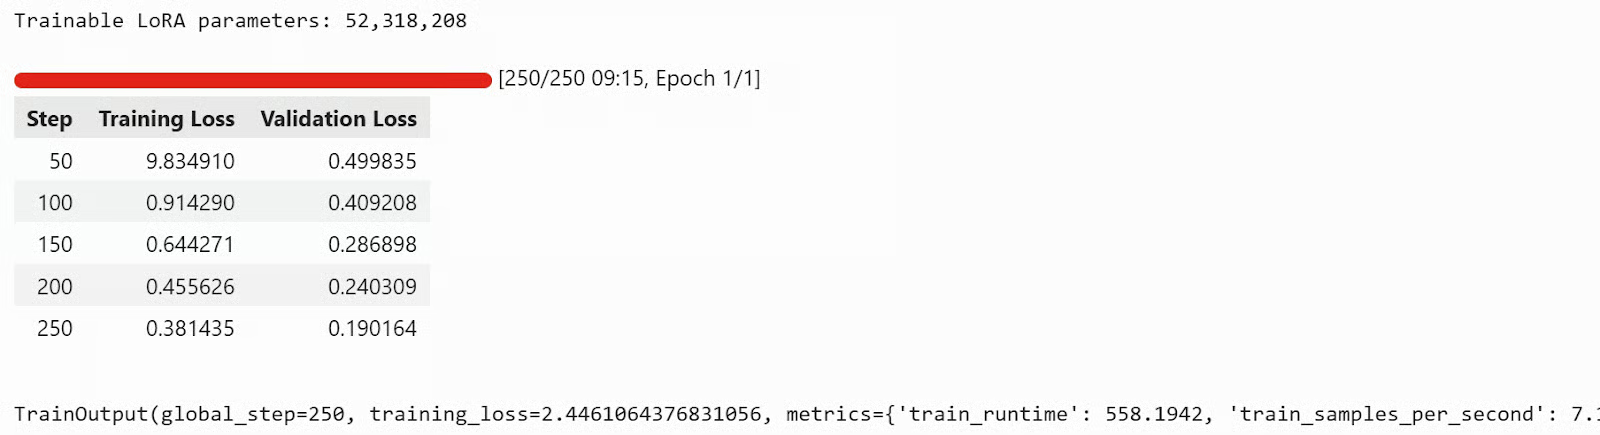
Una volta completato il training, possiamo salvare localmente l'adapter e il tokenizer.
trainer.model.save_pretrained("./gemma4-emotion-lora")
processor.save_pretrained("./gemma4-emotion-lora")
Infine, possiamo pubblicare il modello su Hugging Face Hub.
Questo carica l'adapter con fine-tuning e il tokenizer sull'Hub così da poterli accedere ovunque, condividerli con altri o caricarli direttamente in un altro notebook o applicazione.
repo_id = "kingabzpro/gemma4-emotion-lora"

# Push adapter + processor to the Hub
trainer.model.push_to_hub(
    repo_id,
    private=False,
)

processor.push_to_hub(
    repo_id,
    private=False,
)
Ora puoi visualizzare kingabzpro/gemma4-emotion-lora su Hugging Face e provarlo tu stesso. Il repository include i file del modello, le istruzioni d'uso e i risultati del fine-tuning.
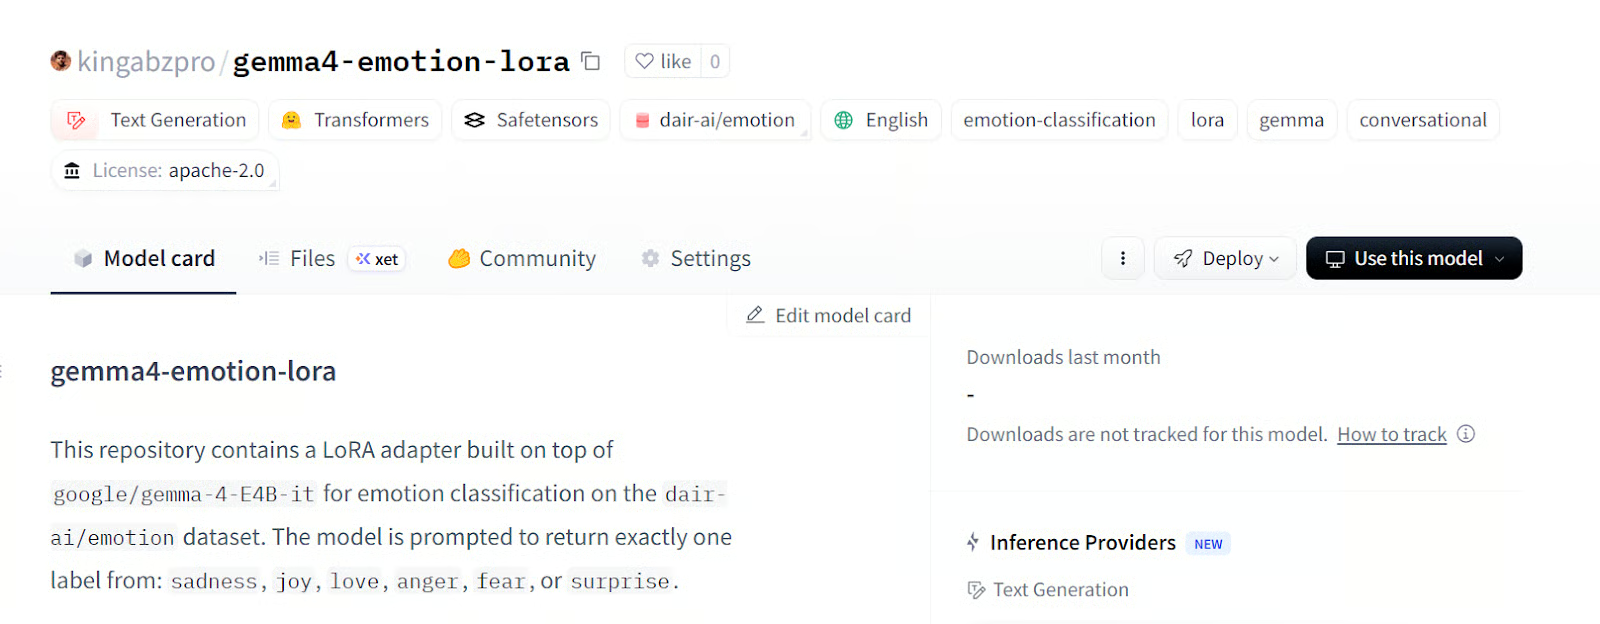
Fonte: kingabzpro/gemma4-emotion-lora · Hugging Face
Ora che il training è completo, l'ultimo passaggio è valutare il modello con fine-tuning sullo stesso split di test e confrontare i risultati con il modello base. Questo ci aiuta a capire se il fine-tuning con LoRA ha migliorato la capacità del modello di classificare le emozioni con maggiore accuratezza.
Iniziamo caricando il modello con fine-tuning dal trainer ed eseguendo la valutazione.
ft_model = trainer.model
ft_model.eval()
ft_model.config.use_cache = True
post_metrics, post_report, post_preds = evaluate_model(ft_model, processor, "test")
post_metrics
Questo ci fornisce le metriche principali di valutazione per il modello con fine-tuning.
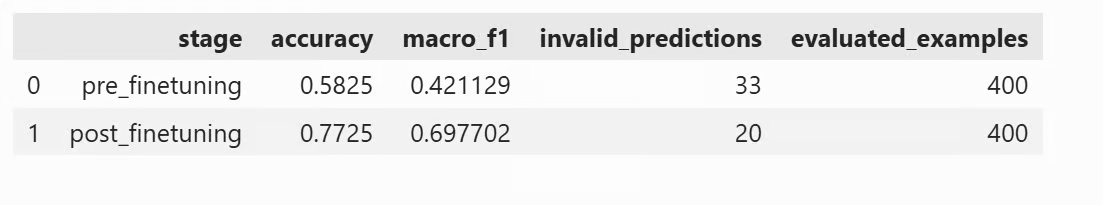
Questi risultati sono chiaramente migliori della baseline. Dopo il fine-tuning, il modello raggiunge il 77,25% di accuratezza e una macro F1 di 0,698. Il numero di predizioni non valide scende anche da 33 a 20, il che mostra che il modello con fine-tuning non è solo più accurato, ma anche più coerente nel restituire etichette valide.
{'accuracy': 0.7725,
 'macro_f1': 0.697702361480462,
 'invalid_predictions': 20,
 'evaluated_examples': 400}
Poi, possiamo visualizzare il classification report completo.
Questo visualizza il classification report come pandas DataFrame direttamente nel notebook. Include precision, recall, F1 score e support per ogni classe di emozione, rendendo più facile vedere quali categorie sono migliorate di più dopo il fine-tuning.
pd.DataFrame(post_report).transpose()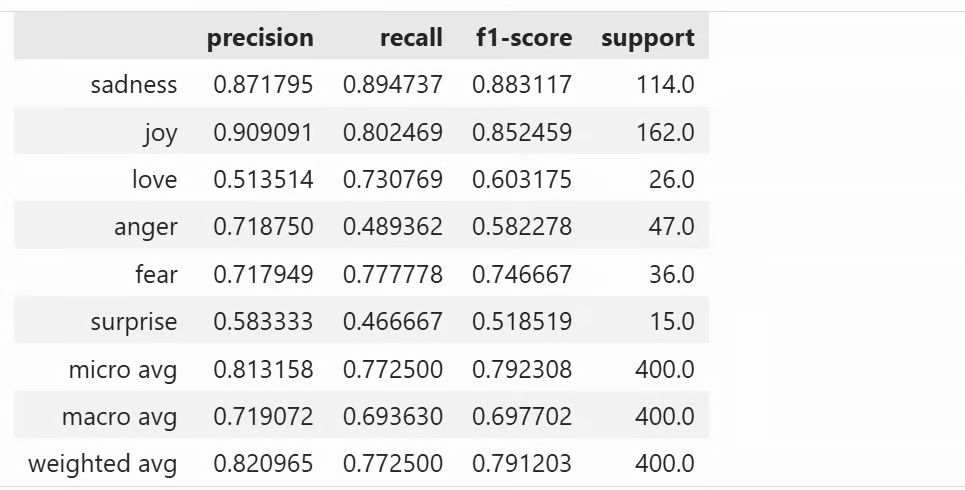
Anche questo è mostrato nel notebook come tabella. Ti aiuta a vedere dove il modello con fine-tuning sta ancora commettendo errori e quali categorie di emozioni vengono più spesso confuse tra loro.
confusion_matrix_df(post_preds)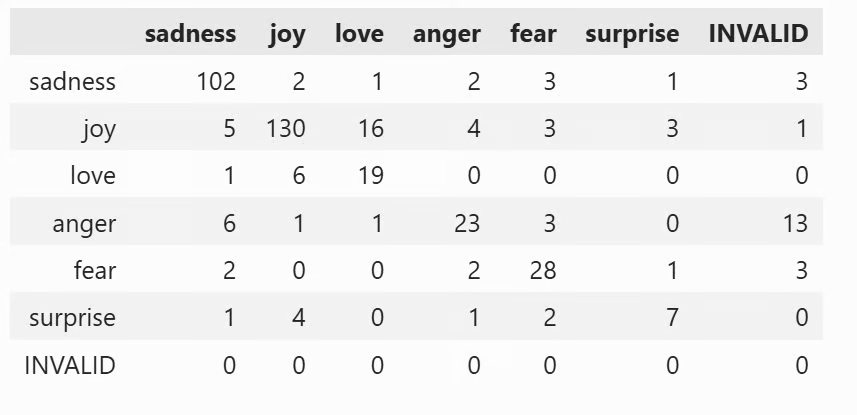
Per rendere il confronto più chiaro, possiamo affiancare le metriche pre e post fine-tuning.
comparison_df = pd.DataFrame([
    {"stage": "pre_finetuning", **pre_metrics},
    {"stage": "post_finetuning", **post_metrics},
])
comparison_df
Fornisce un riepilogo rapido di quanto è migliorato il modello dopo il training.
Nota: se riscontri problemi durante l'esecuzione del codice, puoi fare riferimento al notebook Jupyter completo qui: fine-tune-gemma-4-on-emotions_final.ipynb
Il fine-tuning di Gemma 4 è molto sensibile alla configurazione, in particolare alla struttura del prompt e agli argomenti di training. Se il formato del prompt è sbagliato, o non usi il template corretto in modo coerente, il modello potrebbe passare attraverso il training senza imparare davvero bene il compito. Lo stesso vale per le impostazioni di training. Di solito sono le ragioni principali per cui la loss non diminuisce, o perché la loss diminuisce ma i risultati in valutazione migliorano appena.
Un'altra lezione importante riguarda max_length. Se lo riduci troppo, soprattutto sotto circa 125, il modello potrebbe non apprendere affatto correttamente il pattern. Ho incontrato diversi problemi durante questo processo, ma sono stati risolti uno per uno, e la maggior parte ricondotta alle stesse due aree: formattazione del prompt e configurazione del training.
Per migliorare ulteriormente i risultati, un buon passo successivo sarebbe fare il fine-tuning sull'intero dataset e allenare per almeno 3 epoche invece di una sola. Questo darebbe al modello più esempi da cui imparare e più tempo per adattarsi, il che dovrebbe portare ad accuratezza e F1 più forti.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min