
Kursus
Bekerja dengan OpenAI API
3 jam
179.8K
Sebelum Anda mulai melakukan fine-tuning model GPT-4o Mini, kami merekomendasikan prompt engineering, prompt chaining, dan function calling untuk menyesuaikan respons model dan memperoleh jawaban spesifik domain.
Fine-tuning diperlukan ketika Anda ingin menyesuaikan gaya, nada, atau format. Ini digunakan untuk meningkatkan keandalan dan akurasi, menangani prompt yang kompleks, atau melakukan tugas baru yang tidak dapat dicapai oleh prompt engineer.
Dalam tutorial ini, kita akan melakukan fine-tuning model GPT-4o Mini untuk mengklasifikasikan teks menjadi label "stress" dan "non-stress". Selanjutnya, kita akan mengakses model hasil fine-tuning menggunakan OpenAI API dan playground OpenAI. Terakhir, kita akan mengevaluasi model hasil fine-tuning dengan membandingkan kinerjanya sebelum dan sesudah tuning menggunakan berbagai metrik klasifikasi.
Gambar oleh Penulis
GPT-4o Mini adalah model bahasa besar generalis paling hemat biaya yang tersedia. Model ini meraih skor 82% pada MMLU dan saat ini melampaui Claude 3.5 Sonnet pada preferensi chat di leaderboard LMSYS. Harganya 15 sen per satu juta token input dan 60 sen per satu juta token output, yang 60% lebih murah dibanding GPT-3.5 Turbo.
GPT-4o mini saat ini mendukung teks dan gambar sebagai input. Model ini memiliki jendela konteks 128K token, mendukung hingga 16K token output per permintaan, dan memiliki pengetahuan hingga Oktober 2023. GPT-4o Mini dapat menangani teks non-Inggris karena menggunakan tokenizer GPT-4o. Kita mendapatkan yang terbaik dari kedua dunia dengan biaya rendah.
Pelajari use case, chat completion API, dan tolok ukur terperinci GPT-4o Mini dengan membaca blog kami, Apa Itu GPT-4o Mini?
Kunjungi situs web OpenAI dan buat akun. Fine-tuning mahal, dan menggunakan GPT-4o Mini melalui API mengharuskan Anda memasang metode pembayaran pada akun Anda. Untuk menghindari kendala, pastikan Anda memiliki saldo kredit setidaknya 10 USD di akun sebelum mencoba melakukan fine-tuning model.
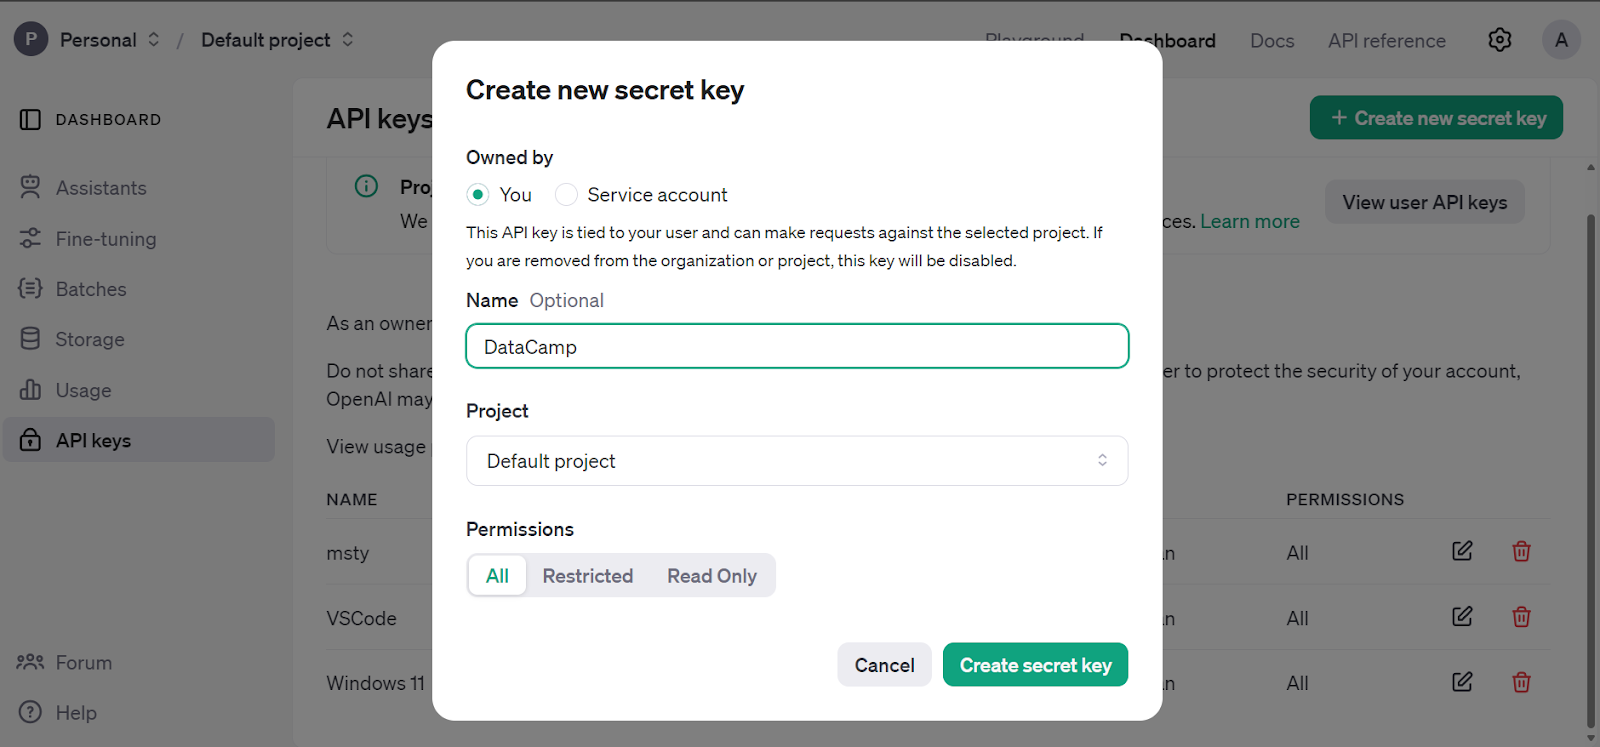
Masuk ke dasbor utama, klik tab “API keys”, dan buat kunci rahasia OpenAI API.
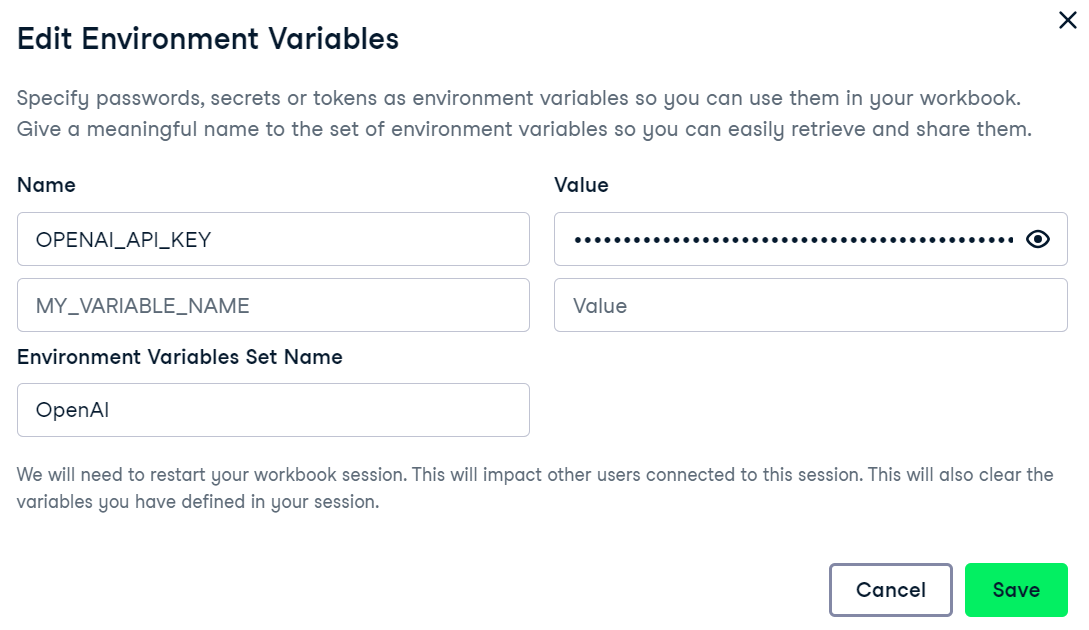
Kami menggunakan DataLab milik DataCamp sebagai editor kode kami. Untuk menyiapkan variabel lingkungan kunci OpenAI API, buka tab environment dan klik opsi environment variable. Lalu, tambahkan variabel lingkungan untuk kunci API dan aktifkan seperti ditunjukkan di bawah.
Instal paket Python OpenAI untuk mengakses GPT-4o Mini.
%%capture
%pip install openai
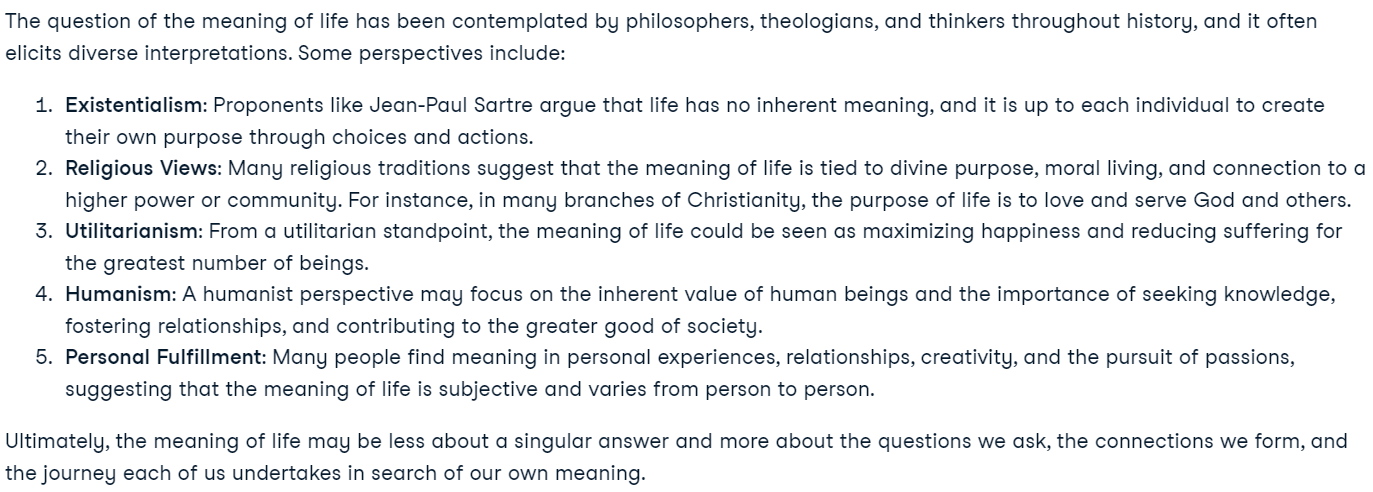
Buat klien menggunakan kunci OpenAI API dan hasilkan respons menggunakan prompt contoh. Fungsi chat completion memerlukan nama model dan pesan dalam format daftar dictionary.
from IPython.display import Markdown, display
from openai import OpenAI
import os

openai_api_key = os.environ["OPENAI_API_KEY"]

client = OpenAI(api_key=openai_api_key)

response = client.chat.completions.create(
  model="gpt-4o-mini",
  messages=[
    {"role": "system", "content": "You are a great philosopher."},
    {"role": "user", "content": "What is the meaning of life?"}
  ]
)
display(Markdown(response.choices[0].message.content))
OpenAI API kita sudah sepenuhnya disiapkan, dan kita siap memulai pekerjaan fine-tuning.
Baru mengenal API OpenAI? Anda dapat mengikuti tutorial sederhana dan mendetail Tutorial API GPT-4o: Mulai Menggunakan API OpenAI untuk memahami cara menulis beberapa baris kode guna mengakses model-model mutakhir.
Pada bagian ini, kita akan melakukan fine-tuning model GPT-4o Mini pada dataset Stress Detection from the Social Media Articles dari Kaggle. Dataset ini berisi postingan dari Reddit dan Twitter, yang mengklasifikasikannya ke dalam label stress dan non-stress.
Sekarang kita akan memuat dan memproses dataset.
Catatan: Pastikan format dataset benar, yang mencakup system prompt, kueri pengguna, dan respons. Responsnya akan berupa label.
import pandas as pd
import json
from sklearn.model_selection import train_test_split

# Load the CSV file with the correct delimiter
file_path = 'Reddit_Title.csv'  # Change this to your local path
data = pd.read_csv(file_path, sep=';')

# Clean up and drop unnecessary columns, and select the top 200 rows
data_cleaned = data[['title', 'label']].head(200)

# Mapping the 'label' column to more human-readable text
label_mapping = {0: "non-stress", 1: "stress"}
data_cleaned['label'] = data_cleaned['label'].map(label_mapping)

# Split the data into training and validation sets (80% train, 20% validation)
train_data, validation_data = train_test_split(data_cleaned, test_size=0.2, random_state=42)

def save_to_jsonl(data, output_file_path):
    jsonl_data = []
    for index, row in data.iterrows():
        jsonl_data.append({
            "messages": [
                {"role": "system", "content": "Given a social media post, classify whether it indicates 'stress' or 'non-stress'."},
                {"role": "user", "content": row['title']},
                {"role": "assistant", "content": f"\"{row['label']}\""}
            ]
        })

    # Save to JSONL format
    with open(output_file_path, 'w') as f:
        for item in jsonl_data:
            f.write(json.dumps(item) + '\n')

# Save the training and validation sets to separate JSONL files
train_output_file_path = 'stress_detection_train.jsonl'
validation_output_file_path = 'stress_detection_validation.jsonl'

save_to_jsonl(train_data, train_output_file_path)
save_to_jsonl(validation_data, validation_output_file_path)

print(f"Training dataset save to {train_output_file_path}")
print(f"Validation dataset save to {validation_output_file_path}")Keluaran:
Training dataset save to stress_detection_train.jsonl
Validation dataset save to stress_detection_validation.jsonlSekarang kita akan menggunakan klien OpenAI untuk mengunggah dataset pelatihan dan validasi guna fine-tuning.
train_file = client.files.create(
  file=open(train_output_file_path, "rb"),
  purpose="fine-tune"
)

valid_file = client.files.create(
  file=open(validation_output_file_path, "rb"),
  purpose="fine-tune"
)

print(f"Training file Info: {train_file}")
print(f"Validation file Info: {valid_file}")
OpenAI API akan terlebih dahulu memvalidasi dataset, lalu mengunggah dataset dan menghasilkan metadata yang dapat kita gunakan untuk melakukan fine-tuning model.
Training file Info: FileObject(id='file-b2lo2chod6xuMhYg9JcEsnp6', bytes=48563, created_at=1727133513, filename='stress_detection_train.jsonl', object='file', purpose='fine-tune', status='processed', status_details=None)
Validation file Info: FileObject(id='file-Fae0AVSUhTGr49qhQz8d2yyp', bytes=12284, created_at=1727133514, filename='stress_detection_validation.jsonl', object='file', purpose='fine-tune', status='processed', status_details=None)
Untuk memeriksa apakah dataset telah berhasil didorong ke cloud, buka Dashboard dan klik tab “Storage”. Dua berkas akan ada di sana dan siap digunakan.
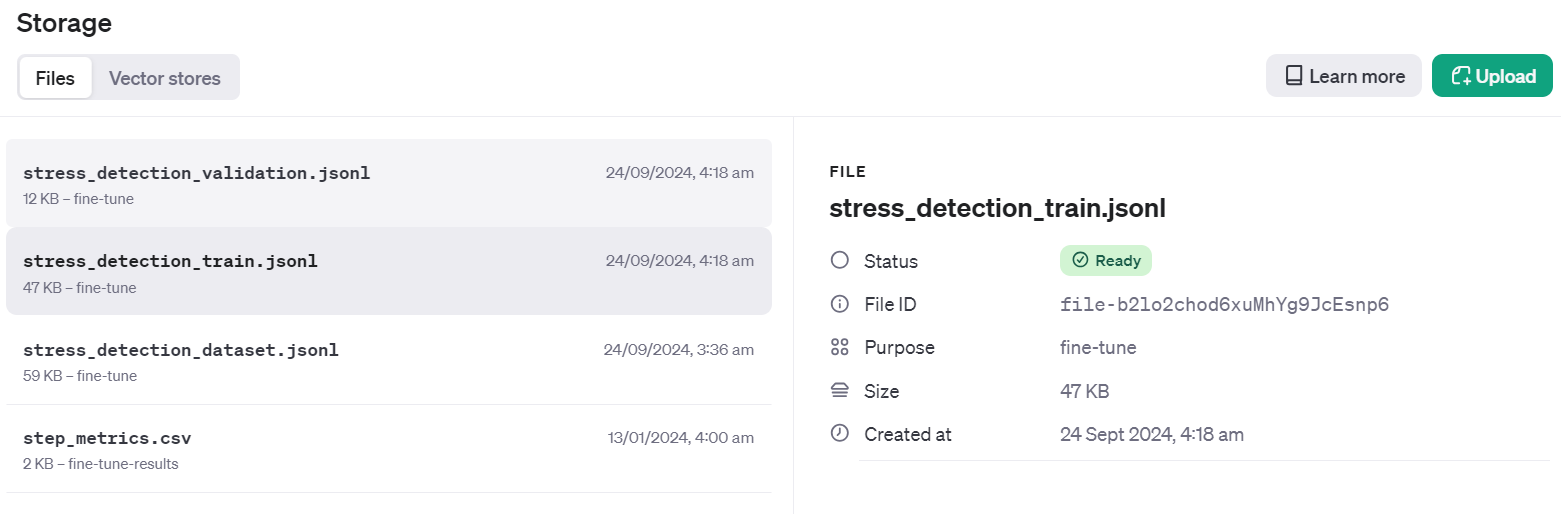
Buat pekerjaan fine-tuning menggunakan client API. Fungsi fine-tuning memerlukan ID berkas dataset pelatihan, ID berkas dataset validasi, nama model, dan hiperparameter. Kita akan melakukan fine-tuning model selama tiga epoch. Untuk meningkatkan kinerja model, Anda selalu dapat melatih pada dataset penuh dengan setidaknya 5 epoch.
model = client.fine_tuning.jobs.create(
  training_file=train_file.id,
  validation_file=valid_file.id,
  model="gpt-4o-mini-2024-07-18",
  hyperparameters={
    "n_epochs": 3,
	"batch_size": 3,
	"learning_rate_multiplier": 0.3
  }
)
job_id = model.id
status = model.status

print(f'Fine-tuning model with jobID: {job_id}.')
print(f"Training Response: {model}")
print(f"Training Status: {status}")
Setelah kita menjalankan fungsi, pekerjaan fine-tuning akan dimulai dan menampilkan log.
Fine-tuning model with jobID: ftjob-rgIMFxZSsWDqCNfOev54e4Jq.
Training Response: FineTuningJob(id='ftjob-rgIMFxZSsWDqCNfOev54e4Jq', created_at=1727135628, error=Error(code=None, message=None, param=None), fine_tuned_model=None, finished_at=None, hyperparameters=Hyperparameters(n_epochs=3, batch_size=3, learning_rate_multiplier=0.3), model='gpt-4o-mini-2024-07-18', object='fine_tuning.job', organization_id='org-jLXWbL5JssIxj9KNgoFBK7Qi', result_files=[], seed=748607710, status='validating_files', trained_tokens=None, training_file='file-b2lo2chod6xuMhYg9JcEsnp6', validation_file='file-Fae0AVSUhTGr49qhQz8d2yyp', estimated_finish=None, integrations=[], user_provided_suffix=None)
Training Status: validating_files
Kita dapat melihat status pekerjaan fine-tuning di dasbor dengan mengklik tab “Fine-tuning” lalu mengklik ID pekerjaan.
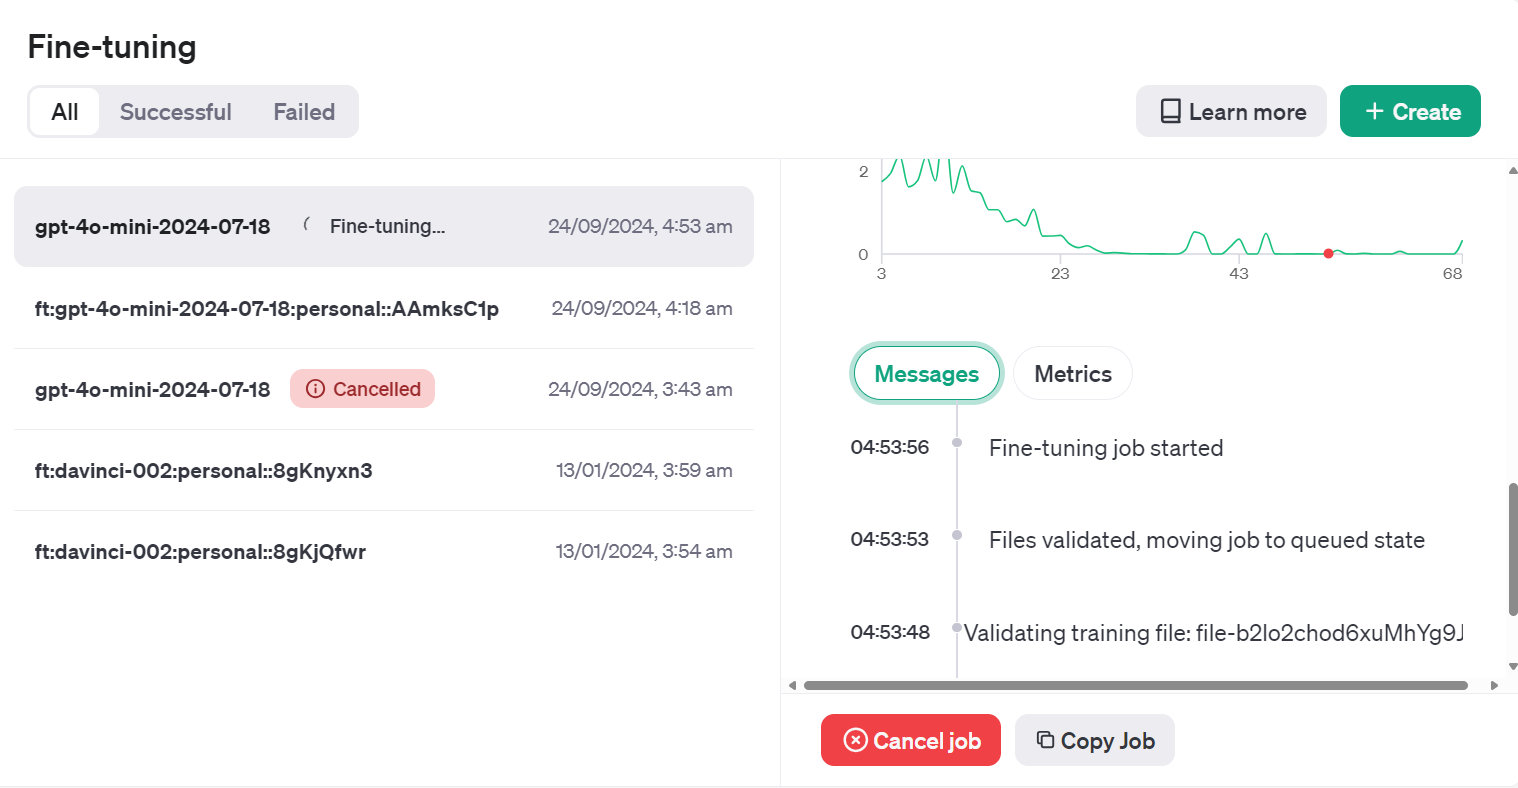
Atau kita dapat memeriksa status pekerjaan fine-tuning menggunakan fungsi jobs.retrieve.
# Retrieve the state of a fine-tune
client.fine_tuning.jobs.retrieve(job_id)
Keluaran:
FineTuningJob(id='ftjob-rgIMFxZSsWDqCNfOev54e4Jq', created_at=1727135628, error=Error(code=None, message=None, param=None), fine_tuned_model=None, finished_at=None, hyperparameters=Hyperparameters(n_epochs=3, batch_size=3, learning_rate_multiplier=0.3), model='gpt-4o-mini-2024-07-18', object='fine_tuning.job', organization_id='org-jLXWbL5JssIxj9KNgoFBK7Qi', result_files=[], seed=748607710, status='running', trained_tokens=None, training_file='file-b2lo2chod6xuMhYg9JcEsnp6', validation_file='file-Fae0AVSUhTGr49qhQz8d2yyp', estimated_finish=1727135943, integrations=[], user_provided_suffix=None)Jika Anda merasa loss tidak menurun, Anda selalu dapat membatalkan pekerjaan menggunakan fungsi jobs.cancel.
# Cancel a job
client.fine_tuning.jobs.cancel(job_id)
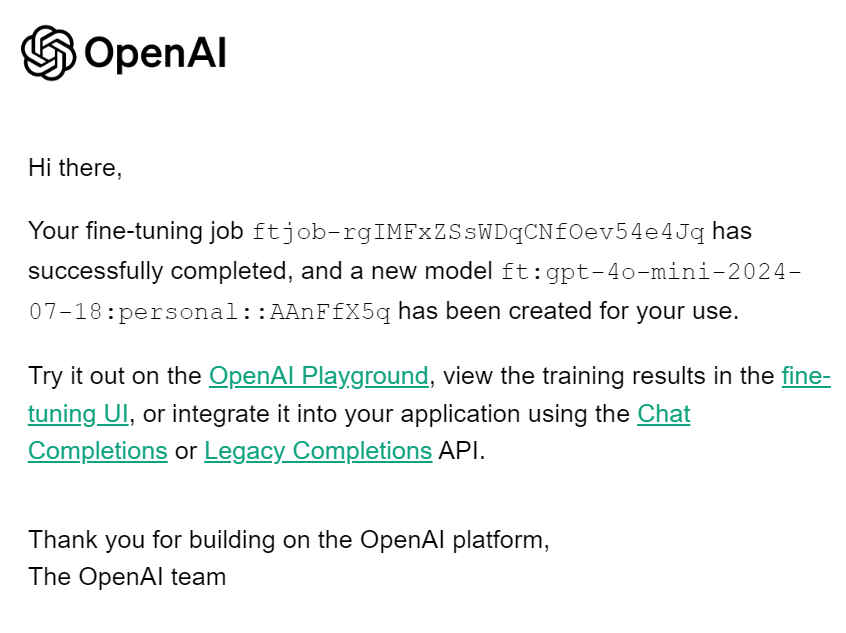
Saat pekerjaan fine-tuning selesai, Anda akan menerima email yang memberi tahu bahwa model hasil fine-tuning siap digunakan.
Untuk mengakses model hasil fine-tuning, kita perlu mendapatkan nama model tersebut. Untuk itu, kita akan mengumpulkan informasi semua pekerjaan fine-tuning, memilih yang terbaru, lalu mengambil nama modelnya.
result = client.fine_tuning.jobs.list()

# Retrieve the fine tuned model
fine_tuned_model = result.data[0].fine_tuned_model
print(fine_tuned_model)
Ini adalah nama model hasil fine-tuning kami.
ft:gpt-4o-mini-2024-07-18:personal::AAnFfX5qHasilkan respons dengan memberikan fungsi chat completion nama model hasil fine-tuning, pesan dengan system prompt yang benar, dan sampel dari dataset.
completion = client.chat.completions.create(
  model = fine_tuned_model,
  messages=[
    {"role": "system", "content": "Given a social media post, classify whether it indicates 'stress' or 'non-stress'."},
    {"role": "user", "content": "Just went to my first homecoming, and they played a song I've always wanted to dance to at an official dance. Sorry for the terrible quality, but my happiness in this moment couldn't be exaggerated!"}
  ]
)
print(completion.choices[0].message.content)
Berhasil! Saya memprediksi label dengan benar.
"non-stress"Jika Anda tidak puas dengan model Anda, Anda selalu dapat menghapusnya menggunakan perintah berikut. Kita tidak akan melakukannya karena kita harus menjalankan evaluasi model tambahan terlebih dahulu.
# Delete a fine-tuned model (must be an owner of the org the model was created in)
client.models.delete(fine_tuned_model)Ada cara lain untuk mengakses model hasil fine-tuning dan mengujinya pada berbagai prompt secara lebih efisien.
Buka dasbor OpenAI, klik tab "Fine-tuning", pilih pekerjaan yang baru dijalankan, lalu klik tombol "Playground" yang berada di kanan bawah.
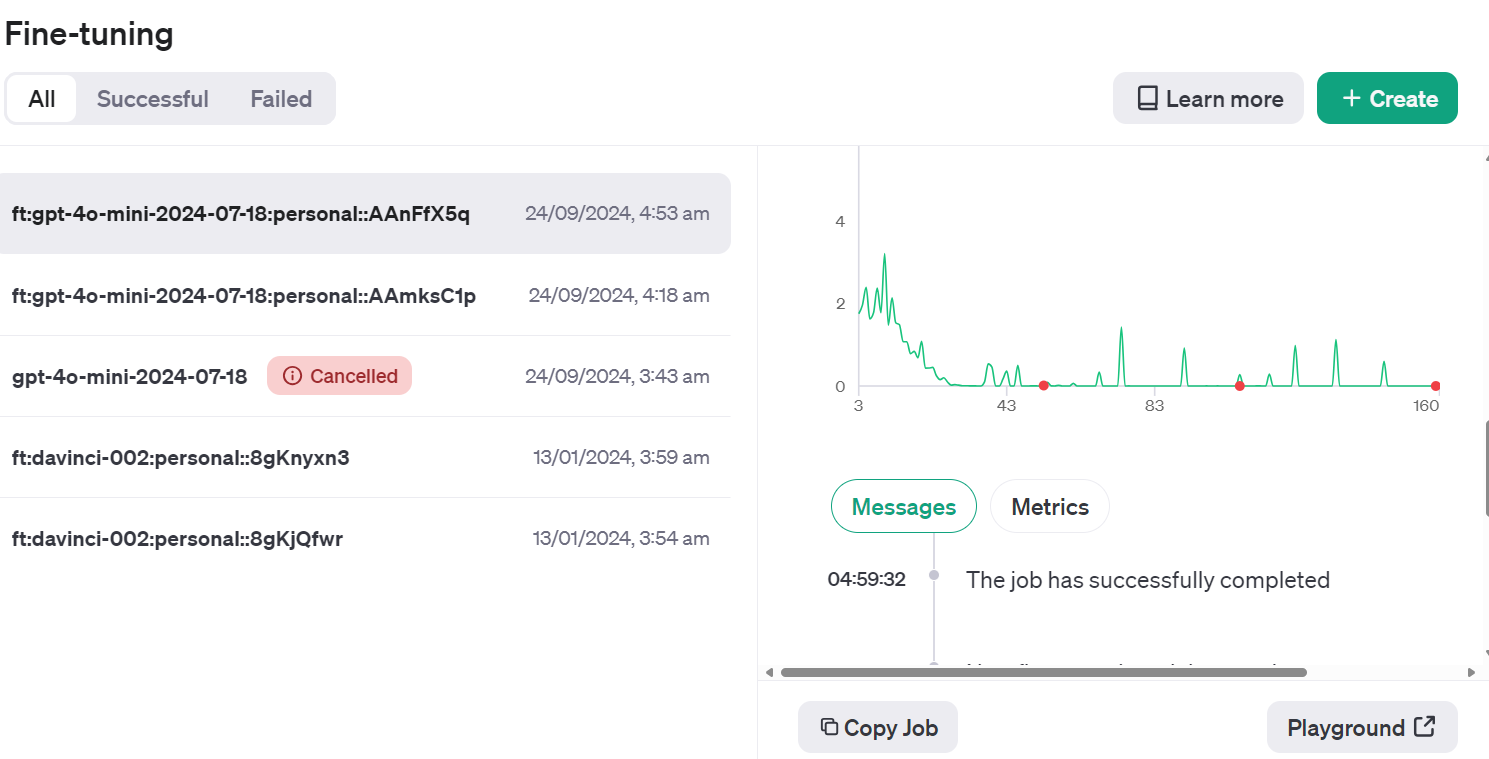
Anda akan diarahkan ke aplikasi chatbot. Di sana, Anda dapat memberikan system prompt dan mulai mengetik sampel postingan Reddit.
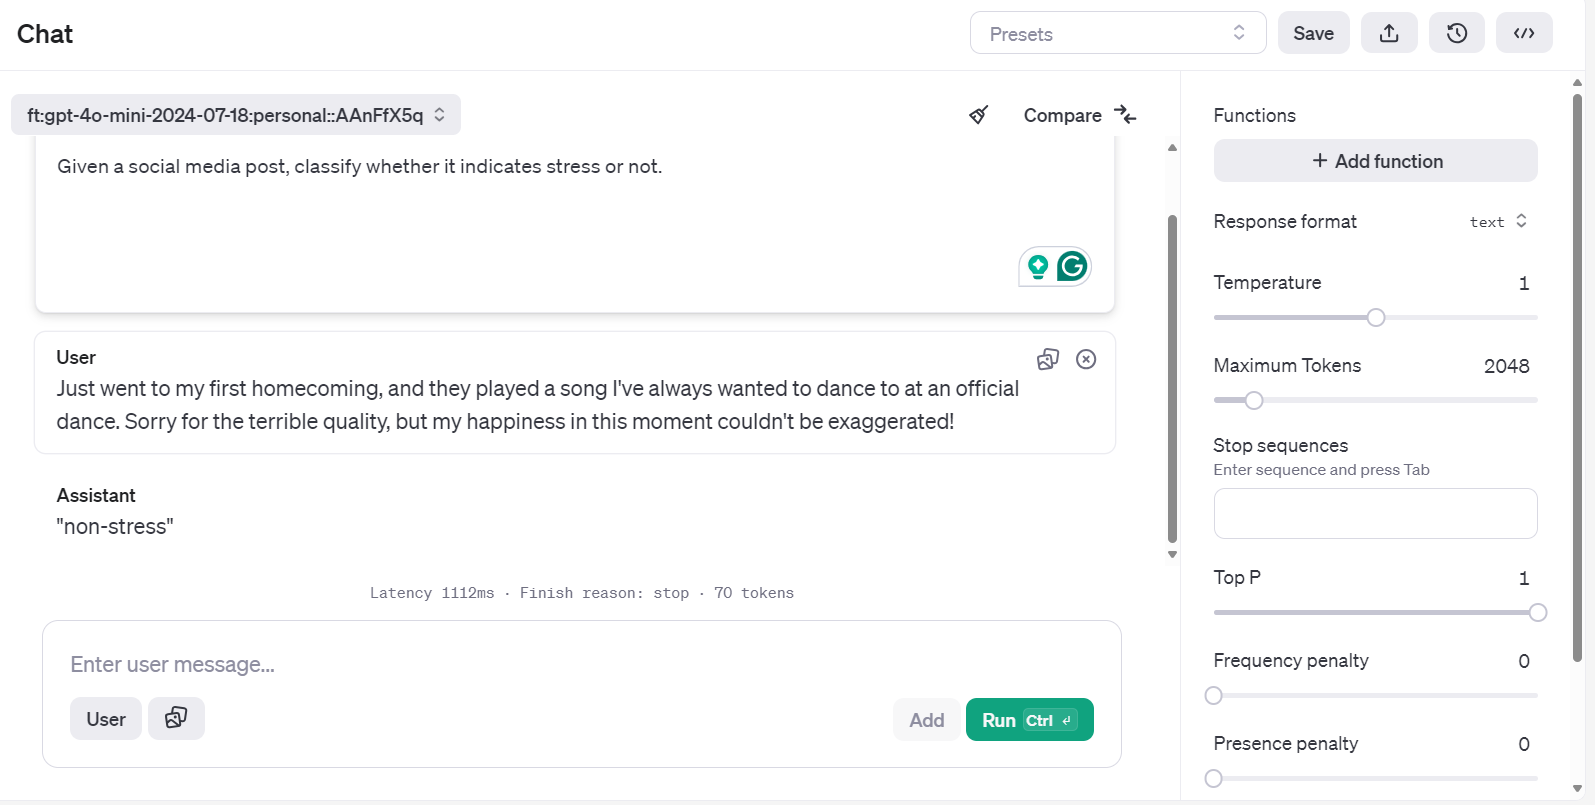
Anda bahkan dapat menjalankan prompt yang sama dan membandingkannya dengan model lain untuk analisis yang lebih baik.
Kita telah melakukan fine-tuning model dan merasa hasilnya cukup baik. Namun apakah Anda mempertimbangkan apakah model sudah lebih baik sejak awal? Kita belum melakukan perbandingan sebelum-dan-sesudah yang mendetail.
Pada bagian ini, kita akan menggunakan data validasi untuk memprediksi label menggunakan model dasar lalu membandingkannya dengan model hasil fine-tuning. Kita akan membandingkan kedua model berdasarkan akurasi, laporan klasifikasi, dan metrik kebingungan (confusion matrix).
Buat fungsi predict yang menerima input dataset dan nama model untuk menghasilkan daftar label prediksi. Fungsi ini menggunakan pesan sistem yang sama dan judul postingan dari dataset.
def predict(test, model):
    y_pred = []
    categories = ["non-stress", "stress"]

    for index, row in test.iterrows():
        response = client.chat.completions.create(
            model=model,
            messages=[
                {
                    "role": "system",
                    "content": "Given a social media post, classify whether it indicates 'stress' or 'non-stress'.",
                },
                {"role": "user", "content": row["title"]},
            ],
        )

        answer = response.choices[0].message.content

        # Determine the predicted category

        for category in categories:
            if category.lower() in answer.lower():
                y_pred.append(category)
                break
        else:
            y_pred.append("none")
    return y_pred
Kemudian, kita akan membuat fungsi evaluate, yang akan menggunakan label prediksi dan label aktual untuk menghasilkan skor akurasi, laporan klasifikasi, dan metrik kebingungan.
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import numpy as np


def evaluate(y_true, y_pred):
    labels = ["non-stress", "stress"]
    mapping = {label: idx for idx, label in enumerate(labels)}

    def map_func(x):
        return mapping.get(
            x, -1
        )  # Map to -1 if not found, but should not occur with correct data

    y_true_mapped = np.vectorize(map_func)(y_true)
    y_pred_mapped = np.vectorize(map_func)(y_pred)

    # Calculate accuracy

    accuracy = accuracy_score(y_true=y_true_mapped, y_pred=y_pred_mapped)
    print(f"Accuracy: {accuracy:.3f}")

    # Generate accuracy report

    unique_labels = set(y_true_mapped)  # Get unique labels

    for label in unique_labels:
        label_indices = [
            i for i in range(len(y_true_mapped)) if y_true_mapped[i] == label
        ]
        label_y_true = [y_true_mapped[i] for i in label_indices]
        label_y_pred = [y_pred_mapped[i] for i in label_indices]
        label_accuracy = accuracy_score(label_y_true, label_y_pred)
        print(f"Accuracy for label {labels[label]}: {label_accuracy:.3f}")
    # Generate classification report

    class_report = classification_report(
        y_true=y_true_mapped,
        y_pred=y_pred_mapped,
        target_names=labels,
        labels=list(range(len(labels))),
    )
    print("\nClassification Report:")
    print(class_report)

    # Generate confusion matrix

    conf_matrix = confusion_matrix(
        y_true=y_true_mapped, y_pred=y_pred_mapped, labels=list(range(len(labels)))
    )
    print("\nConfusion Matrix:")
    print(conf_matrix)
Berikan fungsi predict dataset validasi dan nama model dasar. Lalu, berikan label prediksi dan label aktual ke fungsi evaluate dan hasilkan laporan evaluasi model.
y_pred = predict(validation_data, "gpt-4o-mini-2024-07-18")
y_true = validation_data["label"]
evaluate(y_true, y_pred)
Model dasar kita cukup baik dalam mengklasifikasikan teks. Kita mencapai akurasi 92,5%.
Accuracy: 0.925
Accuracy for label non-stress: 0.947
Accuracy for label stress: 0.905

Classification Report:
              precision    recall  f1-score   support

  non-stress       0.90      0.95      0.92        19
      stress       0.95      0.90      0.93        21

    accuracy                           0.93        40
   macro avg       0.93      0.93      0.92        40
weighted avg       0.93      0.93      0.93        40


Confusion Matrix:
[[18  1]
[ 2 19]]Mari gunakan fungsi predict dengan nama model hasil fine-tuning untuk menghasilkan label stress. Kemudian, kita dapat menggunakan label prediksi dan label aktual untuk menghasilkan laporan evaluasi model yang lebih rinci.
fine_tuned_model = "ft:gpt-4o-mini-2024-07-18:personal::AAnFfX5q"

y_pred = predict(validation_data,fine_tuned_model)
evaluate(y_true, y_pred)
Kinerja model kita meningkat. Kita mencapai akurasi 97,5%, yang menandai peningkatan signifikan.
Accuracy: 0.975
Accuracy for label non-stress: 1.000
Accuracy for label stress: 0.952

Classification Report:
              precision    recall  f1-score   support

  non-stress       0.95      1.00      0.97        19
      stress       1.00      0.95      0.98        21

    accuracy                           0.97        40
   macro avg       0.97      0.98      0.97        40
weighted avg       0.98      0.97      0.98        40


Confusion Matrix:
[[19  0]
 [ 1 20]]
Fine-tuning pada tugas tertentu dapat meningkatkan akurasi secara signifikan. Ini hanya uji coba sampel, tetapi dalam proyek nyata, fine-tuning meningkatkan akurasi dan performa model pada tugas klasifikasi, penataan gaya, dan keluaran terstruktur.
Jika Anda mengalami kendala saat menjalankan kode di atas, silakan merujuk ke workspace DataLab: Fine-tuning GPT-4 Mini.
Langkah berikutnya dalam perjalanan Anda adalah menggunakan model hasil fine-tuning ini untuk membuat aplikasi AI yang tepat. Anda dapat mempelajarinya dengan mengikuti code along: Membuat Asisten AI dengan GPT-4o.
Dalam tutorial ini, kita berhasil melakukan fine-tuning model GPT-4o mini untuk mengklasifikasikan teks menjadi label "stress" dan "non-stress". Kita kemudian mengakses model hasil fine-tuning ini menggunakan OpenAI API dan playground OpenAI, sehingga memungkinkan penerapan praktis dan pengujian lanjutan.
Evaluasi model hasil fine-tuning memberikan hasil yang informatif, menunjukkan peningkatan kinerja klasifikasi pada berbagai metrik dibandingkan model dasar. Proses ini menyoroti nilai fine-tuning dalam mencapai keluaran yang lebih andal dan akurat, terutama saat menangani tugas seperti klasifikasi teks.
Jika Anda ingin menggunakan model sumber terbuka gratis, kami memiliki tutorial yang sangat baik berjudul Fine-tuning Llama 3.2 dan Menggunakannya Secara Lokal: Panduan Langkah demi Langkah. Dalam panduan ini, kami akan menunjukkan cara melakukan fine-tuning model Llama terbaru dan mengonversinya ke format GGUF untuk penggunaan lokal di laptop Anda.
Kursus OpenAI Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt



