
Kursus
Membangun Agen AI dengan Google ADK
1 jam
7.7K
Tim Gemini baru-baru ini memperkenalkan Gemini 2.5 Computer Use, model khusus yang dapat melihat layar langsung dan bertindak di atasnya dengan mengklik, mengetik, menggulir, serta menavigasi web seperti operator manusia.
Dalam panduan ini, kita akan melewati tolok ukur abstrak dan membangun sesuatu yang praktis. Aplikasi Streamlit yang menggunakan Computer Use untuk mengendalikan browser nyata, menelusuri Google untuk lowongan kerja, menerapkan filter, dan mengekspor hasil ke CSV tanpa API pencarian pihak ketiga.
Dalam tutorial ini, Anda akan mempelajari cara:
Di akhir, Anda akan memiliki agen pencari kerja yang mengkurasi lowongan kerja secara akurat untuk Anda.
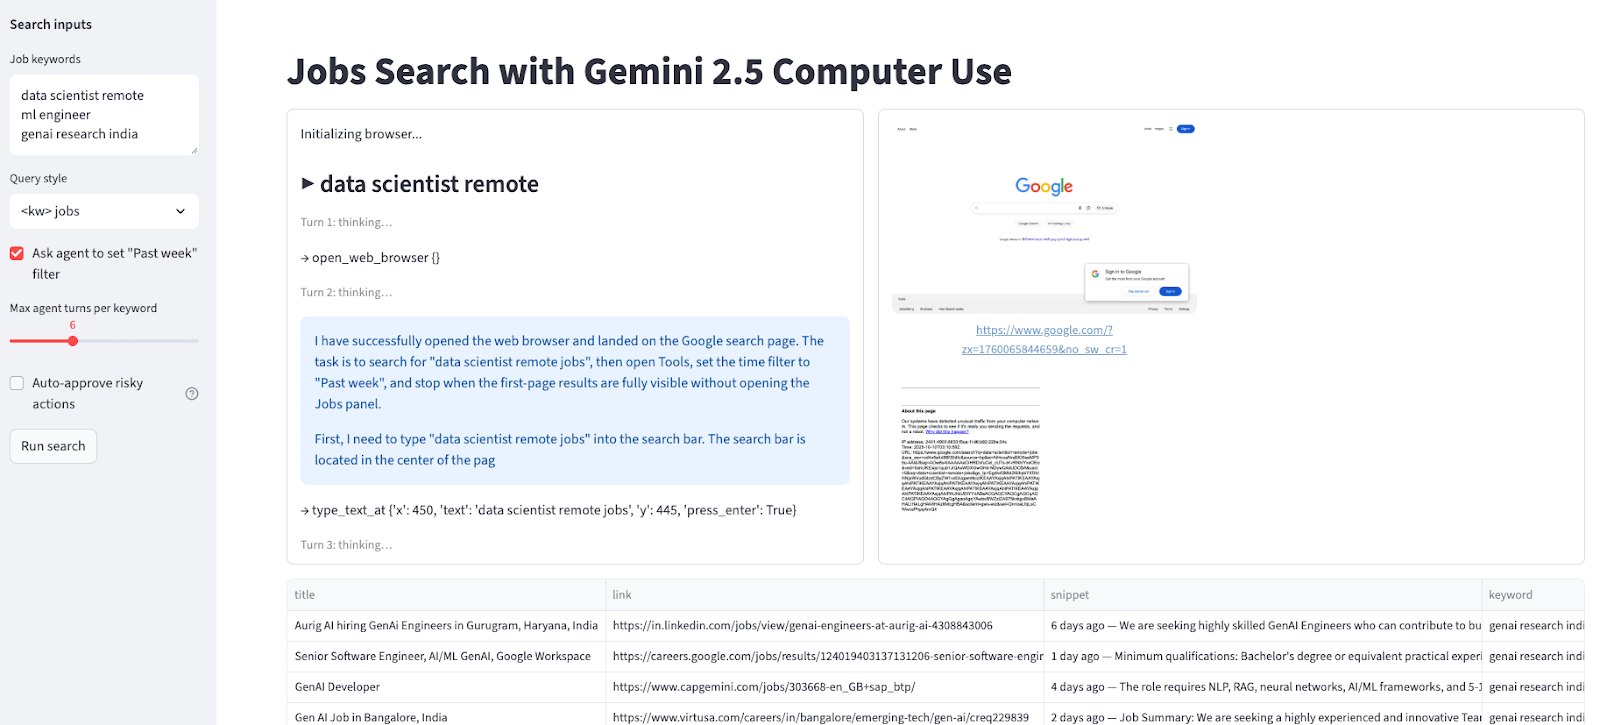
Jika Anda ingin mempelajari lebih lanjut tentang Gemini 2.5, saya sarankan membaca tutorial Gemini 2.5 Pro kami, yang membahas fitur, pengujian, akses, tolok ukur, dan lainnya. Anda juga sebaiknya mempelajari Gemini 3 Pro, model terbaru dari Google.
Gemini 2.5 Computer Use adalah model (pratinjau) khusus dan alat dalam Gemini API yang memungkinkan Anda membangun agen pengendali browser. Alih-alih memanggil API khusus situs, model bekerja dari tangkapan layar. Ia dapat melihat apa yang ada di halaman lalu bertindak dengan mengeluarkan aksi UI seperti navigate, click_at, scroll_document, dll.
Kode klien menerima aksi yang diusulkan, mengeksekusinya, dan mengirim kembali kombinasi baru tangkapan layar dan URL agar model dapat menentukan langkah berikutnya.
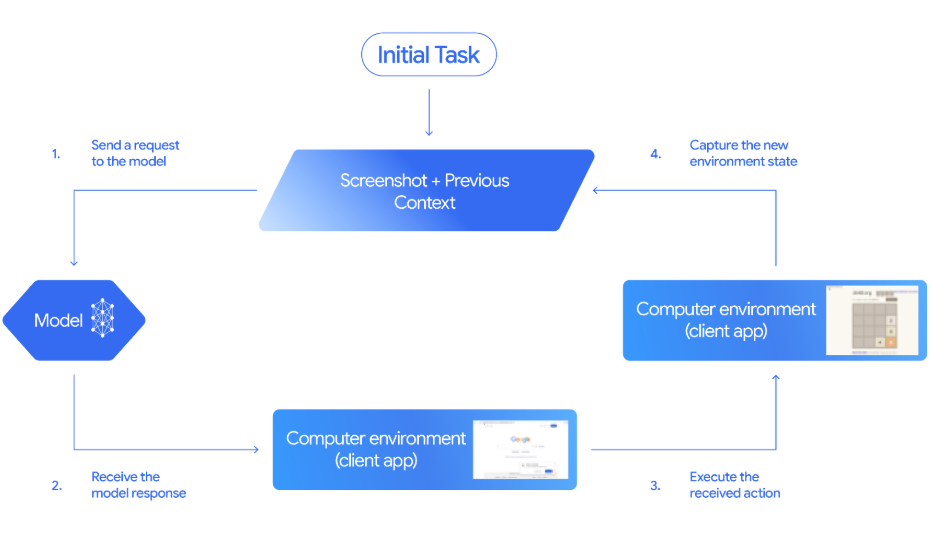
Sumber: Dokumentasi Gemini
Berikut cara kerja loop agen di atas dari awal hingga akhir:
click_at atau type_text_at) serta keputusan keamanan.FunctionResponse yang berisi tangkapan layar baru dan URL saat ini.lihat–putuskan–bertindak–amati ini hingga tugas selesai, terjadi kesalahan, atau pengguna/model memilih untuk berhenti.Di bagian ini, kita akan membangun agen pencarian kerja bertenaga Streamlit yang mengendalikan browser nyata menggunakan Gemini 2.5 Computer Use dan Playwright, lalu mengekspor hasil ke CSV.
Begini cara kerjanya:
Di balik layar, aplikasi menerapkan domain daftar izin untuk navigasi aman, mendukung konfirmasi manusia opsional untuk langkah berisiko, dan menggunakan loop Computer Use untuk debug yang mudah.
Beberapa penggunaan bertanggung jawab dan kebijakan situs meliputi:
Pertama, pastikan Anda telah memasang impor berikut:
python -m venv .venv && source .venv/bin/activate
pip install streamlit google-genai playwright python-dotenv
playwright install chromium
Perintah di atas menyiapkan virtual environment dan memasang semua dependensi inti yang diperlukan untuk membangun aplikasi, yaitu Streamlit untuk UI, google-genai untuk memanggil Gemini API, Playwright untuk otomatisasi browser, dan python-dotenv untuk memuat variabel lingkungan serta Chromium untuk Playwright.
Sekarang dependensi sudah terpasang, berikutnya kita menyiapkan Kunci API Gemini dari AI Studio.
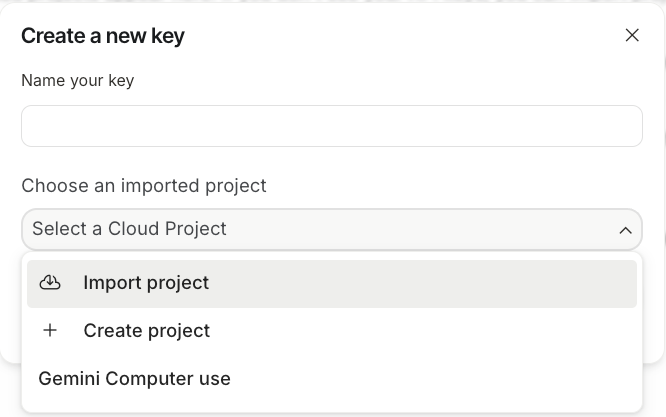
Sekarang, buat file .env di folder proyek Anda dan tambahkan Kunci API Anda di sana:
GOOGLE_API_KEY=YOUR_REAL_KEY
ALLOWED_HOSTS=google.com
Paket python-dotenv akan memuat GOOGLE_API_KEY saat runtime sehingga aplikasi dapat memanggil model Gemini 2.5 Computer Use.
Sekarang, mari mempersiapkan runtime, termasuk impor, konstanta, ID model, dan autentikasi. Ini memastikan aplikasi terhubung ke Gemini dan navigasi tetap aman dalam domain daftar izin.
import os, io, time, csv, base64, urllib.parse
from typing import List, Dict, Tuple
import streamlit as st
from dotenv import load_dotenv
from playwright.sync_api import sync_playwright
from google import genai
from google.genai import types
from google.genai.types import Content, Part
W, H = 1440, 900
MODEL = "gemini-2.5-computer-use-preview-10-2025"
load_dotenv()
API_KEY = os.getenv("GOOGLE_API_KEY")
if not API_KEY:
    st.stop()
ALLOWED_HOSTS = {h.strip().lower() for h in os.getenv("ALLOWED_HOSTS", "google.com").split(",") if h.strip()}
client = genai.Client(api_key=API_KEY)
Kita mulai dengan mengimpor pustaka inti seperti Streamlit, Playwright, google-genai, dan utilitas kecil (dotenv, os, io, csv, time, urllib) untuk konfigurasi dan I/O.
Viewport tetap (W, H = 1440 × 900) menjaga konsistensi tangkapan layar dan pemetaan koordinat untuk Computer Use, dan model pratinjau disetel ke gemini-2.5-computer-use-preview-10-2025.
Kunci API dimuat dengan load_dotenv() dan os.getenv("GOOGLE_API_KEY"). Navigasi diatur oleh daftar izin (default google.com) demi keamanan.
Terakhir, genai.Client(api_key=API_KEY) menginisialisasi SDK Gemini sehingga aplikasi dapat menjalankan loop agen dan merender hasil di Streamlit.
Sebelum lanjut ke inti aplikasi, kita perlu menyiapkan beberapa fungsi pembantu. Fungsi-fungsi ini membantu pemeriksaan keamanan, konversi koordinat, mengeksekusi aksi untuk pemanggilan fungsi Gemini, pengambilan SERP, dan mengekspor hasil sebagai CSV.
Kita mulai dengan menambahkan pembantu backend yang mendukung kendali browser yang aman. Ini mencakup fungsi pemeriksaan domain daftar izin untuk membatasi navigasi, fungsi konverter koordinat untuk memetakan grid 0–999 milik model ke viewport tetap, dan fungsi dispatcher aksi yang menafsirkan pemanggilan fungsi Computer Use dan mengeksekusinya melalui Playwright.
def host_allowed(url: str) -> bool:
    try:
        netloc = urllib.parse.urlparse(url).netloc.lower()
        return any(netloc.endswith(allowed) for allowed in ALLOWED_HOSTS)
    except Exception:
        return False
def denorm(v: int, size: int) -> int:
    return int(v/1000*size)
def exec_calls(candidate, page, viewport, *, approve_all=False) -> List[Tuple[str, Dict]]:
    W, H = viewport
    results = []
    for part in candidate.content.parts:
        fc = getattr(part, "function_call", None)
        if not fc:
            continue
        name, args = fc.name, (fc.args or {})
        sd = args.get("safety_decision")
        if sd and sd.get("decision") == "require_confirmation":
            reason = sd.get("explanation", "Model flagged a risky action.")
            log_box.warning(f"[SAFETY requires confirmation] {reason}")
            if not approve_all:
                st.stop()
            results.append((name, {"safety_acknowledgement": "true"}))
        if name == "navigate":
            target = args.get("url", "")
            if target and not host_allowed(target):
                log_box.error(f"[BLOCKED] Non-allowlisted host: {target}")
                results.append((name, {"error": "blocked_by_allowlist"}))
                continue
        try:
            if name == "open_web_browser":
                pass
            elif name == "navigate":
                page.goto(args["url"], timeout=30000)
            elif name == "search":
                page.goto("https://www.google.com", timeout=30000)
            elif name == "click_at":
                page.mouse.click(denorm(args["x"], W), denorm(args["y"], H))
            elif name == "hover_at":
                page.mouse.move(denorm(args["x"], W), denorm(args["y"], H))
            elif name == "type_text_at":
                x, y = denorm(args["x"], W), denorm(args["y"], H)
                page.mouse.click(x, y)
                if args.get("clear_before_typing", True):
                    page.keyboard.press("Meta+A"); page.keyboard.press("Backspace")
                page.keyboard.type(args["text"])
                if args.get("press_enter", True):
                    page.keyboard.press("Enter")
            elif name == "scroll_document":
                page.mouse.wheel(0, 800 if args["direction"] == "down" else -800)
            elif name == "key_combination":
                page.keyboard.press(args["keys"])
            page.wait_for_load_state("networkidle", timeout=10000)
            results.append((name, {}))
            time.sleep(0.6)
        except Exception as e:
            results.append((name, {"error": str(e)}))
    return results
Mari pahami bagaimana tiap fungsi terpasang dalam pipeline:
host_allowed() function: Fungsi ini mengurai URL target, menormalkan nama host ke huruf kecil, dan memeriksa apakah diakhiri dengan domain mana pun di ALLOWED_HOSTS yang tercantum di file .env. denorm() function: Utilitas ini mengonversi koordinat penunjuk ke satuan piksel aktual untuk viewport saat ini. Ini krusial untuk klik, hover, dan pengetikan yang presisi, khususnya saat Anda mengubah ukuran layar atau menjalankan headless.exec_calls() function: Terakhir, fungsi eksekusi panggilan memindai respons model untuk pemanggilan fungsi dan mengirimkannya ke Playwright. Fungsi ini memblokir panggilan navigasi ke host yang tidak ada dalam daftar izin, mengeksekusi aksi yang didukung, menunggu jaringan idle untuk menstabilkan halaman, dan mencatat hasil per-aksi (termasuk error). Hasil ini kemudian digunakan pada langkah berikutnya untuk menyusun FunctionResponses kembali ke model.Bersama-sama, fungsi-fungsi ini menegakkan batasan, menjaga akurasi perhitungan penunjuk, dan mencatat hasil secara rinci.
Setelah mengeksekusi aksi, agen membutuhkan umpan balik untuk menentukan langkah berikutnya dan mengembalikan keluaran yang berguna. Langkah ini menyediakan tiga fungsi pembantu sebagai berikut:
def fr_from(page, results):
    shot = page.screenshot(type="png")
    url = page.url
    frs = []
    for name, result in results:
        frs.append(types.FunctionResponse(
            name=name,
            response={"url": url, **result},
            parts=[types.FunctionResponsePart(
                inline_data=types.FunctionResponseBlob(mime_type="image/png", data=shot)
            )]
        ))
    return frs, shot
def scrape_google_serp(page, max_items=10):
    items = []
    anchors = page.locator('div#search a:has(h3)')
    count = min(anchors.count(), max_items)
    for i in range(count):
        a = anchors.nth(i)
        title = a.locator('h3').inner_text()
        link = a.get_attribute('href')
        snippet = ""
        snips = page.locator('div#search .VwiC3b')
        if snips.count() > i:
            snippet = snips.nth(i).inner_text()
        items.append({"title": title, "link": link, "snippet": snippet})
    return items
def to_csv_download(rows: List[Dict], name="results.csv"):
    if not rows:
        return None
    out = io.StringIO()
    writer = csv.DictWriter(out, fieldnames=["keyword", "title", "link", "snippet"])
    writer.writeheader(); writer.writerows(rows)
    b = out.getvalue().encode("utf-8")
    href = f"data:text/csv;base64,{base64.b64encode(b).decode()}"
    st.download_button("Download CSV", data=b, file_name=name, mime="text/csv")
Mari lihat cara kerja masing-masing fungsi pembantu pasca-aksi:
fr_from() function: Fungsi ini menangkap tangkapan layar PNG terbaru dan URL saat ini, lalu membangun FunctionResponse untuk setiap aksi yang dieksekusi. Ini menyematkan konteks visual untuk giliran inferensi berikutnya dan mempertahankan jejak audit atas apa yang terjadi.scrape_google_serp() function: Berikutnya, kita mengekstrak judul, tautan, dan cuplikan dari halaman hasil pertama Google menggunakan selektor andal seperti a:has(h3) untuk judul/tautan dan .VwiC3b untuk cuplikan. Pengambil membatasi hasil pada max_items dan mengembalikan baris terstruktur yang rapi siap untuk analisis atau ekspor.to_csv_download() function: Fungsi ini menghasilkan CSV dalam memori dengan header yang konsisten dan menyediakannya melalui fungsi download_button() milik Streamlit.Sekarang semua fungsi pembantu sudah siap, berikutnya kita dapat membangun aplikasi Streamlit di atasnya.
Langkah ini menghubungkan UI Streamlit ke loop agen Computer Use. UI merender antarmuka, mengelola cara pengguna berinteraksi dengan agen, dan memastikan keluaran sesuai kebutuhan mereka.
st.set_page_config(page_title="Jobs Search with Gemini Computer Use", layout="wide")
st.title("Jobs Search with Gemini 2.5 Computer Use")
with st.sidebar:
    st.markdown("**Search inputs**")
    default_kw = "data scientist remote\nml engineer \ngenai research india"
    kw_text = st.text_area("Job keywords", value=default_kw, height=120)
    query_mode = st.selectbox("Query style", ["<kw> jobs", 'site:linkedin.com/jobs "<kw>"'], index=0)
    use_past_week = st.checkbox('Ask agent to set "Past week" filter', value=True)
    turns = st.slider("Max agent turns per keyword", 3, 12, 6)
    auto_confirm = st.checkbox("Auto-approve risky actions", value=False, help="If model requests confirmation (e.g., CAPTCHA), auto-approve instead of pausing.")
    run_btn = st.button("Run search")
log_col, shot_col = st.columns([0.45, 0.55])
log_box = log_col.container(height=520)
shot_box = shot_col.container(height=520)
table_box = st.container()
if run_btn:
    keywords = [k.strip() for k in kw_text.splitlines() if k.strip()]
    all_rows = []
    log_box.write("Initializing browser...")
    pw = sync_playwright().start()
    browser = pw.chromium.launch(headless=False)
    ctx = browser.new_context(viewport={"width": W, "height": H})
    page = ctx.new_page()
    try:
        for kw in keywords:
            log_box.subheader(f"▶ {kw}")
            page.goto("https://www.google.com", timeout=30000)
            initial_shot = page.screenshot(type="png")
            base_query = f'{kw} jobs' if query_mode == "<kw> jobs" else f'site:linkedin.com/jobs "{kw}"'
            goal = (
                f'Search Google for "{base_query}". '
                f'{"Open Tools and set time filter to Past week. " if use_past_week else ""}'
                'Stop when first-page results are fully visible; do NOT open the Jobs panel.'
            )
            contents = [Content(role="user", parts=[Part(text=goal), Part.from_bytes(data=initial_shot, mime_type="image/png")])]
            cfg = types.GenerateContentConfig(
                tools=[types.Tool(computer_use=types.ComputerUse(
                    environment=types.Environment.ENVIRONMENT_BROWSER
                ))]
            )
            for turn in range(turns):
                log_box.caption(f"Turn {turn+1}: thinking…")
                resp = client.models.generate_content(model=MODEL, contents=contents, config=cfg)
                cand = resp.candidates[0]
                contents.append(cand.content)
                narr = " ".join([p.text for p in cand.content.parts if getattr(p, "text", None)])
                if narr:
                    log_box.info(narr[:400])
                fcs = [p.function_call for p in cand.content.parts if getattr(p, "function_call", None)]
                if not fcs:
                    log_box.success("Agent stopped proposing actions.")
                    break
                for fc in fcs:
                    log_box.write(f"→ {fc.name} {fc.args or {}}")
                results = exec_calls(cand, page, (W, H), approve_all=auto_confirm)
                frs, shot = fr_from(page, results)
                contents.append(Content(role="user", parts=[Part(function_response=fr) for fr in frs]))
                shot_box.image(shot, caption=page.url, width='stretch')
            rows = scrape_google_serp(page)
            for r in rows:
                r["keyword"] = kw
            all_rows.extend(rows)
            log_box.success(f"{kw}: collected {len(rows)} results")
        if all_rows:
            table_box.dataframe(all_rows, width='stretch')
            to_csv_download(all_rows, name="jobs_google_results.csv")
        else:
            st.warning("No rows collected. Try fewer keywords or fewer turns.")
    finally:
        browser.close()
        pw.stop()
Mari pahami pipeline ini secara detail:
Untuk menjalankan aplikasi ini, cukup jalankan perintah bash berikut di terminal Anda:
python -m streamlit run app.pyTip: Selalu jalankan Streamlit dari venv Anda untuk menghindari masalah “ModuleNotFoundError”.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



