Last chance! 50% off DataCamp Premium
Sale ends in
Beberapa waktu lalu, komputer berfungsi seperti pustakawan yang efisien tetapi harfiah. Jika Anda mencari "pertarungan robot raksasa," mereka hanya akan menemukan judul dengan kata-kata persis itu. Kecocokan sempurna seperti "Kaiju Mech Warfare" akan terlewat. Komputer mengenali kata-kata tetapi melewatkan musiknya—mereka kekurangan pemahaman, nuansa, dan konteks. Itulah era pencarian berbasis kata kunci, yang menjadi opsi terbaik kita selama bertahun-tahun.
Lalu datanglah sebuah revolusi. Terinspirasi dari otak manusia, kecerdasan buatan mengembangkan cara baru untuk belajar. Alih-alih sekadar menghafal kata, AI mulai memahami hubungan di antaranya. Dipahami bahwa "king" berelasi dengan "man" sebagaimana "queen" berelasi dengan "woman." AI mengenali bahwa "happy," "joyful," dan "ecstatic" berada dalam wilayah emosi yang sama, sementara "sombre" berada di ranah yang sama sekali berbeda.
Bagaimana AI mewujudkan ini? Dengan membuat sebuah peta makna.
Bayangkan sebuah galaksi multi-dimensi yang luas di mana setiap konsep—sebuah kata, kalimat, gambar, lagu—adalah bintang. Di galaksi ini, bintang-bintang dengan makna serupa berkelompok, sementara yang tidak berhubungan berada sangat berjauhan.
Sebuah vector embedding hanyalah koordinat sebuah bintang di galaksi ini. Itu adalah daftar angka (misalnya, [0.12, -0.45, 0.89, ...]) yang tepat menunjukkan posisi sebuah konsep pada peta makna ini.
Pencarian vektor adalah kemampuan revolusioner untuk menavigasi peta ini. Saat Anda bertanya, "sebuah film tentang anak yatim yang mengetahui bahwa dia adalah penyihir," kita tidak mencari kata kunci persis itu. Sebagai gantinya, kita:
Bintang-bintang terdekat mewakili hasil yang paling mirip secara semantik. Inilah cara AI berevolusi dari pustakawan yang harfiah menjadi penasihat bijak yang memahami apa yang sebenarnya Anda maksud.
Mencari berdasarkan makna alih-alih kata kunci mendorong aplikasi AI modern di berbagai industri. Kapabilitas ini memungkinkan:
Pencarian vektor menjembatani niat manusia dan data digital, secara fundamental mengubah cara kita berinteraksi dengan informasi. Teknologi ini membuat sistem digital terasa kurang mekanis dan lebih seperti kolaborator yang intuitif.
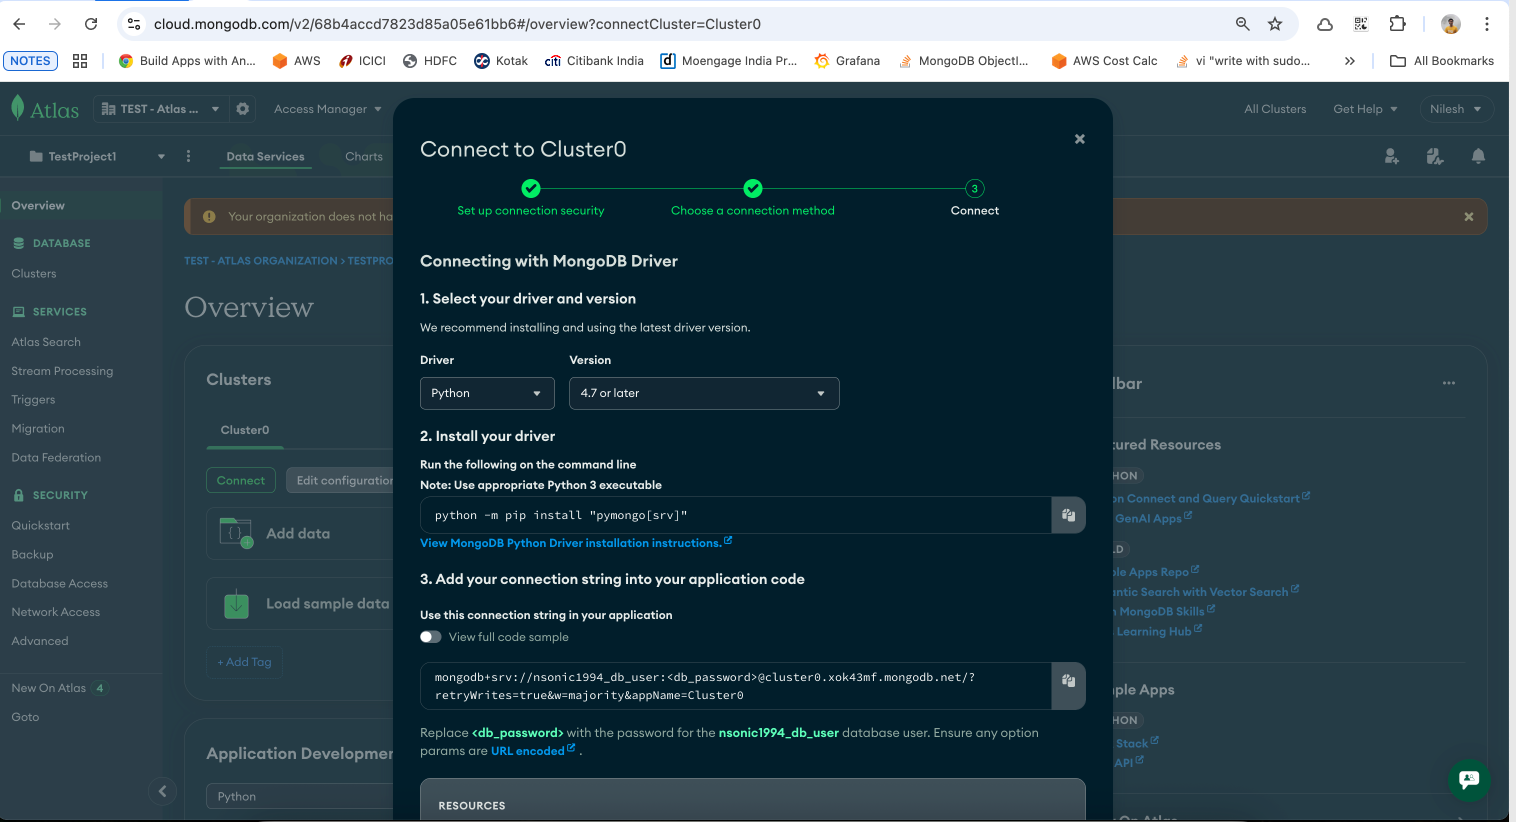
Selamat datang di garis depan baru pencarian! MongoDB memperkenalkan Vector Search di Atlas. Ini memungkinkan Anda menyimpan dan melakukan query terhadap vector embedding (seperti dari teks, gambar, atau audio) langsung di dalam MongoDB—tidak perlu basis data vektor terpisah seperti Pinecone atau Weaviate.
Dalam tutorial ini, kita akan membangun mesin rekomendasi sepatu yang sederhana namun bertenaga menggunakan Python dan MongoDB Atlas. Anda akan belajar bagaimana mengubah teks menjadi representasi numerik yang bermakna (vektor) dan kemudian menggunakan Vector Search bawaan Atlas untuk menemukan film dengan alur yang serupa.
pip install pymongo sentence-transformers numpy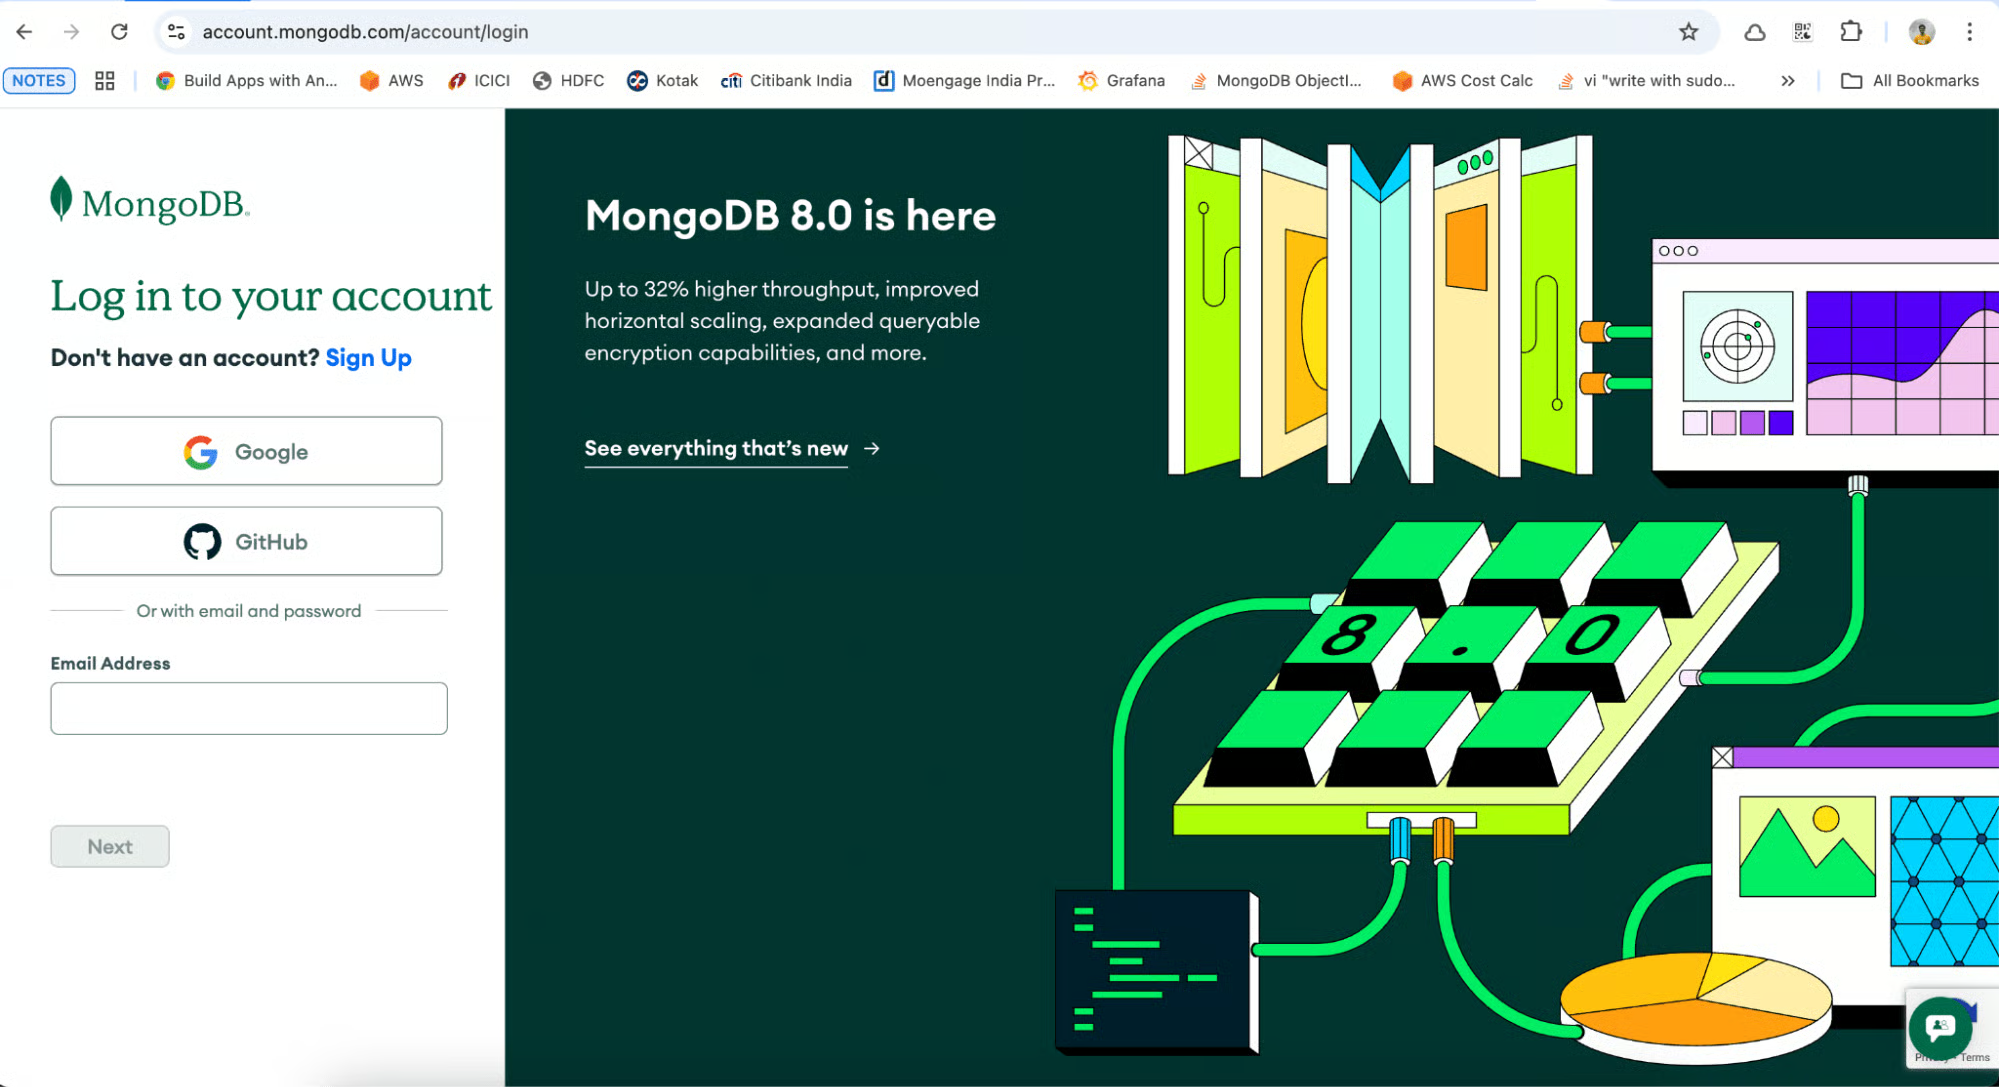
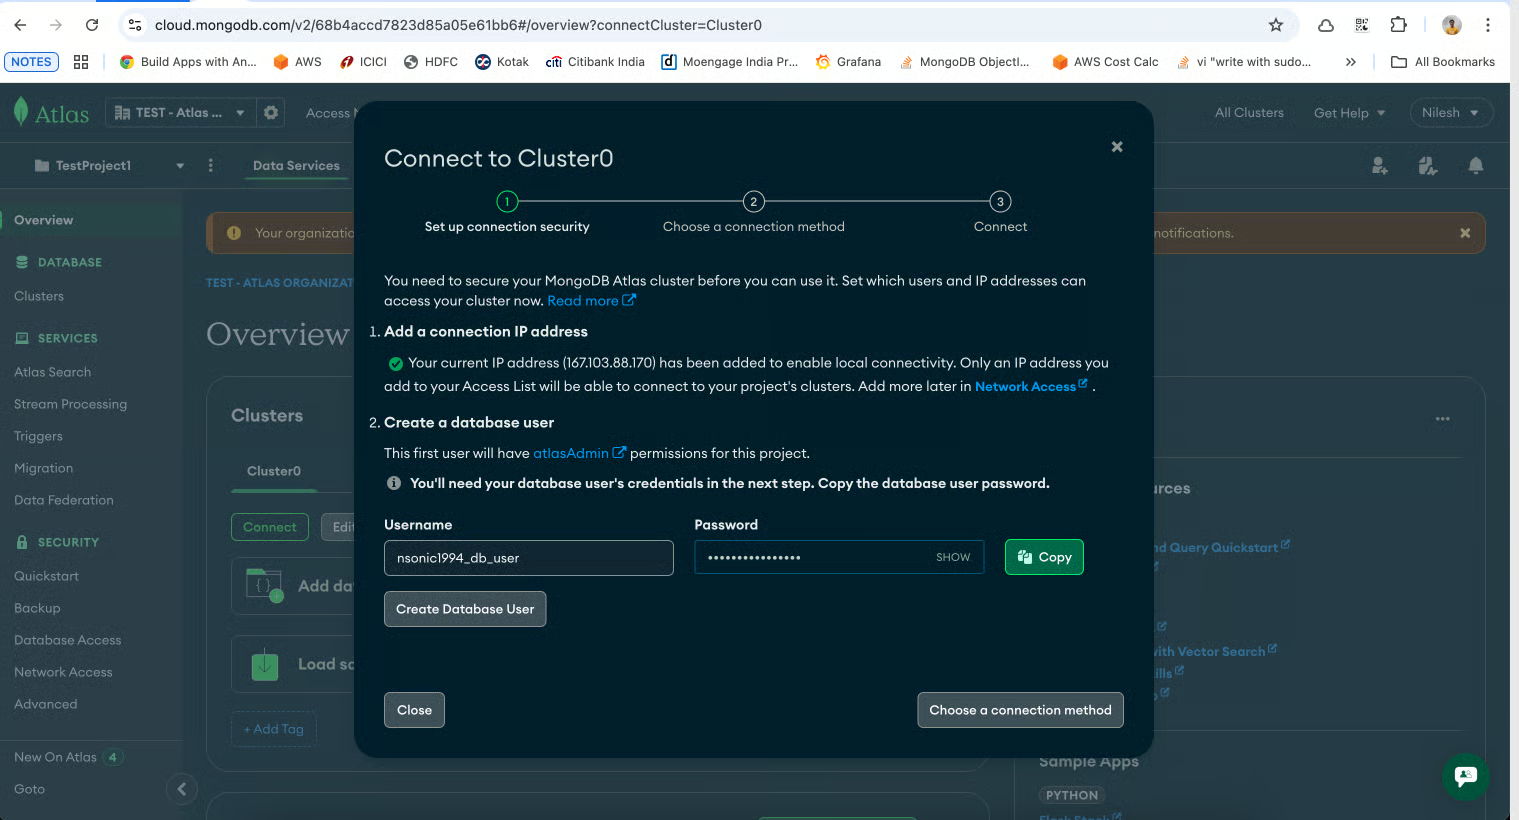
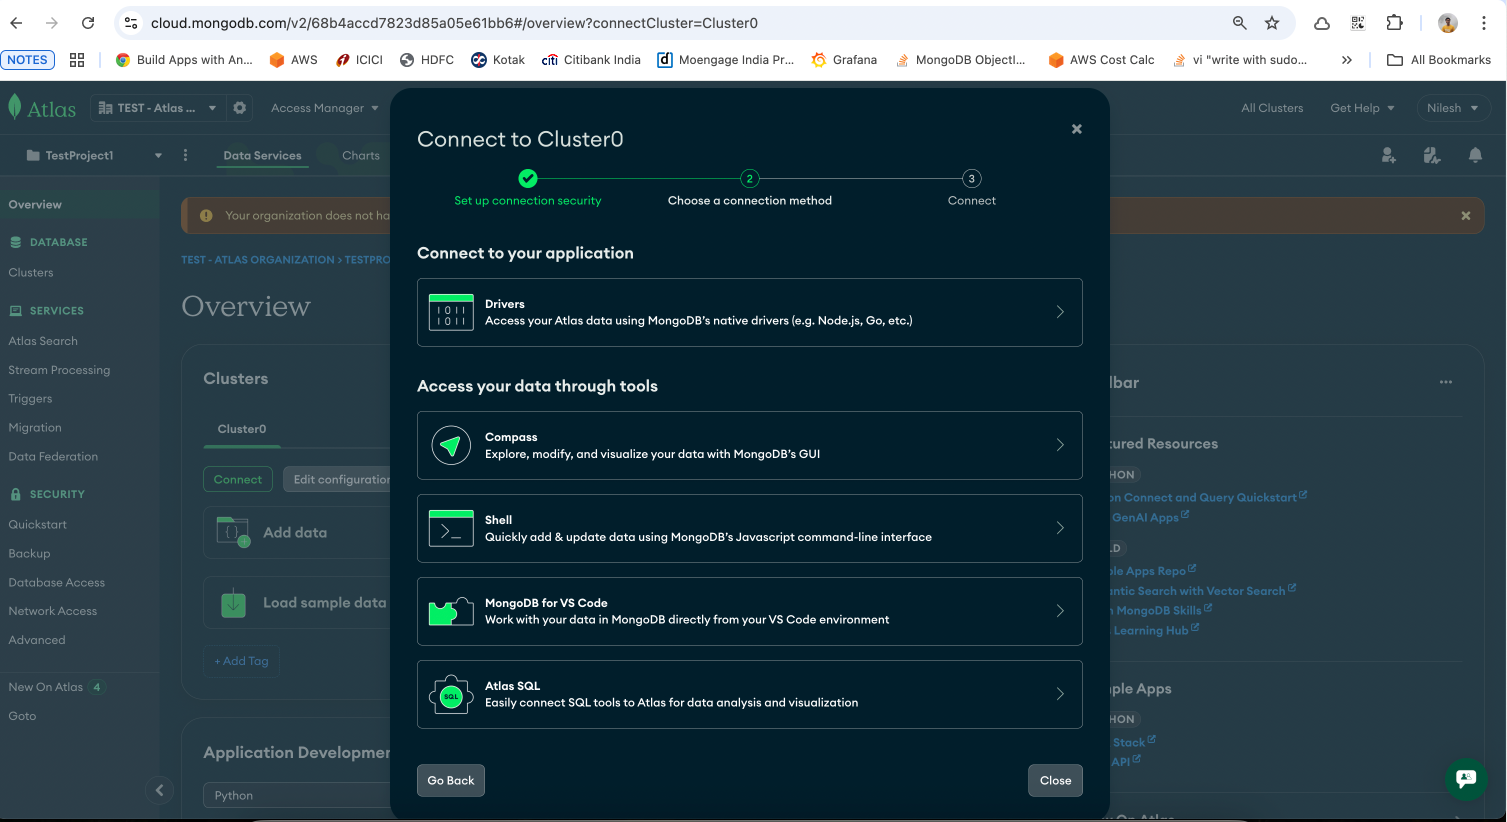
vectorDemoitems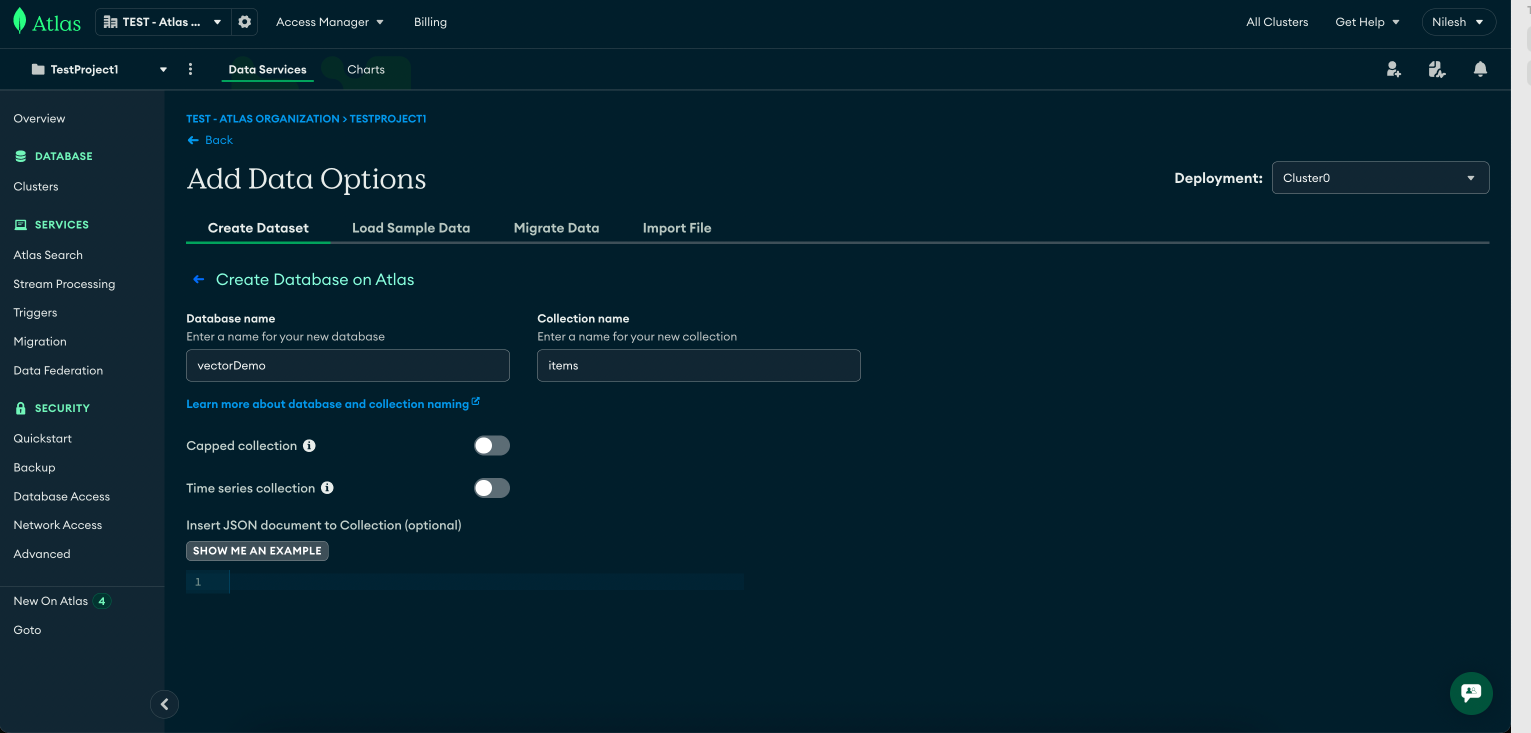
items.{
"fields": [
{
"type": "vector",
"path": "embedding",
"numDimensions": 768,
"similarity": "cosine"
}
]
}
Catatan: 768 adalah ukuran embedding yang akan kita gunakan dengan model sentence-transformers.
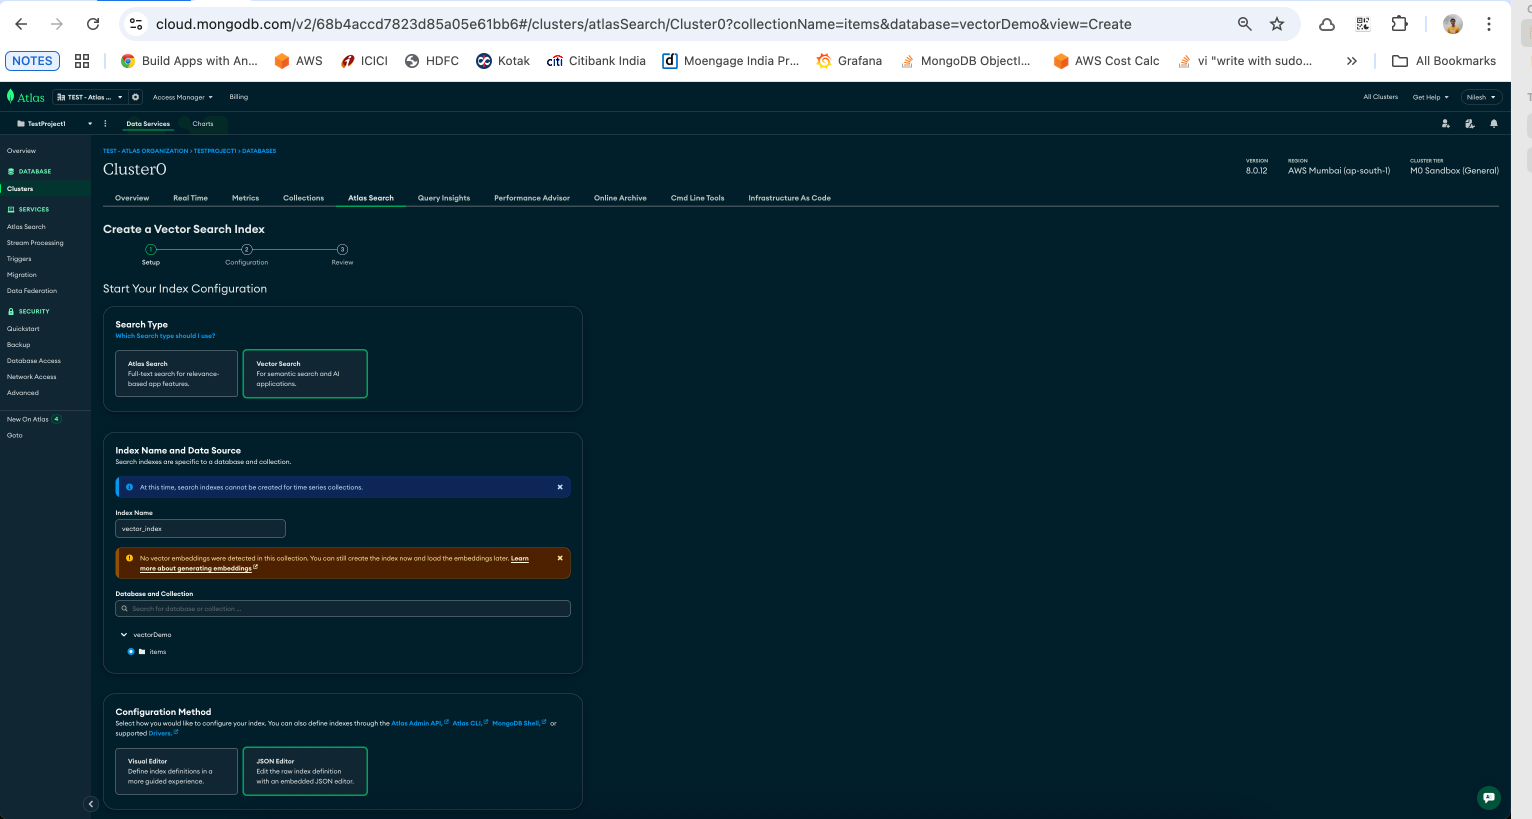
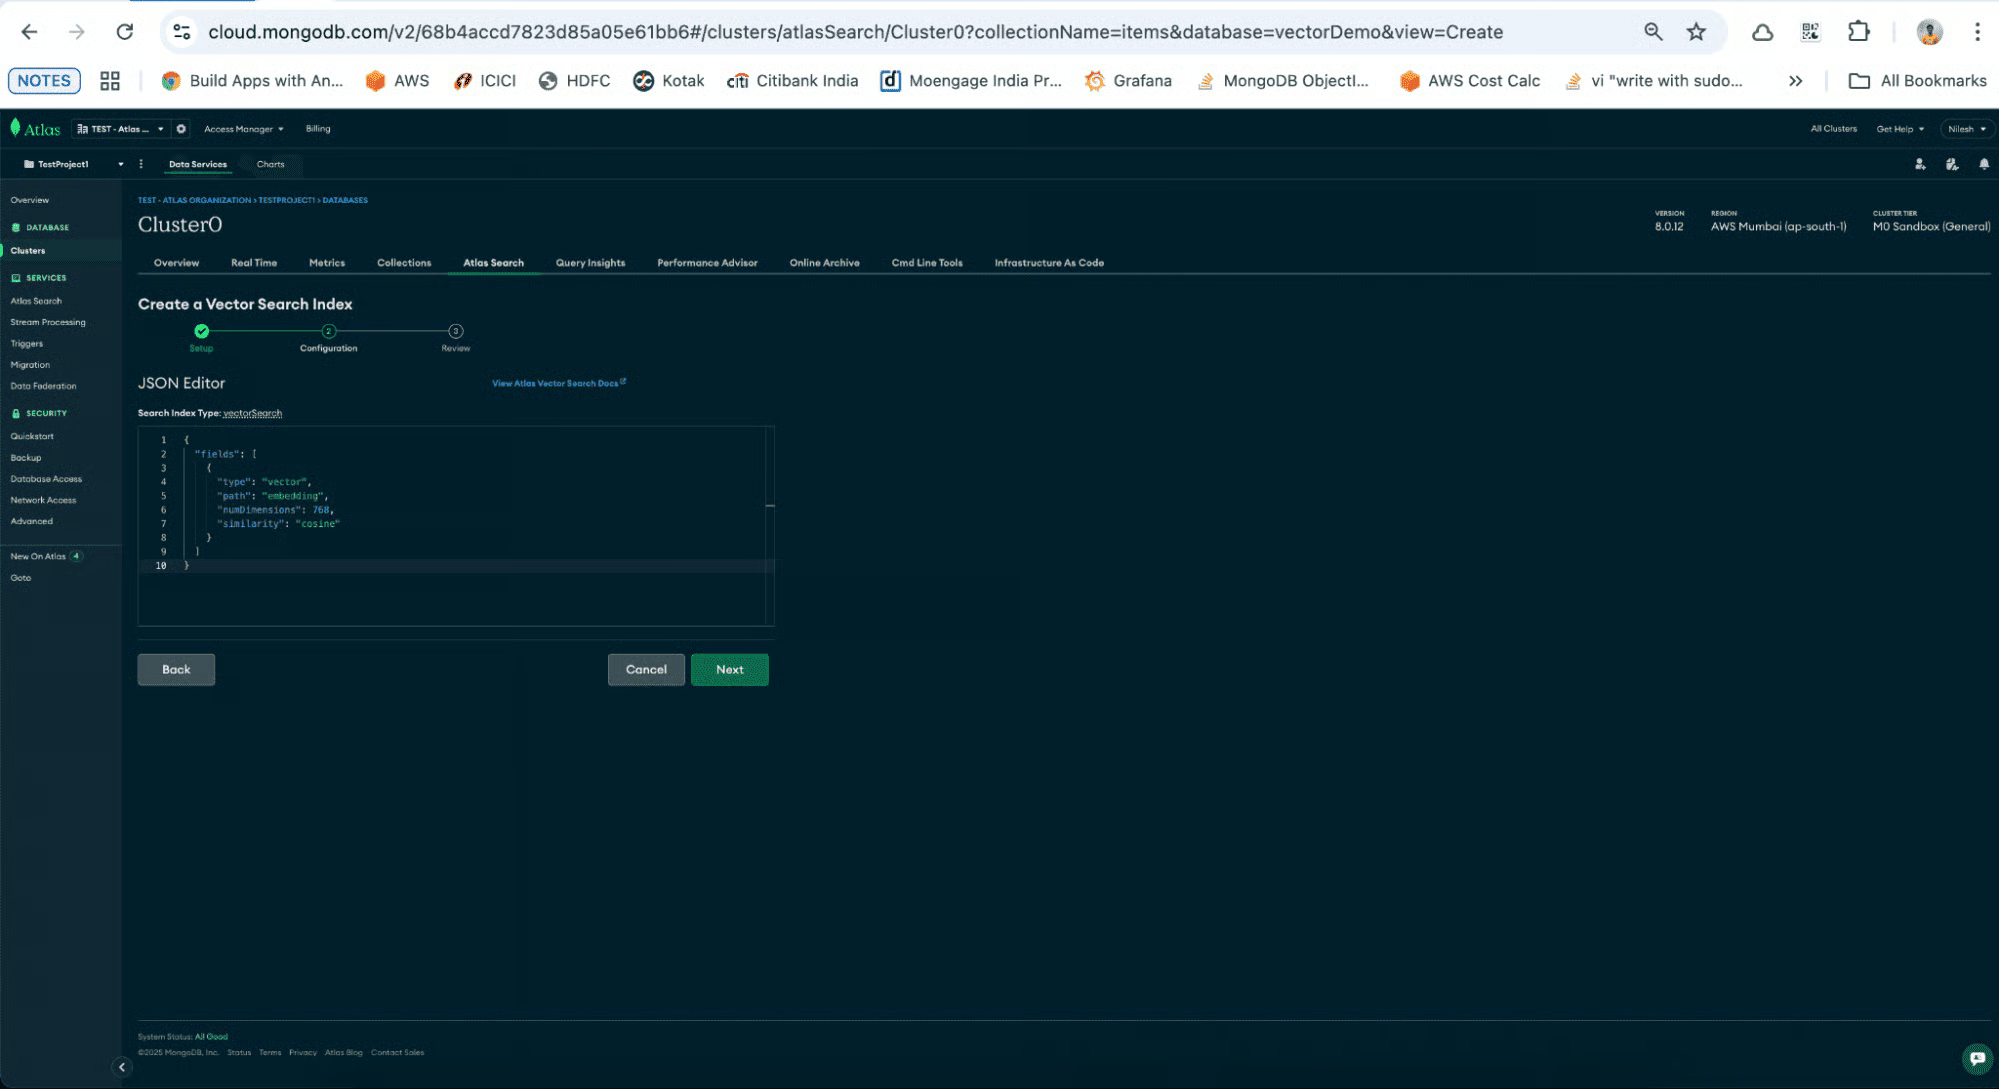
Memahami definisi indeks:
"type": "vector": Memberi tahu MongoDB Atlas bahwa ini adalah indeks vektor."path": "embedding": Poin krusial, ini menunjuk ke field dalam dokumen kita yang berisi vektor."numDimensions": 768: Ini harus cocok dengan dimensi vektor yang dihasilkan model kita."similarity": "cosine": Algoritma yang digunakan untuk mengukur "kedekatan" vektor. Sangat baik untuk kemiripan berbasis teks.Dapatkan string koneksi MongoDB Atlas Anda:
<username>, <password>, dan <cluster-url> pada cuplikan di bawah.from pymongo import MongoClient
# Replace with your Atlas connection string
uri = "mongodb+srv://<username>:<password>@<cluster-url>/vectorDemo?retryWrites=true&w=majority"
client = MongoClient(uri)
db = client["vectorDemo"]
collection = db["items"]
print("Connected to MongoDB Atlas")
# Clear existing
collection.delete_many({})
print("Cleared collection.")Kita akan menggunakan SentenceTransformers untuk mengonversi teks menjadi embedding.
from sentence_transformers import SentenceTransformer
# Choose model: higher-quality for search -> "sentence-transformers/all-mpnet-base-v2" (768-d)
# If you need faster/smaller: "all-MiniLM-L6-v2" (384-d)
MODEL_NAME = "sentence-transformers/all-mpnet-base-v2"
# MODEL_NAME = "all-MiniLM-L6-v2"

# Note: if you use all-mpnet-base-v2, your Atlas vector index must use numDimensions: 768
# If you use all-MiniLM-L6-v2, index numDimensions: 384
model = SentenceTransformer(MODEL_NAME)

def embed_text(text: str):
return model.encode(text).tolist()Mari simpan beberapa deskripsi produk di MongoDB beserta embedding-nya.
# Each product includes name, description, list of features, use_cases and tags.
products = [
    # Marathon / long-distance running (explicit!)
    {
        "name": "MarathonPro 3000",
        "description": "Designed specifically for marathon and ultra distance running: maximum cushioning, breathable knit upper, responsive midsole and engineered heel support for long-run comfort.",
        "features": ["marathon", "long-distance", "max cushioning", "breathable", "support"],
        "category": "shoes",
        "use_cases": ["marathon", "long-distance running", "road running"],
        "tags": ["running", "endurance", "comfort"]
    },
    {
        "name": "Enduro LongRun",
        "description": "Lightweight long-run trainer optimized for marathon pacing with added cushioning, stable platform, and enhanced forefoot energy return for hours of comfortable running.",
        "features": ["long-run", "lightweight", "energy return", "cushioning"],
        "category": "shoes",
        "use_cases": ["marathon", "road running"],
        "tags": ["running","marathon","comfort"]
    },

    # Road running / neutral
    {
        "name": "Red Road Runner",
        "description": "Neutral road running shoe for daily training: breathable mesh, moderate cushioning and responsive ride; suitable for tempo runs and long easy runs.",
        "features": ["road running", "breathable", "moderate cushioning"],
        "category": "shoes",
        "use_cases": ["training", "road running", "tempo runs"],
        "tags": ["running","training"]
    },

    # Trail running (explicit trail)
    {
        "name": "TrailMaster RidgeGrip",
        "description": "Trail-running shoe with aggressive outsole, rock plate for protection, waterproof upper, designed for technical trails and rugged terrain.",
        "features": ["trail", "high grip", "rock plate", "waterproof"],
        "category": "shoes",
        "use_cases": ["trail running", "hiking", "off-road"],
        "tags": ["trail","outdoors"]
    },

    # Tennis & court
    {
        "name": "CourtPro Tennis",
        "description": "Court shoe with lateral support, non-marking sole and reinforced toe; built for tennis footwork and short intense bursts, not for long-distance running.",
        "features": ["court", "lateral support", "non-marking sole"],
        "category": "shoes",
        "use_cases": ["tennis","court sports"],
        "tags": ["tennis","sport"]
    },

    # Formal
    {
        "name": "Oxford Leather Formal",
        "description": "Classic leather formal shoe for office and events: polished leather, sturdy sole, refined silhouette.",
        "features": ["formal", "leather", "office"],
        "category": "shoes",
        "use_cases": ["formal wear","office"],
        "tags": ["formal","leather"]
    },

    # Hiking
    {
        "name": "Alpine Trek Boots",
        "description": "High-ankle hiking boots with waterproof membrane, ankle support and durable lugged outsole for mountain treks.",
        "features": ["hiking", "waterproof", "ankle support", "lugged outsole"],
        "category": "shoes",
        "use_cases": ["hiking","trekking","outdoor"],
        "tags": ["outdoors","hiking"]
    },

    # Casual sneakers
    {
        "name": "Classic Canvas Sneaker",
        "description": "Casual everyday canvas sneaker with rubber sole, comfortable fit for daily wear and walking.",
        "features": ["casual","canvas", "everyday"],
        "category": "shoes",
        "use_cases": ["casual","walking"],
        "tags": ["casual"]
    },

    # Cross-trainer
    {
        "name": "CrossFit Trainer",
        "description": "Stable cross-trainer shoe engineered for gym workouts, short sprints, and lateral movements; flexible yet supportive.",
        "features": ["cross-train","stable","gym"],
        "category": "shoes",
        "use_cases": ["gym","cross-training"],
        "tags": ["training","gym"]
    },

    # Cleats
    {
        "name": "Pro Soccer Cleats",
        "description": "Low-profile football/soccer cleats with studded outsole; optimized for grip on grass and agility.",
        "features": ["cleats","studs","agility"],
        "category": "shoes",
        "use_cases": ["soccer","football"],
        "tags": ["sports","cleats"]
    }
]

# ---------- Create 'canonical_text' to improve embedding quality for better scoring ----------
for p in products:
    # join features and others into one rich text blob
    features = ", ".join(p["features"])
    uses = ", ".join(p["use_cases"])
    tags = ", ".join(p["tags"])
    canonical = f"{p['name']}. {p['description']}. Features: {features}. Use cases: {uses}. Tags: {tags}."
    p["canonical_text"] = canonical

# ---------- Embed canonical_text----------
print("Embedding items...")
for p in products:
    p["embedding"] = embed_text(p["canonical_text"])

# ---------- Insert into MongoDB ----------
collection.insert_many(products)
Dengan menggunakan insert_many, kita melakukan satu operasi tulis massal yang efisien ke basis data kita.
Saatnya langkah terakhir yang paling menarik! Kita akan menggunakan kerangka agregasi MongoDB dan $vectorSearch—sebuah operator untuk menemukan kueri sepatu terbaik.
query_text = "25k long running best shoes"
query_embedding = embed_text(query_text)

pipeline = [
    {
        "$vectorSearch": {
            "index": "vector_index",  # Use the vector search index you created
            "path": "embedding",
            "queryVector": query_embedding,
            "numCandidates": 100,
            "limit": 3
        }
    },
    {
        "$project": {
            "name": 1,
            "description":1,
            "score": {"$meta": "vectorSearchScore"}
        }
    }
]

results = collection.aggregate(pipeline)

print(f"\nSearch results for: '{query_text}'\n")
for r in results:
    print(f"- {r['name']} (score: {r['score']:.4f})")
Membedah pipeline $vectorSearch:
$vectorSearch: Ini adalah operator inti. Operator ini secara efisien membandingkan queryVector kita terhadap field plot_embedding yang diindeks untuk semua dokumen.$project: Tahap ini membentuk ulang output. Kita menyertakan name dan description, mengecualikan noisy _id dan field lainnya, dan yang terpenting, kita menambahkan field score menggunakan $meta: "vectorSearchScore". Skor ini, dari 0 hingga 1, menunjukkan seberapa mirip hasil dengan kueri kita.Jika semuanya telah disetel dengan benar, Anda akan melihat sesuatu seperti ini:
Search results for: '25k long running best shoes'

- MarathonPro 3000 (score: 0.7980)
- Red Road Runner (score: 0.7479)
- Enduro LongRun (score: 0.7389)
Perhatikan bahwa “MarathonPro 3000” berada di urutan teratas—persis seperti yang kita harapkan.
Selamat! Anda berhasil membangun aplikasi pencarian vektor dari nol. Anda telah mempelajari cara terhubung ke basis data, membuat dan memvalidasi data, menghasilkan vector embedding, dan memanfaatkan kekuatan MongoDB Atlas untuk menemukan informasi dengan cara yang benar-benar cerdas. Selamat datang di masa depan interaksi data.
Dalam tutorial ini, Anda berhasil mempelajari cara:
Bereksperimenlah dengan metrik kemiripan yang berbeda (dotProduct, euclidean).
Kursus DataCamp Teratas
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt