
Kursus
Konsep Generative AI
2 jam
121.2K
Weaviate adalah mesin pencari vektor sumber terbuka, cloud-native, modular, dan real-time yang memungkinkan Anda menyimpan objek data dan embedding vektor serta melakukan kueri berdasarkan ukuran kemiripan. Dalam tutorial ini, kita akan mengeksplorasi Weaviate dan konsep utamanya, mempelajari cara menyiapkannya, membuat skema, menambahkan data, dan melakukan kueri data menggunakan antarmuka GraphQL Weaviate. Kita juga akan membahas cara menggunakan Weaviate dengan Python serta praktik terbaik dan kiat untuk desain skema, impor data, dan pengoptimalan kueri.
Weaviate adalah basis data vektor yang menyimpan objek dan vektor, sehingga memungkinkan penggabungan pencarian vektor. Solusi ini bersifat modular, cloud-native, dan real-time, sehingga mudah menskalakan model pembelajaran mesin. Weaviate dilengkapi modul opsional untuk teks, gambar, dan jenis media lainnya, yang dapat dipilih berdasarkan tugas dan data Anda. Anda juga dapat menggunakan lebih dari satu modul, tergantung pada variasi data.
Data tidak terstruktur, seperti teks, gambar, dan audio, tidak memiliki format baku, sehingga menantang bagi basis data dan metode tradisional untuk menanganinya.
Agar data ini dapat digunakan dalam aplikasi AI dan pembelajaran mesin, data dikonversi menjadi vektor numerik menggunakan embedding.
Embedding berfungsi seperti kamus khusus yang mengubah data berdimensi tinggi menjadi bentuk numerik yang ringkas, sehingga memudahkan pemrosesan oleh model AI.
Embedding krusial untuk mengurangi dimensi data dan mengatasi keterbatasan metode pengodean tradisional, sehingga AI dapat memahami relasi dan konteks kompleks dalam data.
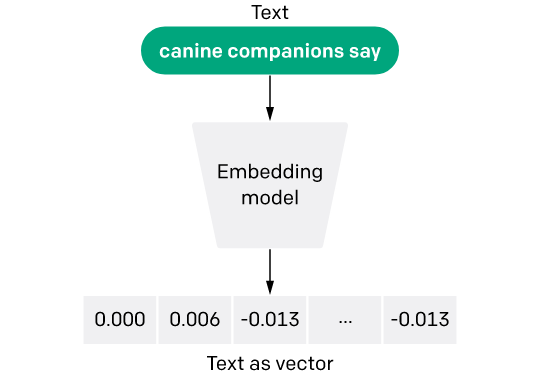
Model Embedding Teks - Sumber Gambar
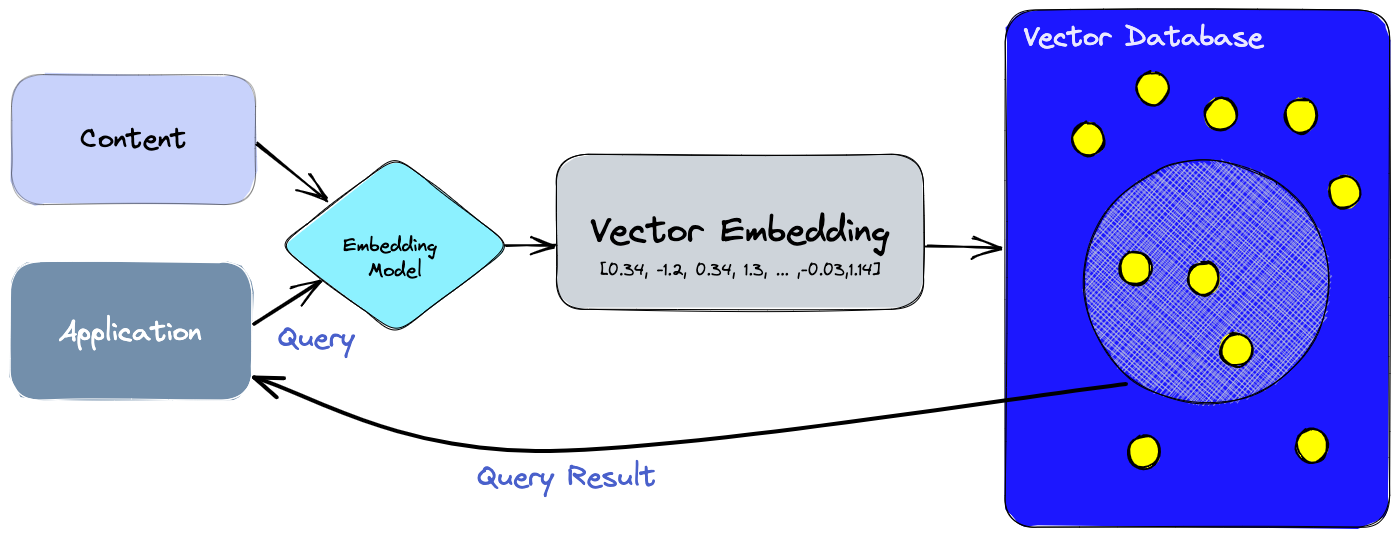
Basis data tradisional menyimpan data dalam tabel yang dapat dikueri menggunakan SQL. Namun, SQL kurang cocok untuk mencari data tidak terstruktur, seperti teks atau gambar. Basis data vektor, di sisi lain, menyimpan data sebagai vektor yang dapat dikueri menggunakan ukuran kemiripan.
Ini membuatnya sangat cocok untuk tugas seperti pencarian semantik, tanya jawab, dan pencarian generatif. Vektor diperoleh menggunakan model embedding ML. Ini hanyalah representasi numerik dari objek asli, seperti teks, gambar, audio, video, dan sebagainya.
Pertimbangkan skenario ketika sebuah model bahasa digunakan untuk menganalisis dan mengkategorikan kumpulan besar dokumen teks. Setiap dokumen dapat diubah menjadi vektor berdimensi tinggi yang merangkum esensi semantiknya.
Menyimpan vektor-vektor ini dalam basis data tradisional mungkin tidak efisien untuk tugas seperti pencarian kemiripan atau pengelompokan.
Di sinilah basis data vektor berguna. Basis data ini dioptimalkan untuk menyimpan vektor dan melakukan operasi vektor berkecepatan tinggi, seperti mencari tetangga terdekat atau menghitung kemiripan kosinus antar vektor.
Pinecone adalah basis data vektor populer lainnya dan merupakan alternatif yang bagus untuk Weaviate. Jika Anda ingin mempelajari lebih lanjut tentang Pinecone, lihat Tutorial Menguasai Basis Data Vektor dengan Pinecone.
Untuk menyiapkan Weaviate, Anda dapat menggunakan Docker Compose atau memasangnya secara manual. Docker Compose adalah metode yang direkomendasikan karena menyederhanakan proses instalasi. Setelah memasang Weaviate, Anda dapat memverifikasinya dengan menjalankan kueri sederhana.
Untuk Docker compose, unduh berkas yaml ini dari Weaviate. Setelah Anda memiliki berkas ini, Anda cukup menjalankan:
docker compose up -dOpsi lain untuk menggunakan Weaviate adalah:
Untuk menggunakan Weaviate di Python Anda dapat memasang klien Python weaviate menggunakan pip.
!pip install -U weaviate-clientDi Weaviate, setiap item data termasuk dalam grup yang disebut "Class" dan memiliki fitur tertentu yang disebut "Properties". Item data ini (direpresentasikan sebagai dokumen JSON) adalah koleksi berbasis kelas.
Setiap item data direpresentasikan oleh vektor (model embedding pembelajaran mesin). Setiap koleksi berbasis kelas berisi objek dari kelas yang sama, yang didefinisikan oleh skema umum.
Weaviate dibangun secara fleksibel, memungkinkan Anda menambahkan fitur opsional seperti mengubah data menjadi vektor atau membuat cadangan.
Tanpa add-on ini, versi dasar Weaviate berfungsi sebagai basis data yang dirancang khusus untuk data vektor.
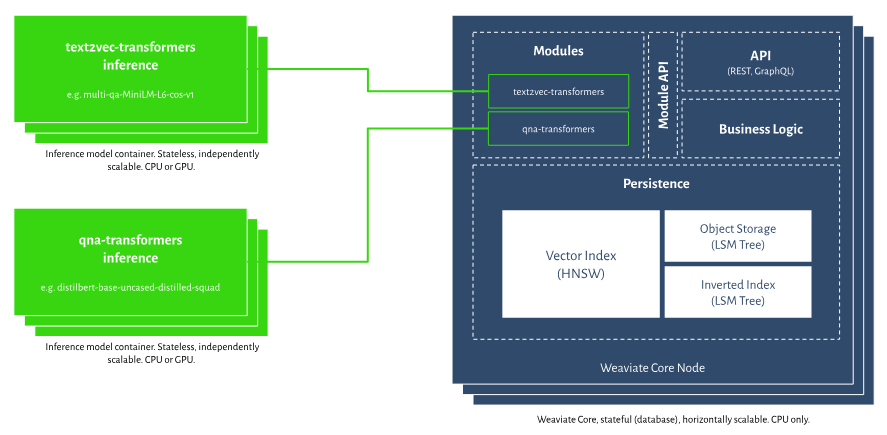
Weaviate adalah basis data andal yang menyimpan data secara instan dan tahan terhadap kegagalan perangkat lunak maupun perangkat keras.
Saat Anda mencari sesuatu menggunakan vektor, Weaviate memberikan item data lengkap (terkadang disebut "dokumen" di basis data lain) alih-alih hanya sebuah pengenal seperti ID.
Jika Anda menggunakan pencarian reguler dan berbasis vektor sekaligus, filter diterapkan sebelum pencarian vektor, memastikan Anda mendapatkan jumlah hasil tepat seperti yang diminta. Ini berbeda dengan pemfilteran setelah pencarian, di mana jumlah hasil bisa bervariasi.
Anda bebas memperbarui atau menghapus data dan vektornya, bahkan saat Anda membaca dari basis data.
Anda dapat berinteraksi dengan Weaviate menggunakan API-nya, yang mencakup RESTful API dan GraphQL API. Pustaka klien untuk semua bahasa pemrograman kompatibel dengan fitur API ini.
GraphQL adalah bahasa kueri untuk API yang memungkinkan Anda meminta data secara presisi sesuai kebutuhan. Ini memberikan cara yang lebih efisien dan fleksibel untuk berinteraksi dengan basis data dibandingkan metode tradisional seperti REST.
Antarmuka GraphQL dipilih karena beberapa alasan, antara lain:
Setiap objek Weaviate termasuk dalam satu kelas. Anda dapat membuat kelas secara manual atau menggunakan Auto-schema dari Weaviate untuk membuatnya. Saat Anda membuat kelas secara manual, Anda memiliki kontrol lebih besar atas model data.
Untuk membuat kelas menggunakan pustaka klien python:
class_name = "Item description"
class_object = {"class": class_name}
client.schema.create_class(class_object)
Biasanya, Anda juga akan menentukan konfigurasi tambahan; contoh yang lebih realistis seperti yang diambil dari Weaviate.io adalah:
{
"class": "Article",
"vectorizer": "text2vec-cohere",
"vectorIndexConfig": {
"distance": "cosine",
},
"moduleConfig": {
"generative-openai": {}
},
"properties": [
{
"name": "title",
"dataType": ["text"]
},
{
"name": "chunk",
"dataType": ["text"]
},
{
"name": "chunk_no",
"dataType": ["int"]
},
{
"name": "url",
"dataType": ["text"],
"tokenization": "field"
},
],
}
Perhatikan bahwa model untuk vektorisasi text2vec-cohere didefinisikan serta metrik jarak cosine. Perhatikan bagaimana properti didefinisikan sebagai daftar kamus.
Objek termasuk dalam sebuah kelas. Objek dapat mengabaikan properti kelas sekaligus menambahkan properti baru. Di bawah ini adalah contoh menambahkan objek ke kelas Article.
uuid = client.data_object.create({
'question': 'question here ...',
'answer': 'answer here ...'
}, 'Article')
Anda dapat secara opsional menetapkan vektor untuk merepresentasikan setiap objek. Jika Anda tidak mendefinisikan vektor, Weaviate akan menggunakan vektorisernya yang standar.
uuid = client.data_object.create(
data_object={
'question': 'question here ...',
'answer': 'answer here ...',
},
class_name='Article',
vector=[0.12345] * 1536Ini adalah contoh yang menunjukkan cara membuat kelas lalu menambahkan objek ke kelas tersebut menggunakan klien python Weaviate. Anda harus memasang klien python terlebih dahulu dengan pip.
!pip install -U weaviate-clientUntuk bekerja dengan Weaviate, Anda harus memiliki instance Weaviate yang berjalan. Ada dua cara Anda dapat menggunakannya, pertama dengan menggunakan instance terkelola penuh yang dihosting di layanan cloud Weaviate. Atau Anda dapat menggunakan Weaviate Embedded, yang menjalankan instance di latar belakang aplikasi Anda.
# For using embedded
import weaviate
from weaviate.embedded import EmbeddedOptions
import json
import os


client = weaviate.Client(
    embedded_options=EmbeddedOptions(),
    additional_headers = {
        "X-OpenAI-Api-Key": "YOUR_OPENAI_KEY"
    }
)
Membuat kelas sangatlah langsung:
class_obj = {
    "class": "Question",
    "vectorizer": "text2vec-openai",
"moduleConfig": {
        "text2vec-openai": {},
        "generative-openai": {}
    }
}


client.schema.create_class(class_obj)
Jika vektorisasi diatur ke None maka Anda harus menyediakan vektor sendiri sebagai sebuah daftar.
Sekarang kita dapat menambahkan objek ke kelas Question yang dibuat melalui proses impor batch. Kita akan menggunakan jeopardy Q&A dalam format json. Seperti inilah tampilannya:
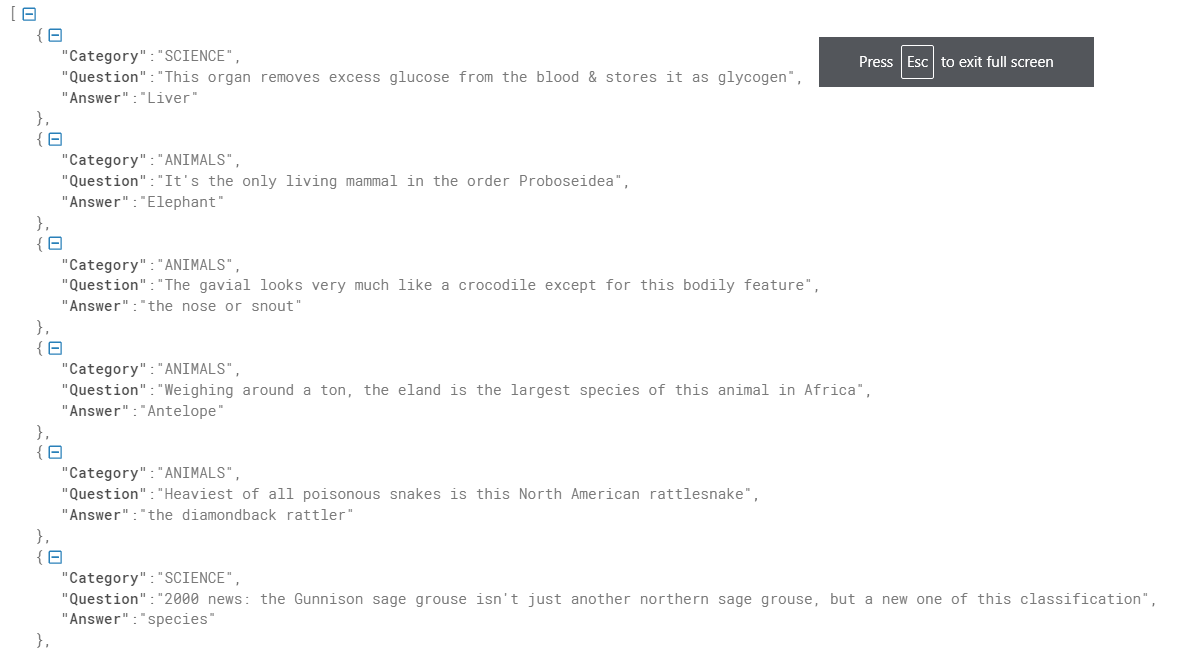
Sumber Data (Kredit: Weaviate Official)
# Load data
import requests
url = 'https://raw.githubusercontent.com/weaviate-tutorials/quickstart/main/data/jeopardy_tiny.json'
resp = requests.get(url)
data = json.loads(resp.text)


# Configure a batch process
with client.batch(
    batch_size=100
) as batch:
    # Batch import all Questions
    for i, d in enumerate(data):
        print(f"importing question: {i+1}")


        properties = {
            "answer": d["Answer"],
            "question": d["Question"],
            "category": d["Category"],
        }


        client.batch.add_data_object(
            properties,
            "Question",
        )
Contoh ini telah direproduksi menggunakan dokumentasi Weaviate.
Mari kita telusuri beberapa kiat bermanfaat untuk menggunakan Weaviate secara efektif. Baik saat Anda merancang skema, mengimpor data, atau mengoptimalkan kueri, praktik terbaik ini akan membantu Anda memaksimalkan kemampuan Weaviate.
ChromaDB adalah basis data vektor sumber terbuka populer lainnya di komunitas data science. Dengan Chroma DB, Anda dapat dengan mudah mengelola dokumen teks, mengonversi teks menjadi embedding, dan melakukan pencarian kemiripan. Jika Anda ingin mempelajari lebih lanjut tentang ChromaDB, lihat Tutorial Chroma DB.
Tutorial Weaviate menyediakan panduan komprehensif untuk memahami dan memanfaatkan Weaviate, mesin pencari vektor real-time berbasis cloud yang bersifat sumber terbuka. Blog ini mencakup berbagai topik, mulai dari dasar-dasar apa itu Weaviate dan bagaimana perbedaannya dari basis data tradisional, hingga seluk-beluk penyiapan dan penggunaannya secara efektif.
Weaviate unggul dalam kemampuannya menangani data tidak terstruktur melalui embedding vektor, menjadikannya alat yang kuat untuk aplikasi pembelajaran mesin dan AI. Arsitektur modularnya memberikan fleksibilitas, memungkinkan Anda memilih modul opsional sesuai kebutuhan spesifik. Blog ini juga membahas pentingnya embedding, menjelaskan bagaimana embedding mengubah data berdimensi tinggi menjadi format yang mudah diproses oleh model AI.
Jika Anda ingin terus belajar tentang Weaviate, lihat webinar kami tentang Basis Data Vektor untuk Data Science dengan Weaviate di Python.
Mulailah Bekerja dengan AI Hari Ini!
Kursus
Program
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




