Cursus
AI-toepassingen bouwen met Pinecone
3 uur
11.9K
Nog niet zo lang geleden functioneerden computers als efficiënte maar letterlijke bibliothecarissen. Als je zocht op "giant robot battles", vonden ze alleen titels met precies die woorden. Een perfecte match zoals "Kaiju Mech Warfare" werd over het hoofd gezien. Computers herkenden woorden maar misten de muziek—ze misten begrip, nuance en context. Dit was het tijdperk van de zoekopdracht op trefwoord, dat jarenlang onze beste optie was.
Toen kwam er een revolutie. Geïnspireerd door het menselijk brein ontwikkelde kunstmatige intelligentie een nieuwe manier van leren. In plaats van simpelweg woorden te onthouden, begon AI de relaties ertussen te begrijpen. Het begrijpt dat "king" zich verhoudt tot "man" zoals "queen" tot "woman". Het herkende dat "happy", "joyful" en "ecstatic" een emotioneel gebied delen, terwijl "sombre" in een totaal andere sfeer thuishoort.
Hoe deed AI dit? Door een betekeniskaart te maken.
Stel je een uitgestrekte, multidimensionale melkweg voor waar elk concept—een woord, een zin, een afbeelding, een lied—een ster is. In deze melkweg clusteren sterren met vergelijkbare betekenissen bij elkaar, terwijl niet-gerelateerde sterren lichtjaren van elkaar verwijderd zijn.
Een vector embedding is simpelweg de coördinaat van een ster in deze melkweg. Het is een lijst met getallen (bijv. [0.12, -0.45, 0.89, ...]) die een concept precies lokaliseert op deze betekeniskaart.
Vectorzoek is het revolutionaire vermogen om door deze kaart te navigeren. Als je vraagt: "een film over een weesjongen die ontdekt dat hij een tovenaar is", zoeken we niet naar die exacte trefwoorden. In plaats daarvan:
De dichtstbijzijnde sterren vertegenwoordigen de meest semantisch vergelijkbare resultaten. Zo evolueerde AI van een letterlijke bibliothecaris naar een wijze gids die begrijpt wat je eigenlijk bedoelt.
Zoeken op betekenis in plaats van trefwoorden voedt moderne AI-toepassingen in allerlei sectoren. Deze mogelijkheid maakt het mogelijk dat:
Vectorzoek slaat een brug tussen menselijke intentie en digitale data, en transformeert fundamenteel hoe we met informatie omgaan. Deze technologie laat digitale systemen minder mechanisch en meer als intuïtieve samenwerkers aanvoelen.
Welkom bij de nieuwe grens van zoeken! MongoDB introduceerde Vectorzoek in Atlas. Hiermee kun je vector-embeddings (zoals die van tekst, afbeeldingen of audio) rechtstreeks in MongoDB opslaan en bevragen—geen aparte vectordatabank zoals Pinecone of Weaviate nodig.
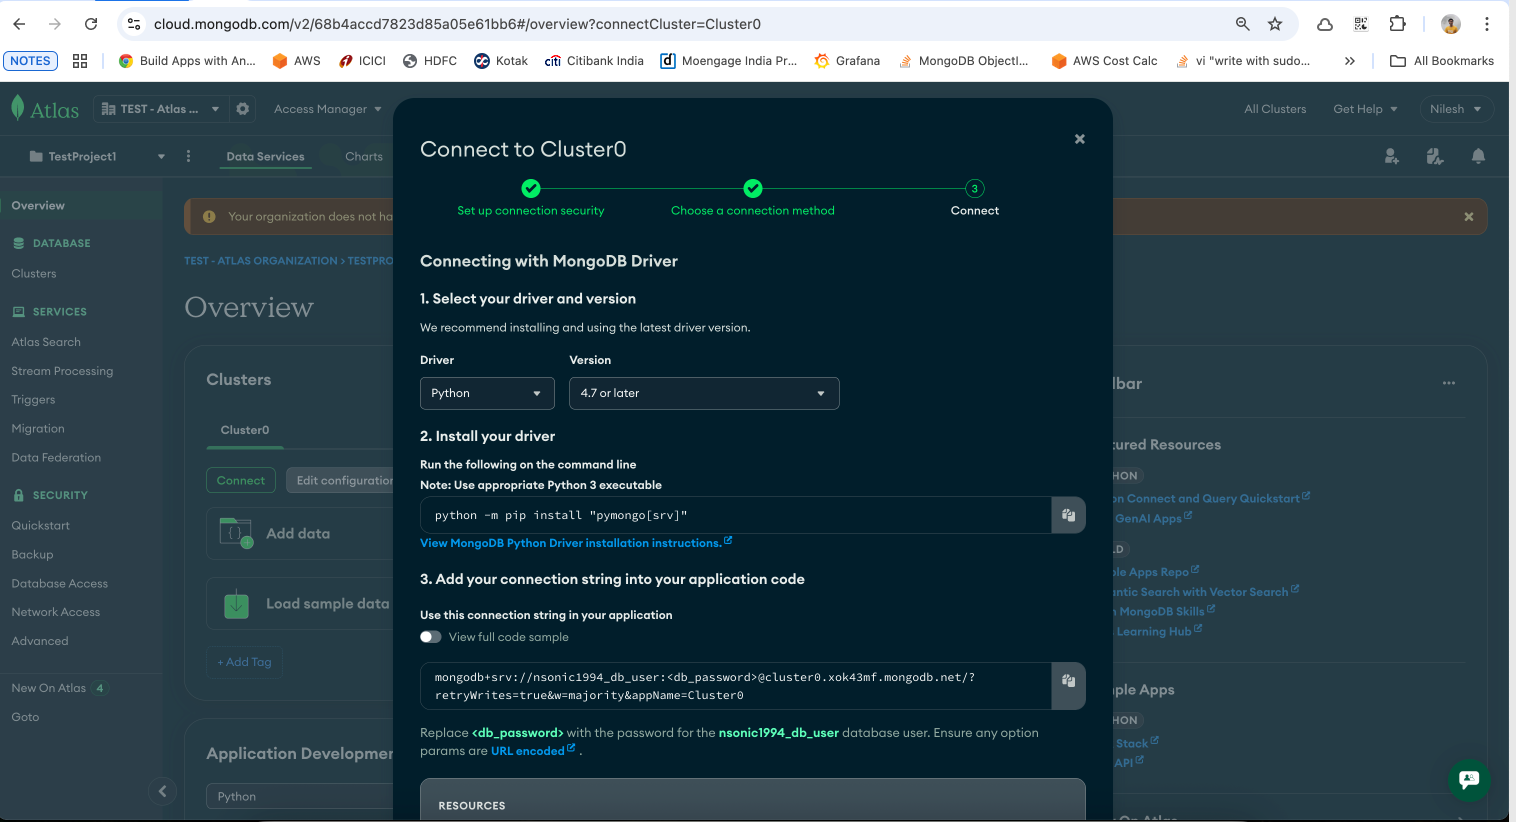
In deze tutorial bouwen we een eenvoudige maar krachtige aanbevelingsengine voor schoenen met Python en MongoDB Atlas. Je leert hoe je tekst omzet in betekenisvolle numerieke representaties (vectoren) en vervolgens de ingebouwde Vectorzoek van Atlas gebruikt om films met vergelijkbare plots te vinden.
pip install pymongo sentence-transformers numpy
vectorDemoitems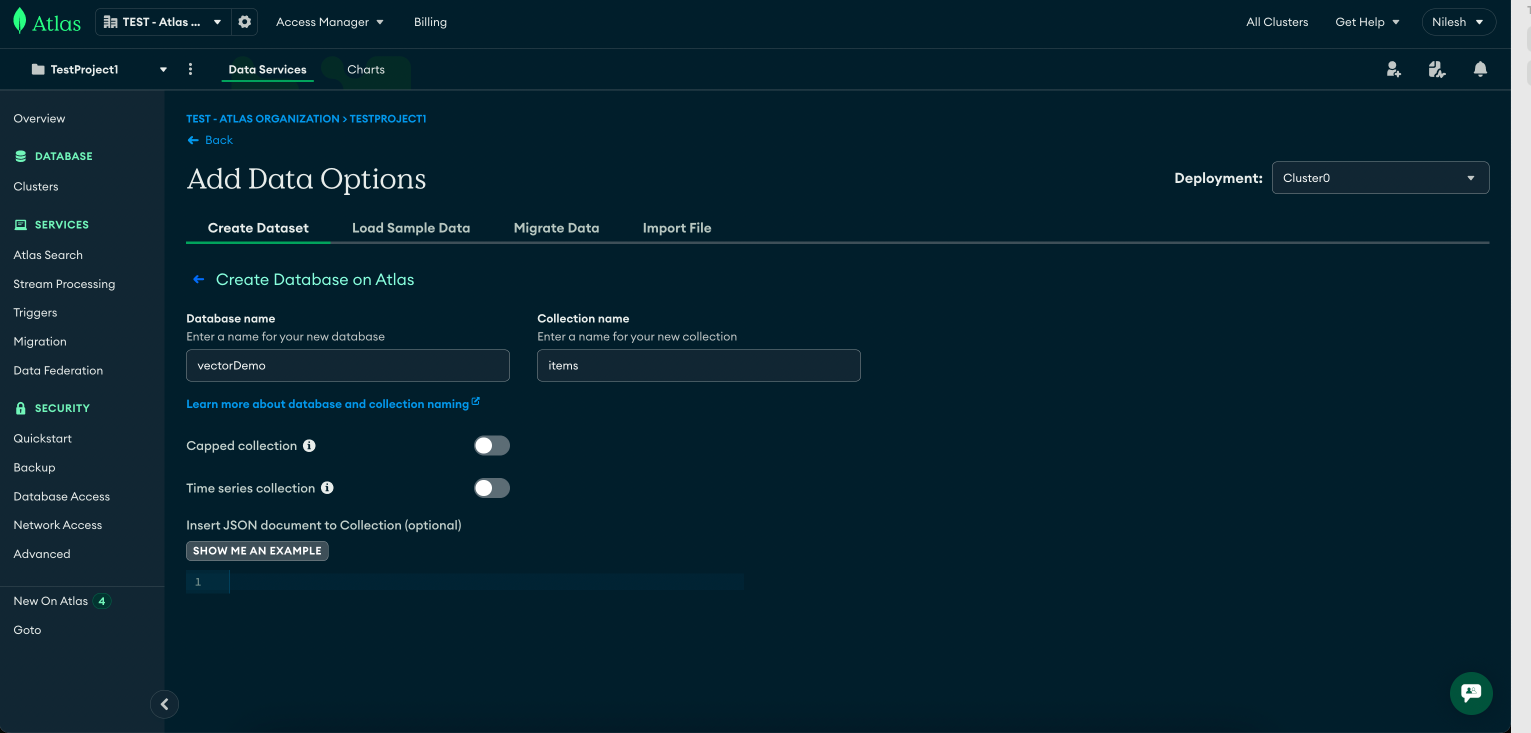
items.{
"fields": [
{
"type": "vector",
"path": "embedding",
"numDimensions": 768,
"similarity": "cosine"
}
]
}
Let op: 768 is de embeddinggrootte die we gebruiken met het sentence-transformers-model.
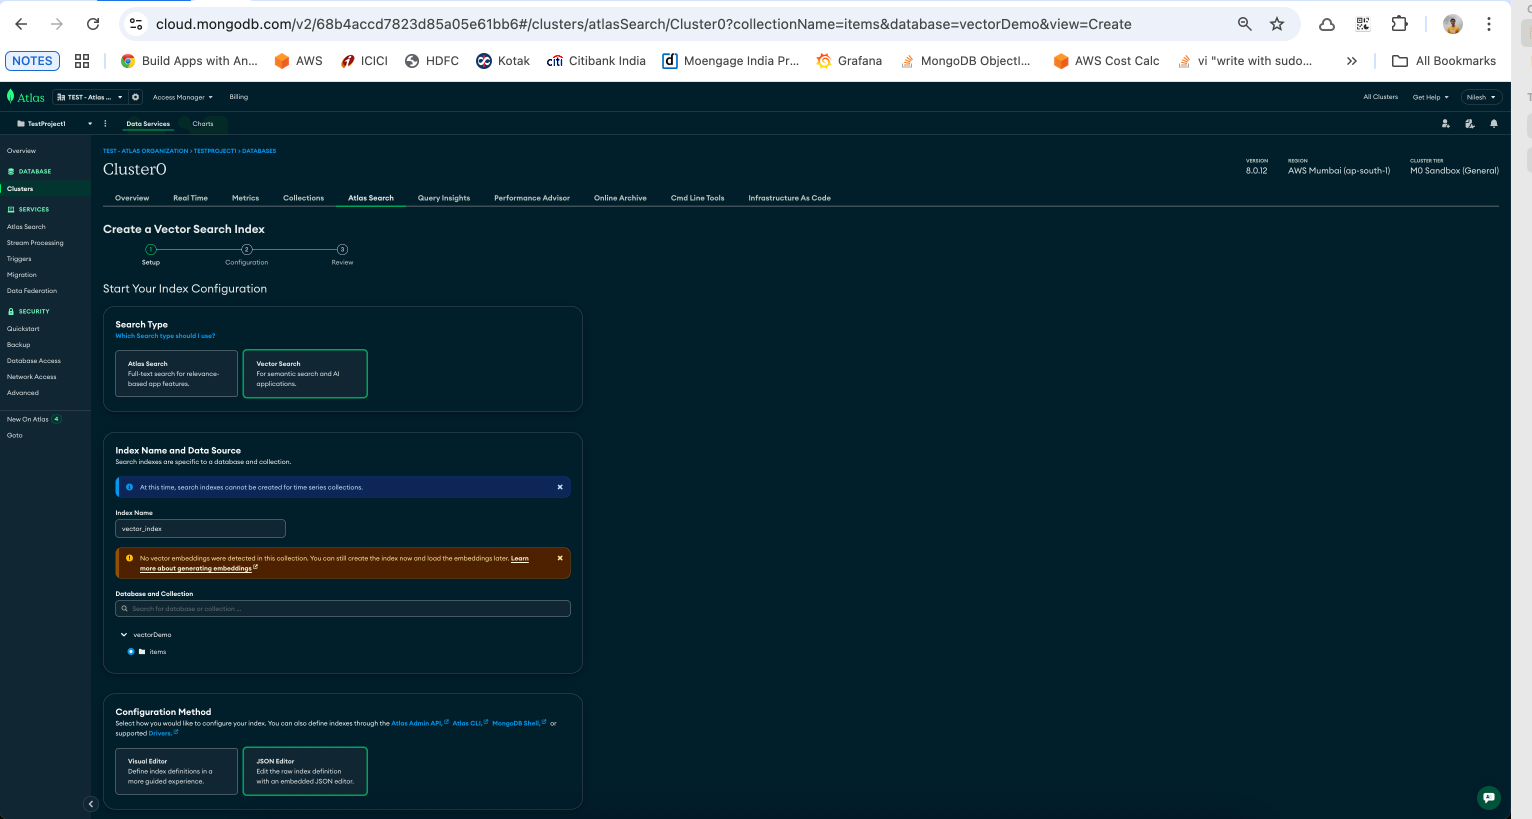
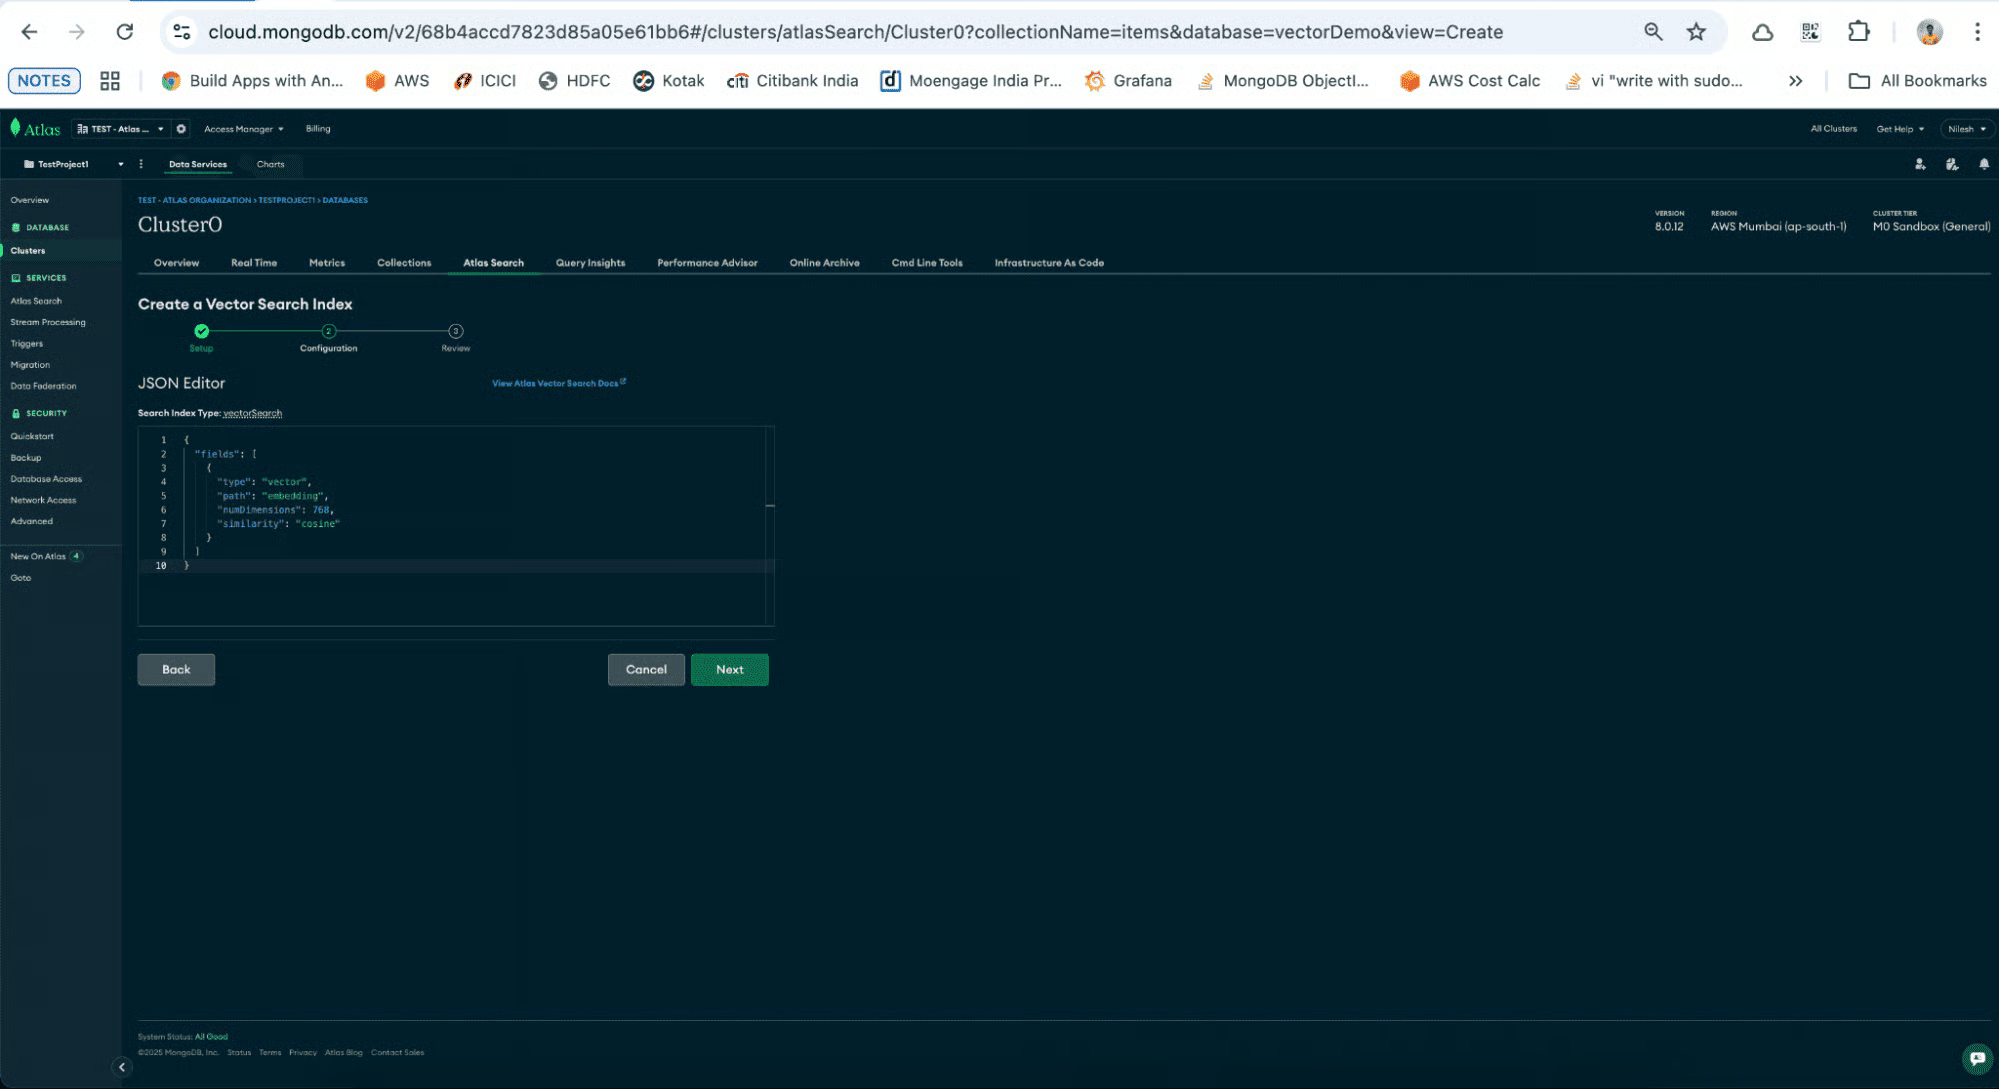
De indexdefinitie begrijpen:
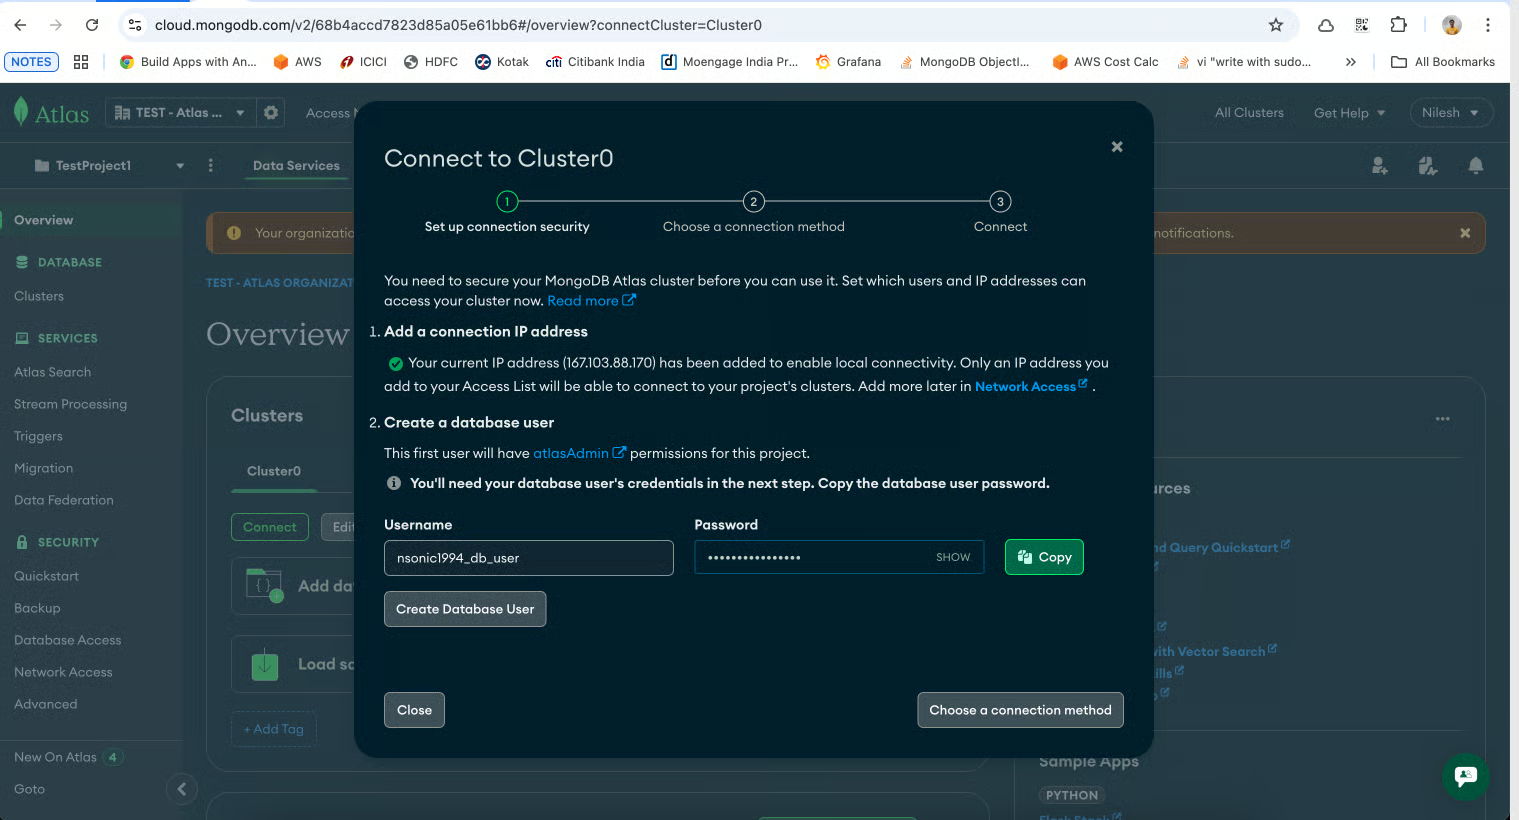
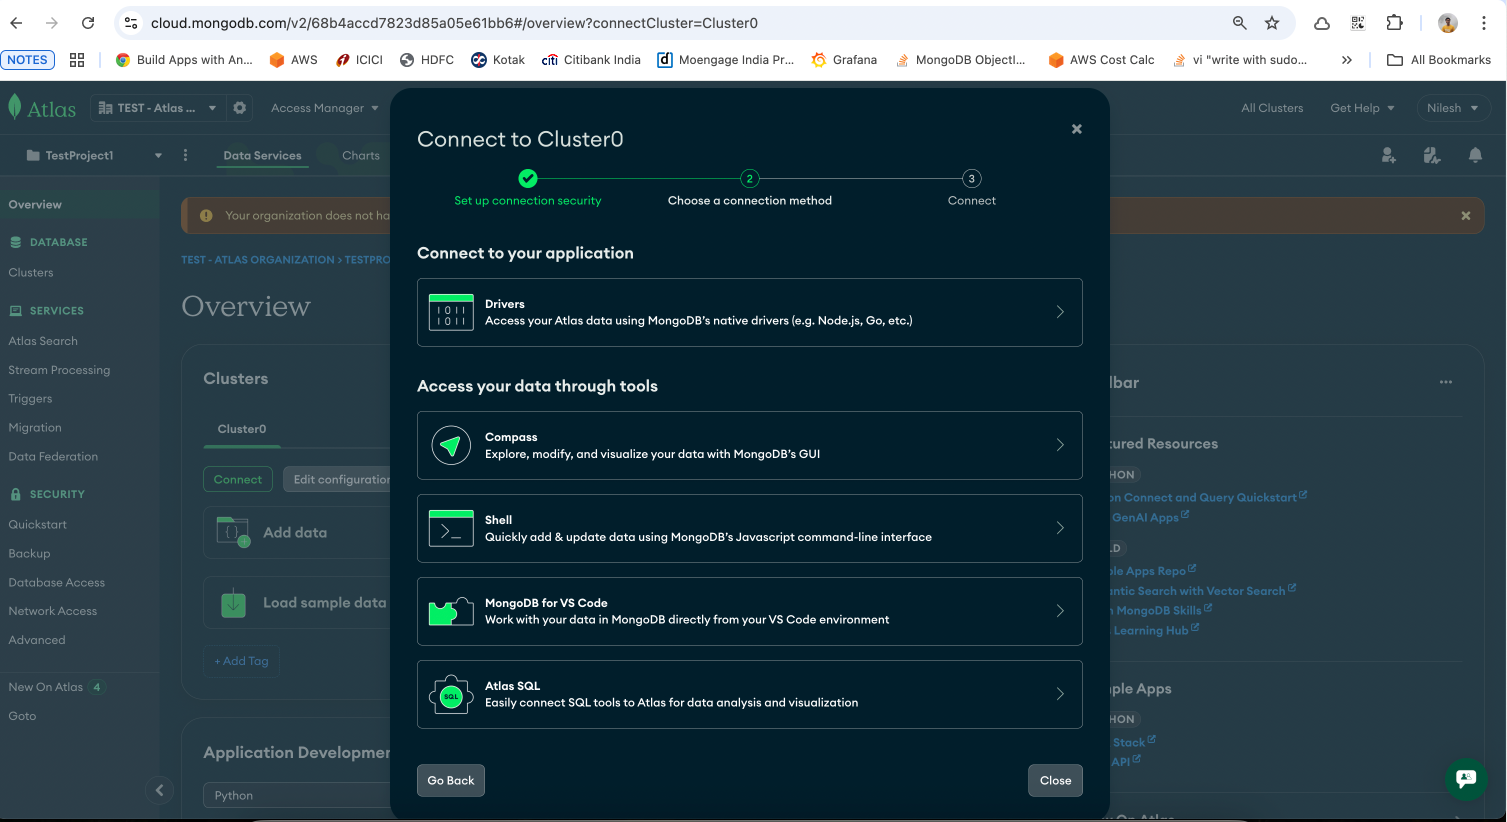
"type": "vector": Vertelt MongoDB Atlas dat dit een vectorindex is."path": "embedding": Belangrijk: dit wijst naar het veld in onze documenten dat de vectoren bevat."numDimensions": 768: Dit moet overeenkomen met de dimensie van de vectoren die ons model produceert."similarity": "cosine": Het algoritme dat wordt gebruikt om de "nabijheid" van vectoren te meten. Uitstekend voor tekstgebaseerde gelijkenis.Haal je MongoDB Atlas-connection string op:
<username>, <password> en <cluster-url> in het onderstaande fragment.from pymongo import MongoClient
# Replace with your Atlas connection string
uri = "mongodb+srv://<username>:<password>@<cluster-url>/vectorDemo?retryWrites=true&w=majority"
client = MongoClient(uri)
db = client["vectorDemo"]
collection = db["items"]
print("Connected to MongoDB Atlas")
# Clear existing
collection.delete_many({})
print("Cleared collection.")We gebruiken SentenceTransformers om tekst om te zetten in embeddings.
from sentence_transformers import SentenceTransformer
# Choose model: higher-quality for search -> "sentence-transformers/all-mpnet-base-v2" (768-d)
# If you need faster/smaller: "all-MiniLM-L6-v2" (384-d)
MODEL_NAME = "sentence-transformers/all-mpnet-base-v2"
# MODEL_NAME = "all-MiniLM-L6-v2"

# Note: if you use all-mpnet-base-v2, your Atlas vector index must use numDimensions: 768
# If you use all-MiniLM-L6-v2, index numDimensions: 384
model = SentenceTransformer(MODEL_NAME)

def embed_text(text: str):
return model.encode(text).tolist()Laten we een aantal productbeschrijvingen met hun embeddings in MongoDB opslaan.
# Each product includes name, description, list of features, use_cases and tags.
products = [
    # Marathon / long-distance running (explicit!)
    {
        "name": "MarathonPro 3000",
        "description": "Designed specifically for marathon and ultra distance running: maximum cushioning, breathable knit upper, responsive midsole and engineered heel support for long-run comfort.",
        "features": ["marathon", "long-distance", "max cushioning", "breathable", "support"],
        "category": "shoes",
        "use_cases": ["marathon", "long-distance running", "road running"],
        "tags": ["running", "endurance", "comfort"]
    },
    {
        "name": "Enduro LongRun",
        "description": "Lightweight long-run trainer optimized for marathon pacing with added cushioning, stable platform, and enhanced forefoot energy return for hours of comfortable running.",
        "features": ["long-run", "lightweight", "energy return", "cushioning"],
        "category": "shoes",
        "use_cases": ["marathon", "road running"],
        "tags": ["running","marathon","comfort"]
    },

    # Road running / neutral
    {
        "name": "Red Road Runner",
        "description": "Neutral road running shoe for daily training: breathable mesh, moderate cushioning and responsive ride; suitable for tempo runs and long easy runs.",
        "features": ["road running", "breathable", "moderate cushioning"],
        "category": "shoes",
        "use_cases": ["training", "road running", "tempo runs"],
        "tags": ["running","training"]
    },

    # Trail running (explicit trail)
    {
        "name": "TrailMaster RidgeGrip",
        "description": "Trail-running shoe with aggressive outsole, rock plate for protection, waterproof upper, designed for technical trails and rugged terrain.",
        "features": ["trail", "high grip", "rock plate", "waterproof"],
        "category": "shoes",
        "use_cases": ["trail running", "hiking", "off-road"],
        "tags": ["trail","outdoors"]
    },

    # Tennis & court
    {
        "name": "CourtPro Tennis",
        "description": "Court shoe with lateral support, non-marking sole and reinforced toe; built for tennis footwork and short intense bursts, not for long-distance running.",
        "features": ["court", "lateral support", "non-marking sole"],
        "category": "shoes",
        "use_cases": ["tennis","court sports"],
        "tags": ["tennis","sport"]
    },

    # Formal
    {
        "name": "Oxford Leather Formal",
        "description": "Classic leather formal shoe for office and events: polished leather, sturdy sole, refined silhouette.",
        "features": ["formal", "leather", "office"],
        "category": "shoes",
        "use_cases": ["formal wear","office"],
        "tags": ["formal","leather"]
    },

    # Hiking
    {
        "name": "Alpine Trek Boots",
        "description": "High-ankle hiking boots with waterproof membrane, ankle support and durable lugged outsole for mountain treks.",
        "features": ["hiking", "waterproof", "ankle support", "lugged outsole"],
        "category": "shoes",
        "use_cases": ["hiking","trekking","outdoor"],
        "tags": ["outdoors","hiking"]
    },

    # Casual sneakers
    {
        "name": "Classic Canvas Sneaker",
        "description": "Casual everyday canvas sneaker with rubber sole, comfortable fit for daily wear and walking.",
        "features": ["casual","canvas", "everyday"],
        "category": "shoes",
        "use_cases": ["casual","walking"],
        "tags": ["casual"]
    },

    # Cross-trainer
    {
        "name": "CrossFit Trainer",
        "description": "Stable cross-trainer shoe engineered for gym workouts, short sprints, and lateral movements; flexible yet supportive.",
        "features": ["cross-train","stable","gym"],
        "category": "shoes",
        "use_cases": ["gym","cross-training"],
        "tags": ["training","gym"]
    },

    # Cleats
    {
        "name": "Pro Soccer Cleats",
        "description": "Low-profile football/soccer cleats with studded outsole; optimized for grip on grass and agility.",
        "features": ["cleats","studs","agility"],
        "category": "shoes",
        "use_cases": ["soccer","football"],
        "tags": ["sports","cleats"]
    }
]

# ---------- Create 'canonical_text' to improve embedding quality for better scoring ----------
for p in products:
    # join features and others into one rich text blob
    features = ", ".join(p["features"])
    uses = ", ".join(p["use_cases"])
    tags = ", ".join(p["tags"])
    canonical = f"{p['name']}. {p['description']}. Features: {features}. Use cases: {uses}. Tags: {tags}."
    p["canonical_text"] = canonical

# ---------- Embed canonical_text----------
print("Embedding items...")
for p in products:
    p["embedding"] = embed_text(p["canonical_text"])

# ---------- Insert into MongoDB ----------
collection.insert_many(products)
Door insert_many te gebruiken, doen we één enkele, efficiënte bulkschrijfbewerking naar onze database.
Tijd voor de laatste en spannendste stap! We gebruiken MongoDB's aggregatiekader en de $vectorSearch—een operator om de beste schoenquery te vinden.
query_text = "25k long running best shoes"
query_embedding = embed_text(query_text)

pipeline = [
    {
        "$vectorSearch": {
            "index": "vector_index",  # Use the vector search index you created
            "path": "embedding",
            "queryVector": query_embedding,
            "numCandidates": 100,
            "limit": 3
        }
    },
    {
        "$project": {
            "name": 1,
            "description":1,
            "score": {"$meta": "vectorSearchScore"}
        }
    }
]

results = collection.aggregate(pipeline)

print(f"\nSearch results for: '{query_text}'\n")
for r in results:
    print(f"- {r['name']} (score: {r['score']:.4f})")
De $vectorSearch-pijplijn ontleden:
$vectorSearch: Dit is de kernoperator. Hij vergelijkt efficiënt onze queryVector met het geïndexeerde veld plot_embedding voor alle documenten.$project: Deze fase vormt de uitvoer om. We nemen de name en description op, sluiten de ruisende _id en andere velden uit en vooral voegen we een score-veld toe met $meta: "vectorSearchScore". Deze score, van 0 tot 1, geeft aan hoe vergelijkbaar het resultaat is met onze query.Als alles correct is ingesteld, zie je iets als dit:
Search results for: '25k long running best shoes'

- MarathonPro 3000 (score: 0.7980)
- Red Road Runner (score: 0.7479)
- Enduro LongRun (score: 0.7389)
Merk op dat “MarathonPro 3000” bovenaan komt te staan—precies wat we zouden verwachten.
Gefeliciteerd! Je hebt succesvol een vectorzoekapplicatie vanaf nul gebouwd. Je leerde hoe je verbinding maakt met een database, data maakt en valideert, vector-embeddings genereert en de kracht van MongoDB Atlas benut om informatie op een echt intelligente manier te vinden. Welkom in de toekomst van datainteractie.
In deze tutorial heb je geleerd om:
Experimenteer met verschillende similariteitsmaten (dotProduct, euclidean).
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

