Curso
Criando Aplicações de IA com Pinecone
3 h
11.9K
Há pouco tempo, os computadores funcionavam como bibliotecários eficientes, porém literais. Se você buscasse por "batalhas de robôs gigantes", eles só encontrariam títulos com essas palavras exatas. Uma correspondência perfeita como "Kaiju Mech Warfare" passaria batido. Os computadores reconheciam palavras, mas perdiam a música—faltavam entendimento, nuances e contexto. Essa foi a era da busca por palavras-chave, que foi nossa melhor opção por muitos anos.
Então veio a revolução. Inspirada no cérebro humano, a inteligência artificial desenvolveu uma nova forma de aprender. Em vez de simplesmente memorizar palavras, a IA passou a compreender as relações entre elas. Entendeu que "rei" se relaciona com "homem" assim como "rainha" com "mulher". Reconheceu que "feliz", "alegre" e "eufórico" compartilham o mesmo território emocional, enquanto "soturno" está em um universo à parte.
Como a IA conseguiu isso? Criando um mapa de significados.
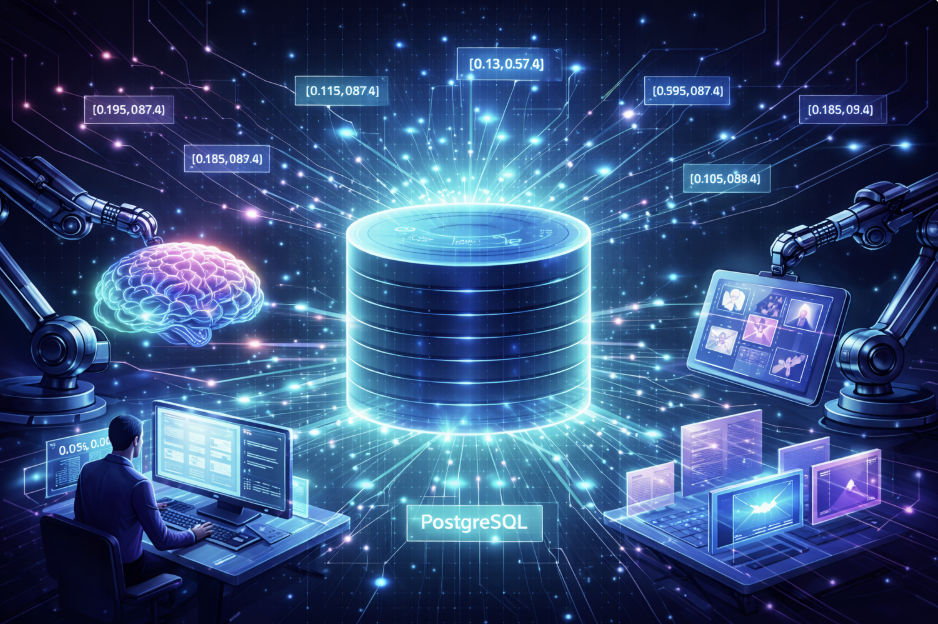
Imagine uma galáxia vasta e multidimensional onde cada conceito—uma palavra, uma frase, uma imagem, uma música—é uma estrela. Nessa galáxia, estrelas com significados semelhantes se agrupam, enquanto as não relacionadas ficam a anos-luz de distância.
Uma vector embedding é simplesmente a coordenada de uma estrela nessa galáxia. É uma lista de números (por exemplo, [0.12, -0.45, 0.89, ...]) que localiza com precisão um conceito nesse mapa de significados.
Vector search é a habilidade revolucionária de navegar por esse mapa. Quando você pede "um filme sobre um garoto órfão que descobre que é um bruxo", não buscamos essas palavras exatas. Em vez disso, nós:
As estrelas mais próximas representam os resultados semanticamente mais semelhantes. É assim que a IA evoluiu de uma bibliotecária literal para uma sábia que entende o que você realmente quer dizer.
Buscar por significado em vez de palavras-chave impulsiona aplicações modernas de IA em diversos setores. Essa capacidade permite:
A busca vetorial aproxima a intenção humana dos dados digitais, transformando a forma como interagimos com a informação. Essa tecnologia faz os sistemas digitais parecerem menos mecânicos e mais como colaboradores intuitivos.
Bem-vindo à nova fronteira da busca! O MongoDB lançou o Vector Search no Atlas. Isso permite armazenar e consultar embeddings vetoriais (de texto, imagens ou áudio) diretamente no MongoDB—sem precisar de um banco de dados vetorial separado como o Pinecone ou o Weaviate.
Neste tutorial, vamos construir um mecanismo simples, porém poderoso, de recomendação de tênis usando Python e MongoDB Atlas. Você vai aprender a transformar texto em representações numéricas com significado (vetores) e depois usar o Vector Search nativo do Atlas para encontrar produtos com descrições semelhantes.
pip install pymongo sentence-transformers numpy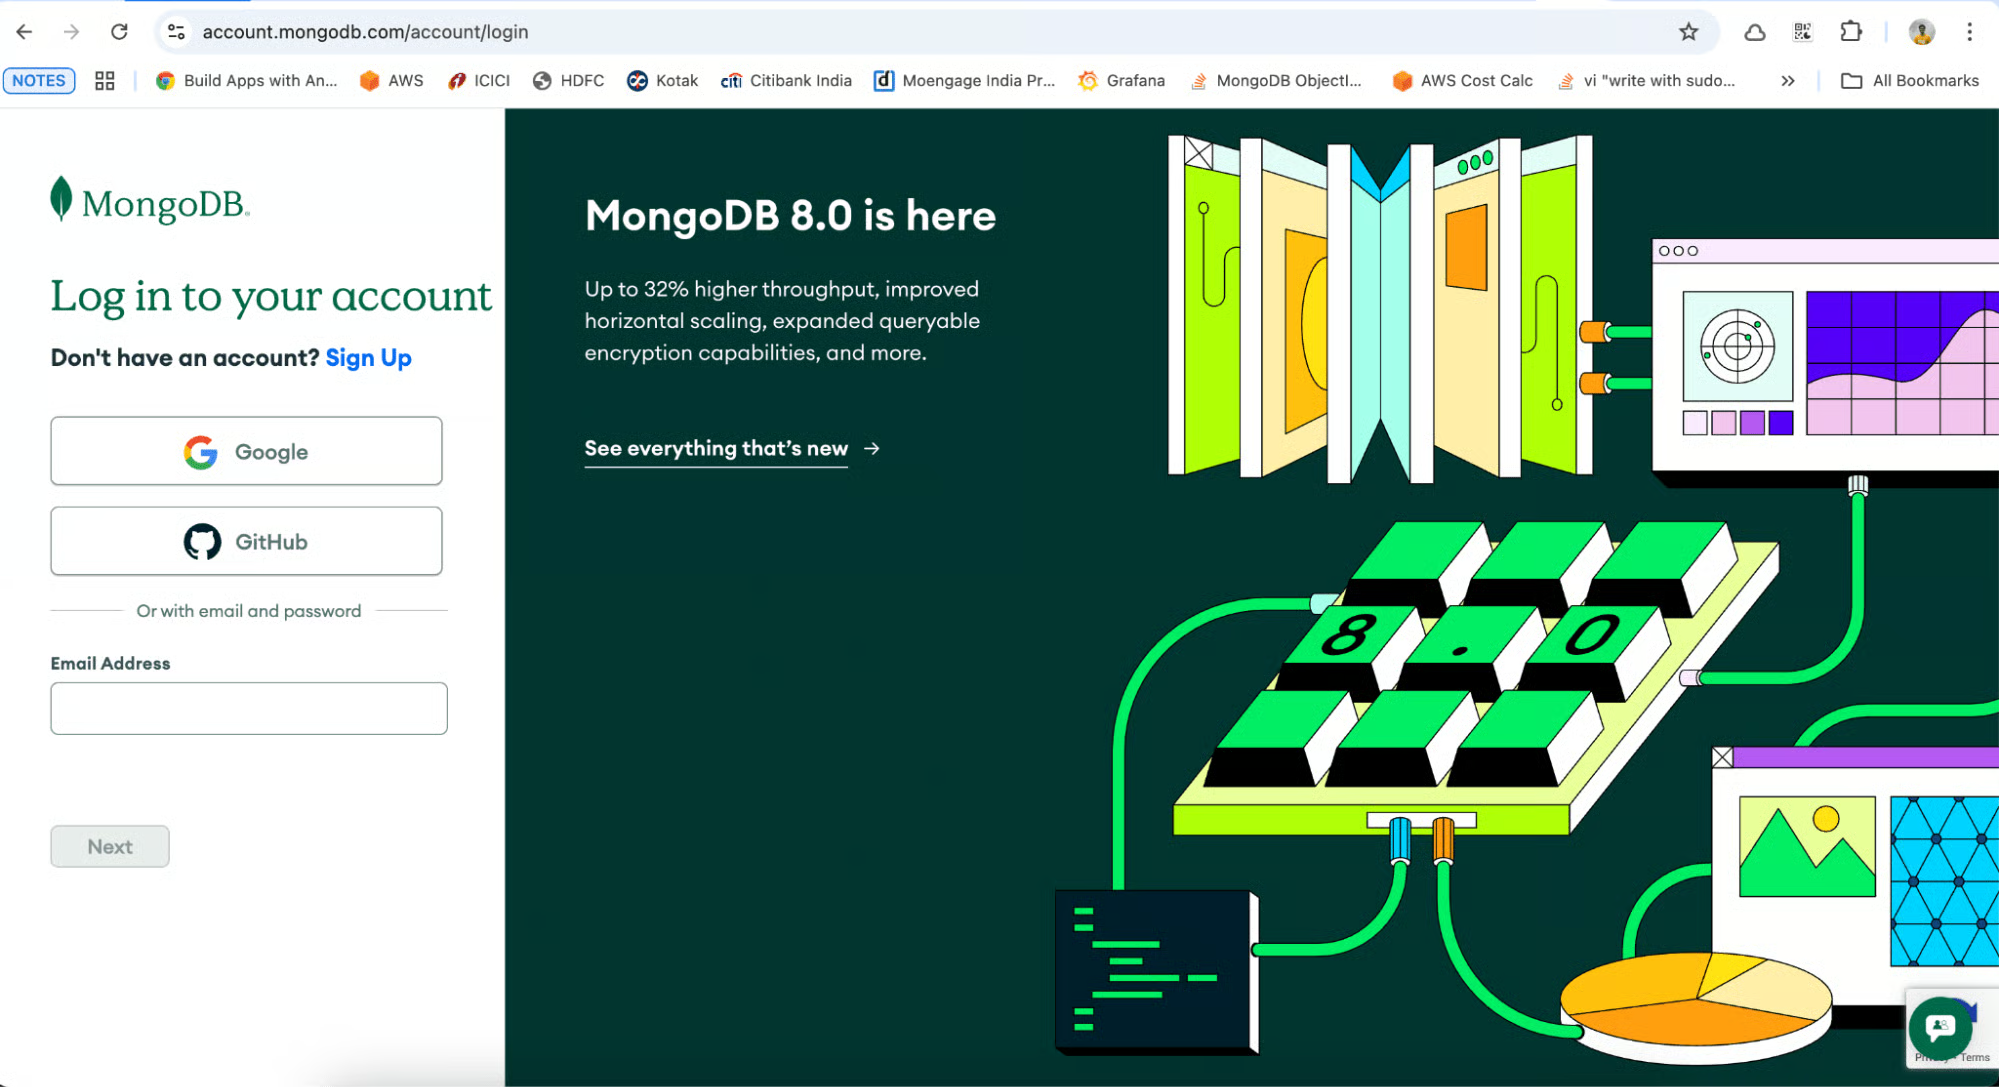
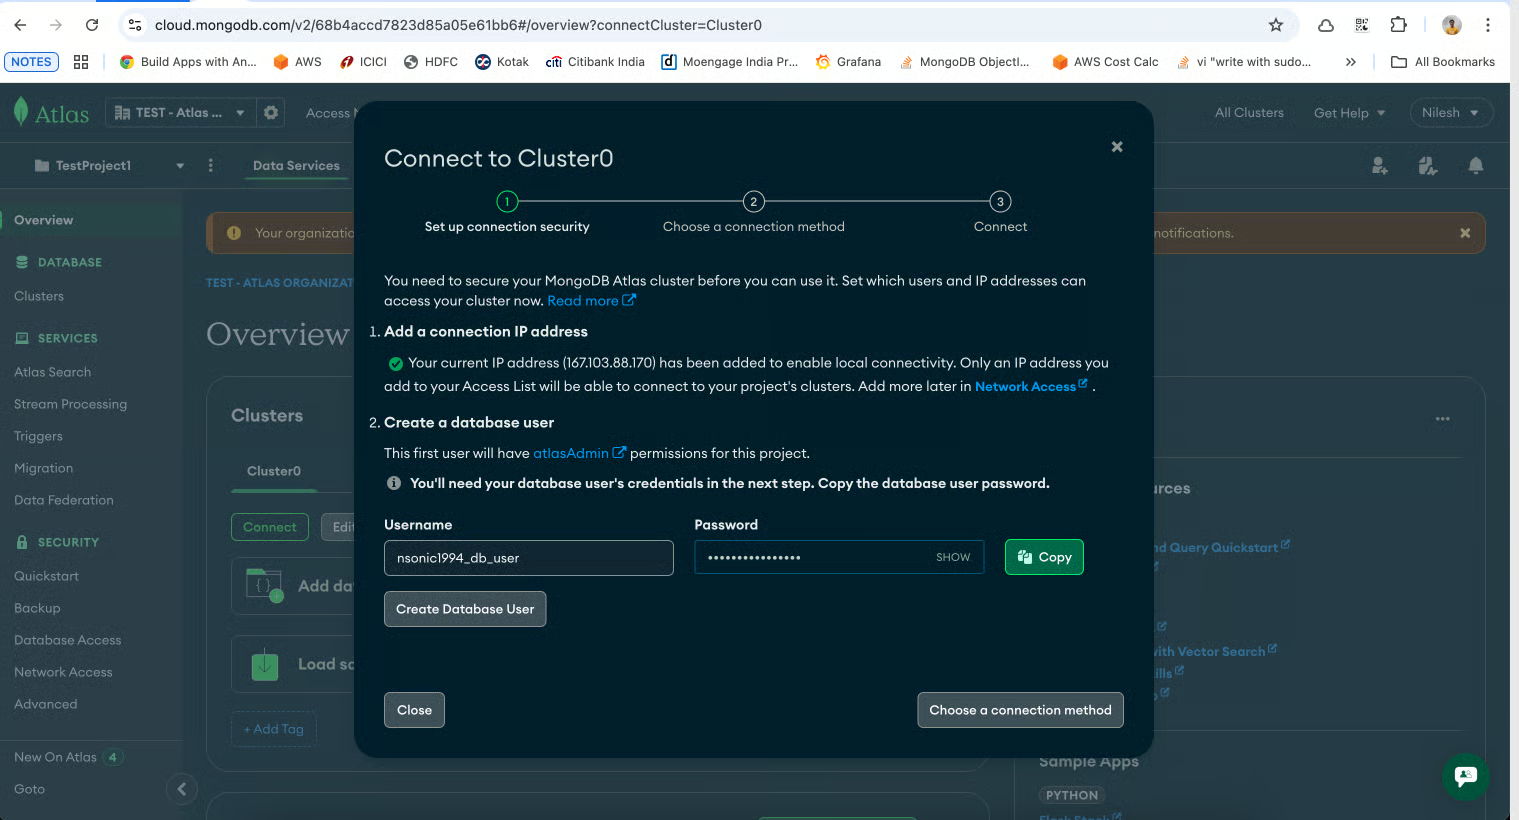
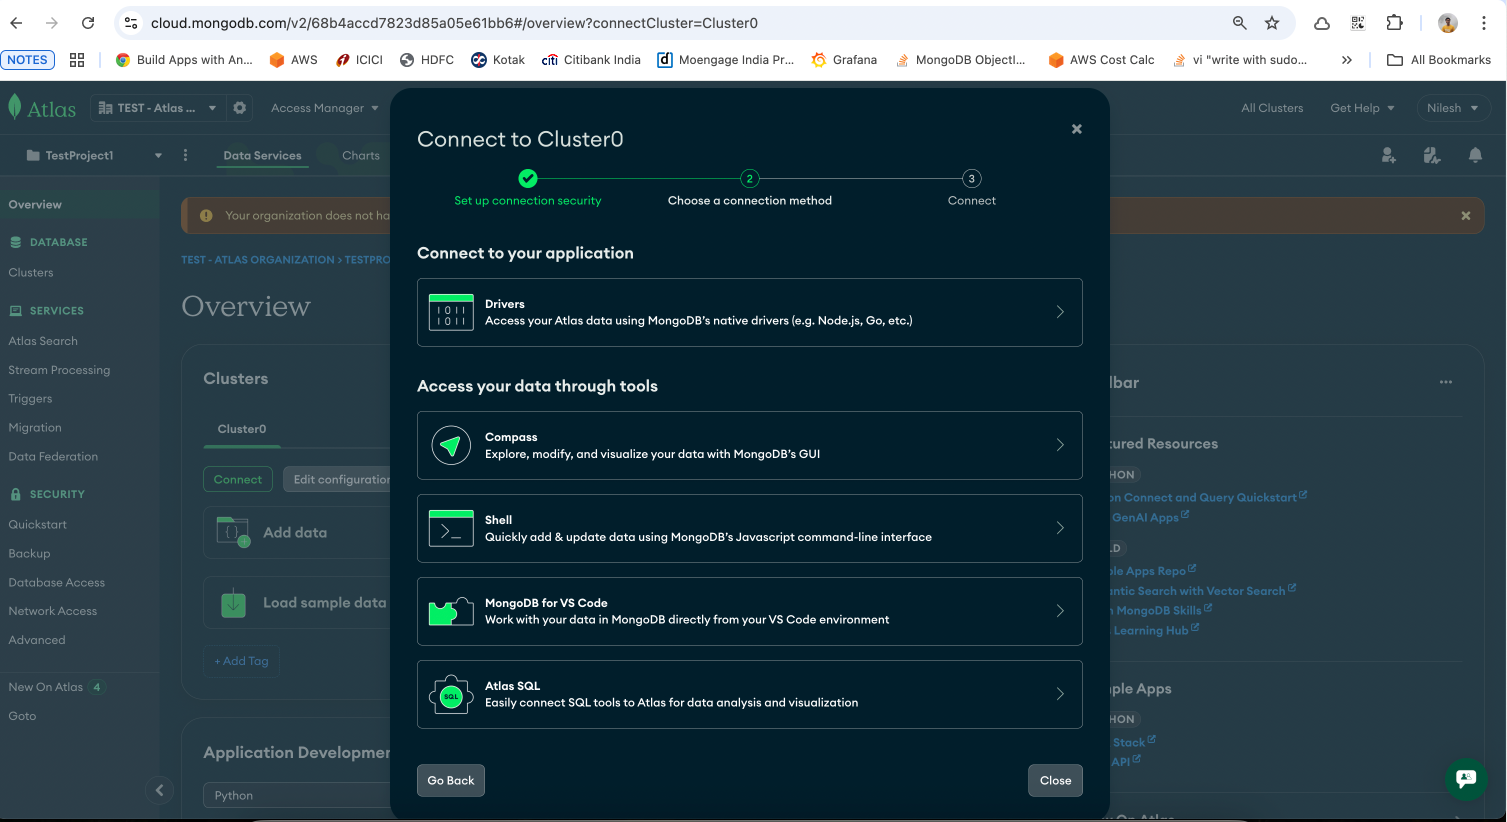
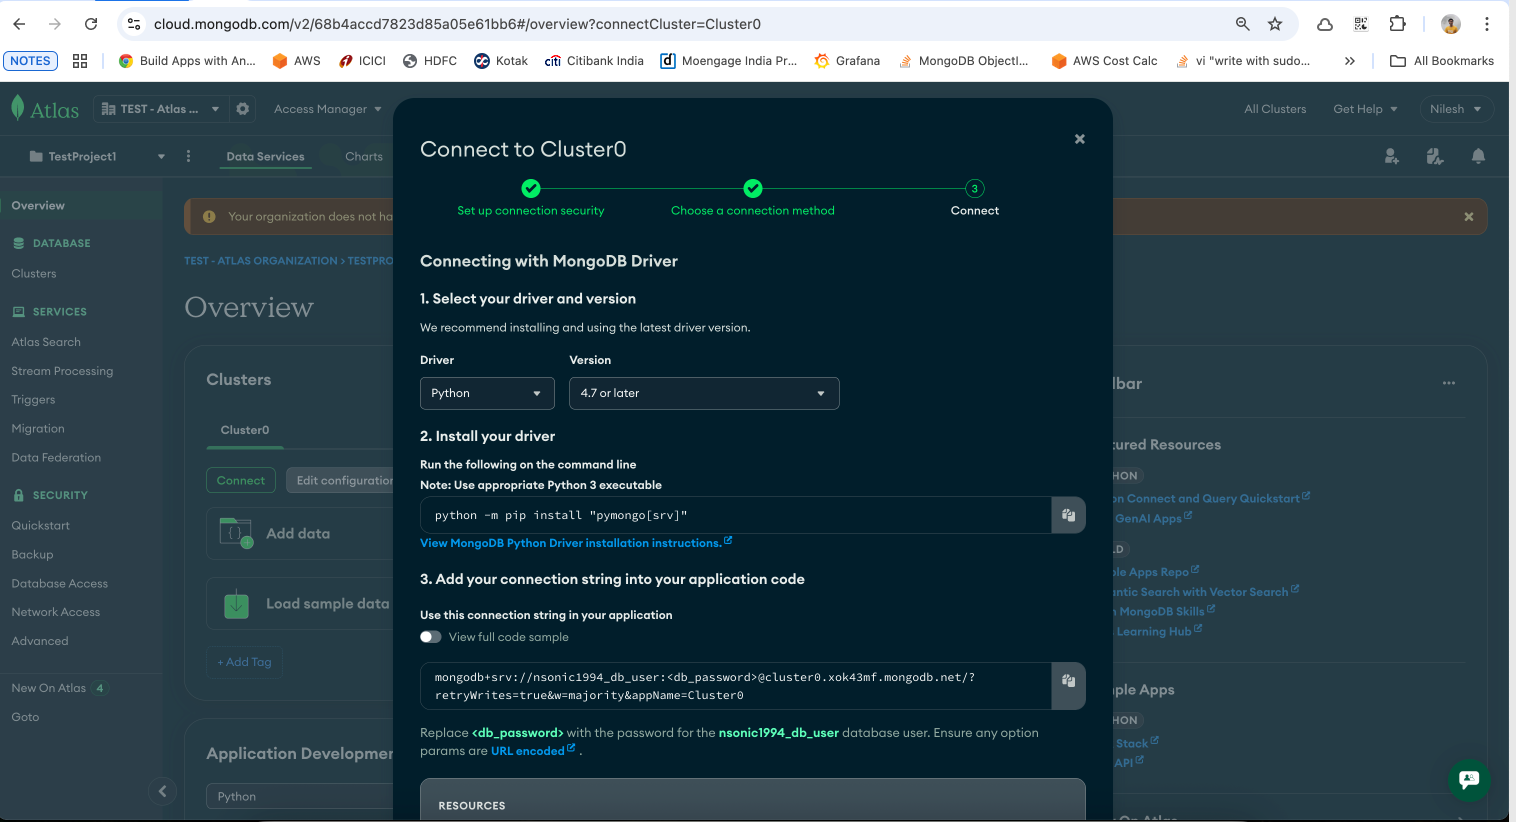
vectorDemoitems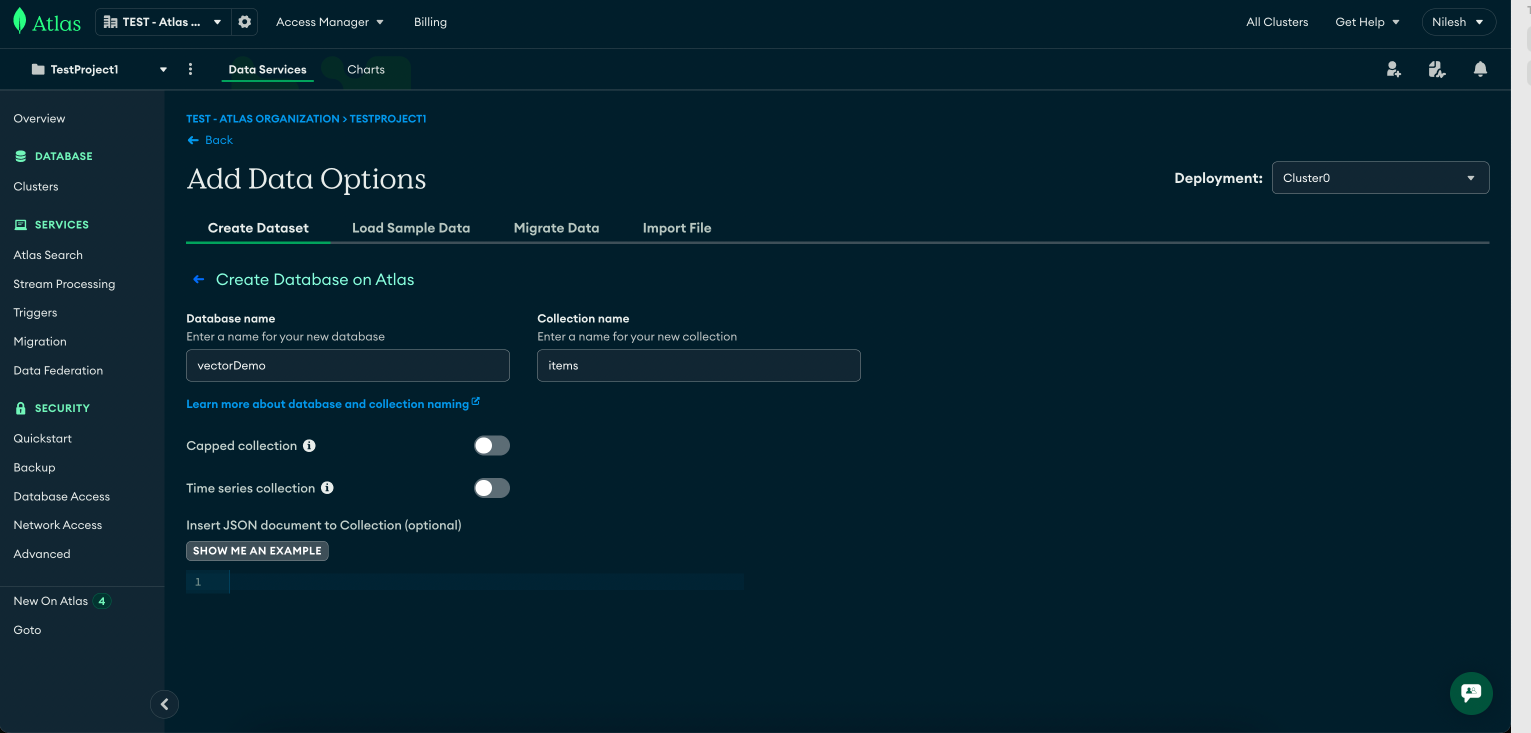
items.{
"fields": [
{
"type": "vector",
"path": "embedding",
"numDimensions": 768,
"similarity": "cosine"
}
]
}
Observação: 768 é o tamanho do embedding que usaremos com o modelo sentence-transformers.
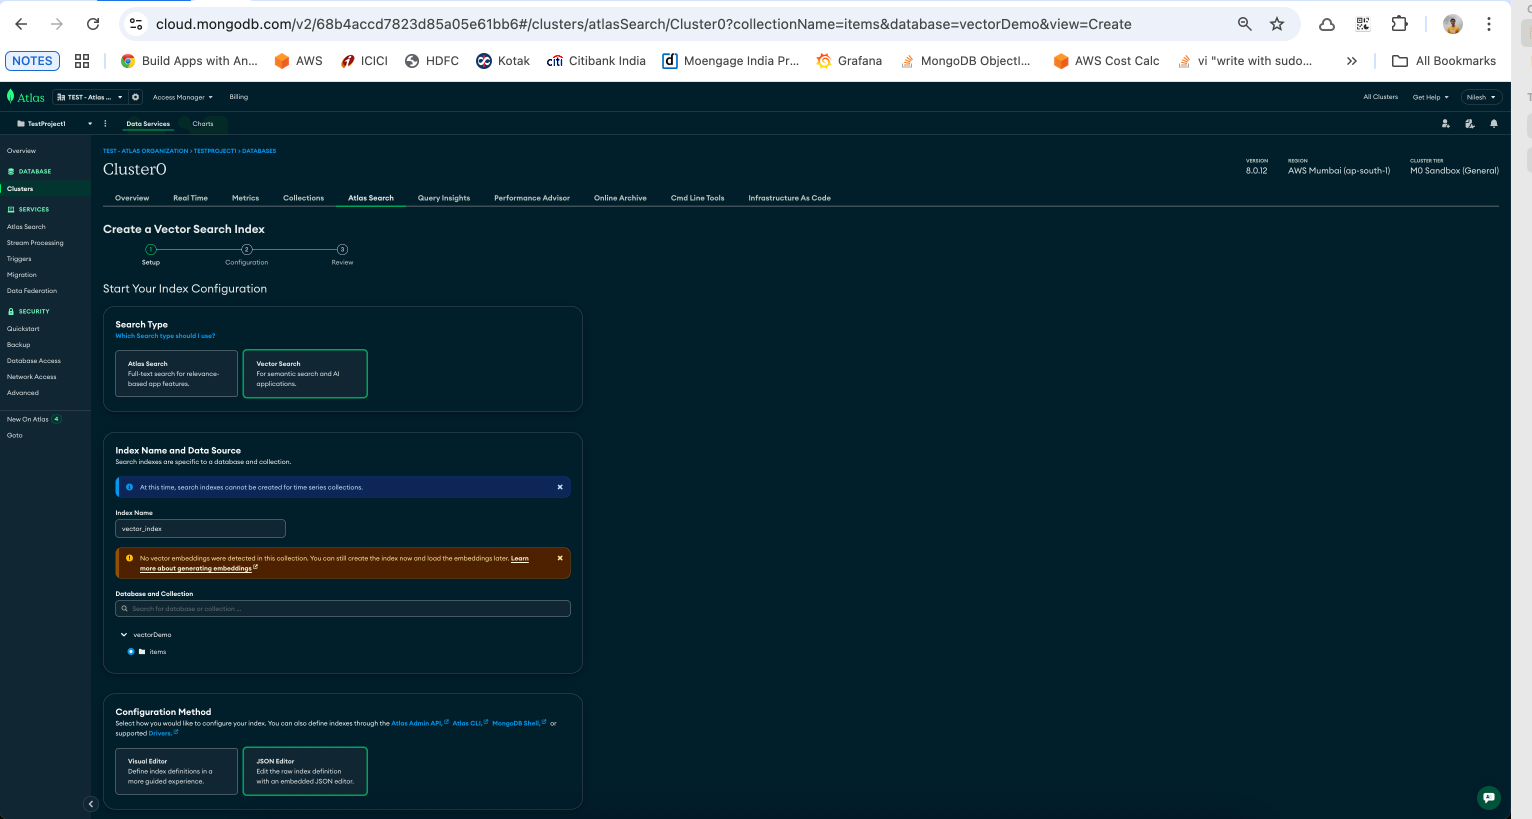
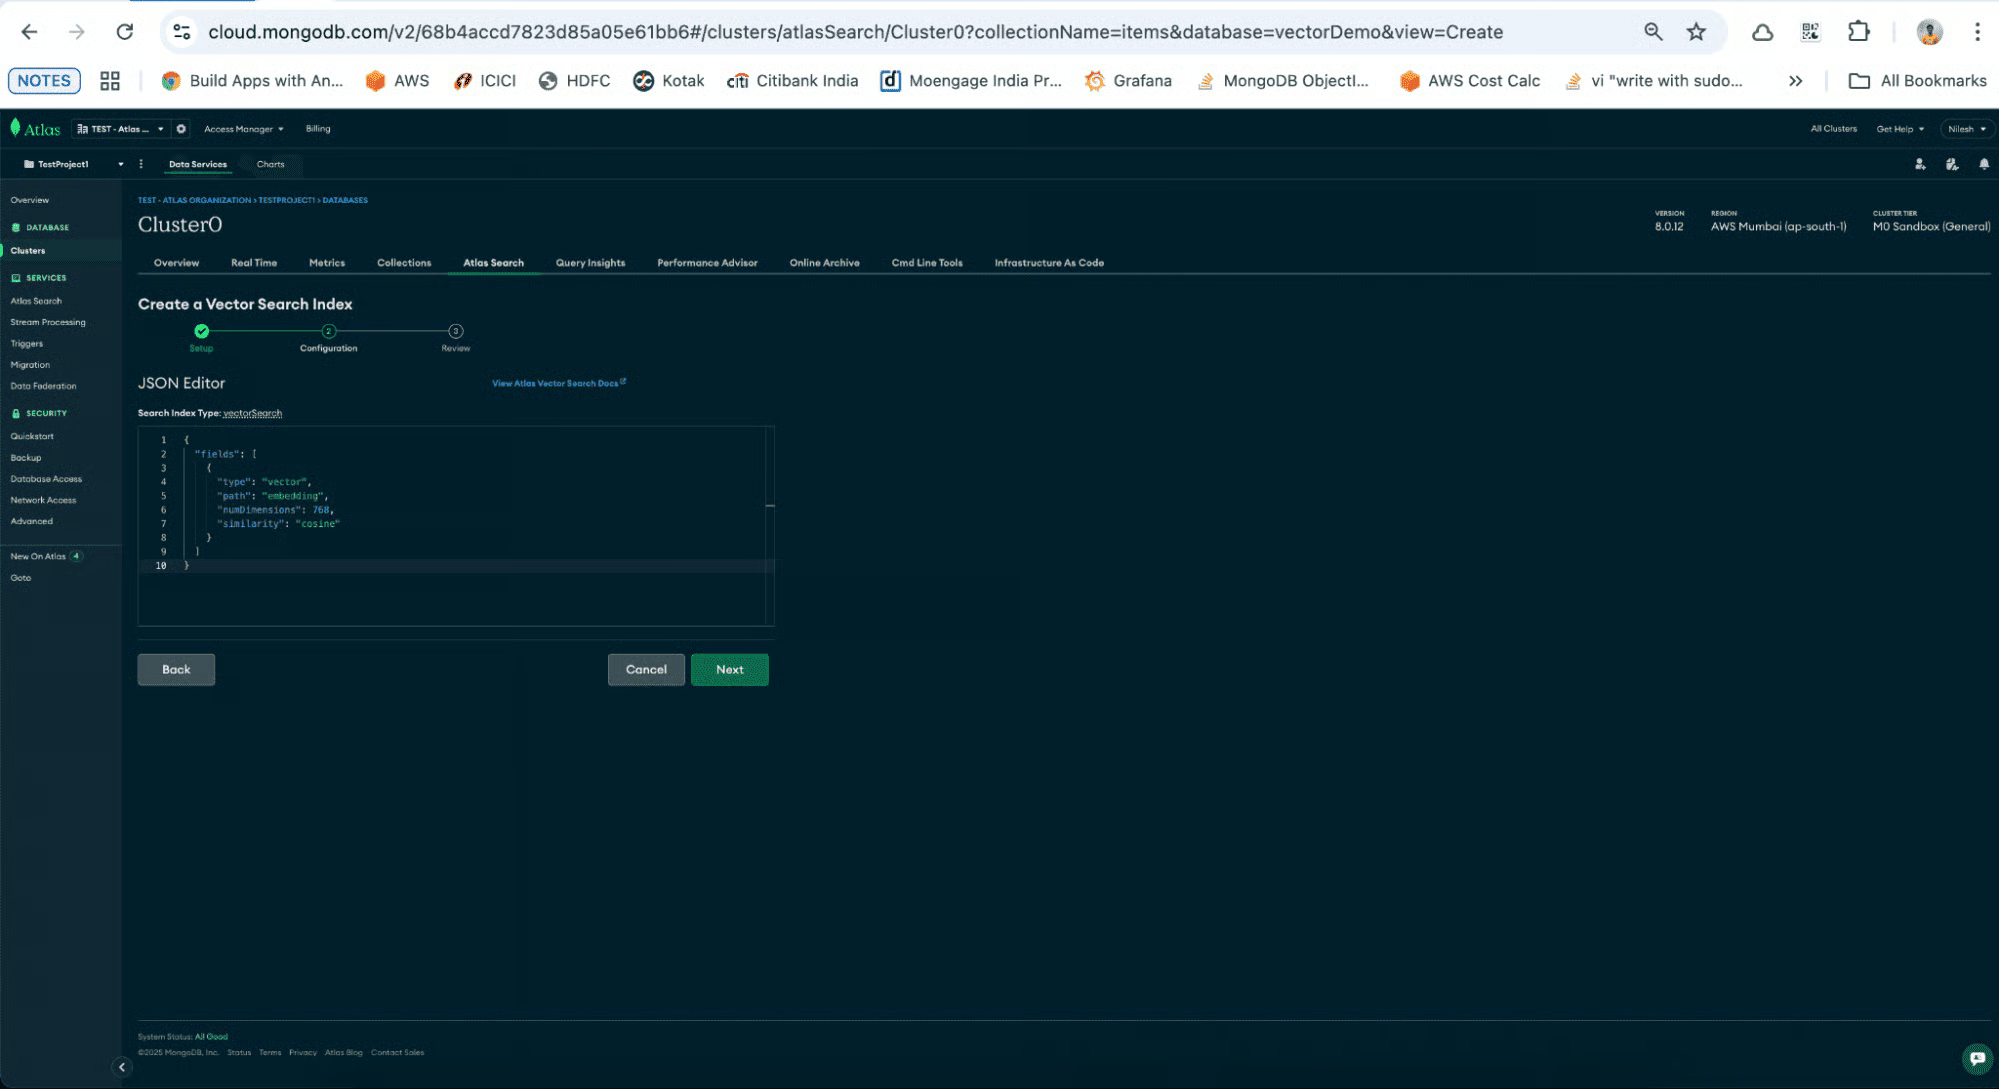
Entendendo a definição do índice:
"type": "vector": Informa ao MongoDB Atlas que este é um índice vetorial."path": "embedding": Crucialmente, aponta para o campo nos documentos que contém os vetores."numDimensions": 768: Isso precisa corresponder à dimensionalidade dos vetores produzidos pelo nosso modelo."similarity": "cosine": O algoritmo usado para medir a “proximidade” dos vetores. É excelente para similaridade baseada em texto.Obtenha sua string de conexão do MongoDB Atlas:
<username>, <password> e <cluster-url> no trecho abaixo.from pymongo import MongoClient
# Replace with your Atlas connection string
uri = "mongodb+srv://<username>:<password>@<cluster-url>/vectorDemo?retryWrites=true&w=majority"
client = MongoClient(uri)
db = client["vectorDemo"]
collection = db["items"]
print("Connected to MongoDB Atlas")
# Clear existing
collection.delete_many({})
print("Cleared collection.")Vamos usar o SentenceTransformers para converter texto em embeddings.
from sentence_transformers import SentenceTransformer
# Choose model: higher-quality for search -> "sentence-transformers/all-mpnet-base-v2" (768-d)
# If you need faster/smaller: "all-MiniLM-L6-v2" (384-d)
MODEL_NAME = "sentence-transformers/all-mpnet-base-v2"
# MODEL_NAME = "all-MiniLM-L6-v2"

# Note: if you use all-mpnet-base-v2, your Atlas vector index must use numDimensions: 768
# If you use all-MiniLM-L6-v2, index numDimensions: 384
model = SentenceTransformer(MODEL_NAME)

def embed_text(text: str):
return model.encode(text).tolist()Vamos armazenar algumas descrições de produtos no MongoDB com seus embeddings.
# Each product includes name, description, list of features, use_cases and tags.
products = [
    # Marathon / long-distance running (explicit!)
    {
        "name": "MarathonPro 3000",
        "description": "Designed specifically for marathon and ultra distance running: maximum cushioning, breathable knit upper, responsive midsole and engineered heel support for long-run comfort.",
        "features": ["marathon", "long-distance", "max cushioning", "breathable", "support"],
        "category": "shoes",
        "use_cases": ["marathon", "long-distance running", "road running"],
        "tags": ["running", "endurance", "comfort"]
    },
    {
        "name": "Enduro LongRun",
        "description": "Lightweight long-run trainer optimized for marathon pacing with added cushioning, stable platform, and enhanced forefoot energy return for hours of comfortable running.",
        "features": ["long-run", "lightweight", "energy return", "cushioning"],
        "category": "shoes",
        "use_cases": ["marathon", "road running"],
        "tags": ["running","marathon","comfort"]
    },

    # Road running / neutral
    {
        "name": "Red Road Runner",
        "description": "Neutral road running shoe for daily training: breathable mesh, moderate cushioning and responsive ride; suitable for tempo runs and long easy runs.",
        "features": ["road running", "breathable", "moderate cushioning"],
        "category": "shoes",
        "use_cases": ["training", "road running", "tempo runs"],
        "tags": ["running","training"]
    },

    # Trail running (explicit trail)
    {
        "name": "TrailMaster RidgeGrip",
        "description": "Trail-running shoe with aggressive outsole, rock plate for protection, waterproof upper, designed for technical trails and rugged terrain.",
        "features": ["trail", "high grip", "rock plate", "waterproof"],
        "category": "shoes",
        "use_cases": ["trail running", "hiking", "off-road"],
        "tags": ["trail","outdoors"]
    },

    # Tennis & court
    {
        "name": "CourtPro Tennis",
        "description": "Court shoe with lateral support, non-marking sole and reinforced toe; built for tennis footwork and short intense bursts, not for long-distance running.",
        "features": ["court", "lateral support", "non-marking sole"],
        "category": "shoes",
        "use_cases": ["tennis","court sports"],
        "tags": ["tennis","sport"]
    },

    # Formal
    {
        "name": "Oxford Leather Formal",
        "description": "Classic leather formal shoe for office and events: polished leather, sturdy sole, refined silhouette.",
        "features": ["formal", "leather", "office"],
        "category": "shoes",
        "use_cases": ["formal wear","office"],
        "tags": ["formal","leather"]
    },

    # Hiking
    {
        "name": "Alpine Trek Boots",
        "description": "High-ankle hiking boots with waterproof membrane, ankle support and durable lugged outsole for mountain treks.",
        "features": ["hiking", "waterproof", "ankle support", "lugged outsole"],
        "category": "shoes",
        "use_cases": ["hiking","trekking","outdoor"],
        "tags": ["outdoors","hiking"]
    },

    # Casual sneakers
    {
        "name": "Classic Canvas Sneaker",
        "description": "Casual everyday canvas sneaker with rubber sole, comfortable fit for daily wear and walking.",
        "features": ["casual","canvas", "everyday"],
        "category": "shoes",
        "use_cases": ["casual","walking"],
        "tags": ["casual"]
    },

    # Cross-trainer
    {
        "name": "CrossFit Trainer",
        "description": "Stable cross-trainer shoe engineered for gym workouts, short sprints, and lateral movements; flexible yet supportive.",
        "features": ["cross-train","stable","gym"],
        "category": "shoes",
        "use_cases": ["gym","cross-training"],
        "tags": ["training","gym"]
    },

    # Cleats
    {
        "name": "Pro Soccer Cleats",
        "description": "Low-profile football/soccer cleats with studded outsole; optimized for grip on grass and agility.",
        "features": ["cleats","studs","agility"],
        "category": "shoes",
        "use_cases": ["soccer","football"],
        "tags": ["sports","cleats"]
    }
]

# ---------- Create 'canonical_text' to improve embedding quality for better scoring ----------
for p in products:
    # join features and others into one rich text blob
    features = ", ".join(p["features"])
    uses = ", ".join(p["use_cases"])
    tags = ", ".join(p["tags"])
    canonical = f"{p['name']}. {p['description']}. Features: {features}. Use cases: {uses}. Tags: {tags}."
    p["canonical_text"] = canonical

# ---------- Embed canonical_text----------
print("Embedding items...")
for p in products:
    p["embedding"] = embed_text(p["canonical_text"])

# ---------- Insert into MongoDB ----------
collection.insert_many(products)
Ao usar o insert_many, fazemos uma única operação em lote eficiente no banco de dados.
Chegou a hora do passo final e mais empolgante! Vamos usar o framework de agregação do MongoDB e o $vectorSearch—um operador para encontrar os melhores tênis para a consulta.
query_text = "25k long running best shoes"
query_embedding = embed_text(query_text)

pipeline = [
    {
        "$vectorSearch": {
            "index": "vector_index",  # Use the vector search index you created
            "path": "embedding",
            "queryVector": query_embedding,
            "numCandidates": 100,
            "limit": 3
        }
    },
    {
        "$project": {
            "name": 1,
            "description":1,
            "score": {"$meta": "vectorSearchScore"}
        }
    }
]

results = collection.aggregate(pipeline)

print(f"\nSearch results for: '{query_text}'\n")
for r in results:
    print(f"- {r['name']} (score: {r['score']:.4f})")
Dissecando o pipeline $vectorSearch:
$vectorSearch: Este é o operador central. Ele compara de forma eficiente nosso queryVector com o campo indexado plot_embedding de todos os documentos.$project: Esta etapa remodela a saída. Incluímos name e description, excluímos o ruído do _id e outros campos e, principalmente, adicionamos um campo score usando $meta: "vectorSearchScore". Esse score, de 0 a 1, indica o quão semelhante o resultado é à nossa consulta.Se tudo estiver configurado corretamente, você verá algo assim:
Search results for: '25k long running best shoes'

- MarathonPro 3000 (score: 0.7980)
- Red Road Runner (score: 0.7479)
- Enduro LongRun (score: 0.7389)
Perceba que “MarathonPro 3000” aparece no topo—exatamente como esperado.
Parabéns! Você acabou de construir um aplicativo de busca vetorial do zero. Aprendeu a se conectar a um banco de dados, criar e validar dados, gerar embeddings vetoriais e aproveitar o poder do MongoDB Atlas para encontrar informação de um jeito realmente inteligente. Bem-vindo ao futuro da interação com dados.
Neste tutorial, você aprendeu a:
Experimente diferentes métricas de similaridade (dotProduct, euclidean).
Principais cursos da DataCamp
Curso
Curso
Curso
Tutorial
Moez Ali
10 min
Tutorial
Kevin Babitz
8 min
Tutorial
Joleen Bothma
9 min
Tutorial
DataCamp Team
3 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Aditya Sharma
8 min