Last chance! 50% off DataCamp Premium
Sale ends in
हाल तक, कंप्यूटर कुशल लेकिन शब्दशः लाइब्रेरियन की तरह काम करते थे। यदि आप "giant robot battles" खोजते, तो वे केवल उन्हीं सटीक शब्दों वाले शीर्षक ढूँढते। "Kaiju Mech Warfare" जैसा एकदम उपयुक्त मेल भी छूट जाता। कंप्यूटर शब्दों को पहचानते थे, पर संगीत चूक जाते थे—समझ, बारीकी और संदर्भ का अभाव था। यह कीवर्ड सर्च का युग था, जो कई वर्षों तक हमारा सबसे अच्छा विकल्प रहा।
फिर आई एक क्रांति। मानव मस्तिष्क से प्रेरणा लेते हुए, कृत्रिम बुद्धिमत्ता ने सीखने का एक नया तरीका विकसित किया। केवल शब्दों को रटने के बजाय, AI ने उनके बीच के संबंधों को समझना शुरू किया। यह समझा कि "king" का "man" से वैसा ही संबंध है जैसा "queen" का "woman" से। उसने पहचाना कि "happy," "joyful," और "ecstatic" एक ही भावनात्मक क्षेत्र साझा करते हैं, जबकि "sombre" बिल्कुल अलग दुनिया में है।
AI ने यह कैसे किया? एक अर्थ मानचित्र बनाकर।
एक विशाल, बहु-आयामी आकाशगंगा की कल्पना करें जहाँ हर अवधारणा—एक शब्द, एक वाक्य, एक छवि, एक गीत—एक तारा है। इस आकाशगंगा में, समान अर्थ वाले तारे एक साथ समूह बनाते हैं, जबकि असंबंधित तारे प्रकाश-वर्षों दूर रहते हैं।
एक vector embedding बस इस आकाशगंगा में किसी तारे का निर्देशांक है। यह संख्याओं की एक सूची है (जैसे [0.12, -0.45, 0.89, ...]) जो इस अर्थ मानचित्र पर किसी अवधारणा को सटीक रूप से स्थित करती है।
Vector search इस मानचित्र पर नेविगेट करने की क्रांतिकारी क्षमता है। जब आप पूछते हैं, "एक फिल्म जिसमें एक अनाथ लड़का पता लगाता है कि वह जादूगर है," तो हम उन सटीक कीवर्ड्स को नहीं ढूँढते। इसके बजाय, हम:
सबसे नज़दीकी तारे सबसे अधिक सिमेंटिक रूप से मिलते-जुलते परिणामों का प्रतिनिधित्व करते हैं। इसी तरह AI एक शब्दशः लाइब्रेरियन से एक बुद्धिमान मार्गदर्शक में विकसित हुआ जो समझता है कि आप असल में क्या कहना चाहते हैं।
कीवर्ड्स के बजाय अर्थ के आधार पर खोज करना आज की कई इंडस्ट्रीज़ में आधुनिक AI अनुप्रयोगों को शक्ति देता है। यह क्षमता सक्षम करती है:
Vector search मानव मंशा और डिजिटल डेटा के बीच पुल का काम करता है, जिससे हम जानकारी के साथ कैसे इंटरैक्ट करते हैं यह मूल रूप से बदल जाता है। यह तकनीक डिजिटल सिस्टम्स को कम यांत्रिक और अधिक सहज सहयोगी जैसा बनाती है।
सर्च की नई सीमा में आपका स्वागत है! MongoDB ने Atlas में Vector Search पेश किया है। इससे आप वेक्टर एम्बेडिंग्स (जैसे टेक्स्ट, इमेज या ऑडियो की) सीधे MongoDB में स्टोर और क्वेरी कर सकते हैं—अलग वेक्टर डेटाबेस जैसे Pinecone या Weaviate की ज़रूरत नहीं।
इस ट्यूटोरियल में, हम Python और MongoDB Atlas का उपयोग करके एक सरल लेकिन शक्तिशाली जूतों की सिफारिश इंजन बनाएँगे। आप सीखेंगे कि टेक्स्ट को सार्थक संख्यात्मक निरूपण (वेक्टर) में कैसे बदलना है और फिर Atlas के बिल्ट-इन Vector Search का उपयोग करके समान कथानक वाली फ़िल्मों को कैसे ढूँढना है।
pip install pymongo sentence-transformers numpy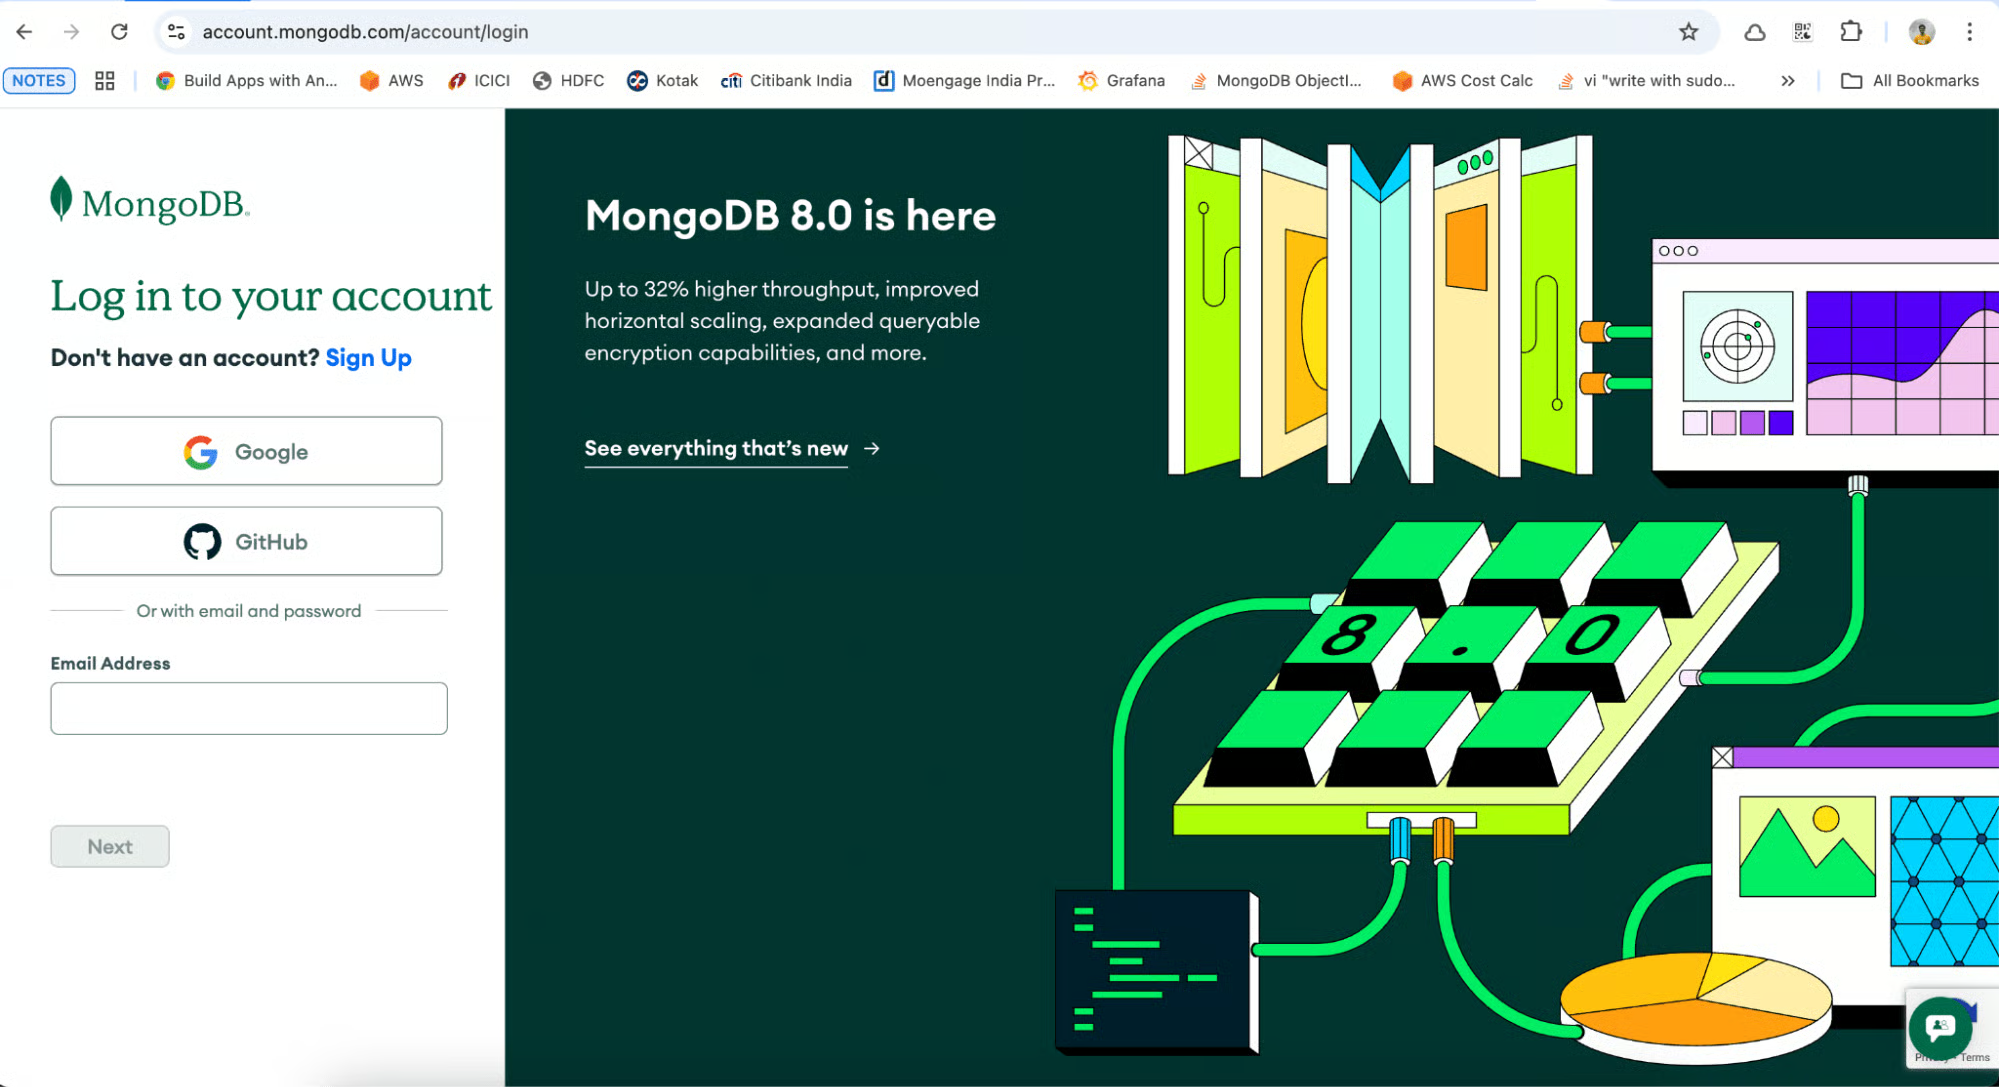
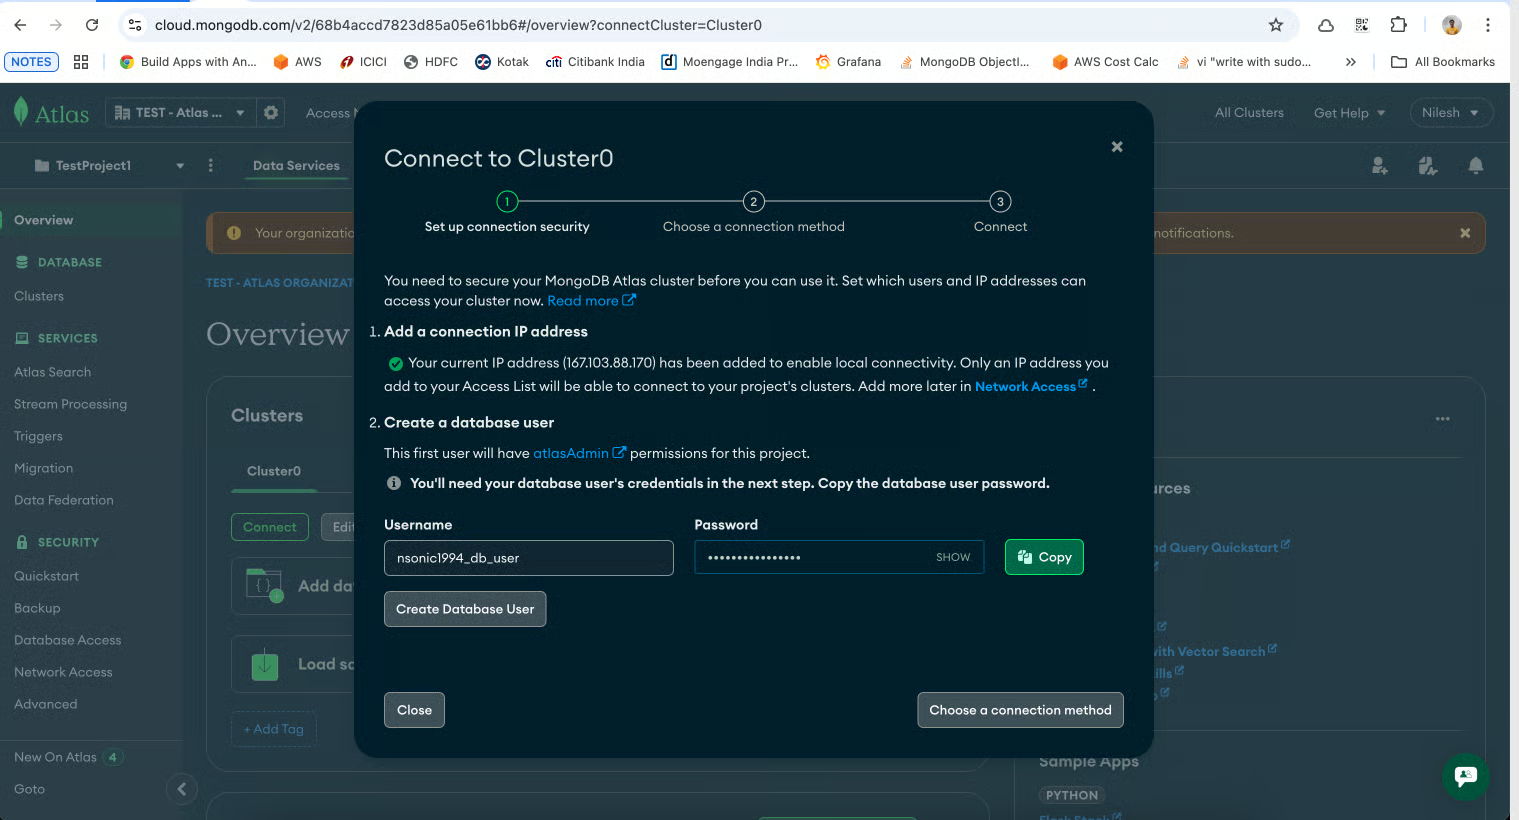
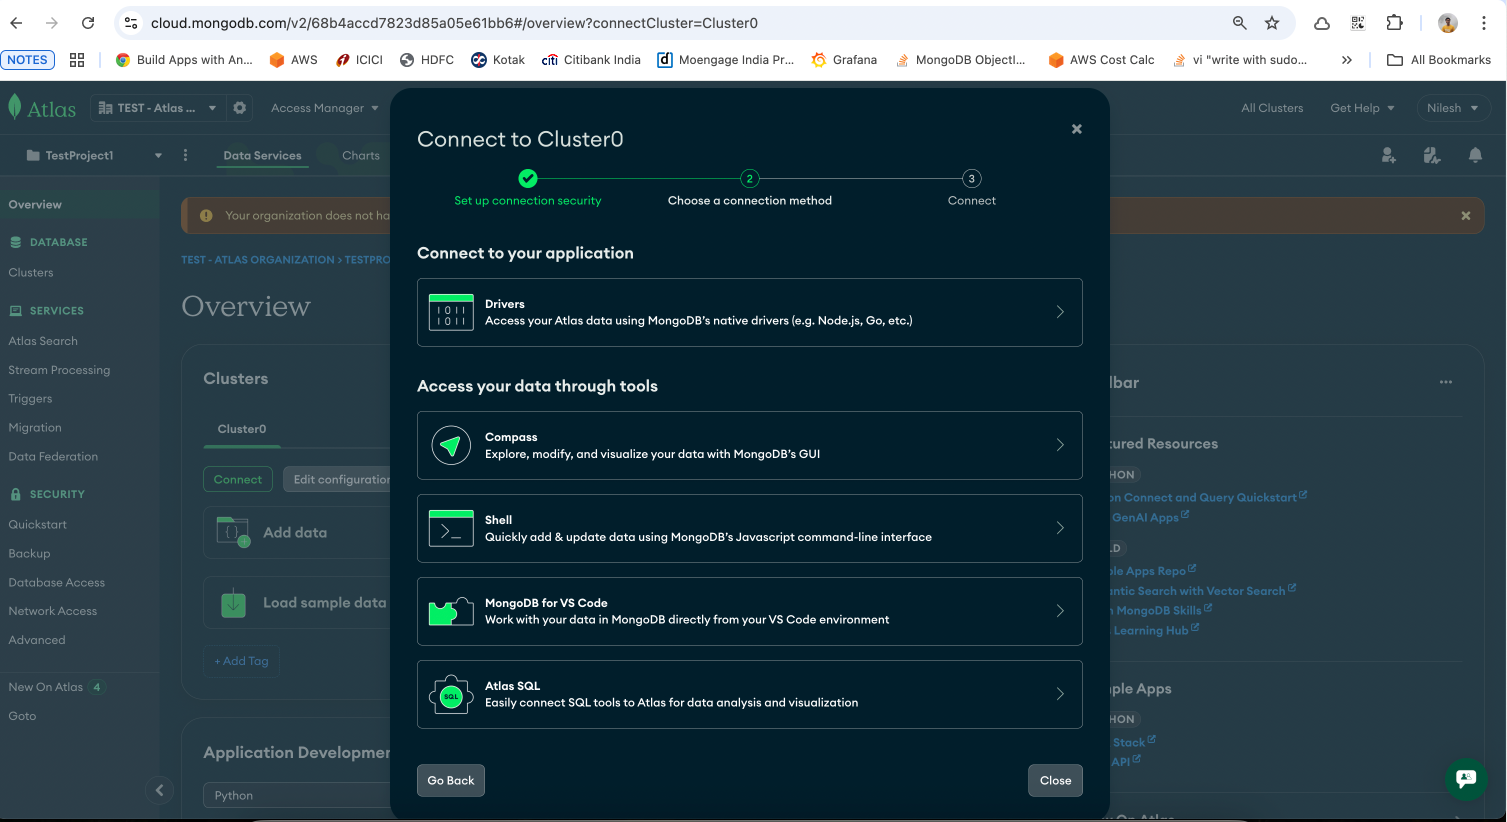
vectorDemoitems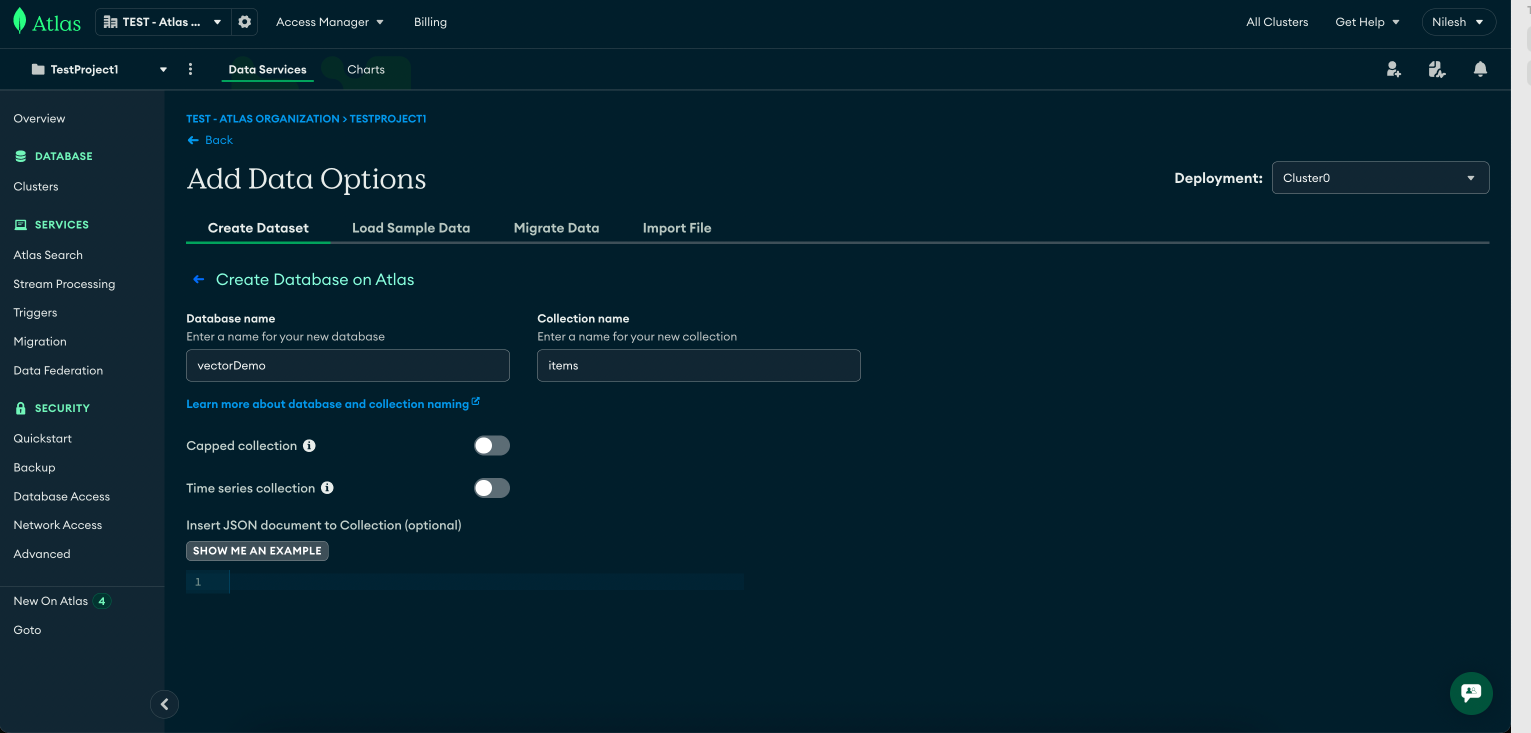
items के लिए नया इंडेक्स बनाएँ।{
"fields": [
{
"type": "vector",
"path": "embedding",
"numDimensions": 768,
"similarity": "cosine"
}
]
}
ध्यान दें: 768 वह एम्बेडिंग साइज है जिसका हम sentence-transformers मॉडल के साथ उपयोग करेंगे।
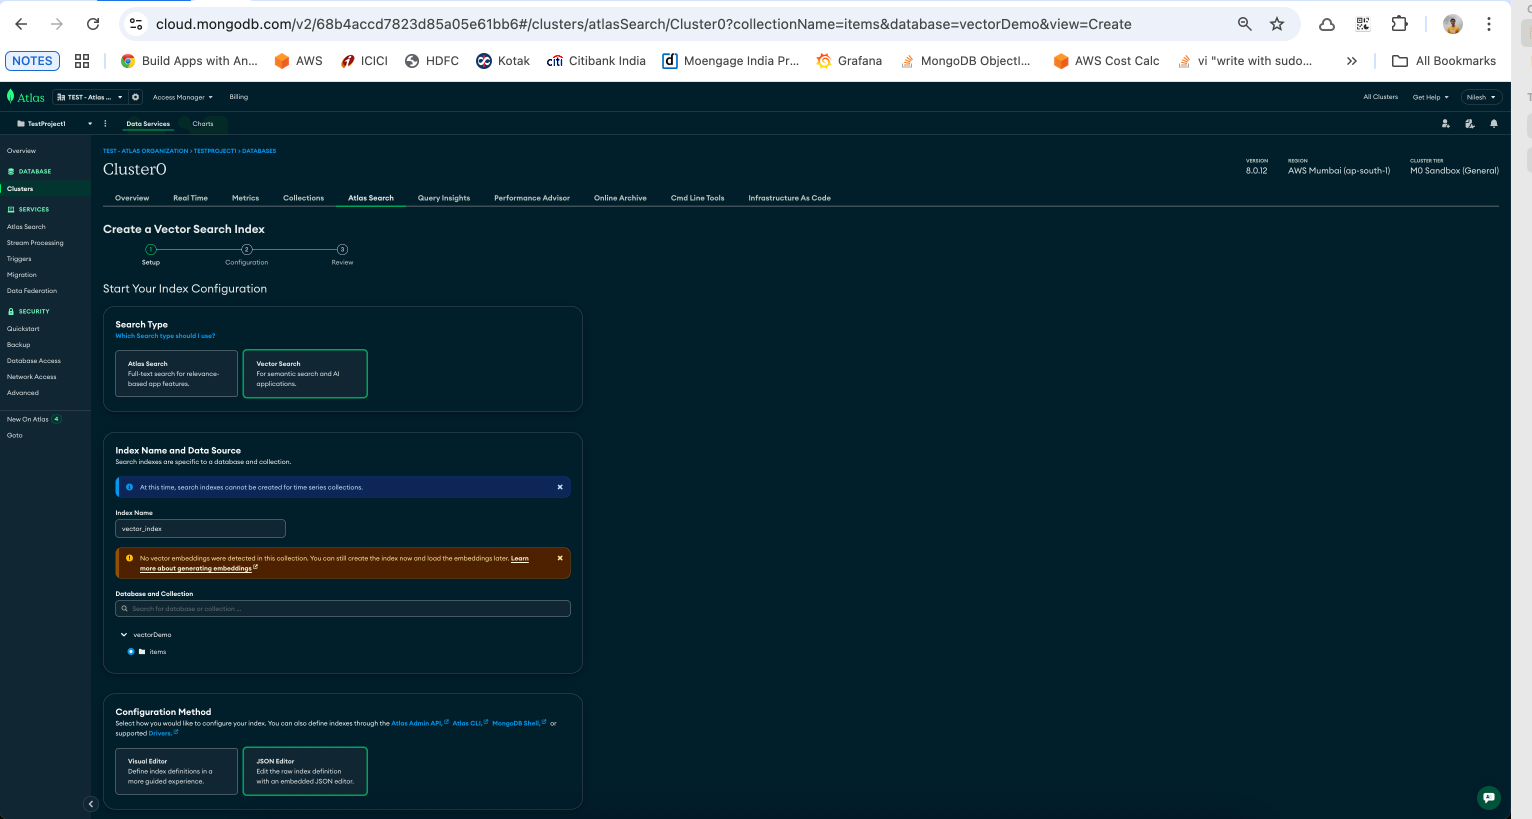
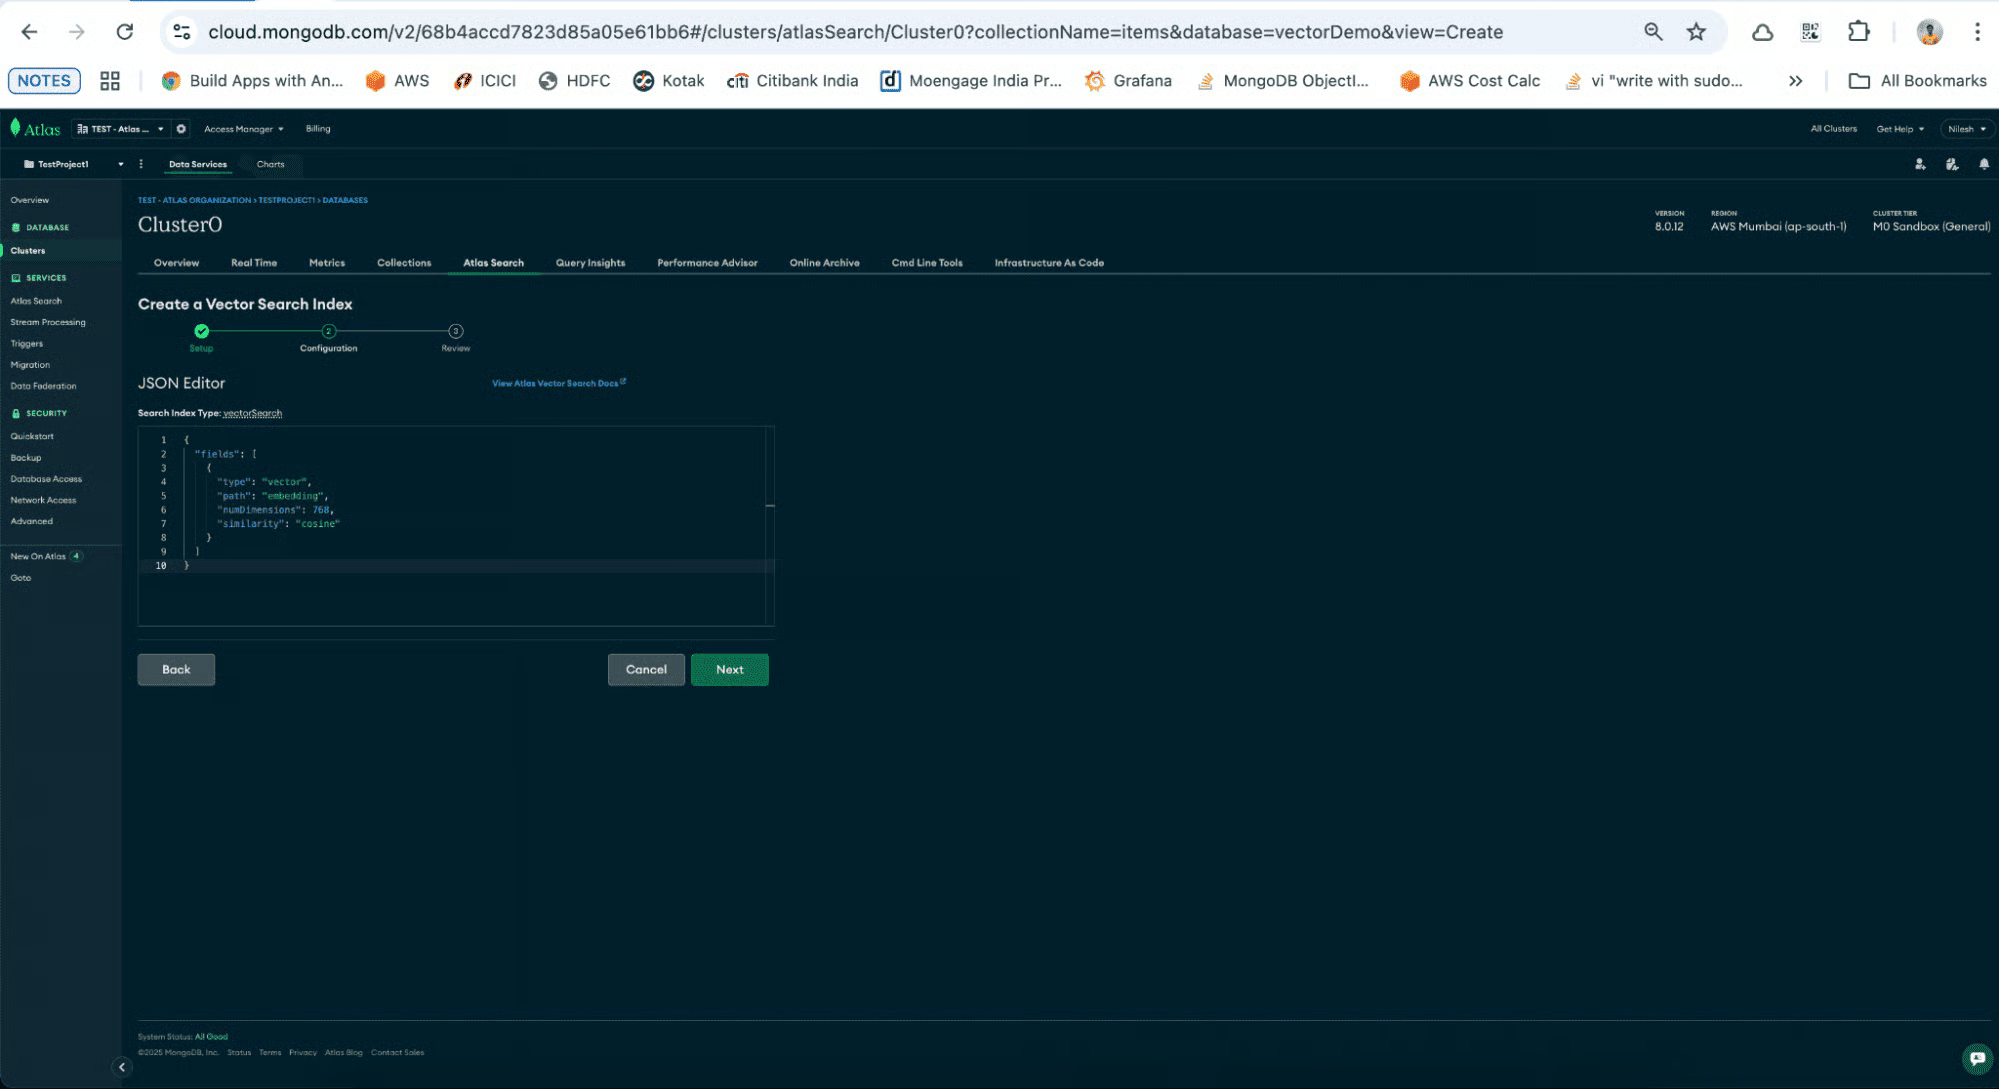
इंडेक्स परिभाषा समझना:
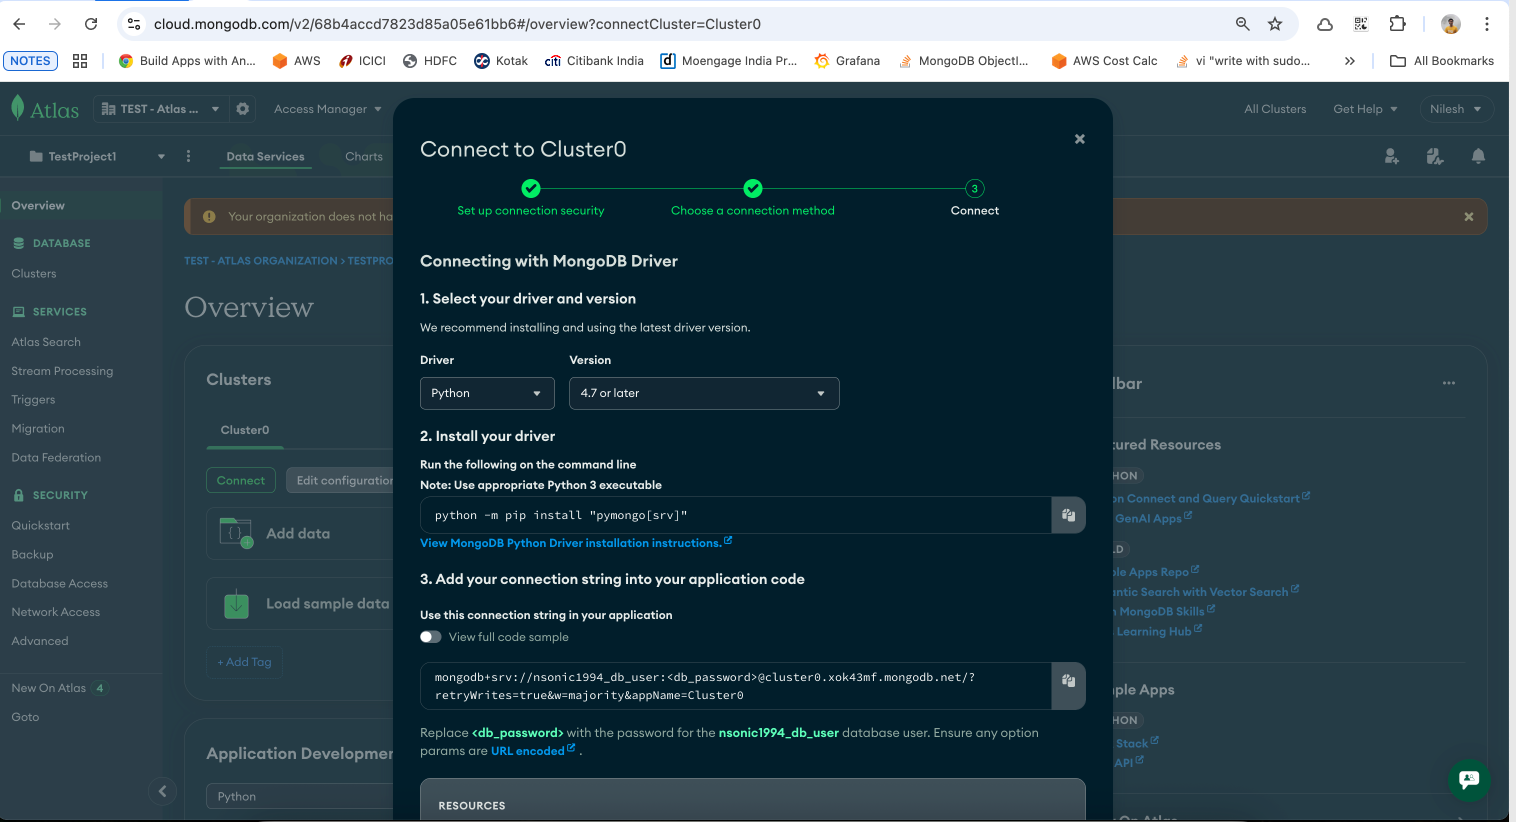
"type": "vector": यह MongoDB Atlas को बताता है कि यह एक वेक्टर इंडेक्स है।"path": "embedding": यह महत्वपूर्ण रूप से हमारे दस्तावेज़ों के उस फ़ील्ड की ओर इंगित करता है जिसमें वेक्टर हैं।"numDimensions": 768: यह ज़रूर उस आयाम से मेल खाना चाहिए जो हमारा मॉडल पैदा करता है।"similarity": "cosine": यह वेक्टरों की "निकटता" मापने के लिए प्रयुक्त एल्गोरिथ्म है। यह टेक्स्ट-आधारित समानता के लिए उत्कृष्ट है।अपनी MongoDB Atlas कनेक्शन स्ट्रिंग प्राप्त करें:
<username>, <password> और <cluster-url> बदलें।from pymongo import MongoClient
# Replace with your Atlas connection string
uri = "mongodb+srv://<username>:<password>@<cluster-url>/vectorDemo?retryWrites=true&w=majority"
client = MongoClient(uri)
db = client["vectorDemo"]
collection = db["items"]
print("Connected to MongoDB Atlas")
# Clear existing
collection.delete_many({})
print("Cleared collection.")हम SentenceTransformers का उपयोग टेक्स्ट को एम्बेडिंग्स में बदलने के लिए करेंगे।
from sentence_transformers import SentenceTransformer
# Choose model: higher-quality for search -> "sentence-transformers/all-mpnet-base-v2" (768-d)
# If you need faster/smaller: "all-MiniLM-L6-v2" (384-d)
MODEL_NAME = "sentence-transformers/all-mpnet-base-v2"
# MODEL_NAME = "all-MiniLM-L6-v2"

# Note: if you use all-mpnet-base-v2, your Atlas vector index must use numDimensions: 768
# If you use all-MiniLM-L6-v2, index numDimensions: 384
model = SentenceTransformer(MODEL_NAME)

def embed_text(text: str):
return model.encode(text).tolist()आइए कुछ उत्पाद विवरणों को उनकी एम्बेडिंग्स सहित MongoDB में स्टोर करें।
# Each product includes name, description, list of features, use_cases and tags.
products = [
    # Marathon / long-distance running (explicit!)
    {
        "name": "MarathonPro 3000",
        "description": "Designed specifically for marathon and ultra distance running: maximum cushioning, breathable knit upper, responsive midsole and engineered heel support for long-run comfort.",
        "features": ["marathon", "long-distance", "max cushioning", "breathable", "support"],
        "category": "shoes",
        "use_cases": ["marathon", "long-distance running", "road running"],
        "tags": ["running", "endurance", "comfort"]
    },
    {
        "name": "Enduro LongRun",
        "description": "Lightweight long-run trainer optimized for marathon pacing with added cushioning, stable platform, and enhanced forefoot energy return for hours of comfortable running.",
        "features": ["long-run", "lightweight", "energy return", "cushioning"],
        "category": "shoes",
        "use_cases": ["marathon", "road running"],
        "tags": ["running","marathon","comfort"]
    },

    # Road running / neutral
    {
        "name": "Red Road Runner",
        "description": "Neutral road running shoe for daily training: breathable mesh, moderate cushioning and responsive ride; suitable for tempo runs and long easy runs.",
        "features": ["road running", "breathable", "moderate cushioning"],
        "category": "shoes",
        "use_cases": ["training", "road running", "tempo runs"],
        "tags": ["running","training"]
    },

    # Trail running (explicit trail)
    {
        "name": "TrailMaster RidgeGrip",
        "description": "Trail-running shoe with aggressive outsole, rock plate for protection, waterproof upper, designed for technical trails and rugged terrain.",
        "features": ["trail", "high grip", "rock plate", "waterproof"],
        "category": "shoes",
        "use_cases": ["trail running", "hiking", "off-road"],
        "tags": ["trail","outdoors"]
    },

    # Tennis & court
    {
        "name": "CourtPro Tennis",
        "description": "Court shoe with lateral support, non-marking sole and reinforced toe; built for tennis footwork and short intense bursts, not for long-distance running.",
        "features": ["court", "lateral support", "non-marking sole"],
        "category": "shoes",
        "use_cases": ["tennis","court sports"],
        "tags": ["tennis","sport"]
    },

    # Formal
    {
        "name": "Oxford Leather Formal",
        "description": "Classic leather formal shoe for office and events: polished leather, sturdy sole, refined silhouette.",
        "features": ["formal", "leather", "office"],
        "category": "shoes",
        "use_cases": ["formal wear","office"],
        "tags": ["formal","leather"]
    },

    # Hiking
    {
        "name": "Alpine Trek Boots",
        "description": "High-ankle hiking boots with waterproof membrane, ankle support and durable lugged outsole for mountain treks.",
        "features": ["hiking", "waterproof", "ankle support", "lugged outsole"],
        "category": "shoes",
        "use_cases": ["hiking","trekking","outdoor"],
        "tags": ["outdoors","hiking"]
    },

    # Casual sneakers
    {
        "name": "Classic Canvas Sneaker",
        "description": "Casual everyday canvas sneaker with rubber sole, comfortable fit for daily wear and walking.",
        "features": ["casual","canvas", "everyday"],
        "category": "shoes",
        "use_cases": ["casual","walking"],
        "tags": ["casual"]
    },

    # Cross-trainer
    {
        "name": "CrossFit Trainer",
        "description": "Stable cross-trainer shoe engineered for gym workouts, short sprints, and lateral movements; flexible yet supportive.",
        "features": ["cross-train","stable","gym"],
        "category": "shoes",
        "use_cases": ["gym","cross-training"],
        "tags": ["training","gym"]
    },

    # Cleats
    {
        "name": "Pro Soccer Cleats",
        "description": "Low-profile football/soccer cleats with studded outsole; optimized for grip on grass and agility.",
        "features": ["cleats","studs","agility"],
        "category": "shoes",
        "use_cases": ["soccer","football"],
        "tags": ["sports","cleats"]
    }
]

# ---------- Create 'canonical_text' to improve embedding quality for better scoring ----------
for p in products:
    # join features and others into one rich text blob
    features = ", ".join(p["features"])
    uses = ", ".join(p["use_cases"])
    tags = ", ".join(p["tags"])
    canonical = f"{p['name']}. {p['description']}. Features: {features}. Use cases: {uses}. Tags: {tags}."
    p["canonical_text"] = canonical

# ---------- Embed canonical_text----------
print("Embedding items...")
for p in products:
    p["embedding"] = embed_text(p["canonical_text"])

# ---------- Insert into MongoDB ----------
collection.insert_many(products)
insert_many का उपयोग करके, हम अपने डेटाबेस में एक ही बार में, कुशल बुल्क राइट ऑपरेशन करते हैं।
अब अंतिम और सबसे रोमांचक चरण का समय है! हम MongoDB के एग्रीगेशन फ्रेमवर्क और $vectorSearch—एक ऑपरेटर—का उपयोग सबसे उपयुक्त जूता क्वेरी ढूँढने के लिए करेंगे।
query_text = "25k long running best shoes"
query_embedding = embed_text(query_text)

pipeline = [
    {
        "$vectorSearch": {
            "index": "vector_index",  # Use the vector search index you created
            "path": "embedding",
            "queryVector": query_embedding,
            "numCandidates": 100,
            "limit": 3
        }
    },
    {
        "$project": {
            "name": 1,
            "description":1,
            "score": {"$meta": "vectorSearchScore"}
        }
    }
]

results = collection.aggregate(pipeline)

print(f"\nSearch results for: '{query_text}'\n")
for r in results:
    print(f"- {r['name']} (score: {r['score']:.4f})")
$vectorSearch पाइपलाइन का विश्लेषण:
$vectorSearch: यह कोर ऑपरेटर है। यह हमारे queryVector की तुलना इंडेक्स किए गए plot_embedding फ़ील्ड से सभी दस्तावेज़ों में कुशलतापूर्वक करता है।$project: यह स्टेज आउटपुट को पुनर्संरचित करता है। हम name और description शामिल करते हैं, _id और अन्य फ़ील्ड जैसे noisy को बाहर रखते हैं, और सबसे महत्वपूर्ण, हम score फ़ील्ड जोड़ते हैं $meta: "vectorSearchScore" का उपयोग करके। यह स्कोर, 0 से 1 तक, यह दर्शाता है कि परिणाम हमारी क्वेरी से कितना मिलता-जुलता है।यदि सब कुछ सही तरह से सेट है, तो आपको कुछ ऐसा दिखाई देगा:
Search results for: '25k long running best shoes'

- MarathonPro 3000 (score: 0.7980)
- Red Road Runner (score: 0.7479)
- Enduro LongRun (score: 0.7389)
ध्यान दें कि “MarathonPro 3000” सबसे ऊपर आता है—बिल्कुल वैसा ही जैसा हम अपेक्षा करते हैं।
बधाई हो! आपने शून्य से एक वेक्टर सर्च एप्लिकेशन सफलतापूर्वक बनाया। आपने डेटाबेस से कनेक्ट करना, डेटा बनाना और वैलिडेट करना, वेक्टर एम्बेडिंग्स जनरेट करना, और MongoDB Atlas की शक्ति का उपयोग करके सच में बुद्धिमानी से जानकारी ढूँढना सीखा। डेटा इंटरेक्शन के भविष्य में आपका स्वागत है।
इस ट्यूटोरियल में, आपने सफलतापूर्वक सीखा कि कैसे:
विभिन्न similarity metrics (dotProduct, euclidean) के साथ प्रयोग करें।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स