Corso
Database vettoriali per Embeddings con Pinecone
3 ore
11.9K
Fino a poco tempo fa, i computer funzionavano come bibliotecari efficienti ma letterali. Se cercavi "battaglie tra robot giganti", trovavano solo titoli con quelle esatte parole. Un abbinamento perfetto come "Kaiju Mech Warfare" sarebbe stato ignorato. I computer riconoscevano le parole ma perdevano la musica—mancavano di comprensione, sfumature e contesto. Questa era l’era della ricerca per parola chiave, che per molti anni è stata la nostra opzione migliore.
Poi è arrivata una rivoluzione. Ispirandosi al cervello umano, l’intelligenza artificiale ha sviluppato un nuovo modo di apprendere. Invece di memorizzare semplicemente le parole, l’IA ha iniziato a comprendere le relazioni tra di esse. Si è capito che "re" è collegato a "uomo" come "regina" è collegato a "donna". Ha riconosciuto che "felice", "gioioso" ed "euforico" condividono lo stesso territorio emotivo, mentre "cupo" appartiene a un ambito completamente diverso.
Come ci è riuscita l’IA? Creando una mappa del significato.
Immagina una vasta galassia multidimensionale in cui ogni concetto—una parola, una frase, un’immagine, una canzone—è una stella. In questa galassia, le stelle con significati simili si raggruppano, mentre quelle non correlate si trovano a anni luce di distanza.
Un’embedding vettoriale è semplicemente la coordinata di una stella in questa galassia. È un elenco di numeri (ad es. [0.12, -0.45, 0.89, ...]) che localizza con precisione un concetto su questa mappa del significato.
La Vector Search è la capacità rivoluzionaria di navigare in questa mappa. Quando chiedi "un film su un ragazzo orfano che scopre di essere un mago", non cerchiamo quelle esatte parole chiave. Invece:
Le stelle più vicine rappresentano i risultati più simili dal punto di vista semantico. È così che l’IA è passata da un bibliotecario letterale a un saggio che capisce cosa intendi davvero.
Cercare per significato anziché per parole chiave alimenta le applicazioni di IA moderne in tutti i settori. Questa capacità permette a:
La vector search fa da ponte tra l’intento umano e i dati digitali, trasformando alla base il modo in cui interagiamo con le informazioni. Questa tecnologia rende i sistemi digitali meno meccanici e più simili a collaboratori intuitivi.
Benvenuto nella nuova frontiera della ricerca! MongoDB ha introdotto la Vector Search in Atlas. Questo ti consente di archiviare e interrogare embedding vettoriali (provenienti da testo, immagini o audio) direttamente in MongoDB—senza bisogno di un database vettoriale separato come Pinecone o Weaviate.
In questo tutorial, costruiremo un semplice ma potente motore di raccomandazione per scarpe usando Python e MongoDB Atlas. Imparerai a trasformare il testo in rappresentazioni numeriche significative (vettori) e poi a usare la Vector Search integrata di Atlas per trovare film con trame simili.
pip install pymongo sentence-transformers numpy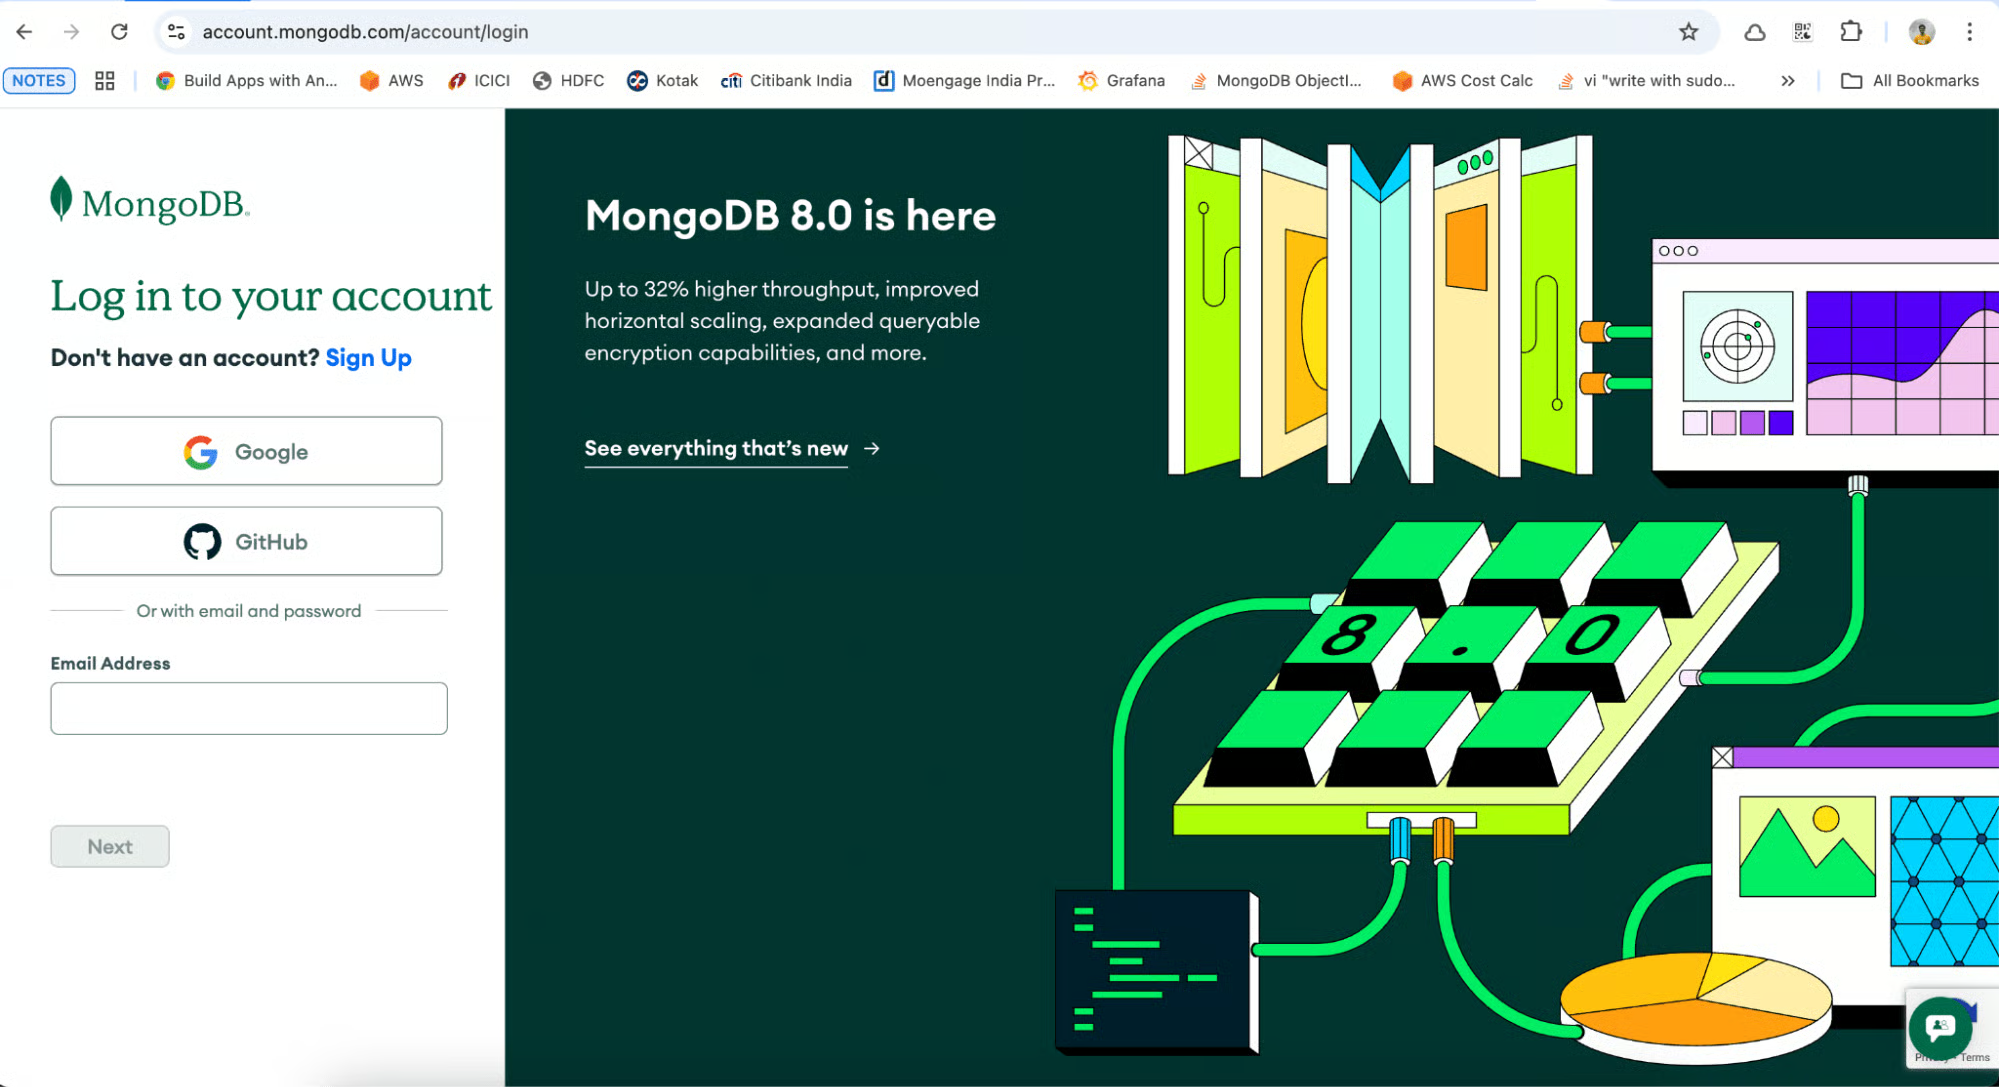
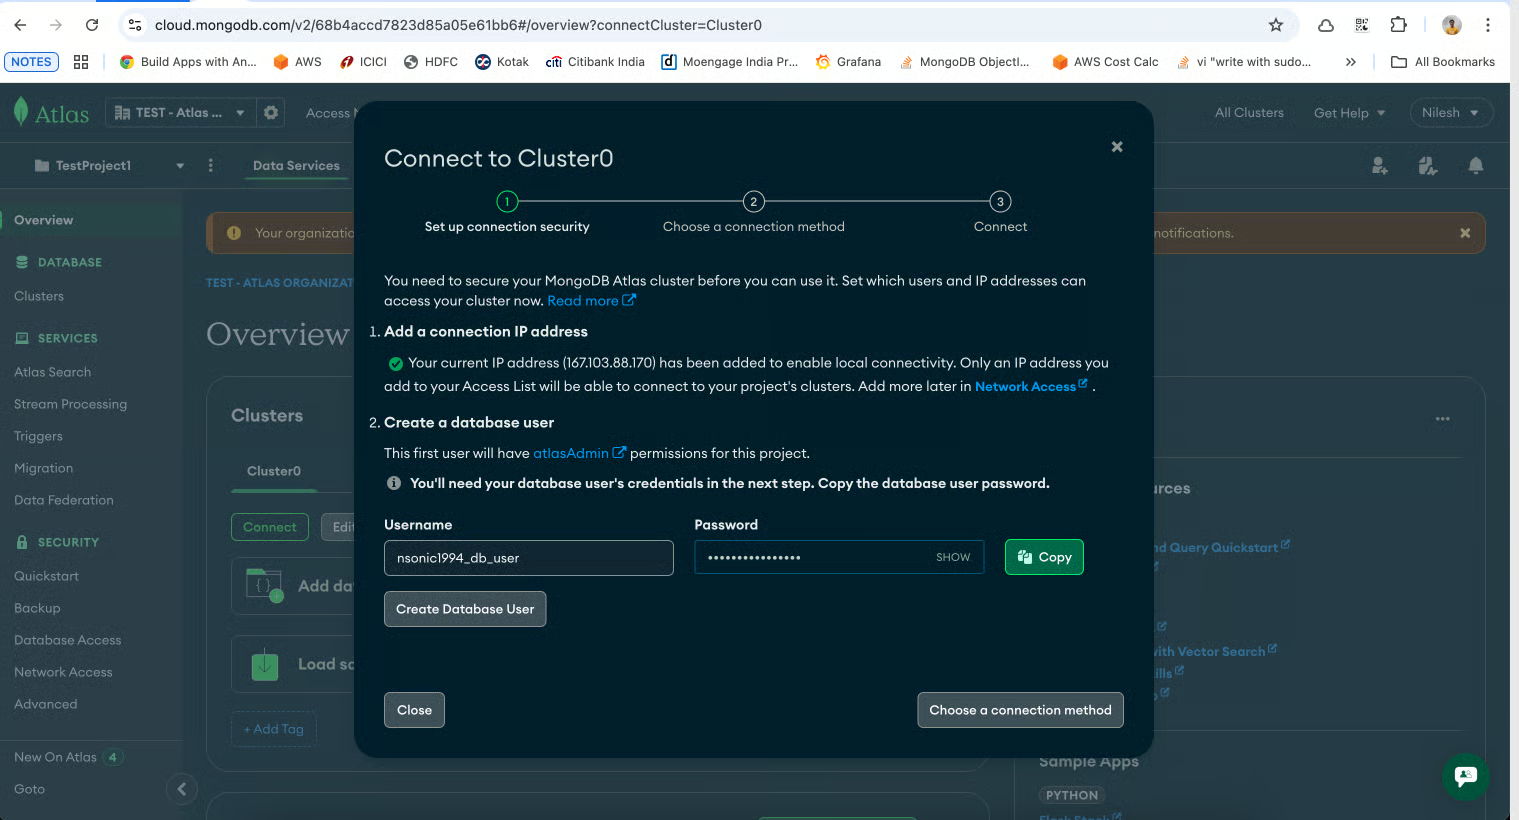
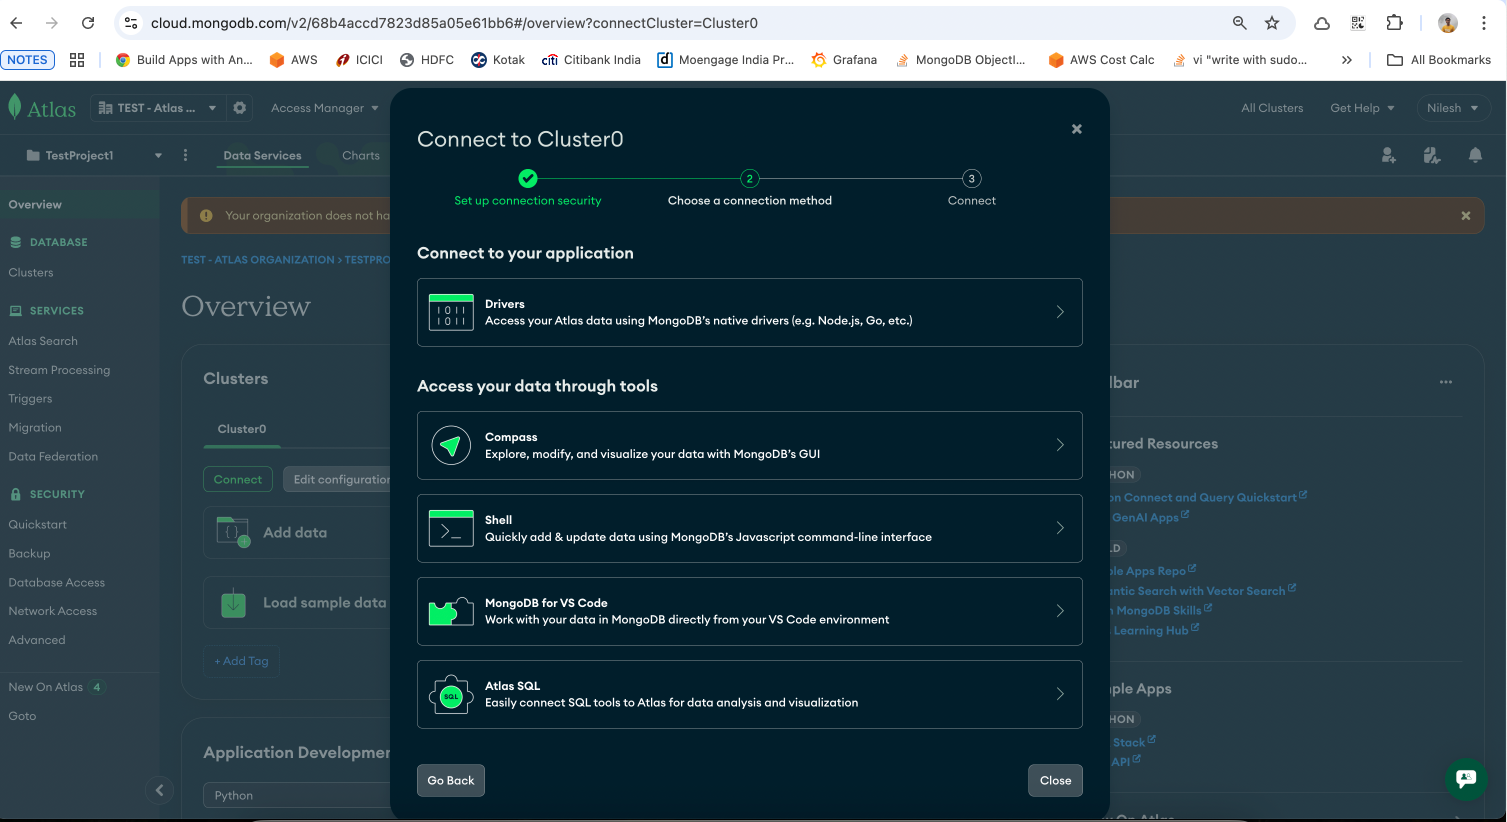
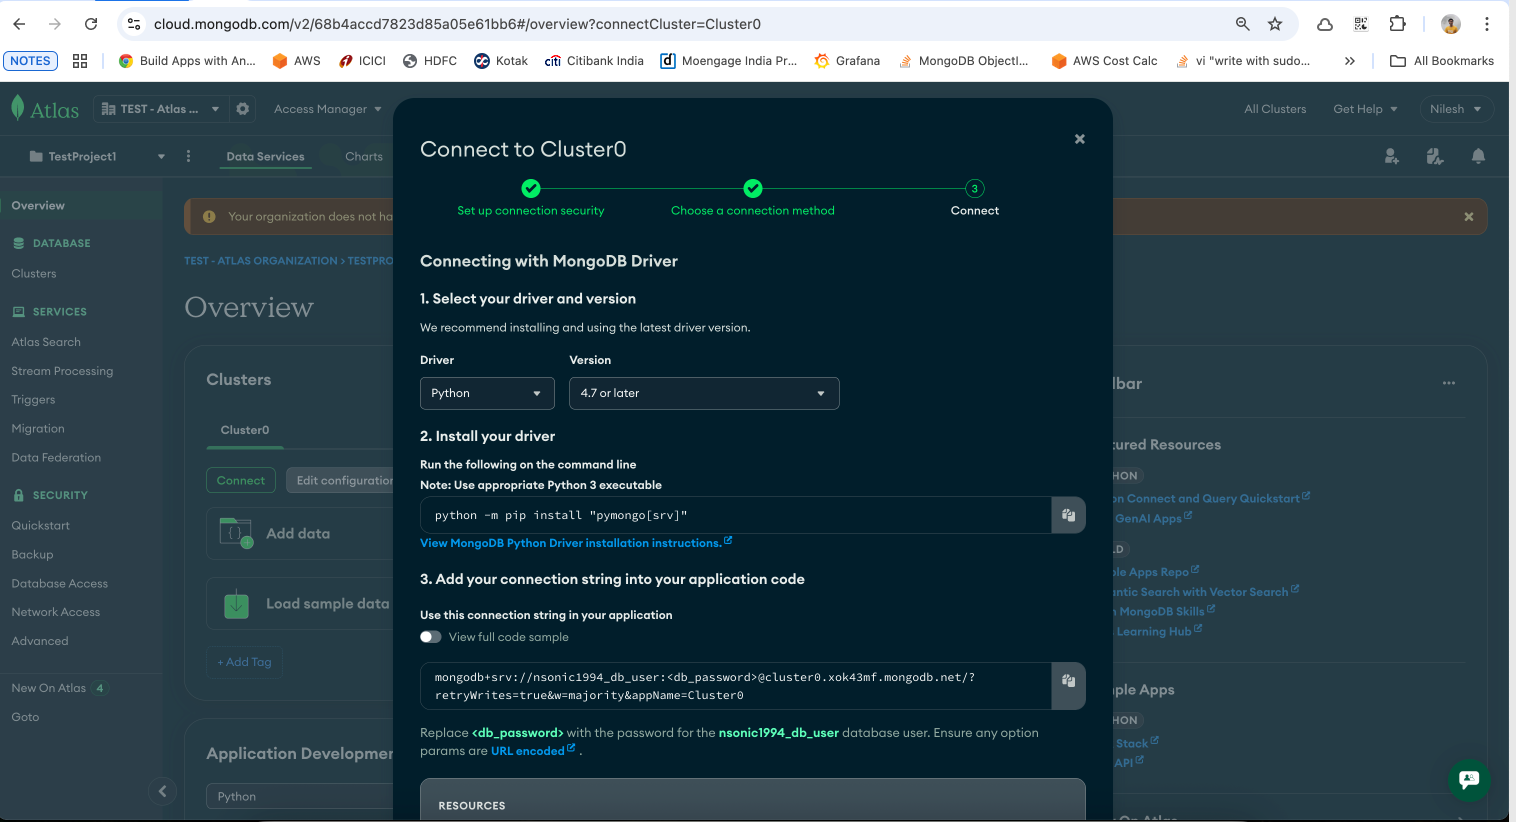
vectorDemoitems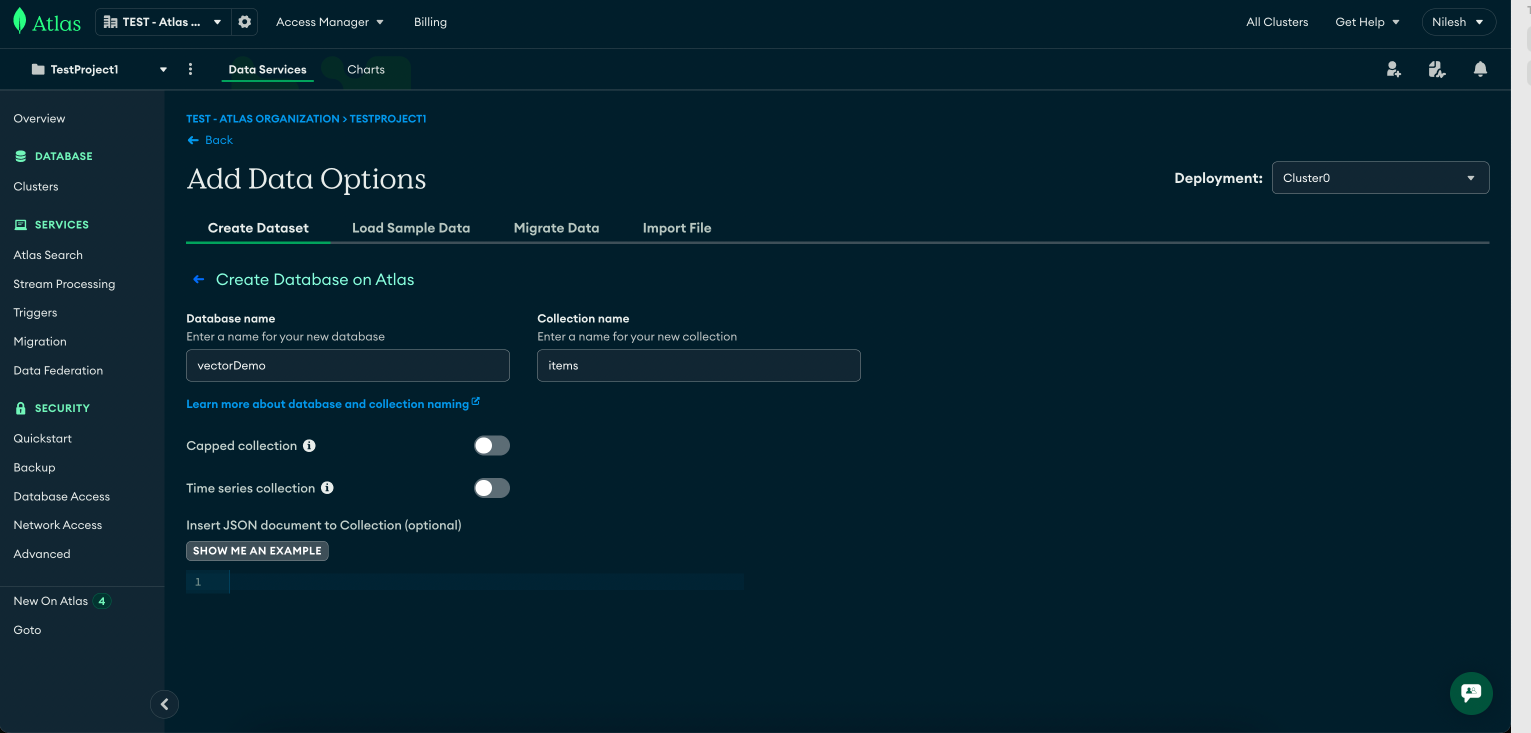
items.{
"fields": [
{
"type": "vector",
"path": "embedding",
"numDimensions": 768,
"similarity": "cosine"
}
]
}
Nota: 768 è la dimensione degli embedding che useremo con il modello sentence-transformers.
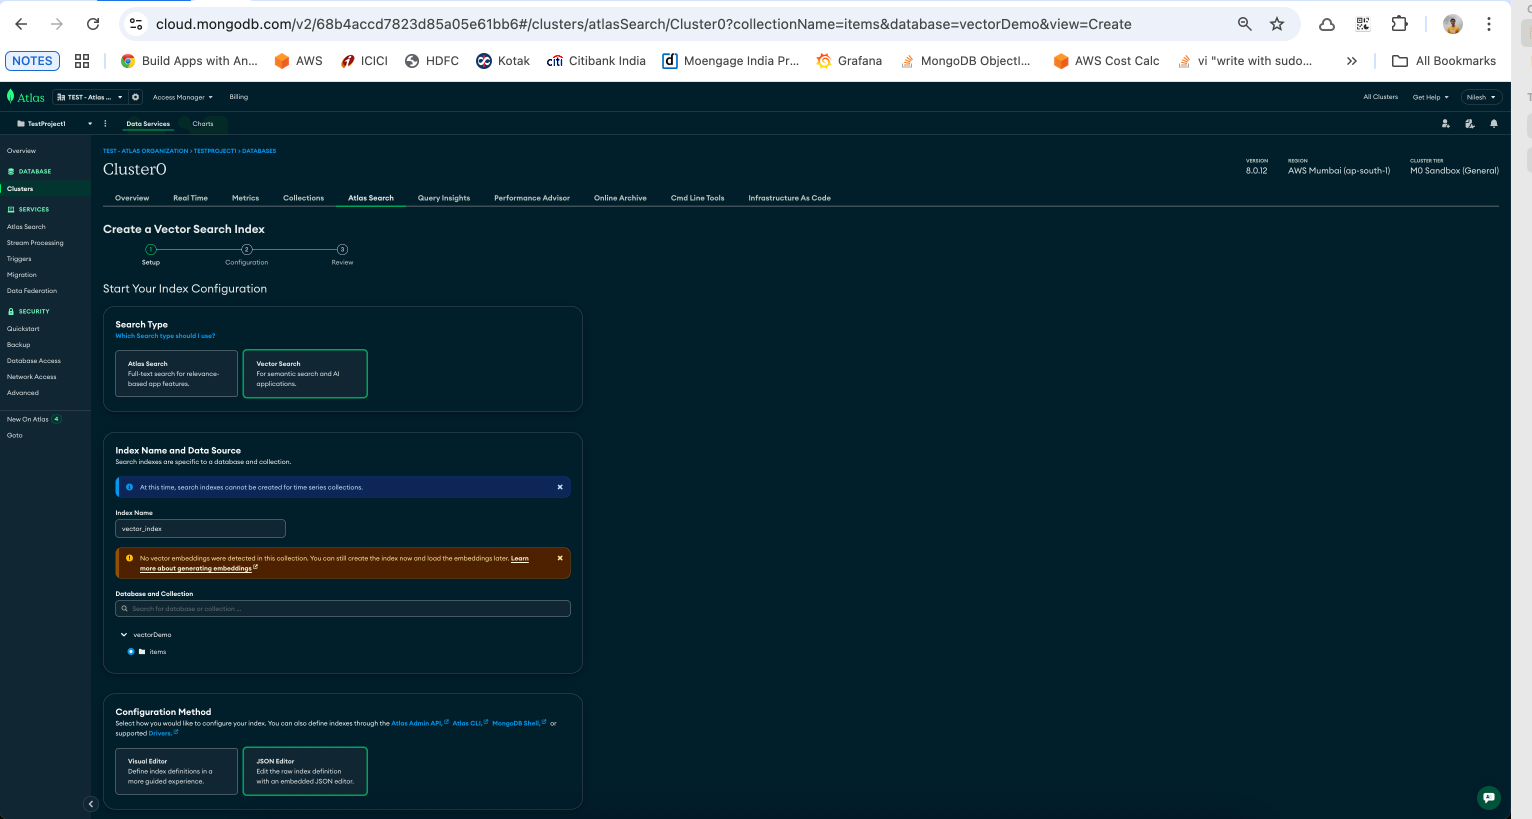
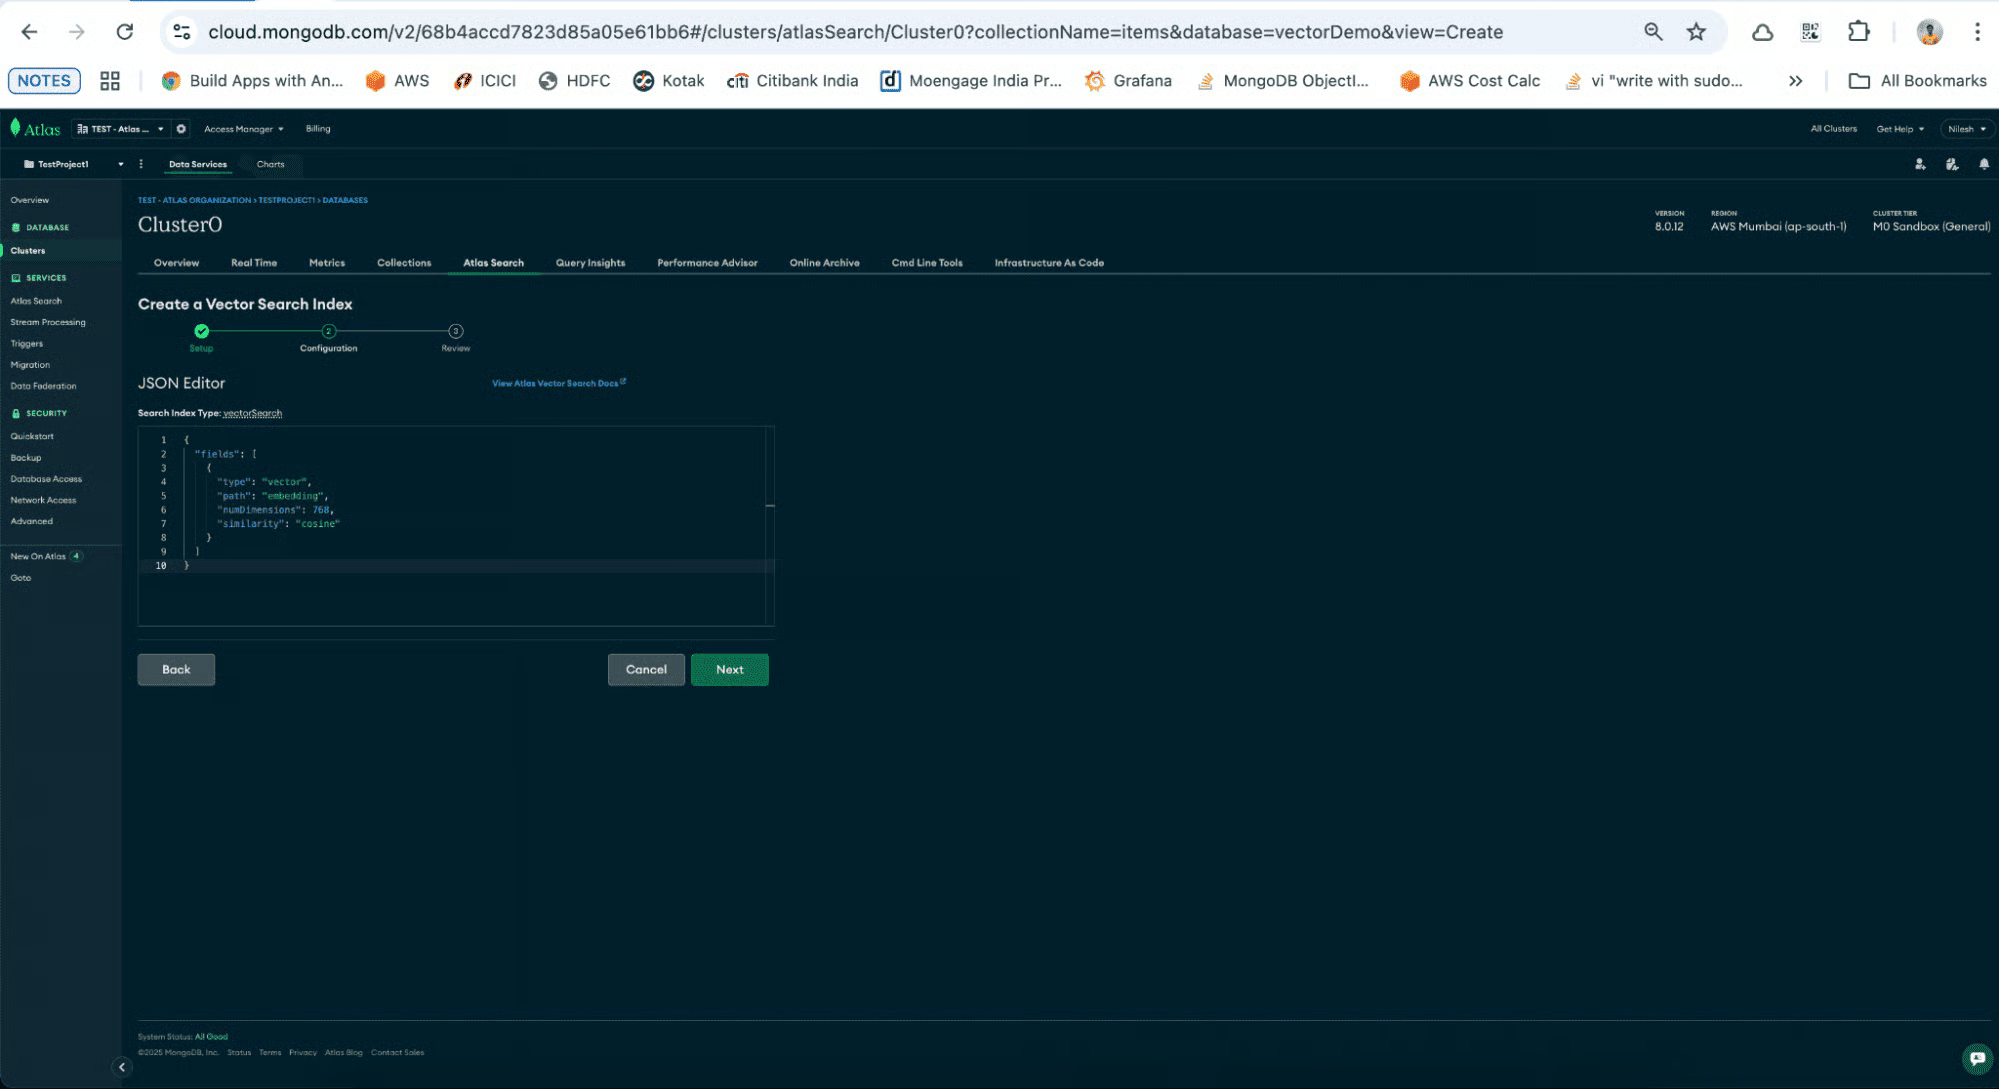
Capire la definizione dell’indice:
"type": "vector": indica a MongoDB Atlas che questo è un indice vettoriale."path": "embedding": fondamentale, punta al campo nei nostri documenti che contiene i vettori."numDimensions": 768: questo deve corrispondere alla dimensione dei vettori prodotti dal nostro modello."similarity": "cosine": l’algoritmo usato per misurare la "vicinanza" tra vettori. È eccellente per la similarità basata sul testo.Recupera la tua stringa di connessione MongoDB Atlas:
<username>, <password> e <cluster-url> nello snippet qui sotto.from pymongo import MongoClient
# Replace with your Atlas connection string
uri = "mongodb+srv://<username>:<password>@<cluster-url>/vectorDemo?retryWrites=true&w=majority"
client = MongoClient(uri)
db = client["vectorDemo"]
collection = db["items"]
print("Connected to MongoDB Atlas")
# Clear existing
collection.delete_many({})
print("Cleared collection.")Useremo SentenceTransformers per convertire il testo in embedding.
from sentence_transformers import SentenceTransformer
# Choose model: higher-quality for search -> "sentence-transformers/all-mpnet-base-v2" (768-d)
# If you need faster/smaller: "all-MiniLM-L6-v2" (384-d)
MODEL_NAME = "sentence-transformers/all-mpnet-base-v2"
# MODEL_NAME = "all-MiniLM-L6-v2"

# Note: if you use all-mpnet-base-v2, your Atlas vector index must use numDimensions: 768
# If you use all-MiniLM-L6-v2, index numDimensions: 384
model = SentenceTransformer(MODEL_NAME)

def embed_text(text: str):
return model.encode(text).tolist()Archiviamo alcune descrizioni di prodotti in MongoDB con i loro embedding.
# Each product includes name, description, list of features, use_cases and tags.
products = [
    # Marathon / long-distance running (explicit!)
    {
        "name": "MarathonPro 3000",
        "description": "Designed specifically for marathon and ultra distance running: maximum cushioning, breathable knit upper, responsive midsole and engineered heel support for long-run comfort.",
        "features": ["marathon", "long-distance", "max cushioning", "breathable", "support"],
        "category": "shoes",
        "use_cases": ["marathon", "long-distance running", "road running"],
        "tags": ["running", "endurance", "comfort"]
    },
    {
        "name": "Enduro LongRun",
        "description": "Lightweight long-run trainer optimized for marathon pacing with added cushioning, stable platform, and enhanced forefoot energy return for hours of comfortable running.",
        "features": ["long-run", "lightweight", "energy return", "cushioning"],
        "category": "shoes",
        "use_cases": ["marathon", "road running"],
        "tags": ["running","marathon","comfort"]
    },

    # Road running / neutral
    {
        "name": "Red Road Runner",
        "description": "Neutral road running shoe for daily training: breathable mesh, moderate cushioning and responsive ride; suitable for tempo runs and long easy runs.",
        "features": ["road running", "breathable", "moderate cushioning"],
        "category": "shoes",
        "use_cases": ["training", "road running", "tempo runs"],
        "tags": ["running","training"]
    },

    # Trail running (explicit trail)
    {
        "name": "TrailMaster RidgeGrip",
        "description": "Trail-running shoe with aggressive outsole, rock plate for protection, waterproof upper, designed for technical trails and rugged terrain.",
        "features": ["trail", "high grip", "rock plate", "waterproof"],
        "category": "shoes",
        "use_cases": ["trail running", "hiking", "off-road"],
        "tags": ["trail","outdoors"]
    },

    # Tennis & court
    {
        "name": "CourtPro Tennis",
        "description": "Court shoe with lateral support, non-marking sole and reinforced toe; built for tennis footwork and short intense bursts, not for long-distance running.",
        "features": ["court", "lateral support", "non-marking sole"],
        "category": "shoes",
        "use_cases": ["tennis","court sports"],
        "tags": ["tennis","sport"]
    },

    # Formal
    {
        "name": "Oxford Leather Formal",
        "description": "Classic leather formal shoe for office and events: polished leather, sturdy sole, refined silhouette.",
        "features": ["formal", "leather", "office"],
        "category": "shoes",
        "use_cases": ["formal wear","office"],
        "tags": ["formal","leather"]
    },

    # Hiking
    {
        "name": "Alpine Trek Boots",
        "description": "High-ankle hiking boots with waterproof membrane, ankle support and durable lugged outsole for mountain treks.",
        "features": ["hiking", "waterproof", "ankle support", "lugged outsole"],
        "category": "shoes",
        "use_cases": ["hiking","trekking","outdoor"],
        "tags": ["outdoors","hiking"]
    },

    # Casual sneakers
    {
        "name": "Classic Canvas Sneaker",
        "description": "Casual everyday canvas sneaker with rubber sole, comfortable fit for daily wear and walking.",
        "features": ["casual","canvas", "everyday"],
        "category": "shoes",
        "use_cases": ["casual","walking"],
        "tags": ["casual"]
    },

    # Cross-trainer
    {
        "name": "CrossFit Trainer",
        "description": "Stable cross-trainer shoe engineered for gym workouts, short sprints, and lateral movements; flexible yet supportive.",
        "features": ["cross-train","stable","gym"],
        "category": "shoes",
        "use_cases": ["gym","cross-training"],
        "tags": ["training","gym"]
    },

    # Cleats
    {
        "name": "Pro Soccer Cleats",
        "description": "Low-profile football/soccer cleats with studded outsole; optimized for grip on grass and agility.",
        "features": ["cleats","studs","agility"],
        "category": "shoes",
        "use_cases": ["soccer","football"],
        "tags": ["sports","cleats"]
    }
]

# ---------- Create 'canonical_text' to improve embedding quality for better scoring ----------
for p in products:
    # join features and others into one rich text blob
    features = ", ".join(p["features"])
    uses = ", ".join(p["use_cases"])
    tags = ", ".join(p["tags"])
    canonical = f"{p['name']}. {p['description']}. Features: {features}. Use cases: {uses}. Tags: {tags}."
    p["canonical_text"] = canonical

# ---------- Embed canonical_text----------
print("Embedding items...")
for p in products:
    p["embedding"] = embed_text(p["canonical_text"])

# ---------- Insert into MongoDB ----------
collection.insert_many(products)
Usando insert_many, eseguiamo un’unica, efficiente operazione di scrittura bulk sul nostro database.
È il momento del passo finale, il più entusiasmante! Useremo l’aggregation framework di MongoDB e $vectorSearch—un operatore per trovare la migliore scarpa per la query.
query_text = "25k long running best shoes"
query_embedding = embed_text(query_text)

pipeline = [
    {
        "$vectorSearch": {
            "index": "vector_index",  # Use the vector search index you created
            "path": "embedding",
            "queryVector": query_embedding,
            "numCandidates": 100,
            "limit": 3
        }
    },
    {
        "$project": {
            "name": 1,
            "description":1,
            "score": {"$meta": "vectorSearchScore"}
        }
    }
]

results = collection.aggregate(pipeline)

print(f"\nSearch results for: '{query_text}'\n")
for r in results:
    print(f"- {r['name']} (score: {r['score']:.4f})")
Analisi della pipeline $vectorSearch:
$vectorSearch: l’operatore principale. Confronta in modo efficiente il nostro queryVector con il campo indicizzato plot_embedding per tutti i documenti.$project: questo stage rimodella l’output. Includiamo name e description, escludiamo l’_id e altri campi "rumorosi" e, soprattutto, aggiungiamo un campo score usando $meta: "vectorSearchScore". Questo punteggio, da 0 a 1, indica quanto il risultato è simile alla nostra query.Se tutto è configurato correttamente, vedrai qualcosa di simile:
Search results for: '25k long running best shoes'

- MarathonPro 3000 (score: 0.7980)
- Red Road Runner (score: 0.7479)
- Enduro LongRun (score: 0.7389)
Nota che “MarathonPro 3000” è in cima—esattamente come ci aspetteremmo.
Congratulazioni! Hai costruito con successo un’applicazione di vector search da zero. Hai imparato a connetterti a un database, creare e convalidare i dati, generare embedding vettoriali e sfruttare la potenza di MongoDB Atlas per trovare informazioni in modo davvero intelligente. Benvenuto nel futuro dell’interazione con i dati.
In questo tutorial, hai imparato a:
Sperimenta con metriche di similarità diverse (dotProduct, euclidean).
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



