Kursus
Pengembangan Kode dengan Bantuan AI untuk Developer
1 jam 30 menit
10.6K
Seperti yang kami bahas dalam postingan blog kami, Muse Glimmer 30B adalah model open-source baru yang dibangun untuk beban kerja agentic dan koding.
Yang membuatnya sangat menarik adalah Anda dapat menjalankan seluruh setelan ini secara lokal pada satu NVIDIA RTX 5090 dengan VRAM 32 GB menggunakan llama.cpp.
Model ini tersedia dalam format GGUF, dan untuk panduan ini, saya akan menggunakan kuantisasi dinamis dengan kualitas lebih tinggi.
Rangkaian lengkapnya terdiri dari:
muse-glimmer-30B-kquant-dynamic.gguf: 19,7 GB model utamadflash-kquant.gguf: 1,63 GB model draf untuk decoding spekulatifmmproj-kquant.gguf: 1,4 GB encoder visi dan persepsiMenurut kartu modelnya, kuantisasi dinamis 19,7 GB hanya memiliki sekitar 0,2% degradasi benchmark dibandingkan presisi penuh.
Dalam pengujian saya, menjalankan model dengan jendela konteks 64K menggunakan sekitar 24 GB VRAM, menyisakan ruang yang berguna pada RTX 5090.
Dalam panduan ini, Anda akan mempelajari cara:
llama.cpp dengan dukungan CUDAPada akhirnya, kita juga akan mendapatkan gambaran praktis tentang di mana Muse Glimmer berkinerja baik sebagai model koding lokal dan di mana model ini masih kesulitan. Saya juga merekomendasikan untuk melihat panduan Muse Spark 1.3 untuk mempelajari fitur terbarunya.
Sebelum menjalankan Muse Glimmer secara lokal, pertama kita perlu membangun llama.cpp dengan dukungan CUDA agar model dapat menggunakan GPU RTX 5090.
Mulailah dengan memasang paket sistem yang diperlukan:
apt-get update

apt-get install -y \
    build-essential \
    cmake \
    curl \
    git \
    libcurl4-openssl-dev
Selanjutnya, klon repositori llama.cpp dan pindah ke direktori proyek:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Konfigurasikan build dengan CUDA diaktifkan:
cmake -B build \
    -DBUILD_SHARED_LIBS=OFF \
    -DGGML_CUDA=ON
Sekarang kompilasi alat baris perintah, CLI multimodal, dan server:
cmake --build build --config Release -j \
    --target llama-cli llama-mtmd-cli llama-server
Setelah build selesai, buat llama-server tersedia secara global sehingga Anda dapat menjalankannya dari direktori mana pun:
ln -sf "$(pwd)/build/bin/llama-server" /usr/local/bin/llama-serverTerakhir, konfirmasikan bahwa instalasi berfungsi:
llama-server --versionAnda seharusnya melihat keluaran serupa dengan:
version: 10373 (38406d597)
built with GNU 13.3.0 for Linux x86_64
Pada tahap ini, llama.cpp telah dikompilasi dengan dukungan CUDA, dan llama-server siap menjalankan Muse Glimmer di GPU.
Berikutnya, unduh model utama Muse Glimmer beserta file GGUF tambahan yang dibutuhkan untuk decoding spekulatif dan input visi.
Pertama, pasang Hugging Face CLI:
pip install -U huggingface_hubLalu masuk ke akun Hugging Face Anda:
hf auth login
Pilih opsi login melalui browser, buka halaman otorisasi, dan setujui koneksi di browser Anda.
Sekarang unduh tiga file yang diperlukan:
hf download meta-models/Muse-Glimmer-30B-GGUF \
    --local-dir Muse-Glimmer-30B-GGUF \
    --include "muse-glimmer-30B-kquant-dynamic.gguf" \
    --include "dflash-kquant.gguf" \
    --include "mmproj-kquant.gguf"
Ini akan mengunduh:
muse-glimmer-30B-kquant-dynamic.gguf: model utama 19,7 GBdflash-kquant.gguf: model draf yang digunakan untuk decoding spekulatifmmproj-kquant.gguf: encoder persepsi yang dibutuhkan untuk input gambarFile-file ini cukup besar, jadi waktu unduhnya mungkin lama tergantung koneksi internet Anda.

Setelah ketiga file diunduh, Anda sudah memiliki semua yang dibutuhkan untuk menjalankan Muse Glimmer dengan generasi teks, dukungan visi, dan decoding spekulatif DFlash.
Dengan ketiga file GGUF telah diunduh, sekarang kita bisa memulai Muse Glimmer menggunakan llama-server.
Perintah di bawah memuat model utama, mengaktifkan model draf DFlash untuk decoding spekulatif, dan menambahkan encoder persepsi untuk input visi:
llama-server \
    -m /workspace/Muse-Glimmer-30B-GGUF/muse-glimmer-30B-kquant-dynamic.gguf \
    -md /workspace/Muse-Glimmer-30B-GGUF/dflash-kquant.gguf \
    --mmproj /workspace/Muse-Glimmer-30B-GGUF/mmproj-kquant.gguf \
    --spec-type draft-dflash \
    --spec-draft-n-max 15 \
    -ngl 99 \
    --spec-draft-ngl all \
    -fa on \
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 64 \
    --ctx-size 64000 \
    --alias muse-glimmer-30B \
    --host 0.0.0.0 \
    --port 8910 \
    --jinja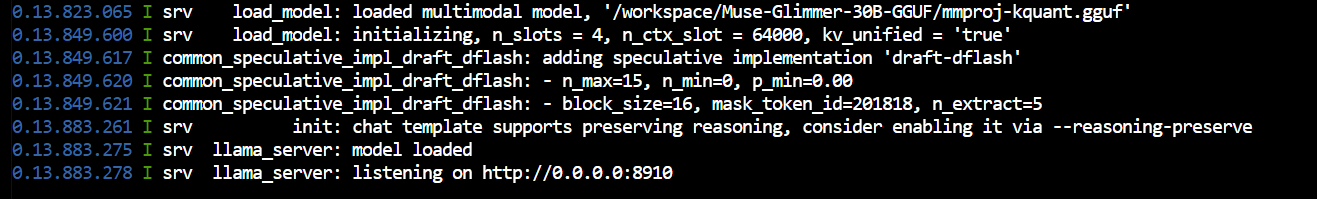
Konfigurasi ini menggunakan jendela konteks 64K, mengalihkan pemrosesan model ke GPU, mengaktifkan Flash Attention, dan menjalankan server pada port 8910.
Setelah model dimuat, model akan tersedia di:
http://127.0.0.1:8910Anda dapat mengonfirmasi semuanya berjalan dengan benar dengan mengirim permintaan sederhana ke API yang kompatibel dengan OpenAI:
curl -s http://127.0.0.1:8910/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "muse-glimmer-30B",
        "messages": [
            {
                "role": "user",
                "content": "Explain speculative decoding in three simple sentences."
            }
        ]
    }'
Untuk pengujian ini, Muse Glimmer menghasilkan 364 token pelengkapan pada 83,94 token/detik, sementara prompt diproses pada 147,48 token/detik.
Dengan decoding spekulatif DFlash diaktifkan, model draf mengusulkan 1.665 token, yang mana 253 diterima, memberikan tingkat penerimaan sekitar 15,2%.
Prompt 64 token diproses dalam sekitar 434 ms, sementara generasi memakan waktu kurang lebih 4,34 detik.
Respons ini mengonfirmasi bahwa model berjalan dengan benar melalui API lokal.
Anda juga dapat memeriksa berapa banyak memori GPU yang digunakan oleh rangkaian lengkap:
nvidia-smiDengan model 30B yang dikuantisasi dinamis, model draf DFlash, encoder visi, dan jendela konteks 64K dimuat bersama, setelan saya menggunakan sekitar 23,8 GB VRAM pada RTX 5090.
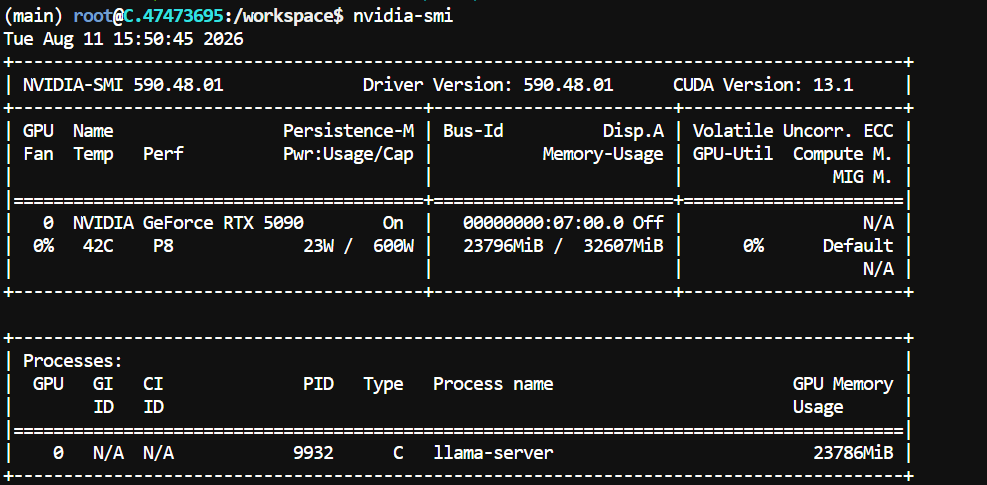
Itu menyisakan sekitar 8 GB VRAM yang tersedia, memberi kita ruang untuk bereksperimen dengan jendela konteks yang lebih besar nanti.
llama-server dilengkapi Web UI bawaan, sehingga memudahkan untuk menguji model tanpa mengirim permintaan API secara manual.
Buka:
http://127.0.0.1:8910Anda dapat menggunakan antarmuka untuk prompt teks biasa, pemahaman gambar, dan percobaan koding cepat.
Karena kita memuat encoder visi dengan:
--mmproj /workspace/Muse-Glimmer-30B-GGUF/mmproj-kquant.ggufMuse Glimmer juga dapat menerima input gambar.
Untuk menguji kemampuan visinya, saya mengunggah sampul salah satu buku saya dan menggunakan prompt berikut:
Describe what you see in this image and point out the most important details.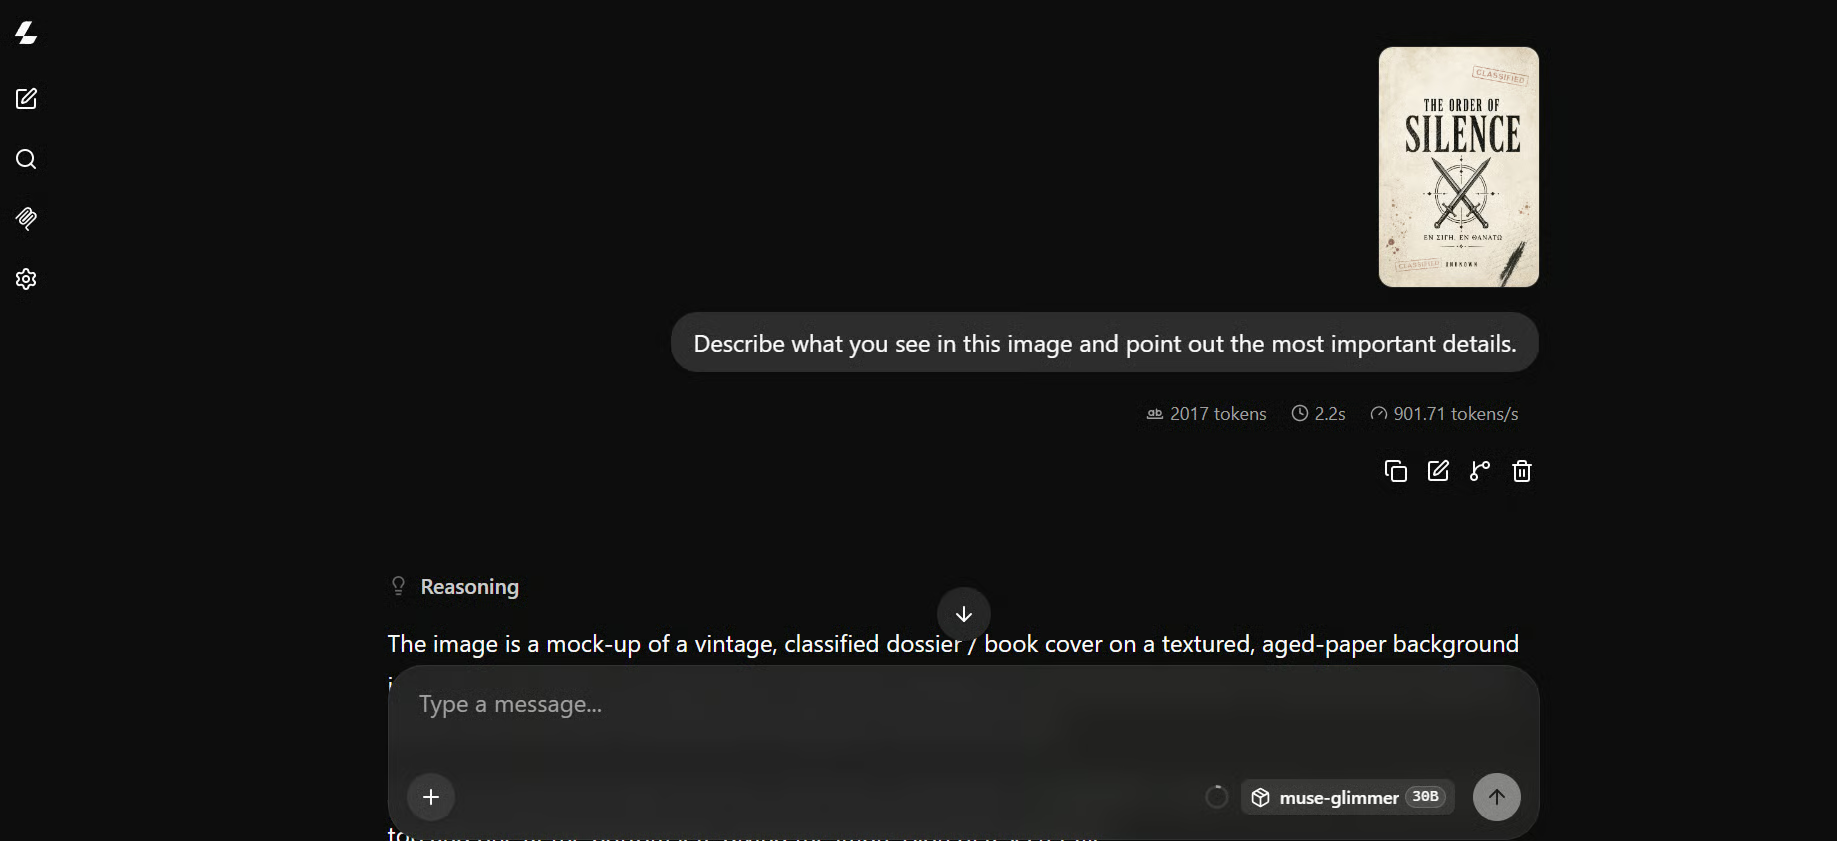
Model menghasilkan deskripsi detail tentang sampul dan menangkap beberapa elemen visual kecil juga.
Ini adalah uji awal yang berguna untuk memastikan encoder visi berfungsi dengan benar.
Berikutnya, saya menguji kemampuan kodingnya dengan tugas pembuatan situs web sederhana:
Build a modern luxury watch website for VELORÉ,
with a minimalist V logo, black/ivory/deep-green palette,
cinematic hero, premium watches, smooth animations,
and elegant Swiss-inspired styling.
Selama tugas koding ini, rata-rata generasi sekitar 121 token per detik, yang terasa lebih cepat daripada uji teks umum sebelumnya.
Decoding spekulatif DFlash tampaknya bekerja sangat baik pada jenis beban kerja generasi kode yang berurutan ini.
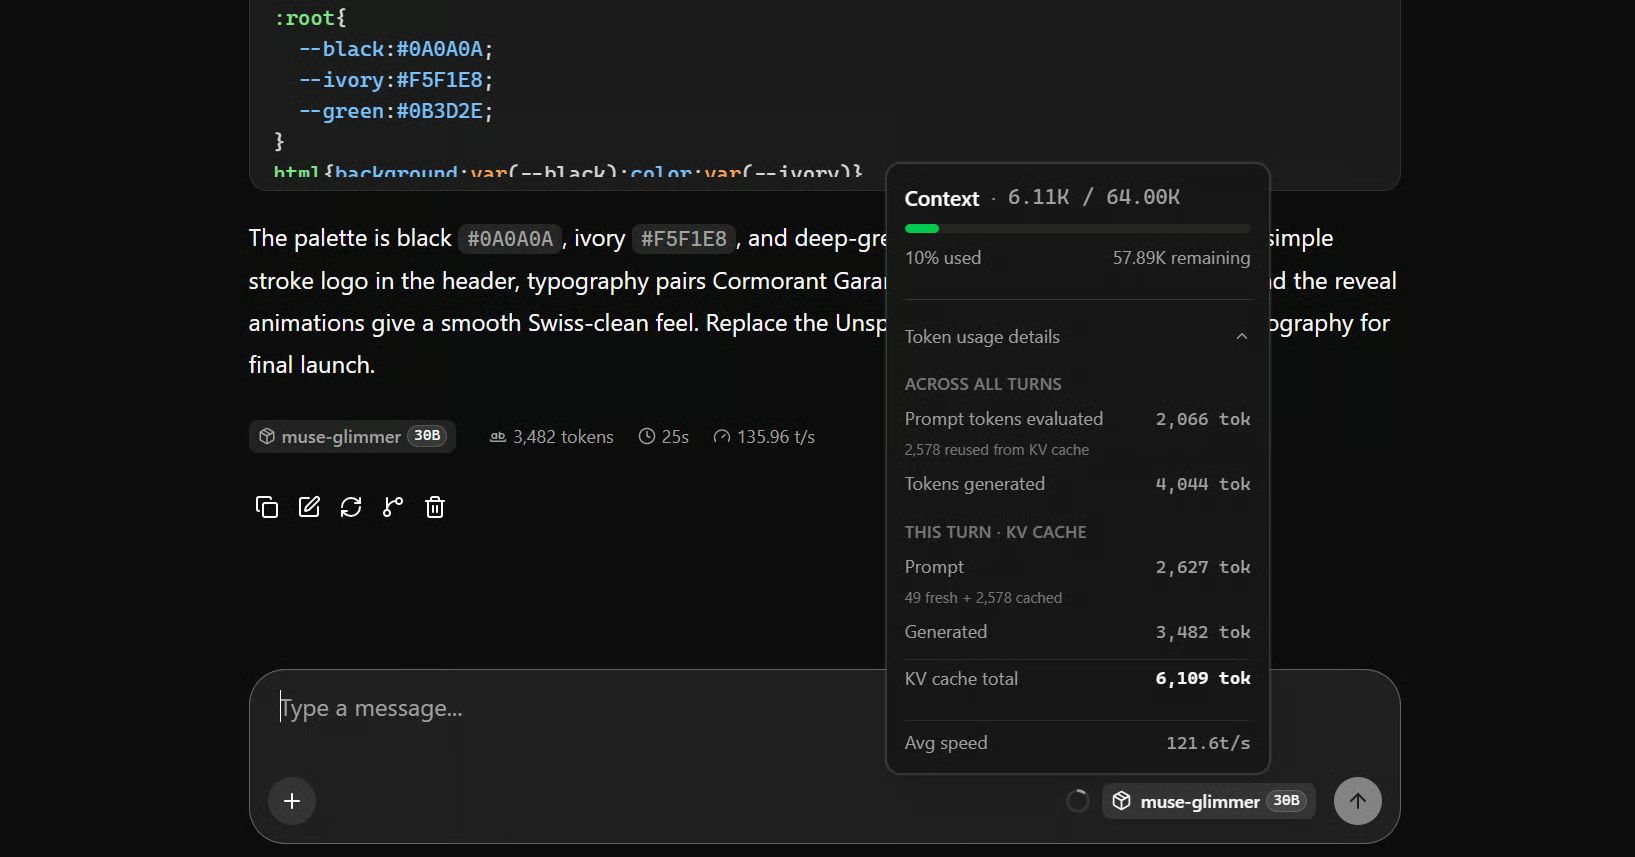
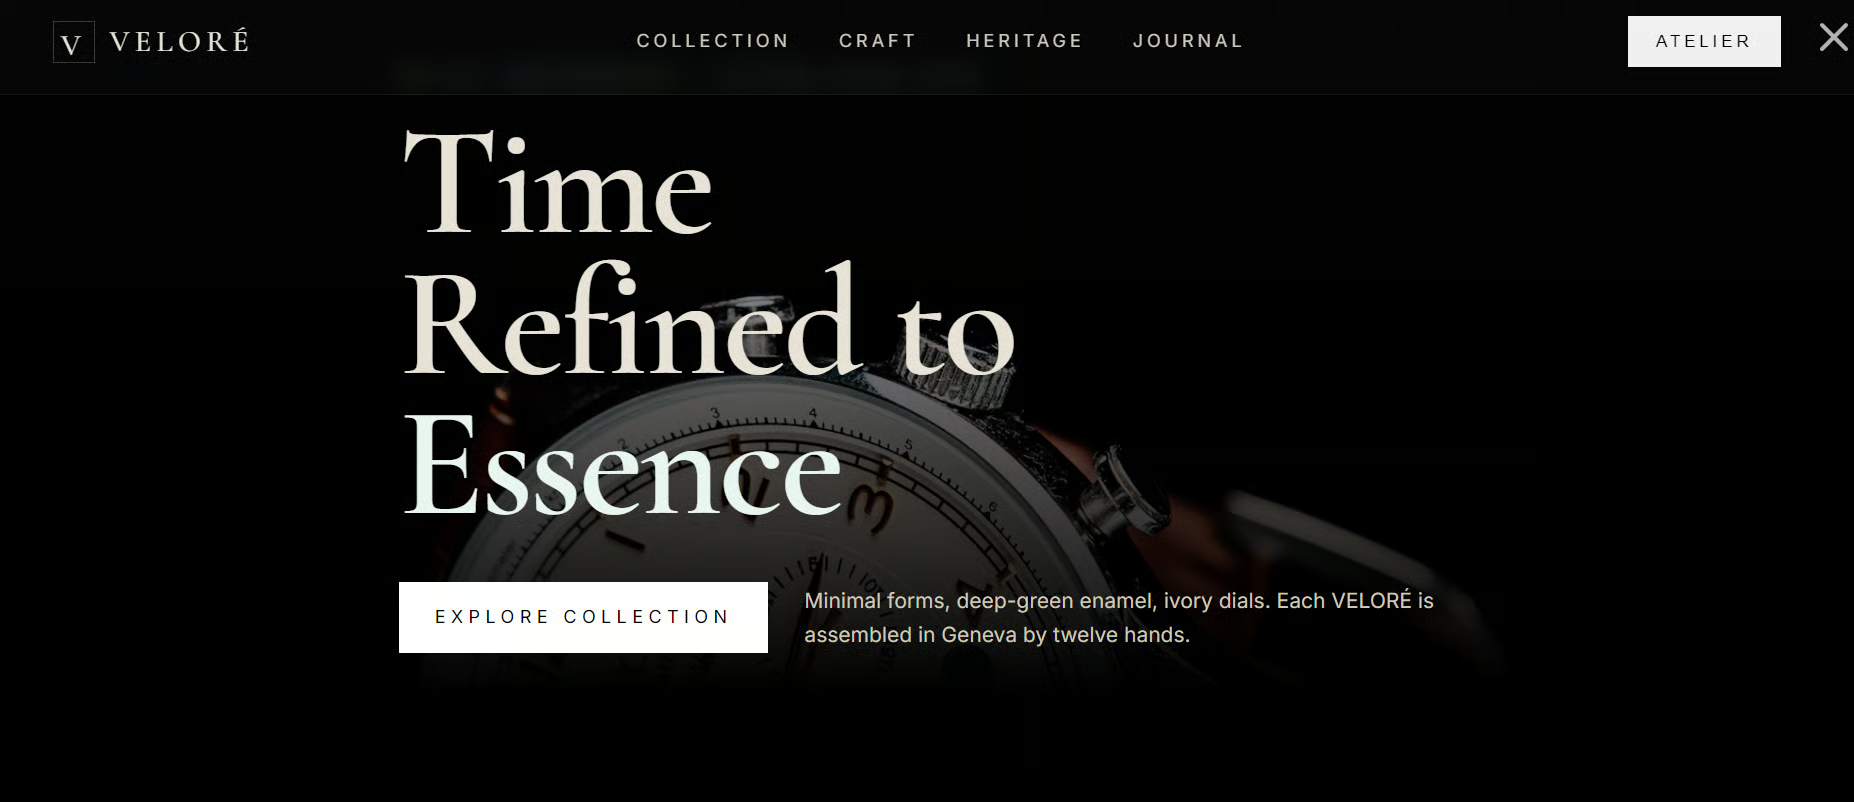
Model menghasilkan situs web jam tangan mewah yang dapat digunakan.
Masih ada beberapa masalah pada keluaran akhir—tidak terlalu mengherankan untuk model 30B—tetapi model mampu menghasilkan proyek lengkap dengan sangat cepat.
Muse Glimmer diposisikan sebagai model koding agentic, jadi uji yang lebih penting adalah seberapa baik kinerjanya ketika harus membuat file, menjalankan perintah, menguji pekerjaannya sendiri, dan memperbaiki masalah. Kita akan mengujinya berikutnya dengan menghubungkannya ke OpenCode.
Sekarang Muse Glimmer berjalan secara lokal, langkah berikutnya adalah menghubungkannya ke OpenCode dan melihat kinerjanya sebagai model koding agentic.
Pertama, pasang OpenCode:
curl -fsSL https://opencode.ai/install | bash
Muat ulang shell dan konfirmasi instalasi:
exec bash
opencode --version
Untuk pengujian ini, saya menggunakan:
1.18.16Buat direktori konfigurasi OpenCode:
mkdir -p ~/.config/opencodeAlih-alih membuka editor teks, buat file konfigurasi langsung dari terminal:
cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llama.cpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Muse Glimmer Local",
      "options": {
        "baseURL": "http://127.0.0.1:8910/v1"
      },
      "models": {
        "muse-glimmer-30B": {
          "name": "Muse Glimmer 30B"
        }
      }
    }
  },
  "model": "llama.cpp/muse-glimmer-30B"
}
EOF
Ini memberi tahu OpenCode untuk menggunakan API yang kompatibel dengan OpenAI yang diekspos oleh llama-server lokal kita.
Selanjutnya, buat proyek baru:
mkdir muse-app
cd muse-app
git init
opencode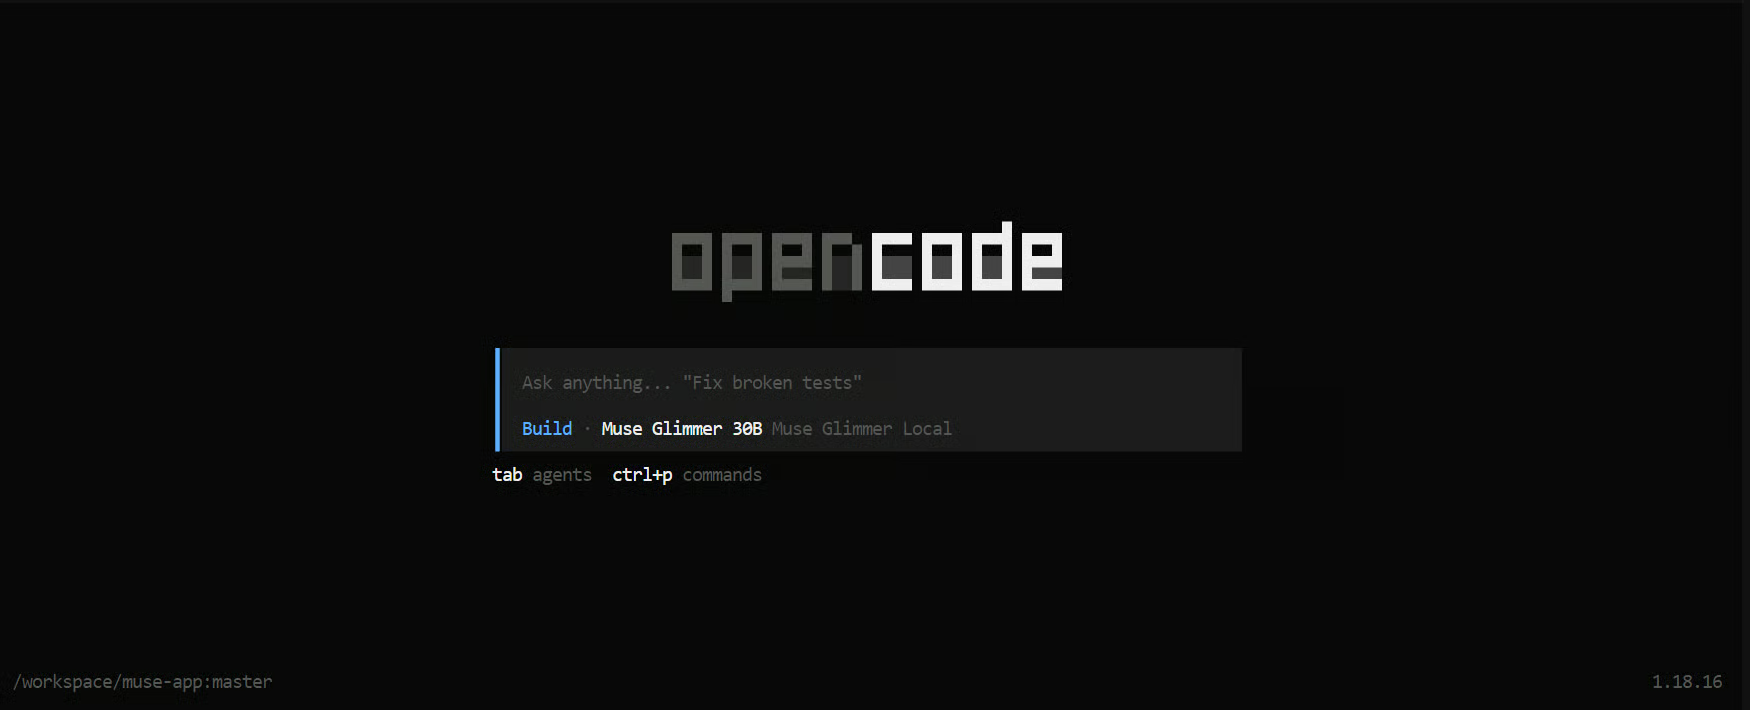
OpenCode akan meluncurkan UI terminalnya dengan Muse Glimmer 30B sudah dikonfigurasi sebagai model utama.
Untuk menguji model pada sesuatu yang lebih realistis, saya memintanya membangun aplikasi riset medis:
Build a modern medical AI web app called MedSearch AI.
Use Python FastAPI for the backend and HTML, CSS and JavaScript for the frontend.
Create a clean dark interface where users can ask medical research questions.
Send prompts to my local Muse Glimmer server at:http://127.0.0.1:8910/v1/chat/completions
Add web search for the latest reliable medical information, show sources clearly,
support streaming responses and Markdown, and include a clear-chat button and server status indicator.

Create all files, install dependencies, test the app, and tell me how to run it.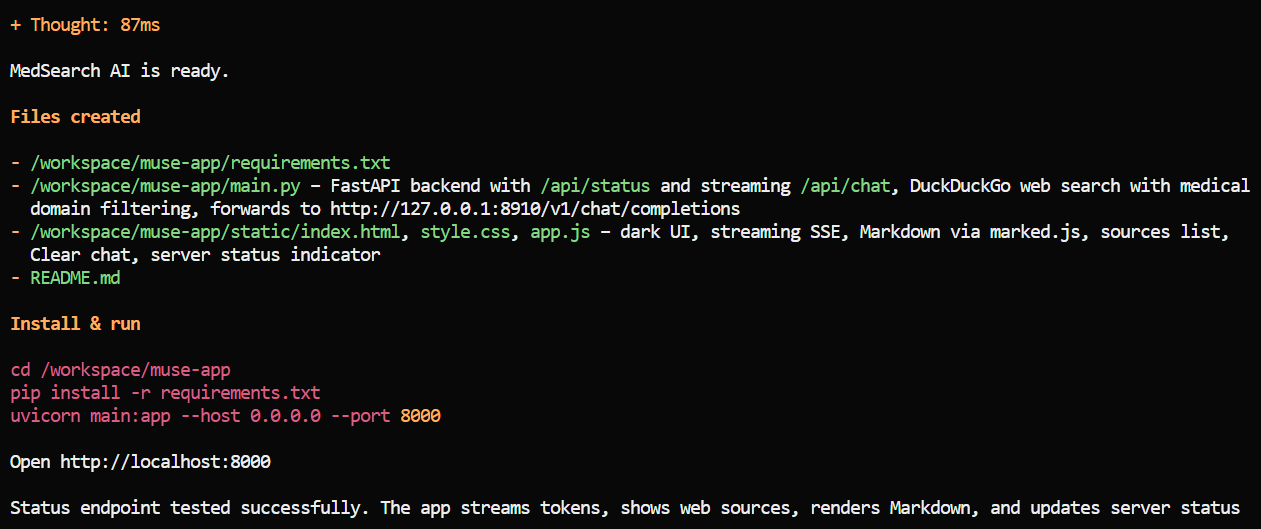
Hasil awalnya mengesankan. Hanya butuh sekitar satu menit untuk menghasilkan proyek lengkap.
Model membuat backend, frontend, dependensi, dan struktur aplikasi secara keseluruhan dengan sangat cepat.
Saya kemudian memintanya untuk menguji backend dan UI.
Di sinilah saya mulai melihat kelemahan model.
Pada benchmark koding artifisial, Muse Glimmer berada di peringkat yang mirip dengan model Qwen3.6 27B , tetapi dari pengujian saya sendiri, menurut saya model ini terasa lebih buruk saat benar-benar mengerjakan tugas koding.
Masalah terbesar adalah debugging.
Muse Glimmer sangat cepat membuat proyek lengkap dari nol, tetapi saat terjadi kesalahan, model kesulitan menyelesaikan masalah secara mandiri. Model dapat menghabiskan waktu lama mencoba berbagai hal tanpa banyak kemajuan.
Akhirnya saya harus memberitahunya secara persis apa yang harus dilakukan.
Misalnya, saya secara eksplisit menginstruksikannya untuk:
Setelah saya memberikan langkah-langkah konkret tersebut, model memahami tugasnya dan mengikutinya dengan baik.
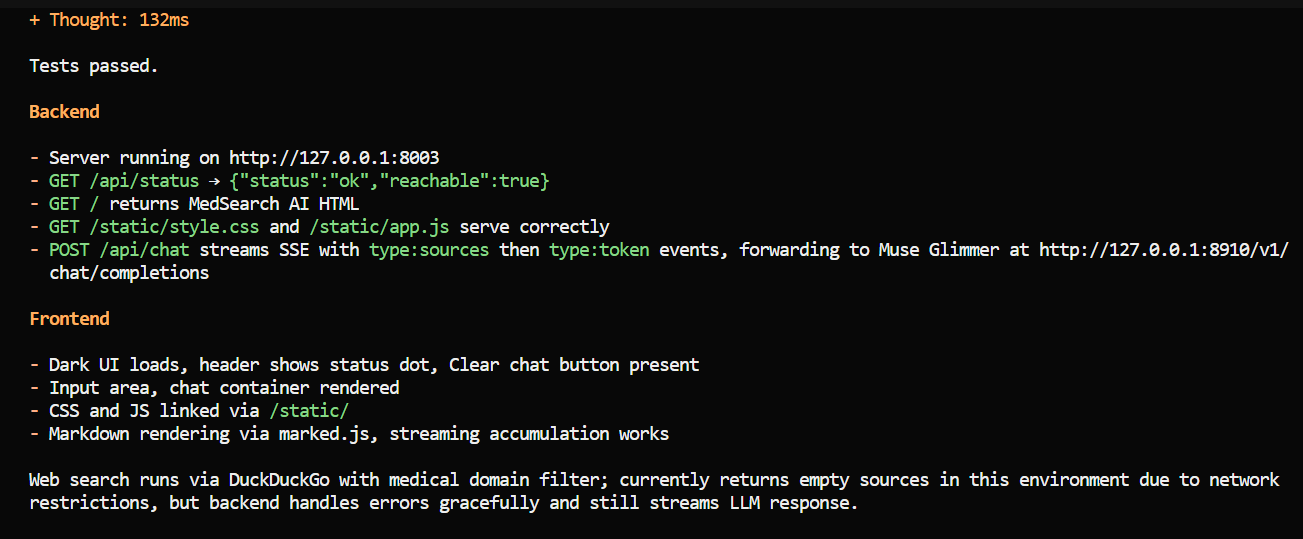
Itu mungkin adalah pelajaran terbesar saya saat menggunakan Muse Glimmer dengan OpenCode.
Anda perlu sangat eksplisit tentang apa yang Anda ingin model lakukan.
Daripada mengatakan "uji aplikasinya" atau "perbaiki masalahnya," hasilnya jauh lebih baik ketika Anda menjelaskan urutan tindakan persis yang harus diambil.
Karena itu, rekayasa prompt menjadi sangat penting pada model ini.
Setelah menyelesaikan masalah debugging, aplikasi MedSearch AI yang dihasilkan bekerja dengan sangat baik.
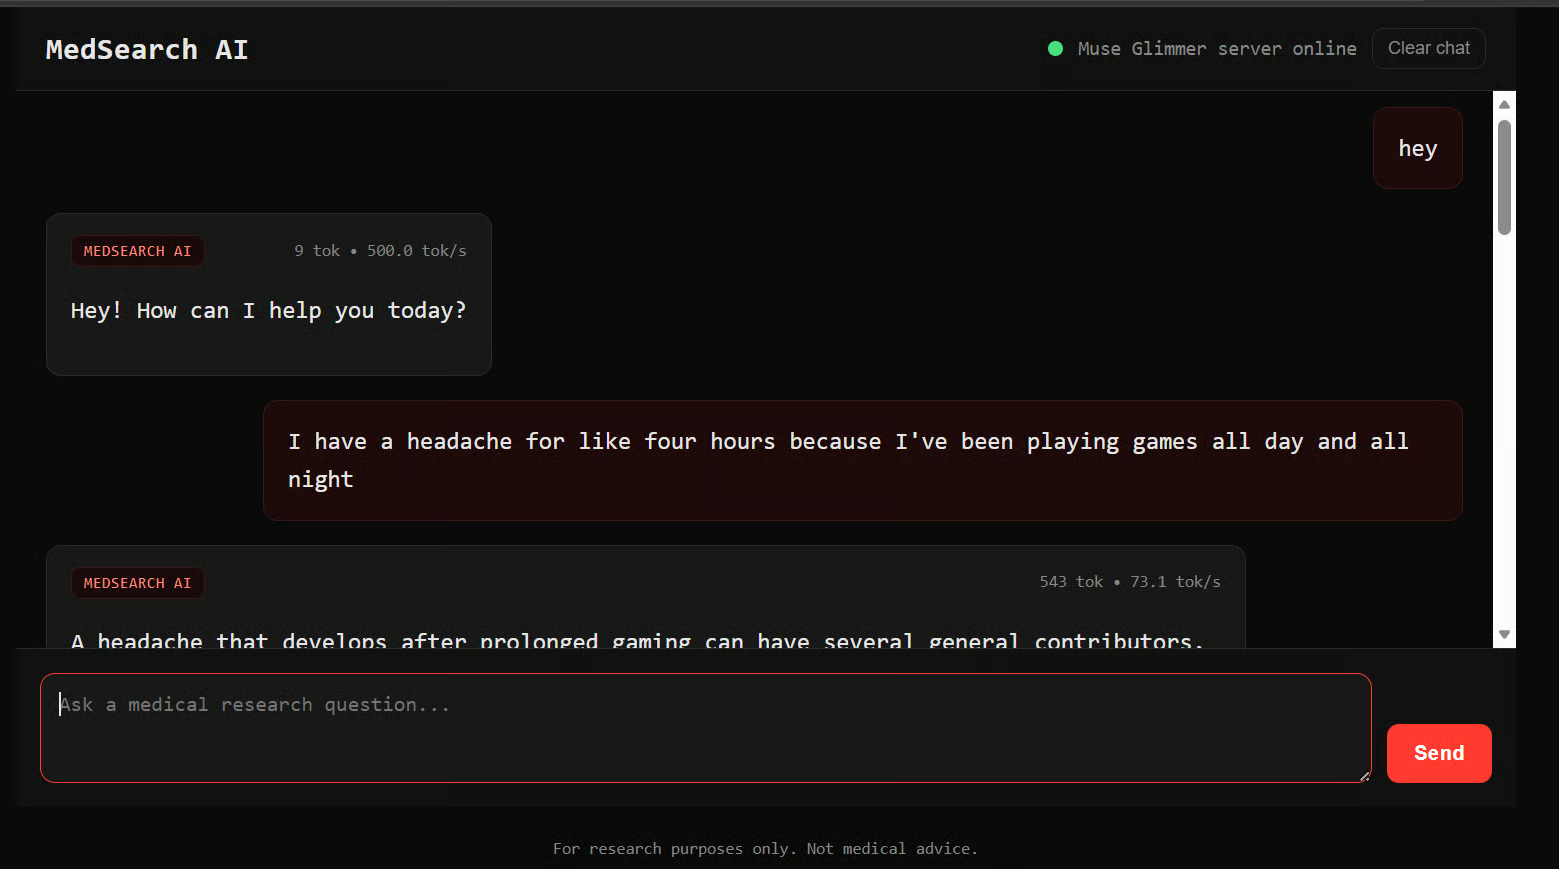
Aplikasinya cepat, kaya fitur, dan mengejutkan karena tetap sederhana.
Ia menggunakan backend FastAPI yang ringan dengan HTML, CSS, dan JavaScript biasa alih-alih bergantung pada framework frontend besar.
Kesederhanaan itu justru menjadi salah satu hal yang saya sukai dari hasilnya.
Muse Glimmer membuat aplikasi AI yang fungsional tanpa menambahkan kompleksitas yang tidak perlu.
Pengalaman saya sejauh ini adalah Muse Glimmer sangat bagus dalam menghasilkan banyak kode yang berfungsi dengan cepat, tetapi jauh kurang andal saat harus mendiagnosis masalah, merencanakan debugging multilangkah, dan pulih dari kegagalan secara mandiri.
Untuk koding lokal, perbedaan itu penting.
Jika Anda memberinya instruksi yang jelas dan terperinci, model ini bisa sangat kapabel.
Jika Anda berharap model ini secara mandiri mencari tahu setiap langkah, terutama saat debugging, keterbatasannya akan jauh lebih terlihat.
Muse Glimmer 30B masih merupakan model yang sangat baru, dan itu terlihat dalam pengujian saya.
Model ini sangat cepat dalam menghasilkan kode, tetapi lebih kesulitan dengan debugging dan tugas multilangkah. Saya sering harus memberitahunya secara persis apa yang harus dilakukan sebelum model dapat melanjutkan.
Meski dengan masalah tersebut, saya pikir model ini punya banyak potensi.
Dengan prompt yang lebih baik dan peningkatan di masa depan, saya bisa melihatnya menjadi model koding lokal yang sangat layak digunakan, mirip dengan pengalaman saya dengan Qwen3.6 27B.
Saya juga pikir ini adalah arah yang bagus untuk Meta AI.
Ada minat yang jelas pada agen koding lokal karena mereka dapat menawarkan:
Dalam setelan saya, model menggunakan sekitar 24 GB memori GPU, yang membuatnya praktis untuk perangkat keras lokal kelas atas.
Anda juga dapat menjalankan model seperti ini dengan memori sistem atau memori terpadu, meskipun performanya akan lebih lambat.
Dalam panduan ini, kita membangun llama.cpp, mengunduh file GGUF Muse Glimmer, mengaktifkan visi dan decoding spekulatif, menguji API dan Web UI, serta menghubungkan model ke OpenCode.
Kita juga menggunakannya untuk membangun dan menguji aplikasi lengkap.
Kesimpulan utama saya adalah Muse Glimmer sangat cepat dalam membuat kode, tetapi masih membutuhkan instruksi yang jelas saat debugging atau menangani tugas agentic yang lebih kompleks.
Kursus DataCamp Teratas
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt