
Kursus
Pengembangan Kode dengan Bantuan AI untuk Developer
1 jam 30 menit
11.1K
Hanya beberapa jam setelah Google memperkenalkan Gemini 3.8 Flash, Meta merilis Muse Spark 1.3, sebuah pembaruan pada keluarga model andalannya yang ditujukan langsung pada alur kerja agentic dan pengodean.
Rilis ini hadir di pasar yang ramai, di mana GPT-5.6 Sol dari OpenAI, Claude Opus 5 dari Anthropic, dan Grok 4.6 dari xAI sama-sama bersaing memperebutkan perhatian para pengembang.
Muse Spark 1.3 diluncurkan di Muse Code dan Meta Model API, mempertahankan jendela konteks 1M token.
Dalam perbandingan yang dijalankan oleh insinyur Meta, model ini menggunakan sekitar 20% lebih sedikit panggilan alat dan 25% lebih sedikit token daripada Muse Spark 1.2, dan Artificial Analysis memberi skor varian xhigh pada Intelligence Index 61 dengan kecepatan keluaran 182 token/detik.
Dalam artikel ini, saya akan membahas semua hal baru di Muse Spark 1.3, melihat fitur agentic dan pengodeannya, gambaran tolok ukur, dan harga.
Untuk membandingkannya dengan kompetitor, lihat panduan kami tentang GPT-5.6 Terra vs Claude Sonnet 5 dan Claude Opus 5 vs Claude Sonnet 5. Saya juga merekomendasikan panduan tentang Muse Agent dari Meta.
Muse Spark 1.3 adalah model andalan Meta saat ini, diposisikan sebagai pembaruan inkremental atas Muse Spark 1.2 alih-alih pembangunan ulang dari nol.
Model ini hadir dalam dua varian yang muncul dalam riset:
Perubahan berfokus pada dua area utama: mempertahankan pekerjaan agentic jangka panjang dan merapikan perilaku pengodean.
Meta melatih model ini di berbagai harness sehingga dapat menggeneralisasi ke berbagai lingkungan agentic, dan menambahkan pelatihan pada lebih banyak tugas pengodean jangka panjang. Mereka membingkai rilis ini sebagai langkah menuju tujuan yang dinyatakan: superkecerdasan personal.
Inti yang saya tangkap dari peluncuran ini adalah soal efisiensi; Muse Spark 1.3 menyelesaikan perbandingan rekayasa dengan sekitar 20% lebih sedikit panggilan alat dan 25% lebih sedikit token daripada 1.2.
Bagi siapa pun yang membayar per token di Meta Model API, ini adalah pengurangan biaya langsung pada beban kerja yang sama.
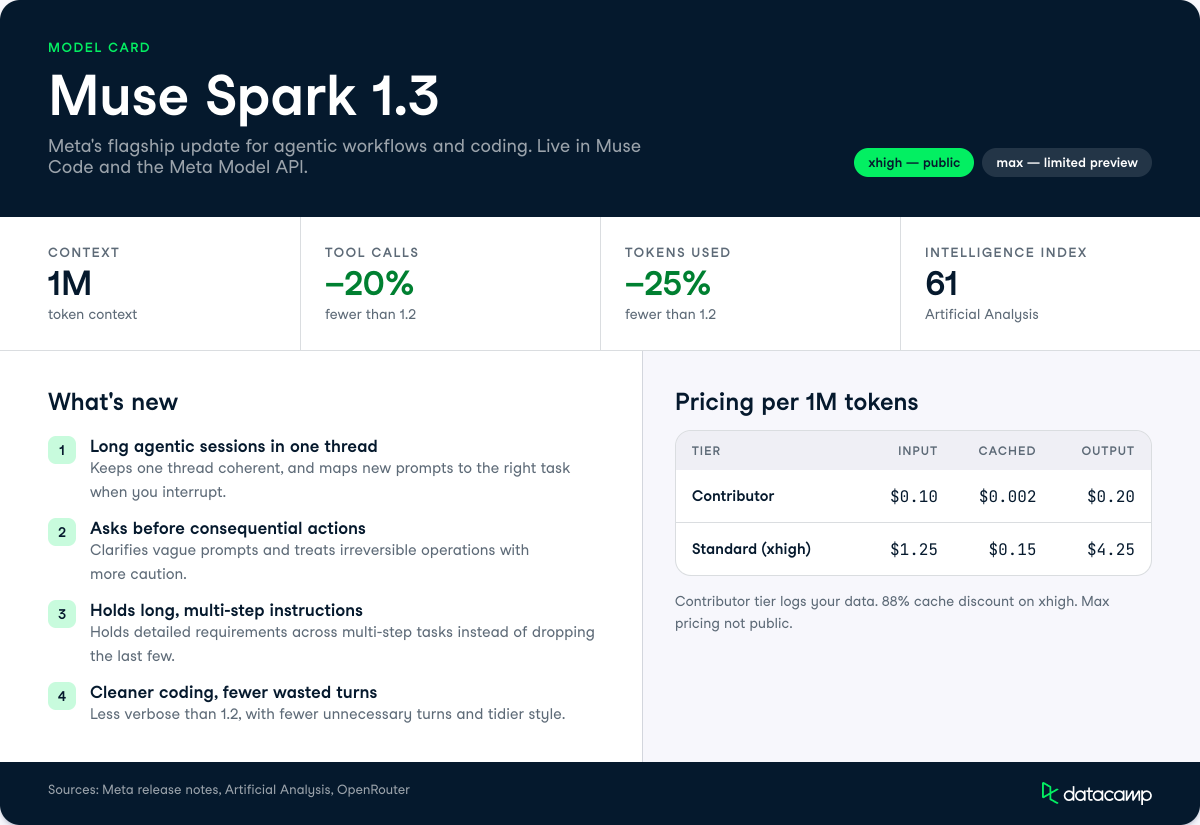
Pembaruan di Muse Spark 1.3 berpusat pada bagaimana model berperilaku selama sesi agentic yang panjang dan bagaimana model menulis serta mengedit kode.
Berikut adalah kemampuan yang menonjol bagi saya.
Muse Spark 1.3 dibangun untuk menjaga satu thread panjang tetap koheren sambil menangani banyak alur kerja sekaligus.
Diberi sebuah tujuan terbuka, model ini menggunakan alat untuk membangun konteksnya sendiri dari sumber yang berantakan dan saling bertentangan, memperbaiki celah dalam rencananya seiring berjalan, dan melacak apa yang telah dipelajarinya untuk menghasilkan keluaran akhir.
Meta juga meningkatkan multitugas dalam konteks thread tunggal.
Model memetakan prompt yang masuk ke tugas yang benar bahkan ketika Anda mengarahkan ulang permintaan sebelumnya atau mengganggunya di tengah proses, yang biasanya menjadi mode kegagalan yang menggagalkan sesi agent panjang.
Bagi mereka yang sering menggunakan Muse Spark, ini penting karena sebagian besar pekerjaan agent nyata bukan satu instruksi bersih. Ini adalah percakapan berkelanjutan di mana Anda mengubah pikiran, menambah batasan, dan menjeda tugas; model yang kehilangan jejak tugas mana yang terkait dengan sebuah pesan akan cepat menjadi tidak dapat digunakan.
Meta mengklaim bahwa Muse Spark 1.3 dilatih untuk bekerja bersama Anda alih-alih melaju tanpa klarifikasi pada instruksi yang ambigu. Artinya, model mengajukan pertanyaan klarifikasi ketika prompt samar, melibatkan Anda saat buntu, dan meminta konfirmasi sebelum melakukan tindakan yang berdampak.
Pada tugas panjang, model beradaptasi dengan preferensi Anda untuk pembaruan. Anda dapat memintanya melapor sering atau bekerja diam-diam di latar belakang hingga memiliki hasil, yang berguna ketika Anda ingin menjalankan sebuah tugas dan kembali mengecek nanti.
Meta juga meningkatkan kalibrasi model pada tindakan yang tidak dapat diurungkan, sehingga memperlakukan operasi destruktif dengan lebih hati-hati dibandingkan yang reversibel.
Itu bisa menjadi katup pengaman yang berarti bagi agen yang menyentuh file, mengirim pesan, atau menjalankan perintah shell.
Muse Spark 1.3 mengikuti instruksi kompleks dan panjang dengan lebih andal dibanding versi Muse Spark sebelumnya.
Di seluruh tugas multi-langkah, Meta melaporkan model ini lebih baik dalam mempertahankan persyaratan detail tanpa menjatuhkan batasan atau melenceng dari alur kerja yang diminta.
Pertimbangkan permintaan seperti: susun laporan kepatuhan, ambil angka dari spreadsheet terlampir, format angka menjadi dua tabel, ekspor sebagai PDF, dan susun di bawah enam judul bernama. Model sebelumnya cenderung memaku tiga persyaratan pertama dan diam-diam melupakan dua yang terakhir.
Model juga memiliki kesadaran yang lebih baik tentang batasnya sendiri.
Meta melatihnya untuk mengenali saat menemui jalan buntu dan mengatakannya, daripada menghalusinasi hasil agar terlihat tuntas, meskipun riset tidak mengkuantifikasi seberapa sering ini terjadi.
Muse Spark 1.3 dilatih pada lebih banyak tugas pengodean jangka panjang dan berperilaku lebih baik dalam alur kerja rekayasa umum.
Dibandingkan Muse Spark 1.2, Meta mengatakan model ini mengambil lebih sedikit putaran saat tidak diperlukan, kurang bertele-tele, dan menghasilkan gaya pengodean yang lebih bersih.
Keuntungan efisiensi adalah bagian yang konkret: dalam perbandingan insinyur Meta, Muse Spark 1.3 menggunakan sekitar 20% lebih sedikit panggilan alat dan 25% lebih sedikit token dibanding 1.2.
Lebih sedikit panggilan alat berarti lebih sedikit perjalanan bolak-balik dan latensi lebih rendah pada tugas pengodean agentic, dan lebih sedikit token berarti biaya per tugas yang diselesaikan lebih rendah.
Satu catatan yang terlihat di laporan komunitas adalah beberapa pengguna Reddit menemukan model ini membuat frustrasi karena tidak mengekspos proses berpikirnya, yang membuat debug keputusan pengodeannya lebih sulit dibanding model yang menampilkan jejak penalaran.
Meta memublikasikan skor tolok ukur di tiga kategori dalam rilis Muse Spark 1.3: tugas agen, pengambilan konteks panjang, dan pengodean.
Hasil di bawah ini membandingkan varian max dengan Muse Spark 1.2 xhigh, GPT-5.6 Sol (max), dan Claude Opus 5 (max).
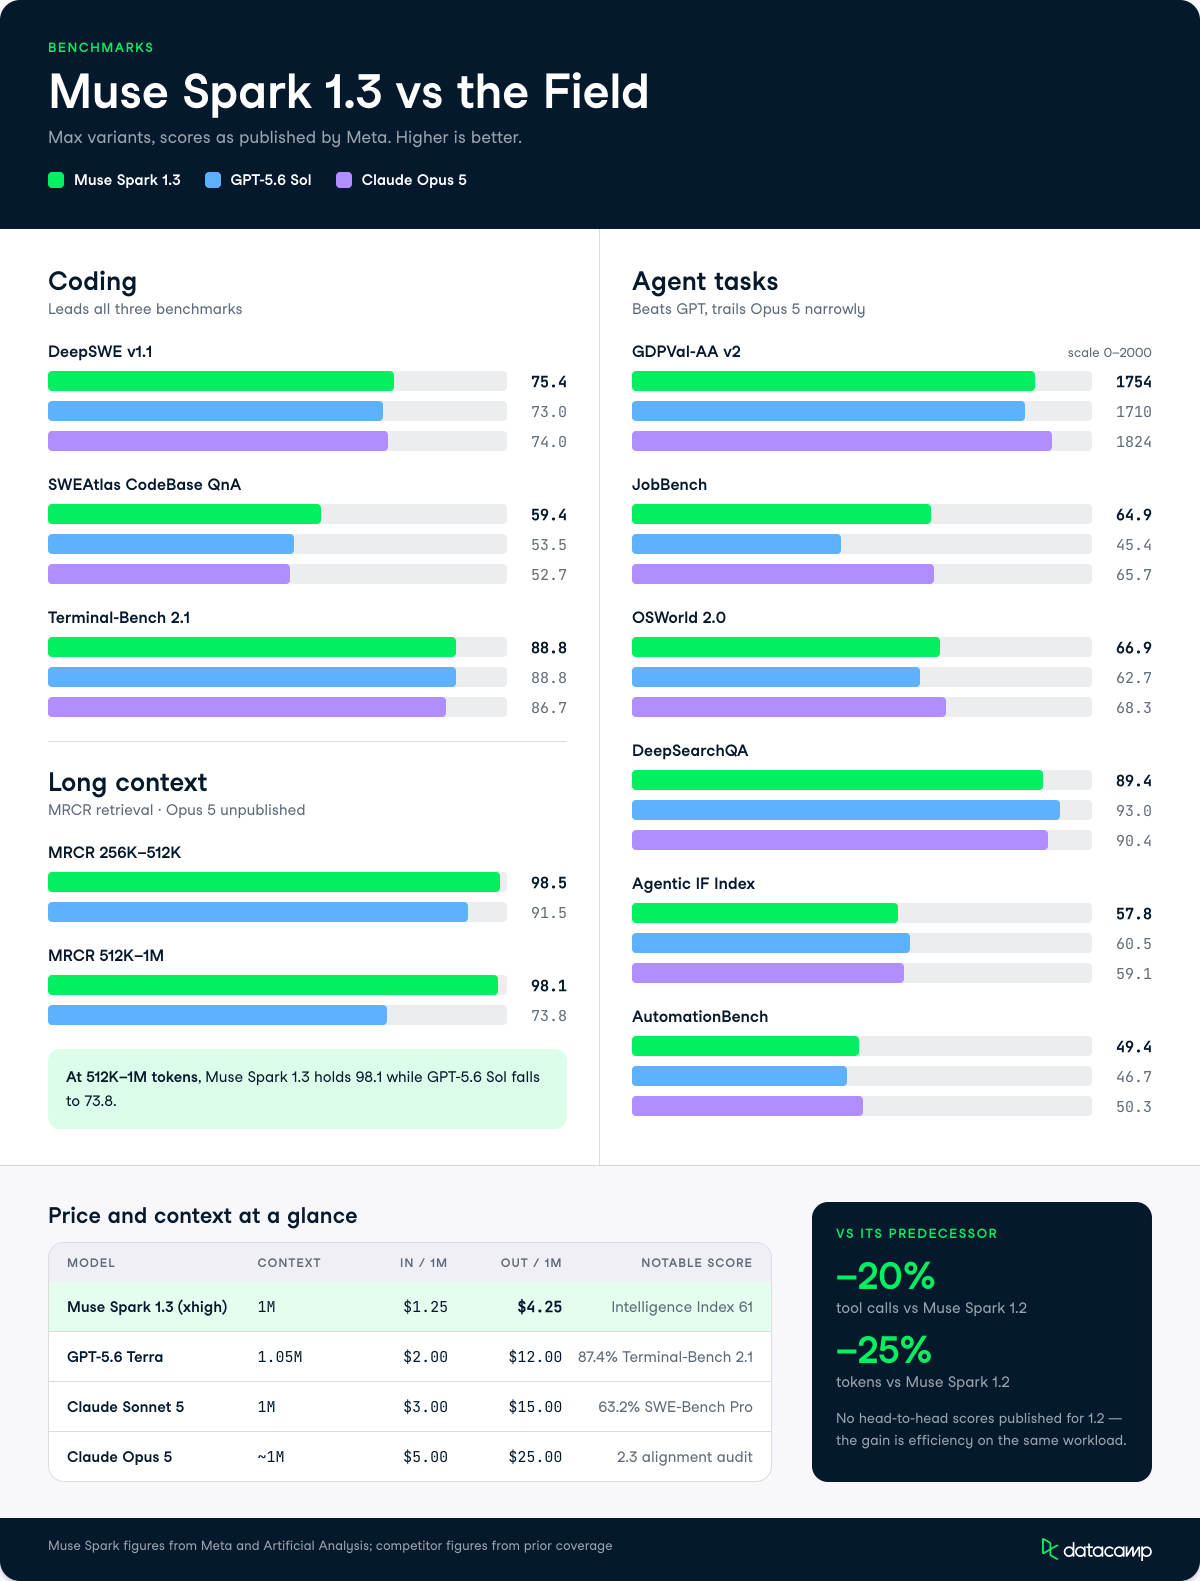
Pengodean adalah area di mana Muse Spark 1.3 membuat argumen terkuat. Model ini memimpin di ketiga tolok ukur, termasuk seri dengan GPT-5.6 Sol pada Terminal-Bench 2.1.
| Tolok ukur | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| DeepSWE v1.1 | 75,4 | 73,0 | 74,0 |
| SWEAtlas CodeBase QnA | 59,4 | 53,5 | 52,7 |
| Terminal-Bench 2.1 | 88,8 | 88,8 | 86,7 |
Hasil DeepSWE v1.1 (75,4) adalah yang paling menonjol.
Tolok ukur tersebut mengukur pengodean agentic jangka panjang, di mana model harus menyelesaikan tugas rekayasa perangkat lunak nyata secara mandiri.
Mengalahkan Opus 5 dan GPT-5.6 Sol pada evaluasi itu bermakna bagi siapa pun yang mengevaluasi agen pengodean.
Skor pemahaman basis kode SWEAtlas (59,4) menunjukkan cerita serupa: Muse Spark 1.3 membaca dan menalar atas basis kode besar lebih baik daripada kedua pesaing langsung di sini.
Muse Spark 1.3 memiliki keunggulan signifikan pada pengambilan konteks panjang, terutama pada ujung jauh jendela konteks di mana sebagian besar model mengalami degradasi.
| Tolok ukur | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) |
|---|---|---|
| MRCR 256K–512K | 98,5 | 91,5 |
| MRCR 512K–1M | 98,1 | 73,8 |
Pada 512K hingga 1M token, GPT-5.6 Sol turun ke 73,8 sementara Muse Spark 1.3 bertahan di 98,1. Jika pekerjaan Anda melibatkan memasukkan seluruh basis kode, rangkaian dokumen panjang, atau jejak agen yang diperluas ke dalam satu konteks, ini adalah kategori yang paling penting. Skor Opus 5 tidak dipublikasikan untuk MRCR, sehingga perbandingan tiga arah langsung tidak memungkinkan di sini.
Pada tolok ukur agen, Muse Spark 1.3 berada di antara GPT-5.6 Sol dan Opus 5.
Model ini mengalahkan GPT di sebagian besar kategori tetapi tertinggal tipis dari Opus 5 secara keseluruhan.
| Tolok ukur | Muse Spark 1.3 (max) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|
| GDPVal-AA v2 | 1754 | 1710 | 1824 |
| JobBench | 64,9 | 45,4 | 65,7 |
| OSWorld 2.0 | 66,9 | 62,7 | 68,3 |
| DeepSearchQA | 89,4 | 93,0 | 90,4 |
| Agentic IF Index | 57,8 | 60,5 | 59,1 |
| AutomationBench | 49,4 | 46,7 | 50,3 |
Kesenjangan JobBench atas GPT-5.6 Sol (64,9 vs 45,4) adalah margin terbesar di kategori agen dan patut dicatat bagi siapa pun yang menggunakan AI dalam alur kerja profesional.
DeepSearchQA adalah satu area di mana GPT-5.6 Sol memimpin (93,0 vs 89,4), dan pengikutan instruksi (Agentic IF Index) juga sedikit menguntungkan GPT.
Pada penggunaan komputer (OSWorld 2.0), Muse Spark 1.3 kompetitif di 66,9 melawan 68,3 milik Opus 5.
Gambaran keseluruhannya: Muse Spark 1.3 unggul pada pengodean dan pengambilan konteks panjang, kompetitif pada tugas agen, dan sedikit di belakang Opus 5 pada pekerjaan berbasis pengetahuan dan orkestrasi agen umum.
Berikut referensi cepat yang membandingkan Muse Spark 1.3 dengan model kelas menengah dan andalan yang telah kami ulas.
Angka untuk Muse Spark berasal dari Artificial Analysis; angka kompetitor berasal dari liputan kami sebelumnya.
| Model | Konteks | Input / 1M | Output / 1M | Skor penting |
|---|---|---|---|---|
| Muse Spark 1.3 (xhigh) | 1M | $1,25 | $4,25 | Intelligence Index 61 |
| GPT-5.6 Terra | 1,05M | $2,00 | $12,00 | 87,4% Terminal-Bench 2.1 |
| Claude Sonnet 5 | 1M | $3,00 | $15,00 | 63,2% SWE-Bench Pro |
| Claude Opus 5 | ~1M | $5,00 | $25,00 | 2,3 audit alignment |
Kesenjangan harga terlihat jelas di sini; token keluaran Muse Spark 1.3 kira-kira sepertiga dari Sonnet 5 dan seperenam dari Opus 5.
Muse Spark 1.3 tersedia hari ini di Muse Code dan Meta Model API.
Meta for Developers mencatat bahwa pengguna yang sudah ada dapat mengganti ID model dan mempertahankan endpoint, SDK, dan harga yang sama, sehingga jalur peningkatannya minim gesekan.
Harga di Meta Model API bergantung pada tingkat, dengan tingkat kontributor yang mencatat data Anda untuk meningkatkan produk Meta dengan tarif lebih rendah dan tingkat standar yang tidak melakukannya.
| Tingkat | Konteks | Input / 1M | Input cache / 1M | Output / 1M |
|---|---|---|---|---|
| Kontributor (data digunakan untuk meningkatkan produk) | 1M | $0,10 | $0,002 | $0,20 |
| Standar (xhigh) | 1M | $1,25 | $0,15 | $4,25 |
Artificial Analysis melaporkan diskon cache 88% pada tingkat xhigh, dan OpenRouter mencerminkan tarif input $1,25 / output $4,25 sambil mencantumkan add-on seperti penelusuran web sebesar $2,50 per 1.000 panggilan.
Harga untuk varian max belum dipublikasikan pada saat analisis rilis.
Ada dua catatan ketersediaan dari komunitas yang perlu disampaikan pada saat penulisan:
Muse Spark 1.3 adalah pembaruan yang terarah pada efisiensi dan keandalan, bukan lompatan kapabilitas, dan Meta jujur mengenai kerangka tersebut.
Pengurangan 20% panggilan alat dan 25% token dibanding 1.2 adalah angka yang paling penting bagi siapa pun yang menjalankan agen dalam skala besar, karena langsung diterjemahkan menjadi biaya dan latensi yang lebih rendah.
Menurut saya, jika Anda sudah berada di Meta Model API atau Muse Code, peningkatan drop-in dengan penggunaan token yang lebih rendah adalah keputusan yang mudah.
Jika Anda memilih model baru untuk agen produksi, saya ingin melihat bagaimana model tampil di lapangan dan harga varian max sebelum berkomitmen padanya dibanding alternatif yang sudah terdokumentasi dengan baik.
Jika Anda ingin membangun keterampilan untuk mengevaluasi dan menggunakan model seperti ini dalam alur kerja Anda sendiri, saya merekomendasikan untuk memulai dengan AI Agent Fundamentals skill track kami.
Kursus Teratas di DataCamp
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt



