
Last chance! 50% off DataCamp Premium
Sale ends in
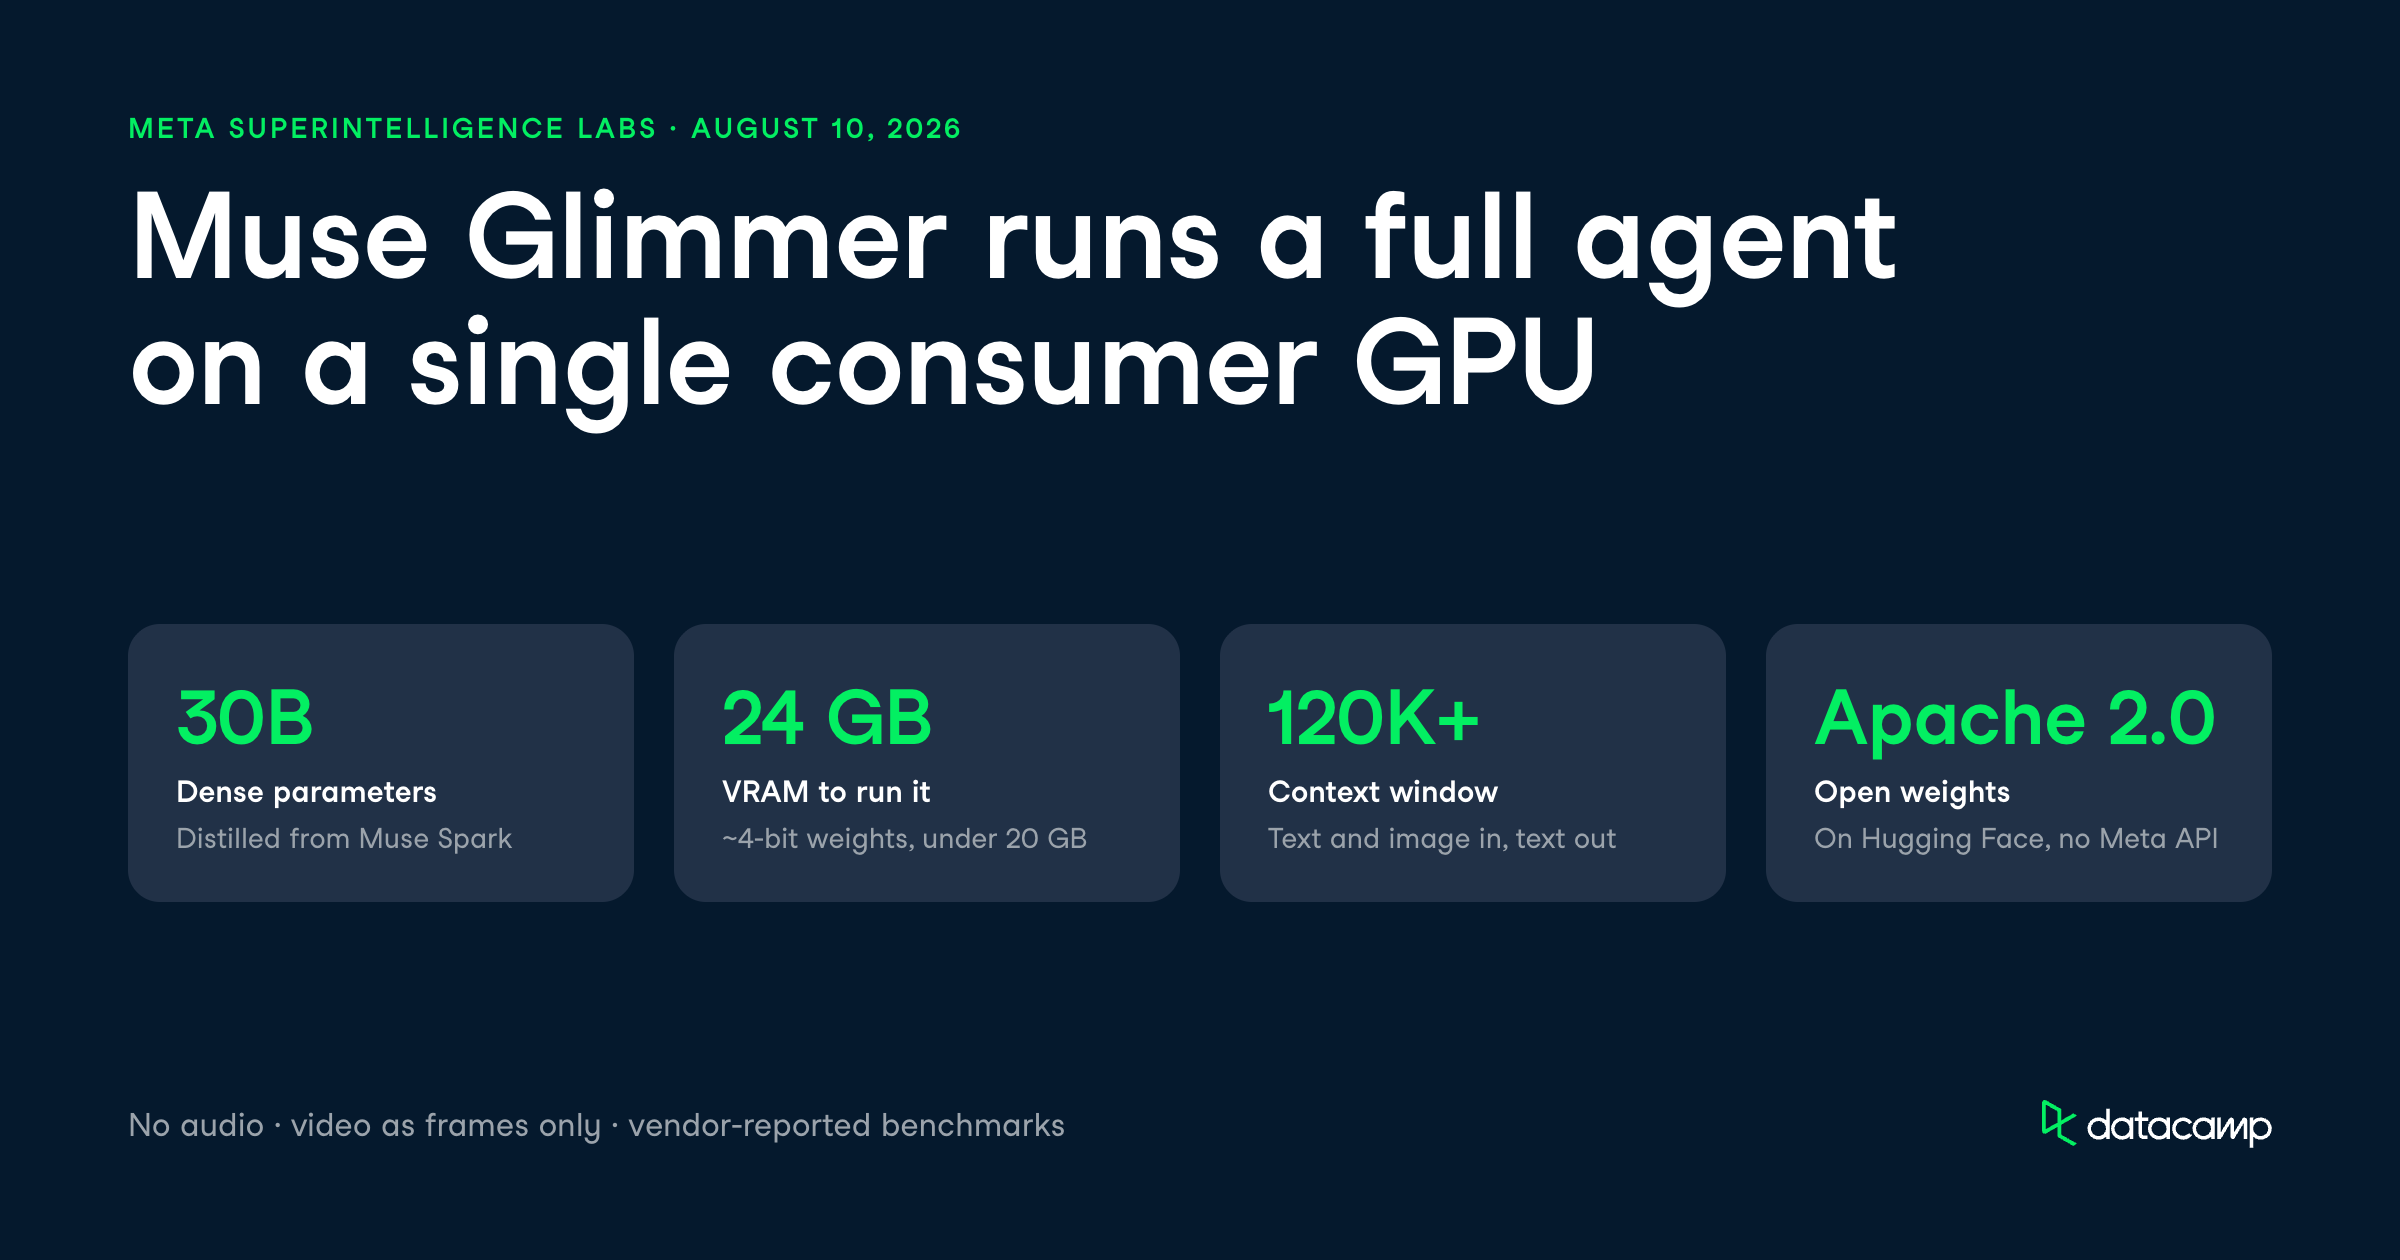
Meta Superintelligence Labs merilis Muse Glimmer pada 10 Agustus 2026, dan jualannya tidak biasa untuk peluncuran model 2026: model ini berjalan di laptop.
Ini adalah model agen bermuatan 30 miliar parameter yang dibuat untuk alur kerja lokal dan selalu aktif, dikirim dengan bobot terbuka di bawah lisensi Apache 2.0.
Klaim utamanya adalah bahwa Muse Glimmer berfungsi sebagai agen penuh (perencanaan, pemanggilan alat, pemeriksaan mandiri, dan pemulihan kegagalan) pada satu GPU konsumen 24 GB atau sistem memori terpadu kelas Mac. Model ini dikirim dengan jendela konteks 120K+, input multimodal teks dan gambar, serta bobot terkuantisasi yang mengecilkan model menjadi di bawah 20 GB. Meta membuka sumber bobotnya di Hugging Face bersama dokumentasi pengembang.
Dalam artikel ini, saya akan membahas semua hal baru dari Muse Glimmer, melihat fitur-fiturnya, tolok ukur terhadap model seperti Qwen3.6-27B dan Gemma4-31B, serta trik penerapan lokalnya. Anda dapat membaca panduan menjalankan Muse Glimmer secara lokal untuk pengodean AI kami secara terpisah.
Untuk mempelajari lebih lanjut tentang menjalankan model secara lokal secara umum, lihat tutorial kami tentang fine-tuning Qwen3.6 dan tingkatkan kemampuan Anda dengan jalur keterampilan AI Agent Fundamentals.
Muse Glimmer adalah model padat 30 miliar parameter dari Meta Superintelligence Labs, dioptimalkan untuk alur kerja agen lokal alih-alih chat yang di-host di cloud.
Model ini diposisikan sebagai saudara yang lebih kecil dan terdistenasi dari model guru internal yang lebih besar, Muse Spark, dan Meta secara eksplisit menyatakan Muse Glimmer tidak memenuhi definisi "Frontier AI" mereka.
Yang baru di sini adalah target penerapannya.
Kebanyakan model agen berkemampuan seperti ini mengasumsikan ada pusat data di belakangnya, tetapi Muse Glimmer dibangun untuk berjalan offline pada satu GPU konsumen.
Meta mengompresi bobotnya menjadi sekitar presisi 4-bit, membawa model bahasa ini menjadi di bawah 20 GB sehingga muat dalam amplop memori 24 GB atau 32 GB dengan ruang tersisa.
Tolok ukur utama yang menonjol adalah MCP-Atlas, tolok ukur agen umum, di mana Muse Glimmer mencetak 75,5 melawan 62,5 milik Qwen3.6-27B dan 54,2 milik Gemma4-31B.
Untuk model yang dapat Anda jalankan tanpa koneksi internet, memimpin kelas ukurannya pada orkestrasi agen adalah inti dari rilis ini.
Muse Glimmer dibangun untuk menjalankan agen personal secara lokal, jadi fiturnya berfokus pada penyelesaian tugas, penggunaan alat, dan tetap responsif pada perangkat keras terbatas.
Berikut kemampuan yang paling penting bagi para praktisi.
Anda dapat mengarahkan Muse Glimmer pada tugas multi-langkah dan membiarkannya merencanakan, memanggil alat, memeriksa hasilnya sendiri, dan memulihkan dari kegagalan tanpa koneksi jaringan.
Alexandr Wang, Chief AI Officer Meta, mengatakan model ini beroperasi "sebagai agen yang sepenuhnya mampu" dan mempertahankan keandalan ageniknya pada 24 GB VRAM.
Bagi praktisi, ini mengubah di mana agen dapat ditempatkan.
Model yang menyusun draf email Anda, menata ulang file Anda, atau memilah kalender Anda memerlukan akses mendalam ke konteks pribadi, dan menjaga konteks tersebut tetap di perangkat adalah posisi privasi yang berbeda dibanding mengirimkannya ke API cloud.
Muse Glimmer memanggil alat dengan skema yang presisi di sepanjang alur kerja panjang, dan ketika panggilan gagal atau mengembalikan sesuatu yang tidak terduga, model ini dilatih untuk mendiagnosis kesalahan dan mencoba lagi alih-alih berhenti. Perilaku pemulihan kegagalan ini adalah perbedaan antara agen yang menyelesaikan tugas dan yang macet di tengah jalan.
Model ini bekerja lintas OpenClaw dan pola orkestrasi agen lainnya, sehingga Anda tidak terkunci pada satu rangka.
Meta mengirimkan panduan tentang menyiapkan rangka khusus dalam dokumentasi, yang penting karena kualitas agen sering kali lebih bergantung pada harness di sekitarnya daripada model mentahnya.
Melalui encoder persepsi khusus, Muse Glimmer menerima teks dan gambar yang diselingi, sehingga agen dapat menafsirkan tangkapan layar dialog kesalahan, bagan penjualan, atau faktur hasil pemindaian bersamaan dengan percakapan.
Ini adalah teks dan gambar sebagai input, teks sebagai output.
Ada batasan nyata yang perlu dicatat: tidak ada input atau output audio, dan video hanya ditangani sebagai frame individual, bukan pemahaman video sejati.
Jika alur kerja Anda perlu menonton rekaman layar dari awal hingga akhir, ini bukan model yang tepat.
Muse Glimmer mendukung tingkat kekuatan penalaran yang berbeda, sehingga Anda dapat menukar kualitas dengan kecepatan tergantung tugasnya.
Agen pengganti nama file cepat tidak membutuhkan pertimbangan yang sama dengan sesi debug multi-langkah, dan kemampuan mengatur itu di perangkat menjaga latensi tetap wajar.
Model ini juga dilatih pada data dari lebih dari 100 bahasa, meski Meta mengingatkan belum dievaluasi pada semuanya, dan kualitas bisa menurun di luar set yang didukung kuat.
Meta mengevaluasi Muse Glimmer terhadap Gemma4-31B dan Qwen3.6-27B di kategori agen, pengodean, multimodal, keamanan, dan penalaran, menggunakan harness mereka sendiri.
Reproduksi independen belum tersedia saat penulisan, jadi perlakukan ini sebagai angka dari vendor.
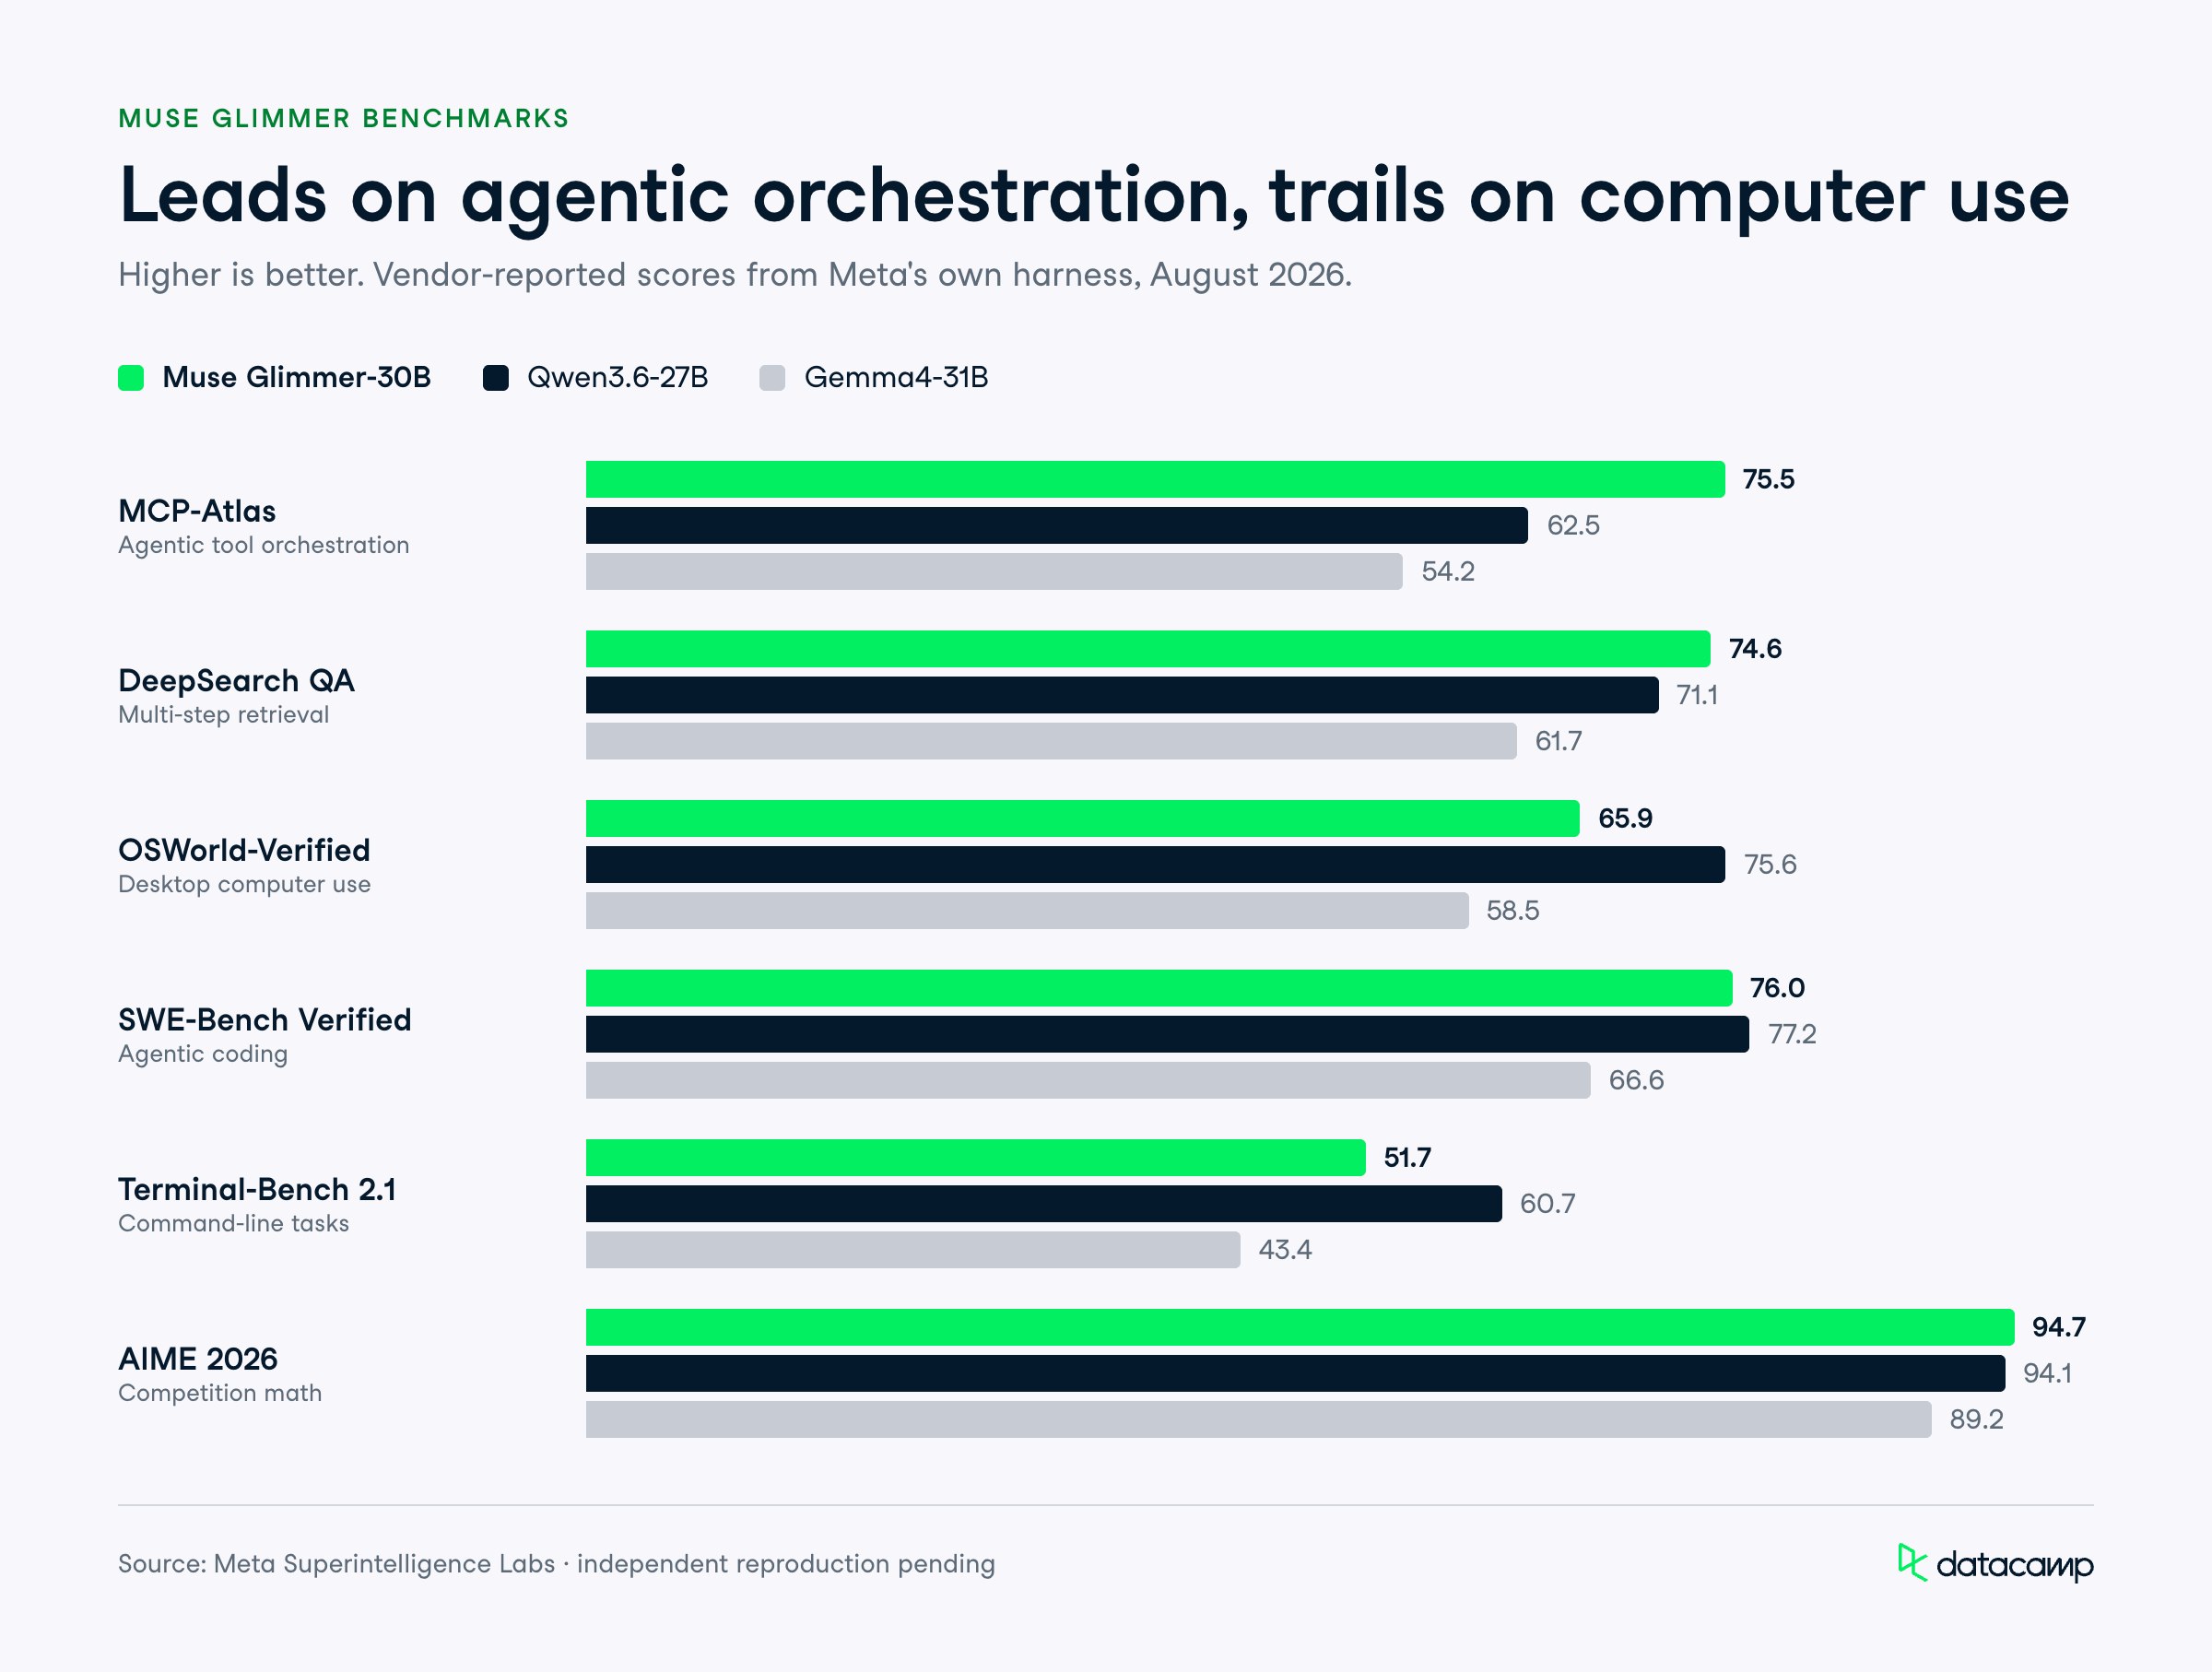
Muse Glimmer memimpin kelas ukurannya pada tolok ukur agen umum tetapi tertinggal dari Qwen3.6-27B pada beberapa tugas penggunaan komputer dan terminal.
Pada tabel di bawah, Anda dapat dengan cepat melihat bagaimana Muse Glimmer dibandingkan dengan kompetitornya:
| Tolok ukur | Muse Glimmer-30B | Qwen3.6-27B | Gemma4-31B |
|---|---|---|---|
| MCP-Atlas | 75.5 | 62.5 | 54.2 |
| DeepSearch QA | 74.6 | 71.1 | 61.7 |
| OSWorld-Verified | 65.9 | 75.6 | 58.5 |
| SWE-Bench Verified | 76.0 | 77.2 | 66.6 |
| Terminal-Bench 2.1 | 51.7 | 60.7 | 43.4 |
| AIME 2026 | 94.7 | 94.1 | 89.2 |
| GPQA Diamond | 83.5 | 84.2 | 85.7 |
| MMMU Pro | 74 | 75 | 73 |
MCP-Atlas mengukur seberapa baik sebuah model mengorkestrasi pemanggilan alat melalui Model Context Protocol, dan Muse Glimmer mencetak 75,5 melawan 62,5 milik Qwen3.6-27B dan 54,2 milik Gemma4-31B.
Pada DeepSearch QA, tolok ukur pengambilan informasi multi-langkah, Muse Glimmer mencetak 74,6, sedikit di depan 71,1 milik Qwen3.6-27B dan jauh melampaui 61,7 milik Gemma4-31B.
Gambarnya tidak seragam. Pada OSWorld-Verified, yang menguji agen penggunaan komputer di lingkungan desktop nyata, Muse Glimmer mencetak 65,9 sementara Qwen3.6-27B memimpin di 75,6, jadi Qwen adalah pilihan yang lebih kuat untuk agen penggerak layar.
SWE-Bench Verified mengukur apakah sebuah model dapat menyelesaikan isu GitHub nyata dengan menulis dan men-debug kode.
Muse Glimmer mencetak 76,0, mendekati 77,2 milik Qwen3.6-27B dan di depan 66,6 milik Gemma4-31B.
Pada Terminal-Bench 2.1, yang menguji penyelesaian tugas baris perintah, Muse Glimmer tertinggal di 51,7 melawan 60,7 milik Qwen3.6-27B. Sebagai referensi, ketika kami melakukan fine-tuning Qwen3.6 dalam tutorial kami sendiri, kami menemukan kekuatannya pada SWE-bench dan Terminal-Bench terbukti dalam praktik, sehingga keunggulan Qwen pada tugas terminal di sini selaras dengan yang kami lihat.
AIME 2026 adalah tolok ukur matematika kompetisi, dan Muse Glimmer mencetak 94,7, sedikit mengungguli 94,1 milik Qwen3.6-27B dan mengalahkan 89,2 milik Gemma4-31B.
Itu hasil yang kuat untuk model sekecil ini.
Pada GPQA Diamond, kumpulan pertanyaan sains tingkat pascasarjana, Muse Glimmer mencetak 83,5 sementara Gemma4-31B memimpin di 85,7, dan Qwen3.6-27B berada di 84,2.
Pada Humanity's Last Exam (teks, tanpa alat), Muse Glimmer mencetak 22,0, sedikit di belakang kedua rivalnya.
MMMU Pro menguji penalaran multimodal pada gambar dan teks dengan tingkat kesulitan pascasarjana, dan ketiga model hampir identik: Muse Glimmer 74, Qwen3.6-27B 75, Gemma4-31B 73.
Pada Charxiv Reasoning, yang menguji interpretasi bagan, Muse Glimmer mencetak 78,8, sedikit di depan kedua rivalnya.
Klaim kekuatan Meta sendiri pada ScreenSpot Pro tidak sepenuhnya terbukti: Muse Glimmer mencetak 75,4 sementara Qwen3.6-27B memimpin di 76,1.
Kategori multimodal cukup berdekatan sehingga ini tidak akan menjadi faktor penentu di antara model-model ini.
Pada CI Memories, yang mengukur tingkat pelanggaran privasi (lebih rendah lebih baik), Muse Glimmer mencatat tingkat pelanggaran 26,4 melawan 12,1 milik Gemma4-31B yang jauh lebih bersih dan 53,4 milik Qwen3.6-27B.
Jadi Muse Glimmer berada di antara rivalnya di sini, lebih aman daripada Qwen tetapi jauh di belakang Gemma pada metrik ini.
Pada Siren AgentDojo, yang mengukur ketahanan terhadap serangan injeksi prompt, Muse Glimmer menunjukkan tingkat keberhasilan serangan 28,4 dengan utilitas 94,2, dibandingkan 25,6 milik Gemma4-31B dan 40,3 milik Qwen3.6-27B. Jika Anda menerapkan agen yang menyentuh konten tidak tepercaya, ketahanan terhadap injeksi itu patut dipertimbangkan.
Muse Glimmer didistribusikan sebagai bobot terbuka di bawah Apache 2.0, dan tidak ada API pihak pertama yang di-host Meta.
Artinya tidak ada harga per-token dari Meta yang bisa dilaporkan: biaya Anda adalah infrastruktur dan self-hosting, bukan biaya API terukur.
Anda bisa mulai menjalankannya melalui beberapa jalur:
Meta bekerja sama dengan AMD, Arm, Dell, Intel, dan NVIDIA untuk menyetel kinerja di berbagai perangkat.
Target perangkat keras praktis adalah mesin 24 GB atau 32 GB: Meta melaporkan build K-Quant-17GB ditambah drafter DFlash terkuantisasi mempercepat decoding 3,1x pada RTX 5090, 1,8x pada M5 Max, dan 1,5x pada M4 Max.
Muse Glimmer menunjukkan taruhan sadar Meta pada agen lokal, privat, berbobot terbuka alih-alih satu lagi andalan cloud.
Dengan membatasi pada 30B dan mengirimkan bobot terkuantisasi yang muat pada satu GPU konsumen, Meta menargetkan ceruk yang diabaikan sebagian besar lab: pengembang yang menginginkan agen offline dengan konteks pribadi yang tidak pernah meninggalkan perangkat.
Menurut saya ini adalah tumpukan untuk builder, bukan pengganti cloud sekali-klik.
Kisah tolok ukurnya campur aduk (Qwen3.6-27B masih memimpin pada OSWorld-Verified dan Terminal-Bench 2.1, dan Gemma4-31B lebih bersih pada CI Memories), dan para peninjau menyebut Muse Glimmer lambat dan rapuh dekat batas memori. Namun memimpin kelas ukurannya pada MCP-Atlas dan DeepSearch QA, dengan lisensi Apache 2.0 yang permisif, menjadikannya opsi serius bagi siapa pun yang membangun agen lokal.
Keterbatasannya adalah tidak ada audio, video hanya sebagai frame, cakupan bahasa yang tidak merata, dan tolok ukur dari vendor saja hingga reproduksi independen tersedia.
Jika alur kerja Anda sensitif terhadap privasi atau benar-benar perlu berjalan tanpa jaringan, Muse Glimmer layak diunduh dan diuji melawan Qwen3.6 di perangkat keras Anda sendiri.
Jika Anda ingin membangun keterampilan untuk menjalankan dan menyetel model seperti ini sendiri, saya merekomendasikan tutorial kami tentang membangun agen AI otonom pertama Anda.
Kursus Teratas DataCamp
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




