Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
10.5K
Comme nous l'avons expliqué dans notre article de blog, Muse Glimmer 30B est un nouveau modèle ouvert conçu pour les workloads agentiques et de programmation.
Ce qui le rend particulièrement intéressant, c'est que vous pouvez faire tourner l'ensemble de la configuration en local sur une seule NVIDIA RTX 5090 avec 32 Go de VRAM à l'aide de llama.cpp.
Le modèle est disponible au format GGUF et, pour ce guide, j'utiliserai la quantification dynamique, plus qualitative.
La configuration complète comprend :
muse-glimmer-30B-kquant-dynamic.gguf : 19,7 Go de modèle principaldflash-kquant.gguf : 1,63 Go de modèle de brouillon pour le décodage spéculatifmmproj-kquant.gguf : 1,4 Go d'encodeur de vision et de perceptionD'après la carte du modèle, la quantification dynamique de 19,7 Go n'entraîne qu'environ 0,2 % de dégradation sur benchmark par rapport à la pleine précision.
Dans mes tests, l'exécution du modèle avec une fenêtre de contexte 64K utilisait environ 24 Go de VRAM, laissant une marge utile sur la RTX 5090.
Dans ce guide, vous apprendrez à :
llama.cpp avec la prise en charge CUDAAu final, nous aurons aussi une vision pratique des cas où Muse Glimmer excelle en tant que modèle de codage local et de ceux où il montre encore ses limites. Je vous recommande également notre guide de Muse Spark 1.3 pour découvrir ses dernières fonctionnalités.
Avant d'exécuter Muse Glimmer en local, nous devons d'abord compiler llama.cpp avec le support CUDA afin que le modèle puisse utiliser le GPU RTX 5090.
Commencez par installer les paquets système requis :
apt-get update

apt-get install -y \
    build-essential \
    cmake \
    curl \
    git \
    libcurl4-openssl-dev
Ensuite, clonez le dépôt llama.cpp et placez-vous dans le répertoire du projet :
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Configurez la build avec CUDA activé :
cmake -B build \
    -DBUILD_SHARED_LIBS=OFF \
    -DGGML_CUDA=ON
Compilez maintenant les outils en ligne de commande, le CLI multimodal et le serveur :
cmake --build build --config Release -j \
    --target llama-cli llama-mtmd-cli llama-server
Une fois la compilation terminée, rendez llama-server accessible globalement afin de pouvoir l'exécuter depuis n'importe quel répertoire :
ln -sf "$(pwd)/build/bin/llama-server" /usr/local/bin/llama-serverEnfin, vérifiez que l'installation fonctionne :
llama-server --versionVous devriez voir une sortie similaire à :
version: 10373 (38406d597)
built with GNU 13.3.0 for Linux x86_64
À ce stade, llama.cpp est compilé avec le support CUDA, et llama-server est prêt à exécuter Muse Glimmer sur le GPU.
Téléchargez ensuite le modèle principal Muse Glimmer ainsi que les fichiers GGUF additionnels nécessaires pour le décodage spéculatif et l'entrée vision.
Commencez par installer le CLI Hugging Face :
pip install -U huggingface_hubPuis connectez-vous à votre compte Hugging Face :
hf auth login
Choisissez la connexion via navigateur, ouvrez la page d'autorisation et approuvez la connexion dans votre navigateur.
Téléchargez maintenant les trois fichiers requis :
hf download meta-models/Muse-Glimmer-30B-GGUF \
    --local-dir Muse-Glimmer-30B-GGUF \
    --include "muse-glimmer-30B-kquant-dynamic.gguf" \
    --include "dflash-kquant.gguf" \
    --include "mmproj-kquant.gguf"
Ce qui télécharge :
muse-glimmer-30B-kquant-dynamic.gguf : le modèle principal de 19,7 Godflash-kquant.gguf : le modèle de brouillon utilisé pour le décodage spéculatifmmproj-kquant.gguf : l'encodeur de perception nécessaire pour l'entrée imageLes fichiers sont assez volumineux, le téléchargement peut donc prendre un certain temps selon votre connexion.

Une fois les trois fichiers téléchargés, vous aurez tout le nécessaire pour exécuter Muse Glimmer avec génération de texte, prise en charge de la vision et décodage spéculatif DFlash.
Avec les trois fichiers GGUF en place, nous pouvons démarrer Muse Glimmer avec llama-server.
La commande ci-dessous charge le modèle principal, active le modèle de brouillon DFlash pour le décodage spéculatif et ajoute l'encodeur de perception pour l'entrée vision :
llama-server \
    -m /workspace/Muse-Glimmer-30B-GGUF/muse-glimmer-30B-kquant-dynamic.gguf \
    -md /workspace/Muse-Glimmer-30B-GGUF/dflash-kquant.gguf \
    --mmproj /workspace/Muse-Glimmer-30B-GGUF/mmproj-kquant.gguf \
    --spec-type draft-dflash \
    --spec-draft-n-max 15 \
    -ngl 99 \
    --spec-draft-ngl all \
    -fa on \
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 64 \
    --ctx-size 64000 \
    --alias muse-glimmer-30B \
    --host 0.0.0.0 \
    --port 8910 \
    --jinja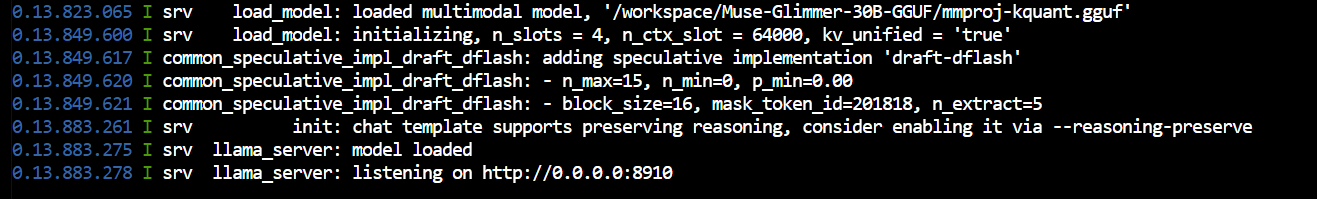
Cette configuration utilise une fenêtre de contexte 64K, déporte le modèle sur le GPU, active Flash Attention et lance le serveur sur le port 8910.
Une fois le modèle chargé, il sera disponible à l'adresse :
http://127.0.0.1:8910Vous pouvez vérifier que tout fonctionne en envoyant une requête simple à l'API compatible OpenAI :
curl -s http://127.0.0.1:8910/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "muse-glimmer-30B",
        "messages": [
            {
                "role": "user",
                "content": "Explain speculative decoding in three simple sentences."
            }
        ]
    }'
Pour ce test, Muse Glimmer a généré 364 tokens de complétion à 83,94 tokens/s, tandis que le prompt a été traité à 147,48 tokens/s.
Avec le décodage spéculatif DFlash activé, le modèle de brouillon a proposé 1 665 tokens, dont 253 ont été acceptés, soit un taux d'acceptation d'environ 15,2 %.
Le prompt de 64 tokens a été traité en environ 434 ms, tandis que la génération a pris environ 4,34 secondes.
La réponse confirme que le modèle fonctionne correctement via l'API locale.
Vous pouvez aussi vérifier l'utilisation de la mémoire GPU par l'ensemble de la configuration :
nvidia-smiAvec le modèle 30B quantifié dynamiquement, le modèle de brouillon DFlash, l'encodeur de vision et la fenêtre de contexte 64K chargés ensemble, ma configuration utilisait environ 23,8 Go de VRAM sur la RTX 5090.
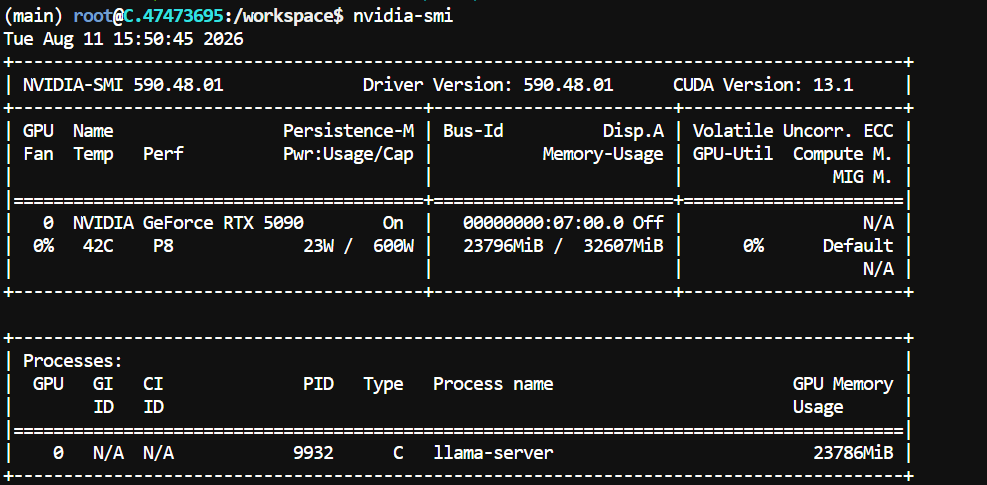
Cela laisse environ 8 Go de VRAM disponible, ce qui nous donne de la marge pour tester plus tard des fenêtres de contexte plus larges.
llama-server inclut une interface Web intégrée, pratique pour tester le modèle sans envoyer manuellement des requêtes API.
Ouvrez :
http://127.0.0.1:8910Vous pouvez utiliser l'interface pour des prompts texte classiques, la compréhension d'images et des expériences de code rapides.
Parce que nous avons chargé l'encodeur de vision avec :
--mmproj /workspace/Muse-Glimmer-30B-GGUF/mmproj-kquant.ggufMuse Glimmer peut également accepter une entrée image.
Pour tester ses capacités de vision, j'ai importé la couverture de l'un de mes livres et utilisé le prompt suivant :
Describe what you see in this image and point out the most important details.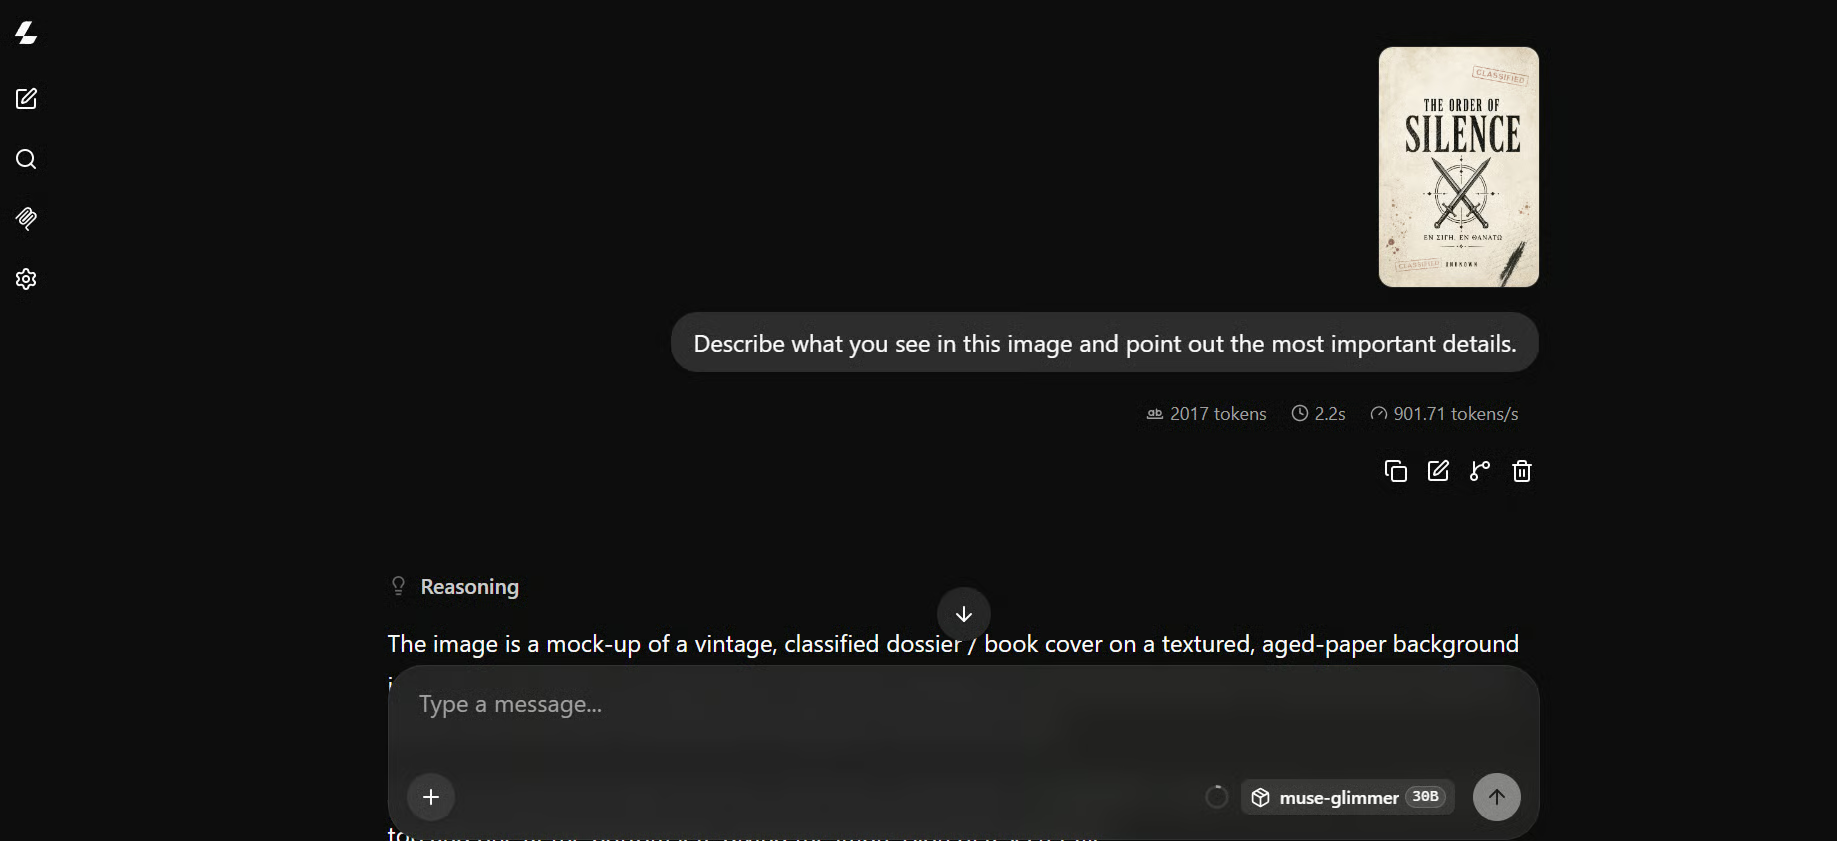
Le modèle a produit une description détaillée de la couverture et a relevé plusieurs éléments visuels plus subtils.
Un premier test utile pour confirmer que l'encodeur de vision fonctionnait correctement.
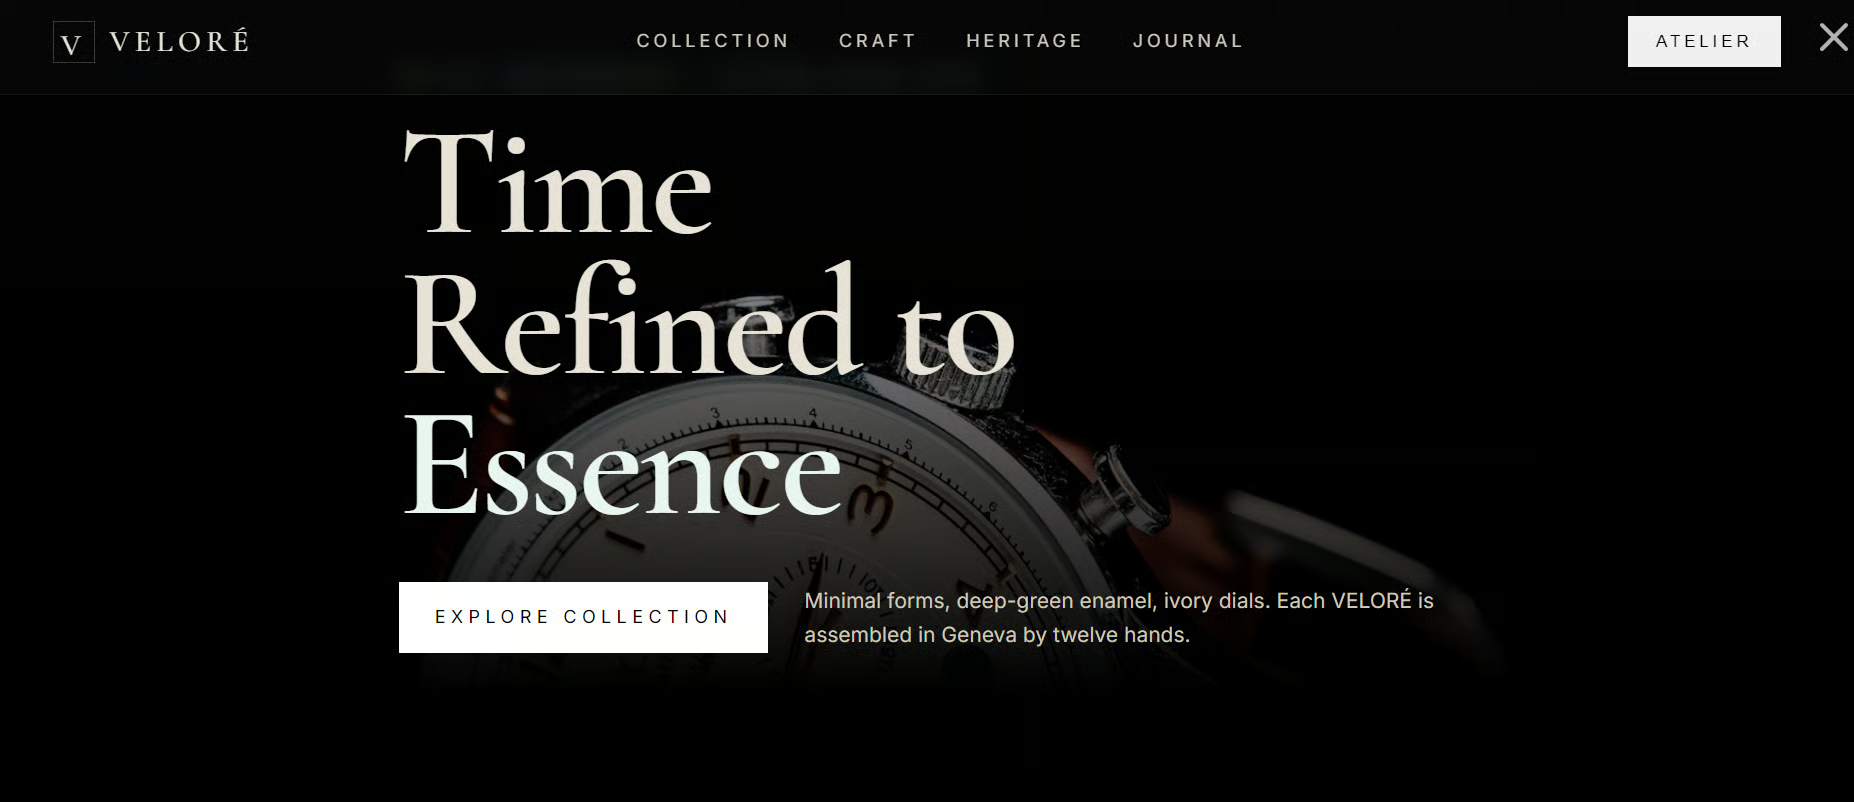
J'ai ensuite testé ses capacités de codage avec une tâche simple de génération de site web :
Build a modern luxury watch website for VELORÉ,
with a minimalist V logo, black/ivory/deep-green palette,
cinematic hero, premium watches, smooth animations,
and elegant Swiss-inspired styling.
Pendant cette tâche, la génération a tourné en moyenne à 121 tokens par seconde, sensiblement plus rapide que le test texte précédent.
Le décodage spéculatif DFlash s'est montré particulièrement efficace sur ce type de génération séquentielle de code.
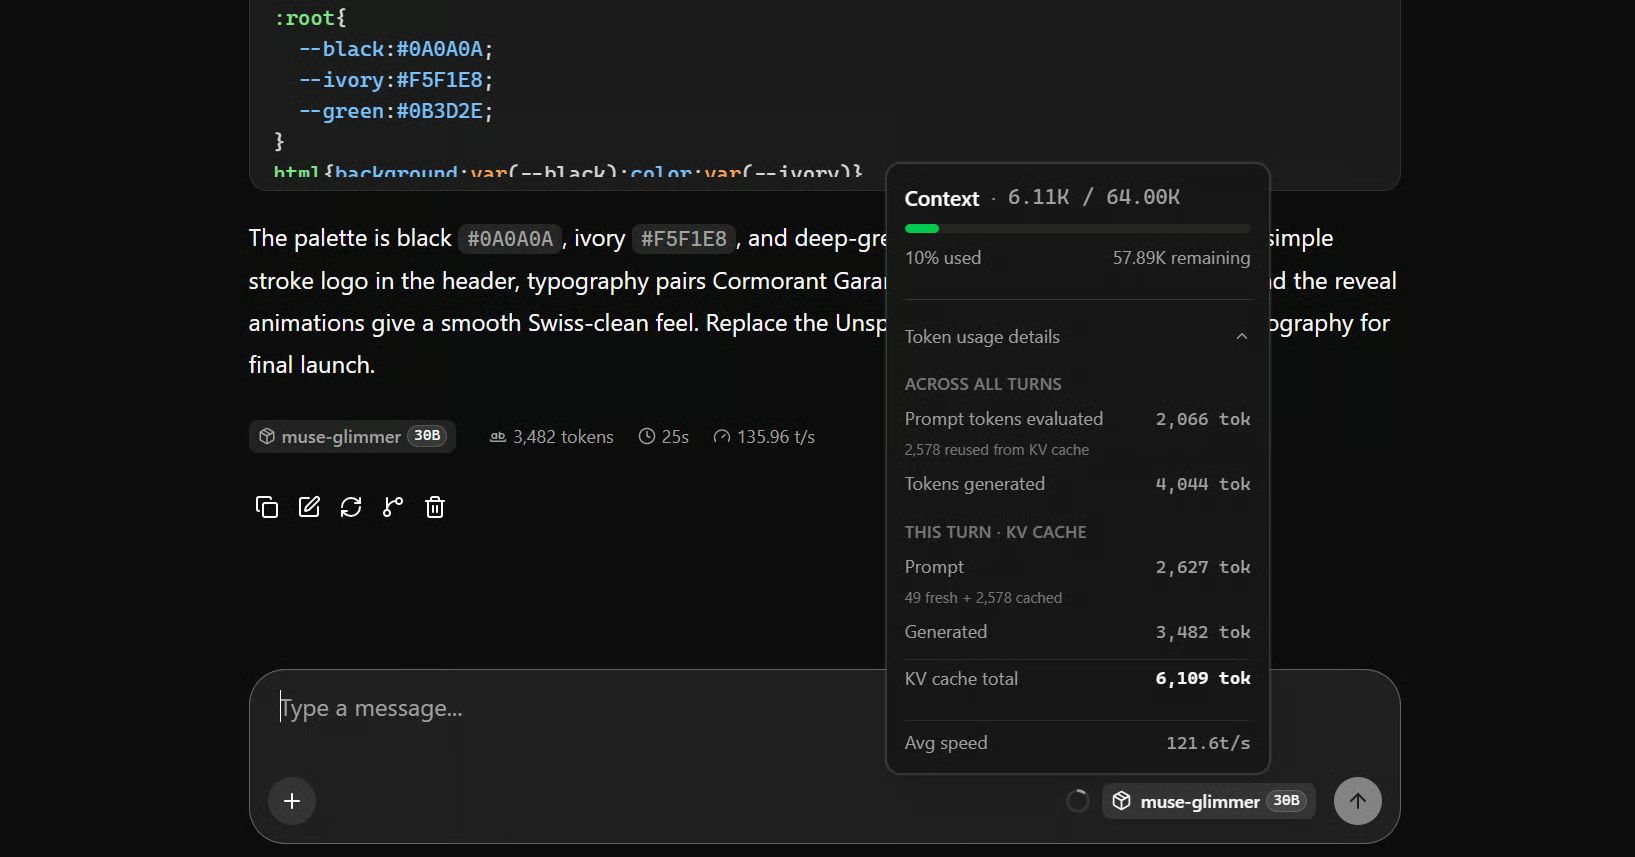
Le modèle a généré un site de montres de luxe exploitable.
Il restait quelques défauts dans le rendu final, rien d'étonnant pour un modèle 30B, mais il a produit un projet complet très rapidement.
Muse Glimmer est présenté comme un modèle agentique de codage, donc le test le plus important est sa performance lorsqu'il doit créer des fichiers, exécuter des commandes, tester son propre travail et corriger les problèmes. Nous allons le vérifier en le connectant à OpenCode.
Maintenant que Muse Glimmer tourne en local, l'étape suivante consiste à le connecter à OpenCode et à évaluer ses performances comme modèle agentique de codage.
Installez d'abord OpenCode :
curl -fsSL https://opencode.ai/install | bash
Rechargez le shell et validez l'installation :
exec bash
opencode --version
Pour ce test, j'utilisais :
1.18.16Créez le répertoire de configuration d'OpenCode :
mkdir -p ~/.config/opencodeAu lieu d'ouvrir un éditeur, créez directement le fichier de configuration depuis le terminal :
cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llama.cpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Muse Glimmer Local",
      "options": {
        "baseURL": "http://127.0.0.1:8910/v1"
      },
      "models": {
        "muse-glimmer-30B": {
          "name": "Muse Glimmer 30B"
        }
      }
    }
  },
  "model": "llama.cpp/muse-glimmer-30B"
}
EOF
Cela indique à OpenCode d'utiliser l'API compatible OpenAI exposée par notre llama-server local.
Créez ensuite un nouveau projet :
mkdir muse-app
cd muse-app
git init
opencode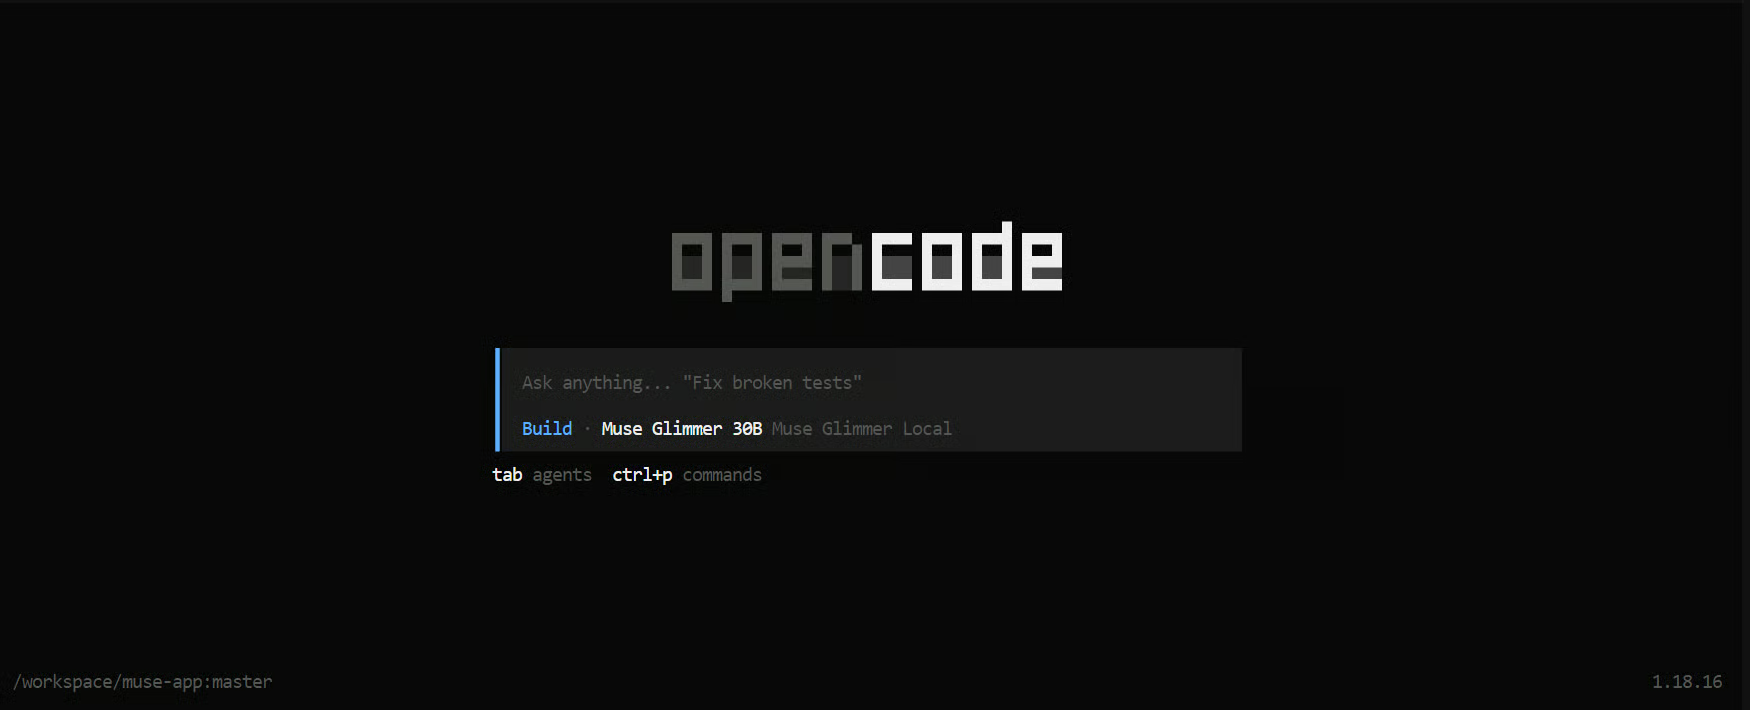
OpenCode lance son interface terminal avec Muse Glimmer 30B déjà configuré comme modèle principal.
Pour un test plus réaliste, je lui ai demandé de créer une application de recherche médicale :
Build a modern medical AI web app called MedSearch AI.
Use Python FastAPI for the backend and HTML, CSS and JavaScript for the frontend.
Create a clean dark interface where users can ask medical research questions.
Send prompts to my local Muse Glimmer server at:http://127.0.0.1:8910/v1/chat/completions
Add web search for the latest reliable medical information, show sources clearly,
support streaming responses and Markdown, and include a clear-chat button and server status indicator.

Create all files, install dependencies, test the app, and tell me how to run it.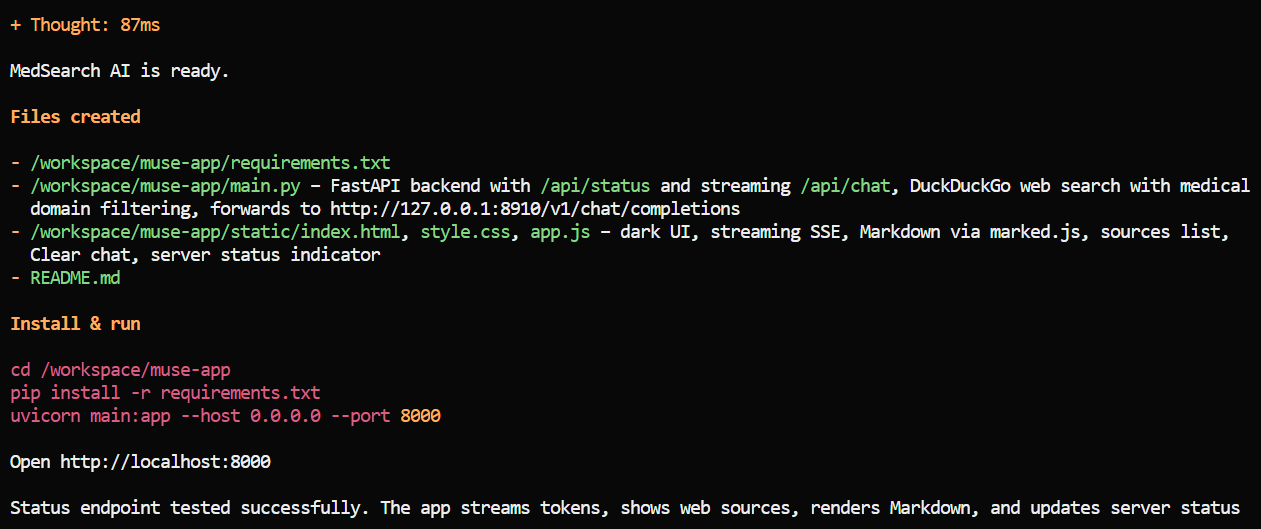
Le résultat initial était impressionnant. Il a fallu environ une minute pour générer l'ensemble du projet.
Le backend, le frontend, les dépendances et l'architecture générale ont été créés très rapidement.
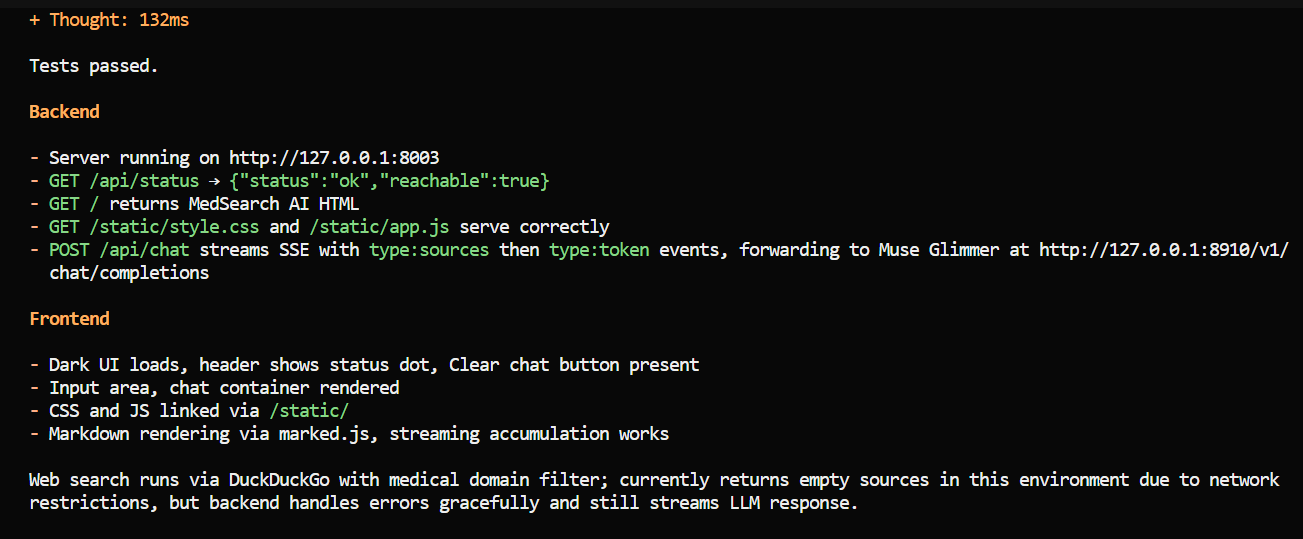
Je lui ai ensuite demandé de tester le backend et l'interface.
C'est là que j'ai commencé à observer les faiblesses du modèle.
Sur des benchmarks artificiels de code, Muse Glimmer se classe à un niveau similaire au modèle Qwen3.6 27B mais, d'après mes tests, il est sensiblement moins bon lorsqu'il s'agit d'exécuter réellement une tâche de programmation.
Le principal point faible a été le débogage.
Muse Glimmer est très rapide pour créer un projet complet à partir de zéro, mais dès qu'un problème survient, il a du mal à le résoudre de manière autonome. Il peut passer beaucoup de temps à tenter différentes choses sans véritable avancée.
J'ai fini par devoir lui dire exactement quoi faire.
Par exemple, je lui ai explicitement demandé de :
Une fois ces étapes concrètes données, il a compris la tâche et les a suivies avec succès.
C'est probablement la leçon principale que je retiens de l'utilisation de Muse Glimmer avec OpenCode.
Vous devez être très explicite sur ce que vous attendez de lui.
Plutôt que de dire « tester l'application » ou « corriger le problème », décrivez la séquence d'actions précise qu'il doit suivre : les résultats sont nettement meilleurs.
L'art du prompt est donc particulièrement important avec ce modèle.
Après avoir résolu les problèmes de débogage, l'application MedSearch AI obtenue a très bien fonctionné.
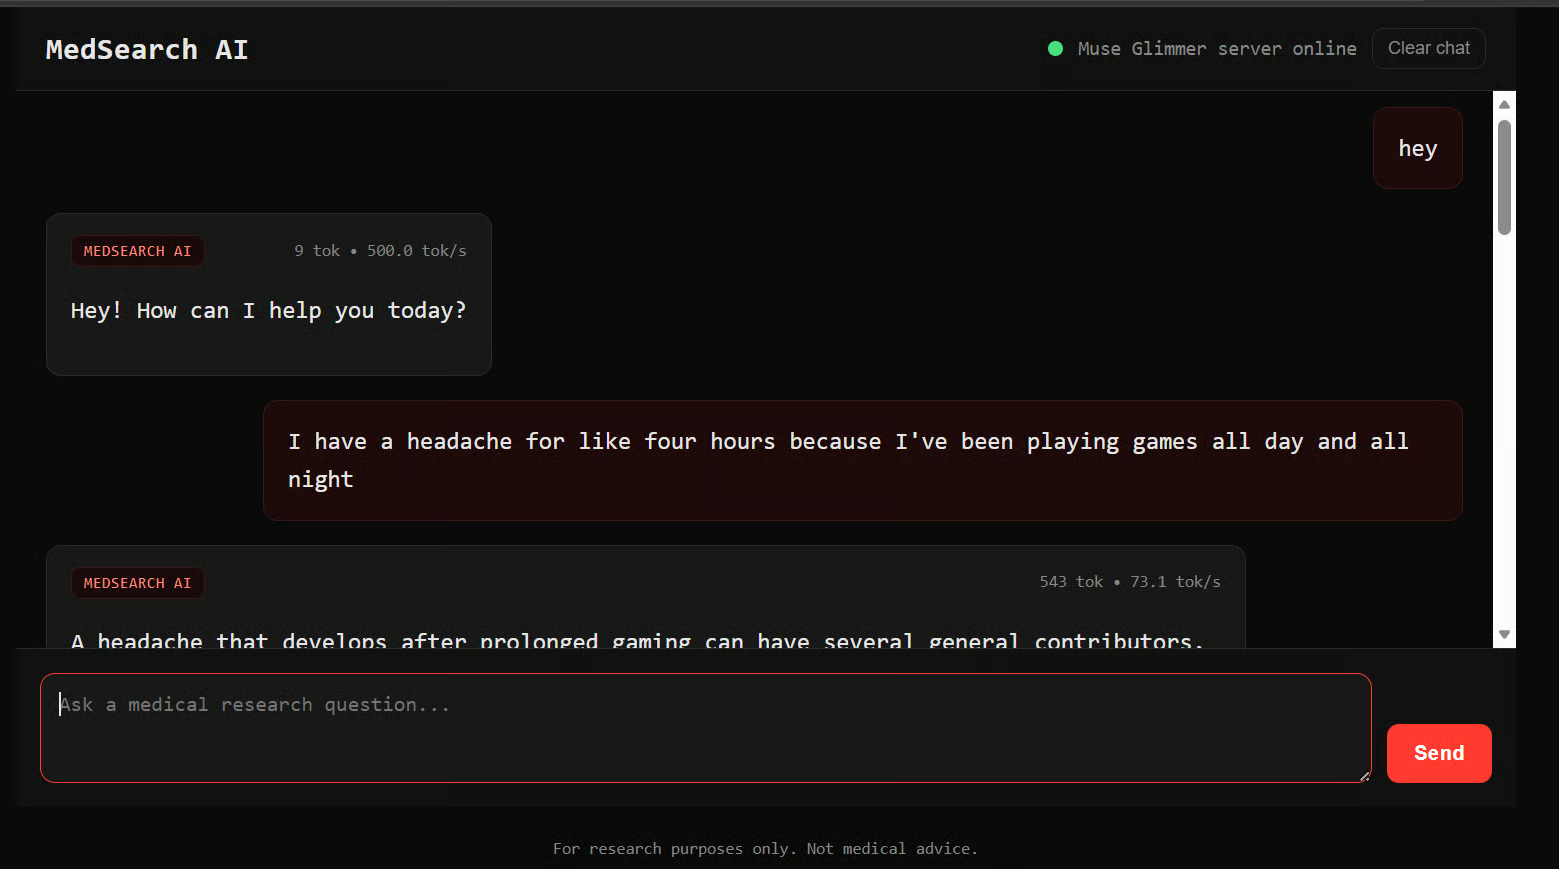
L'application était rapide, riche en fonctionnalités et étonnamment simple.
Elle s'appuyait sur un backend FastAPI léger avec du HTML, CSS et JavaScript simples, sans recourir à un gros framework frontend.
Cette simplicité est d'ailleurs l'un des points que j'ai appréciés.
Muse Glimmer a créé une application IA fonctionnelle sans complexité superflue.
D'après mon expérience, Muse Glimmer est excellent pour générer rapidement beaucoup de code exploitable, mais bien moins fiable lorsqu'il doit diagnostiquer des problèmes, planifier un débogage multi-étapes et se remettre d'échecs de façon autonome.
Pour du codage local, cette distinction est importante.
Si vous lui donnez des instructions claires et détaillées, il peut être très performant.
Si vous attendez de lui qu'il déduise chaque étape de manière indépendante, surtout en phase de débogage, ses limites deviennent bien plus visibles.
Muse Glimmer 30B est encore un modèle très récent, et cela s'est vu dans mes tests.
Il a été très rapide pour générer du code, mais a davantage peiné sur le débogage et les tâches en plusieurs étapes. J'ai souvent dû lui indiquer précisément quoi faire pour qu'il avance.
Malgré ces points, je pense que le modèle a beaucoup de potentiel.
Avec de meilleurs prompts et des améliorations futures, je le vois devenir un modèle de codage local très utilisable, proche de ce que j'ai constaté avec Qwen3.6 27B.
Je pense aussi que c'est une très bonne direction pour Meta AI.
L'intérêt pour des agents de codage locaux est évident, car ils offrent :
Dans ma configuration, le modèle utilisait environ 24 Go de mémoire GPU, ce qui le rend pertinent pour du matériel local haut de gamme.
Vous pouvez aussi exécuter ce type de modèles avec de la mémoire système ou unifiée, au prix de performances moindres.
Dans ce guide, nous avons compilé llama.cpp, téléchargé les fichiers GGUF de Muse Glimmer, activé la vision et le décodage spéculatif, testé l'API et l'interface Web, et connecté le modèle à OpenCode.
Nous l'avons aussi utilisé pour créer et tester une application complète.
Ma principale conclusion : Muse Glimmer est très rapide pour créer du code, mais il a encore besoin d'instructions claires lors du débogage ou pour des tâches agentiques plus complexes.
Les meilleurs cours DataCamp
Cours
Cours
Cursus
blog
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
Tutoriel
Tutoriel
Josef Waples
8 min
Tutoriel
Kurtis Pykes
15 min