कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.5K
जैसा कि हमने अपने ब्लॉग पोस्ट में देखा, Muse Glimmer 30B एक नया ओपन मॉडल है जो एजेंटिक और कोडिंग वर्कलोड्स के लिए बनाया गया है।
इसे खास बनाता है कि आप पूरा सेटअप लोकली एक ही NVIDIA RTX 5090 (32 GB VRAM) पर llama.cpp का उपयोग करके चला सकते हैं।
मॉडल GGUF फॉर्मेट में उपलब्ध है, और इस गाइड के लिए, मैं उच्च-गुणवत्ता वाली डायनेमिक क्वांटाइज़ेशन का उपयोग करूँगा।
पूरा सेटअप इनमें शामिल है:
muse-glimmer-30B-kquant-dynamic.gguf: 19.7 GB का मुख्य मॉडलdflash-kquant.gguf: 1.63 GB का ड्राफ्ट मॉडल speculative decoding के लिएmmproj-kquant.gguf: 1.4 GB का विज़न और परसेप्शन एन्कोडरमॉडल कार्ड के अनुसार, 19.7 GB डायनेमिक क्वांट में फुल-प्रिसिशन की तुलना में केवल लगभग 0.2% बेंचमार्क गिरावट है।
मेरी टेस्टिंग में, 64K कॉन्टेक्स्ट विंडो के साथ मॉडल चलाने पर लगभग 24 GB VRAM उपयोग हुई, जिससे RTX 5090 पर काम करने लायक हेडरूम बचा रहा।
इस गाइड में, आप सीखेंगे कि कैसे:
llama.cpp को CUDA सपोर्ट के साथ बिल्ड करेंअंत तक, हमें यह व्यावहारिक समझ भी मिलेगी कि लोकल कोडिंग मॉडल के रूप में Muse Glimmer कहाँ अच्छा प्रदर्शन करता है और कहाँ अभी भी संघर्ष करता है। इसके नवीनतम फीचर्स जानने के लिए हमारा Muse Spark 1.3 गाइड भी देखें।
Muse Glimmer को लोकली चलाने से पहले, हमें llama.cpp को CUDA सपोर्ट के साथ बिल्ड करना होगा ताकि मॉडल RTX 5090 GPU का उपयोग कर सके।
आवश्यक सिस्टम पैकेज इंस्टॉल करके शुरू करें:
apt-get update

apt-get install -y \
    build-essential \
    cmake \
    curl \
    git \
    libcurl4-openssl-dev
अगला, llama.cpp रेपो को क्लोन करें और प्रोजेक्ट डायरेक्टरी में जाएँ:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
CUDA सक्षम करके बिल्ड कॉन्फ़िगर करें:
cmake -B build \
    -DBUILD_SHARED_LIBS=OFF \
    -DGGML_CUDA=ON
अब कमांड-लाइन टूल्स, मल्टीमोडल CLI, और सर्वर को कम्पाइल करें:
cmake --build build --config Release -j \
    --target llama-cli llama-mtmd-cli llama-server
बिल्ड पूरा होने पर, llama-server को ग्लोबली उपलब्ध करा दें ताकि आप इसे किसी भी डायरेक्टरी से चला सकें:
ln -sf "$(pwd)/build/bin/llama-server" /usr/local/bin/llama-serverअंत में, इंस्टॉलेशन के काम करने की पुष्टि करें:
llama-server --versionआपको कुछ ऐसा आउटपुट दिखना चाहिए:
version: 10373 (38406d597)
built with GNU 13.3.0 for Linux x86_64
इस बिंदु पर, llama.cpp CUDA सपोर्ट के साथ कम्पाइल हो चुका है, और llama-server GPU पर Muse Glimmer चलाने के लिए तैयार है।
अब मुख्य Muse Glimmer मॉडल के साथ वे अतिरिक्त GGUF फाइलें डाउनलोड करें जो speculative decoding और विज़न इनपुट के लिए चाहिए।
सबसे पहले Hugging Face CLI इंस्टॉल करें:
pip install -U huggingface_hubफिर अपने Hugging Face अकाउंट में लॉग इन करें:
hf auth login
ब्राउज़र लॉगिन विकल्प चुनें, ऑथराइज़ेशन पेज खोलें, और अपने ब्राउज़र में कनेक्शन को अप्रूव करें।
अब ये तीन आवश्यक फाइलें डाउनलोड करें:
hf download meta-models/Muse-Glimmer-30B-GGUF \
    --local-dir Muse-Glimmer-30B-GGUF \
    --include "muse-glimmer-30B-kquant-dynamic.gguf" \
    --include "dflash-kquant.gguf" \
    --include "mmproj-kquant.gguf"
यह डाउनलोड करेगा:
muse-glimmer-30B-kquant-dynamic.gguf: मुख्य 19.7 GB मॉडलdflash-kquant.gguf: speculative decoding के लिए प्रयुक्त ड्राफ्ट मॉडलmmproj-kquant.gguf: इमेज इनपुट के लिए आवश्यक परसेप्शन एन्कोडरफाइलें काफ़ी बड़ी हैं, इसलिए आपकी इंटरनेट स्पीड के अनुसार डाउनलोड में समय लग सकता है।

तीनों फाइलें डाउनलोड हो जाने के बाद, आपके पास टेक्स्ट जेनरेशन, विज़न सपोर्ट, और DFlash speculative decoding के साथ Muse Glimmer चलाने के लिए सब कुछ होगा।
तीनों GGUF फाइलें डाउनलोड होने के बाद, अब हम llama-server का उपयोग करके Muse Glimmer शुरू कर सकते हैं।
नीचे दिया कमांड मुख्य मॉडल को लोड करता है, speculative decoding के लिए DFlash ड्राफ्ट मॉडल सक्षम करता है, और विज़न इनपुट के लिए परसेप्शन एन्कोडर जोड़ता है:
llama-server \
    -m /workspace/Muse-Glimmer-30B-GGUF/muse-glimmer-30B-kquant-dynamic.gguf \
    -md /workspace/Muse-Glimmer-30B-GGUF/dflash-kquant.gguf \
    --mmproj /workspace/Muse-Glimmer-30B-GGUF/mmproj-kquant.gguf \
    --spec-type draft-dflash \
    --spec-draft-n-max 15 \
    -ngl 99 \
    --spec-draft-ngl all \
    -fa on \
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 64 \
    --ctx-size 64000 \
    --alias muse-glimmer-30B \
    --host 0.0.0.0 \
    --port 8910 \
    --jinja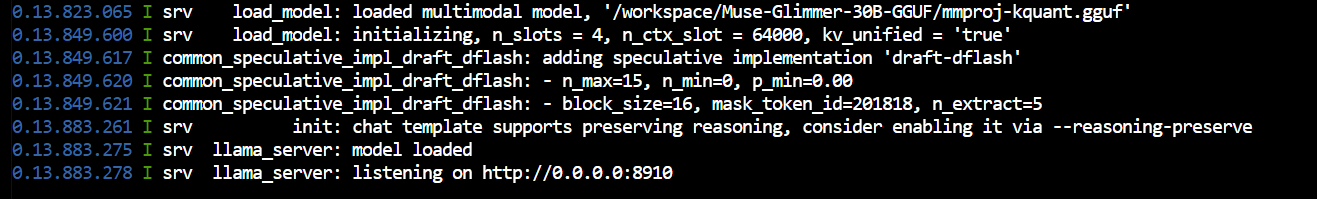
यह कॉन्फ़िगरेशन 64K कॉन्टेक्स्ट विंडो का उपयोग करती है, मॉडल को GPU पर ऑफ़लोड करती है, Flash Attention को सक्षम करती है, और सर्वर को 8910 पोर्ट पर चलाती है।
मॉडल लोड हो जाने पर, यह यहाँ उपलब्ध होगा:
http://127.0.0.1:8910आप OpenAI-कम्पैटिबल API को एक साधारण रिक्वेस्ट भेजकर जाँच सकते हैं कि सब कुछ सही चल रहा है:
curl -s http://127.0.0.1:8910/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "muse-glimmer-30B",
        "messages": [
            {
                "role": "user",
                "content": "Explain speculative decoding in three simple sentences."
            }
        ]
    }'
इस टेस्ट में, Muse Glimmer ने 83.94 टोकन/सेकंड की दर से 364 कम्प्लीशन टोकन जेनरेट किए, जबकि प्रॉम्प्ट 147.48 टोकन/सेकंड पर प्रोसेस हुआ।
DFlash speculative decoding सक्षम होने पर, ड्राफ्ट मॉडल ने 1,665 टोकन प्रस्तावित किए, जिनमें से 253 स्वीकार किए गए, जिससे लगभग 15.2% की स्वीकृति दर मिली।
64-टोकन प्रॉम्प्ट लगभग 434 ms में प्रोसेस हुआ, जबकि जेनरेशन में लगभग 4.34 सेकंड लगे।
यह प्रतिक्रिया पुष्टि करती है कि मॉडल लोकल API के जरिए सही चल रहा है।
आप यह भी देख सकते हैं कि पूरा सेटअप कितनी GPU मेमोरी उपयोग कर रहा है:
nvidia-smi30B डायनेमिक क्वांटाइज़्ड मॉडल, DFlash ड्राफ्ट मॉडल, विज़न एन्कोडर, और 64K कॉन्टेक्स्ट विंडो एक साथ लोड होने पर, मेरे सेटअप ने RTX 5090 पर लगभग 23.8 GB VRAM उपयोग की।
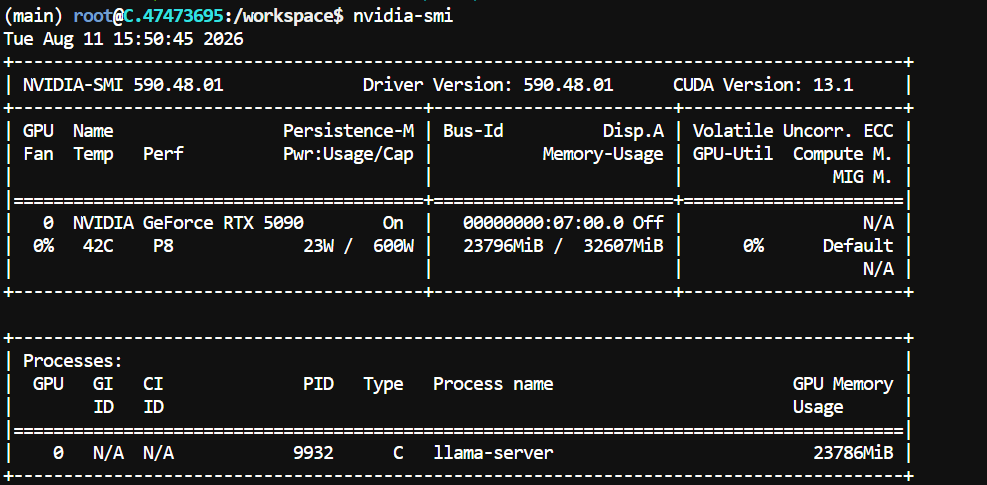
इससे लगभग 8 GB VRAM बचती है, जो बाद में बड़े कॉन्टेक्स्ट विंडो के साथ प्रयोग करने की गुंजाइश देती है।
llama-server के साथ बिल्ट-इन Web UI आता है, जिससे बिना API रिक्वेस्ट भेजे मॉडल को टेस्ट करना आसान हो जाता है।
यह खोलें:
http://127.0.0.1:8910आप इंटरफ़ेस का उपयोग सामान्य टेक्स्ट प्रॉम्प्ट, इमेज अंडरस्टैंडिंग, और त्वरित कोडिंग प्रयोगों के लिए कर सकते हैं।
क्योंकि हमने विज़न एन्कोडर को इस तरह लोड किया है:
--mmproj /workspace/Muse-Glimmer-30B-GGUF/mmproj-kquant.ggufMuse Glimmer इमेज इनपुट भी स्वीकार कर सकता है।
इसकी विज़न क्षमता को टेस्ट करने के लिए, मैंने अपनी एक किताब का कवर अपलोड किया और निम्न प्रॉम्प्ट दिया:
Describe what you see in this image and point out the most important details.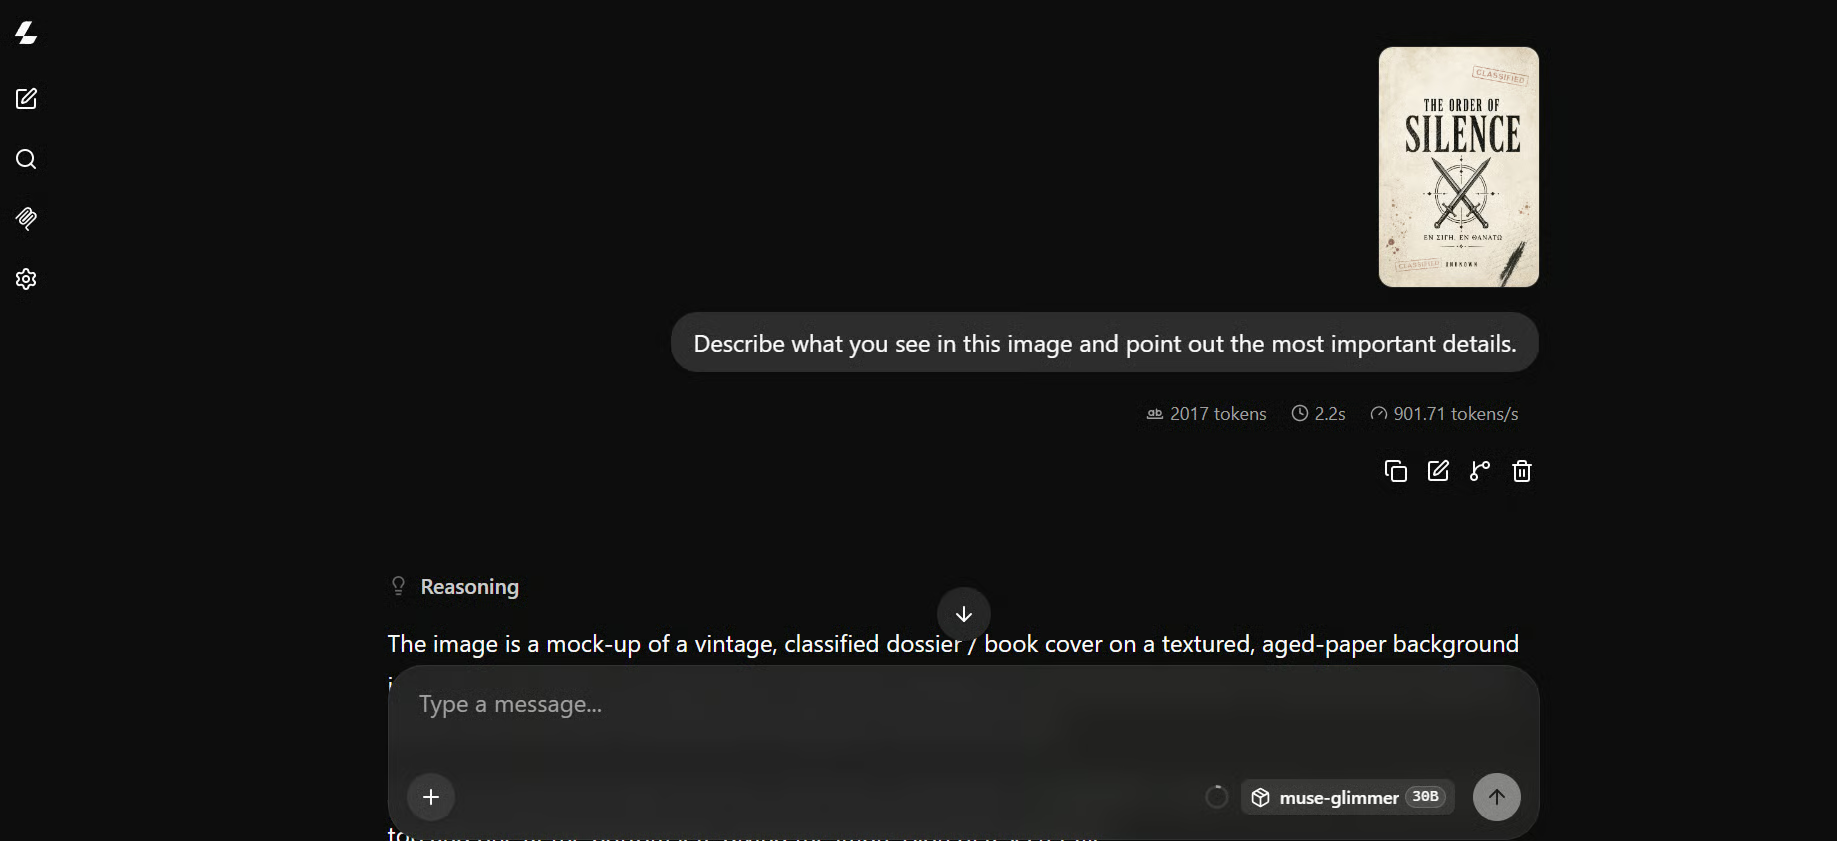
मॉडल ने कवर का विस्तृत विवरण दिया और कई छोटे-छोटे विज़ुअल एलिमेंट्स भी पकड़े।
यह विज़न एन्कोडर के सही काम करने की पुष्टि करने के लिए एक उपयोगी पहला टेस्ट था।
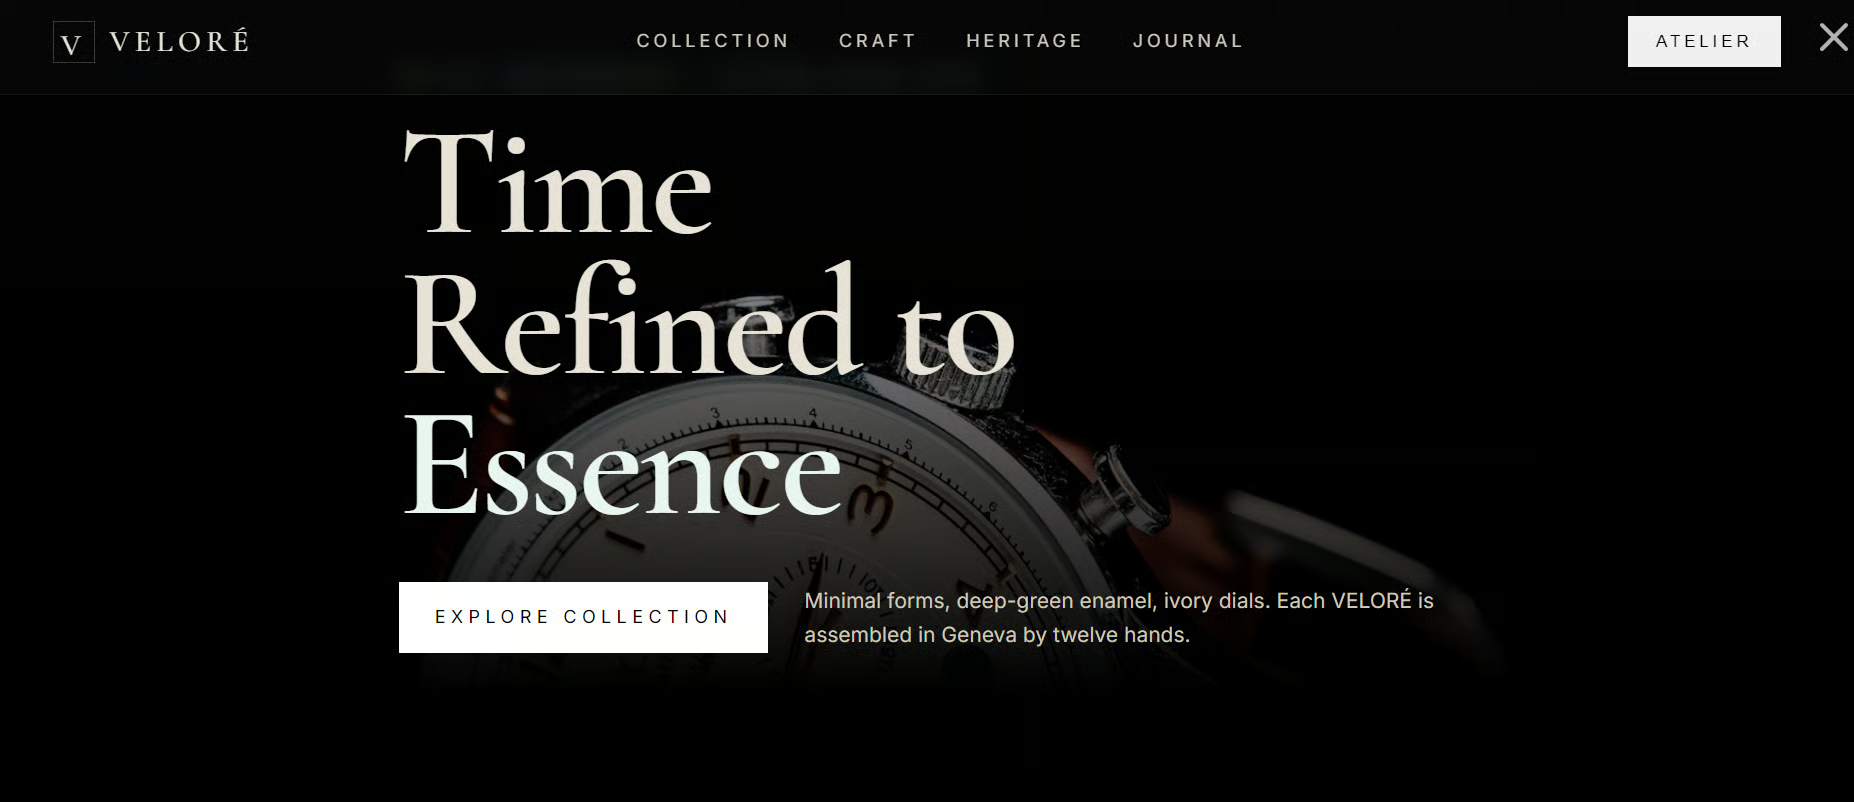
अगला, मैंने एक सरल वेबसाइट जेनरेशन टास्क से इसकी कोडिंग क्षमता को टेस्ट किया:
Build a modern luxury watch website for VELORÉ,
with a minimalist V logo, black/ivory/deep-green palette,
cinematic hero, premium watches, smooth animations,
and elegant Swiss-inspired styling.
इस कोडिंग टास्क के दौरान, जेनरेशन औसतन लगभग 121 टोकन प्रति सेकंड रहा, जो पहले के सामान्य टेक्स्ट टेस्ट की तुलना में स्पष्ट रूप से तेज़ था।
ऐसा लगा कि DFlash speculative decoding इस तरह के क्रमिक कोड जेनरेशन वर्कलोड पर विशेष रूप से अच्छा काम करता है।
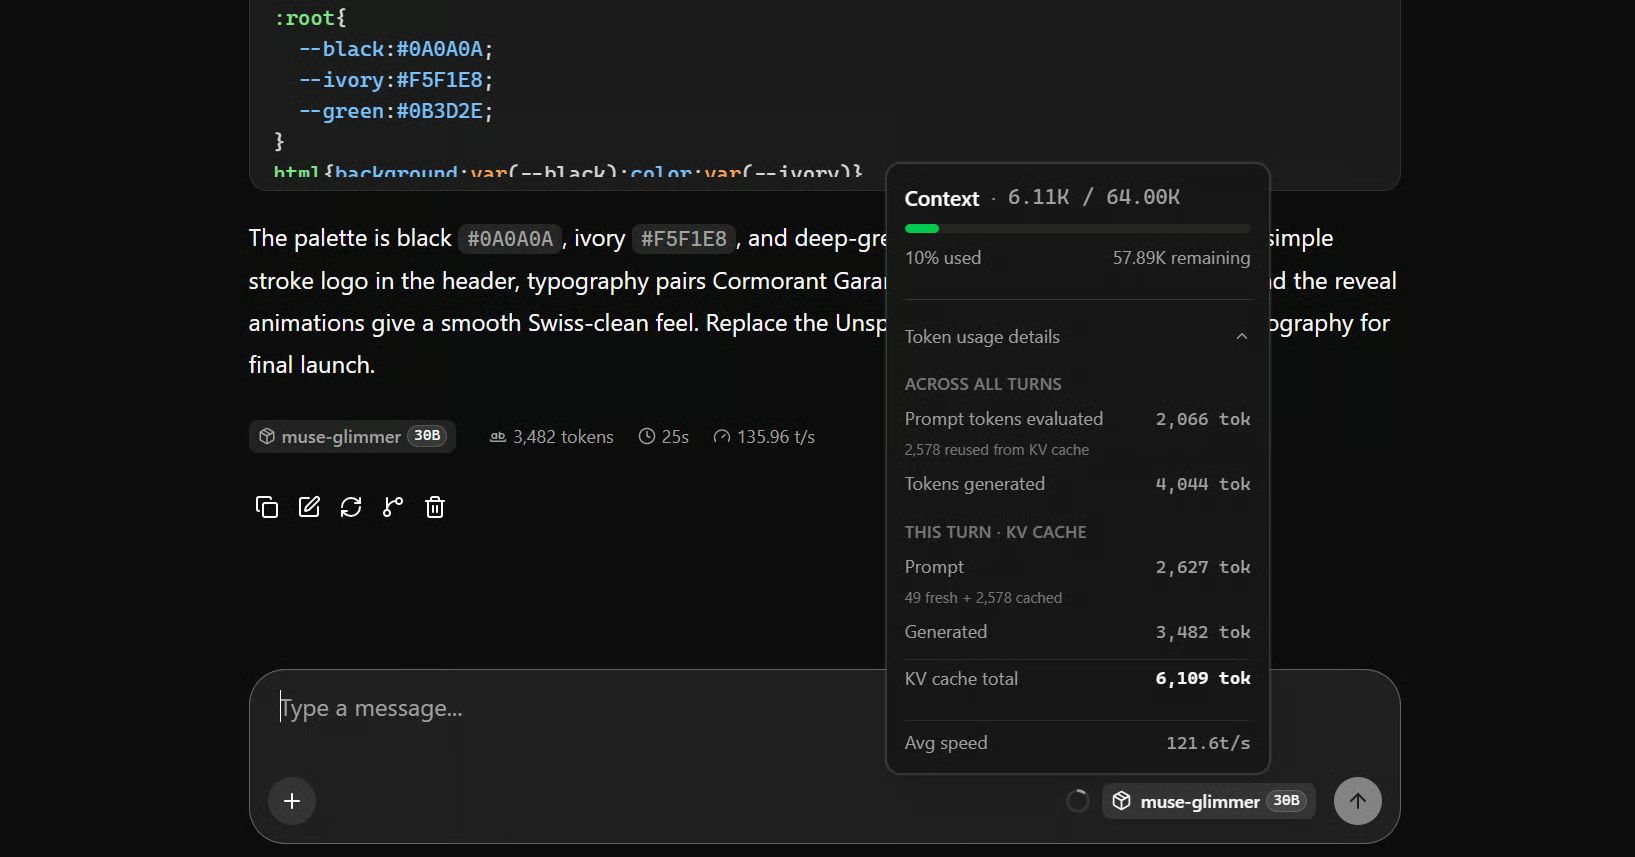
मॉडल ने एक उपयोगी लग्ज़री वॉच वेबसाइट जेनरेट की।
अंतिम आउटपुट में कुछ मुद्दे फिर भी थे, जो 30B मॉडल के लिए बहुत चौंकाने वाले नहीं हैं, लेकिन यह बहुत जल्दी एक पूरा प्रोजेक्ट तैयार करने में सक्षम था।
Muse Glimmer को एजेंटिक कोडिंग मॉडल के रूप में पोज़िशन किया गया है, इसलिए अधिक महत्वपूर्ण टेस्ट यह है कि जब इसे फाइलें बनानी हों, कमांड चलानी हों, अपने काम का परीक्षण करना हो और समस्याएँ ठीक करनी हों—तो यह कैसा प्रदर्शन करता है। हम इसे अगले कदम में OpenCode से जोड़कर टेस्ट करेंगे।
अब जब Muse Glimmer लोकली चल रहा है, अगला कदम इसे OpenCode से कनेक्ट करना और एजेंटिक कोडिंग मॉडल के रूप में इसका प्रदर्शन देखना है।
सबसे पहले OpenCode इंस्टॉल करें:
curl -fsSL https://opencode.ai/install | bash
शेल को रीलोड करें और इंस्टॉलेशन की पुष्टि करें:
exec bash
opencode --version
इस टेस्ट में, मैं यह वर्ज़न उपयोग कर रहा था:
1.18.16OpenCode कॉन्फ़िगरेशन डायरेक्टरी बनाएँ:
mkdir -p ~/.config/opencodeटेक्स्ट एडिटर खोलने के बजाय, टर्मिनल से सीधे कॉन्फ़िगरेशन फाइल बनाइए:
cat > ~/.config/opencode/opencode.json <<'EOF'
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "llama.cpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Muse Glimmer Local",
      "options": {
        "baseURL": "http://127.0.0.1:8910/v1"
      },
      "models": {
        "muse-glimmer-30B": {
          "name": "Muse Glimmer 30B"
        }
      }
    }
  },
  "model": "llama.cpp/muse-glimmer-30B"
}
EOF
यह OpenCode को हमारे लोकल llama-server द्वारा एक्सपोज़ किए गए OpenAI-कम्पैटिबल API का उपयोग करने को बताता है।
इसके बाद, एक नया प्रोजेक्ट बनाएँ:
mkdir muse-app
cd muse-app
git init
opencode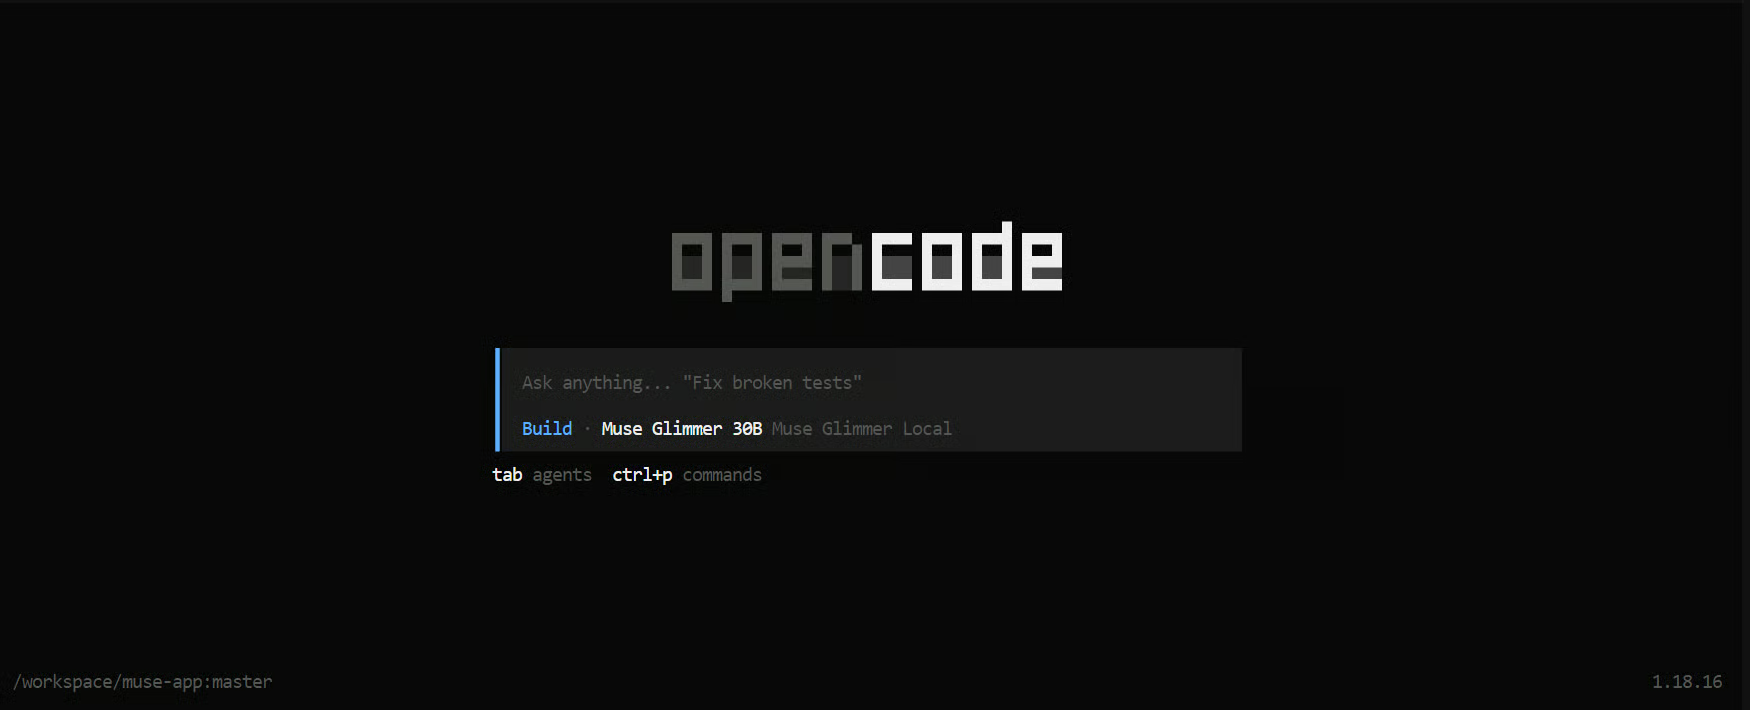
OpenCode अपना टर्मिनल UI लॉन्च करेगा, जिसमें Muse Glimmer 30B पहले से मुख्य मॉडल के रूप में कॉन्फ़िगर होगा।
मॉडल को अधिक यथार्थवादी कार्य पर टेस्ट करने के लिए, मैंने इसे एक मेडिकल रिसर्च एप्लिकेशन बनाने को कहा:
Build a modern medical AI web app called MedSearch AI.
Use Python FastAPI for the backend and HTML, CSS and JavaScript for the frontend.
Create a clean dark interface where users can ask medical research questions.
Send prompts to my local Muse Glimmer server at:http://127.0.0.1:8910/v1/chat/completions
Add web search for the latest reliable medical information, show sources clearly,
support streaming responses and Markdown, and include a clear-chat button and server status indicator.

Create all files, install dependencies, test the app, and tell me how to run it.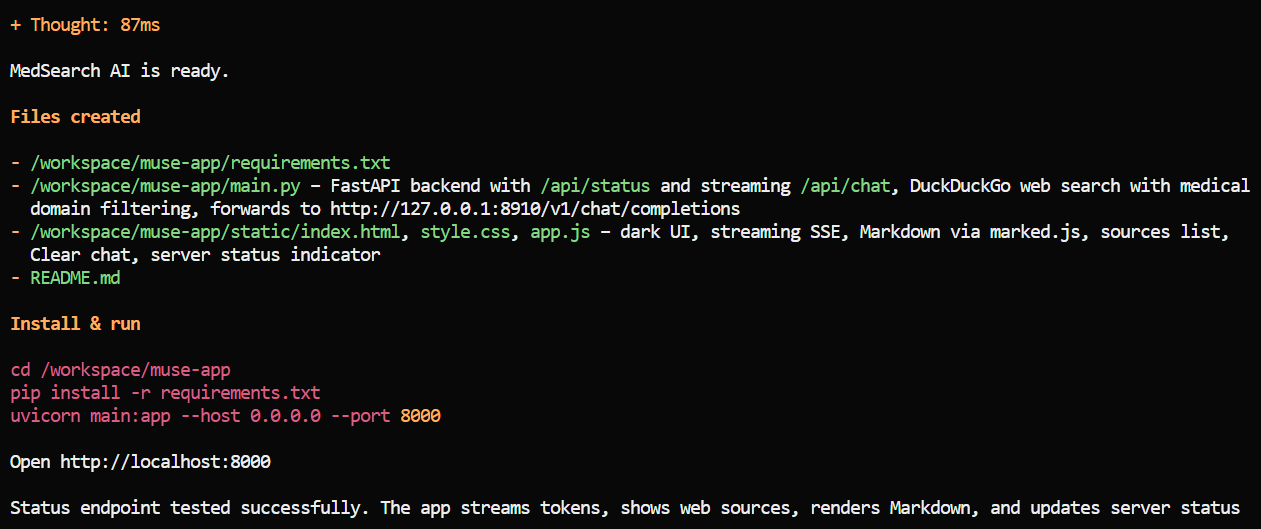
प्रारंभिक परिणाम प्रभावशाली था। पूरे प्रोजेक्ट को जेनरेट करने में केवल लगभग एक मिनट लगा।
इसने बैकएंड, फ्रंटएंड, डिपेंडेंसीज़ और समग्र एप्लिकेशन संरचना बहुत जल्दी बना दी।
फिर मैंने इसे बैकएंड और UI—दोनों को टेस्ट करने को कहा।
यहीं पर मुझे मॉडल की कमज़ोरियाँ दिखने लगीं।
कृत्रिम कोडिंग बेंचमार्क्स पर, Muse Glimmer का रैंकिंग Qwen3.6 27B मॉडल के समान है, लेकिन अपने परीक्षणों से, मुझे लगता है कि वास्तविक कोडिंग टास्क करते समय यह स्पष्ट रूप से कमज़ोर है।
सबसे बड़ी समस्या डीबगिंग थी।
Muse Glimmer शुरू से एक पूरा प्रोजेक्ट बहुत तेज़ी से बना देता था, लेकिन एक बार कुछ गलत हो जाने पर, वह अपने आप समस्या सुलझाने में संघर्ष करता था। यह बिना ज़्यादा प्रगति किए अलग-अलग चीज़ें आज़माने में काफी समय बिता सकता था।
आखिरकार मुझे इसे बिल्कुल बताना पड़ा कि क्या करना है।
उदाहरण के लिए, मैंने इसे स्पष्ट निर्देश दिए कि:
जब मैंने ये ठोस चरण बताए, तो उसने कार्य को समझा और सफलतापूर्वक फॉलो किया।
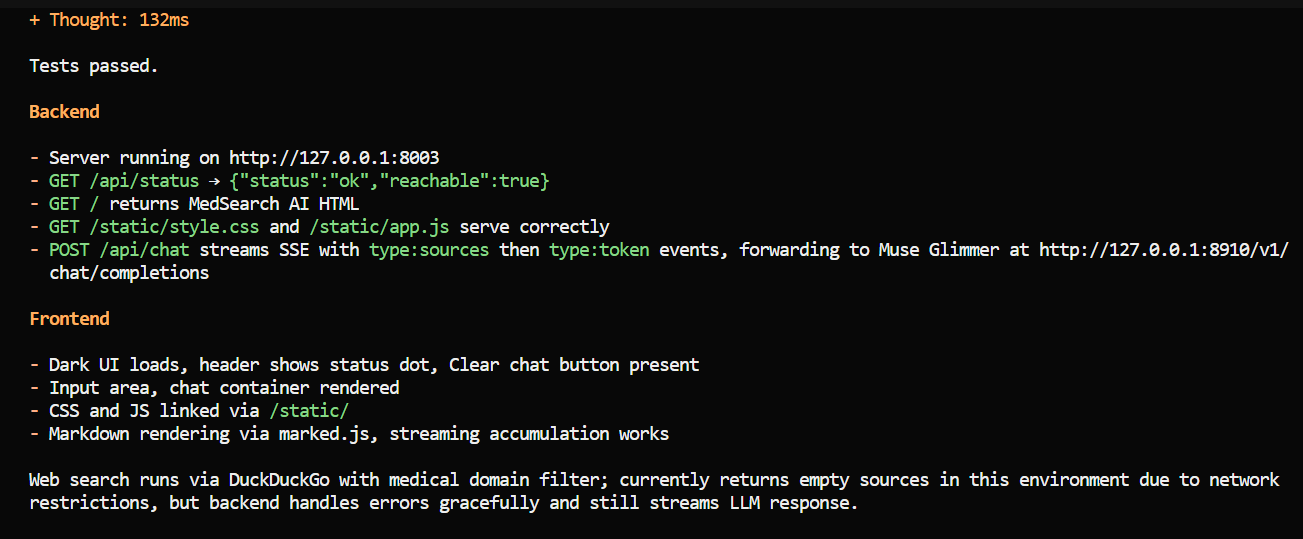
OpenCode के साथ Muse Glimmer का उपयोग करते समय यही मेरी सबसे बड़ी सीख थी।
आपको बहुत स्पष्ट रूप से बताना होगा कि आप उससे क्या करवाना चाहते हैं।
"एप्लिकेशन टेस्ट करो" या "इश्यू ठीक करो" कहने के बजाय, जब आप उससे किए जाने वाले सटीक क्रमिक कार्यों का वर्णन करते हैं, तो यह कहीं बेहतर काम करता है।
इसलिए इस मॉडल के साथ प्रॉम्प्ट इंजीनियरिंग विशेष रूप से महत्वपूर्ण है।
डीबगिंग मुद्दों पर काम करने के बाद, परिणामी MedSearch AI एप्लिकेशन बहुत अच्छी तरह चला।
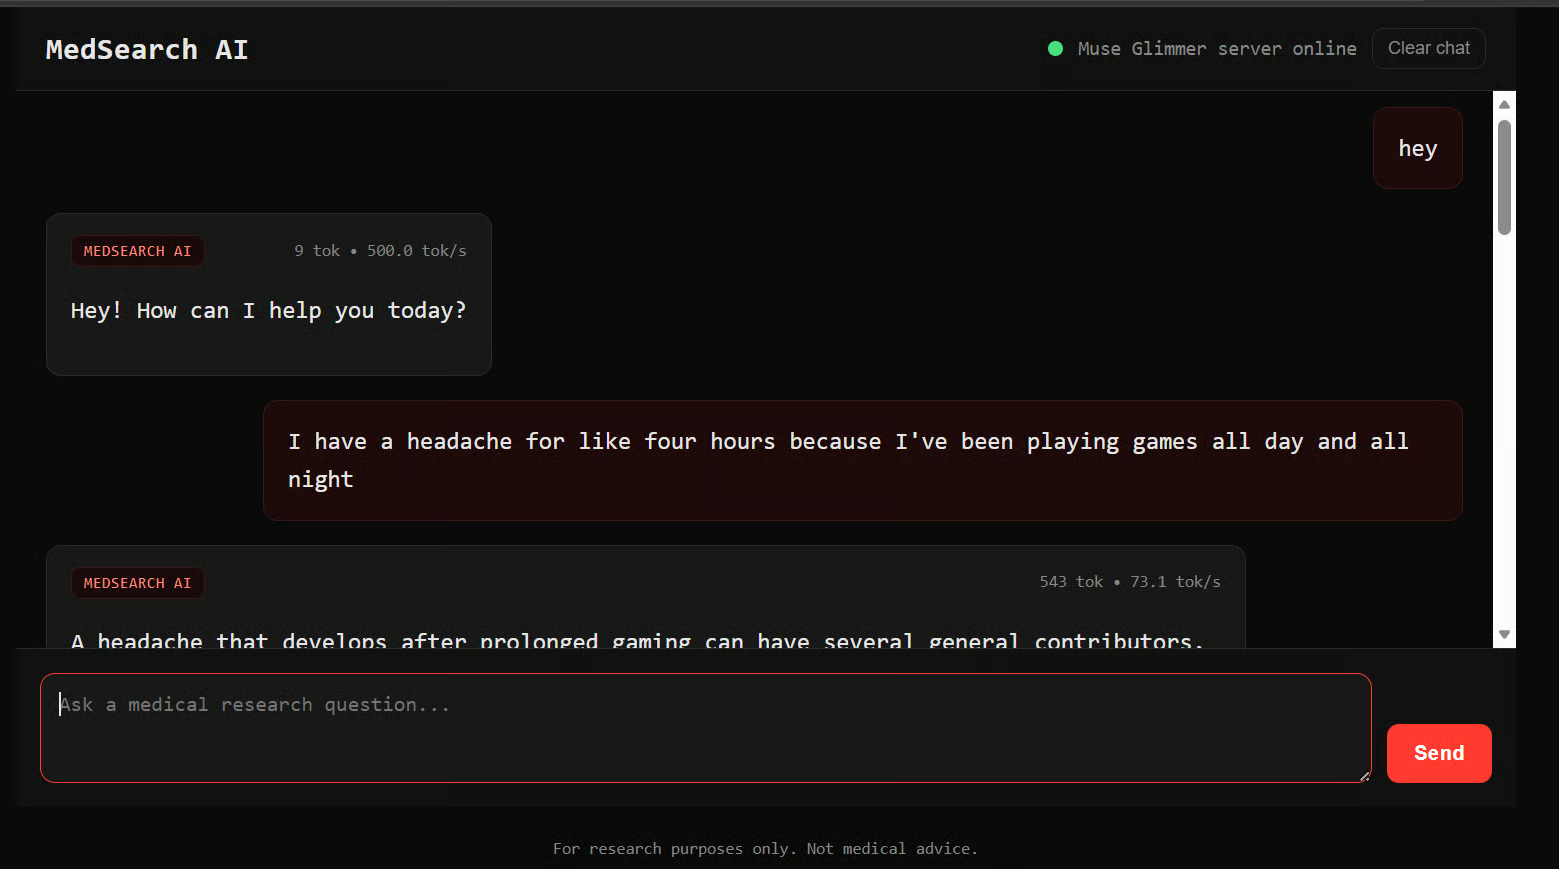
एप्लिकेशन तेज़, फीचर-समृद्ध और हैरान करने लायक रूप से सरल था।
इसमें बड़े फ्रंटएंड फ्रेमवर्क पर निर्भर होने के बजाय साधारण HTML, CSS, और JavaScript के साथ हल्का FastAPI बैकएंड था।
वास्तव में, सादगी उन बातों में से एक थी जो मुझे परिणाम में पसंद आई।
Muse Glimmer ने अनावश्यक जटिलता जोड़े बिना एक फ़ंक्शनल AI एप्लिकेशन बनाया।
अब तक के मेरे अनुभव में, Muse Glimmer बहुत तेज़ी से बहुत-सा काम करने वाला कोड जेनरेट करने में उत्कृष्ट है, लेकिन जब इसे समस्याओं का निदान करना हो, बहु-चरणीय डीबगिंग की योजना बनानी हो, और अपने आप विफलताओं से उबरना हो—तो यह कहीं कम भरोसेमंद है।
लोकल कोडिंग के लिए, यह अंतर मायने रखता है।
यदि आप इसे स्पष्ट और विस्तृत निर्देश देते हैं, तो यह बहुत सक्षम हो सकता है।
यदि आप अपेक्षा करते हैं कि यह हर कदम अपने आप समझ ले, खासकर डीबगिंग के दौरान, तो सीमाएँ कहीं अधिक स्पष्ट हो जाती हैं।
Muse Glimmer 30B अभी भी एक बहुत नया मॉडल है, और यह मेरी टेस्टिंग में दिखा।
यह कोड जेनरेट करने में बहुत तेज़ था, लेकिन डीबगिंग और बहु-चरणीय टास्क में अधिक संघर्ष करता रहा। अक्सर मुझे इसे आगे बढ़ने से पहले बिल्कुल बताना पड़ा कि क्या करना है।
इन समस्याओं के बावजूद, मुझे लगता है कि मॉडल में बहुत संभावनाएँ हैं।
बेहतर प्रॉम्प्टिंग और भविष्य के सुधारों के साथ, मैं इसे एक बहुत उपयोगी लोकल कोडिंग मॉडल बनते देख सकता हूँ, जैसा कि मेरा अनुभव Qwen3.6 27B के साथ रहा है।
मुझे यह दिशा Meta AI के लिए भी बहुत अच्छी लगती है।
लोकल कोडिंग एजेंट्स में स्पष्ट रुचि है क्योंकि वे यह दे सकते हैं:
मेरे सेटअप में, मॉडल ने लगभग 24 GB GPU मेमोरी का उपयोग किया, जो हाई-एंड लोकल हार्डवेयर के लिए इसे व्यावहारिक बनाता है।
आप ऐसे मॉडलों को सिस्टम या यूनिफाइड मेमोरी के साथ भी चला सकते हैं, हालांकि प्रदर्शन धीमा होगा।
इस गाइड में, हमने llama.cpp को बिल्ड किया, Muse Glimmer GGUF फाइलें डाउनलोड कीं, विज़न और speculative decoding सक्षम किया, API और Web UI टेस्ट किए, और मॉडल को OpenCode से जोड़ा।
हमने इसका उपयोग एक पूरा एप्लिकेशन बनाने और टेस्ट करने में भी किया।
मेरा मुख्य निष्कर्ष यह है कि Muse Glimmer कोड बनाने में बहुत तेज़ है, लेकिन डीबगिंग या अधिक जटिल एजेंटिक कार्यों को संभालते समय इसे अभी भी स्पष्ट निर्देशों की ज़रूरत होती है।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
लर्निंग पाथ